course
Introducere în modelele Claude
3 oră
14.3K
Zvonurile despre următoarea lansare Anthropic au tot mocnit în ultimele zile. Deși mulți se așteptau la Claude Sonnet 5, prima lansare a anului vine sub forma Claude Opus 4.6.
Cu o fereastră de context de 1 milion de tokeni, gândire adaptivă, compactarea conversațiilor și o serie de benchmarkuri de top, Claude Opus 4.6 reprezintă o îmbunătățire față de Opus 4.5. Așa cum o numește Anthropic, au upgradat cel mai inteligent model al lor. Alături de model, Anthropic a lansat și echipe de agenți în Claude Code și Claude în PowerPoint.
În acest articol, vom acoperi tot ce e nou în Claude Opus 4.6, analizând funcțiile noi, explorând benchmarkurile și punându-l la treabă cu câteva exemple practice.
Pentru a afla mai multe despre unele dintre cele mai recente funcții Claude, îți recomand să consulți ghidurile noastre pentru Claude Cowork și Claude Code, precum și tutorialul OpenClaw. Pentru o comparație cu alți competitori, citește ghidurile noastre despre Muse Spark vs Claude Opus 4.6 și GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 este cel mai recent model de limbaj de mari dimensiuni de la Anthropic. Continuând după Opus 4.5, reprezintă un upgrade semnificativ al nivelului de model „cel mai inteligent” al companiei.
Din blogul de lansare, Anthropic susține că are un accent mai mare pe programare agentică, raționament profund și autocorecție. Asta înseamnă o trecere de la acțiune la acțiune susținută.
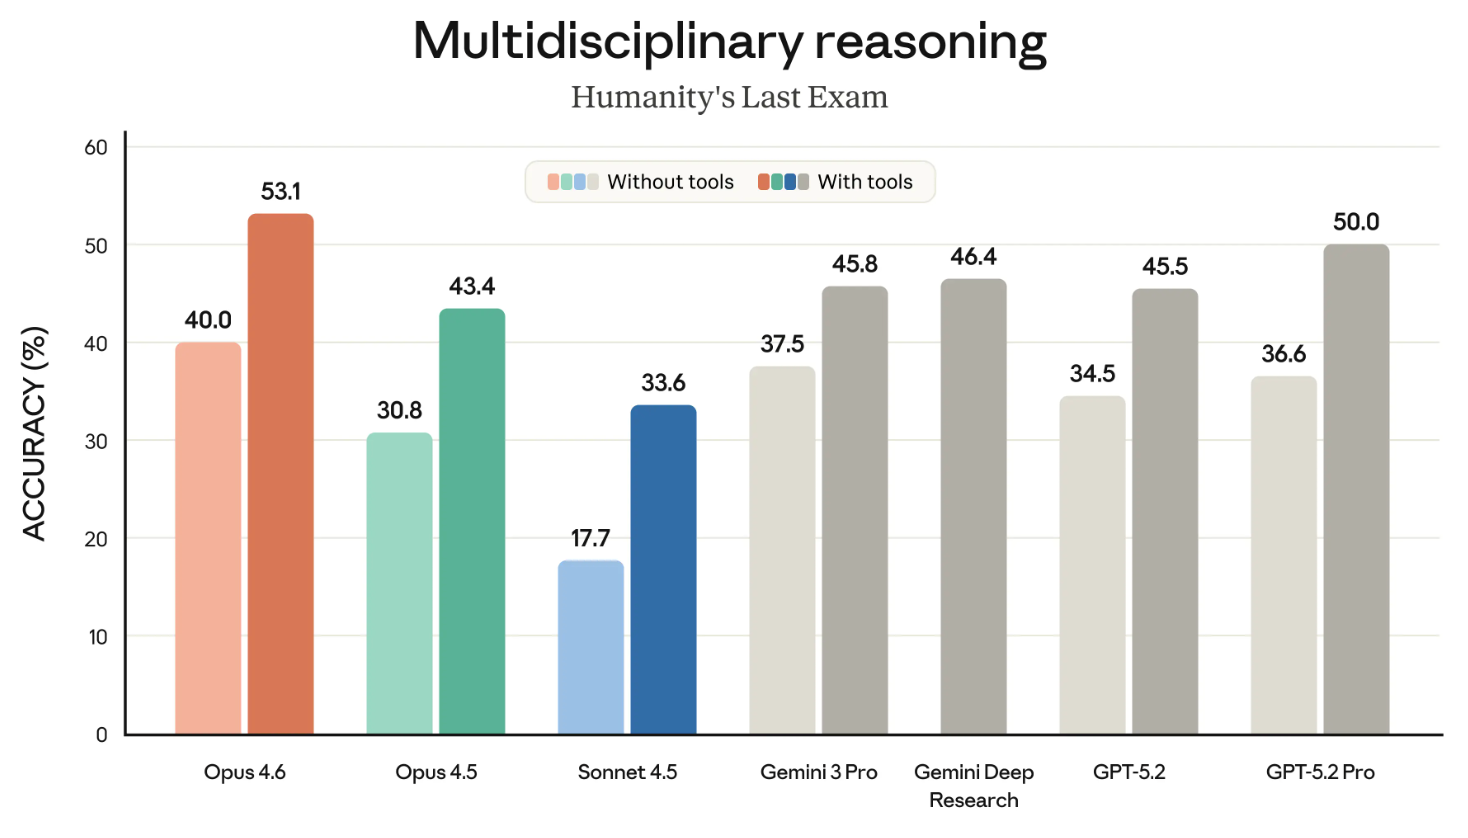
Opus 4.6 este conceput să planifice mai atent, are coerență îmbunătățită pe perioade mai lungi și identifică erorile în propriul proces. Toate acestea înseamnă că Claude Opus 4.6 conduce mai multe benchmarkuri, inclusiv scorul de top la evaluarea de programare Terminal-Bench 2.0 și depășește toate celelalte modele de avangardă la Humanity’s Last Exam.
Unul dintre lucrurile care mi-au atras cel mai mult atenția este fereastra de context îmbunătățită din Claude Opus 4.6. Cu 1 milion de tokeni în beta, acest lucru aliniază noul model cu Gemini 3, ceea ce înseamnă că poate procesa mai multe informații fără a pierde contextul.
Între timp, Anthropic a publicat versiunea succesoare a lui Opus. Îți recomand să citești ghidul nostru Claude Opus 4.7 pentru a rămâne la curent.
Există mai multe funcții noi notabile în Claude Opus 4.6, multe dintre ele axate pe fluxuri de lucru agentice. Să vedem câteva puncte cheie:
Echipele de agenți reprezintă o îmbunătățire față de „subagenții” pe care i-am văzut în versiunile anterioare ale lui Claude. Echipele de agenți îți permit să pornești mai multe instanțe Claude complet independente care pot lucra în paralel. O sesiune este agentul „lider” care coordonează lucrurile, în timp ce „coechipierii” se ocupă de execuția propriu-zisă.
Ce mi se pare cel mai interesant este că fiecare membru al echipei are propria fereastră de context, permițând o execuție mai temeinică. Fiecare coechipier poate, de asemenea, să comunice direct cu ceilalți din echipă.
Desigur, această funcție vine și cu un potențial dezavantaj – costul. Deoarece fiecare agent are propria fereastră de context, poți ajunge repede să consumi multe tokenuri. Astfel, Anthropic recomandă să le folosești pentru scenarii cu niveluri ridicate de complexitate.
O funcție reușită a lui Claude Opus 4.6 este compactarea contextului. Acest upgrade de confort te ajută să eviți problemele când rulezi fluxuri de lucru lungi care umplu ferestrele de context. De obicei, ai lovi un „zid de context” unde performanța începe să degradeze.
Cu compactarea conversației, Claude Opus 4.6 poate detecta automat când o conversație se apropie de un prag de tokeni și rezuma conversația existentă într-un bloc concis (un bloc de compactare).
Această funcție ar trebui să ajute la păstrarea esențialului din interacțiunile tale, eliberând totodată spațiu pentru a-ți continua munca. Dacă plănuiești să folosești agenți orientați pe sarcini care trebuie să ruleze mult timp, le-ar putea menține cursul cu o memorie mult îmbunătățită.
Există două funcții în Claude Opus 4.6 care determină dacă are nevoie de gândire extinsă și cât de mult „trage” pentru acea gândire.
Gândirea adaptivă permite modelului să determine cât de complexă este solicitarea ta. În funcție de simplitate sau complexitate, va decide dacă să folosească gândirea extinsă. În loc să aibă o setare manuală pentru câți tokeni folosește în acest scop, Claude își va ajusta bugetul în funcție de complexitatea fiecărei cereri.
Parametrul „effort” îți permite să setezi cât de dornic sau conservator este Claude în a cheltui tokeni. Practic, poți echilibra eficiența tokenilor și cât de detaliate sunt răspunsurile.
Când folosești Claude Opus 4.6 în API, poți seta manual acești parametri. De exemplu:
Recent am acoperit Claude în Excel, arătând cum suplimentul te poate ajuta cu diverse sarcini într-un panou lateral al foii tale de calcul Excel. Pe lângă îmbunătățirea funcționalității acestui instrument, Anthropic a anunțat Claude în PowerPoint.
Această integrare respectă slide master-urile, fonturile și layout-urile tale. Îi poți furniza un șablon corporativ și să-i ceri să construiască o secțiune specifică sau poți selecta un slide și să-i ceri să transforme textul dens într-o diagramă nativă, editabilă.
Accentul pe generarea de obiecte PowerPoint editabile, mai degrabă decât „poze ale slide-urilor”, face din asta un instrument real de productivitate, nu doar un generator de concepte.
Claude în PowerPoint este în prezent în previzualizare de cercetare pentru utilizatorii Max și Enterprise.
Multe dintre afirmațiile principale ale lui Opus 4.6 se concentrează pe sarcini de programare mai dificile și raționament mai profund. Aceste abilități se bazează pe o fundație clară: capacitatea de a ține în minte constrângeri multiple, de a raționa pe mai mulți pași și de a prinde greșelile.
Cu asta în minte, am supus Opus 4.6 la o serie de provocări de logică pe mai mulți pași, matematică și cod. Am vrut să vedem dacă putem scoate la iveală unele slăbiciuni cunoscute și comune ale LLM-urilor – lucruri precum erori de calcul în cascadă, raționament spațial (mereu o problemă) și întrebări care implică constrângeri. Am inclus și o sarcină specifică de depanare, deoarece anunțul Anthropic s-a lăudat cu cât de bun este Opus 4.6 la analiza cauzei rădăcină și alte probleme de debugging.
Primul nostru test combină numere prime, hexazecimale și numărare:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
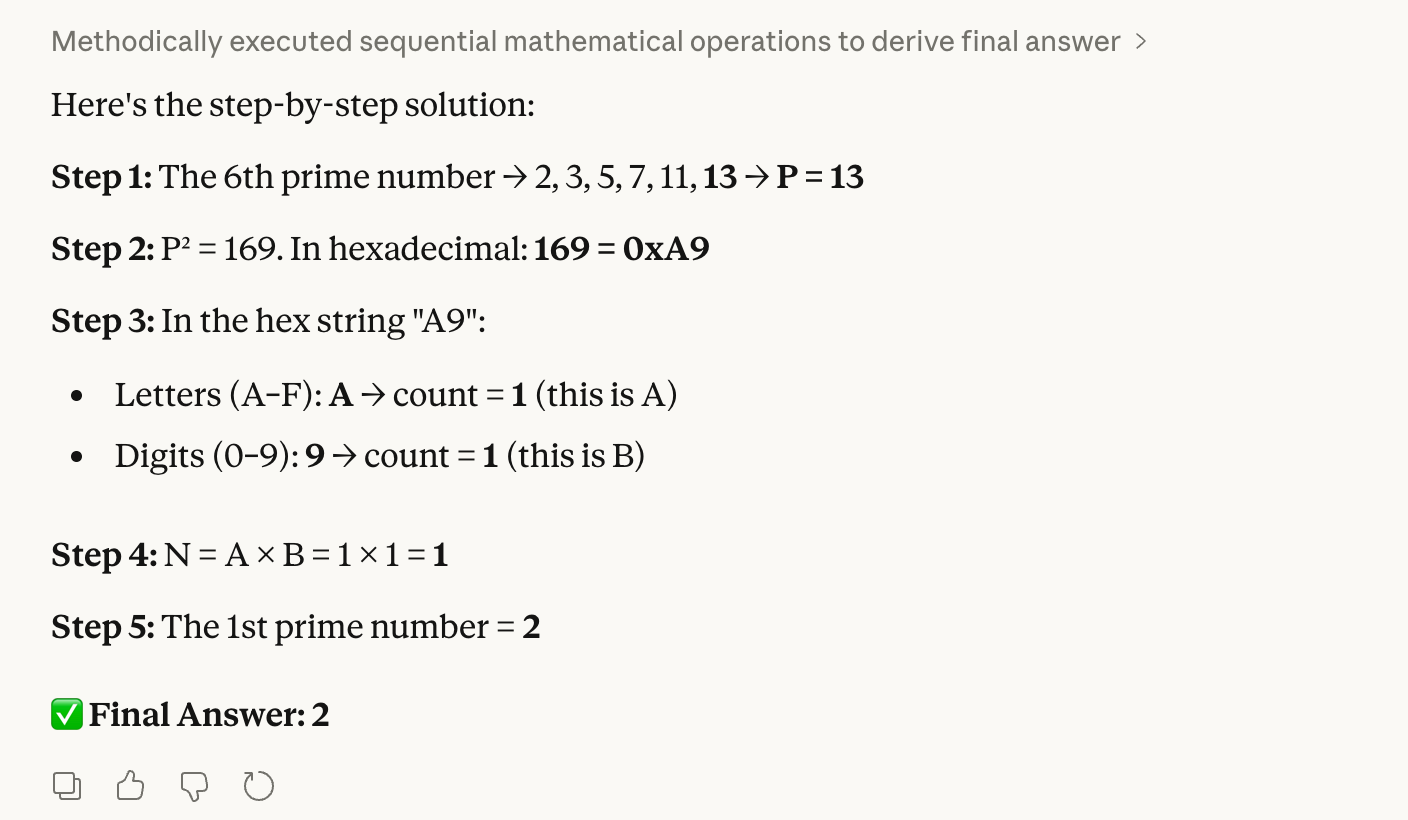
Sună puțin complex, dar testul e destul de ușor de verificat pentru noi, oamenii. Răspunsul corect pe care îl știm este 2, deoarece al 6-lea număr prim este 13; 13 la pătrat este 169, care este „A9” în hex. Acesta are 1 literă × 1 cifră, ceea ce dă 1 când le înmulțim, iar primul număr prim este 2.
Îngrijorarea este că un model s-ar putea poticni la conversia hex, ceea ce ar duce în cascadă la un răspuns final complet greșit. După cum poți vedea, Opus 4.6 nu a avut nicio problemă:
Al doilea test e unul de raționament spațial și de gestionare a numerelor negative:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
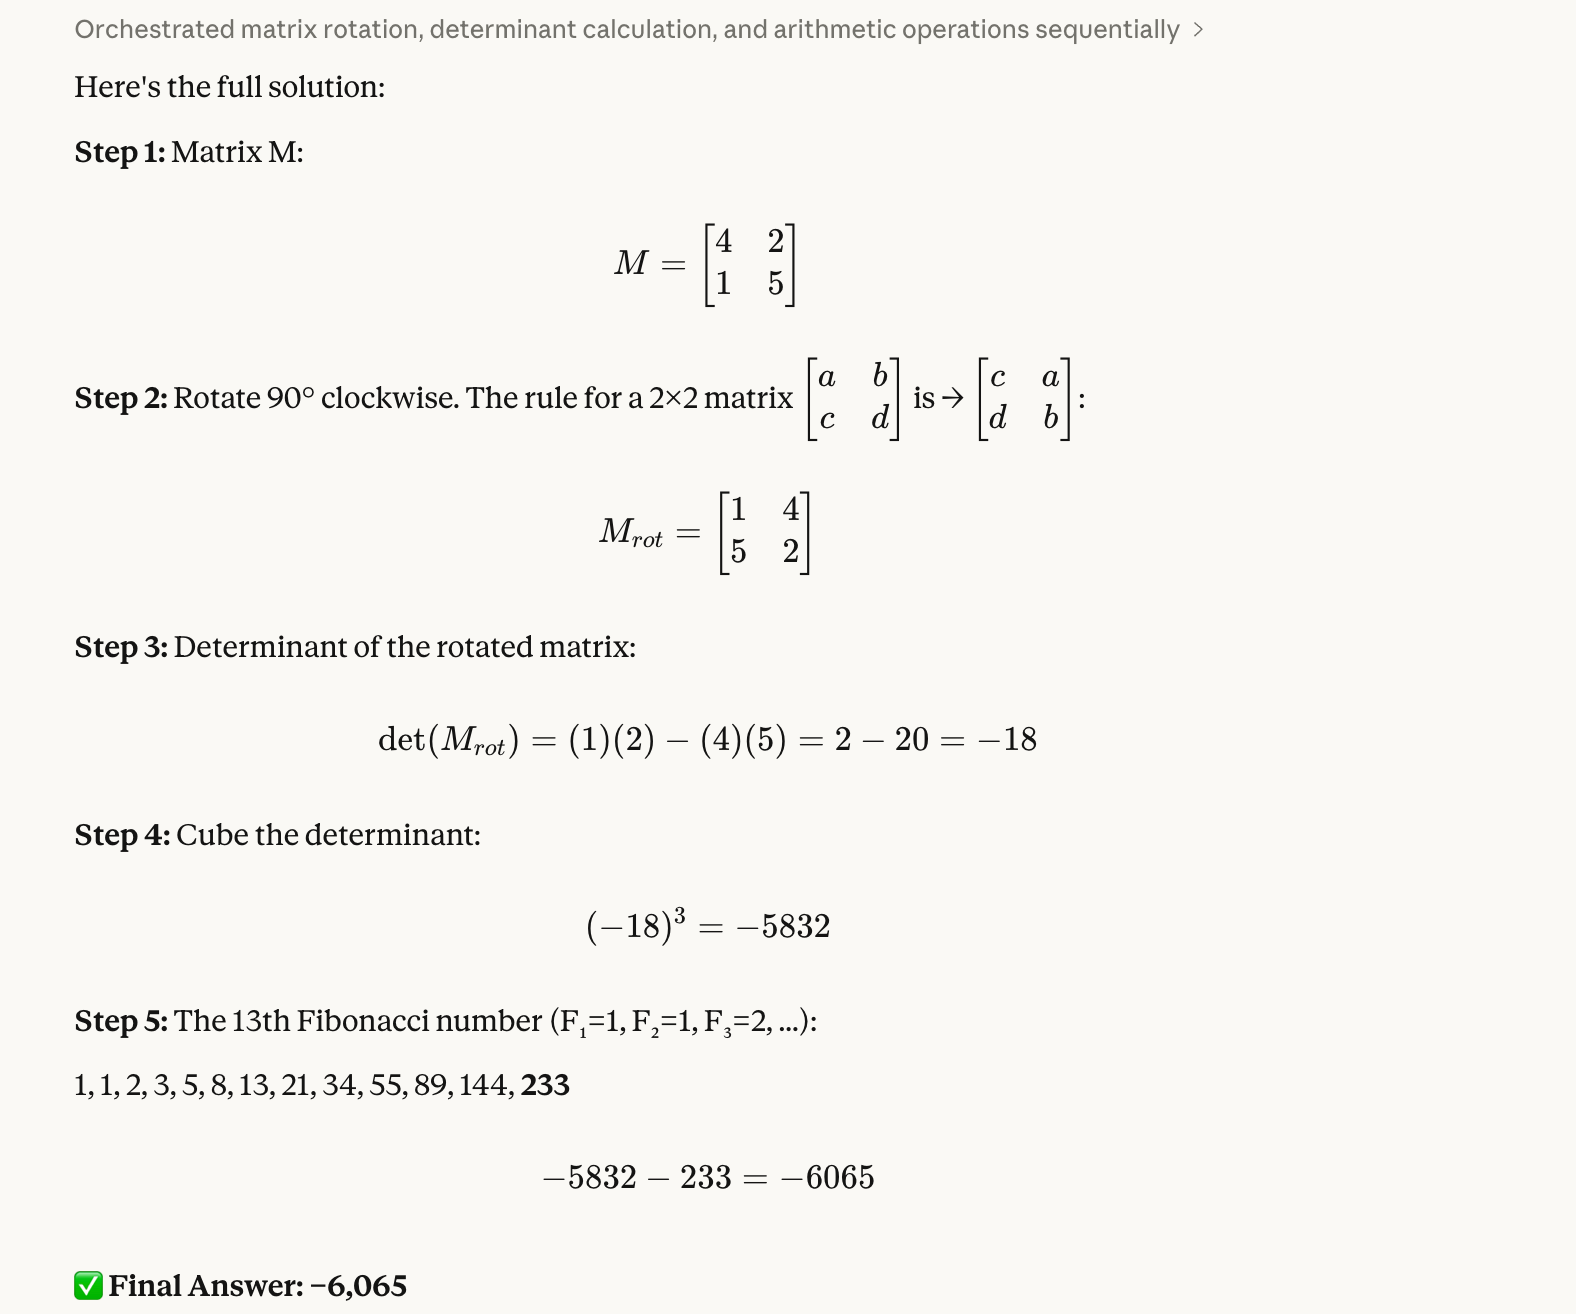
Acesta a necesitat ceva mai multă muncă de verificare din partea noastră. Răspunsul corect este -6.065. Știm asta pentru că matricea rotită este [[1, 4], [5, 2]]; apoi putem folosi Python pentru a găsi determinantul, care este -18 și, când îl ridicăm la cub, obținem -5.832; în final, scădem 233 și obținem -6.065.
Ne-a plăcut ideea acestui test pentru că știm din experiență că modelele adesea încurcă elementele matricei sau pierd semnul negativ pe parcurs. Din nou, Opus 4.6 nu a avut nicio problemă:
Pentru al treilea test, am încercat o problemă de satisfacere a constrângerilor care necesită backtracking:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
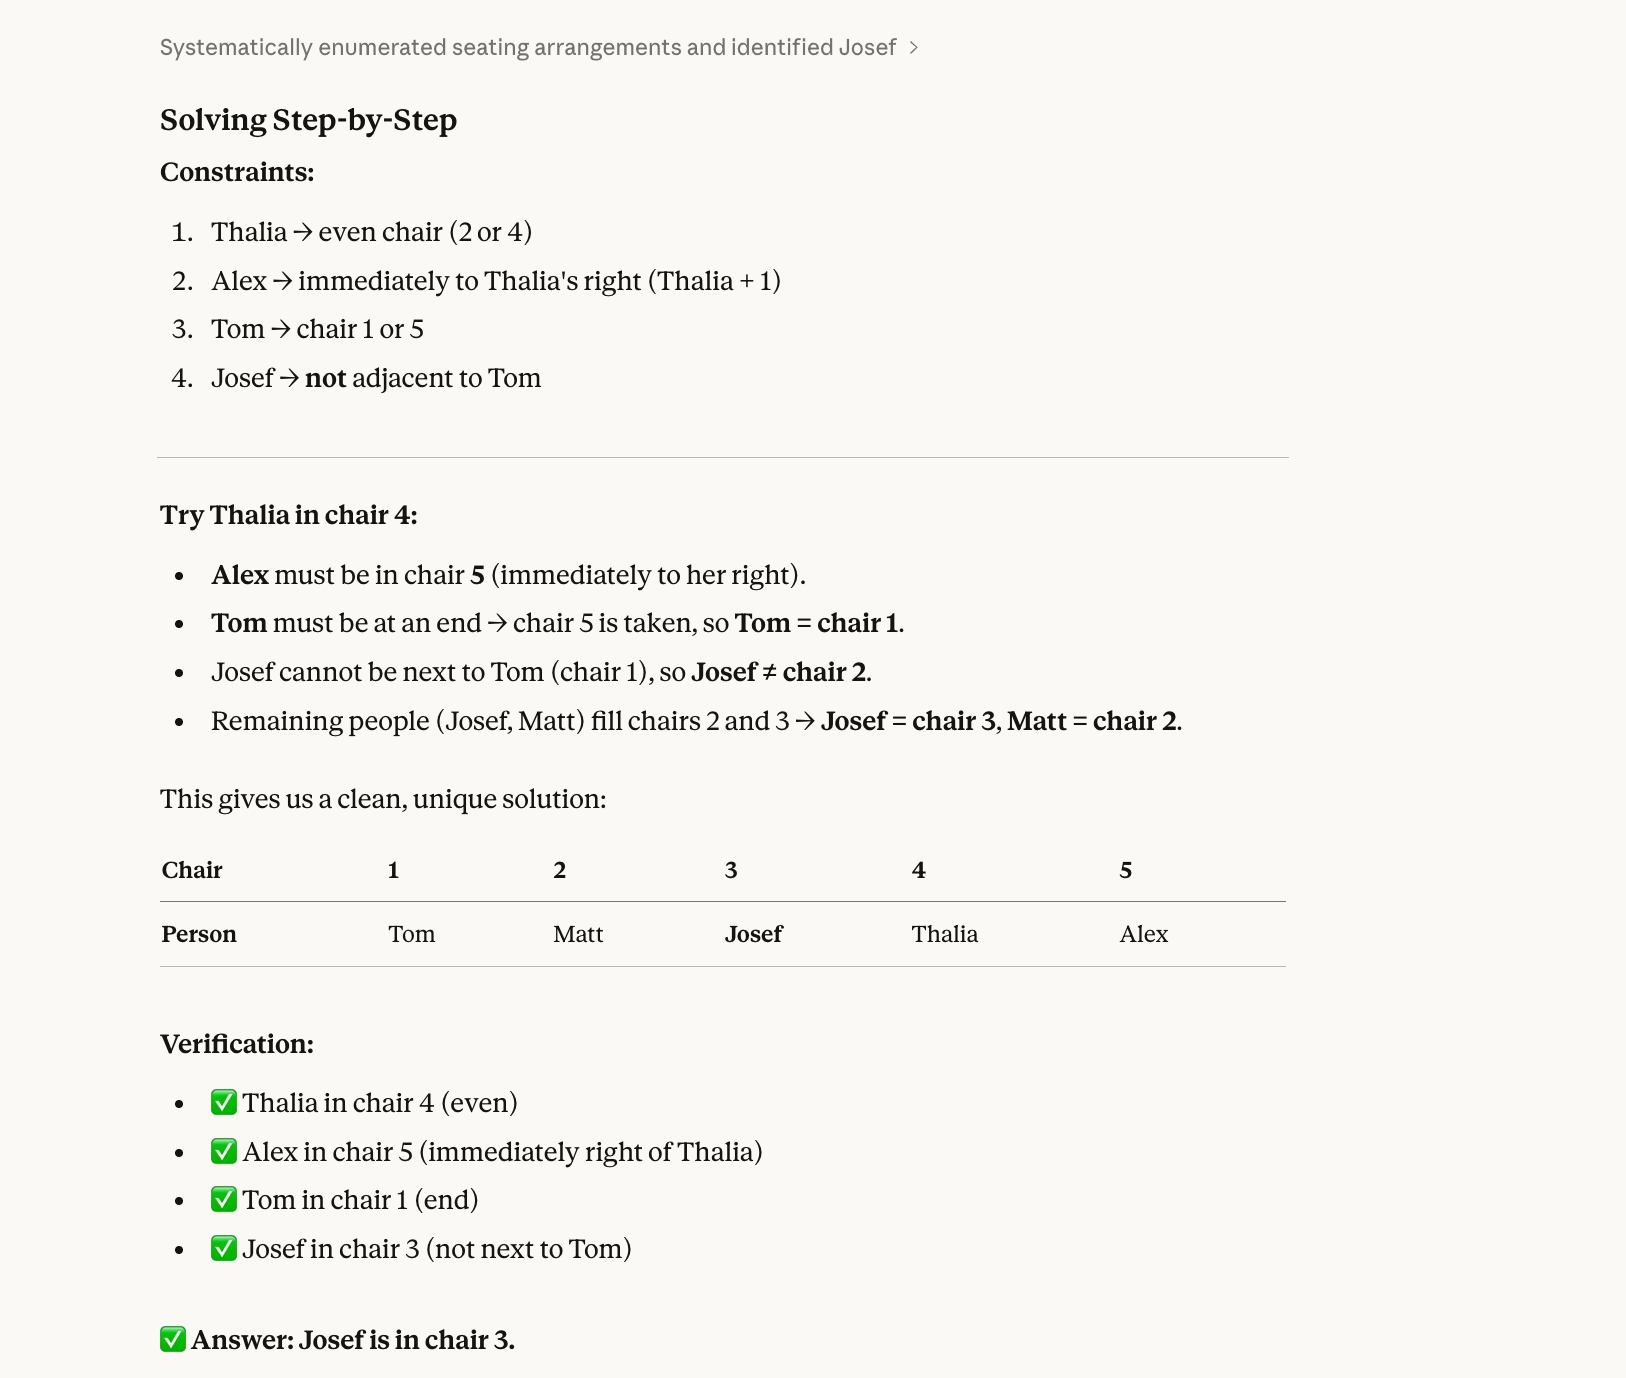
Răspunsul corect la acest test este Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Poți rezolva asta pe hârtie cu puțin efort.
Motivul de bază pentru care un model ar putea greși la acest tip de întrebare este că, istoric, modelele au rezolvat secvențial, nu holistic. Ele citesc „Thalia este pe un scaun cu număr par” și aleg unul (să zicem, scaunul 2) fără să verifice dacă acea alegere funcționează cu toate celelalte constrângeri. Apoi se fixează pe ea, completează mai multe scaune și, în cele din urmă, dau de un conflict, dar până atunci s-au „scris” într-un colț și nu se mai întorc să încerce Thalia pe scaunul 4.
Opus 4.6 a rezolvat corect și acest test:
Al patrulea test evaluează vizualizarea spațială și intuiția fizică:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Pentru a verifica acest test, chiar am scos ceasul de la mână și l-am rotit.
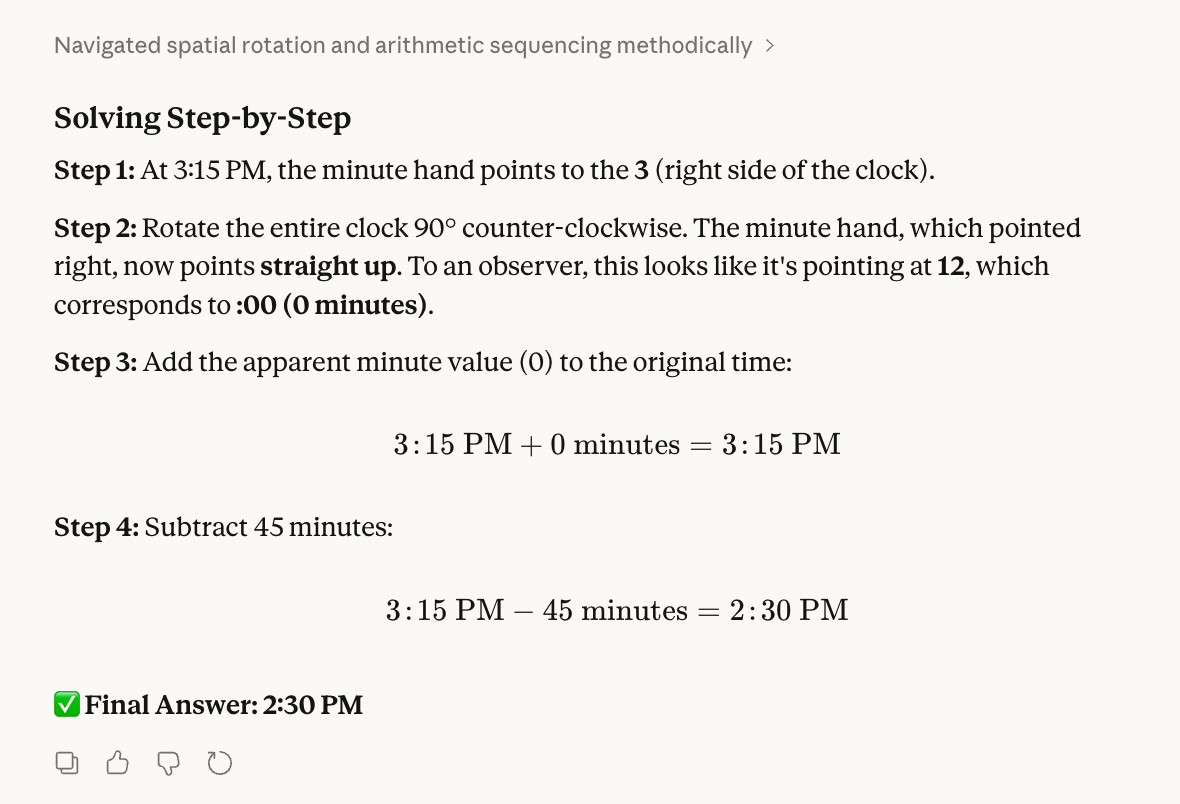
Răspunsul corect este 14:30. La 3:15, minutarul indică „3”. Când am orientat „12” spre fereastra din stânga mea, „3” a ajuns acolo unde era „12”. Apoi am adăugat 0 la 3:15, am scăzut 45 de minute și am obținut 14:30.
Când am conceput testul, ne așteptam ca modelele să confunde rotirea feței ceasului cu mutarea acelor. Am auzit, de asemenea, că modelele tind să considere adunarea lui 0 ca suspectă și, prin urmare, încearcă să forțeze un alt număr.
Totuși, Opus 4.6 a reușit să rezolve problema; a dat și aici răspunsul corect:
Al cincilea test combină aritmetica modulară cu filtrarea numerelor prime:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
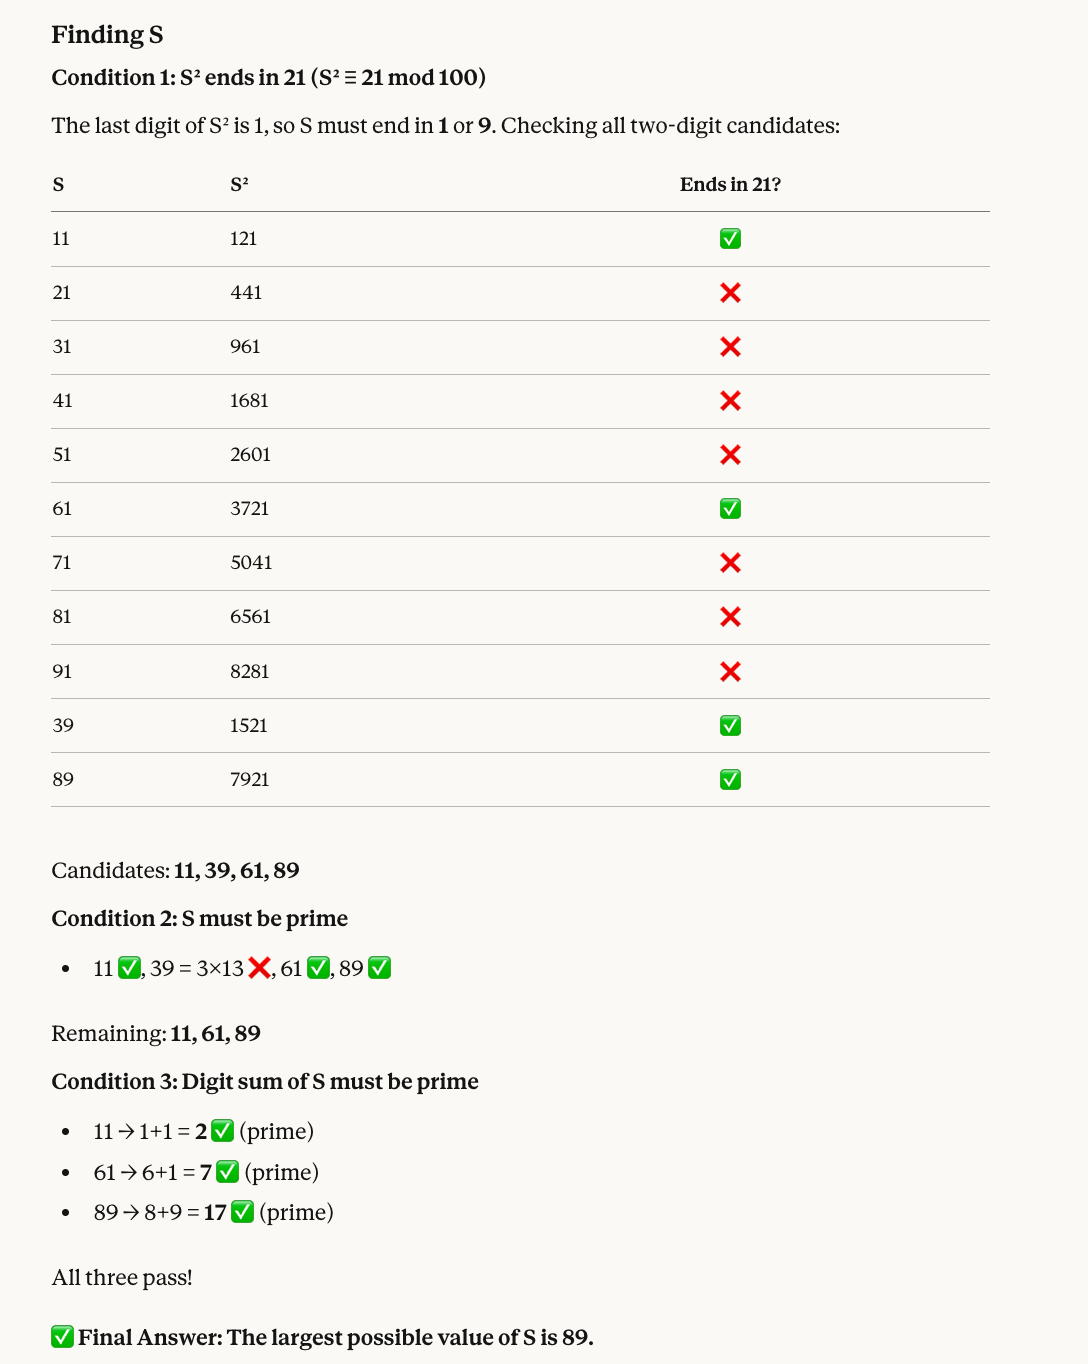
Iată de ce numărul corect este 89: Numerele ale căror pătrate se termină în 21 includ 11, 39, 61 și 89. Dintre acestea, 39 nu este prim, așa că rămân 11, 61 și 89. Toate trei au sume ale cifrelor care sunt prime (2, 7 și 17, respectiv), deci cel mai mare este 89.
Opus 4.6 a dat din nou răspunsul corect și, de data aceasta, a inclus și un vizual util:
Următorul test leagă între ele factori factoriali, manipularea șirurilor și numere prime:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
Iată cum am verificat 425 ca răspuns corect: 5! = 120; scădem 1 și obținem 119; inversăm cifrele și obținem 911. Apoi, folosind ceva cod R (mai jos), am văzut că există 152 de numere prime între 10 și 911, iar suma lor este 64.598. În final, folosind din nou R, împărțim și rotunjim: 64.598 ÷ 152 ≈ 425.
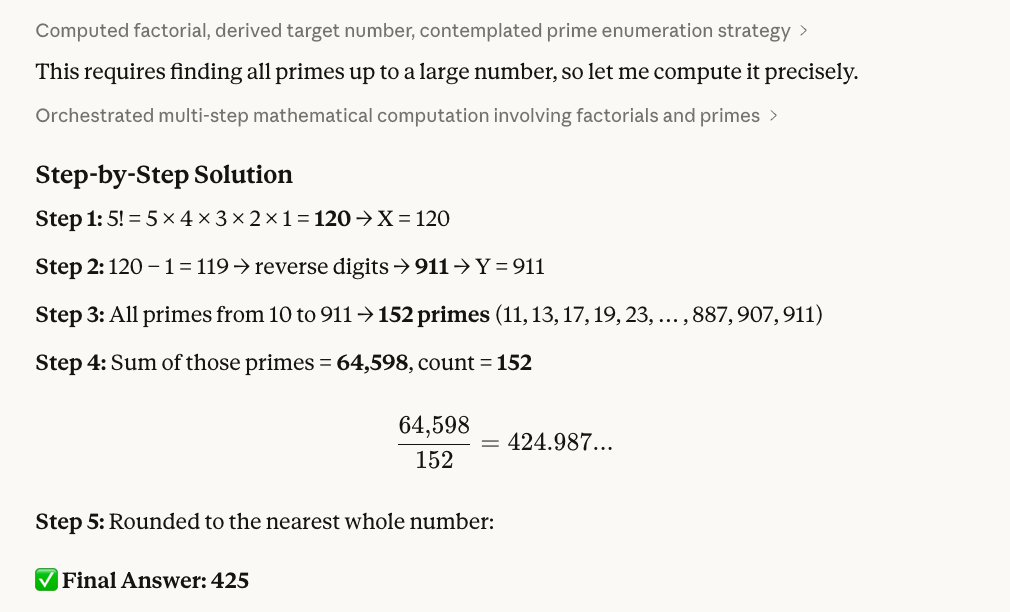
Iată scriptul R pe care l-am folosit:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Următorul nostru test vizează una dintre afirmațiile majore ale lui Opus 4.6: diagnosticarea bug-urilor în cod. Știm că modelele parcurg adesea corect codul linie cu linie, dar nu reușesc să conecteze parcurgerea la defectul de bază.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
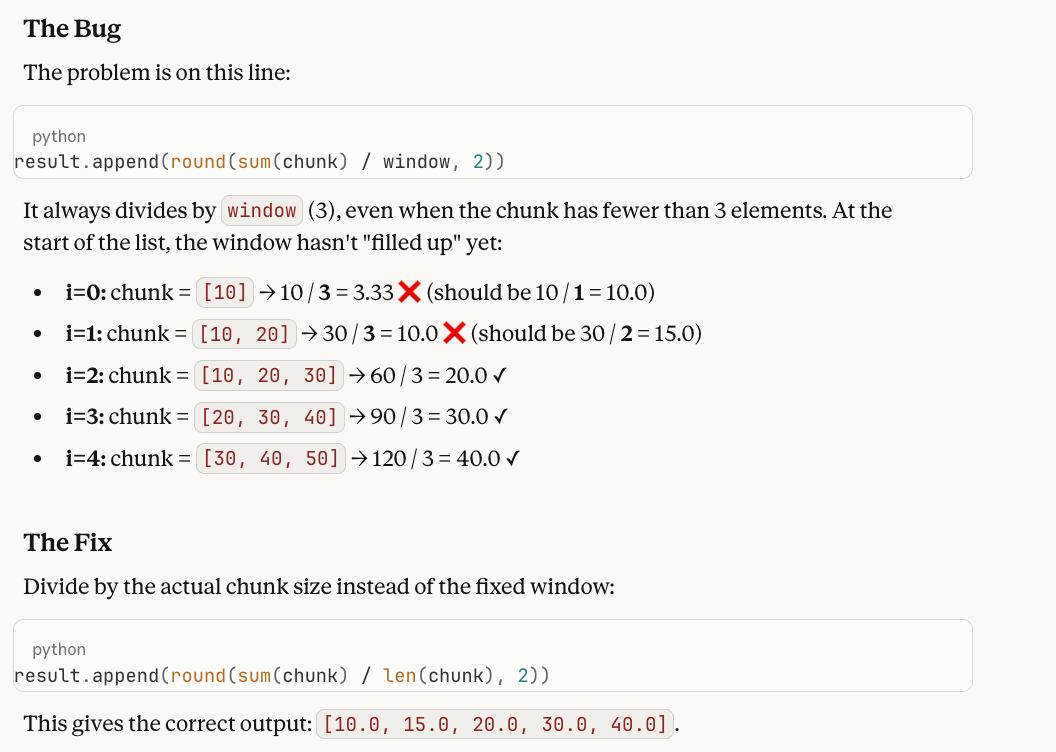
Iată răspunsul și de ce funcționează ca test: funcția împarte mereu la window (3), chiar și când secvența are mai puțin de 3 elemente la începutul listei. Ieșirea cu bug este [3.33, 10.0, 20.0, 30.0, 40.0], dar primele două valori ar trebui să fie 10.0 și 15.0, deoarece acele secvențe conțin doar 1, respectiv 2 elemente. Remedierea constă în schimbarea / window în / len(chunk).
Ne place acest test pentru că modelele parcurg adesea perfect bucla, dar apoi raportează „ieșirea pare corectă” — văd matematica pas cu pas și nu semnalează că împărțirea unui singur element la 3 este greșită. Necesită ca modelul să țină intenția (ce ar trebui să facă o medie mobilă) alături de execuție (ce face efectiv codul) și să observe discrepanța dintre ele.
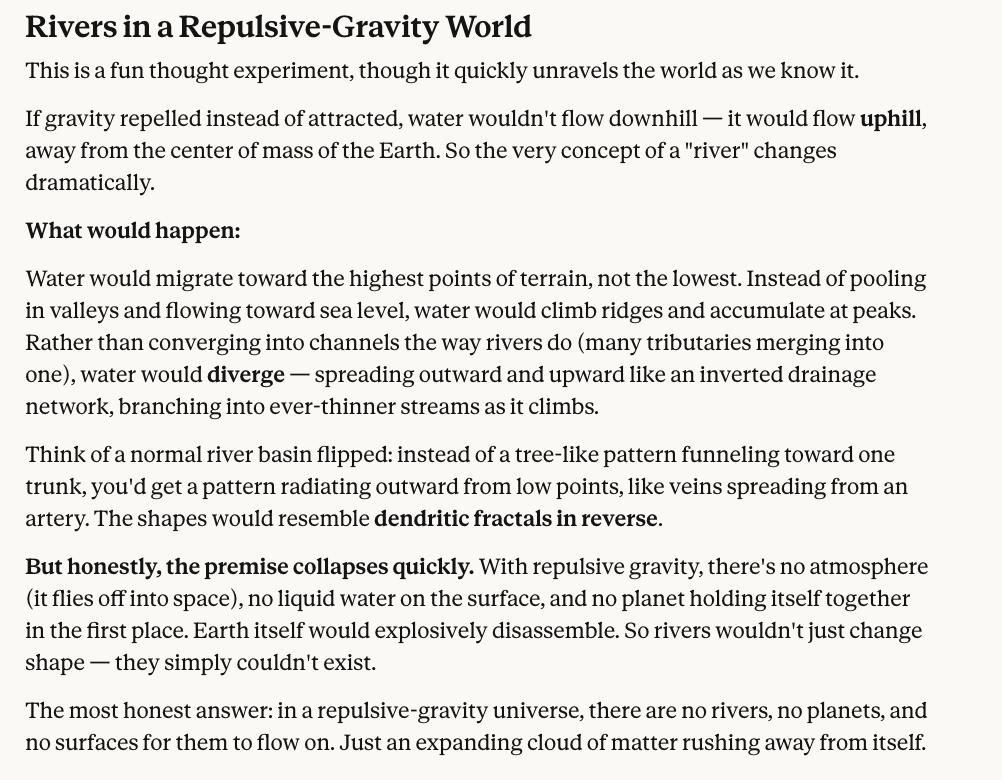
Ultimul nostru test nu are matematică, doar raționament contrafactual.
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Desigur, nu există un singur răspuns corect aici și e greu de imaginat. Dar căutăm ca modelul măcar să raționeze asupra implicațiilor, iar noi credem că răspunsul lui Claude Opus 4.6 este suficient de rezonabil.
Per total, pe scurt, Opus 4.6 a obținut scor perfect, deși, cum ai văzut, am inclus o întrebare în care răspunsul a fost puțin subiectiv, așa că poți fi tu judecătorul final.
Opus 4.6 este liderul incontestabil în cel puțin patru benchmarkuri importante:
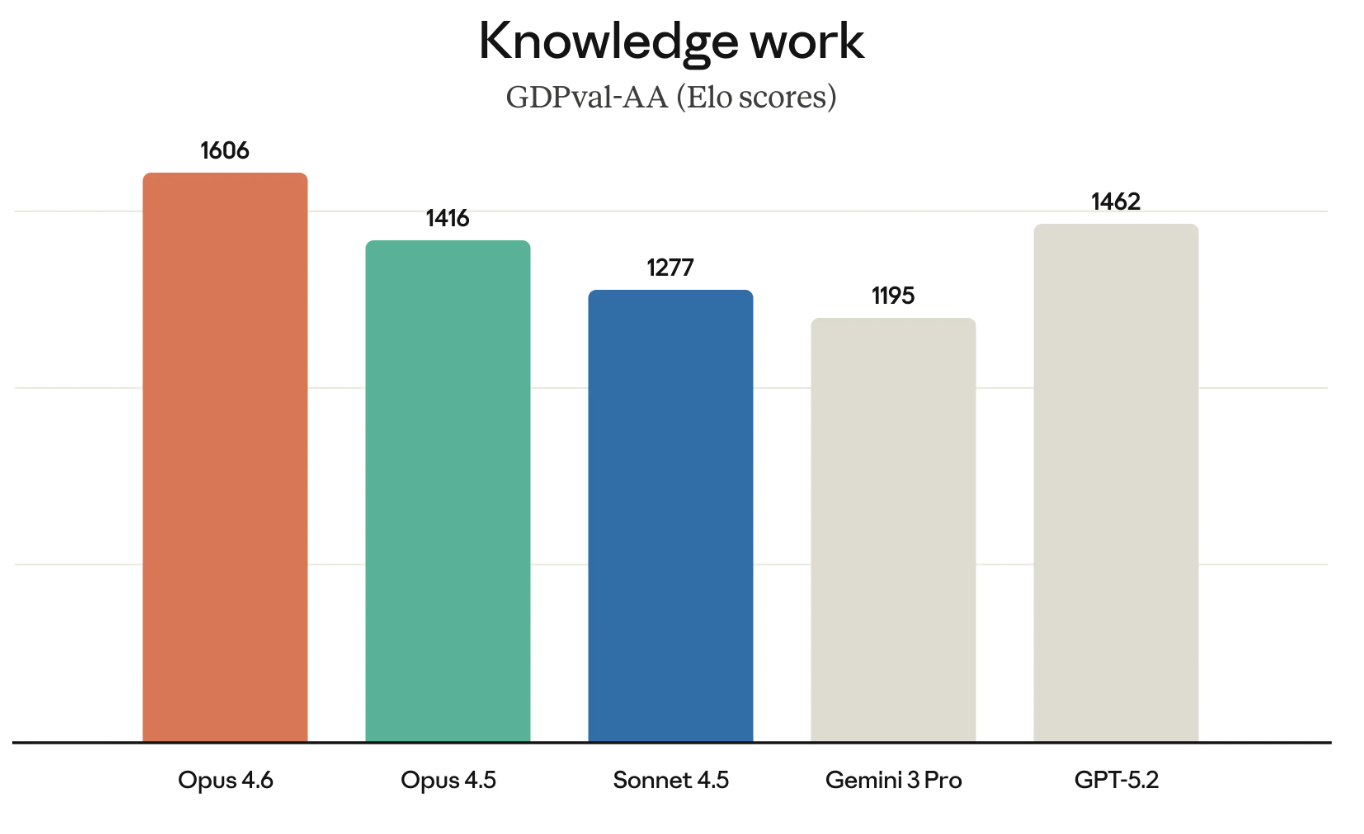
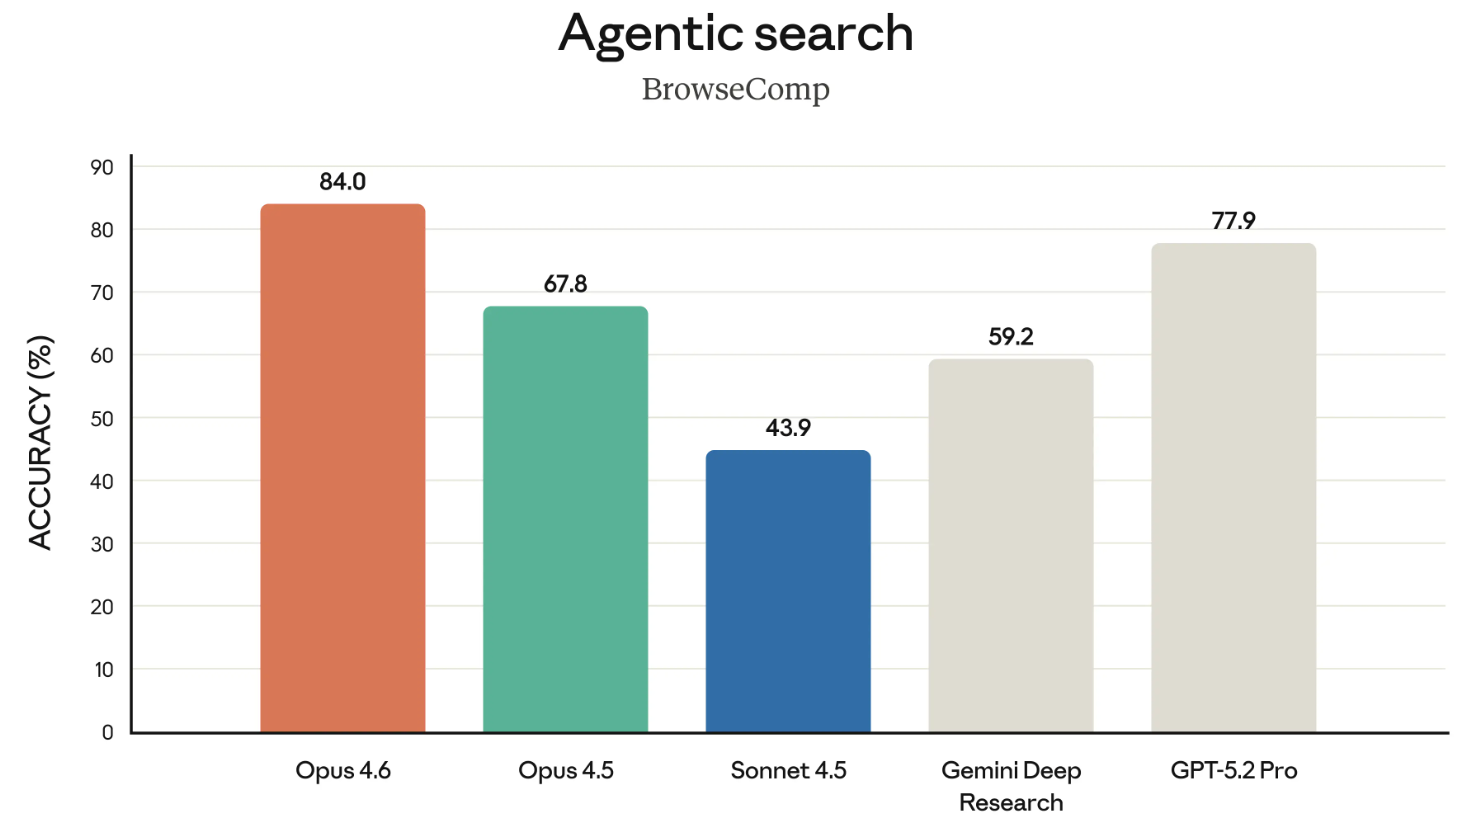
Terminal-Bench 2.0 este un benchmark de programare agentică; Humanity’s Last Exam este un test de raționament complex; GDPval-AA testează performanța în munca de cunoaștere; BrowseComp măsoară abilitatea unui model de a găsi online informații greu de găsit.
Modelele Claude au o reputație meritată ca fiind printre cei mai buni „programatori”. Așadar, să începem prin a ne uita la rezultatele benchmarkului Terminal-Bench 2.0.
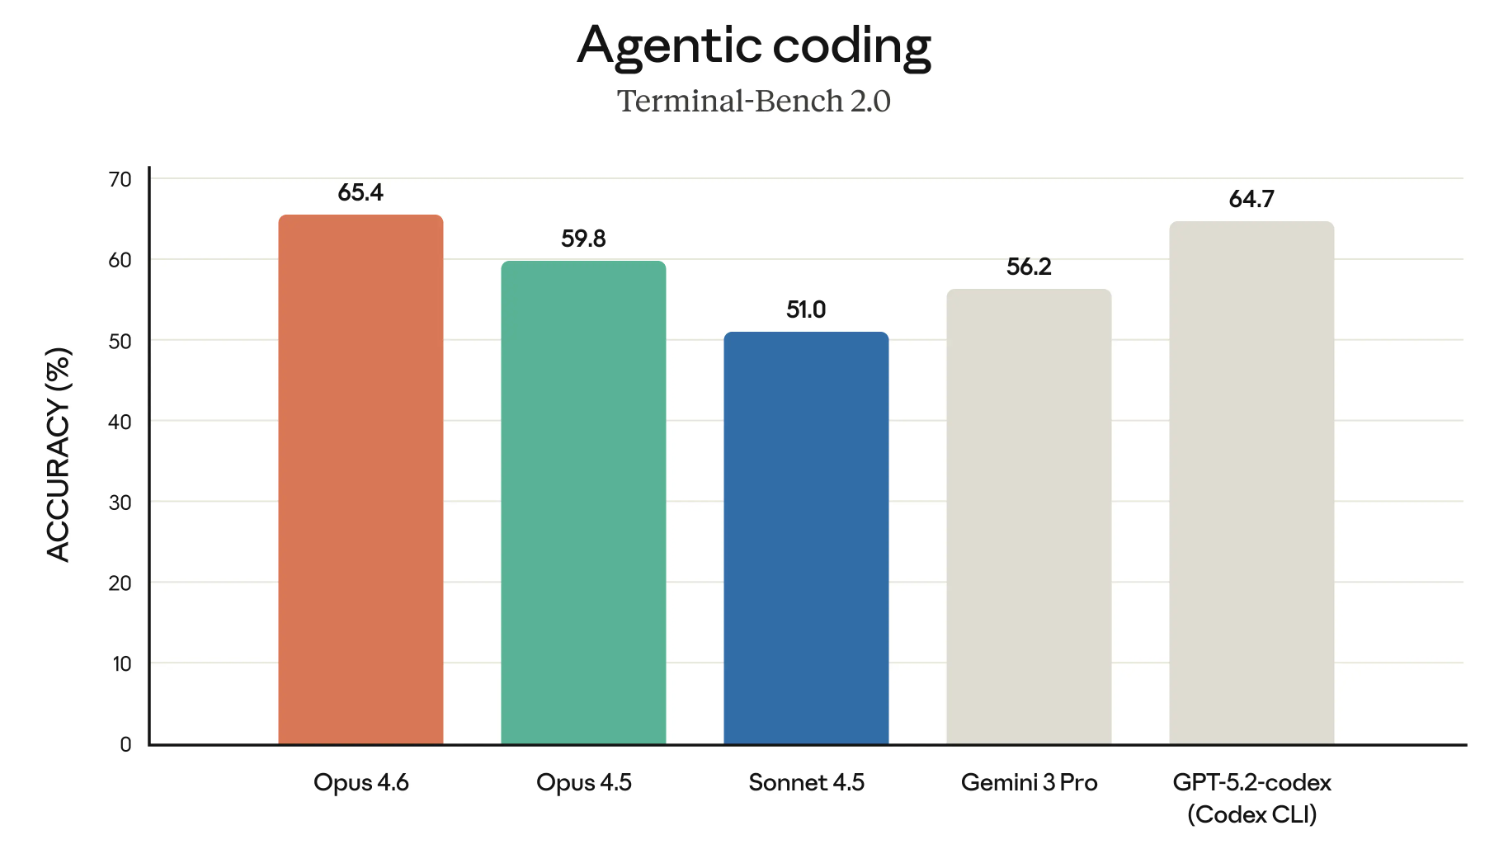
Dacă graficul de mai sus pare să evidențieze Opus 4.6 în raport cu GPT-5.2-codex – ei bine, cu siguranță e intenționat. Anthropic a provocat direct OpenAI în mai multe domenii în ultima vreme și își susține cazul pentru uz enterprise.
Humanity’s Last Exam este unul dintre cele mai cunoscute benchmarkuri și este unul pe care îl urmărim cu atenție. Măsoară abilitatea unui model de a raționa în general.
Graficul următor arată succesul diferitelor modele de avangardă pe benchmarkul HLE, atât cu instrumente, cât și fără. („Cu instrumente” înseamnă că modelului i s-a permis să folosească capabilități externe, cum ar fi căutarea pe web și execuția de cod.)
Acest grafic ar fi putut fi mai bun ca două grafice. Lăsând deoparte acest aspect minor, concluzia e clară: Opus 4.6 este lider atât la categoria „cu instrumente”, cât și la „fără instrumente”.
GDPval-AA (după cum sugerează numele) este un test al a ceea ce este considerat muncă de cunoaștere cu valoare economică. Gândește-te la lucruri precum rularea de modele financiare sau realizarea de cercetări.
GDPval-AA și alte benchmarkuri similare devin tot mai importante, deoarece chiar măsoară tipurile de muncă pentru care companiile plătesc efectiv. Succesul lui Opus 4.6 la GDPval-AA este, de asemenea, o altă provocare directă la adresa suitei de modele GPT, deoarece OpenAI și Anthropic concurează pentru mulți dintre aceiași clienți.
BrowseComp este ultimul benchmark demn de menționat din lansare. Măsoară abilitatea unui model de a găsi online informații greu de găsit. Puțin context: OpenAI a dezvoltat de fapt BrowseComp pentru a evidenția capabilitățile de căutare ale propriilor modele.
Într-o mișcare sugestivă, în această lansare, Anthropic a legat direct de anunțul OpenAI din aprilie 2025 privind dezvoltarea BrowseComp când a subliniat că Opus 4.6 este pe primul loc la acest benchmark. A fost o mișcare puțin „șmecheră”, citându-le celor de la OpenAI propriul benchmark împotriva lor.
Opus 4.6 este pe scară largă disponibil la momentul acestui articol. Totuși, nu poți accesa Opus 4.6 fără să faci upgrade la un cont pro, care vine cu alte beneficii, precum posibilitatea de a folosi Claude în Excel.
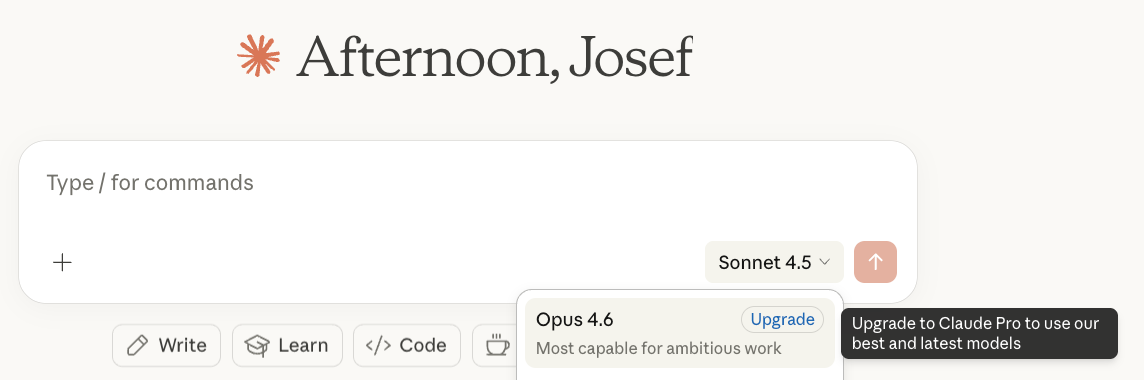
Dacă ești dezvoltator, ar trebui să folosești claude-opus-4-6 în API-ul Claude. Prețurile nu s-au schimbat: sunt în continuare 5$/25$ per milion de tokeni. Dacă te încurcă cele două numere, să știi că primul este ce plătești pentru a trimite tokeni către model (mă refer la prompturile tale), iar al doilea este ce plătești pentru tokenii pe care îi generează la întoarcere (răspunsurile).
Claude Opus 4.6 conduce clasamentele la benchmarkuri importante precum GPDVal-AA, care măsoară cât de bine performează un model pe sarcini cu importanță economică, adică exact ceea ce contează pentru clienții enterprise mari. OpenAI ar putea fi tulburat de această evoluție, deoarece cu doar câteva ore înainte de lansarea Opus 4.6 au anunțat OpenAI Frontier, o nouă platformă enterprise pentru construirea, implementarea și gestionarea agenților AI în producție.
Cu alte cuvinte, în loc să concureze pe benchmarkuri de model, Frontier ne arată că OpenAI se concentrează pe infrastructura din jurul suitei sale de modele, în mod specific pe a oferi agenților AI context de business comun, permisiuni și abilitatea de a primi și învăța din feedback în timp. Pierzând teren la benchmarkuri, OpenAI semnalează că platforma sa este mai bine poziționată pentru a face agenții cu adevărat utili într-o companie.
Dacă asta este o pivotare strategică sau o admitere tacită că pierd cursa modelelor, rămâne la latitudinea ta să decizi.
Per ansamblu, însă, suntem impresionați de ce oferă Anthropic cu Claude Opus 4.6 și abia așteptăm să lucrăm efectiv cu echipele de agenți. Dacă vrei să afli mai multe despre familia Claude, nu rata cursul Introduction to Claude Models.
Învață AI cu DataCamp
course
course
course