Courses
Claude Models เบื้องต้น
3 ชม.
14.3K
ตลอดสองสามวันที่ผ่านมา มีข่าวลือเกี่ยวกับรุ่นถัดไปของ Anthropic หลายคนคาดว่าเป็น Claude Sonnet 5 แต่รุ่นแรกของปีนี้มาในรูปแบบของ Claude Opus 4.6
ด้วยหน้าต่างบริบท 1 ล้านโทเค็น การคิดแบบปรับตัว การย่อบทสนทนา และคะแนนท็อปชาร์ตในหลายเกณฑ์ชี้วัด Claude Opus 4.6 ถือเป็นการอัปเกรดจาก Opus 4.5 ตามคำของ Anthropic นี่คือการยกระดับโมเดลที่ฉลาดที่สุดของตน นอกเหนือจากโมเดลแล้ว Anthropic ยังเปิดตัวทีมเอเจนต์ใน Claude Code และ Claude in PowerPoint อีกด้วย
ในบทความนี้ จะครอบคลุมทุกอย่างที่ใหม่ใน Claude Opus 4.6 ดูฟีเจอร์ใหม่ สำรวจเกณฑ์ชี้วัด และทดสอบด้วยตัวอย่างแบบลงมือทำหลายแบบ
หากต้องการเรียนรู้ฟีเจอร์ใหม่ ๆ ของ Claude แนะนำให้อ่านคู่มือเกี่ยวกับ Claude Cowork และ Claude Code รวมถึงบทเรียน OpenClawของเรา สำหรับการเปรียบเทียบกับคู่แข่ง อ่านคู่มือ Muse Spark เทียบกับ Claude Opus 4.6 และ GPT-5.4 เทียบกับ Claude Opus 4.6.
Claude Opus 4.6 เป็นโมเดลภาษาขนาดใหญ่รุ่นล่าสุดจาก Anthropic ต่อเนื่องจากOpus 4.5 โดยเป็นการอัปเกรดครั้งสำคัญของระดับโมเดลที่ว่า “ฉลาดที่สุด” ของบริษัท
จากบล็อกประกาศรุ่น Anthropic ระบุว่าให้ความสำคัญมากขึ้นกับการโค้ดแบบเอเจนต์ การให้เหตุผลเชิงลึก และการแก้ไขตนเอง หมายความว่ามีการขยับจากการลงมือทำแบบครั้งเดียวไปสู่การลงมือทำแบบต่อเนื่อง.
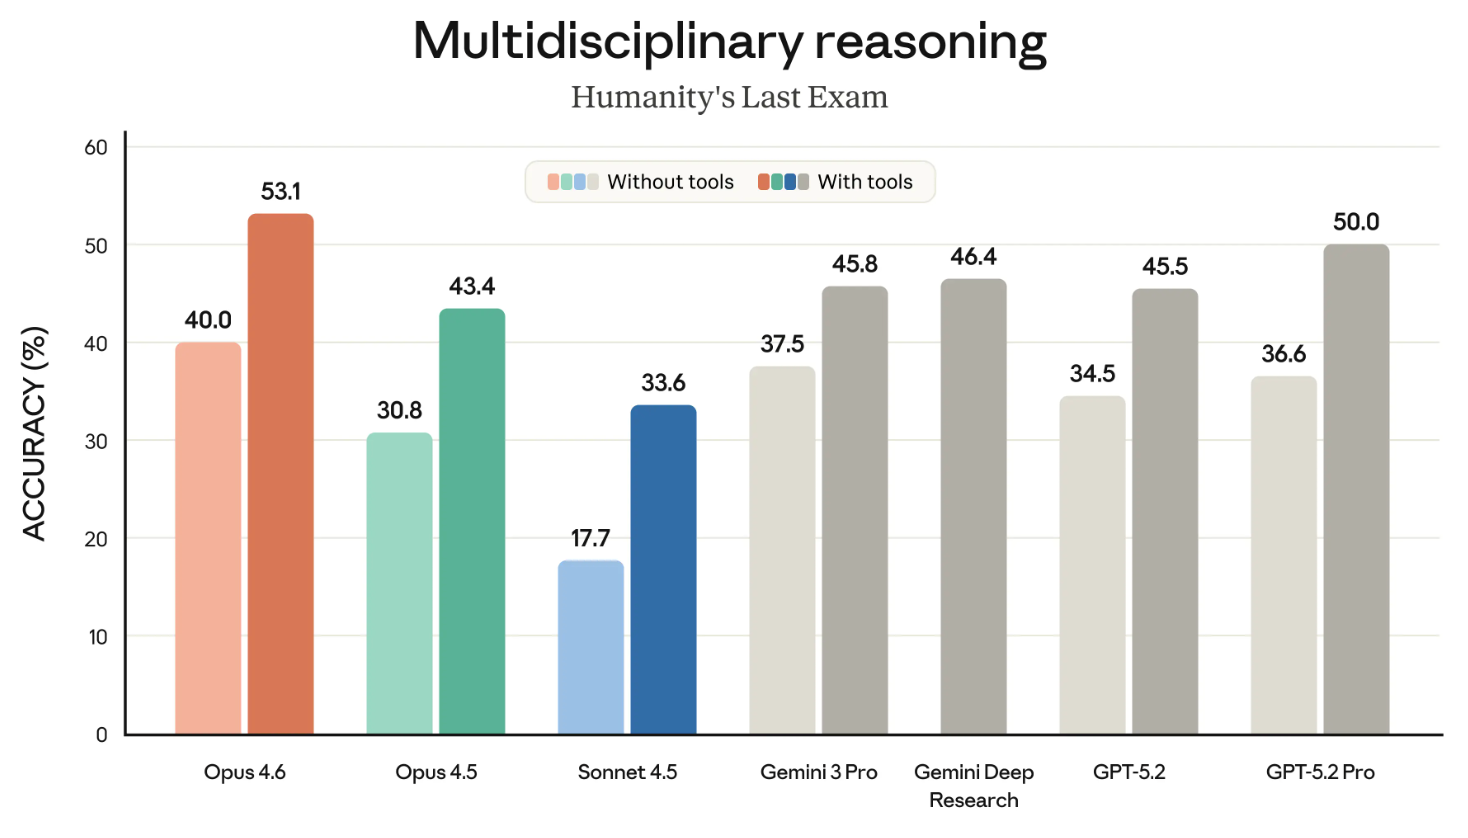
Opus 4.6 ถูกออกแบบให้วางแผนอย่างรอบคอบขึ้น มีความสอดคล้องต่อเนื่องในช่วงเวลาที่ยาวนานขึ้น และตรวจจับข้อผิดพลาดในกระบวนการของตนเอง ทั้งหมดนี้ทำให้ Claude Opus 4.6 ทำคะแนนนำในหลายเกณฑ์ชี้วัด รวมถึงคะแนนสูงสุดในการประเมินการโค้ด Terminal-Bench 2.0 และชนะโมเดลแนวหน้าทั้งหมดในHumanity’s Last Exam.
หนึ่งในจุดที่โดดเด่นที่สุดคือหน้าต่างบริบทที่ดีขึ้นของ Claude Opus 4.6 กับ 1 ล้านโทเค็นในช่วงเบตา ทำให้โมเดลใหม่นี้อยู่ในระดับเดียวกับ Gemini 3 หมายความว่าสามารถประมวลผลข้อมูลได้มากขึ้นโดยไม่หลุดบริบท
ในระหว่างนี้ Anthropic ได้เผยแพร่รุ่นถัดไปของ Opus แล้ว แนะนำให้อ่านคู่มือ Claude Opus 4.7 เพื่ออัปเดตความเคลื่อนไหว
มีฟีเจอร์ใหม่ที่น่าสนใจหลายอย่างใน Claude Opus 4.6 โดยจำนวนมากมุ่งไปที่เวิร์กโฟลว์แบบเอเจนต์ มาดูประเด็นสำคัญกัน:
ทีมเอเจนต์เป็นการพัฒนาต่อยอดจาก ‘ซับเอเจนต์’ ที่เห็นในรุ่นก่อน ทีมเอเจนต์ช่วยให้เปิดอินสแตนซ์ของ Claude หลายอินสแตนซ์ที่อิสระเต็มรูปแบบและทำงานขนานกันได้ ในหนึ่งเซสชันจะมีเอเจนต์ ‘หลัก’ คอยประสานงาน ขณะที่ ‘เพื่อนร่วมทีม’ จัดการการลงมือทำจริง
ที่น่าสนใจคือสมาชิกทีมแต่ละคนมีหน้าต่างบริบทของตนเอง ทำให้ทำงานได้ละเอียดขึ้น และเพื่อนร่วมทีมแต่ละคนยังสื่อสารกันโดยตรงภายในทีมได้ด้วย
แน่นอน ฟีเจอร์นี้มีข้อเสียที่อาจเกิดขึ้นได้คือค่าใช้จ่าย เนื่องจากแต่ละเอเจนต์มีหน้าต่างบริบทของตนเอง โทเค็นอาจถูกใช้หมดอย่างรวดเร็ว ดังนั้น Anthropic จึงแนะนำให้ใช้ในสถานการณ์ที่มีความซับซ้อนสูง
ฟีเจอร์เด่นอย่างหนึ่งของ Claude Opus 4.6 คือการย่อบริบท การปรับปรุงด้านความสะดวกนี้ช่วยเลี่ยงปัญหาเวลาเรียกใช้เวิร์กโฟลว์ยาว ๆ จนหน้าต่างบริบทเต็ม ปกติแล้วประสิทธิภาพจะเริ่มลดลงเมื่อชนกำแพงบริบท
ด้วยการย่อบทสนทนา Claude Opus 4.6 สามารถตรวจจับอัตโนมัติเมื่อบทสนทนาเข้าใกล้เกณฑ์โทเค็น และสรุปบทสนทนาที่มีอยู่ให้เป็นบล็อกย่อแบบกระชับ (compaction block)
ฟีเจอร์นี้ควรช่วยคงสาระสำคัญของปฏิสัมพันธ์ไว้ ขณะเดียวกันก็เพิ่มพื้นที่ให้ทำงานต่อได้ หากวางแผนใช้เอเจนต์ที่มุ่งทำภารกิจซึ่งต้องรันยาวนาน สิ่งนี้อาจช่วยให้ทำงานได้ต่อเนื่องด้วยความจำที่ดีขึ้นมาก
Claude Opus 4.6 มีสองฟีเจอร์ที่กำหนดว่าจำเป็นต้องใช้การคิดแบบขยายหรือไม่ และจะพยายามมากน้อยเพียงใดกับการคิดนั้น
การคิดแบบปรับตัวช่วยให้โมเดลประเมินความซับซ้อนของพรอมป์ต โดยอิงตามระดับความง่ายหรือยาก จะตัดสินใจว่าจะใช้การคิดแบบขยายหรือไม่ แทนที่จะตั้งค่ามือว่าต้องใช้กี่โทเค็น Claude จะปรับงบโทเค็นตามความซับซ้อนของแต่ละคำขอ
พารามิเตอร์ความพยายามช่วยตั้งค่าว่า Claude จะขยันหรือระมัดระวังในการใช้โทเค็นเพียงใด โดยสาระคือสามารถชั่งน้ำหนักระหว่างประสิทธิภาพการใช้โทเค็นกับความละเอียดรอบคอบของคำตอบได้
เมื่อใช้ Claude Opus 4.6 ผ่าน API สามารถตั้งค่าพารามิเตอร์เหล่านี้ได้เอง ตัวอย่างเช่น:
ก่อนหน้านี้เราได้กล่าวถึงClaude in Excel ซึ่งแสดงให้เห็นว่าแอดออนนี้ช่วยงานต่าง ๆ ในแถบด้านข้างของสเปรดชีต Excel ได้อย่างไร นอกจากการเพิ่มความสามารถของเครื่องมือนี้แล้ว Anthropic ยังประกาศ Claude in PowerPoint อีกด้วย
การเชื่อมต่อใช้งานนี้เคารพแม่แบบสไลด์ ฟอนต์ และเลย์เอาต์ของคุณ สามารถป้อนแม่แบบองค์กรแล้วให้สร้างส่วนที่ต้องการ หรือเลือกสไลด์แล้วให้แปลงข้อความหนาแน่นเป็นไดอะแกรมแบบเนทีฟที่แก้ไขได้
การเน้นสร้างออบเจ็กต์ PowerPoint ที่แก้ไขได้แทนที่จะเป็นเพียง “รูปภาพของสไลด์” ทำให้สิ่งนี้เป็นเครื่องมือเพิ่มประสิทธิภาพจริง ไม่ใช่แค่ตัวช่วยระดมแนวคิด
ขณะนี้ Claude in PowerPoint อยู่ในช่วงทดลองวิจัยสำหรับผู้ใช้ Max และ Enterprise
หลายคำกล่าวอ้างหลักของ Opus 4.6 มุ่งไปที่งานโค้ดที่ยากขึ้นและการให้เหตุผลเชิงลึก ทักษะเหล่านี้ตั้งอยู่บนพื้นฐานสำคัญบางอย่าง: ความสามารถในการถือข้อจำกัดหลายข้อพร้อมกัน ให้เหตุผลข้ามหลายขั้นตอน และจับความผิดพลาดได้
ด้วยเหตุนี้ เราจึงทดสอบ Opus 4.6 ด้วยลอจิกหลายขั้นตอน เลข และความท้าทายด้านโค้ด เราต้องการดูว่าสามารถเผยจุดอ่อนที่ทราบกันดีของ LLM ได้หรือไม่ เช่น ข้อผิดพลาดแบบลูกโซ่ในการคำนวณ การให้เหตุผลเชิงพื้นที่ (ที่มักเป็นปัญหา) และคำถามที่มีข้อจำกัด นอกจากนี้ เรายังใส่ภารกิจดีบักเฉพาะทางหนึ่งข้อเพราะประกาศของ Anthropic โอ้อวดว่า Opus 4.6 เก่งเรื่องการวิเคราะห์สาเหตุรากและปัญหาดีบักอื่น ๆ
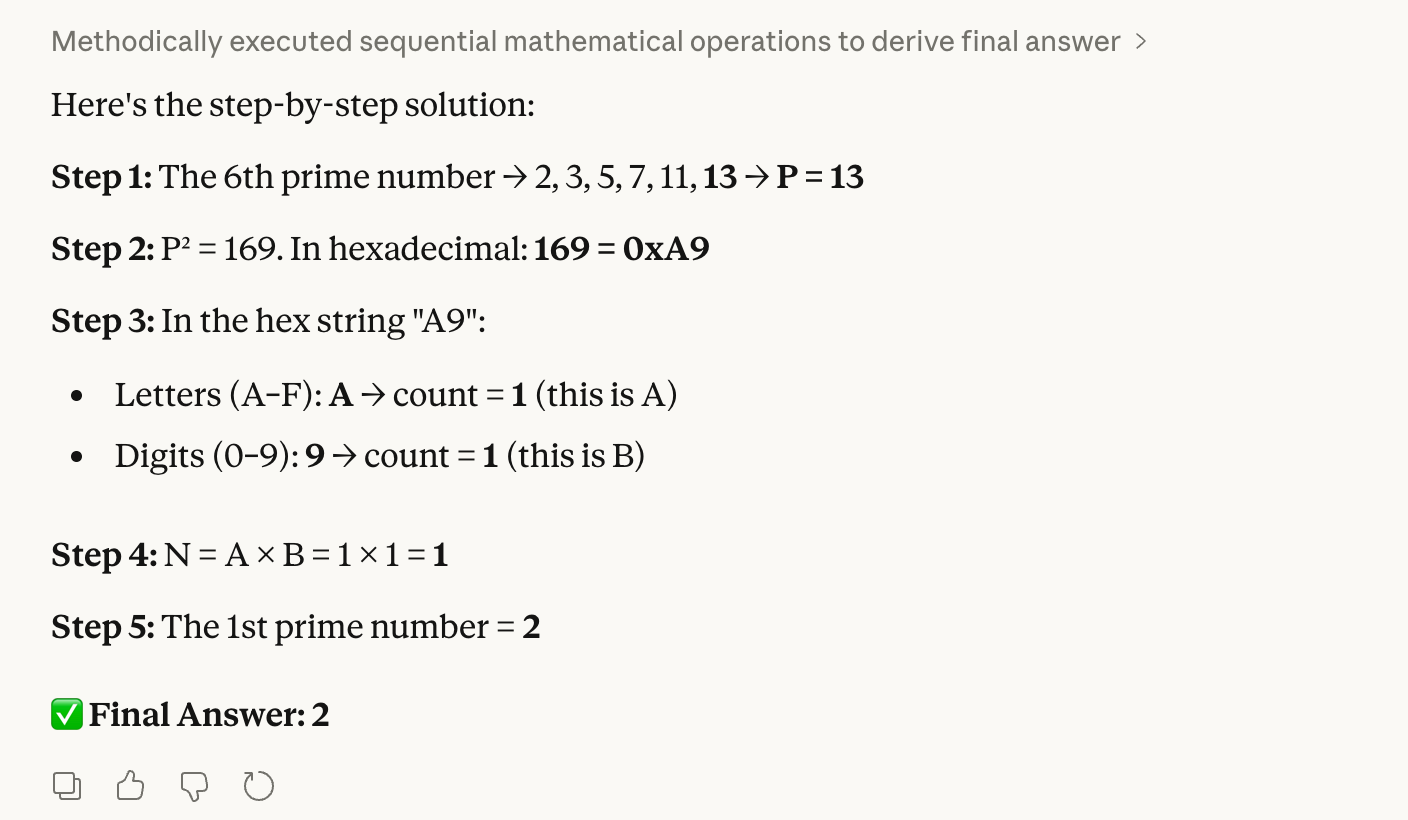
การทดสอบแรกผสมนจำนวนเฉพาะ ฐานสิบหก และการนับ:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
ฟังดูซับซ้อนเล็กน้อย แต่การทดสอบนี้มนุษย์ตรวจสอบได้ค่อนข้างง่าย คำตอบที่ถูกต้องคือ 2 เพราะจำนวนเฉพาะลำดับที่ 6 คือ 13; 13 กำลังสองเท่ากับ 169 ซึ่งเป็น "A9" ในฐานสิบหก ซึ่งมี 1 ตัวอักษร × 1 ตัวเลข เท่ากับ 1 เมื่อคูณกัน และจำนวนเฉพาะลำดับที่ 1 คือ 2
ความกังวลคือโมเดลอาจสะดุดที่การแปลงฐานสิบหก ซึ่งจะส่งผลให้คำตอบสุดท้ายผิดเพี้ยนไปทั้งหมด อย่างที่เห็น Opus 4.6 จัดการได้สบาย:
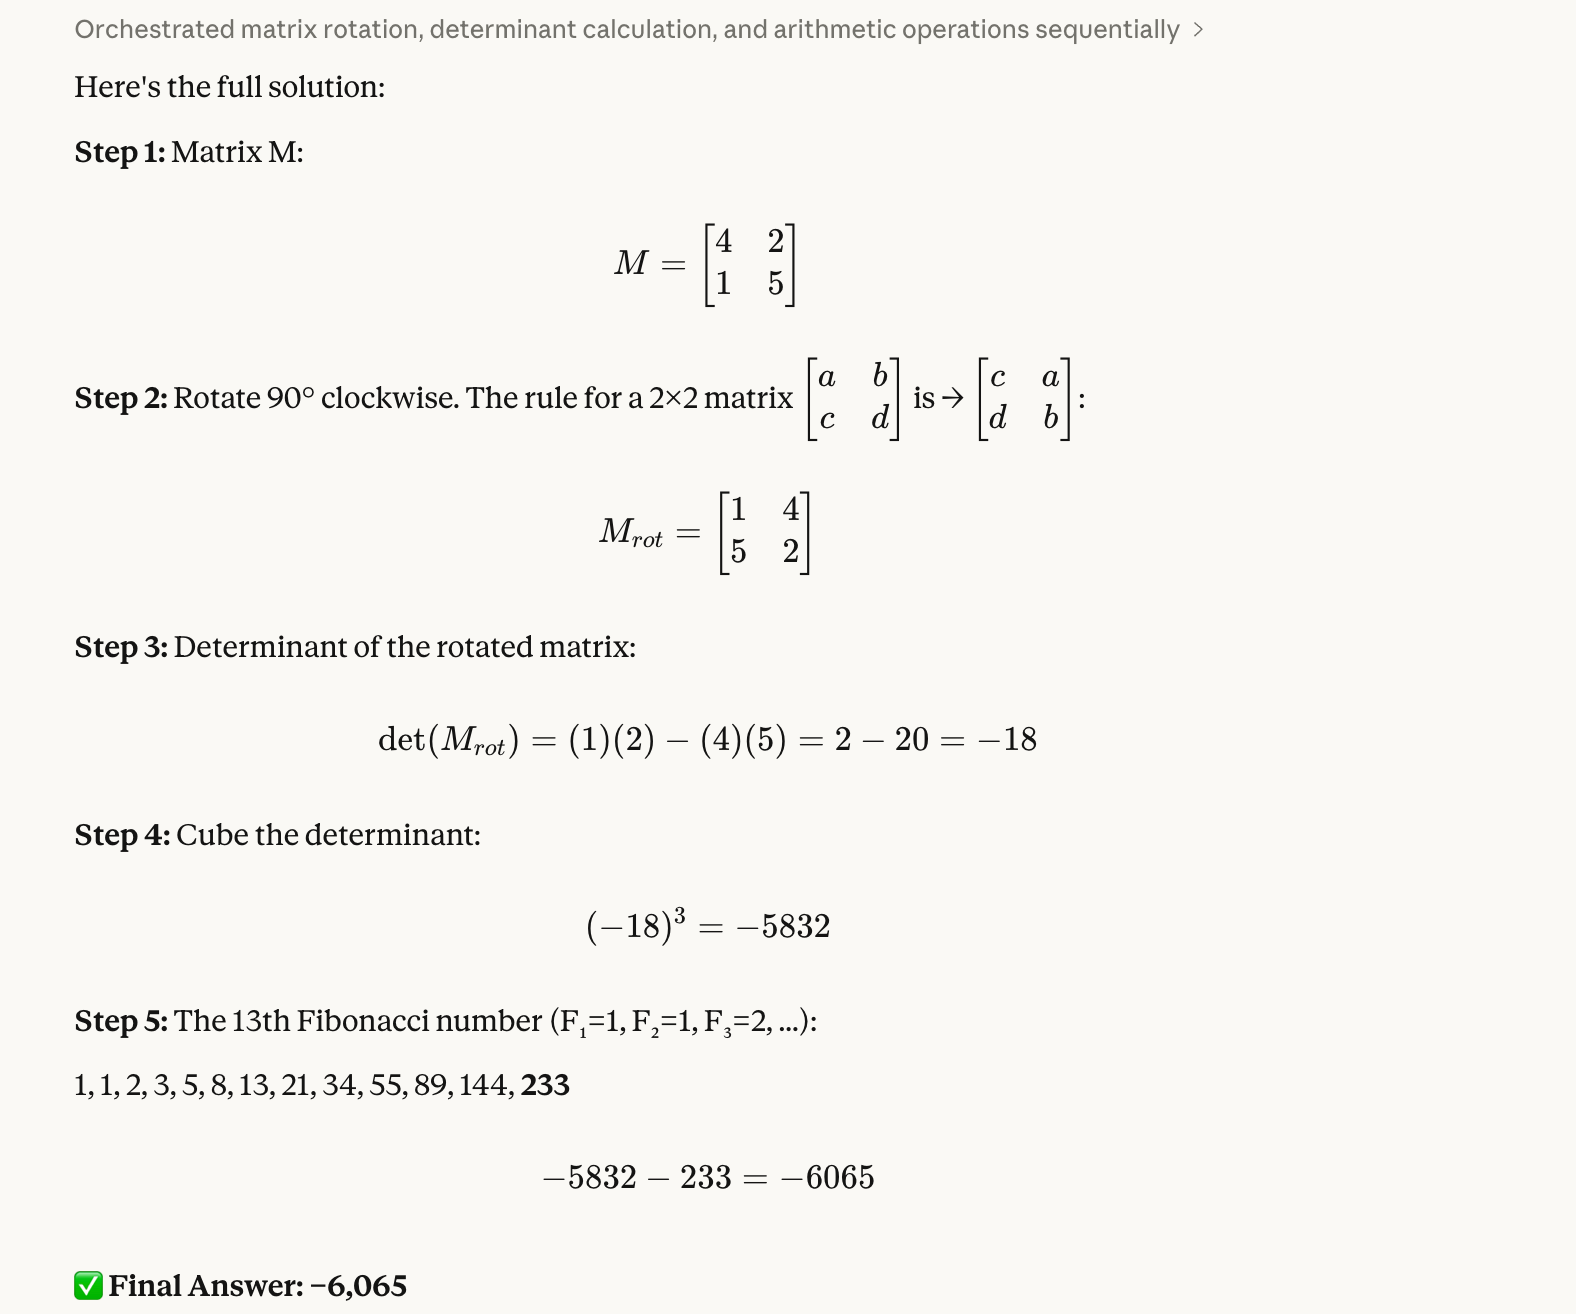
การทดสอบที่สองเป็นการทดสอบการให้เหตุผลเชิงพื้นที่และการจัดการจำนวนลบ:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
ข้อสอบนี้ต้องตรวจสอบมากขึ้นเล็กน้อย คำตอบที่ถูกต้องคือ -6,065 เรารู้เพราะเมทริกซ์หลังหมุนคือ [[1, 4], [5, 2]] แล้วใช้ Python หาดีเทอร์มิแนนต์ได้ -18 เมื่อลูกบาศก์ค่าดังกล่าวจะได้ -5,832 จากนั้นลบ 233 ได้ -6,065
เราชอบการทดสอบนี้เพราะจากประสบการณ์ โมเดลมักสลับสมาชิกเมทริกซ์ผิด หรือทำเครื่องหมายลบหายไปกลางทาง อีกครั้ง Opus 4.6 ก็ไม่มีปัญหา:
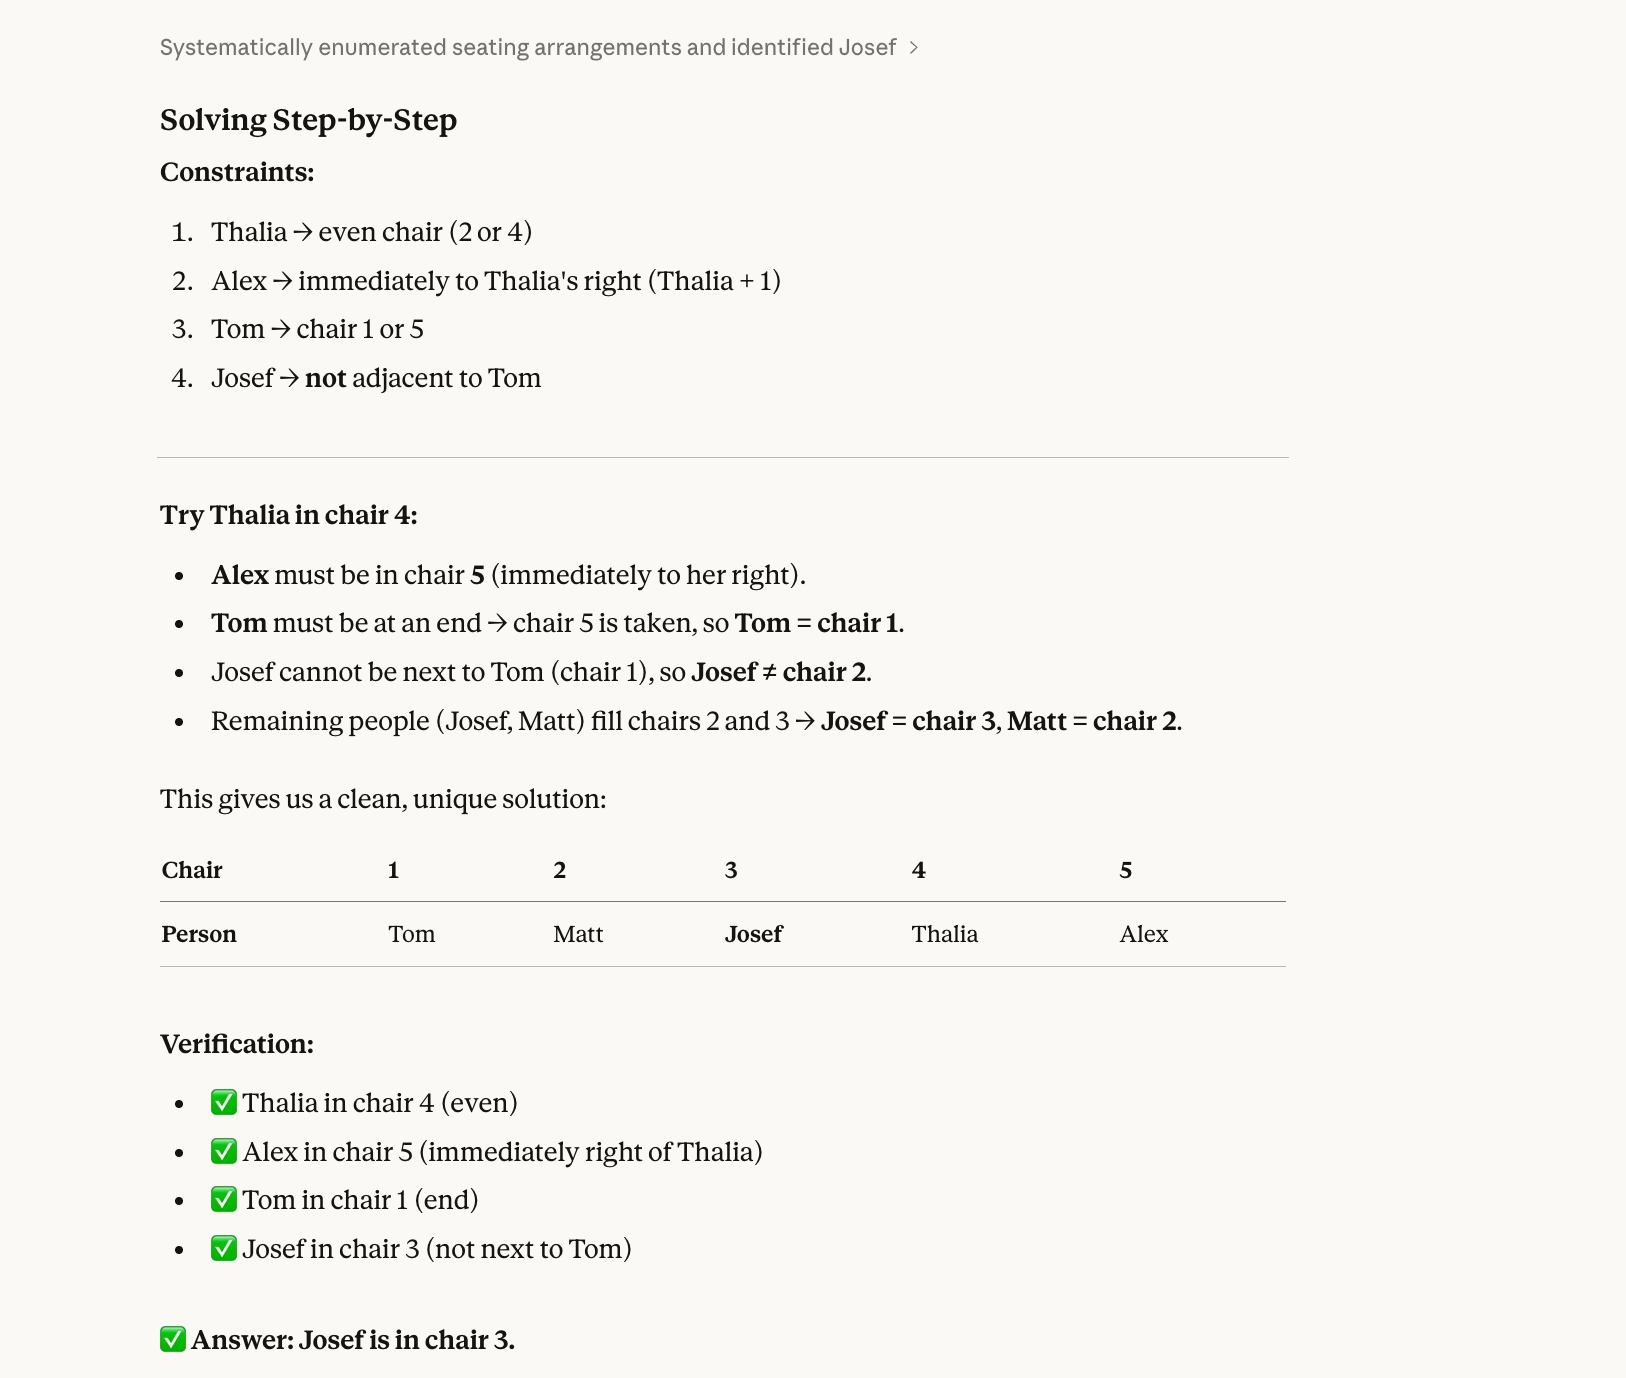
การทดสอบที่สามเป็นปัญหาความพึงพอใจต่อข้อจำกัดที่ต้องอาศัยการย้อนรอย:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
คำตอบที่ถูกต้องคือ Josef (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5) สามารถแก้บนกระดาษด้วยความพยายามเล็กน้อย
เหตุผลพื้นฐานที่โมเดลอาจผิดในคำถามลักษณะนี้ เพราะในอดีตมักแก้เป็นลำดับ ไม่ใช่แบบองค์รวม พออ่านว่า “Thalia นั่งเก้าอี้เลขคู่” ก็เลือกสักตัว (เช่น เลข 2) โดยไม่ตรวจว่าทางเลือกนั้นสอดคล้องกับข้อจำกัดอื่น ๆ ทั้งหมดหรือไม่ จากนั้นก็ตอกย้ำ เติมคนลงไปเรื่อย ๆ จนเจอความขัดแย้ง แต่ครั้นจะย้อนกลับไปลองให้ Thalia นั่งเลข 4 แทนก็ไม่ทำ
Opus 4.6 ตอบข้อนี้ถูกเช่นกัน:
การทดสอบที่สี่ประเมินการมองภาพเชิงพื้นที่และสัญชาตญาณทางกายภาพ:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
เพื่อยืนยันข้อนี้ แทบต้องถอดนาฬิกาข้อมือออกมาแล้วหมุนจริง ๆ
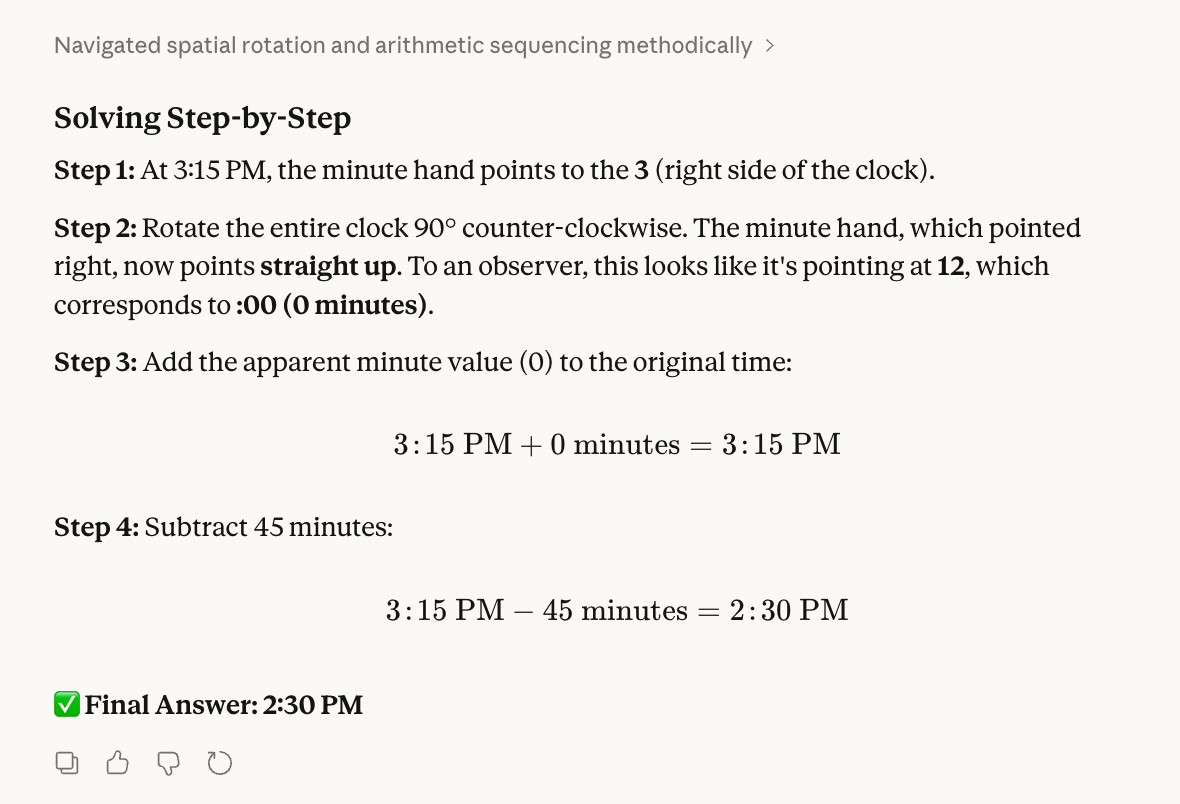
คำตอบที่ถูกต้องคือ 14:30 น. ที่เวลา 3:15 เข็มนาทีชี้ที่ "3" เมื่อหันเลข 12 ไปทางหน้าต่างด้านซ้าย เลข "3" จะย้ายไปตำแหน่งของ "12" จากนั้นบวก 0 กับเวลา 3:15 ลบ 45 นาที ได้ 14:30 น.
ตอนออกแบบข้อสอบ เราคาดว่าโมเดลอาจสับสนระหว่างการหมุนหน้าปัดกับการขยับเข็ม และได้ยินมาว่าโมเดลมักมองการบวก 0 ว่าน่าสงสัย จึงพยายามยัดค่าตัวเลขอื่น
อย่างไรก็ตาม Opus 4.6 แก้ปัญหานี้ได้ และได้คำตอบที่ถูกต้องเช่นกัน:
การทดสอบที่ห้าผสมเลขโมดูลาร์กับการคัดกรองจำนวนเฉพาะ:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
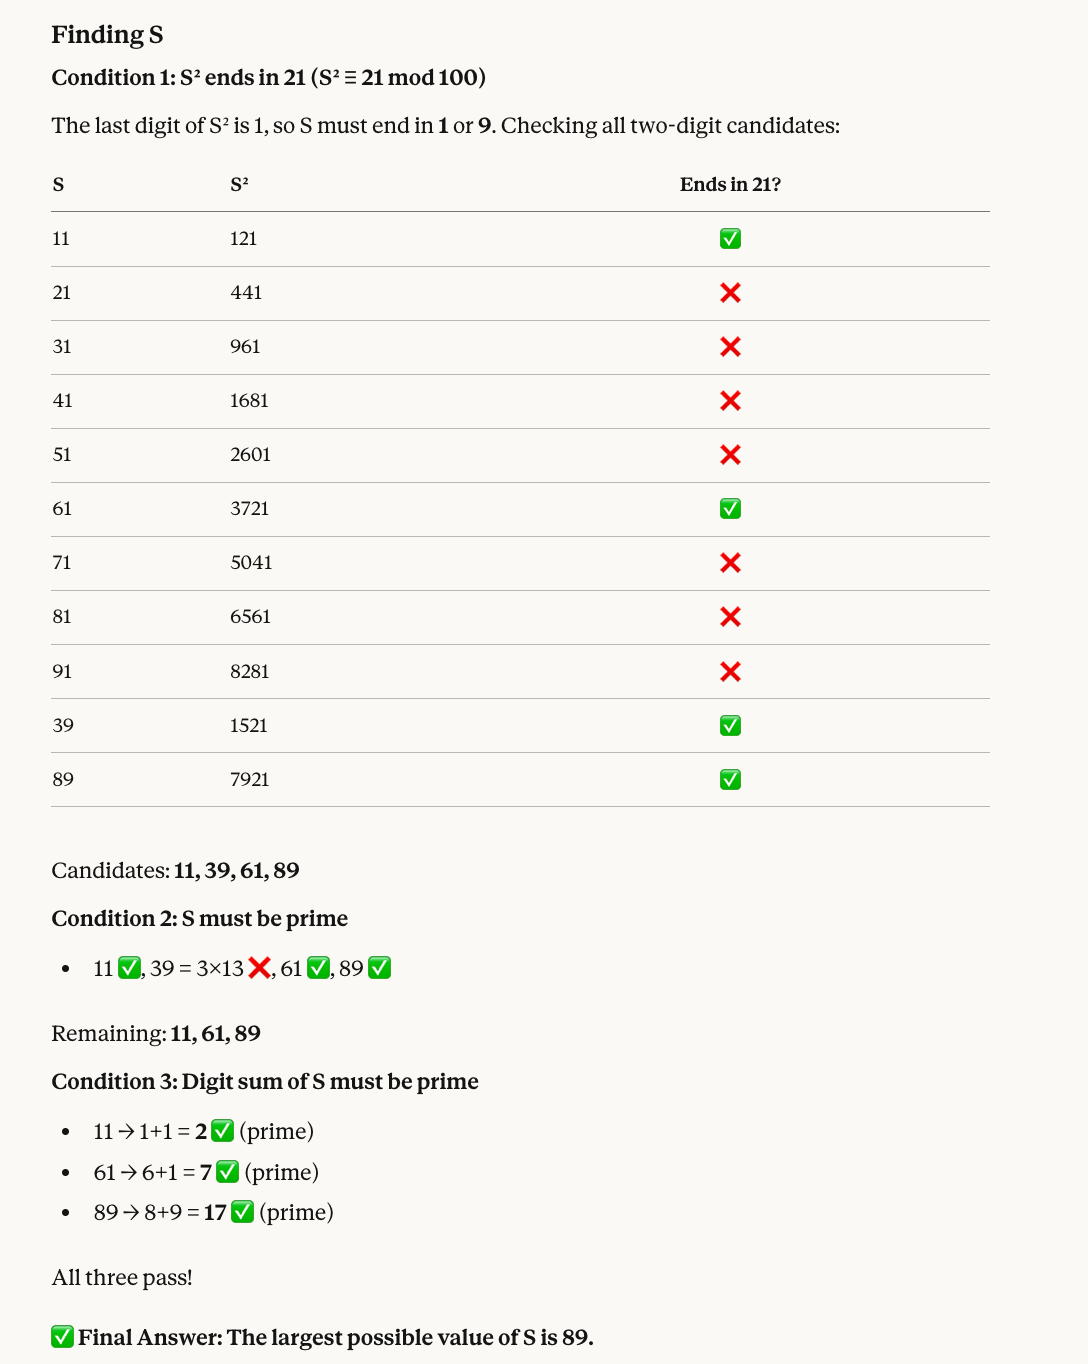
เหตุผลที่คำตอบคือ 89: ตัวเลขที่ยกกำลังสองแล้วลงท้ายด้วย 21 ได้แก่ 11, 39, 61 และ 89 ในจำนวนนั้น 39 ไม่ใช่จำนวนเฉพาะ จึงเหลือ 11, 61 และ 89 ทั้งสามมีผลรวมหลักเป็นจำนวนเฉพาะ (2, 7 และ 17 ตามลำดับ) ดังนั้นค่ามากที่สุดคือ 89
Opus 4.6 ตอบถูกอีกครั้ง และครั้งนี้ยังแนบภาพช่วยอธิบายด้วย:
การทดสอบถัดไปเชื่อมโยงแฟกทอเรียล การจัดการสตริง และจำนวนเฉพาะเข้าด้วยกัน:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
วิธีตรวจสอบคำตอบที่ถูกต้อง 425: 5! = 120; ลบ 1 ได้ 119; กลับลำดับหลักได้ 911 จากนั้นด้วยโค้ด R (ด้านล่าง) พบว่ามีจำนวนเฉพาะ 152 ค่าในช่วง 10 ถึง 911 และผลรวมเป็น 64,598 สุดท้ายหารและปัดเศษ: 64,598 ÷ 152 ≈ 425
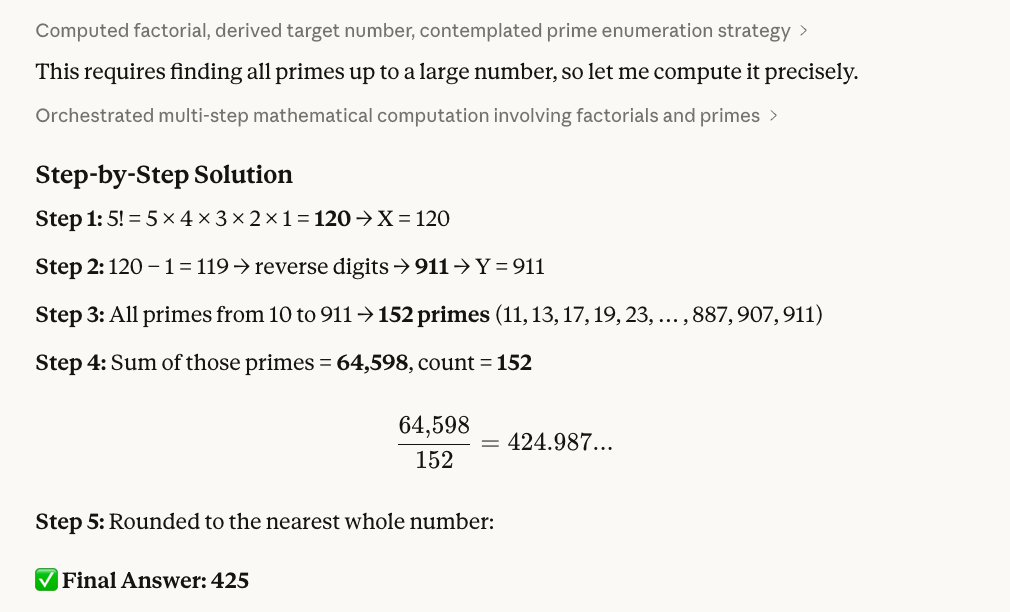
นี่คือสคริปต์ R ที่ใช้:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")การทดสอบถัดไปเล็งไปที่หนึ่งในคำกล่าวอ้างใหญ่ของ Opus 4.6: การวินิจฉัยบั๊กในโค้ด ทราบกันว่าโมเดลมักไล่โค้ดทีละบรรทัดได้ถูกต้อง แต่ไม่เชื่อมโยงผลการไล่กลับไปยังจุดบกพร่องพื้นฐาน
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
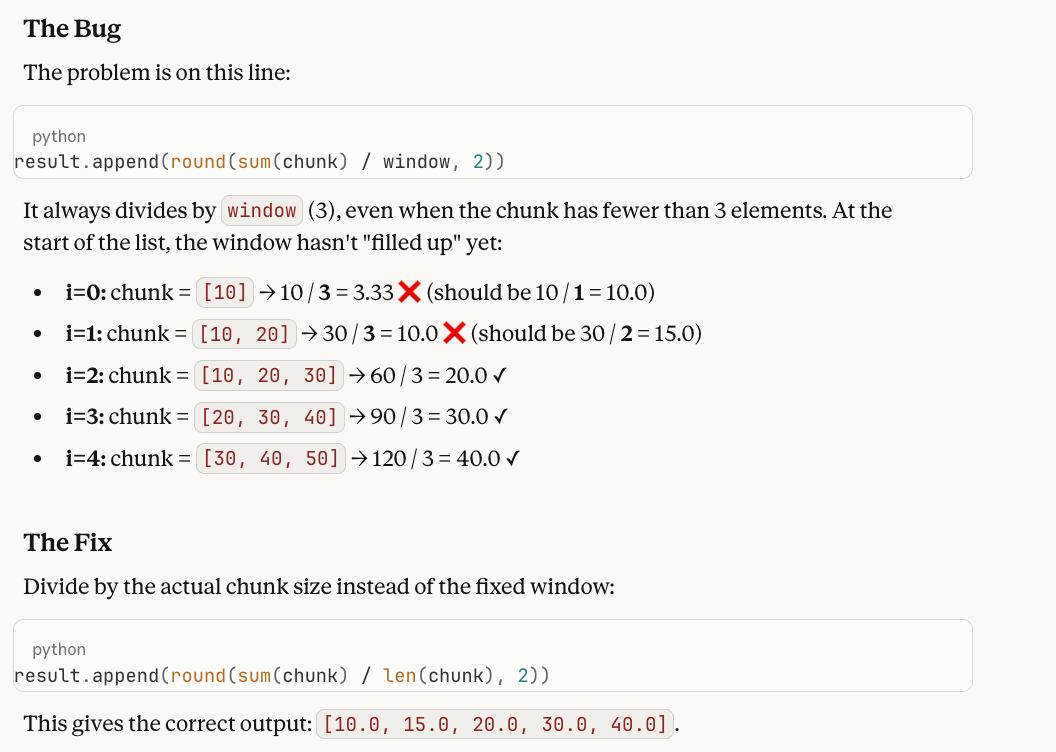
คำตอบและเหตุผลที่ใช้เป็นบททดสอบ: ฟังก์ชันนี้หารด้วย window (3) ตลอด แม้ว่า chunk ช่วงต้นลิสต์จะมีน้อยกว่า 3 อีลิเมนต์ เอาต์พุตที่ผิดคือ [3.33, 10.0, 20.0, 30.0, 40.0] แต่สองค่าต้นควรเป็น 10.0 และ 15.0 เพราะ chunk มีเพียง 1 และ 2 อีลิเมนต์ตามลำดับ วิธีแก้คือเปลี่ยนจาก / window เป็น / len(chunk).
เราชอบการทดสอบนี้เพราะโมเดลมักไล่วงรอบได้เป๊ะ แต่กลับรายงานว่า “เอาต์พุตดูถูกต้อง” — เห็นคณิตศาสตร์เกิดขึ้นทีละขั้นและไม่ตั้งธงว่าการหารสมาชิกตัวเดียวด้วย 3 นั้นผิด ต้องอาศัยการถือเจตนา (สิ่งที่ running average ควรทำ) ควบคู่กับการปฏิบัติ (สิ่งที่โค้ดทำจริง) และมองเห็นช่องว่างระหว่างกัน
การทดสอบสุดท้ายไม่มีคณิตศาสตร์ มีเพียงการให้เหตุผลแบบสวนทางความจริงเท่านั้น
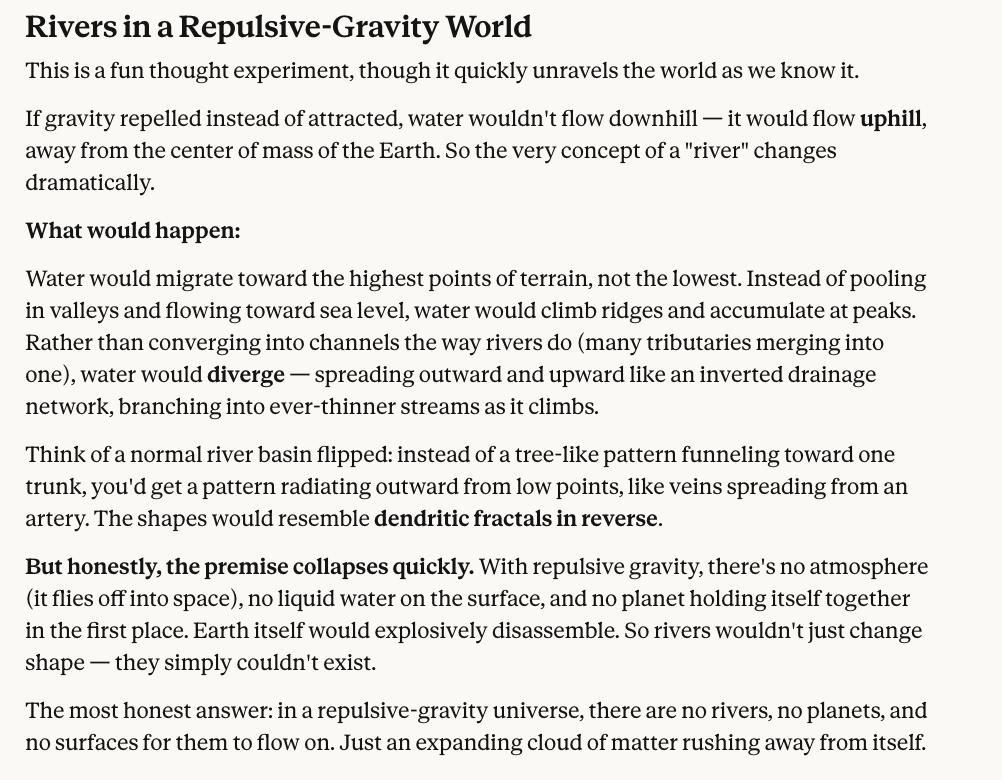
In a world where gravity repels objects instead of attracting them, what shape would rivers take?แน่นอนว่าไม่มีคำตอบเดียวที่ถูกต้อง และยากจะจินตนาการ แต่เรามองหาอย่างน้อยให้โมเดลไล่ตรรกะจากข้อสมมติ และคิดว่า คำตอบของ Claude Opus 4.6 สมเหตุสมผลพอ
โดยสรุป Opus 4.6 ทำคะแนนเต็ม แม้จะมีหนึ่งคำถามที่คำตอบออกจะอิงความเห็นส่วนตัวเล็กน้อย ดังนั้นปล่อยให้ผู้อ่านตัดสินเอง
Opus 4.6 เป็นผู้นำที่ไร้ข้อกังขาอย่างน้อยสี่เกณฑ์ชี้วัดสำคัญ:
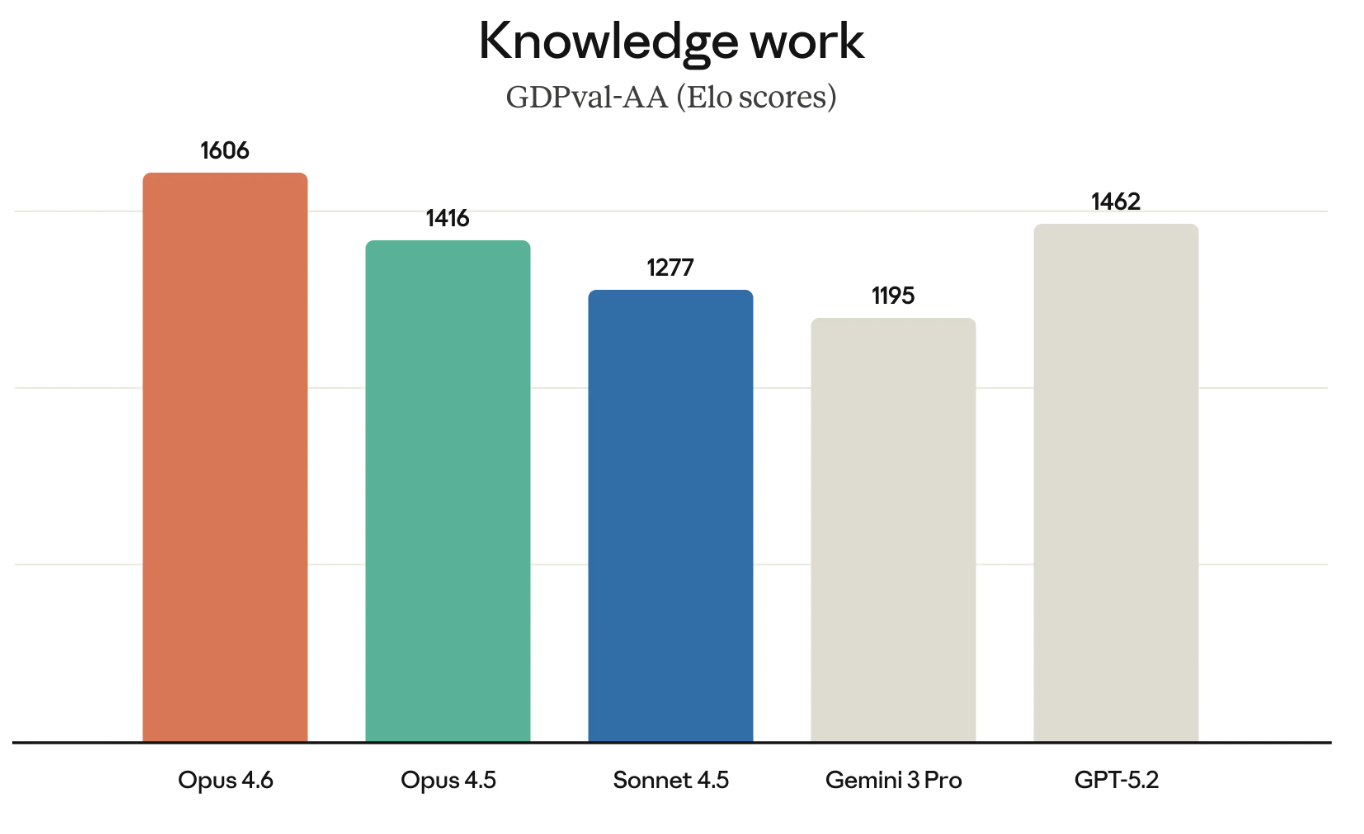
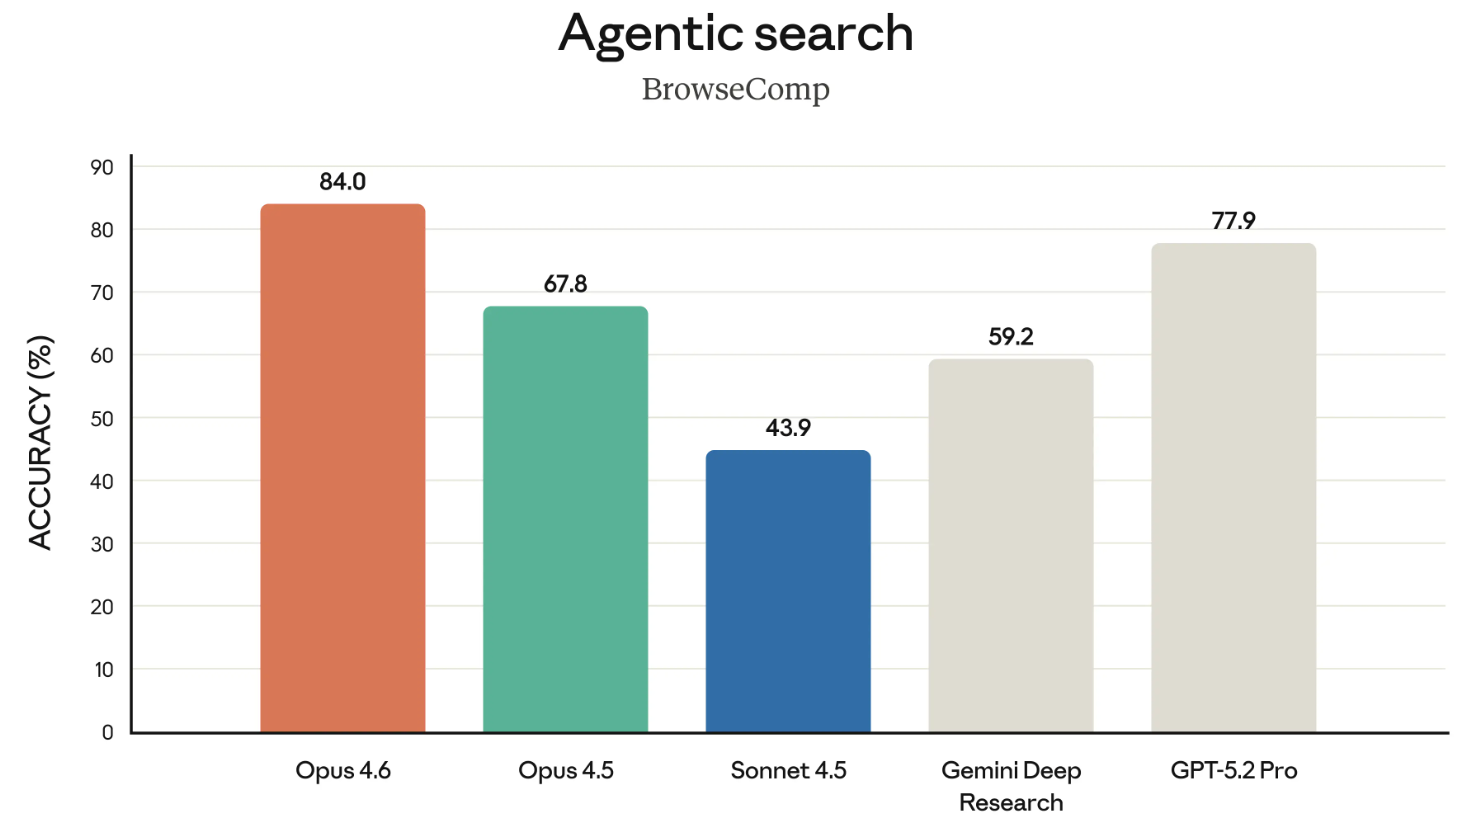
Terminal-Bench 2.0 เป็นเกณฑ์ชี้วัดการโค้ดแบบเอเจนต์ Humanity’s Last Exam วัดการให้เหตุผลเชิงซับซ้อน GDPval-AA ทดสอบผลงานงานความรู้เชิงเศรษฐกิจ BrowseComp วัดความสามารถของโมเดลในการค้นหาข้อมูลที่หาได้ยากบนออนไลน์
ตระกูล Claude มีชื่อเสียงสมควรในฐานะหนึ่งในโมเดลที่โค้ดได้ดีเยี่ยม เริ่มจากดูผลของเกณฑ์ชี้วัด Terminal-Bench 2.0 กันก่อน
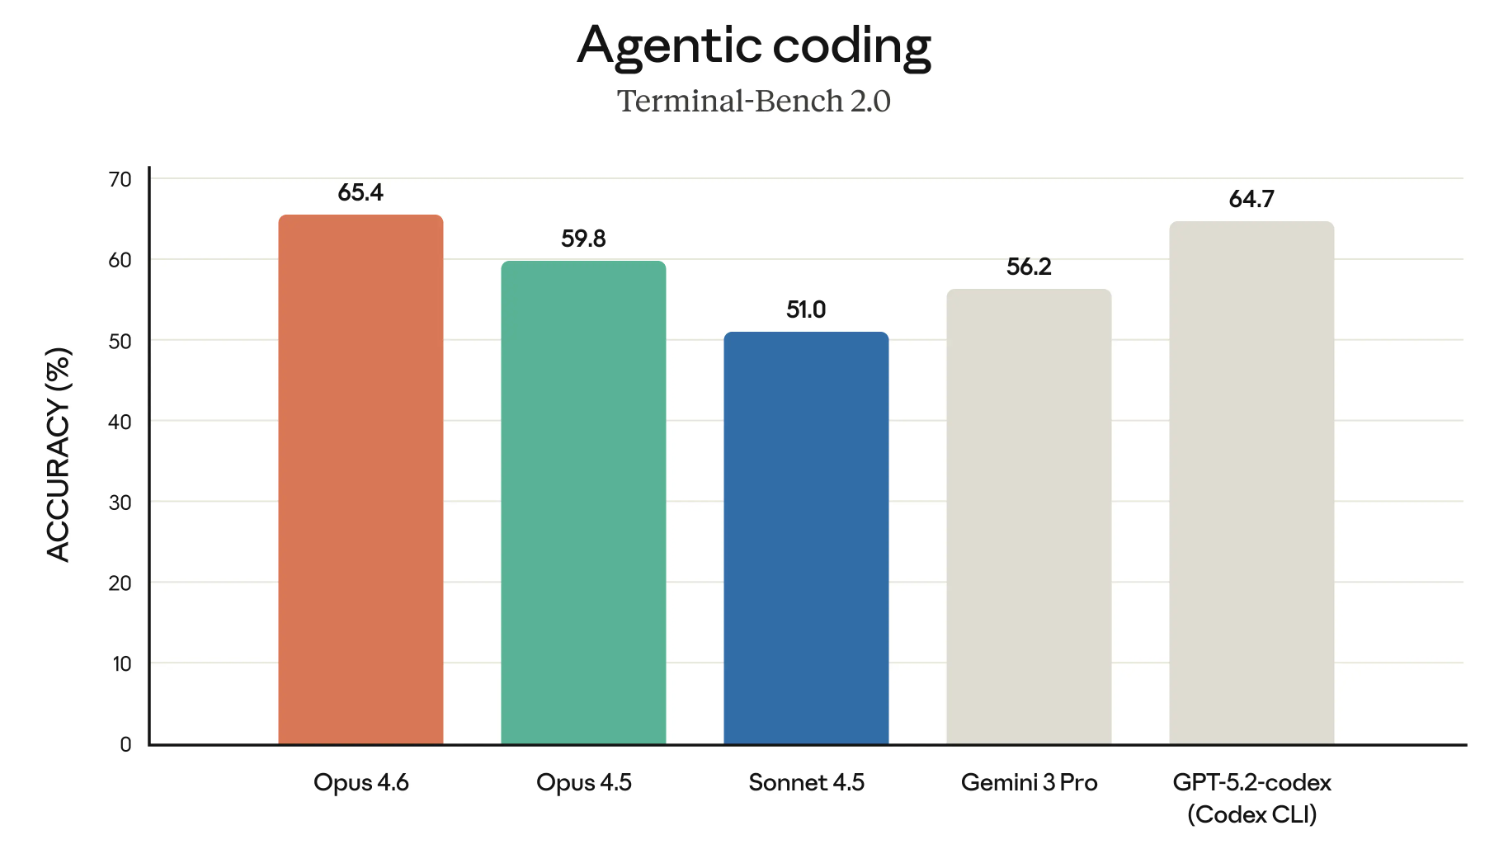
หากกราฟด้านบนเหมือนจงใจเน้น Opus 4.6 เทียบกับ GPT-5.2-codex — ก็คงใช่ Anthropic กำลังท้าทาย OpenAI โดยตรงในหลายด้านช่วงหลัง และกำลังสร้างเคสสำหรับการใช้งานระดับองค์กร
Humanity’s Last Exam เป็นหนึ่งในเกณฑ์ชี้วัดที่รู้จักกันดี และเป็นตัวที่หลายฝ่ายจับตา มันวัดความสามารถในการให้เหตุผลทั่วไปของโมเดล
กราฟต่อไปนี้แสดงความสำเร็จของโมเดลแนวหน้าต่าง ๆ บนเกณฑ์ HLE ทั้งแบบมีเครื่องมือและไม่มีเครื่องมือ (“มีเครื่องมือ” หมายถึงอนุญาตให้โมเดลใช้ความสามารถภายนอก เช่น ค้นเว็บและรันโค้ด)
กราฟนี้อาจจะดีกว่าเมื่อแยกเป็นสองกราฟ อย่างไรก็ดี ข้อสรุปชัดเจน: Opus 4.6 เป็นผู้นำทั้งหมวด “มีเครื่องมือ” และ “ไม่มีเครื่องมือ”
GDPval-AA (ตามชื่อ) เป็นการทดสอบงานความรู้ที่มีมูลค่าทางเศรษฐกิจ เช่น การรันแบบจำลองการเงินหรือทำวิจัย
GDPval-AA และเกณฑ์ชี้วัดคล้ายกันมีความสำคัญมากขึ้น เพราะวัดงานประเภทที่องค์กรยอมจ่ายจริง ความสำเร็จของ Opus 4.6 บน GDPval-AA ยังเป็นการท้าทายชุดโมเดล GPT โดยตรงอีกด้วย เพราะ OpenAI และ Anthropic แข่งขันแย่งลูกค้ากลุ่มเดียวกันจำนวนมาก
BrowseComp เป็นเกณฑ์ชี้วัดสุดท้ายที่ควรกล่าวถึงจากการปล่อยรุ่น วัดความสามารถของโมเดลในการตามหาข้อมูลที่หาได้ยากบนออนไลน์ ประวัติเล็กน้อย: ที่จริง OpenAI พัฒนา BrowseComp เพื่อโชว์ความสามารถด้านการค้นหาของโมเดลตนเอง
ที่แสบคือ ในการปล่อยรุ่นนี้ Anthropic ลิงก์ไปยังประกาศของ OpenAI เดือนเมษายน 2025 เกี่ยวกับ BrowseComp โดยตรงตอนชูว่า Opus 4.6 ทำคะแนนนำบนเกณฑ์นี้ เป็นลูกเล่นเชิงบลัฟท์เล็ก ๆ ที่อ้างอิงเกณฑ์ของ OpenAI กลับไปหาเขาเอง
Opus 4.6 เปิดให้ใช้งานอย่างกว้างขวาง ณ เวลาที่เขียนบทความ อย่างไรก็ตาม ไม่สามารถเข้าถึง Opus 4.6 ได้หากไม่อัปเกรดเป็นบัญชีโปร ซึ่งมาพร้อมสิทธิประโยชน์อื่น ๆ เช่น การใช้งาน Claude in Excel
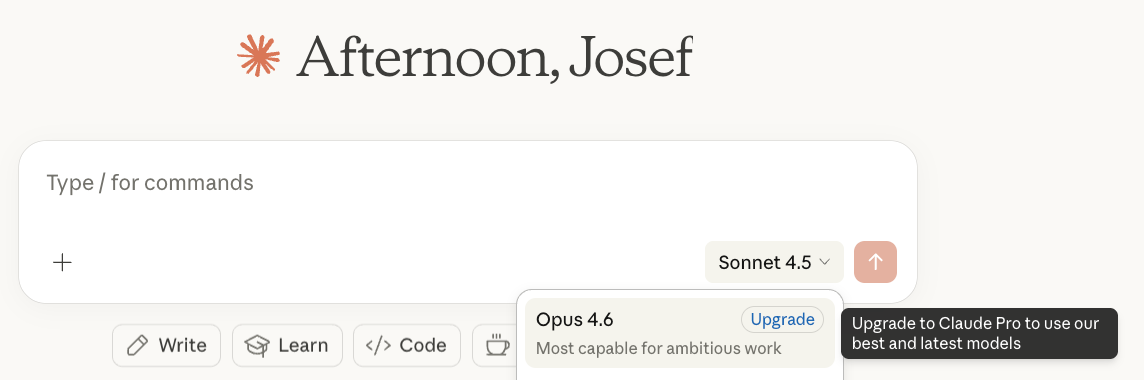
หากเป็นนักพัฒนา ควรใช้ claude-opus-4-6 ใน Claude API ราคายังไม่เปลี่ยน: ยังคง $5/$25 ต่อหนึ่งล้านโทเค็น หากงงกับตัวเลขสองตัว ตัวแรกคือค่าที่จ่ายเพื่อส่งโทเค็นเข้าโมเดล (พรอมป์ตของคุณ) และตัวที่สองคือค่าที่จ่ายสำหรับโทเค็นที่โมเดลตอบกลับ (การตอบ)
Claude Opus 4.6 นำหน้าตารางคะแนนในเกณฑ์สำคัญอย่าง GPDVal-AA ซึ่งวัดผลงานโมเดลบนงานที่สำคัญทางเศรษฐกิจ ซึ่งเป็นสิ่งที่ลูกค้าองค์กรขนาดใหญ่ให้ความสำคัญ OpenAI อาจรู้สึกสะเทือนจากพัฒนาการนี้ เพราะไม่กี่ชั่วโมงก่อนเปิดตัว Opus 4.6 พวกเขาได้ประกาศOpenAI Frontier ซึ่งเป็นแพลตฟอร์มองค์กรใหม่สำหรับสร้าง ดีพลอย และจัดการเอเจนต์ AI ในการใช้งานจริง
กล่าวอีกนัย หนึ่ง แทนจะแข่งกันที่คะแนนเกณฑ์ชี้วัด Frontier แสดงให้เห็นว่า OpenAI โฟกัสที่โครงสร้างพื้นฐานรอบชุดโมเดล โดยเฉพาะการให้เอเจนต์ AI มีบริบททางธุรกิจร่วม สิทธิ์การเข้าถึง และความสามารถในการรับและเรียนรู้จากฟีดแบ็กตามเวลา เมื่อเสียพื้นที่บนเกณฑ์ชี้วัด OpenAI กำลังกระซิบบอกว่าพลาตฟอร์มของตนเหมาะจะทำให้เอเจนต์มีประโยชน์จริงในบริษัทมากกว่า
จะมองว่านี่เป็นการปรับยุทธศาสตร์ หรือยอมรับกลาย ๆ ว่ากำลังแพ้ศึกโมเดล ก็สุดแล้วแต่การตัดสินของผู้อ่าน
โดยรวมแล้ว ประทับใจกับสิ่งที่ Anthropic นำเสนอผ่าน Claude Opus 4.6 และกำลังตั้งตารอได้ลองทีมเอเจนต์อย่างจริงจัง หากสนใจเรียนรู้เพิ่มเติมเกี่ยวกับตระกูล Claude อย่าลืมดูคอร์ส Introduction to Claude Models.
เรียนรู้ AI กับ DataCamp
Courses
Courses
Courses