course
Wprowadzenie do modeli Claude
3 godz.
14.3K
Plotki o kolejnej premierze Anthropic krążyły od kilku dni. Choć wielu spodziewało się Claude Sonnet 5, pierwsza tegoroczna premiera przychodzi w postaci Claude Opus 4.6.
Dzięki oknu kontekstu o wielkości 1 miliona tokenów, adaptacyjnemu rozumowaniu, kompresji rozmów i szeregowi czołowych wyników w benchmarkach, Claude Opus 4.6 stanowi ulepszenie względem Opus 4.5. Jak mówi Anthropic, zaktualizowali swój najinteligentniejszy model. Wraz z modelem Anthropic uruchomił także zespoły agentów w Claude Code i Claude w PowerPoint.
W tym artykule omówimy wszystko, co nowe w Claude Opus 4.6: przyjrzymy się funkcjom, zbadamy benchmarki i sprawdzimy model w praktyce na kilku przykładach.
Aby dowiedzieć się więcej o najnowszych funkcjach Claude, polecam nasze przewodniki po Claude Cowork i Claude Code, a także nasz samouczek OpenClaw. Dla porównania z innymi konkurentami przeczytaj nasze przewodniki: Muse Spark vs Claude Opus 4.6 oraz GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 to najnowszy duży model językowy od Anthropic. Nawiązując do Opus 4.5, stanowi istotne ulepszenie w „najinteligentniejszej” klasie modeli firmy.
Jak wynika z wpisu na blogu premierowym, Anthropic kładzie większy nacisk na agentowe kodowanie, głębokie rozumowanie i autokorektę. Oznacza to przesunięcie akcentu z działania na działanie długotrwałe.
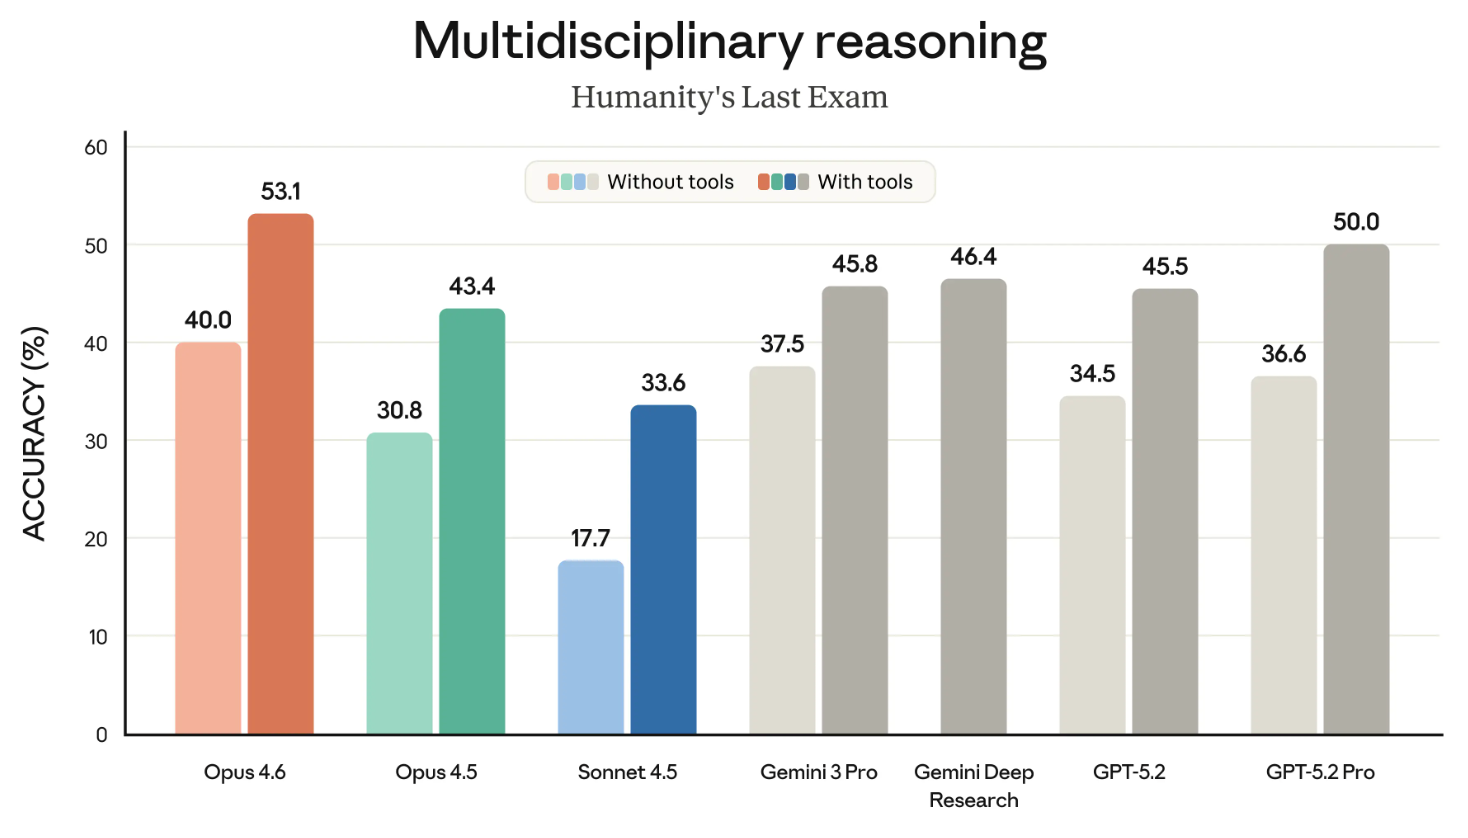
Opus 4.6 jest zaprojektowany tak, by planować uważniej, zachowywać spójność na dłuższych odcinkach i identyfikować błędy we własnym działaniu. Wszystko to sprawia, że Claude Opus 4.6 zajmuje pierwsze miejsca w kilku benchmarkach, w tym uzyskuje najwyższy wynik w ocenie kodowania Terminal-Bench 2.0 i pokonuje inne modele czołówki w Humanity’s Last Exam.
Jedną z rzeczy, które najbardziej rzucają mi się w oczy, jest ulepszone okno kontekstu w Claude Opus 4.6. Wersja beta z 1 milionem tokenów stawia nowy model w jednym rzędzie z Gemini 3, co oznacza, że może przetwarzać więcej informacji bez gubienia kontekstu.
Tymczasem Anthropic opublikował już następcę Opus. Polecam lekturę naszego przewodnika Claude Opus 4.7, żeby być na bieżąco.
W Claude Opus 4.6 pojawiło się kilka istotnych nowości, z których wiele koncentruje się na agentowych przepływach pracy. Oto kluczowe punkty:
Zespoły agentów to rozwinięcie „subagentów” znanych z wcześniejszych wersji Claude. Pozwalają uruchomić wiele w pełni niezależnych instancji Claude, które mogą pracować równolegle. Jedna sesja to agent „prowadzący”, który koordynuje działania, a „współpracownicy” zajmują się wykonaniem.
Co najciekawsze, każdy członek zespołu ma własne okno kontekstu, co umożliwia dokładniejsze działanie. Każdy współpracownik może też komunikować się bezpośrednio z innymi w zespole.
Oczywiście ta funkcja ma potencjalną wadę – koszt. Ponieważ każdy agent ma własne okno kontekstu, szybko możesz zacząć przepalać tokeny. Dlatego Anthropic zaleca używać zespołów w scenariuszach o wyższej złożoności.
Jedną z fajnych funkcji Claude Opus 4.6 jest kompakcja kontekstu. To udogodnienie pomaga uniknąć problemów przy długich przepływach pracy, które wyczerpują okna kontekstu. Zwykle uderza się w ścianę kontekstu, po czym wydajność zaczyna spadać.
Dzięki kompakcji rozmowy Claude Opus 4.6 potrafi automatycznie wykryć, kiedy rozmowa zbliża się do progu tokenów, i streścić dotychczasową konwersację w zwięzły blok (blok kompakcji).
Ta funkcja pomaga zachować istotę Twoich interakcji, a jednocześnie zwalnia miejsce, byś mógł kontynuować pracę. Jeśli planujesz używać agentów zadaniowych działających długo, może to utrzymać je na kursie dzięki znacznie lepszej pamięci.
Dwie funkcje Claude Opus 4.6 określają, czy potrzebuje rozszerzonego rozumowania i jak bardzo się do niego przykłada.
Adaptacyjne rozumowanie pozwala modelowi ocenić złożoność Twojej prośby. Na tej podstawie decyduje, czy użyć rozszerzonego rozumowania. Zamiast ręcznie ustawiać liczbę tokenów na ten cel, Claude dostosuje budżet do złożoności każdego żądania.
Parametr „wysiłek” pozwala ustawić, na ile skłonny lub oszczędny ma być Claude w wydatkowaniu tokenów. Innymi słowy, możesz wyważyć efektywność tokenową i dokładność odpowiedzi.
Korzystając z Claude Opus 4.6 w API, możesz ustawić te parametry ręcznie. Przykładowo:
Niedawno opisywaliśmy Claude w Excelu, pokazując, jak dodatek pomaga w różnych zadaniach w bocznym panelu arkusza. Poza rozbudową funkcjonalności tego narzędzia, Anthropic ogłosił Claude w PowerPoint.
Integracja respektuje Twoje wzorce slajdów, czcionki i układy. Możesz podać szablon korporacyjny i poprosić o zbudowanie konkretnej sekcji albo wybrać slajd i kazać przekształcić gęsty tekst w natywny, edytowalny diagram.
Nacisk na generowanie edytowalnych obiektów PowerPoint, a nie tylko „obrazków slajdów”, sprawia, że to faktycznie narzędzie produktywności, a nie jedynie generator pomysłów.
Claude w PowerPoint jest obecnie w wersji zapoznawczej dla użytkowników Max i Enterprise.
Wiele głównych deklaracji Opus 4.6 dotyczy trudniejszych zadań kodowania i głębszego rozumowania. Te umiejętności opierają się na pewnej bazie: zdolności utrzymania wielu ograniczeń w pamięci, rozumowania przez wiele kroków i wychwytywania błędów.
Mając to na uwadze, poddaliśmy Opus 4.6 serii wieloetapowych wyzwań logicznych, matematycznych i programistycznych. Chcieliśmy sprawdzić, czy uda się obnażyć znane, częste słabości LLM-ów — takie jak kaskadowe błędy obliczeń, rozumowanie przestrzenne (zawsze kłopot) i pytania z ograniczeniami. Dodaliśmy też konkretne zadanie debugowania, bo w zapowiedzi Anthropic chwalił się skutecznością Opus 4.6 w analizie przyczyn źródłowych i innych problemach debugowania.
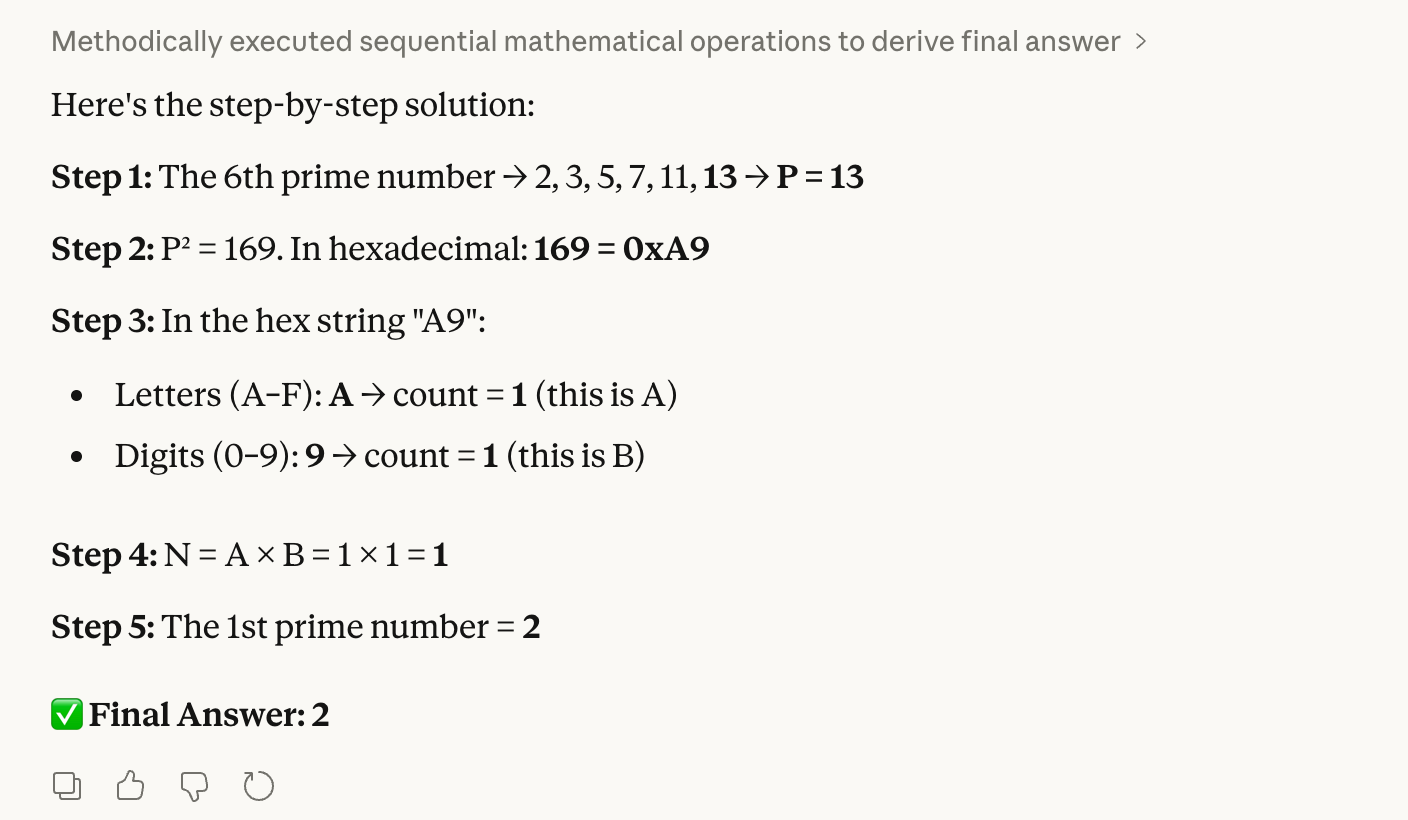
Nasz pierwszy test łączy liczby pierwsze, system szesnastkowy i zliczanie:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
Brzmi dość złożenie, ale ten test łatwo zweryfikować. Wiemy, że poprawna odpowiedź to 2, bo 6. liczba pierwsza to 13; 13 do kwadratu to 169, co w hex to „A9”. Mamy tam 1 literę × 1 cyfrę, czyli 1 po pomnożeniu, a pierwszą liczbą pierwszą jest 2.
Obawa jest taka, że model potknie się na konwersji hex, co kaskadowo da zły wynik końcowy. Jak widać, Opus 4.6 nie miał z tym problemu:
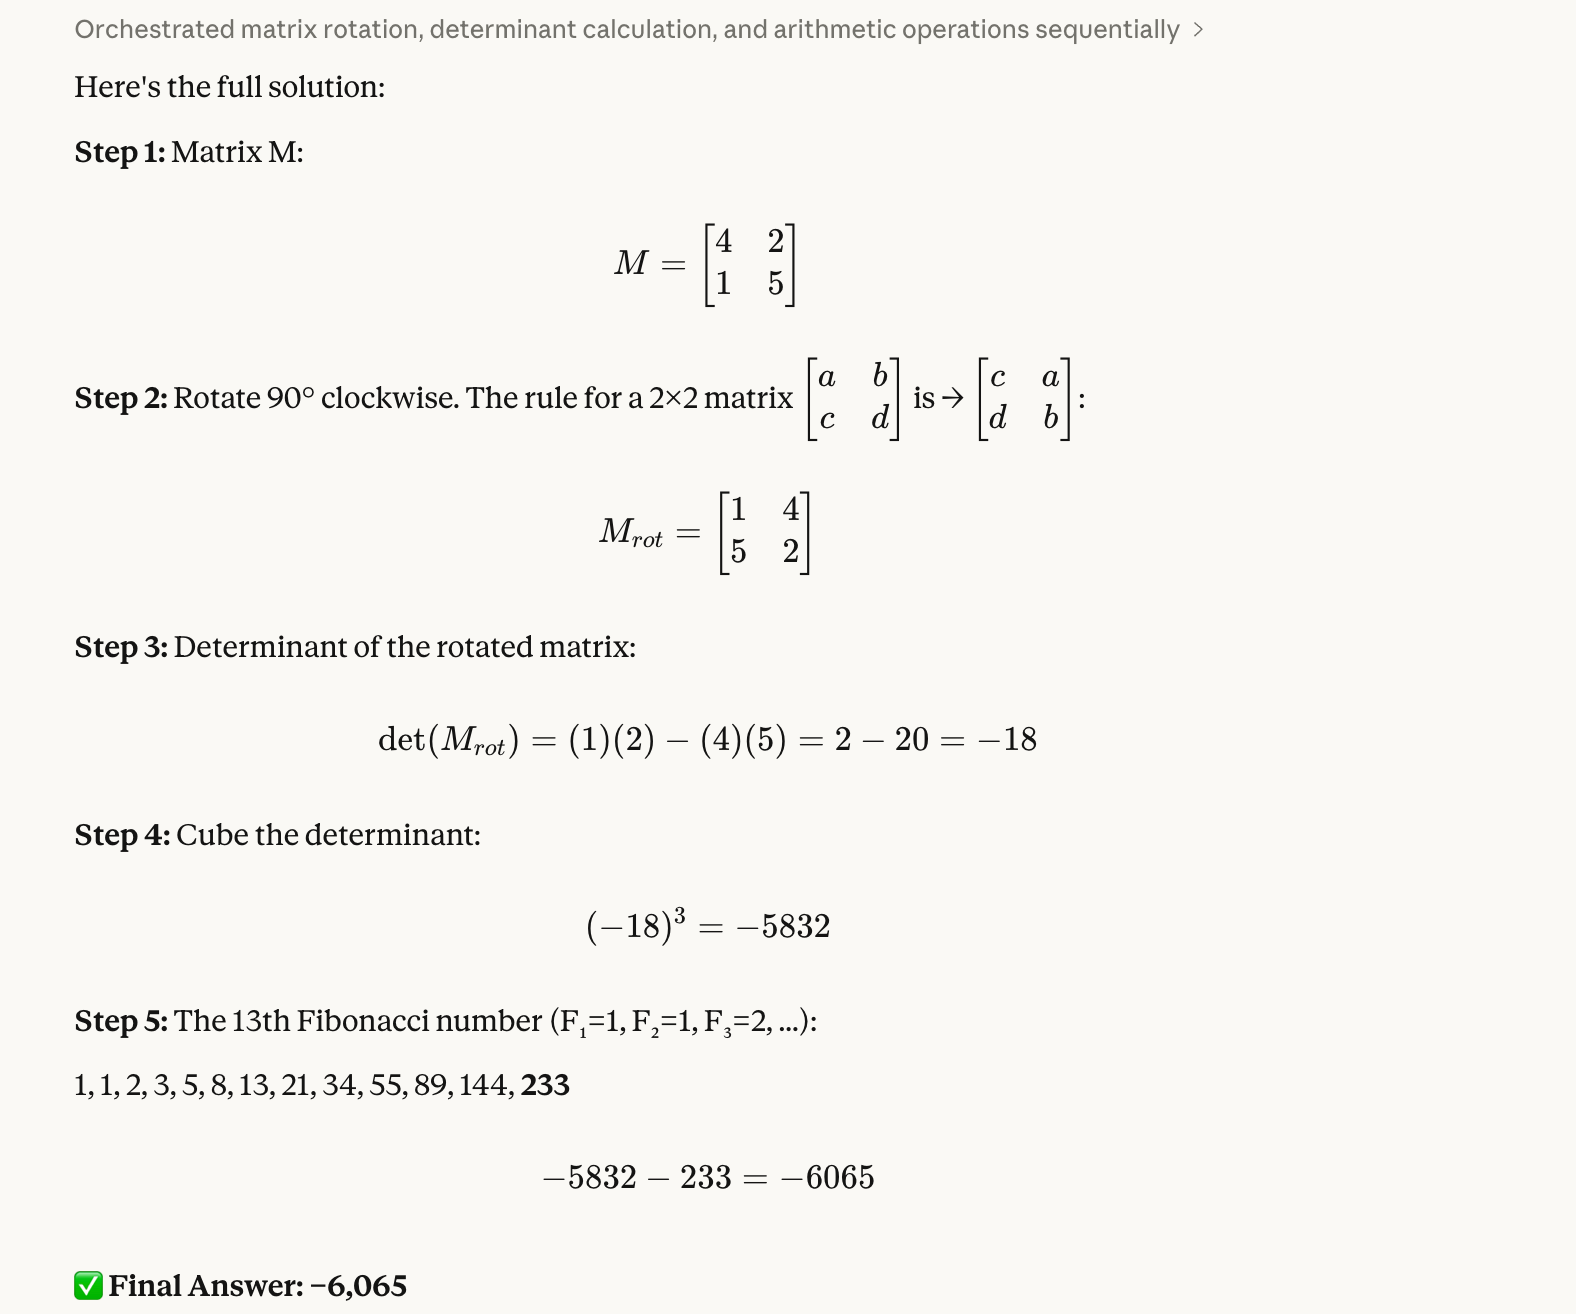
Drugi test sprawdza rozumowanie przestrzenne i obchodzenie się z liczbami ujemnymi:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
Ten wymagał od nas nieco więcej pracy przy weryfikacji. Poprawna odpowiedź to -6 065. Wiemy to, bo obrócona macierz to [[1, 4], [5, 2]]; potem w Pythonie liczymy wyznacznik, który wynosi -18, a po podniesieniu do sześcianu dostajemy -5 832; na koniec odejmujemy 233 i mamy -6 065.
Wybraliśmy ten test, bo wiemy z doświadczenia, że modele często źle zamieniają elementy macierzy albo gubią znak ujemny po drodze. Znów: Opus 4.6 poradził sobie bez trudu:
W trzecim teście spróbowaliśmy problemu spełniania ograniczeń wymagającego backtrackingu:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
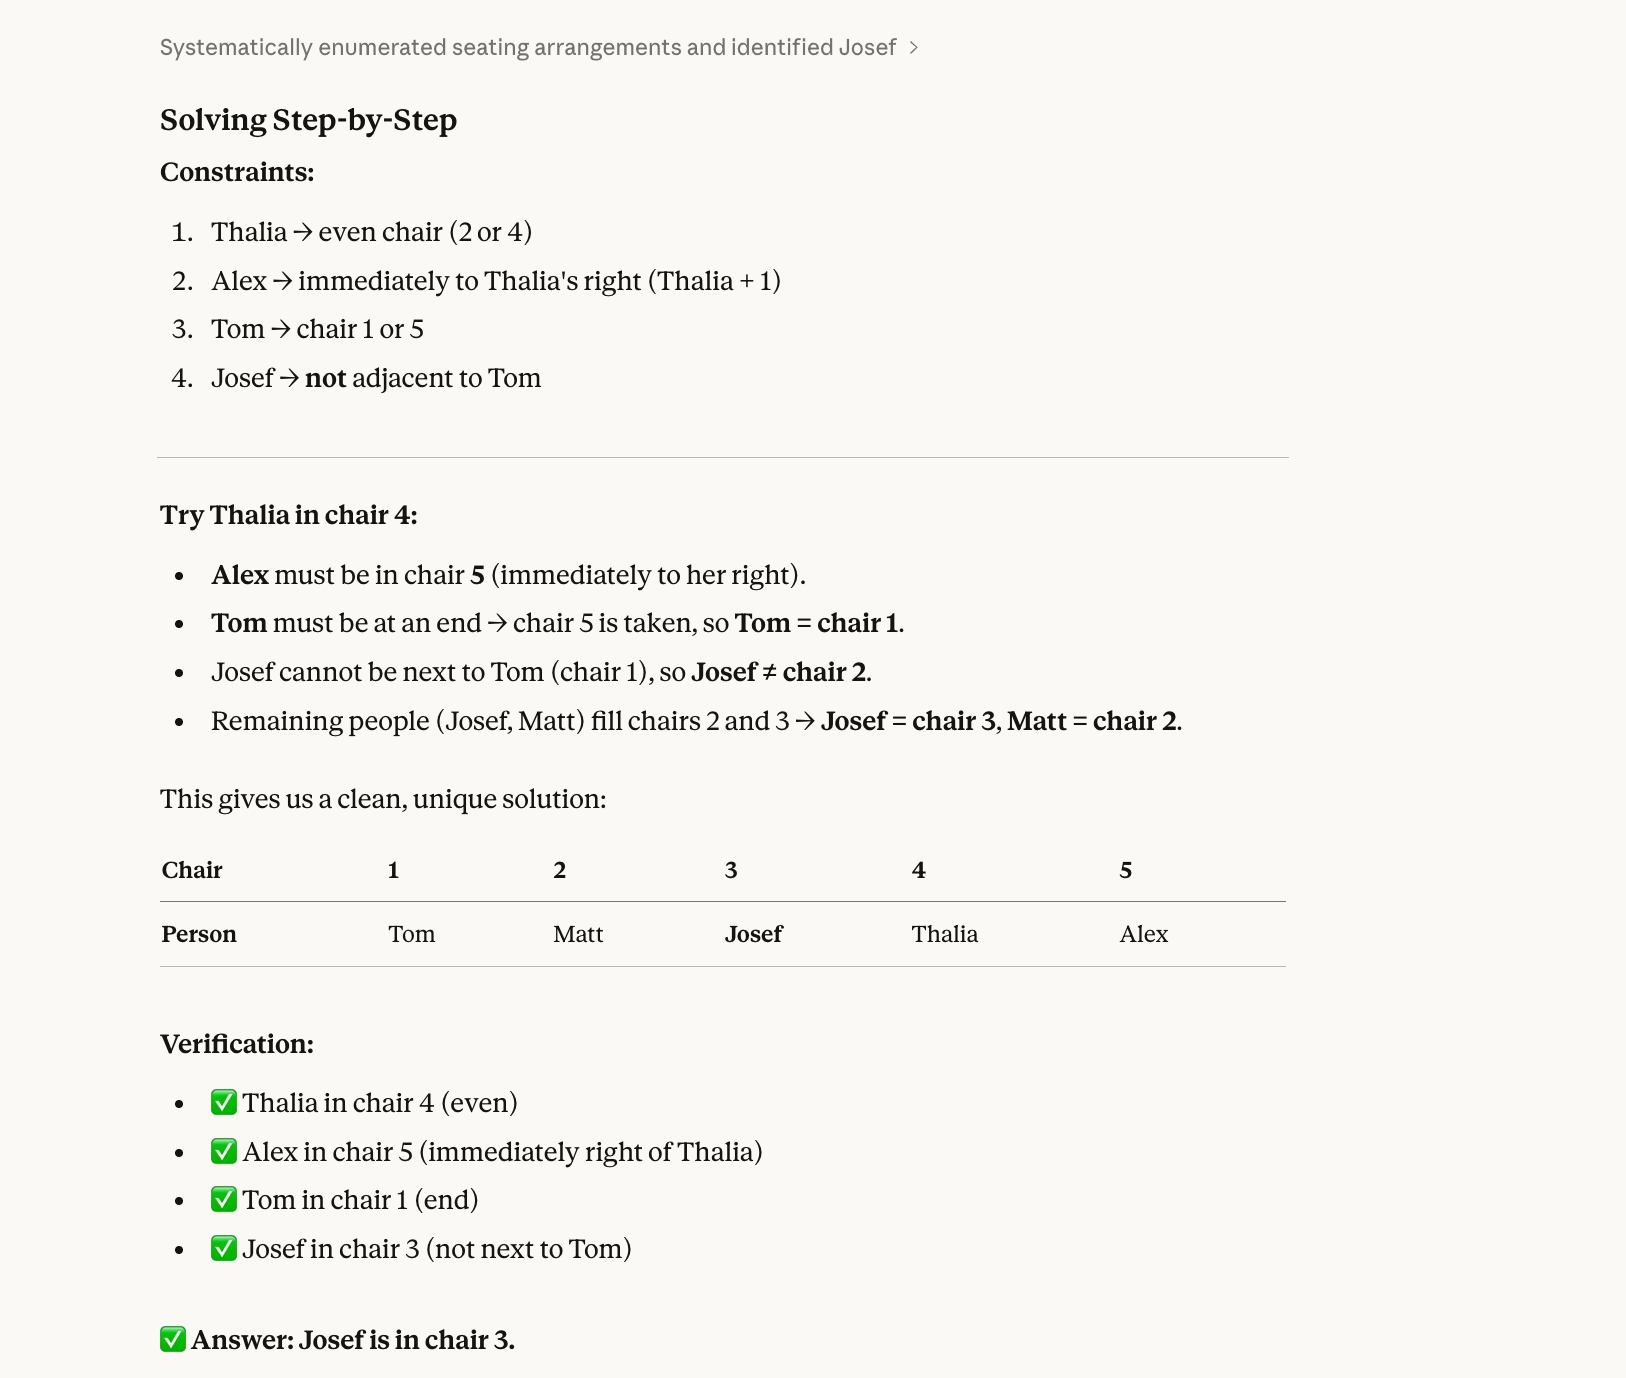
Poprawna odpowiedź to Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Da się to rozwiązać na kartce, z odrobiną wysiłku.
Modele często mylą się tu dlatego, że historycznie rozwiązują sekwencyjnie, a nie całościowo. Czytają „Thalia siedzi na parzystym krześle” i wybierają jedno (np. 2), nie sprawdzając, czy to pasuje do reszty ograniczeń. Potem się tego trzymają, wypełniają kolejne miejsca, aż trafiają na konflikt — ale wtedy są już w narożniku i nie wracają, by spróbować Thalii na 4.
Opus 4.6 rozwiązał to poprawnie:
Czwarty test sprawdza wizualizację przestrzenną i intuicję fizyczną:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Żeby to zweryfikować, faktycznie zdjąłem zegarek z nadgarstka i go obróciłem.
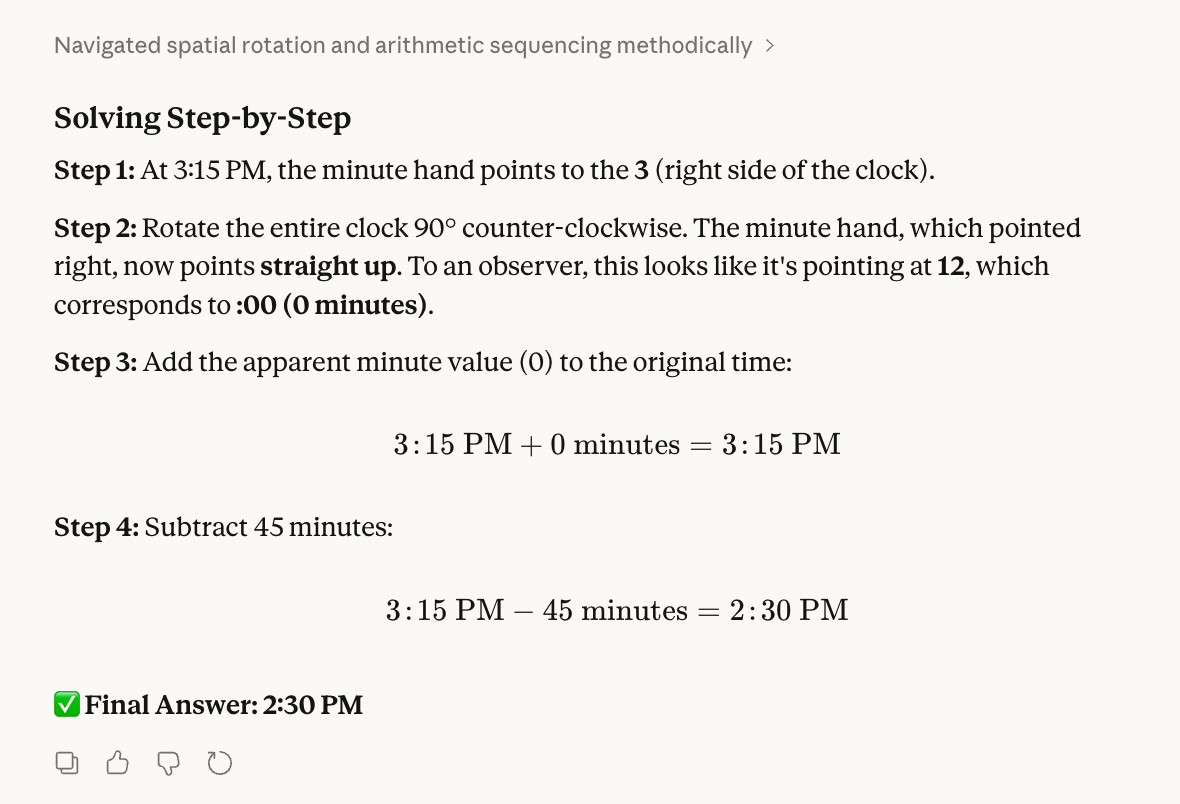
Poprawna odpowiedź to 14:30. O 3:15 wskazówka minutowa wskazuje „3”. Gdy obróciłem „12” w lewo, „3” przesunęła się tam, gdzie była „12”. Dodałem więc 0 do 3:15, odjąłem 45 minut i wyszło 14:30.
Projektując test, spodziewaliśmy się, że modele pomylą obrót tarczy z przesunięciem wskazówki. Słyszeliśmy też, że dodanie 0 bywa dla nich „podejrzane”, więc próbują wymusić inną liczbę.
Jednak Opus 4.6 rozwiązał problem i podał prawidłową odpowiedź:
Piąty test łączy arytmetykę modularną z filtrowaniem liczb pierwszych:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
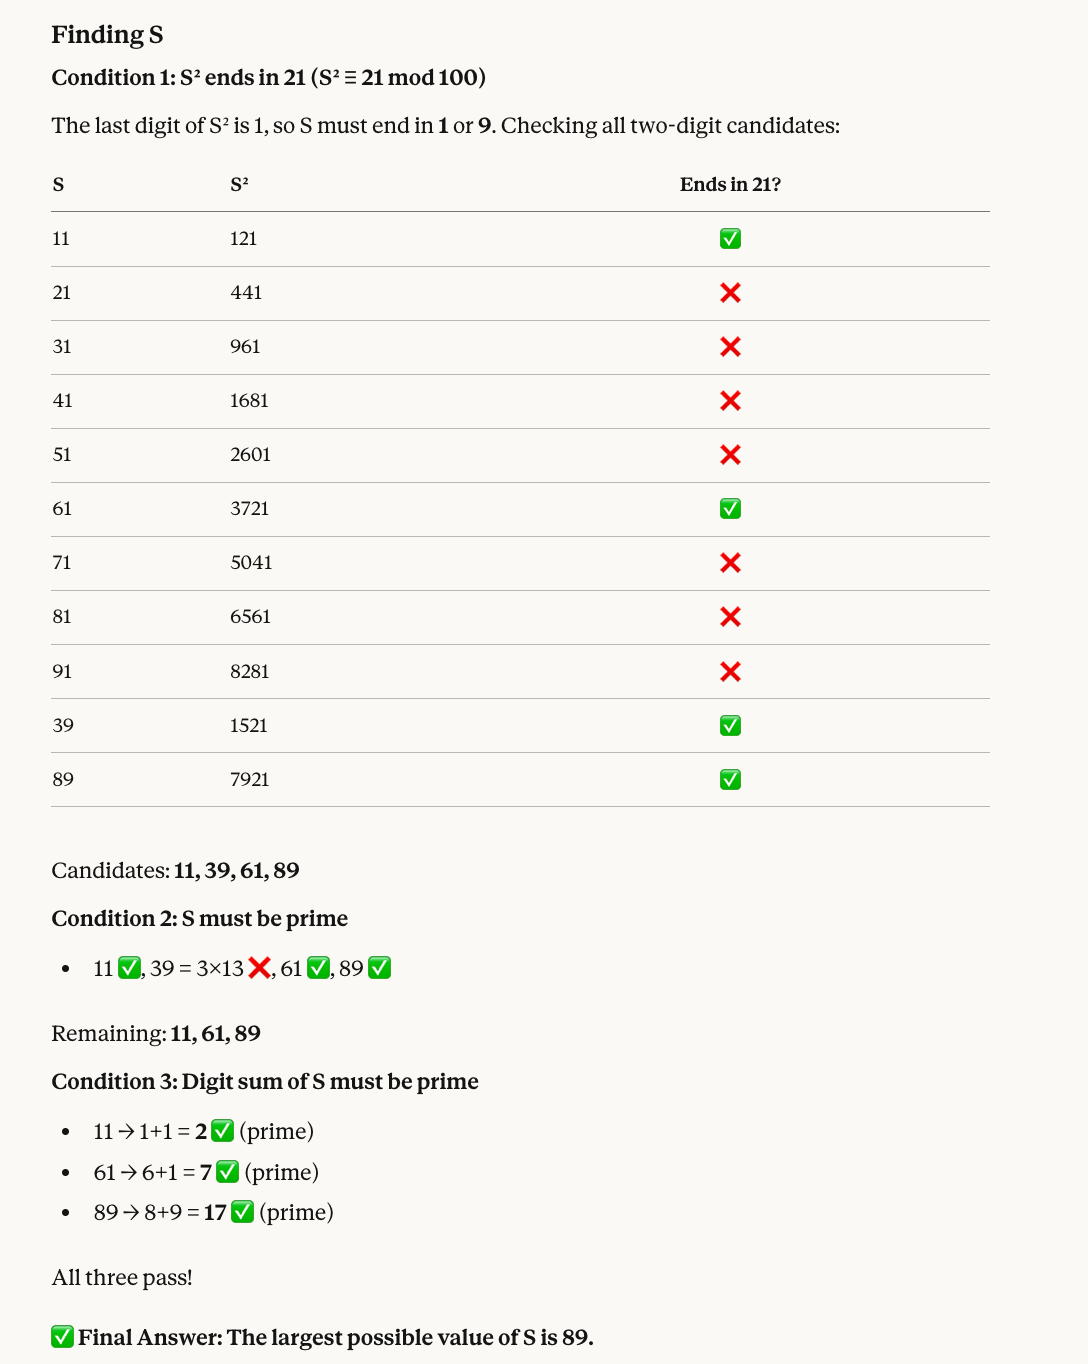
Oto dlaczego poprawną liczbą jest 89: Liczby, których kwadraty kończą się na 21, to 11, 39, 61 i 89. Z nich 39 nie jest pierwsza, więc zostają 11, 61 i 89. Wszystkie mają sumy cyfr będące liczbami pierwszymi (odpowiednio 2, 7 i 17), więc największa to 89.
Opus 4.6 znów podał prawidłową odpowiedź, tym razem dodając też pomocną wizualizację:
Następny test łączy silnię, operacje na łańcuchach i liczby pierwsze:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
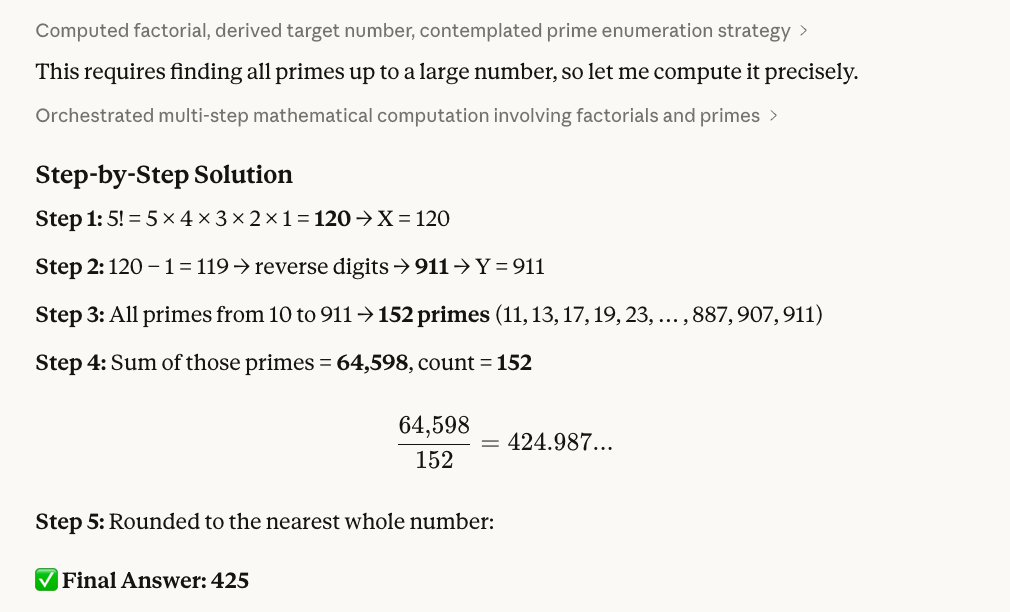
Tak zweryfikowaliśmy, że poprawna odpowiedź to 425: 5! = 120; odejmujemy 1, mamy 119; odwracamy cyfry i wychodzi 911. Potem, używając R (kod poniżej), widzimy, że między 10 a 911 jest 152 liczb pierwszych, a ich suma to 64 598. Na koniec dzielimy i zaokrąglamy: 64 598 ÷ 152 ≈ 425.
Oto skrypt w R, którego użyliśmy:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Kolejny test uderza w jedną z głównych deklaracji Opus 4.6: diagnozowanie błędów w kodzie. Wiemy, że modele często poprawnie śledzą kod linia po linii, ale nie łączą tego tropu z faktyczną usterką.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
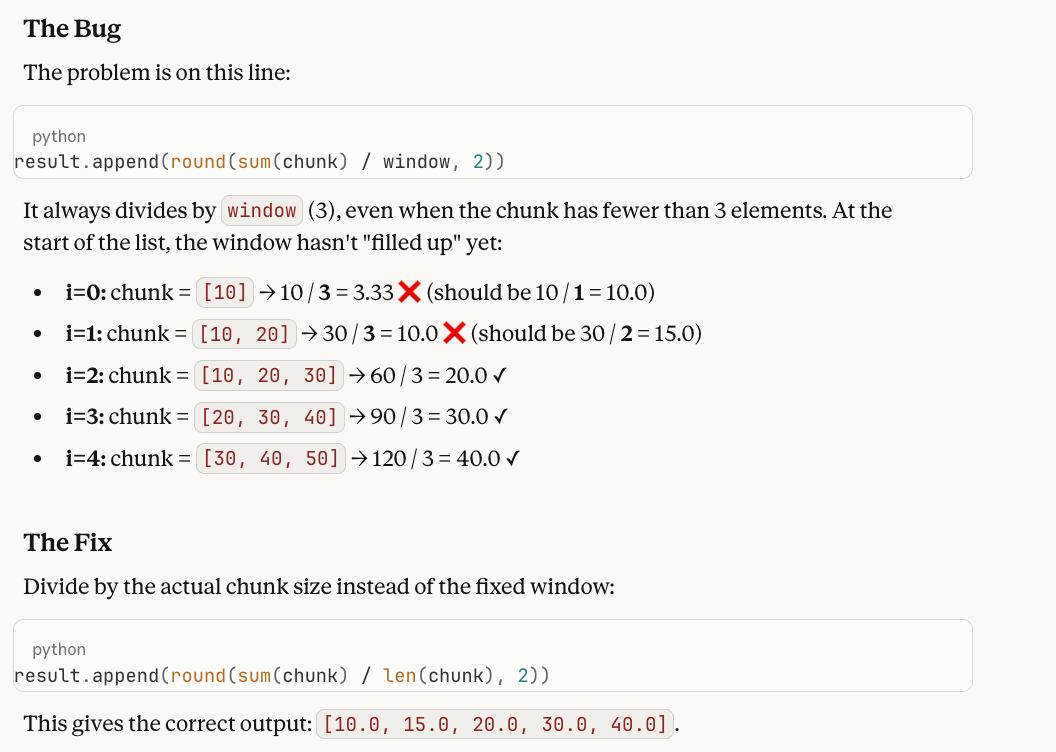
Oto odpowiedź i dlaczego to dobry test: funkcja zawsze dzieli przez window (3), nawet gdy „chunk” na początku listy ma mniej niż 3 elementy. Błędny wynik to [3.33, 10.0, 20.0, 30.0, 40.0], ale dwie pierwsze wartości powinny wynosić 10.0 i 15.0, bo te fragmenty zawierają odpowiednio tylko 1 i 2 elementy. Poprawka to zmiana / window na / len(chunk).
Lubimy ten test, bo modele często idealnie śledzą pętlę, po czym stwierdzają „wyjście wygląda poprawnie” — widzą matematyczne kroki i nie sygnalizują, że dzielenie pojedynczego elementu przez 3 jest błędem. Wymaga to od modelu utrzymania intencji (co powinien robić średni ruchomy) równolegle z wykonaniem (co faktycznie robi kod) i dostrzeżenia luki między nimi.
Ostatni test nie zawiera matematyki, tylko rozumowanie kontrfaktyczne.
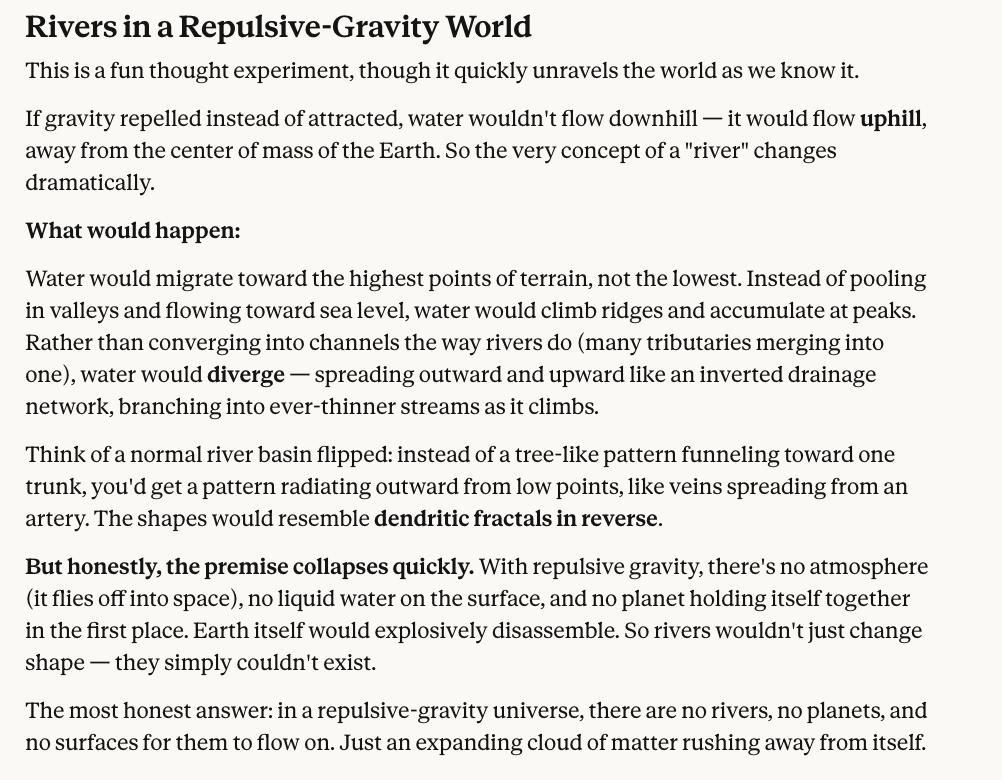
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Jasne, nie ma tu jednej poprawnej odpowiedzi i trudno to sobie wyobrazić. Ale zależy nam, by model przynajmniej przeanalizował implikacje — i uważamy, że odpowiedź Claude Opus 4.6 brzmi wystarczająco rozsądnie.
Krótko mówiąc, Opus 4.6 zdobył komplet punktów, choć — jak widziałeś — jedno pytanie miało odrobinę subiektywną odpowiedź, więc możesz być ostatnią instancją oceniającą.
Opus 4.6 bezdyskusyjnie prowadzi w co najmniej czterech ważnych benchmarkach:
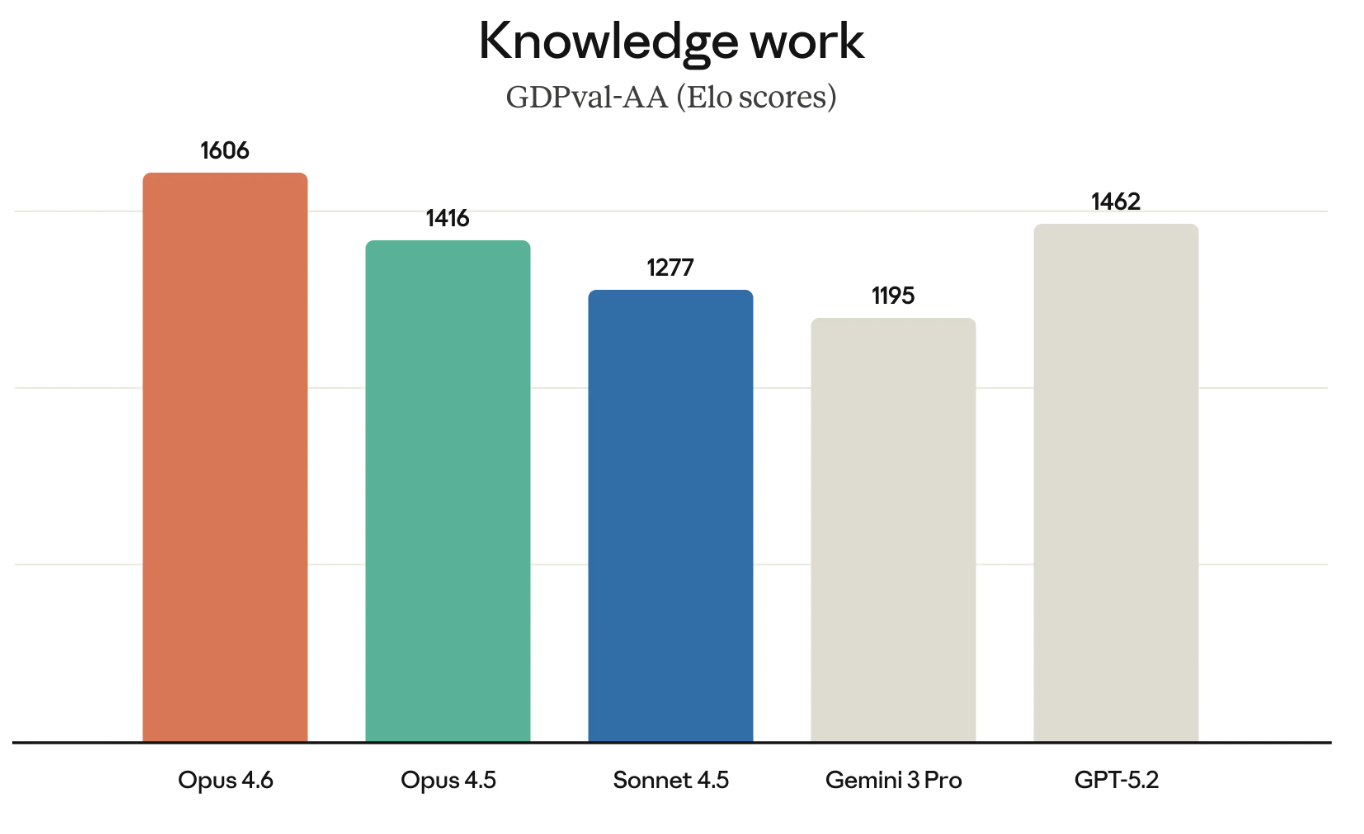
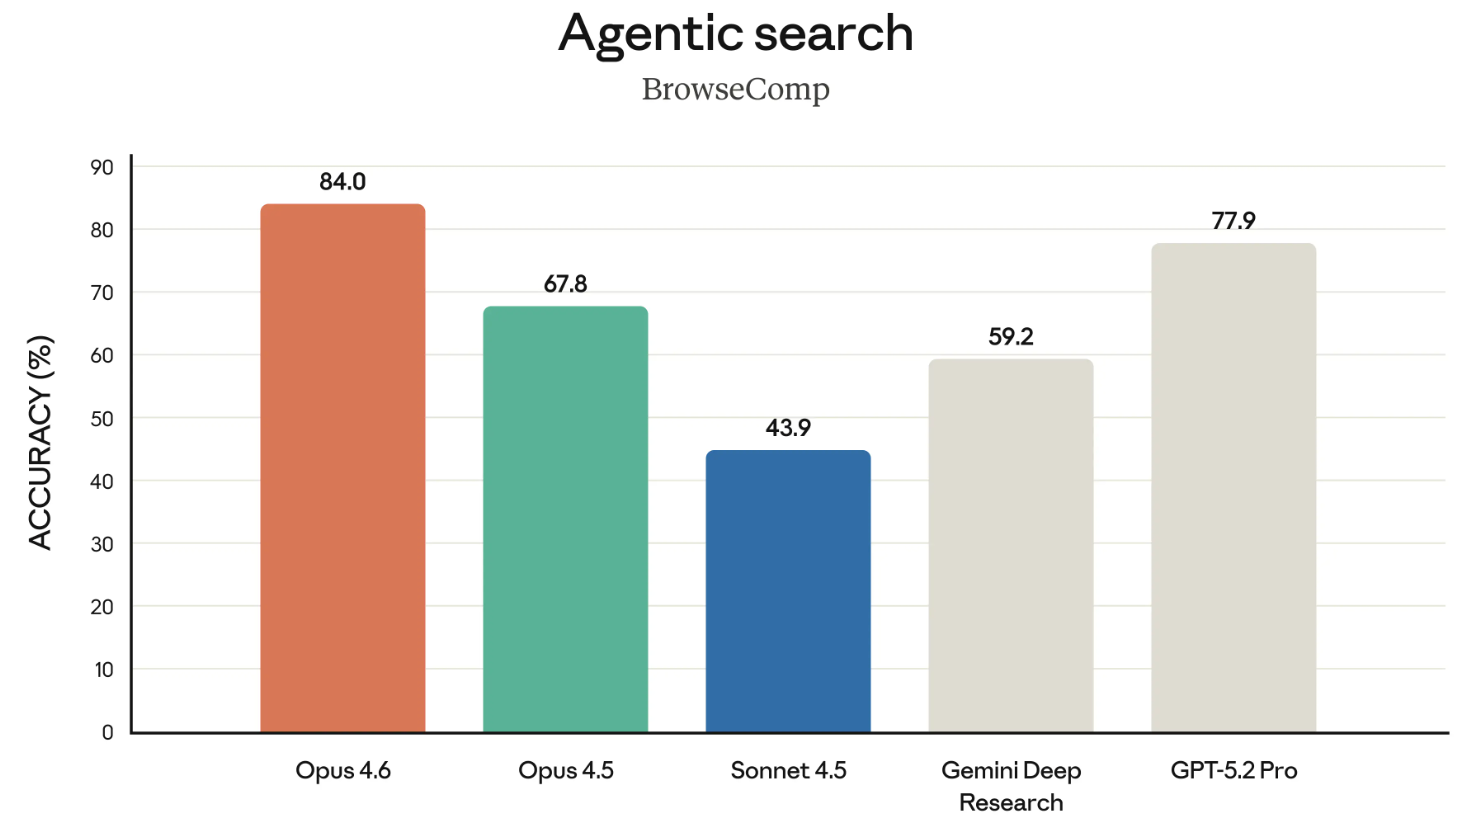
Terminal-Bench 2.0 to benchmark agentowego kodowania; Humanity’s Last Exam bada złożone rozumowanie; GDPval-AA testuje wydajność w pracy wiedzy; BrowseComp mierzy zdolność modelu do znajdowania trudno dostępnych informacji online.
Modele Claude słusznie uchodzą za jedne z najlepszych w kodowaniu. Zacznijmy więc od wyników w benchmarku Terminal-Bench 2.0.
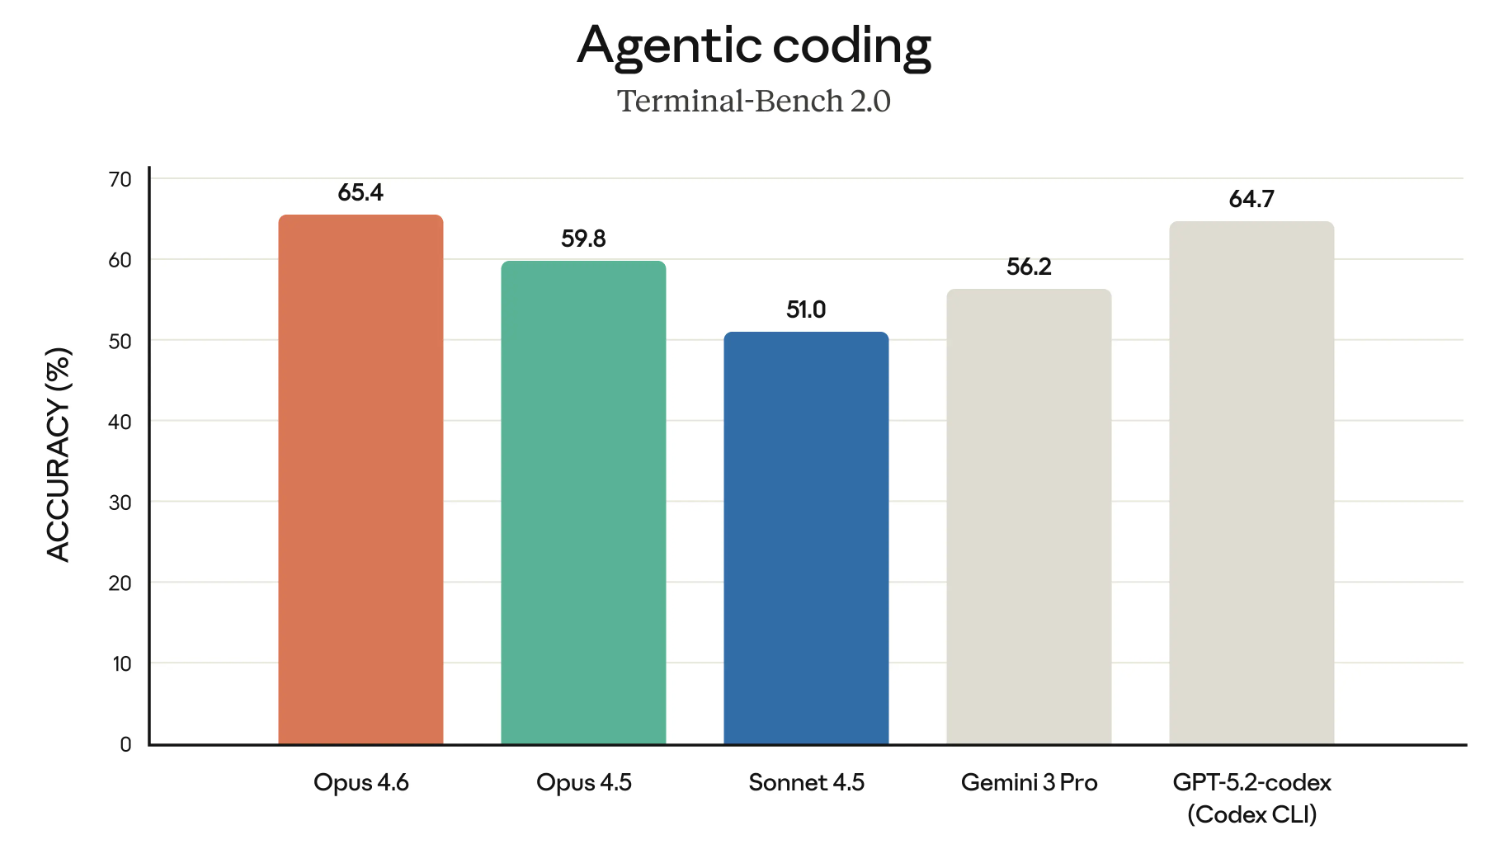
Jeśli wykres powyżej wydaje się podkreślać Opus 4.6 w relacji do GPT-5.2-codex — to zapewne celowe. Anthropic w ostatnim czasie bezpośrednio rzuca wyzwanie OpenAI w kilku obszarach i buduje argumenty za zastosowaniami w enterprise.
Humanity’s Last Exam to jeden z najbardziej znanych benchmarków i taki, który wszyscy bacznie śledzimy. Mierzy ogólną zdolność modelu do rozumowania.
Poniższy wykres pokazuje sukces różnych modeli czołówki w benchmarku HLE — z narzędziami i bez. („Z narzędziami” oznacza, że model mógł korzystać z zewnętrznych możliwości, jak wyszukiwanie w sieci czy wykonywanie kodu.)
Może lepiej byłoby to przedstawić na dwóch wykresach. Odkładając ten drobiazg, wniosek jest jasny: Opus 4.6 prowadzi zarówno w kategorii „z narzędziami”, jak i „bez narzędzi”.
GDPval-AA (jak sugeruje nazwa) to test tego, co uznaje się za ekonomicznie wartościową pracę wiedzy. Pomyśl o uruchamianiu modeli finansowych czy prowadzeniu badań.
GDPval-AA i podobne benchmarki zyskują na znaczeniu, bo realnie mierzą rodzaje pracy, za które firmy faktycznie płacą. Sukces Opus 4.6 w GDPval-AA to też bezpośrednie wyzwanie rzucone rodzinie modeli GPT, bo OpenAI i Anthropic walczą o wielu tych samych klientów.
BrowseComp to ostatni wart wzmianki benchmark z tej premiery. Mierzy zdolność modelu do wyszukiwania trudno dostępnych informacji online. Trochę historii: BrowseComp został opracowany przez OpenAI, by pokazać możliwości wyszukiwania ich własnych modeli.
W dość celowym ruchu Anthropic bezpośrednio podlinkował ogłoszenie OpenAI z kwietnia 2025 o BrowseComp, jednocześnie podkreślając, że Opus 4.6 jest na jego szczycie. To było nieco zadziorne — powołać się na benchmark OpenAI przeciwko nim.
W chwili pisania artykułu Opus 4.6 jest szeroko dostępny. Nie uzyskasz jednak dostępu bez przejścia na konto pro, które oferuje też inne korzyści, np. możliwość używania Claude w Excelu.
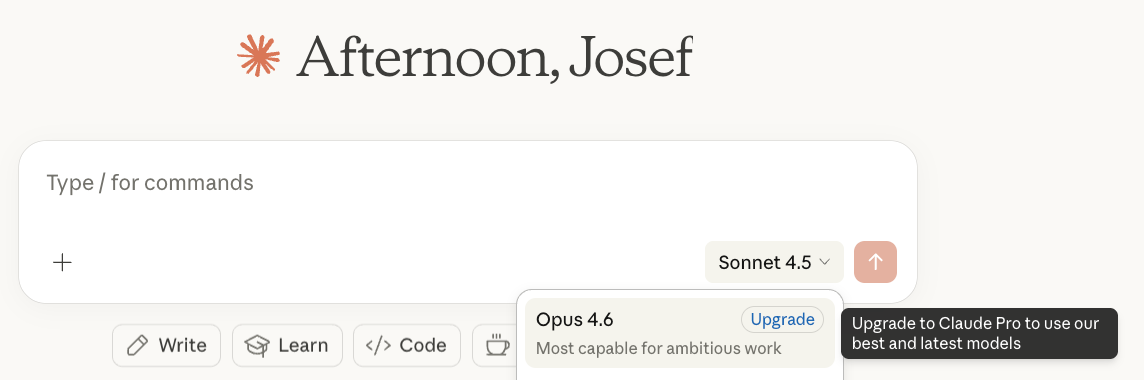
Jeśli jesteś deweloperem, używaj claude-opus-4-6 w API Claude. Ceny się nie zmieniły: nadal $5/$25 za milion tokenów. Jeśli mylą Cię te dwie liczby, pierwsza to koszt wysłania tokenów do modelu (tzn. Twoich promptów), a druga to koszt tokenów, które model zwraca (odpowiedzi).
Claude Opus 4.6 prowadzi w rankingach ważnych benchmarków, takich jak GPDVal-AA, który mierzy wydajność modelu w ekonomicznie istotnych zadaniach — a na tym zależy dużym klientom korporacyjnym. OpenAI może to niepokoić, bo zaledwie kilka godzin przed premierą Opus 4.6 ogłosił OpenAI Frontier — nową platformę enterprise do budowania, wdrażania i zarządzania agentami AI w produkcji.
Innymi słowy, zamiast ścigać się na benchmarki modeli, Frontier pokazuje, że OpenAI skupia się na infrastrukturze wokół swojego pakietu modeli — dając agentom AI współdzielony kontekst biznesowy, uprawnienia i możliwość otrzymywania i wykorzystywania informacji zwrotnej w czasie. Tracąc grunt w benchmarkach, OpenAI sygnalizuje, że jego platforma jest lepiej przygotowana, by faktycznie uczynić agentów użytecznymi w firmie.
Czy to strategiczny zwrot, czy ciche przyznanie, że przegrywają wyścig modeli — ocenę zostawiamy Tobie.
Ogólnie jesteśmy pod wrażeniem tego, co Anthropic oferuje w Claude Opus 4.6, i nie możemy się doczekać pracy z zespołami agentów. Jeśli chcesz dowiedzieć się więcej o rodzinie Claude, koniecznie sprawdź kurs Introduction to Claude Models.
Ucz się AI z DataCamp
course
course
course