Course
Введение в модели Claude
3 ч
14.3K
Последние дни ходили слухи о новом релизе Anthropic. Многие ожидали Claude Sonnet 5, но первой новинкой года стал Claude Opus 4.6.
С контекстным окном на 1 миллион токенов, адаптивным мышлением, сжатием диалога и рядом бенчмарков с результатами на первом месте Claude Opus 4.6 улучшает Opus 4.5. Как говорит Anthropic, они обновили свою самую «умную» модель. Вместе с моделью Anthropic также запустила командные агенты в Claude Code и интеграцию Claude в PowerPoint.
В этой статье мы расскажем обо всём новом в Claude Opus 4.6: рассмотрим функции, изучим бенчмарки и проверим модель на практике с несколькими примерами.
Чтобы узнать больше о последних возможностях Claude, рекомендуем наши руководства по Claude Cowork и Claude Code, а также наш туториал по OpenClaw. Для сравнения с конкурентами прочитайте наши обзоры Muse Spark vs Claude Opus 4.6 и GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 — это новейшая крупная языковая модель от Anthropic. Она следует за Opus 4.5 и существенно прокачивает «самый умный» уровень моделей компании.
Судя по публикации о релизе, Anthropic делает больший акцент на агентном программировании, глубоком рассуждении и самокоррекции. То есть фокус смещается с разового действия на устойчивое выполнение.
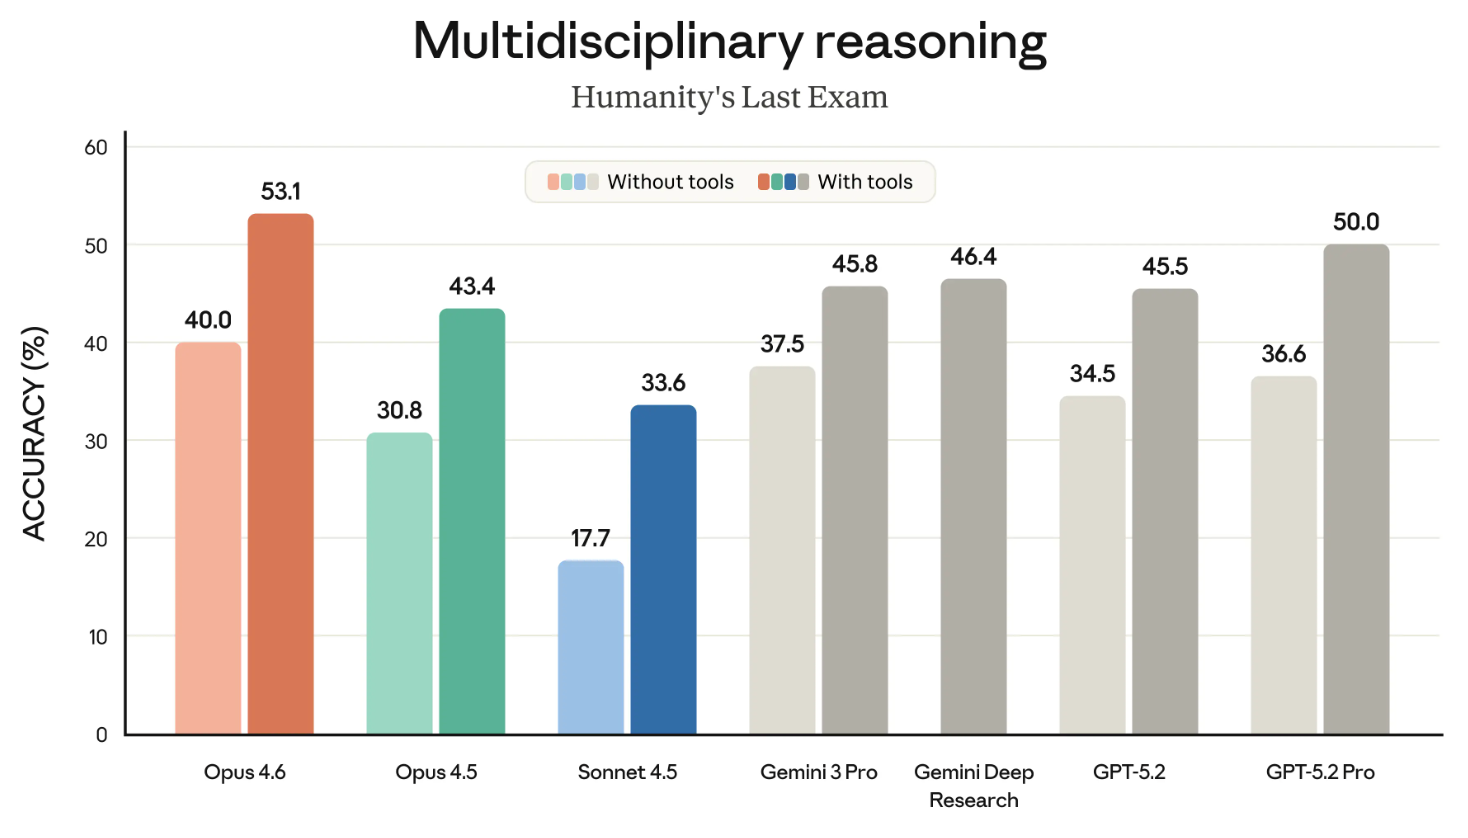
Opus 4.6 лучше планирует, дольше сохраняет связность и выявляет ошибки в собственной работе. Благодаря этому Claude Opus 4.6 возглавляет несколько бенчмарков, включая лучший результат в оценке кодирования Terminal-Bench 2.0, а также обходит все другие передовые модели в Humanity’s Last Exam.
Особенно выделяется улучшенное контекстное окно в Claude Opus 4.6. Бета-версия поддерживает 1 млн токенов — на уровне Gemini 3, — что позволяет обрабатывать больше информации, не теряя контекст.
Тем временем Anthropic уже выпустила следующую версию Opus. Рекомендуем наше руководство Claude Opus 4.7, чтобы оставаться в курсе.
В Claude Opus 4.6 появилось несколько заметных функций, многие из которых ориентированы на агентные рабочие процессы. Ключевые моменты:
Команды агентов — это развитие идеи «субагентов» из предыдущих версий Claude. Они позволяют запускать несколько полностью независимых экземпляров Claude, работающих параллельно. Один сеанс выступает «ведущим» агентом и координирует процесс, а «товарищи по команде» выполняют задачи.
Самое интересное — у каждого участника команды есть своё контекстное окно, что обеспечивает более тщательное выполнение. Каждый «товарищ» также может напрямую общаться с остальными в команде.
Разумеется, у функции есть и обратная сторона — стоимость. Поскольку у каждого агента своё контекстное окно, расход токенов может быстро расти. Поэтому Anthropic рекомендует использовать команды там, где высокая сложность задач оправдывает затраты.
Одна из приятных новинок в Claude Opus 4.6 — сжатие контекста. Это улучшение удобства помогает избежать проблем при длительных сценариях, где контекстные окна заполняются до предела. Обычно в таком случае начинается деградация качества.
Благодаря сжатию диалога Claude Opus 4.6 может автоматически обнаруживать, когда переписка приближается к порогу токенов, и сворачивать её в краткий блок (compact- или compaction-блок).
Это помогает сохранить суть взаимодействий и при этом освободить место для продолжения работы. Если вы планируете использовать агенты, ориентированные на задачи и работающие длительное время, эта функция улучшит «память» и удержание курса.
В Claude Opus 4.6 есть две функции, определяющие, нужно ли модели задействовать расширенное мышление, и насколько интенсивно это делать.
Адаптивное мышление позволяет модели оценить сложность запроса. В зависимости от простоты или сложности она решает, использовать ли расширенное рассуждение. Вместо ручной настройки количества токенов для этого Claude будет подбирать бюджет под каждую задачу по мере необходимости.
Параметр усилия задаёт, насколько охотно или экономно Claude тратит токены. По сути, вы балансируете между эффективностью по токенам и глубиной ответов.
При использовании Claude Opus 4.6 через API эти параметры можно указать вручную. Например:
Недавно мы рассказывали о Claude в Excel, показав, как надстройка помогает с разными задачами в боковой панели таблицы Excel. Помимо улучшения этого инструмента, Anthropic анонсировала Claude в PowerPoint.
Интеграция учитывает ваши мастер-слайды, шрифты и макеты. Можно передать корпоративный шаблон и попросить собрать конкретный раздел или выбрать слайд и преобразовать плотный текст в нативную редактируемую диаграмму.
Акцент на создании редактируемых объектов PowerPoint, а не просто «картинок слайдов», делает инструмент действительно продуктивным, а не генератором концепций.
Claude в PowerPoint сейчас доступен в виде research preview для пользователей Max и Enterprise.
Многие ключевые заявления Opus 4.6 касаются сложных задач кодирования и глубокого рассуждения. Эти навыки опираются на фундамент: удержание нескольких ограничений, многошаговое рассуждение и обнаружение ошибок.
С этим в виду мы проверили Opus 4.6 серией задач по логике, математике и программированию в несколько шагов. Мы хотели выявить известные слабости LLM — каскадные ошибки в вычислениях, пространственное мышление (традиционно сложное), а также вопросы с ограничениями. Мы включили и задание на отладку кода, поскольку в анонсе Anthropic подчёркивалась сила Opus 4.6 в поиске первопричин и другой отладке.
Первый тест сочетает простые числа, шестнадцатеричную систему и счёт:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
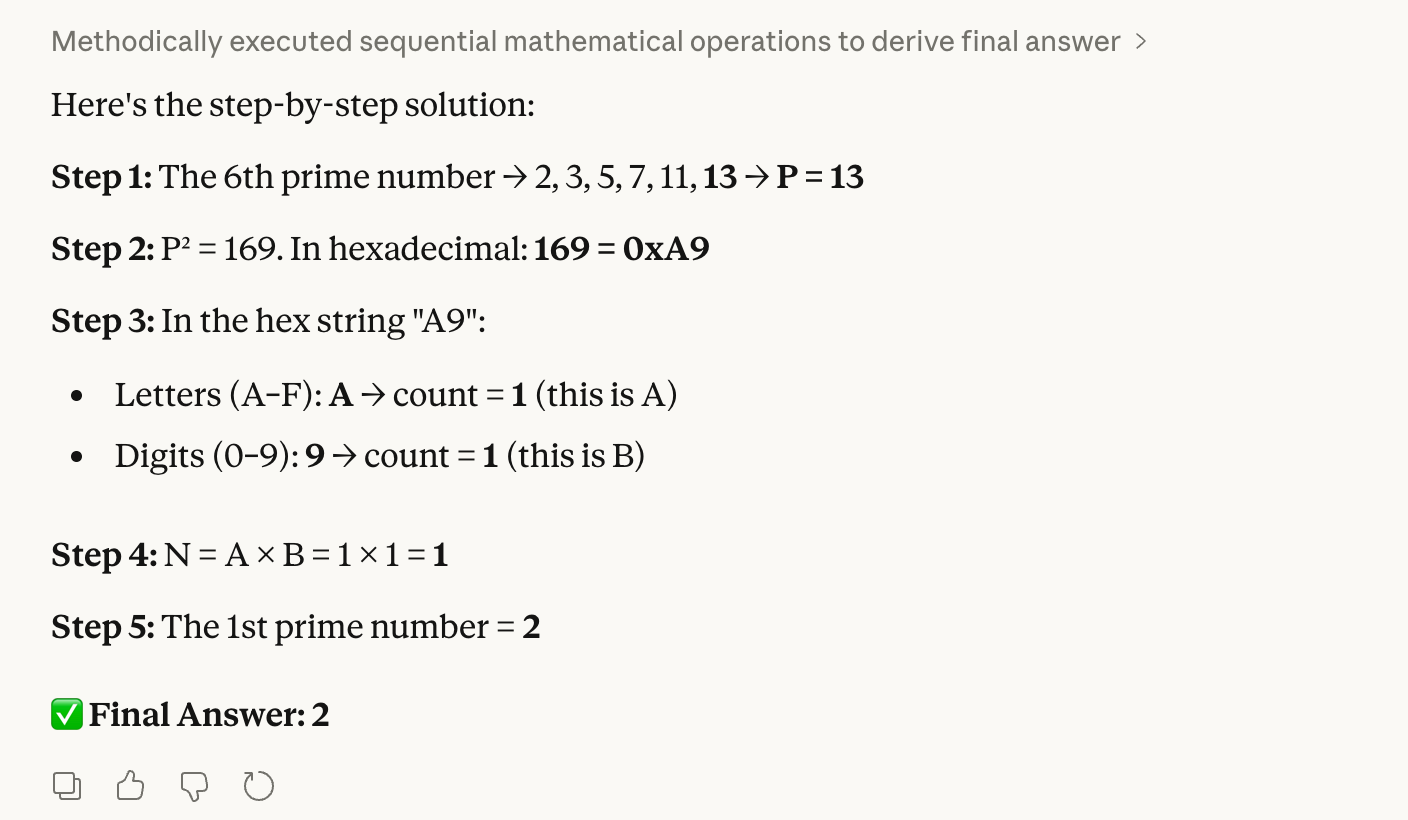
Звучит чуть сложнее, чем есть на самом деле — человеку легко проверить. Правильный ответ — 2, потому что 6-е простое — 13; квадрат 13 — 169, что в hex — «A9». Там 1 буква × 1 цифра, получаем 1, а первое простое — 2.
Риск в том, что модель ошибётся при конвертации в hex, и ошибка «потянется» дальше. Как видно, у Opus 4.6 проблем не возникло:
Второй тест — на пространственное мышление и работу с отрицательными числами:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
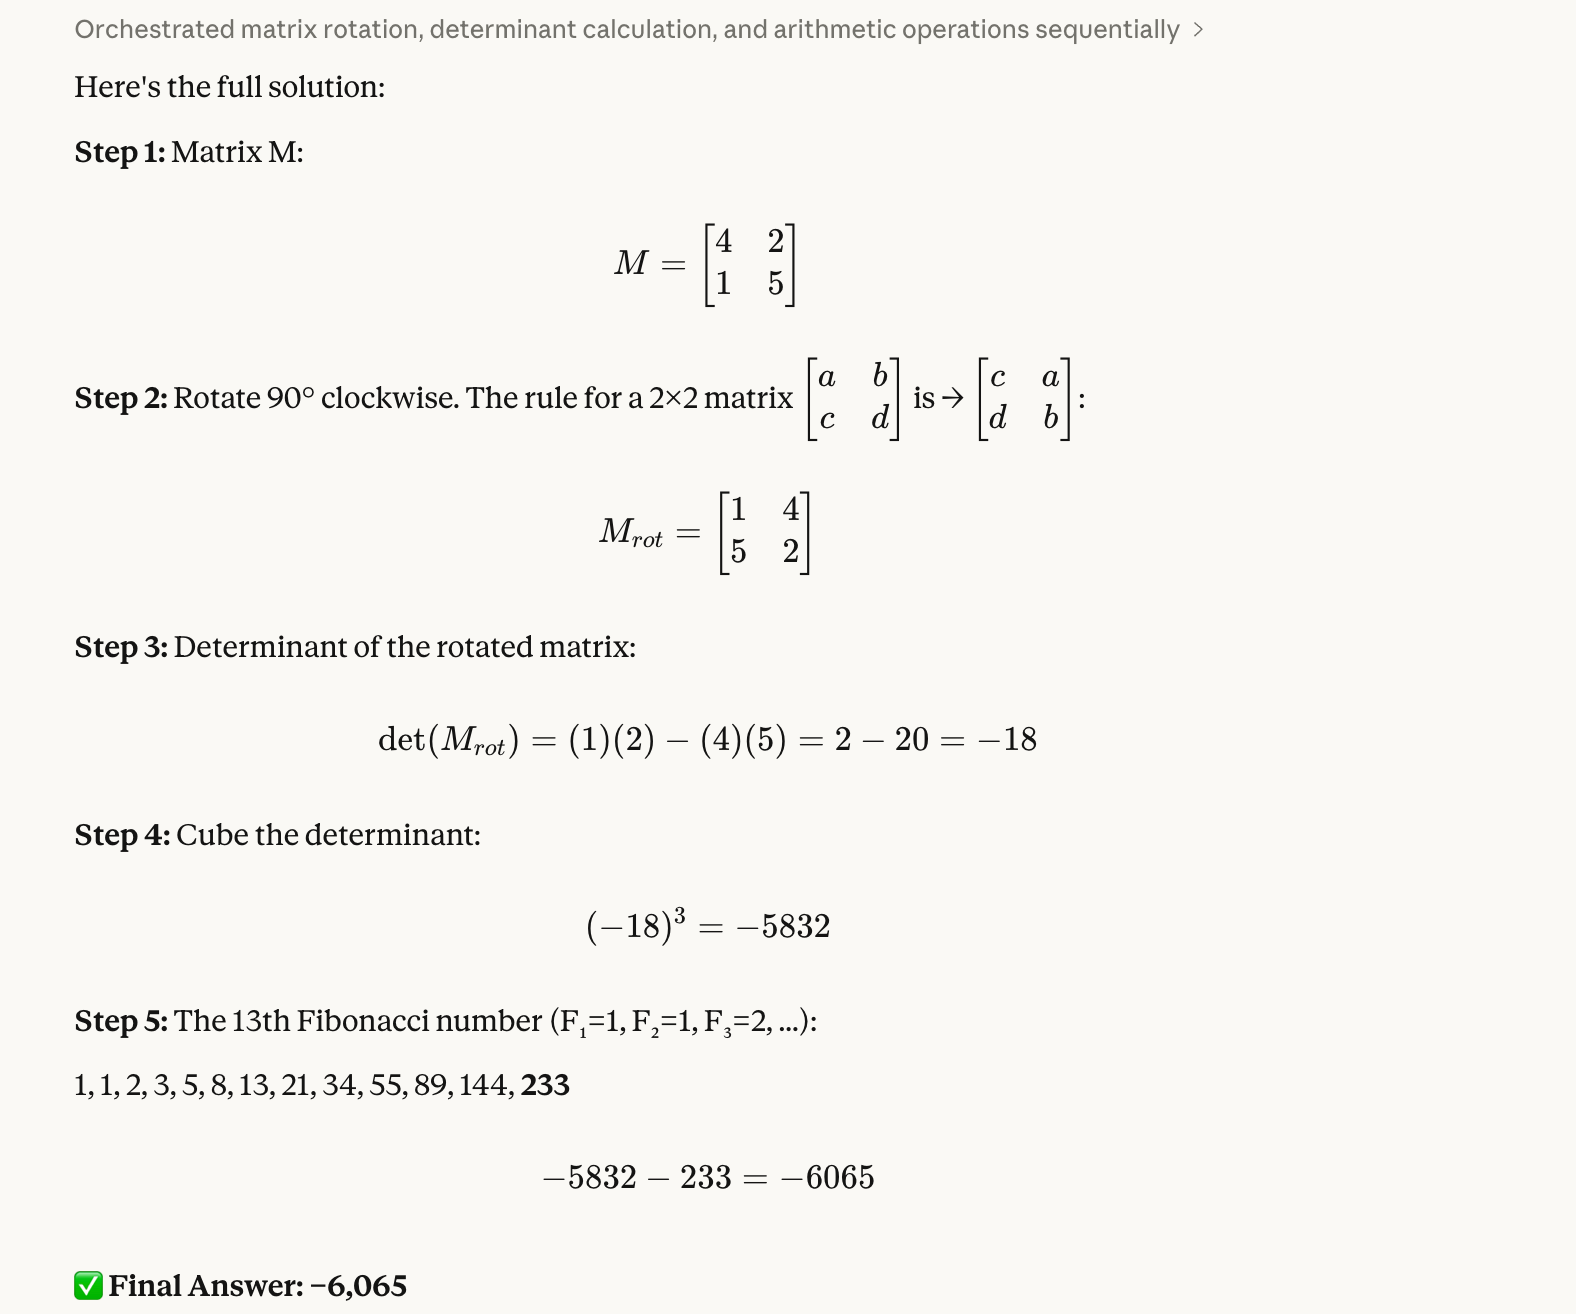
Этому тесту потребовалось чуть больше ручной проверки. Правильный ответ — -6 065. Повернутая матрица — [[1, 4], [5, 2]]; в Python определяем определитель — -18; куб — -5 832; затем вычитаем 233 и получаем -6 065.
Мы выбрали этот тест, потому что модели часто путают перестановку элементов матрицы или «теряют» минус. И снова Opus 4.6 справился без ошибок:
Третий тест — задача удовлетворения ограничений с возвратом (backtracking):
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
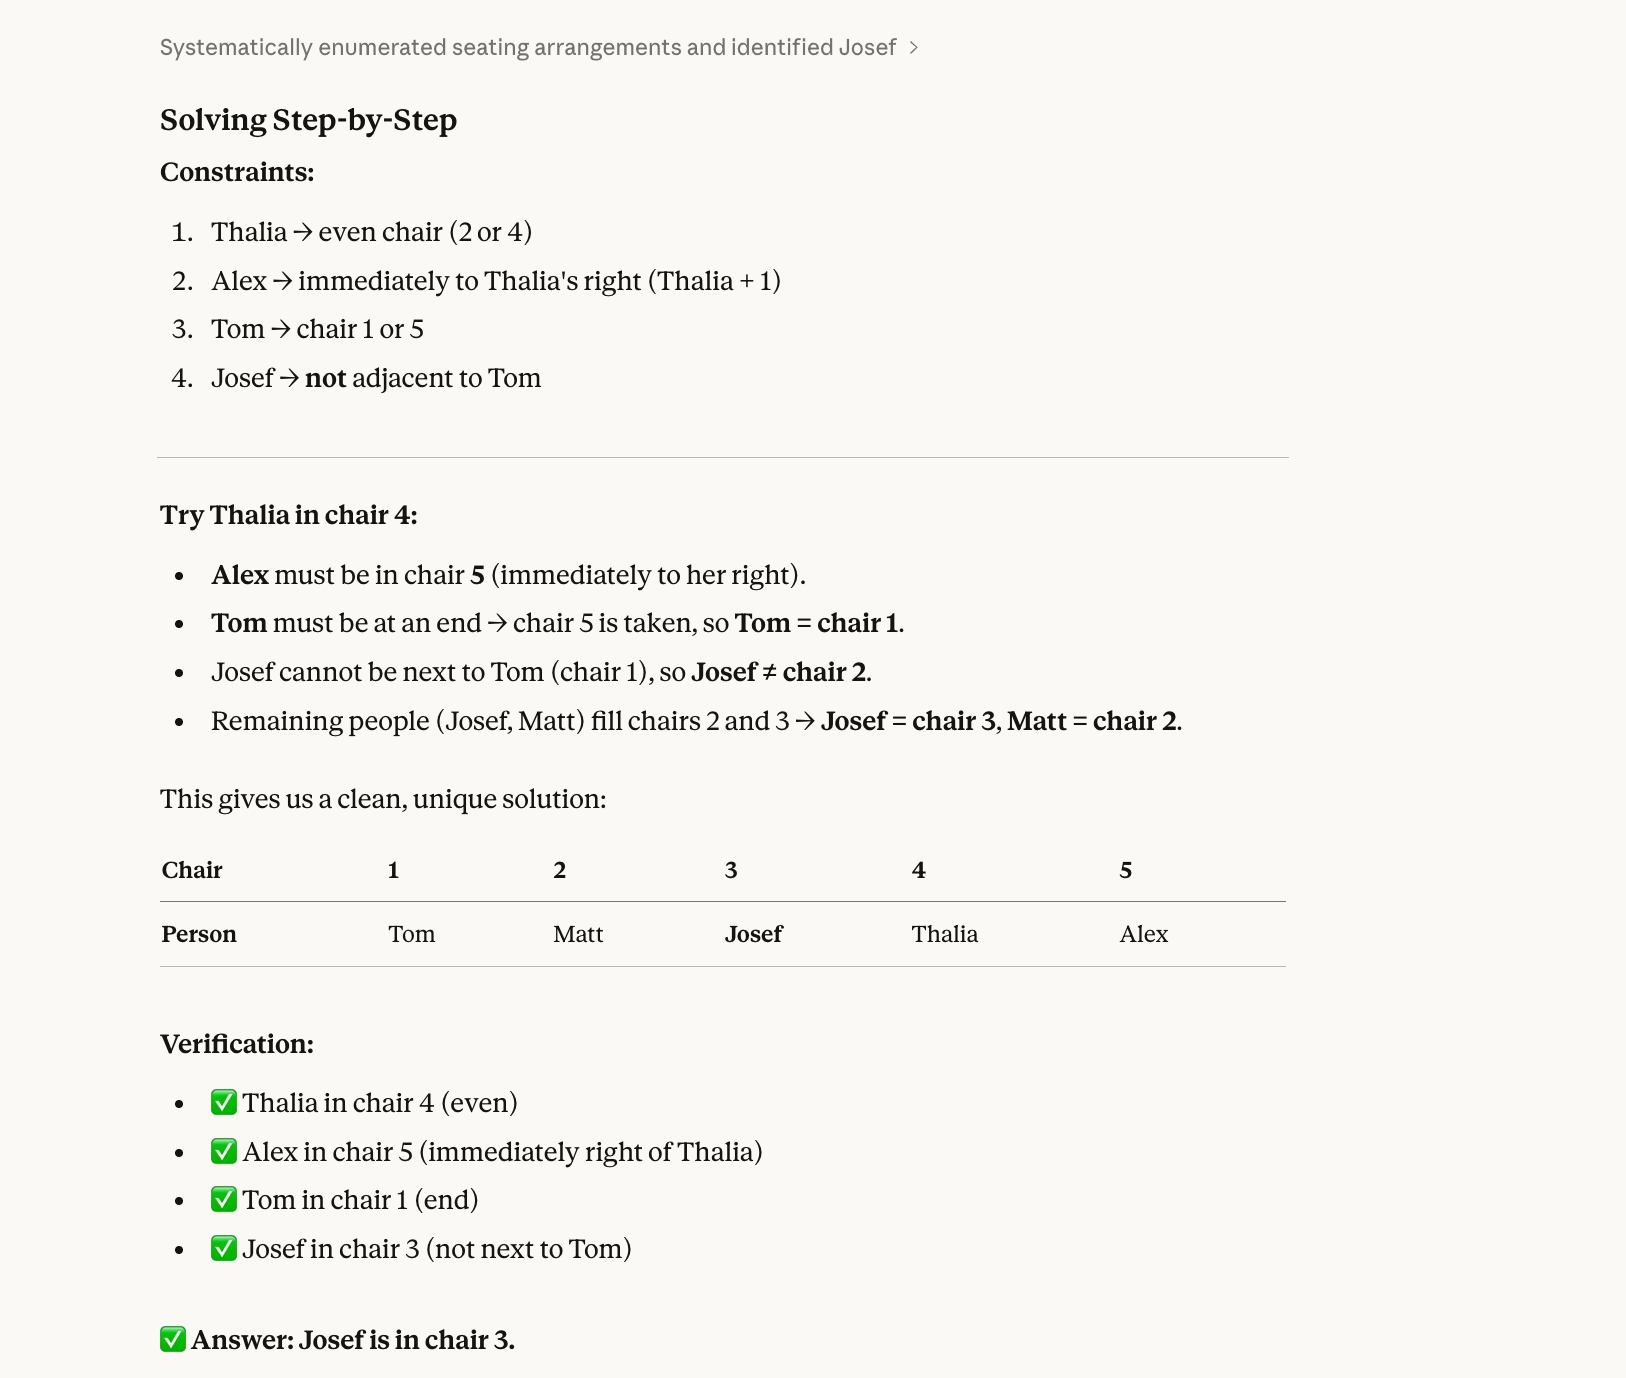
Правильный ответ — Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Это можно вывести на бумаге.
Модели часто ошибаются в такого рода вопросах, потому что решают последовательно, а не целостно. Прочитав «Thalia сидит на чётном месте», выбирают, скажем, 2-й стул, не проверив совместимость со всеми ограничениями, заполняют дальше, натыкаются на конфликт и уже не возвращаются к варианту с 4-м местом.
Opus 4.6 и здесь ответил верно:
Четвёртый тест — на пространственное воображение и физическую интуицию:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
Чтобы проверить ответ, я буквально снял часы и повернул их.
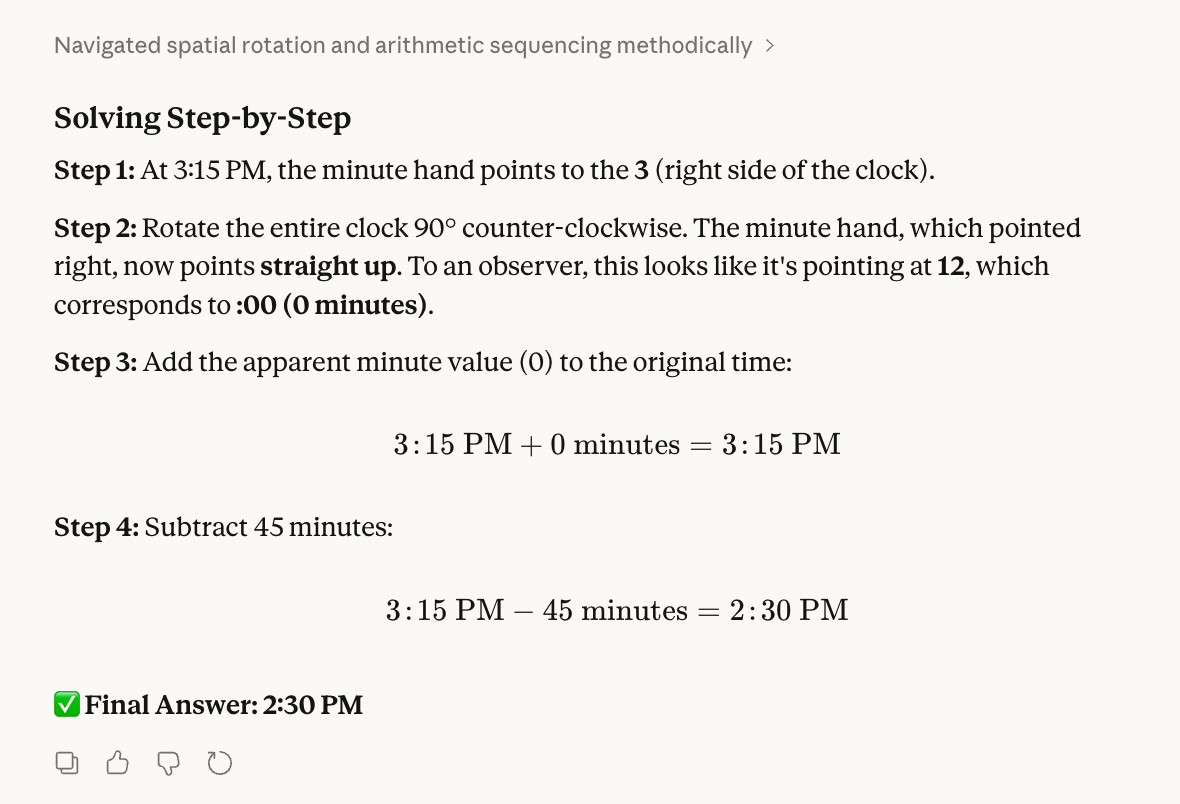
Правильный ответ — 2:30 PM. В 3:15 минутная стрелка указывает на «3». Когда я развернул циферблат на 90° против часовой, «3» оказалась на месте «12». Я добавил 0 к 3:15, вычел 45 минут и получил 2:30 PM.
Мы предполагали, что модели могут спутать поворот циферблата с перемещением стрелки. Также известно, что «добавление 0» кажется подозрительным, и модель попытается «выжать» другое число.
Однако Opus 4.6 решил и эту задачу правильно:
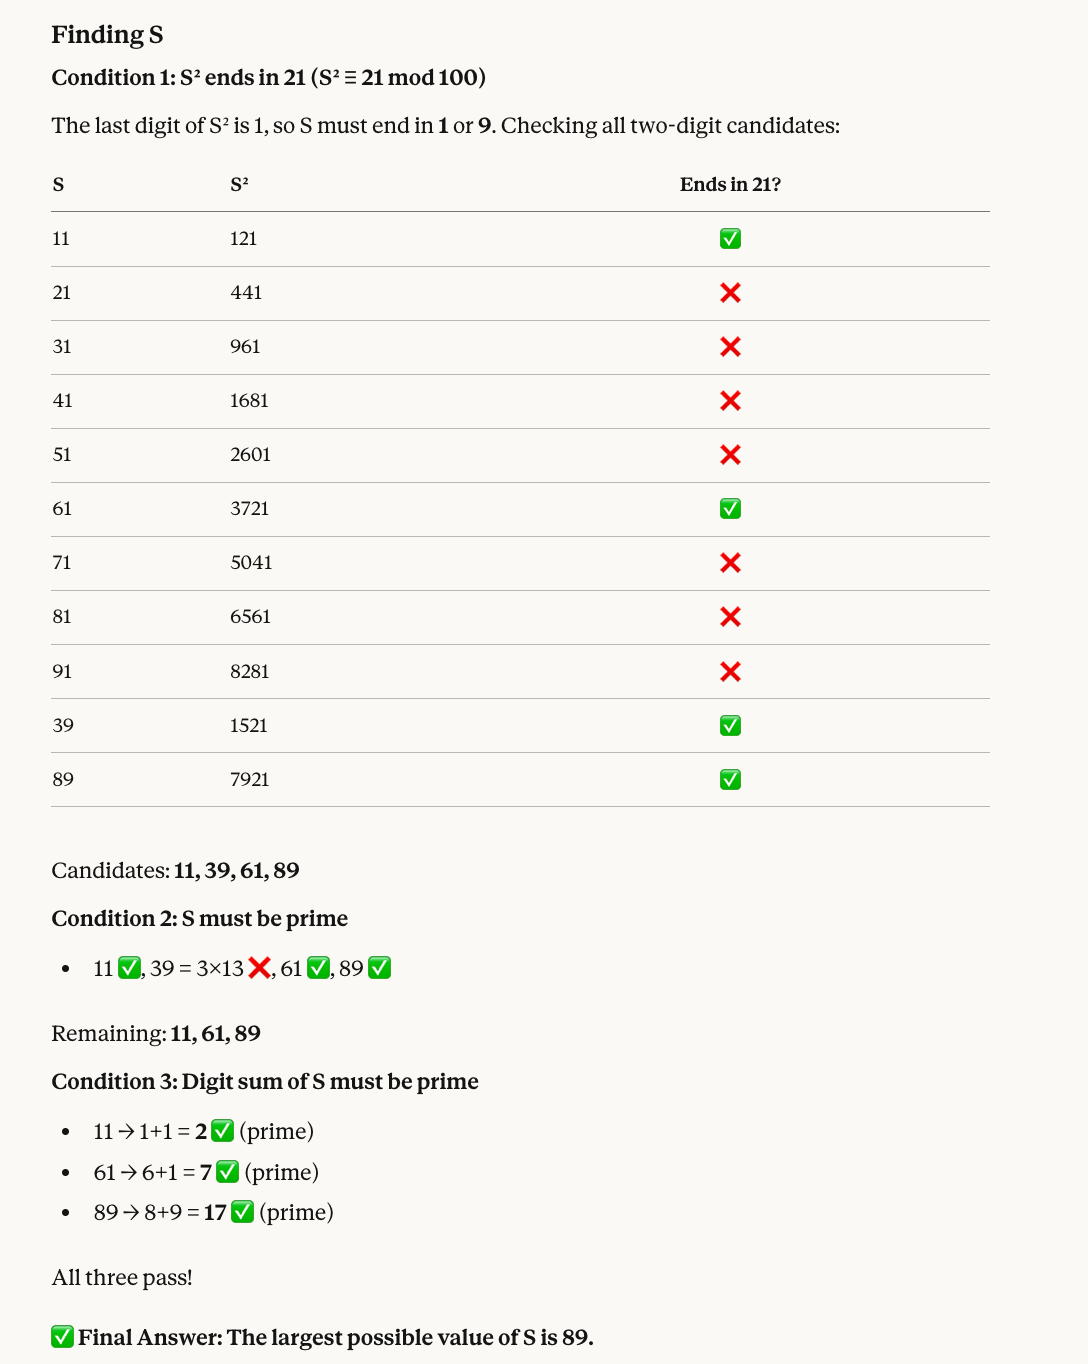
Пятый тест сочетает сравнительную арифметику по модулю и фильтрацию простых чисел:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
Почему ответ — 89: Числа, квадраты которых оканчиваются на 21, включают 11, 39, 61 и 89. Из них 39 — не простое, остаются 11, 61 и 89. Суммы цифр у всех — простые (2, 7 и 17 соответственно), значит, наибольшее — 89.
Opus 4.6 снова дал правильный ответ и даже сопроводил его наглядной визуализацией:
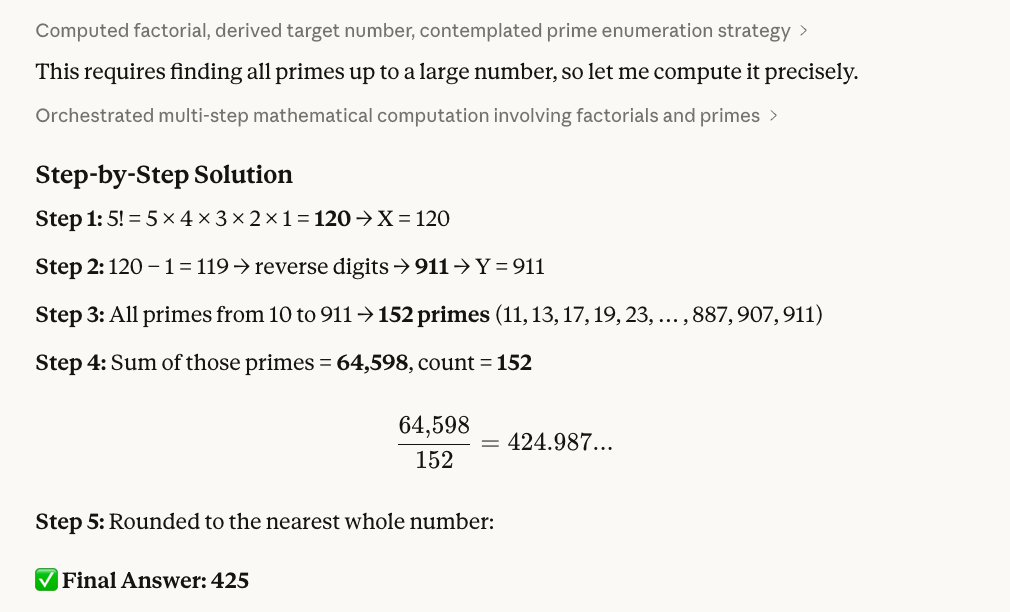
Далее — цепочка из факториала, строковых операций и простых чисел:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
Проверка ответа 425: 5! = 120; вычитаем 1 — получаем 119; разворачиваем цифры — 911. В R (см. ниже) получаем 152 простых между 10 и 911, их сумма — 64 598. Делим и округляем: 64 598 ÷ 152 ≈ 425.
Вот использованный скрипт на R:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Следующий тест проверяет одну из главных заявленных сильных сторон Opus 4.6 — диагностику ошибок в коде. Известно, что модели часто корректно «протаптывают» код построчно, но не связывают это с корневой причиной.
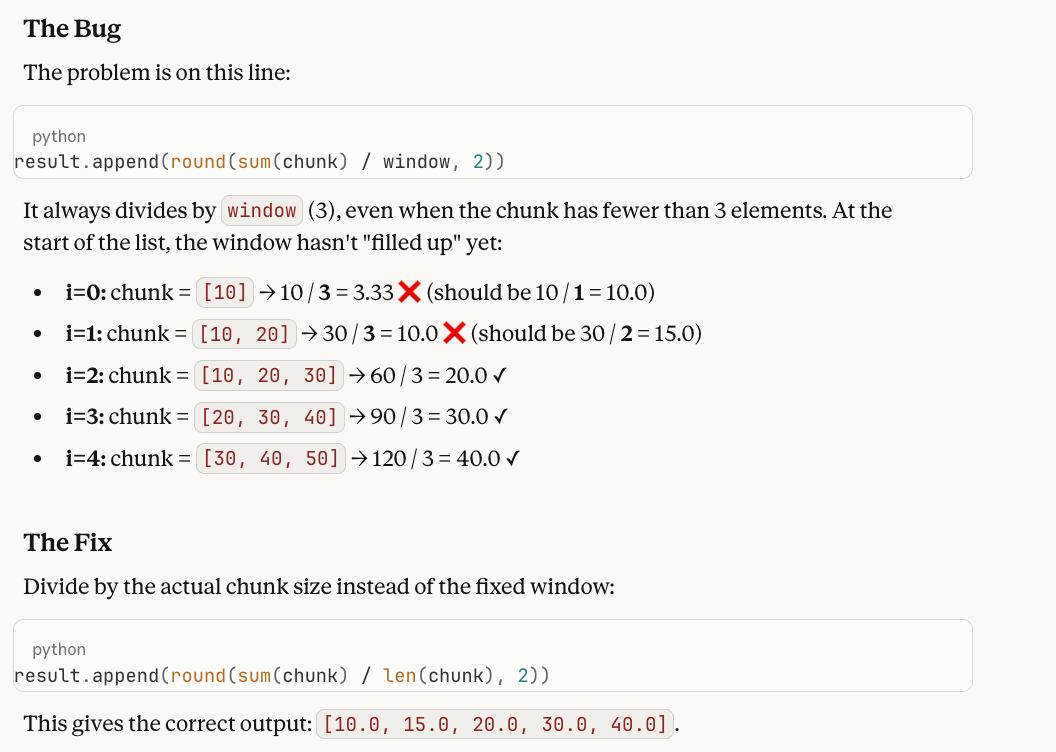
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
Ответ и объяснение: функция всегда делит на window (3), даже когда в начале списка в chunk меньше 3 элементов. Баговый вывод — [3.33, 10.0, 20.0, 30.0, 40.0], но первыми двумя значениями должны быть 10.0 и 15.0, так как в соответствующих фрагментах 1 и 2 элемента. Исправление — заменить / window на / len(chunk).
Нам нравится этот тест, потому что модели нередко идеально проходят цикл, но затем отвечают «вывод выглядит корректным» — они видят шаги вычислений и не замечают, что делить один элемент на 3 — неверно. Здесь нужно удерживать и замысел (что делает скользящее среднее), и исполнение (что делает код) и заметить расхождение.
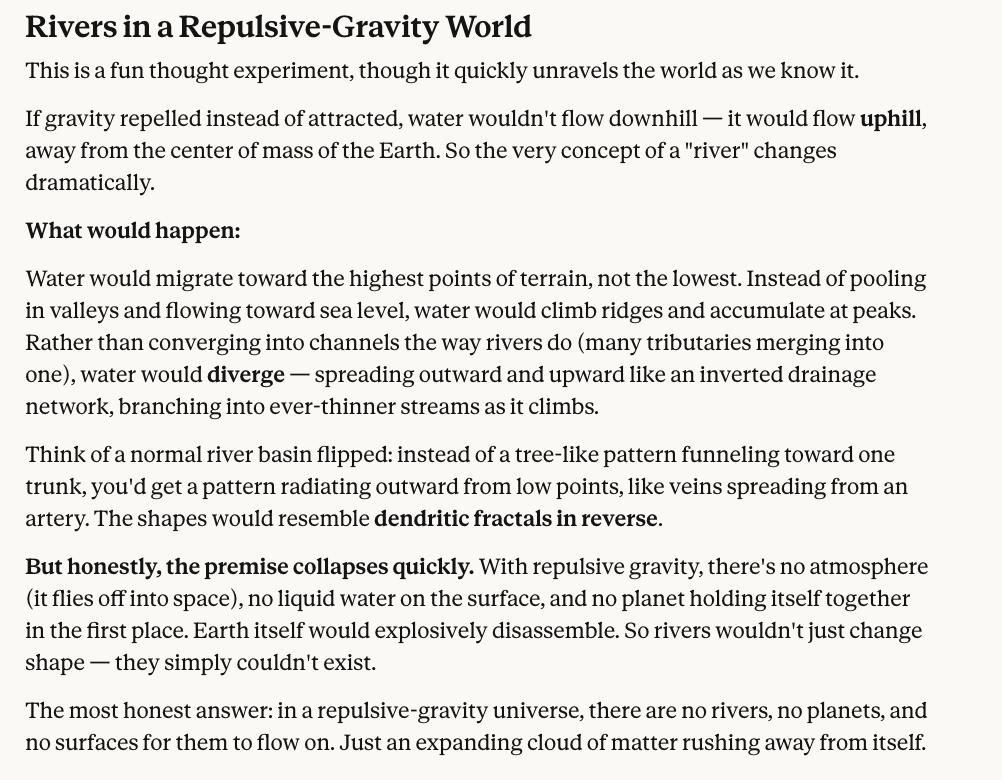
Финальный тест — без математики, только контрфактическое рассуждение.
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Естественно, единственно верного ответа нет, да и представить трудно. Но важно, чтобы модель логично вывела следствия. Нам кажется, что ответ Claude Opus 4.6 выглядит достаточно разумным.
В целом Opus 4.6 показал идеальный результат, хотя, как вы видели, один вопрос был субъективным — последнее слово за вами.
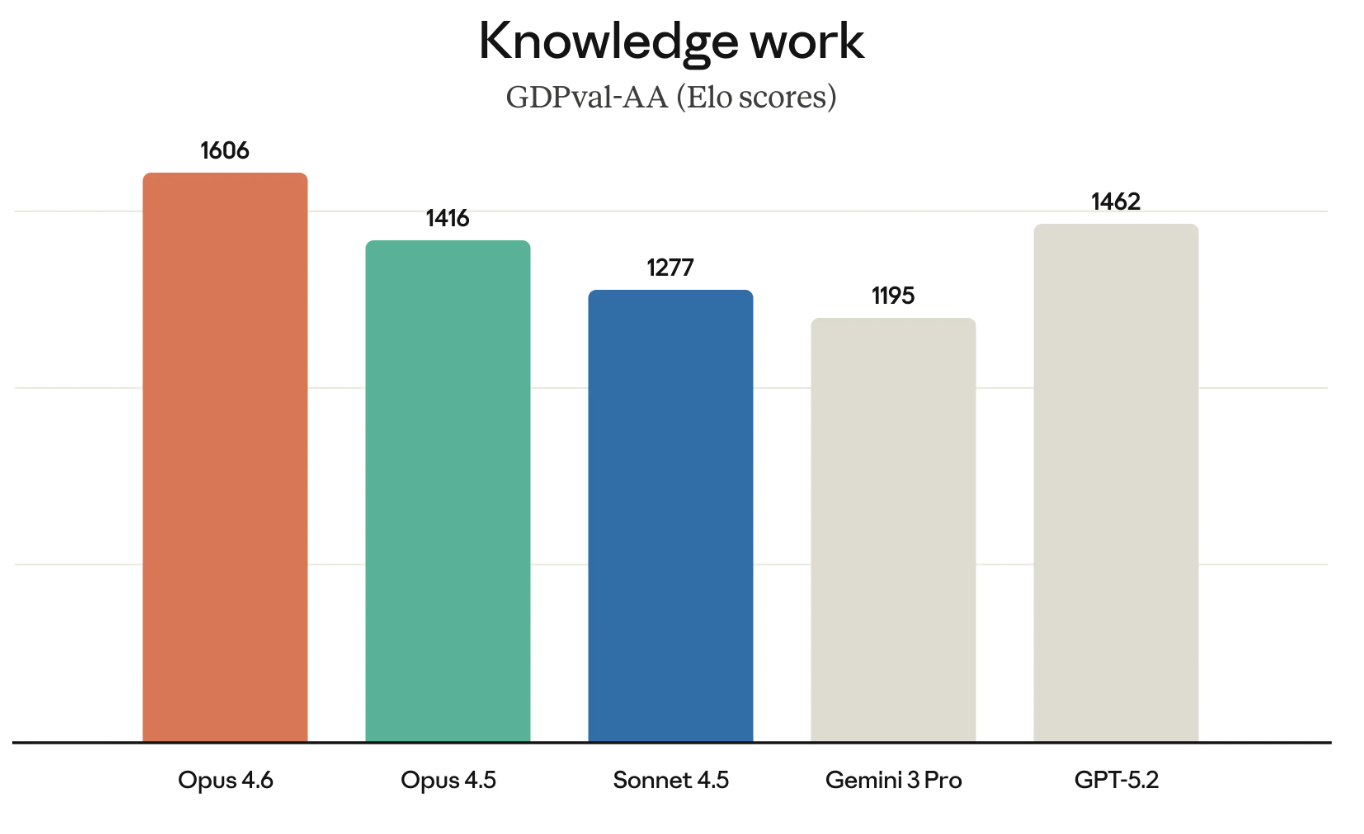
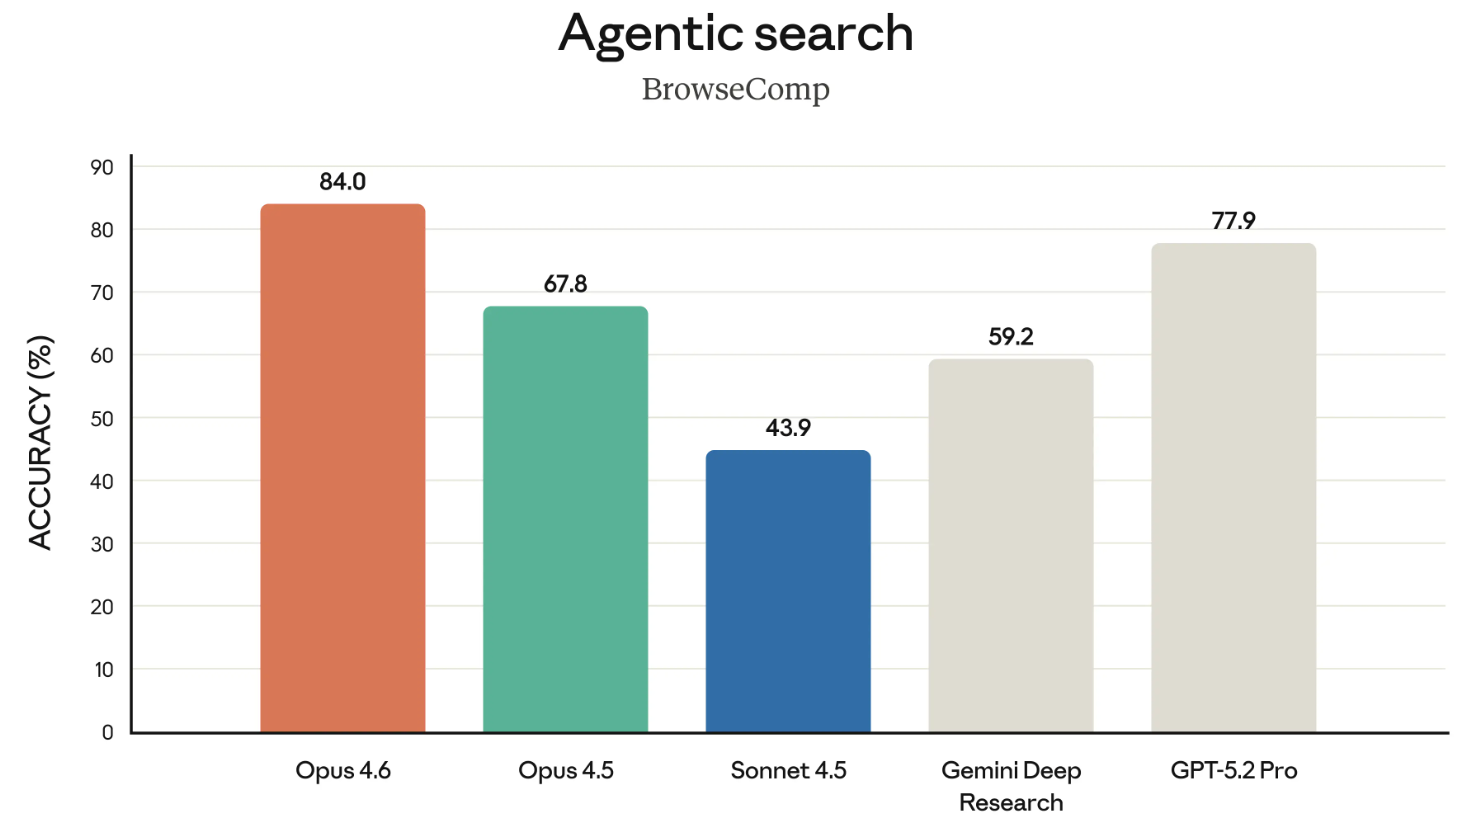
Opus 4.6 — бесспорный лидер как минимум в четырёх важных бенчмарках:
Terminal-Bench 2.0 — бенчмарк агентного кодирования; Humanity’s Last Exam — тест сложного рассуждения; GDPval-AA оценивает производительность в задачах интеллектуального труда; BrowseComp измеряет способность модели находить труднодоступную информацию в интернете.
Модели Claude по праву считаются одними из лучших в коде. Начнём с результатов Terminal-Bench 2.0.
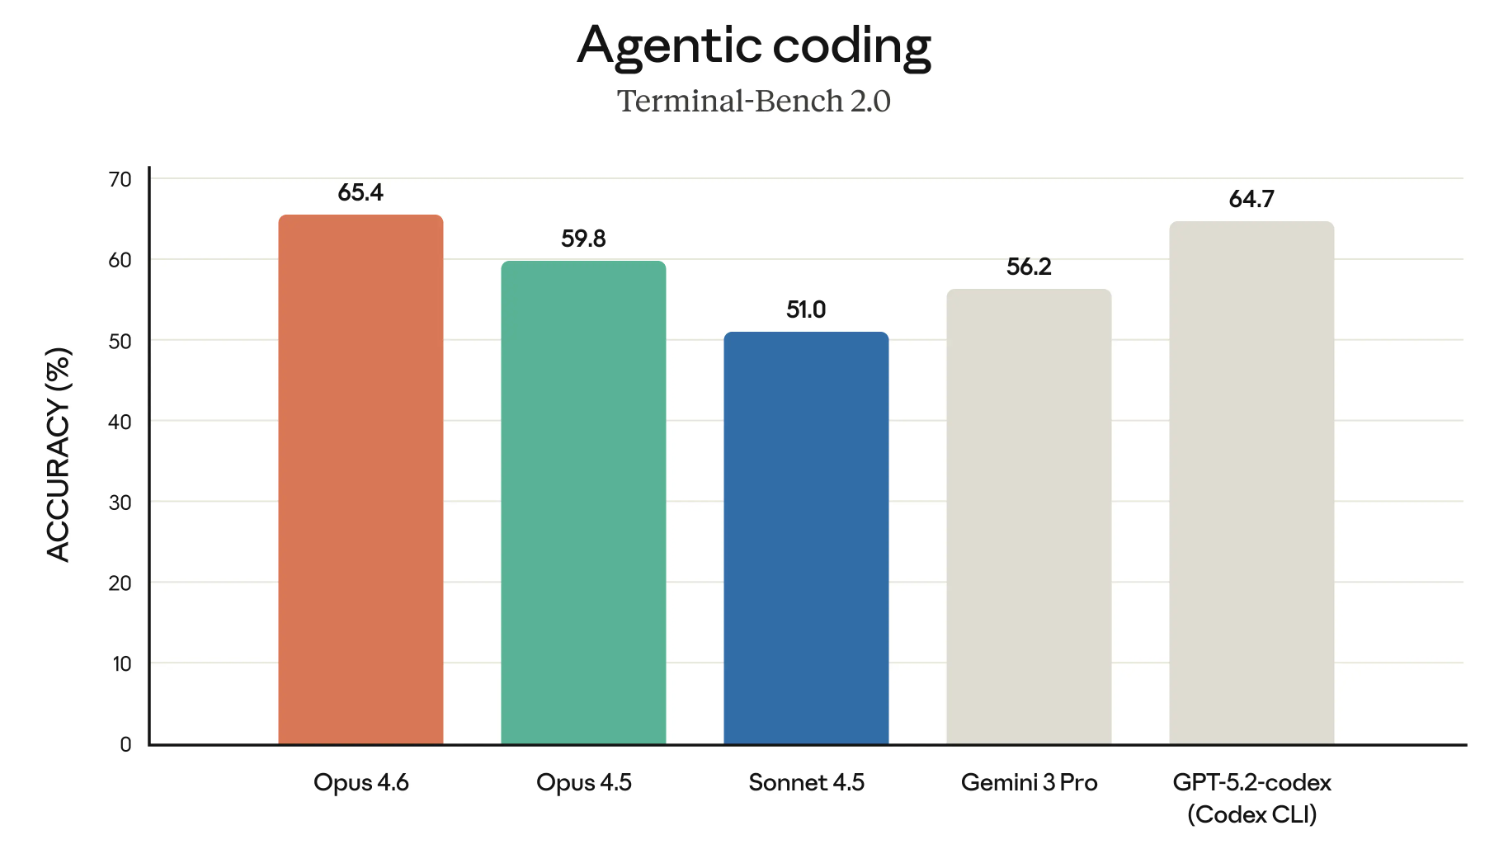
Если график явно сопоставляет Opus 4.6 с GPT-5.2-codex — что ж, это наверняка не случайно. Anthropic в последние месяцы открыто конкурирует с OpenAI по ряду направлений и делает ставку на корпоративных клиентов.
Humanity’s Last Exam — один из самых известных бенчмарков, за которым пристально следят. Он измеряет общую способность модели к рассуждению.
Ниже — успехи передовых моделей на HLE с инструментами и без. («С инструментами» означает доступ к внешним возможностям: веб-поиск, выполнение кода и т. п.)
График, возможно, стоило бы разделить на два. Но главное ясно: Opus 4.6 лидирует и «с инструментами», и «без инструментов».
GDPval-AA (что видно из названия) — тест экономически ценного интеллектуального труда: финансовое моделирование, ресёрч и т. п.
GDPval-AA и похожие бенчмарки становятся всё важнее, потому что они измеряют реальную работу, за которую платят компании. Успех Opus 4.6 в GDPval-AA — ещё один прямой вызов линейке GPT, поскольку OpenAI и Anthropic борются за одних и тех же клиентов.
BrowseComp — последний важный бенчмарк из релиза. Он измеряет способность модели находить сложную для поиска информацию в сети. Исторически OpenAI разработала BrowseComp, чтобы продемонстрировать поисковые возможности своих моделей.
Примечательно, что в этом релизе Anthropic напрямую сослалась на апрельское объявление OpenAI 2025 года о BrowseComp, подчёркивая, что Opus 4.6 возглавляет этот рейтинг. Такой лёгкий «укол» — цитировать бенчмарк OpenAI против них же.
На момент публикации Opus 4.6 широко доступен. Однако доступ к Opus 4.6 возможен только при переходе на pro-аккаунт, который даёт и другие преимущества, например, использование Claude в Excel.
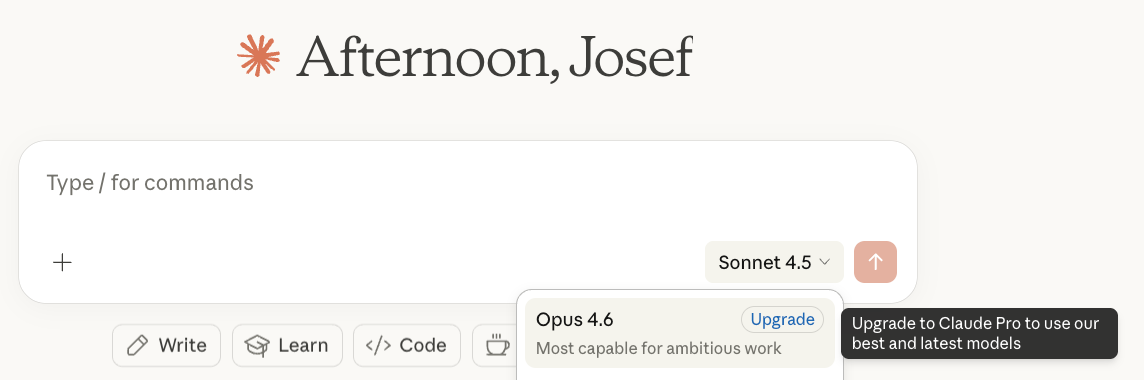
Если вы разработчик, используйте claude-opus-4-6 в Claude API. Цены не изменились: по-прежнему $5/$25 за миллион токенов. Если путают два числа: первое — стоимость токенов, которые вы отправляете модели (ваши запросы), второе — стоимость сгенерированных моделью токенов (ответы).
Claude Opus 4.6 лидирует в важных бенчмарках, таких как GPDVal-AA, который оценивает, как хорошо модель справляется с экономически значимыми задачами — именно это волнует крупных корпоративных клиентов. Возможно, OpenAI это задело: за считаные часы до релиза Opus 4.6 они анонсировали OpenAI Frontier — новую корпоративную платформу для создания, развёртывания и управления ИИ-агентами в продакшене.
Иными словами, вместо конкуренции в бенчмарках Frontier показывает фокус OpenAI на инфраструктуре вокруг моделей — предоставлении агентам общего бизнес-контекста, прав доступа и возможности получать и усваивать обратную связь. Уступая в бенчмарках, OpenAI сигнализирует, что их платформа лучше приспособлена к реальной пользе агентов в компании.
Является ли это стратегическим поворотом или негласным признанием, что гонка моделей проигрывается — решать вам.
В целом мы впечатлены тем, что предлагает Anthropic с Claude Opus 4.6, и с интересом ждём практики с командами агентов. Если хотите больше узнать о семействе Claude, обязательно загляните на курс Introduction to Claude Models.
Учите ИИ с DataCamp
Course
Course
Course