course
Introduktion till Claude-modeller
3 timmar
14.3K
Rykten om Anthropics nästa lansering har mullrat de senaste dagarna. Många väntade sig Claude Sonnet 5, men årets första släpp kommer i form av Claude Opus 4.6.
Med ett kontextfönster på 1 miljon token, adaptivt tänkande, kondenserade konversationer och en rad topplaceringar på benchmarktester är Claude Opus 4.6 en förbättring av Opus 4.5. Som Anthropic uttrycker det har de uppgraderat sin smartaste modell. Samtidigt lanserade Anthropic även agentteam i Claude Code och Claude i PowerPoint.
I den här artikeln går vi igenom allt som är nytt med Claude Opus 4.6, tittar på de nya funktionerna, utforskar benchmarkresultaten och utsätter modellen för flera praktiska exempel.
För att lära dig mer om några av de senaste Claude-funktionerna rekommenderar jag våra guider till Claude Cowork och Claude Code samt vår OpenClaw-handledning. För jämförelser med andra konkurrenter, läs våra guider om Muse Spark vs Claude Opus 4.6 och GPT-5.4 vs Claude Opus 4.6.
Claude Opus 4.6 är Anthropics senaste stora språkmodell. Som en uppföljning på Opus 4.5 innebär den en betydande uppgradering av företagets ”smartaste” modelldivision.
I släppbloggen hävdar Anthropic att fokus ligger mer på agentisk kodning, djupt resonemang och självkorrigering. Det innebär ett skifte från handling till uthållig handling.
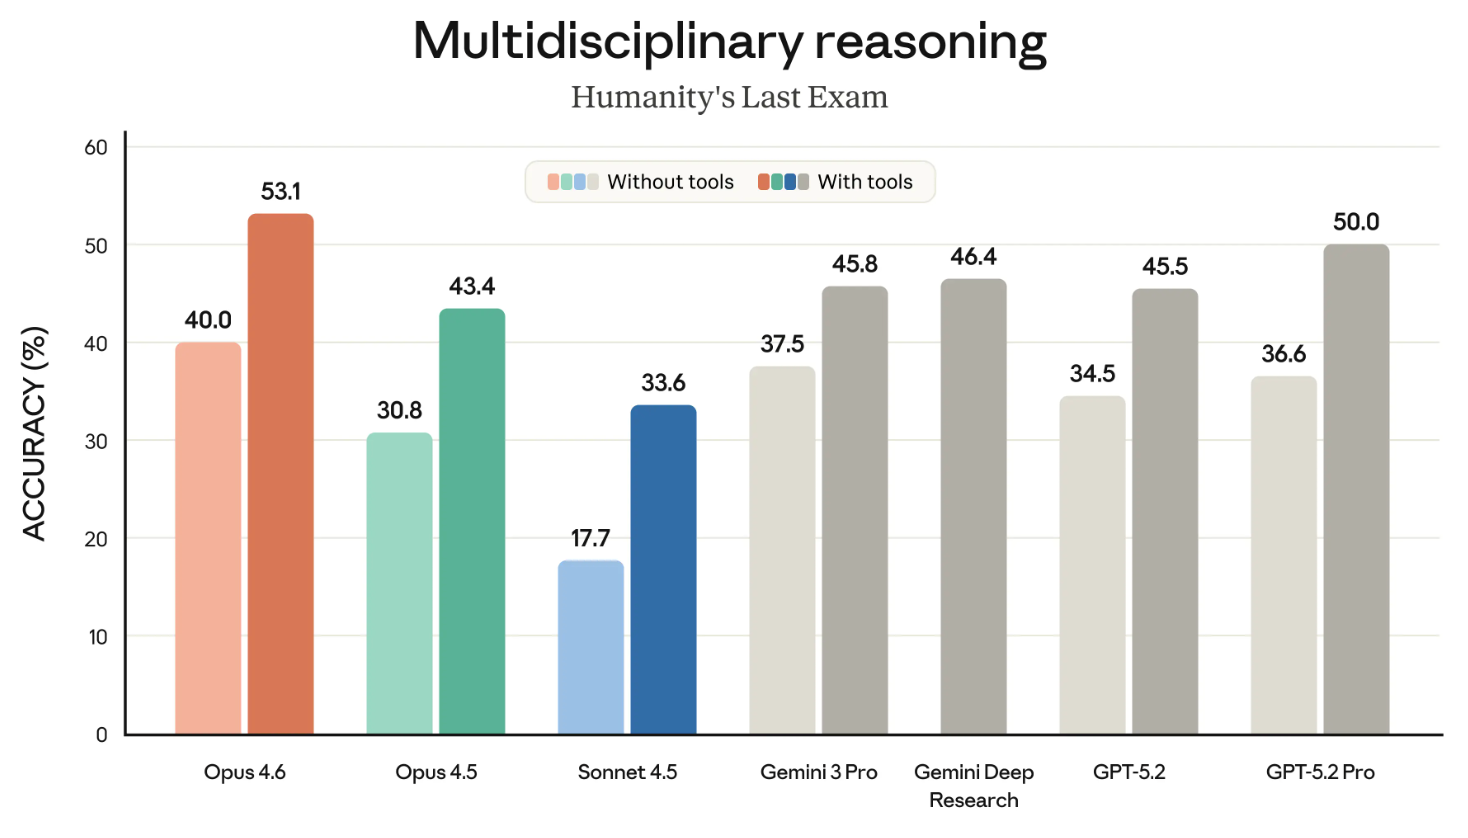
Opus 4.6 är utformad för att planera mer noggrant, har förbättrad sammanhållning över längre tidsförlopp och identifierar fel i sitt eget arbete. Allt detta gör att Claude Opus 4.6 toppar flera benchmarks, inklusive högsta poäng på Terminal-Bench 2.0 för kodning och att den slår alla andra frontmodeller på Humanity’s Last Exam.
En sak som verkligen sticker ut är det förbättrade kontextfönstret i Claude Opus 4.6. Med 1 miljon token i betan hamnar den nya modellen i nivå med Gemini 3, vilket innebär att den kan bearbeta mer information utan att tappa sammanhang.
Under tiden har Anthropic publicerat efterföljaren till Opus. Jag rekommenderar att du läser vår guide till Claude Opus 4.7 för att hålla dig uppdaterad.
Det finns flera nya, anmärkningsvärda funktioner i Claude Opus 4.6, många med fokus på agentiska arbetsflöden. Här är några huvudpunkter:
Agentteam är en förbättring av de ”underagenter” vi sett i tidigare versioner av Claude. Med agentteam kan du starta flera, helt oberoende Claude-instanser som arbetar parallellt. En session är ”huvudagenten” som koordinerar, medan ”lagkamrater” sköter själva utförandet.
Det mest intressanta är att varje lagmedlem har sitt eget kontextfönster, vilket möjliggör mer grundligt arbete. Varje lagkamrat kan också kommunicera direkt med de andra i teamet.
Självklart finns en potentiell nackdel – kostnaden. Eftersom varje agent har sitt eget kontextfönster kan tokenförbrukningen snabbt dra iväg. Anthropic rekommenderar därför att du använder detta vid scenarier med högre komplexitet.
En smidig funktion i Claude Opus 4.6 är kontextkomprimeringen. Denna ”quality-of-life”-förbättring hjälper dig att undvika problem när du kör långa arbetsflöden som fyller kontextfönstret till max. Vanligtvis når du en kontextvägg där prestandan börjar försämras.
Med kondenserade konversationer kan Claude Opus 4.6 automatiskt upptäcka när en konversation närmar sig en tokentröskel och sammanfatta den befintliga konversationen till ett kort block (ett komprimeringsblock).
Detta bör bidra till att bevara det väsentliga i dina interaktioner samtidigt som det frigör utrymme för att fortsätta arbetet. Om du planerar att använda uppgiftsorienterade agenter som behöver köras länge kan detta hjälpa dem att hålla kursen med ett mycket förbättrat minne.
Det finns två funktioner i Claude Opus 4.6 som avgör om utökat tänkande behövs och hur hårt den ska anstränga sig när det används.
Adaptivt tänkande gör att modellen kan avgöra hur komplex din prompt är. Baserat på enkelhet eller komplexitet avgör den om utökat tänkande ska användas. I stället för att ha en manuell inställning för hur många token som används för detta kommer Claude att justera sin budget utifrån varje förfrågans komplexitet.
Parametern ”effort” (ansträngning) låter dig ange hur villig eller återhållsam Claude ska vara med att spendera token. I praktiken innebär det att du kan balansera tokeneffektivitet mot hur grundliga svaren är.
När du använder Claude Opus 4.6 i API:et kan du ställa in dessa parametrar manuellt. Till exempel:
Vi pratade nyligen om Claude i Excel och visade hur tillägget kan hjälpa dig med olika uppgifter i en sidopanel i ditt Excel-ark. Förutom att förbättra funktionaliteten i detta verktyg meddelade Anthropic också Claude i PowerPoint.
Denna integration respekterar dina bildmästare, typsnitt och layouter. Du kan mata in en företagsmall och be den bygga en specifik sektion, eller markera en bild och be den omvandla kompakt text till ett inbyggt, redigerbart diagram.
Fokus på att skapa redigerbara PowerPoint-objekt i stället för bara ”bilder av slides” gör detta till ett verkligt produktivitetsverktyg snarare än bara en idégenerator.
Claude i PowerPoint är för närvarande i forskningsförhandsvisning för Max- och Enterprise-användare.
Många av Opus 4.6:s huvudpåståenden kretsar kring svårare kodningsuppgifter och djupare resonemang. Dessa färdigheter vilar på en grundläggande förmåga: att hålla flera begränsningar i minnet, resonera i många steg och fånga upp misstag.
Med detta i åtanke utsatte vi Opus 4.6 för en serie flerstegsutmaningar i logik, matematik och kodning. Vi ville se om vi kunde avslöja några kända och vanliga svagheter hos LLM:er – sådant som kaskadfel i beräkningar, rumsligt resonemang (alltid en utmaning) och frågor som involverar begränsningar. Vi inkluderade också en specifik felsökningsuppgift eftersom Anthropics tillkännagivande skröt om hur bra Opus 4.6 är på grundorsaksanalys och andra felsökningsproblem.
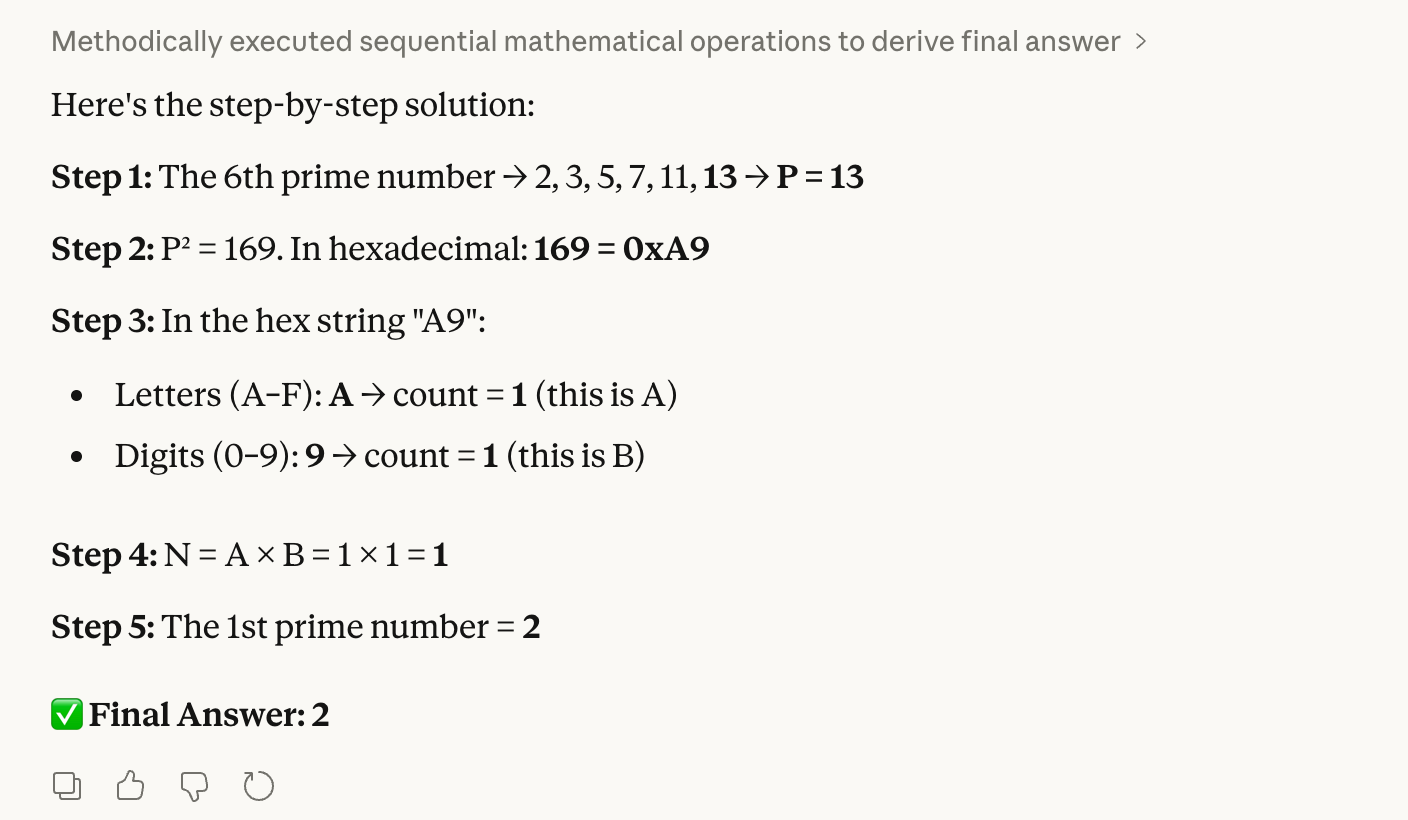
Vårt första test kombinerar primtal, hexadecimala tal och räkning:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
Det låter lite komplext, men testet är ganska lätt för oss människor att verifiera. Det korrekta svaret vi vet är 2 eftersom det 6:e primtalet är 13; 13 i kvadrat är 169, vilket är ”A9” i hex. Det har 1 bokstav × 1 siffra, vilket blir 1 när vi multiplicerar dem, och det första primtalet är 2.
Rädslan är att en modell kan snubbla på hexkonverteringen, vilket skulle leda till ett helt fel slutresultat. Som du ser hade Opus 4.6 inga problem:
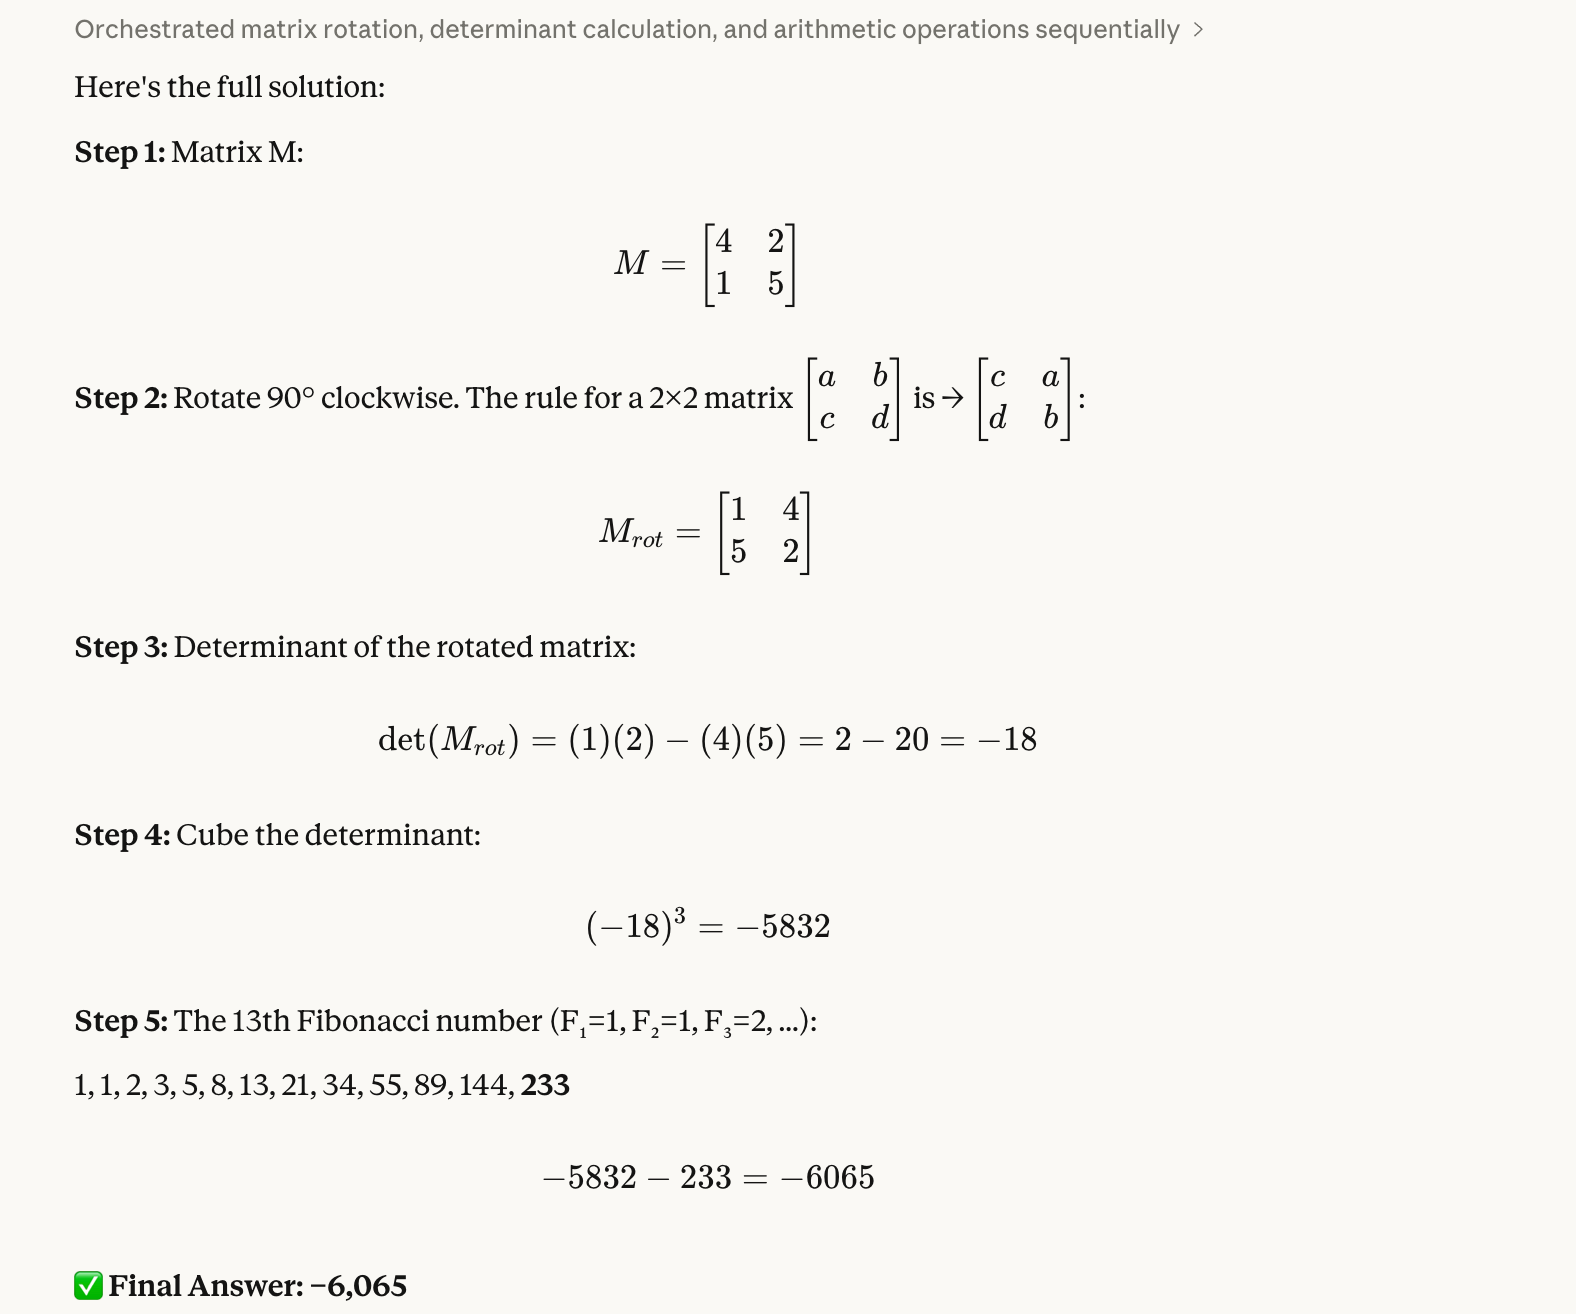
Vårt andra test prövar rumsligt resonemang och hantering av negativa tal:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
Detta krävde lite mer arbete att verifiera. Det korrekta svaret är -6 065. Vi vet detta eftersom den roterade matrisen är [[1, 4], [5, 2]]; vi kan sedan använda Python för att hitta determinanten, som är -18, och när vi kuberar detta tal får vi -5 832; slutligen subtraherar vi 233 och får -6 065.
Vi gillade idén med testet eftersom vi vet av erfarenhet att modeller ofta byter matriselement felaktigt eller tappar det negativa tecknet halvvägs. Även här hade Opus 4.6 inga problem:
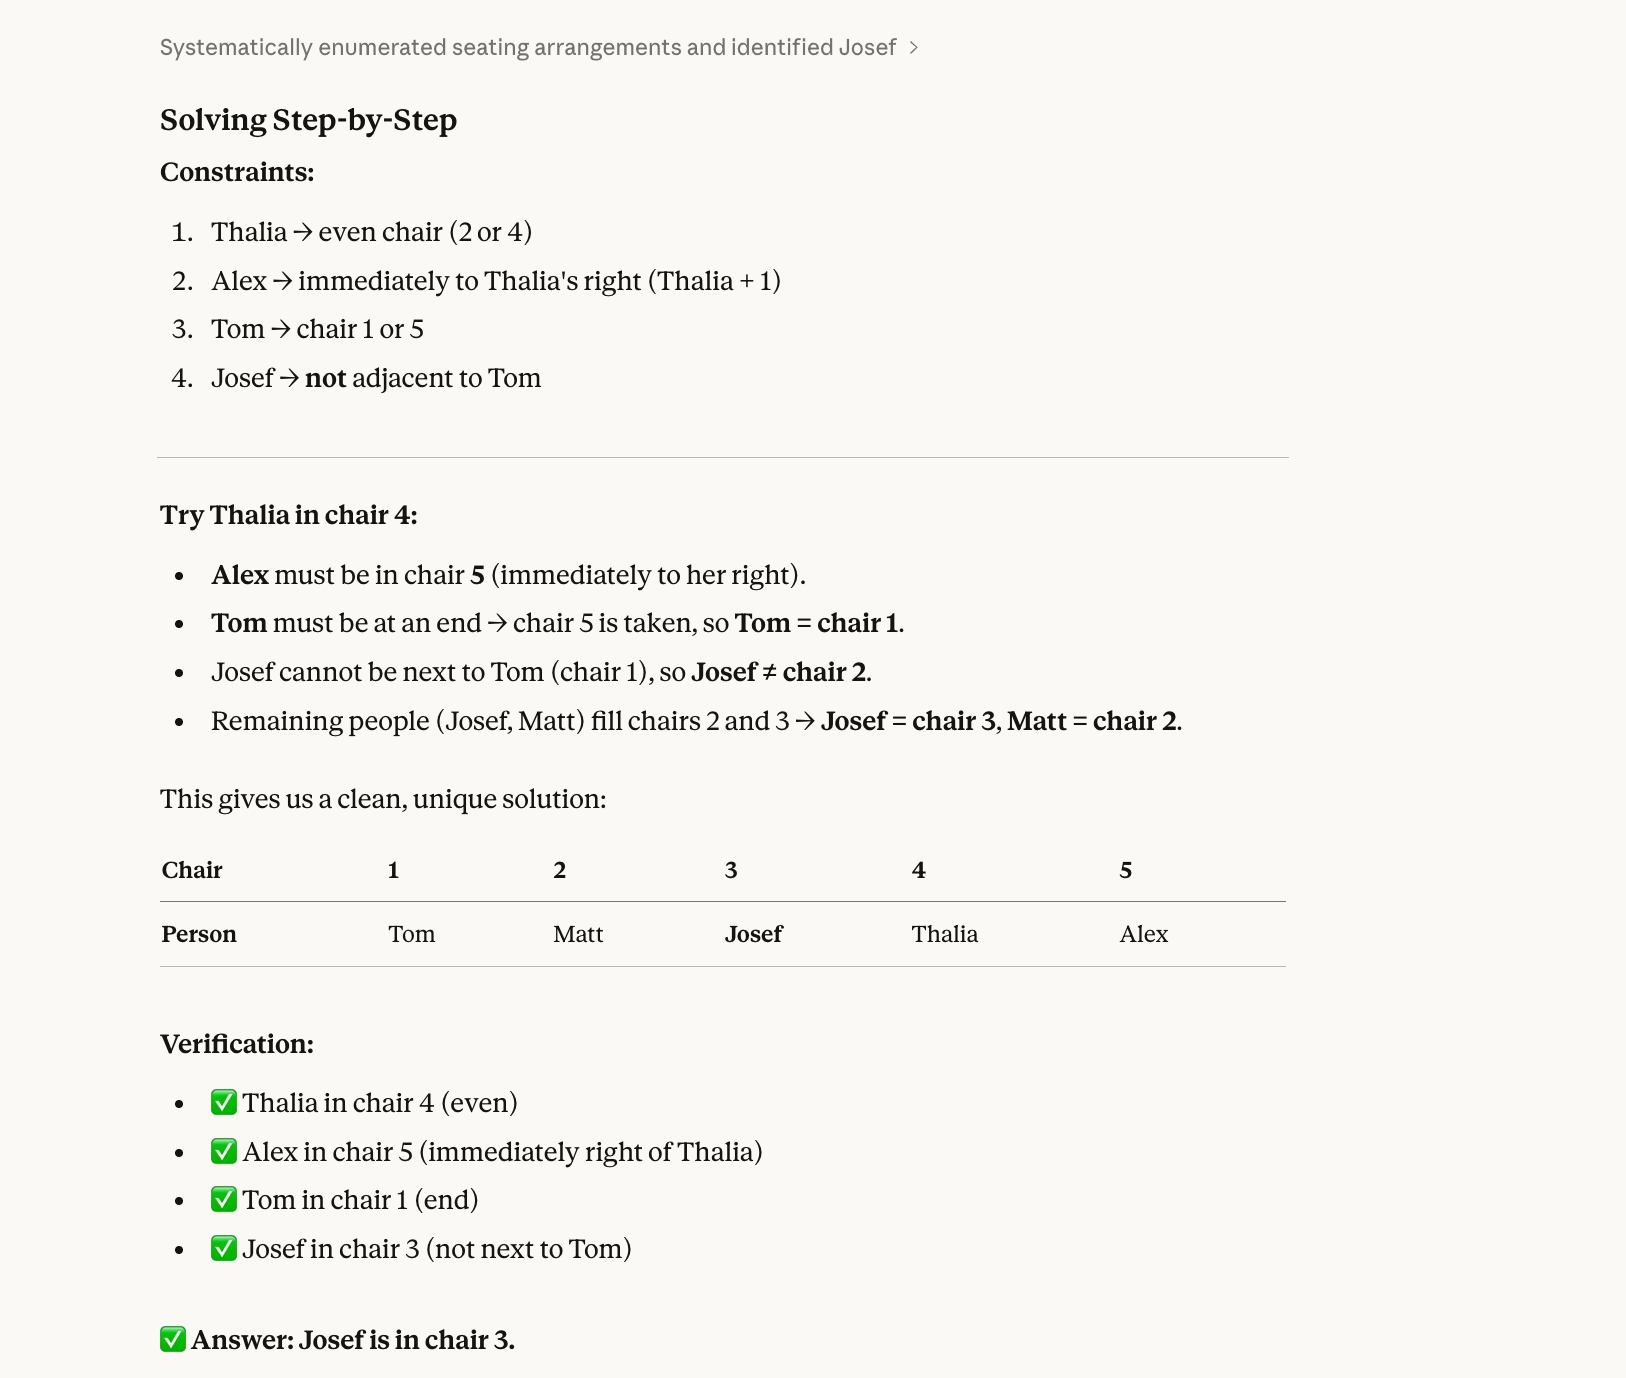
I vårt tredje test försökte vi oss på ett begränsningsproblem som kräver backtracking:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
Det korrekta svaret är Josef. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) Du kan räkna ut detta på papper med lite möda.
Anledningen till att en modell kan svara fel här är att modeller historiskt har löst sekventiellt, inte holistiskt. De läser ”Thalia sitter på en jämn stol” och väljer en (säg stol 2) utan att kontrollera om det valet fungerar med alla andra begränsningar. Sedan låser de sig vid det, fyller i fler stolar och stöter till slut på en konflikt, men då har de skrivit in sig i ett hörn och går inte tillbaka och provar Thalia på stol 4 i stället.
Opus 4.6 fick även detta rätt:
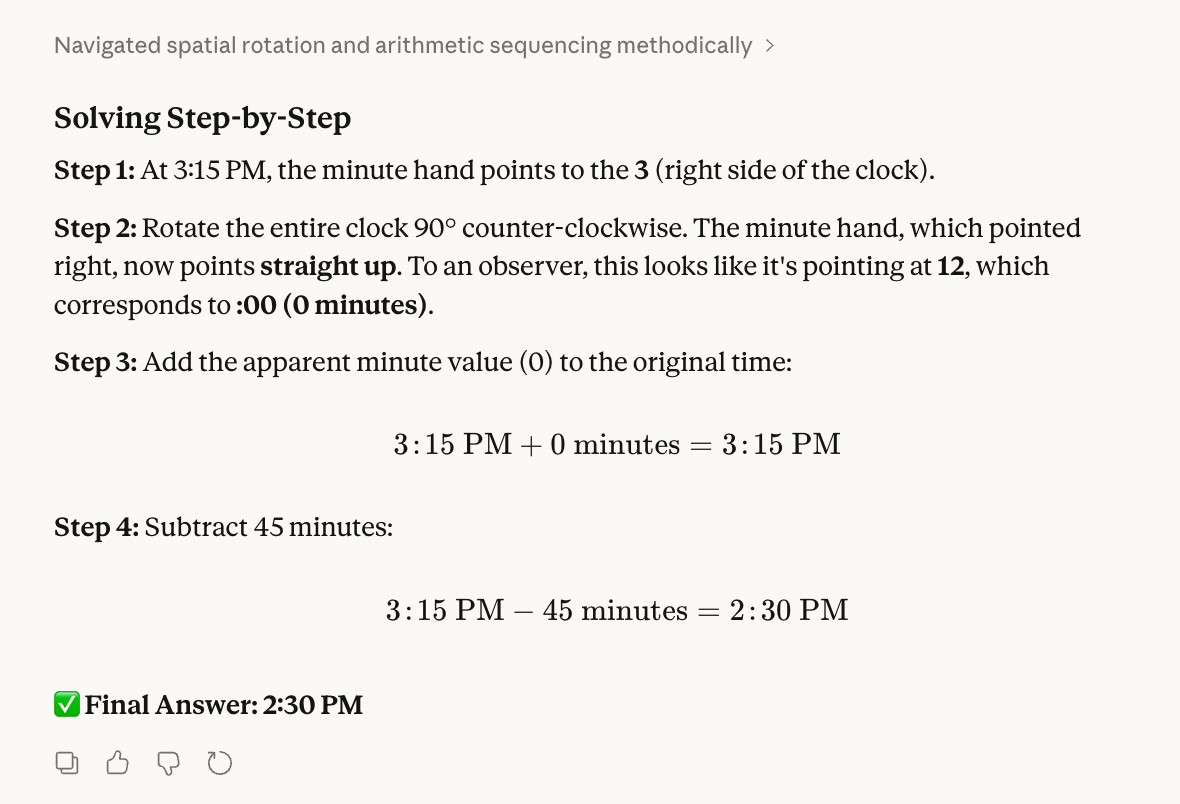
Vårt fjärde test utvärderar rumslig visualisering och fysisk intuition:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
För att verifiera detta tog jag faktiskt av mig klockan och vred runt den.
Det korrekta svaret är 14:30. Klockan 3:15 pekar minutvisaren på ”3”. När jag riktade 12:an mot fönstret till vänster flyttades ”3” dit ”12” var. Jag lade sedan till 0 till 3:15, drog ifrån 45 minuter och fick 14:30.
När vi utformade testet förväntade vi oss att modeller skulle blanda ihop att rotera urtavlan med att flytta visaren. Vi har också hört att modeller tenderar att betrakta addition med 0 som misstänkt och därför försöker tvinga fram ett annat tal.
Men Opus 4.6 lyckades lösa detta problem; den fick även här rätt svar:
Vårt femte test kombinerar modulär aritmetik med primtalsfiltrering:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
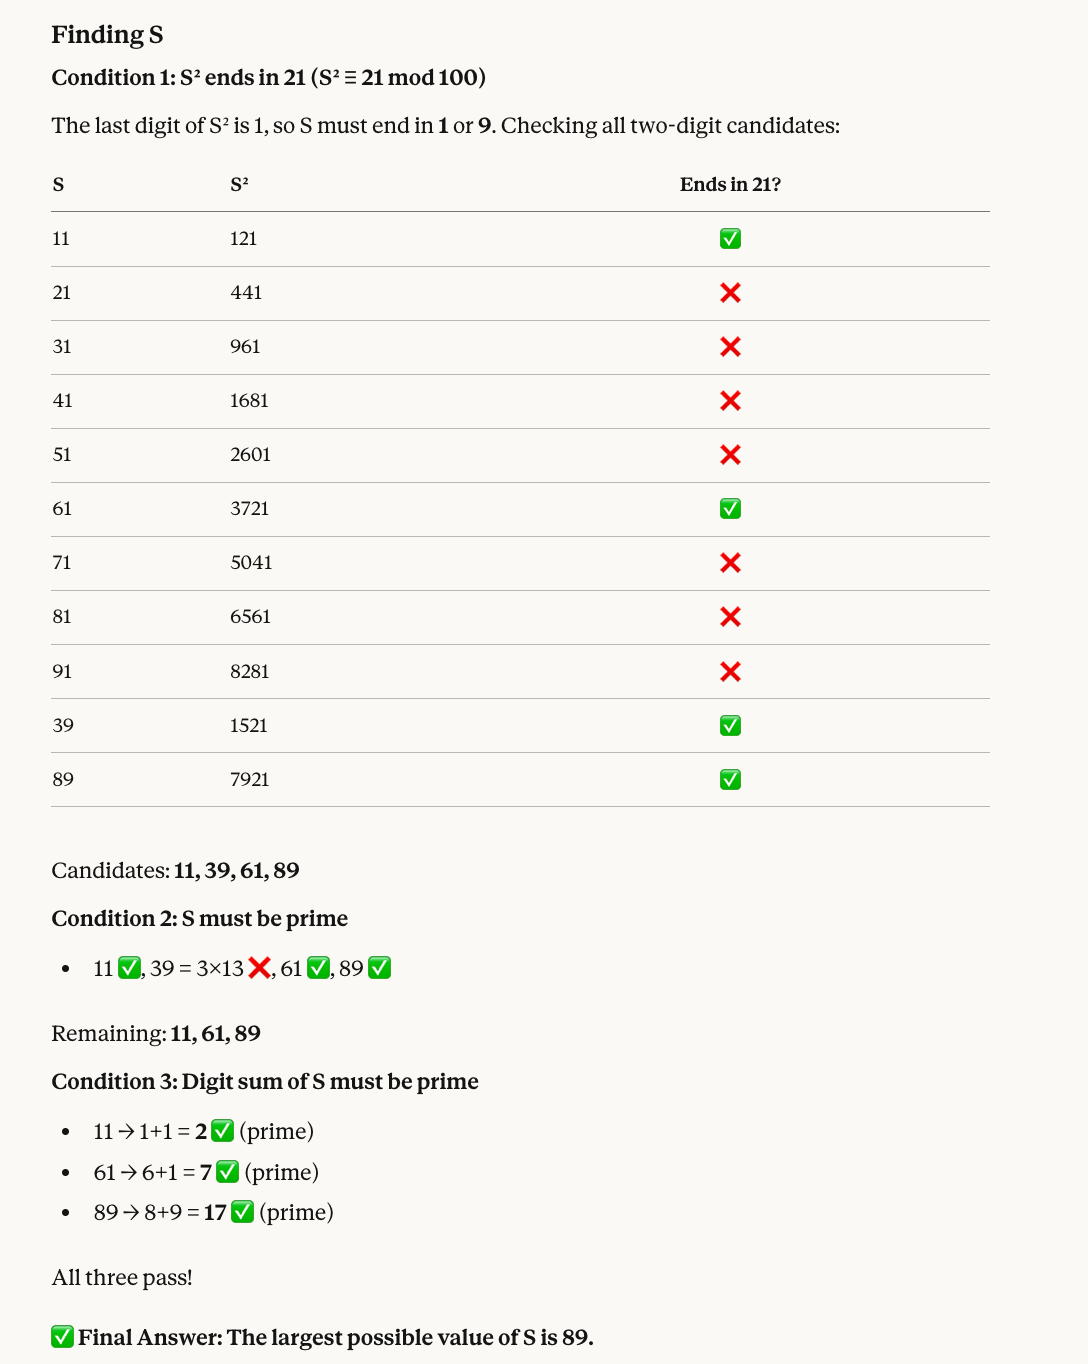
Därför är det korrekta talet 89: Tal vars kvadrater slutar med 21 inkluderar 11, 39, 61 och 89. Av dessa är 39 inte ett primtal, så kvar blir 11, 61 och 89. Alla tre har siffersummor som är primtal (2, 7 respektive 17), så det största är 89.
Opus 4.6 gav rätt svar igen, och den här gången med en hjälpsam visualisering:
Nästa test kedjar ihop fakultetsberäkning, stränghantering och primtal:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
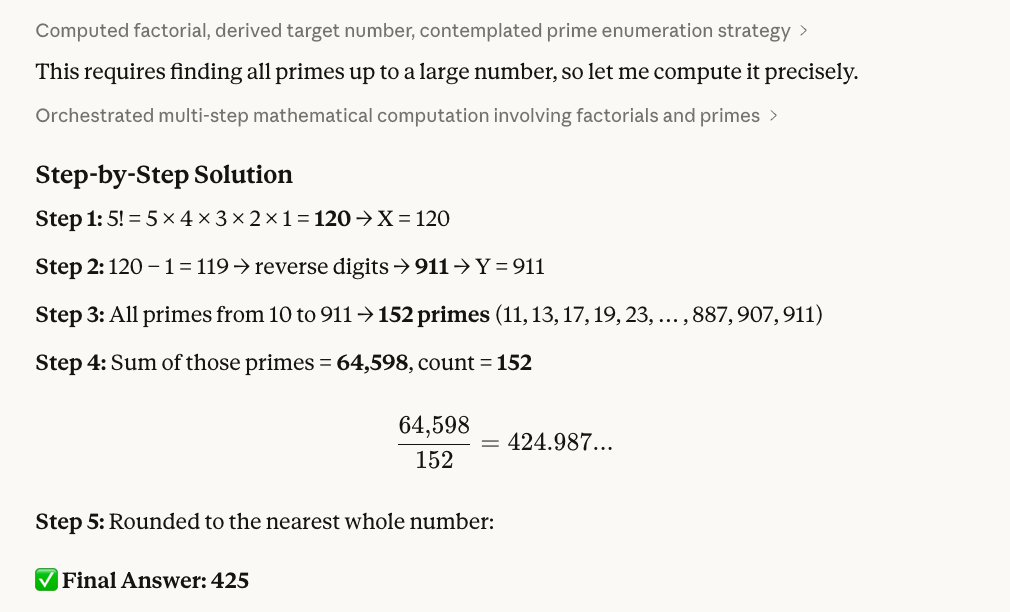
Så här verifierade vi 425 som korrekt svar: 5! = 120; subtrahera 1 för att få 119; vänd siffrorna och få 911. Sedan, med hjälp av lite R-kod (se nedan), ser vi att det finns 152 primtal mellan 10 och 911, och deras summa är 64 598. Slutligen, med R igen, dividerar och rundar vi: 64 598 ÷ 152 ≈ 425.
Här är R-skriptet vi använde:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")Vårt nästa test siktar på ett av Opus 4.6:s stora påståenden: att diagnostisera buggar i kod. Vi vet att modeller ofta följer koden korrekt rad för rad men misslyckas med att koppla spårningen till den underliggande bristen.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
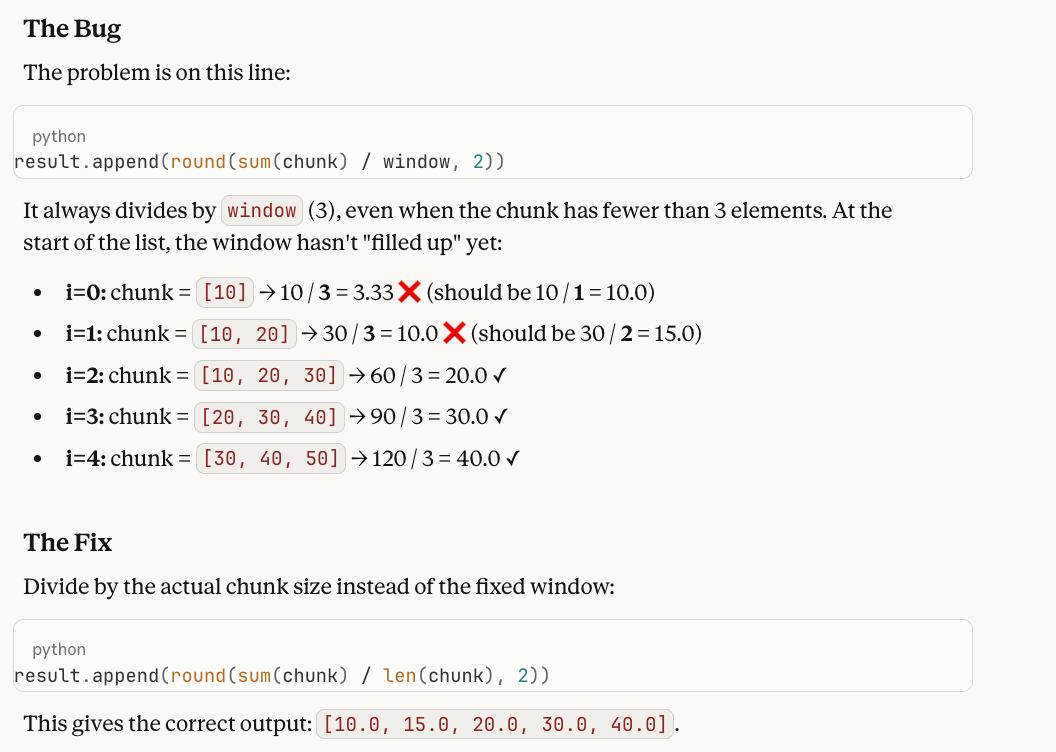
Här är svaret och varför det fungerar som test: funktionen dividerar alltid med window (3), även när segmentet har färre än 3 element i början av listan. Det felaktiga resultatet är [3.33, 10.0, 20.0, 30.0, 40.0], men de två första värdena ska vara 10.0 och 15.0 eftersom dessa segment innehåller endast 1 respektive 2 element. Fixa genom att byta / window mot / len(chunk).
Vi gillar detta test eftersom modeller ofta följer loopen perfekt men sedan rapporterar ”utdata verkar korrekta” — de ser matematiken steg för steg och flaggar inte att det är fel att dividera ett enskilt element med 3. Det kräver att modellen håller avsikt (vad ett glidande medelvärde ska göra) sida vid sida med utförande (vad koden faktiskt gör) och upptäcka gapet mellan dem.
Vårt sista test har ingen matematik, bara kontrafaktiskt resonemang.
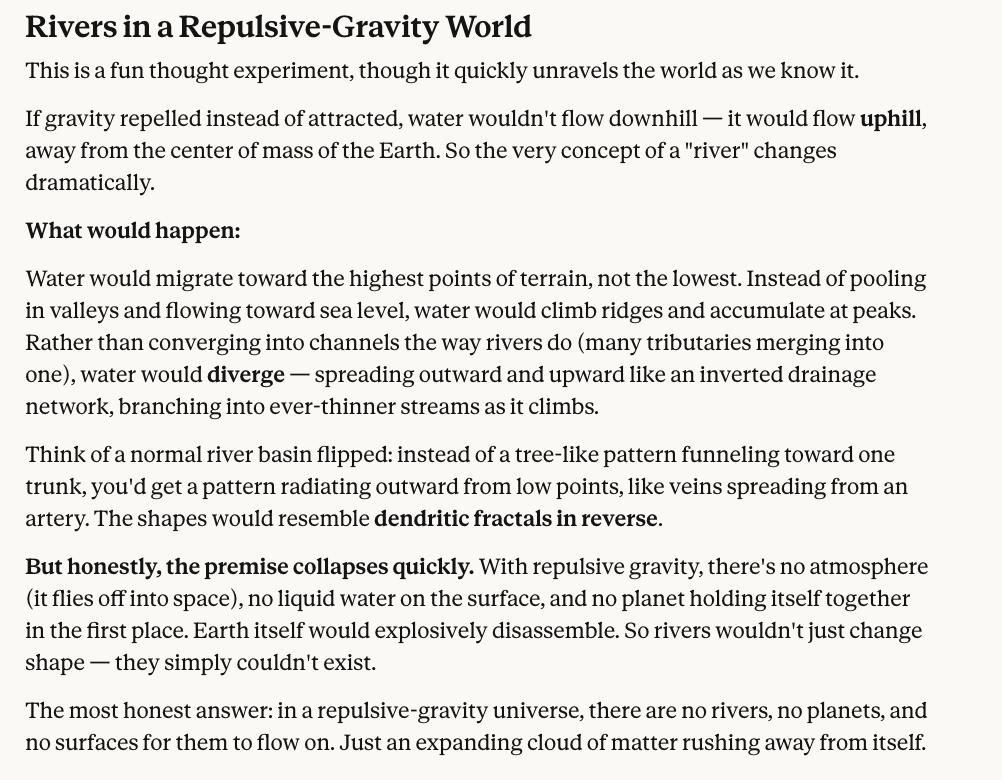
In a world where gravity repels objects instead of attracting them, what shape would rivers take?Visst finns det inget entydigt korrekt svar här, och det är svårt att föreställa sig. Men vi vill åtminstone att modellen resonerar kring konsekvenserna, och vi tycker att Claude Opus 4.6:s svar verkar tillräckligt rimligt.
Sammantaget kan vi konstatera att Opus 4.6 fick full pott, även om vi, som du såg, inkluderade en fråga där svaret var något subjektivt, så du får vara slutgiltig domare.
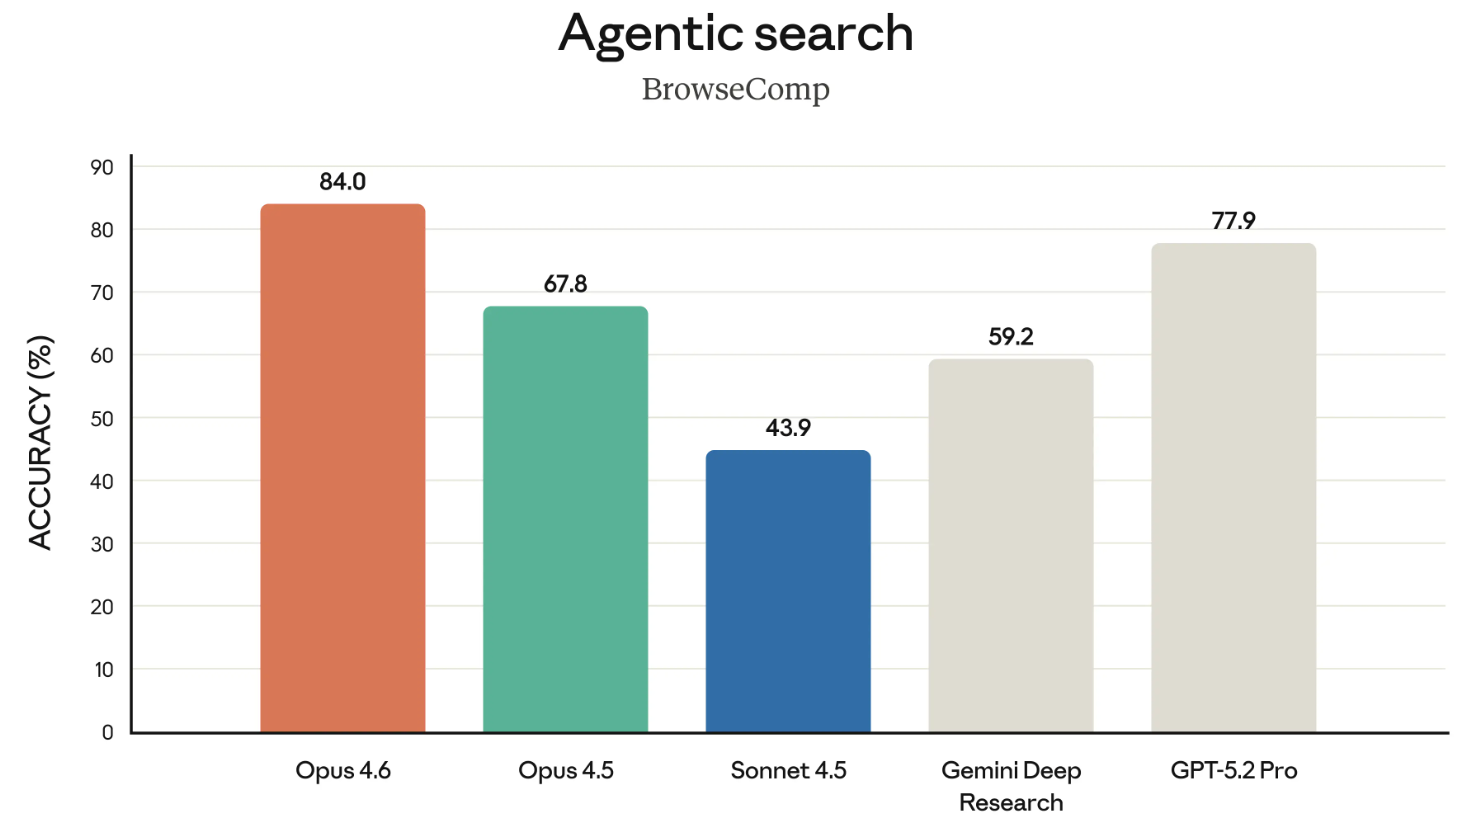
Opus 4.6 är obestridd ledare i minst fyra viktiga benchmarktester:
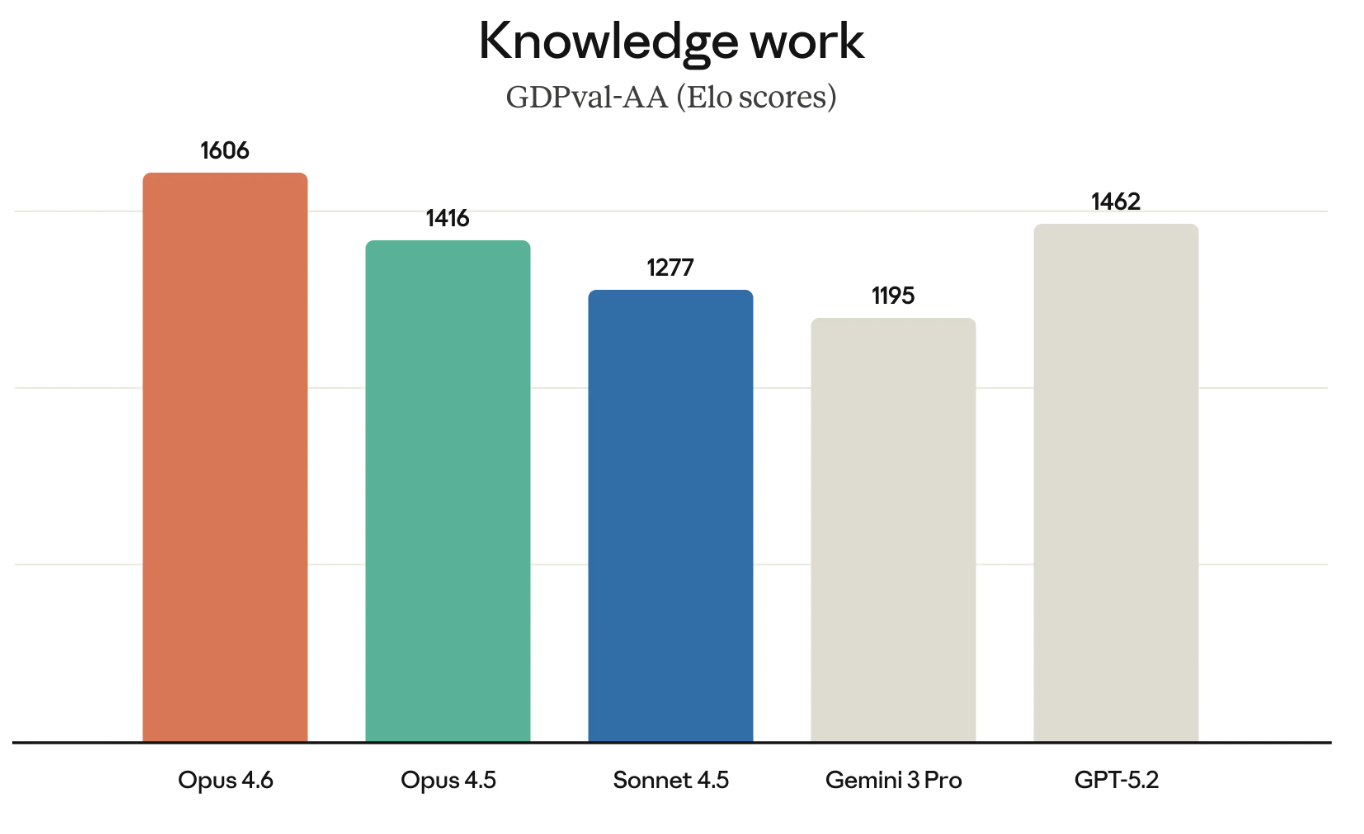
Terminal-Bench 2.0 är ett benchmark för agentisk kodning; Humanity’s Last Exam testar komplext resonemang; GDPval-AA testar prestanda i kunskapsarbete; BrowseComp mäter en modells förmåga att hitta svårfunnen information på nätet.
Claude-modellerna har med rätta rykte om sig att vara några av de bästa kodarna. Låt oss därför börja med resultaten från Terminal-Bench 2.0.
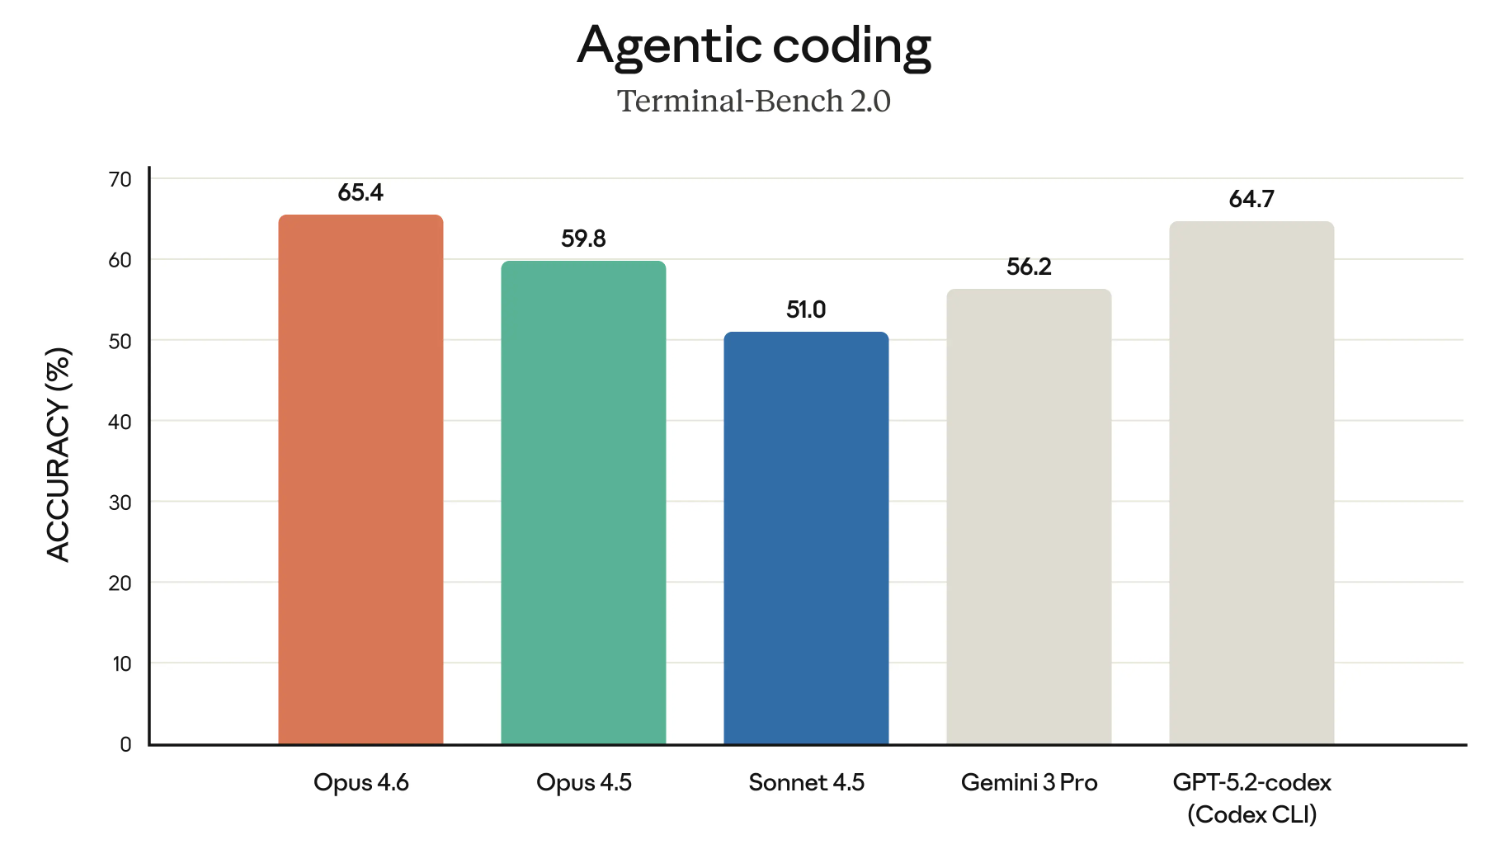
Om grafen ovan verkar framhäva Opus 4.6 i relation till GPT-5.2-codex – ja, det är säkert avsiktligt. Anthropic har på senare tid utmanat OpenAI direkt på flera områden och bygger sitt case för företagsanvändning.
Humanity’s Last Exam är en av de mest välkända benchmarksen, och det är en som vi alla följer noga. Den mäter en modells allmänna resonemangsförmåga.
Följande graf visar hur olika frontmodeller lyckas på HLE-benchmarket både med och utan verktyg. (”Med verktyg” innebär att modellen fick använda externa funktioner som webbsökning och kodkörning.)
Grafen hade kanske varit bättre som två separata grafer. Den detaljen åsido är slutsatsen tydlig: Opus 4.6 leder både i kategorin ”med verktyg” och ”utan verktyg”.
GDPval-AA (som namnet antyder) testar det som anses vara ekonomiskt värdefullt kunskapsarbete. Tänk på saker som att köra finansiella modeller eller göra research.
GDPval-AA och liknande benchmarks blir allt viktigare eftersom de faktiskt mäter den typ av arbete som företag betalar för. Opus 4.6:s framgång på GDPval-AA är också en direkt utmaning mot GPT-sviten eftersom OpenAI och Anthropic konkurrerar om många av samma kunder.
BrowseComp är det sista benchmarktestet värt att nämna från lanseringen. Det mäter en modells förmåga att spåra upp svårfunnen information online. Lite historik: OpenAI tog faktiskt fram BrowseComp för att visa upp sökförmågorna i sina egna modeller.
I ett spetsigt drag länkade Anthropic i detta släpp direkt till OpenAIs tillkännagivande från april 2025 om utvecklingen av BrowseComp när de lyfte fram att Opus 4.6 toppar listan. Det var ett litet stick, att citera OpenAIs eget benchmark tillbaka mot dem.
Opus 4.6 är allmänt tillgänglig vid tiden för denna artikel. Du kan dock inte använda Opus 4.6 utan att uppgradera till ett pro-konto, vilket kommer med andra fördelar, som att du kan använda Claude i Excel.
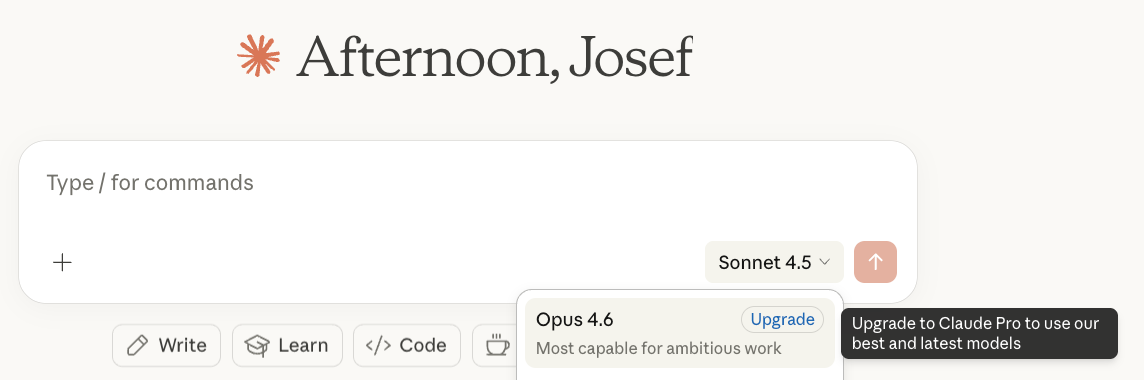
Om du är utvecklare ska du använda claude-opus-4-6 i Claude API. Prissättningen har inte ändrats: Det är fortfarande 5/25 dollar per miljon token. Om du undrar över de två siffrorna: den första är vad du betalar för att skicka token till modellen (dina promptar), och den andra är vad du betalar för de token den genererar tillbaka (svaren).
Claude Opus 4.6 toppar resultatlistorna på viktiga benchmarks som GPDVal-AA, som mäter hur väl en modell presterar på ekonomiskt viktiga uppgifter — det som stora företagskunder bryr sig om. OpenAI kan ha skakats av denna utveckling eftersom de bara timmar före lanseringen av Opus 4.6 tillkännagav OpenAI Frontier, en ny företagsplattform för att bygga, distribuera och hantera AI-agenter i produktion.
Med andra ord, snarare än att tävla på modelbenchmarks visar Frontier att OpenAI fokuserar på infrastrukturen runt sin modelsvit, specifikt genom att ge AI-agenter delad affärskontext, behörigheter och förmåga att ta emot och lära av feedback över tid. När de tappar mark på benchmarksen signalerar OpenAI att deras plattform är bättre positionerad för att faktiskt göra agenter användbara i ett företag.
Om det är en strategisk kursändring eller ett tyst medgivande om att de tappar i modellracet får du avgöra själv.
Överlag är vi imponerade av vad Anthropic erbjuder med Claude Opus 4.6, och vi ser fram emot att få arbeta praktiskt med agentteam. Om du vill lära dig mer om Claude-familjen, kolla gärna in kursen Introduktion till Claude-modeller.
Lär dig AI med DataCamp
course
course
course