courses
Claude 모델 입문
3
14.3K
지난 며칠간 Anthropic의 다음 릴리스에 대한 소문이 무성했습니다. 많은 이들이 Claude Sonnet 5를 기대했지만, 올해 첫 출시작은 Claude Opus 4.6 형태로 등장했습니다.
100만 토큰 컨텍스트 윈도우, 적응형 사고, 대화 압축, 그리고 각종 톱티어 벤치마크 성능을 갖춘 Claude Opus 4.6은 Opus 4.5의 향상판입니다. Anthropic의 표현대로, 그들의 가장 ‘똑똑한’ 모델을 업그레이드한 셈이죠. 이와 함께 Anthropic은 Claude Code의 에이전트 팀과 PowerPoint용 Claude도 발표했습니다.
이 글에서는 Claude Opus 4.6의 새로운 기능을 모두 살펴보고, 벤치마크를 분석하며, 여러 실습 예제로 성능을 직접 점검해 보겠습니다.
최신 Claude 기능을 더 알아보고 싶다면 Claude Cowork와 Claude Code 가이드를 확인해 보세요. 또한 OpenClaw 튜토리얼도 참고하시기 바랍니다. 경쟁 모델과의 비교는 Muse Spark vs Claude Opus 4.6 및 GPT-5.4 vs Claude Opus 4.6 가이드를 읽어보세요.
Claude Opus 4.6은 Anthropic의 최신 대규모 언어 모델입니다. Opus 4.5의 뒤를 잇는 모델로, 회사의 ‘가장 스마트한’ 모델 등급에 큰 폭의 업그레이드를 제공하는 버전입니다.
릴리스 블로그에 따르면, 에이전트형 코딩, 심층 추론, 자기 교정에 더 집중했다고 합니다. 이는 단발성 행동에서 지속적인 실행으로 초점이 이동했음을 의미합니다.
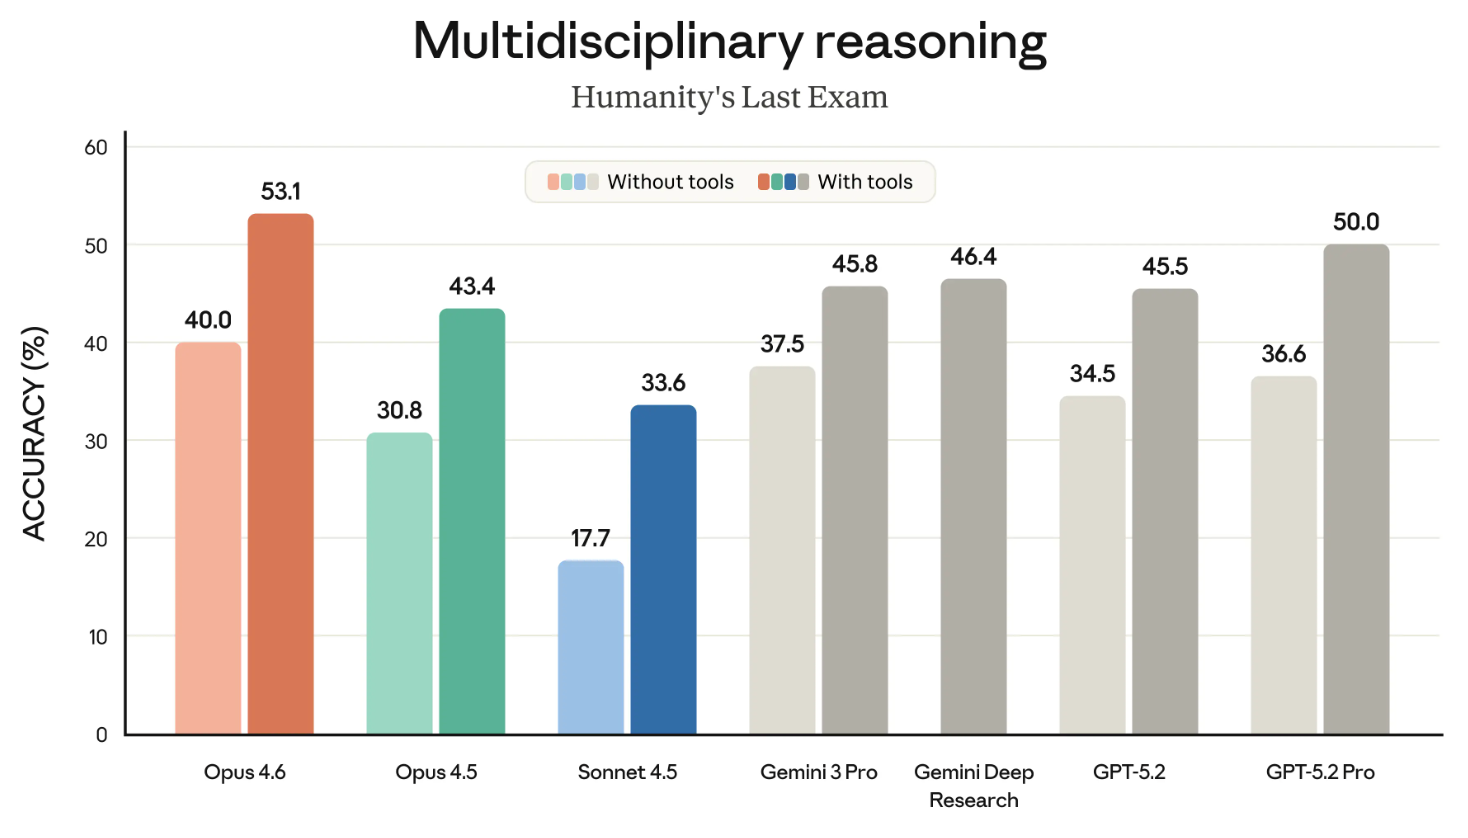
Opus 4.6은 더 신중하게 계획하고, 긴 시간 동안 일관성을 유지하며, 자체 작업에서 오류를 식별하도록 설계되었습니다. 그 결과 Claude Opus 4.6은 여러 벤치마크를 석권했는데, Terminal-Bench 2.0 코딩 평가 최고 점수는 물론 Humanity’s Last Exam에서도 모든 선도 모델을 능가했습니다.
가장 눈에 띄는 점 중 하나는 향상된 컨텍스트 윈도우입니다. 베타에서 100만 토큰을 제공하며, 이는 Gemini 3와 비슷한 수준으로 더 많은 정보를 맥락을 잃지 않고 처리할 수 있음을 의미합니다.
한편, Anthropic은 Opus의 후속 버전도 공개했습니다. 최신 정보를 위해 Claude Opus 4.7 가이드를 읽어보시길 권합니다.
Claude Opus 4.6에는 에이전트형 워크플로에 초점을 맞춘 주목할 만한 새로운 기능이 여럿 포함되어 있습니다. 핵심 포인트를 살펴보겠습니다:
에이전트 팀은 이전 버전의 ‘서브에이전트’보다 발전된 기능입니다. 에이전트 팀을 통해 완전히 독립적인 여러 Claude 인스턴스를 병렬로 실행할 수 있습니다. 한 세션은 일을 조율하는 ‘리드’ 에이전트가 맡고, ‘팀원’들이 실제 실행을 담당합니다.
흥미로운 점은 팀의 각 구성원이 자체 컨텍스트 윈도우를 가진다는 것입니다. 이를 통해 보다 철저한 실행이 가능해집니다. 각 팀원은 팀 내 다른 에이전트와 직접 소통할 수도 있습니다.
물론 이 기능에는 비용이라는 잠재적 단점이 따릅니다. 각 에이전트가 자체 컨텍스트 윈도우를 사용하기 때문에 토큰 소모가 빠르게 늘 수 있습니다. 따라서 Anthropic은 복잡성이 높은 시나리오에서 사용하는 것을 권장합니다.
Claude Opus 4.6의 깔끔한 기능 중 하나가 컨텍스트 압축입니다. 이 품질 개선은 컨텍스트 윈도우 한계에 다다르는 장시간 워크플로에서 발생하는 문제를 완화해 줍니다. 보통은 컨텍스트 한계에 부딪히면 성능이 떨어지기 시작하죠.
대화 압축을 통해 Claude Opus 4.6은 대화가 토큰 임계값에 도달하고 있음을 자동으로 감지하여 기존 대화를 간결한 블록(압축 블록)으로 요약합니다.
이 기능은 상호작용의 핵심을 보존하면서 작업을 이어갈 공간을 확보하는 데 도움이 됩니다. 장시간 실행이 필요한 작업 중심의 에이전트를 사용할 계획이라면, 더 나아진 메모리로 흐름을 유지하는 데 유용할 것입니다.
Claude Opus 4.6에는 확장 사고가 필요한지 여부와 그 강도를 결정하는 두 가지 기능이 있습니다.
적응형 사고는 프롬프트의 복잡도를 모델이 자체 판단하도록 합니다. 단순함 혹은 복잡성에 따라 확장 사고를 사용할지 결정합니다. 이때 몇 토큰을 사용할지 수동으로 설정하는 대신, Claude가 각 요청의 복잡도에 맞춰 예산을 조정합니다.
effort 파라미터는 Claude가 토큰을 얼마나 과감하게 혹은 보수적으로 쓸지 설정합니다. 즉, 토큰 효율성과 응답의 철저함 사이의 균형을 조정할 수 있습니다.
API에서 Claude Opus 4.6을 사용할 때는 이 파라미터들을 수동으로 설정할 수 있습니다. 예를 들어:
최근 저희는 Excel용 Claude을 다루며, Excel 스프레드시트의 사이드 패널에서 애드온이 다양한 작업을 돕는 방법을 소개했습니다. 이 도구의 기능 개선과 함께 Anthropic은 PowerPoint용 Claude를 발표했습니다.
이 통합 기능은 슬라이드 마스터, 폰트, 레이아웃을 준수합니다. 기업 템플릿을 입력해 특정 섹션을 만들도록 요청하거나, 슬라이드를 선택해 복잡한 텍스트를 네이티브 편집 가능한 다이어그램으로 변환해 달라고 할 수 있습니다.
단순한 ‘슬라이드 그림’이 아니라 편집 가능한 PowerPoint 객체 생성을 중시하기 때문에, 아이디어 생성기를 넘어 실제 생산성 도구로서 가치를 제공합니다.
PowerPoint용 Claude는 현재 Max 및 Enterprise 사용자 대상 연구 프리뷰 단계입니다.
Opus 4.6의 핵심 주장은 더 어려운 코딩 작업과 더 깊은 추론에 관한 것입니다. 이 모든 역량은 여러 제약을 동시에 유지하고, 다단계를 따라 추론하며, 실수를 잡아내는 능력을 토대로 합니다.
이 점을 염두에 두고, 우리는 Opus 4.6을 다단계 논리, 수학, 코딩 과제들로 시험했습니다. 연쇄 계산 오류, 공간 추론(항상 난제), 제약이 얽힌 질문 같은 LLM의 알려진 약점을 드러낼 수 있는지 보고자 했습니다. 또한 Anthropic의 발표에서 근본 원인 분석과 디버깅에 뛰어나다고 강조한 만큼, 특정 디버깅 과제도 포함했습니다.
첫 번째 테스트는 소수, 16진수, 카운팅을 결합합니다:
Step 1: Find the 6th prime number. Let this be P.
Step 2: Convert the square of P into hexadecimal.
Step 3: Count the letters (A–F) and digits (0–9) in that hex string. Let these be A and B.
Step 4: Multiply A × B. Let this be N.
Step 5: Find the Nth prime number.
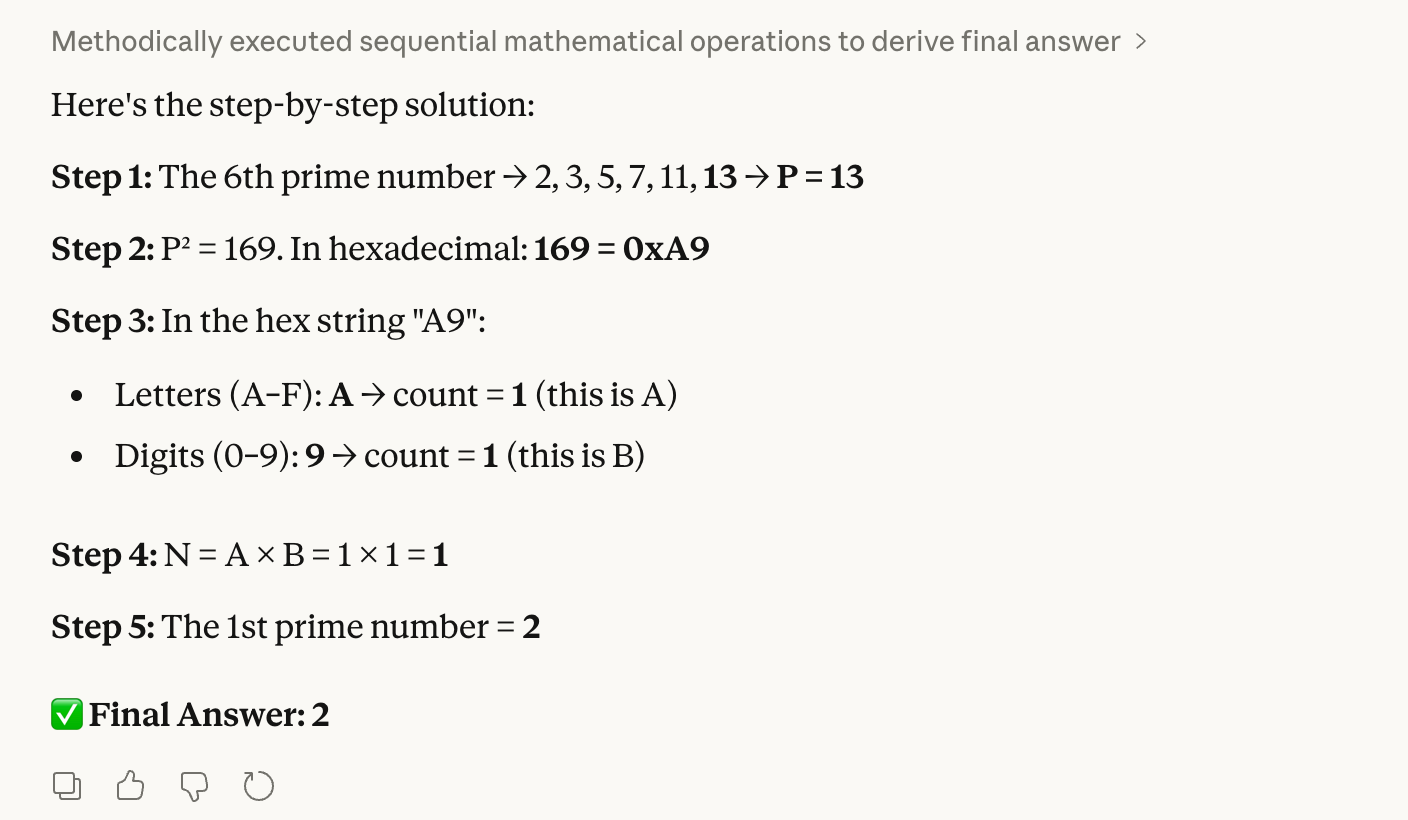
겉으로는 복잡해 보이지만, 사람인 우리가 검증하기 꽤 쉽습니다. 정답은 2입니다. 6번째 소수는 13이고, 13의 제곱은 169, 16진수로는 "A9"입니다. 여기엔 문자 1개 × 숫자 1개가 있으므로 곱하면 1, 1번째 소수는 2입니다.
모델이 16진수 변환에서 실수하면 최종 답도 완전히 틀릴 수 있다는 점이 걱정이었는데, 보시다시피 Opus 4.6은 무리 없이 해결했습니다:
두 번째 테스트는 공간 추론과 음수 처리 능력을 겨냥했습니다:
Step 1: Create a 2×2 matrix M with top row [4, 2] and bottom row [1, 5].
Step 2: Rotate M 90 degrees clockwise.
Step 3: Calculate the determinant of the rotated matrix.
Step 4: Cube that determinant.
Step 5: Subtract the 13th Fibonacci number from the result.
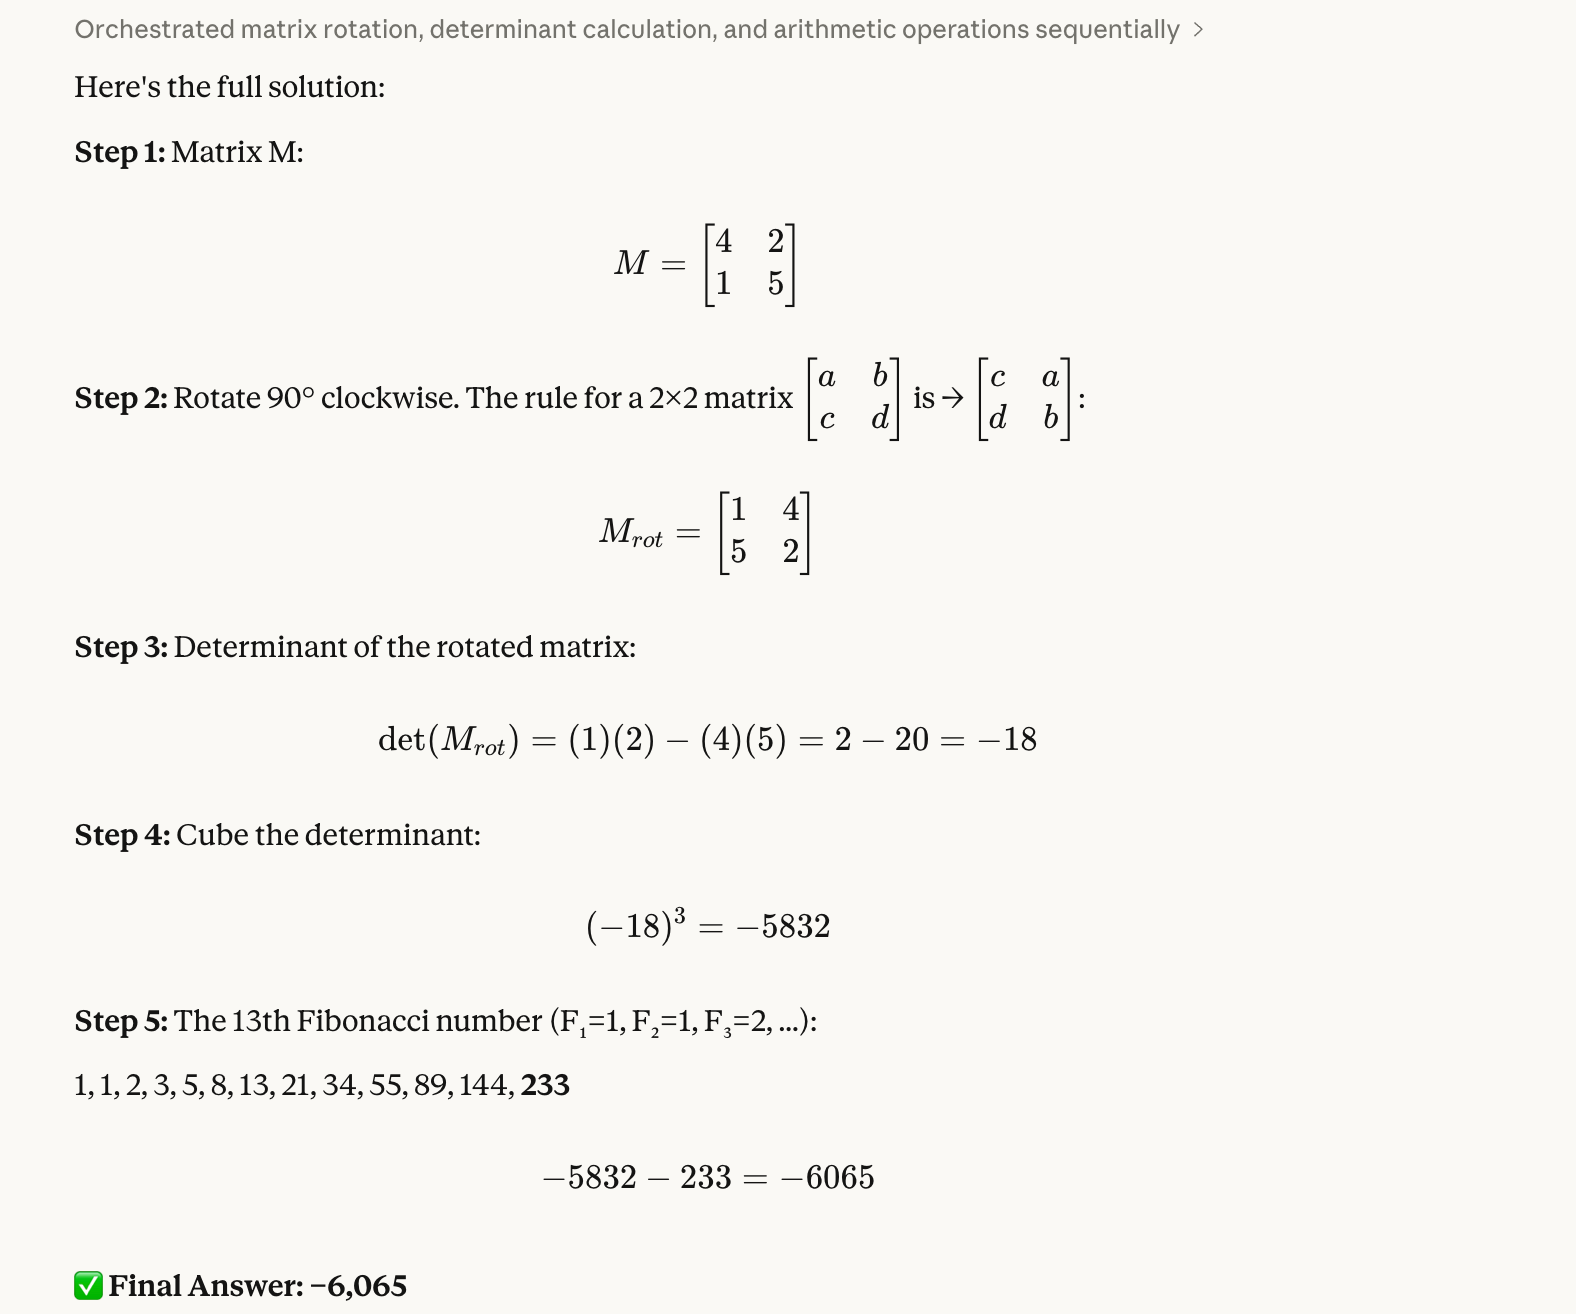
검증에는 약간의 손이 갔습니다. 정답은 -6,065입니다. 회전된 행렬은 [[1, 4], [5, 2]]이고, 행렬식은 -18, 이를 세제곱하면 -5,832, 마지막으로 233을 빼면 -6,065가 됩니다.
경험상 모델들이 행렬 원소를 잘못 자리바꿈하거나, 진행 중 음수 부호를 잃어버리기 때문에 이 테스트를 택했습니다. 역시 Opus 4.6은 문제없었습니다:
세 번째 테스트는 백트래킹이 필요한 제약 충족 문제입니다:
Five people (Alex, Josef, Matt, Thalia, Tom) sit in chairs 1–5.
Thalia is in an even-numbered chair.Alex is immediately to Thalia’s right.Tom is at one end.Josef is not next to Tom.Who is in chair 3?
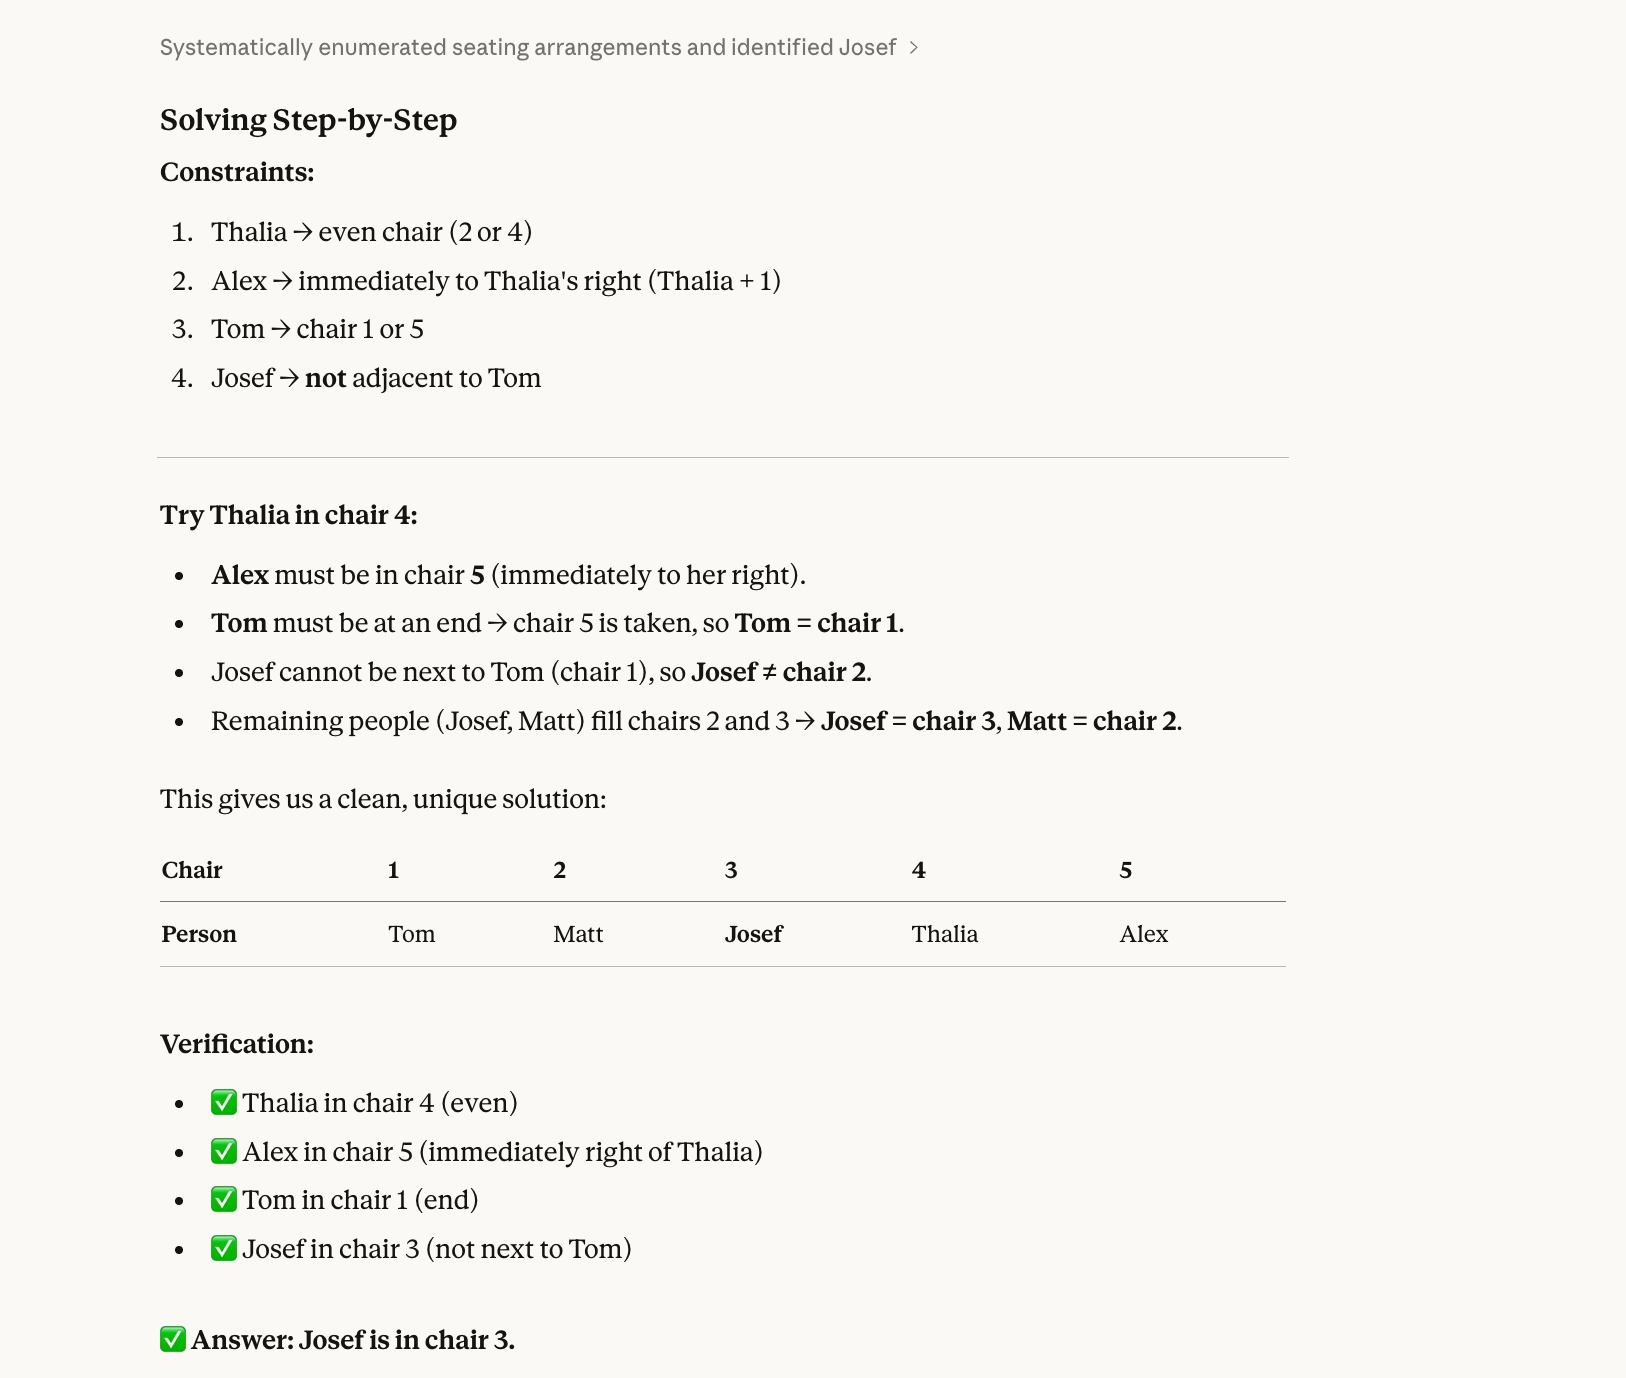
정답은 Josef입니다. (Alex-1, Matt-2, Josef-3, Thalia-4, Tom-5.) 약간의 시간을 들이면 종이에 풀 수 있습니다.
이 유형에서 모델이 실수하는 이유는 역사적으로 순차적으로만 해결하려 하고 전체적으로 보지 못했기 때문입니다. “Thalia는 짝수 의자”라는 문장을 보고 검증 없이 2번을 고른 다음 배치를 채우다가 충돌을 만나도, 그때 가서 4번을 다시 시도하지 않는 식이죠.
Opus 4.6은 이 문제도 맞혔습니다:
네 번째 테스트는 공간 시각화와 물리적 직관을 평가합니다:
Step 1: Imagine a clock currently showing 3:15 PM.
Step 2: Rotate the clock 90 degrees counter-clockwise (physically turning the whole clock face). After the rotation, what time does the minute hand appear to be pointing at?
Step 3: Take that new "apparent" minute value and add it to the original time (3:15 PM).
Step 4: Subtract 45 minutes from that result.
Step 5: What is the final time?
이건 실제로 제 손목시계를 돌려서 검증했습니다.
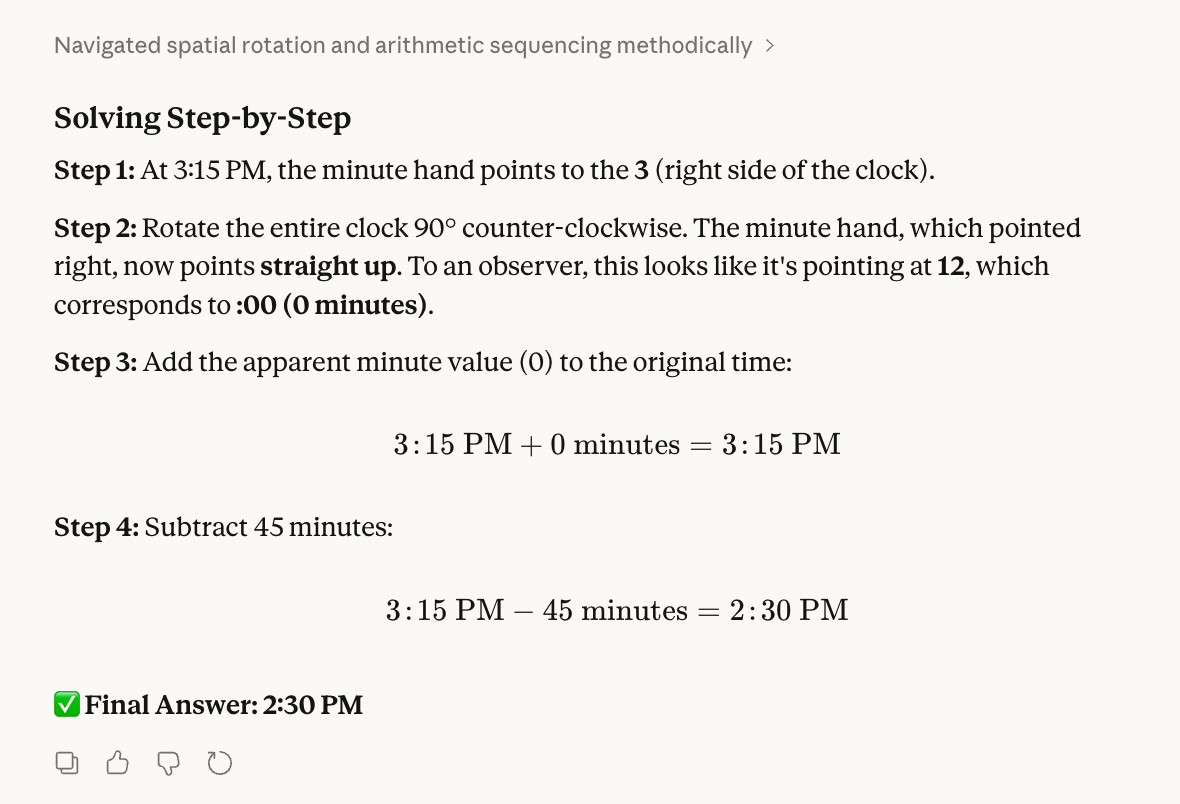
정답은 오후 2시 30분입니다. 3:15에서 분침은 “3”을 가리키고, 시계 전체를 반시계 방향으로 90도 돌려 12가 왼쪽 창문을 향하게 하면 “3”이 원래 “12” 위치로 옵니다. 그 결과 새 ‘겉보기’ 분 값은 0이 되고, 3:15에 0을 더한 뒤 45분을 빼면 2:30 PM이 됩니다.
테스트 설계 시, 모델이 시계판을 돌리는 것과 바늘을 움직이는 것을 혼동할 수 있다고 봤습니다. 또 0을 더하는 상황을 수상히 여겨 다른 수를 억지로 넣으려는 경향도 들었습니다.
그러나 Opus 4.6은 이 문제도 올바르게 해결했습니다:
다섯 번째 테스트는 모듈러 산술과 소수 필터링을 결합합니다:
Find a two-digit number S that satisfies all of the following:
* When S is squared, the last two digits of the result are 21.
* S must be a prime number.
* The sum of the digits of S must also be a prime number.
What is the largest possible value of S?
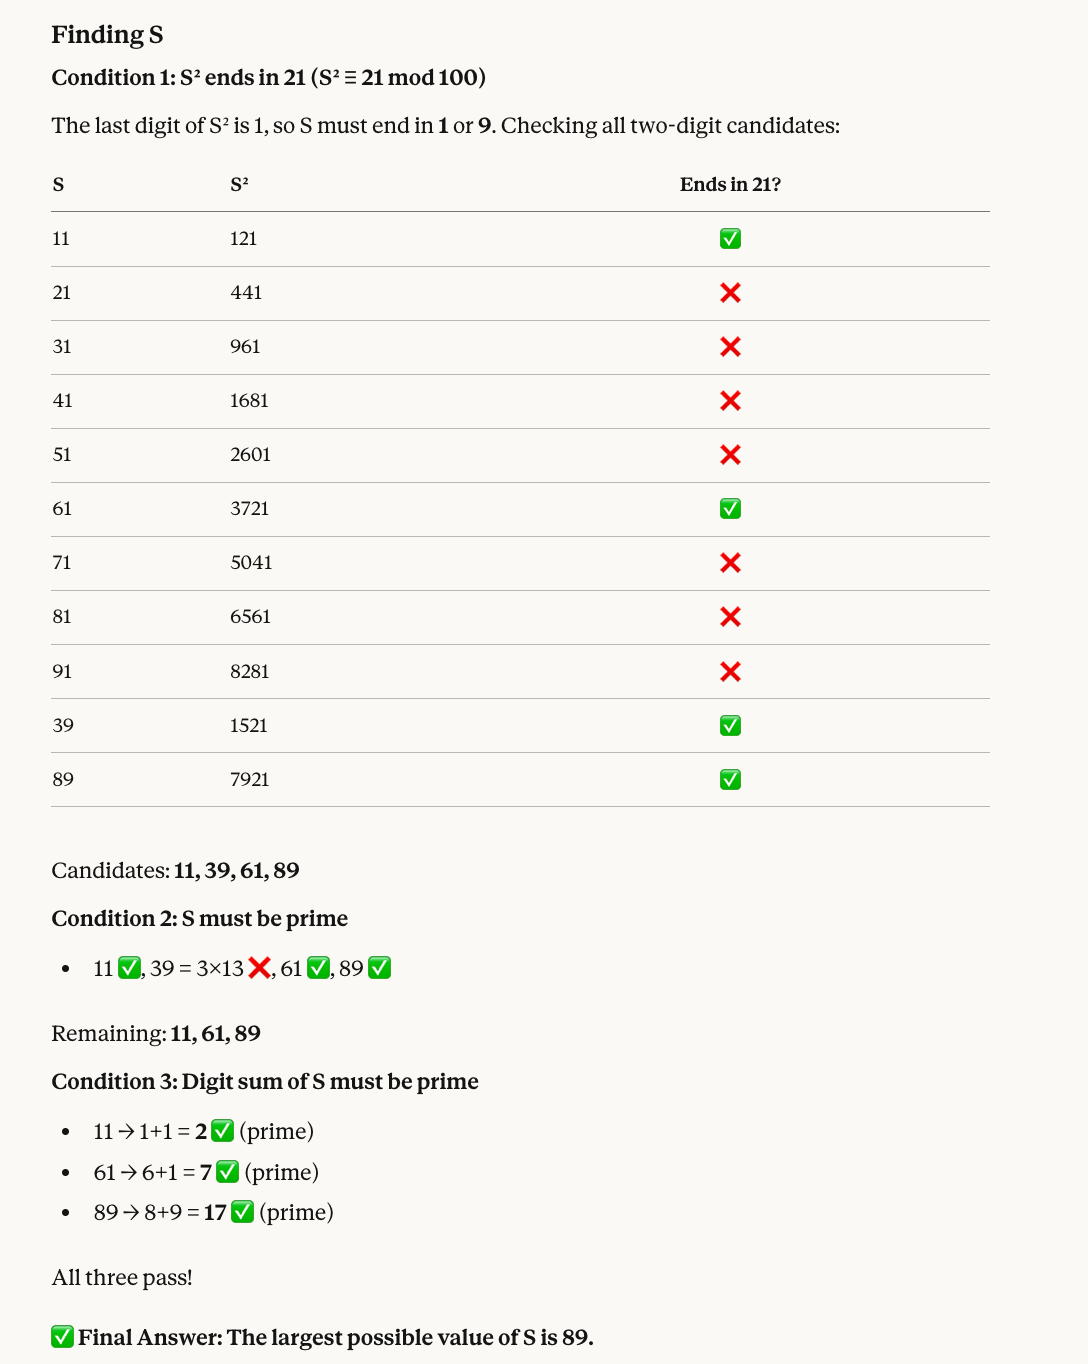
정답이 89인 이유는 다음과 같습니다. 제곱의 마지막 두 자리가 21로 끝나는 수는 11, 39, 61, 89입니다. 이 중 39는 소수가 아니므로 11, 61, 89가 남고, 자리수 합도 각각 2, 7, 17로 모두 소수입니다. 따라서 가장 큰 수는 89입니다.
Opus 4.6은 이번에도 정답을 맞혔고, 유용한 시각 자료도 덧붙였습니다:
다음 테스트는 팩토리얼, 문자열 조작, 소수를 연쇄적으로 묶었습니다:
Step 1: Calculate 5! (5 factorial). Let this result be X.
Step 2: Take X, subtract 1, and reverse the digits of the result. Let this new number be Y.
Step 3: Identify all prime numbers (p) such that 10 ≤ p ≤ Y.
Step 4: Calculate the sum of these primes and divide it by the total count of primes found in that range.
Step 5: Provide the final average, rounded to the nearest whole number.
정답 425를 이렇게 검증했습니다. 5! = 120, 1을 빼면 119, 자리수를 뒤집으면 911입니다. 아래 R 코드를 사용해 10과 911 사이 소수가 152개, 합이 64,598임을 확인했습니다. 마지막으로 R로 64,598 ÷ 152 ≈ 425를 계산하고 반올림했습니다.
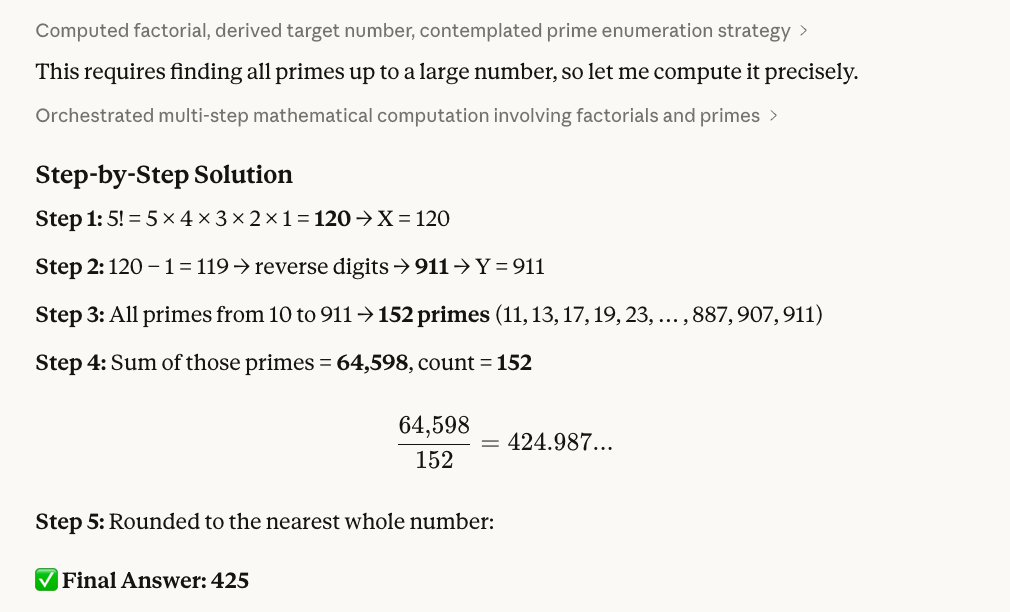
사용한 R 스크립트는 다음과 같습니다:
# Step 1: Calculate 5!
X <- factorial(5)
cat("Step 1: X =", X, "\n")

# Step 2: Subtract 1 and reverse digits
result <- X - 1
Y <- as.numeric(paste0(rev(strsplit(as.character(result), "")[[1]]), collapse = ""))
cat("Step 2:", X, "- 1 =", result, "-> reversed ->", Y, "\n")

# Step 3: Find all primes between 10 and Y
is_prime <- function(n) {
  if (n < 2) return(FALSE)
  if (n == 2) return(TRUE)
  if (n %% 2 == 0) return(FALSE)
  for (i in 3:floor(sqrt(n))) {
    if (n %% i == 0) return(FALSE)
  }
  return(TRUE)
}

primes <- Filter(is_prime, 10:Y)
cat("Step 3: Found", length(primes), "primes between 10 and", Y, "\n")

# Step 4: Sum and average
total <- sum(primes)
count <- length(primes)
avg <- total / count
cat("Step 4: Sum =", total, ", Count =", count, ", Average =", avg, "\n")

# Step 5: Round
cat("Step 5: Rounded =", round(avg), "\n")다음 테스트는 Opus 4.6의 핵심 주장 중 하나인 ‘코드 버그 진단’을 겨냥합니다. 모델들은 종종 코드를 줄 단위로 정확히 추적하면서도 그 추적 결과를 근본적인 결함과 연결하지 못하곤 합니다.
A developer wrote this Python function to compute a running average:

def running_average(data, window=3):
    result = []
    for i in range(len(data)):
        start = max(0, i - window + 1)
        chunk = data[start:i + 1]
        result.append(round(sum(chunk) / window, 2))
    return result
When called with running_average([10, 20, 30, 40, 50]), the first two values in the output seem wrong. Why? Please help me fix what is wrong!
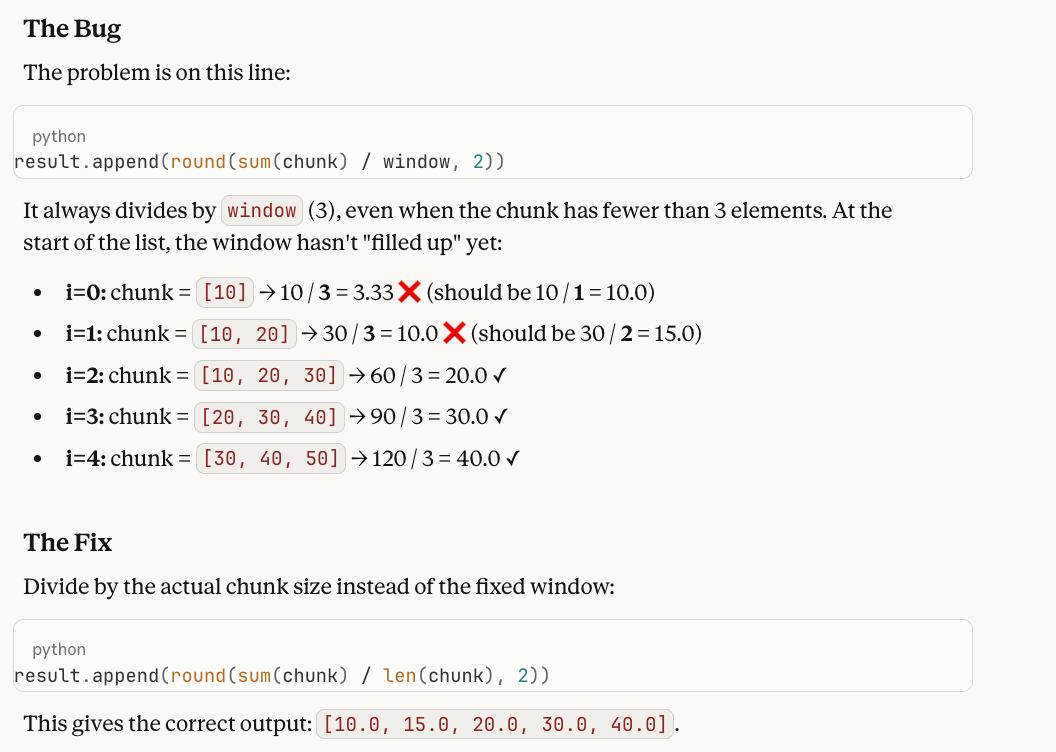
이 테스트의 요지는 다음과 같습니다. 리스트 초반에 요소가 3개 미만인 경우에도 함수가 항상 window (3)로 나눕니다. 잘못된 출력은 [3.33, 10.0, 20.0, 30.0, 40.0]이고, 처음 두 값은 각각 요소가 1개, 2개뿐인 구간이므로 10.0과 15.0이어야 합니다. 수정은 / window를 / len(chunk)로 바꾸는 것입니다.
이 테스트를 좋아하는 이유는, 모델이 루프를 완벽히 추적하고도 “출력이 맞다”고 보고하는 경우가 흔하기 때문입니다. 한 요소를 3으로 나누는 것이 잘못이라는 점을 지적하지 못하죠. 런닝 평균의 의도(무엇을 해야 하는지)와 코드의 실행(실제로 무엇을 하는지)를 함께 유지하며 그 차이를 포착해야 합니다.
마지막 테스트는 수학 없이 반사실적 추론만을 다룹니다.
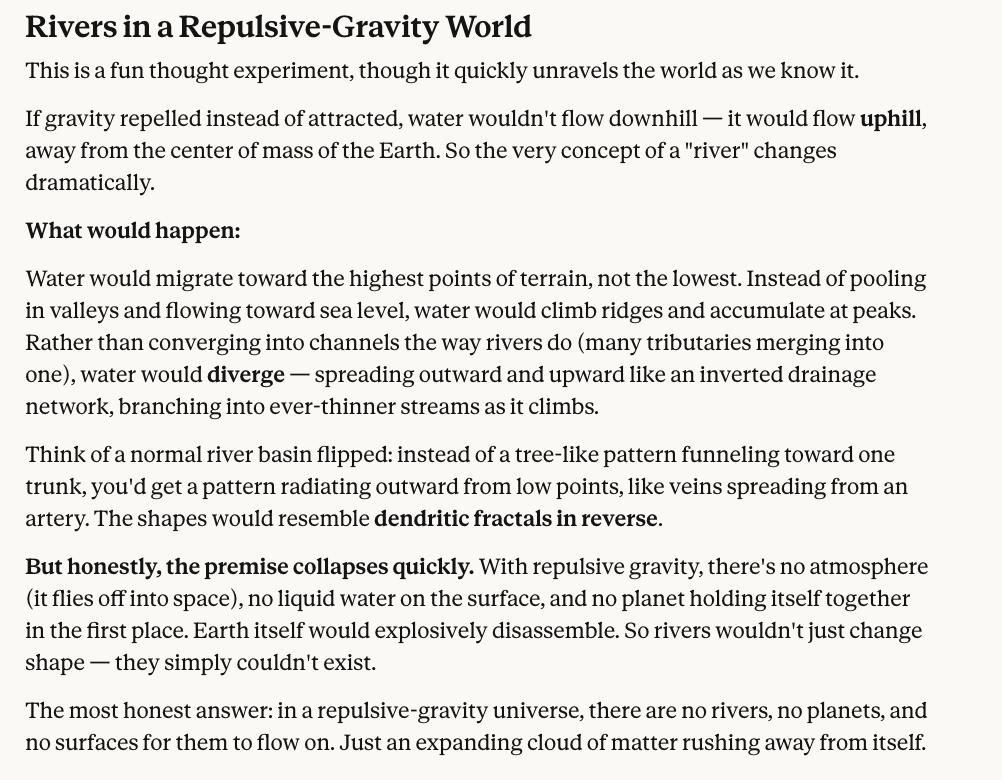
In a world where gravity repels objects instead of attracting them, what shape would rivers take?단일한 정답은 없고, 상상하기도 어렵습니다. 하지만 모델이 함의를 논리적으로 전개하는지 살피고자 했고, Claude Opus 4.6의 답변은 충분히 합리적으로 보였습니다.
결론적으로 Opus 4.6은 만점에 가까운 성과를 보였습니다. 다만 한 문항은 주관적 요소가 있었으니 최종 평가는 여러분의 몫입니다.
Opus 4.6은 최소 네 가지 중요한 벤치마크에서 독보적 선두를 달립니다:
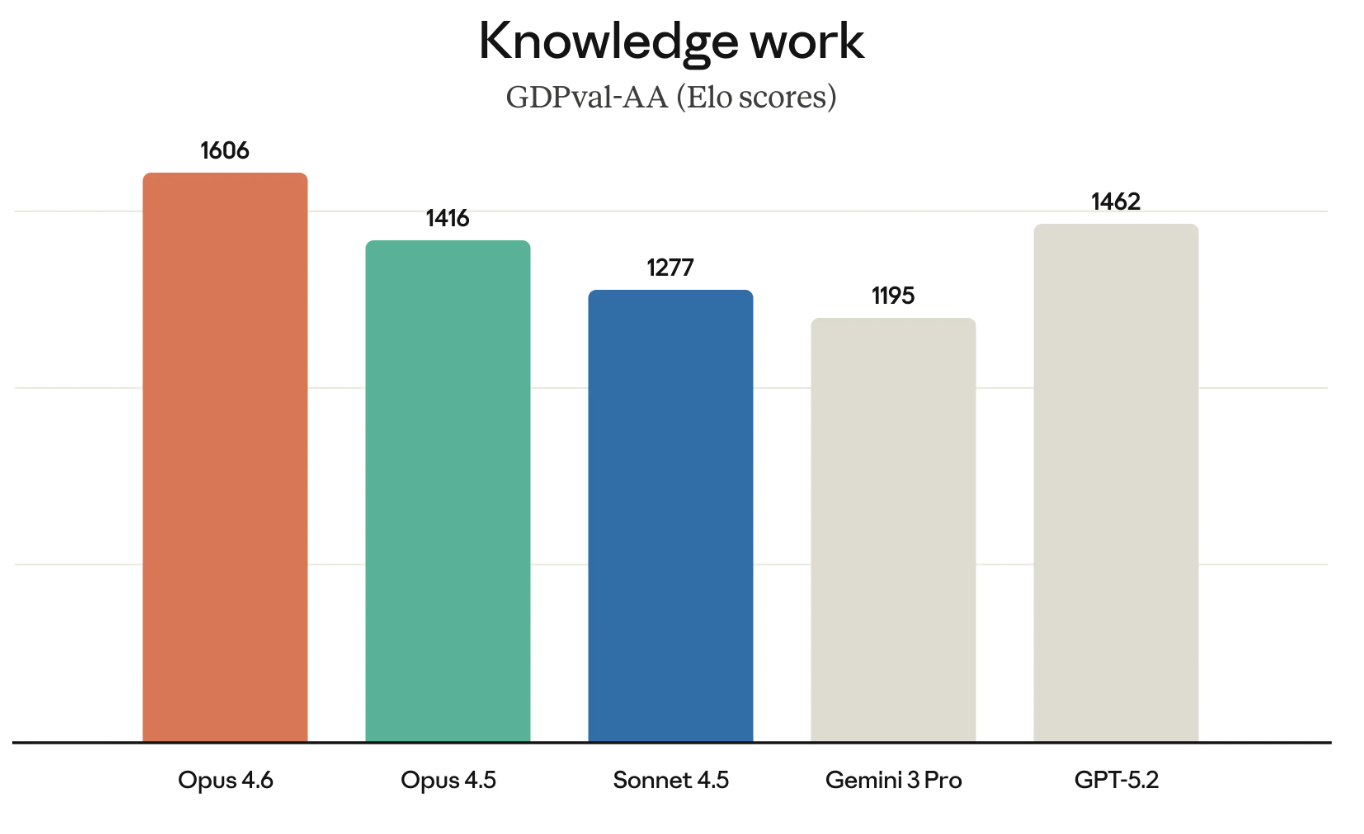
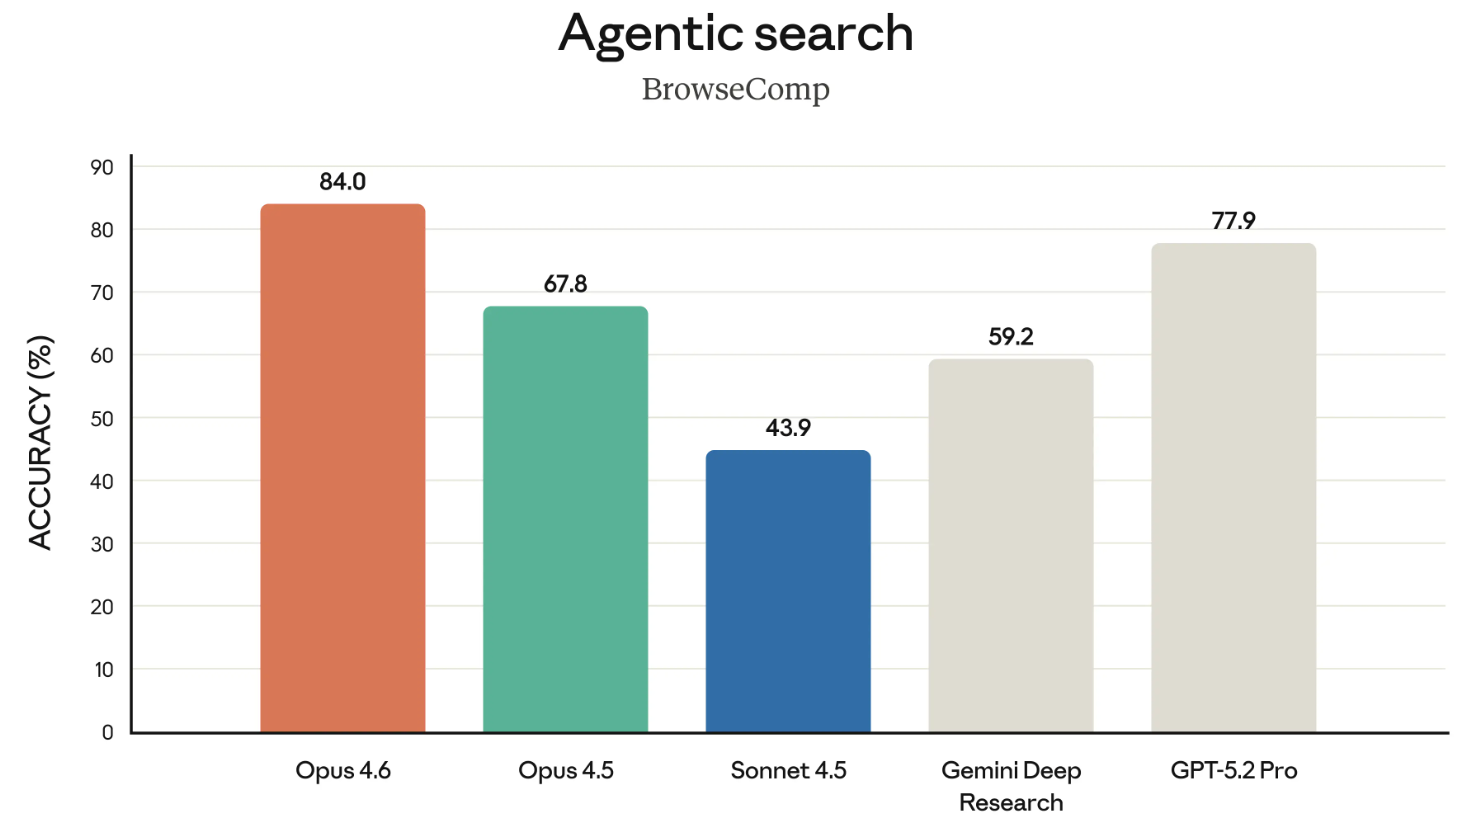
Terminal-Bench 2.0은 에이전트형 코딩 벤치마크, Humanity’s Last Exam은 복잡한 추론 테스트, GDPval-AA는 지식 노동의 성과를 평가, BrowseComp은 온라인에서 찾기 어려운 정보를 찾아내는 능력을 측정합니다.
Claude 계열은 최고의 코더라는 명성을 얻어 왔습니다. Terminal-Bench 2.0 결과부터 살펴보겠습니다.
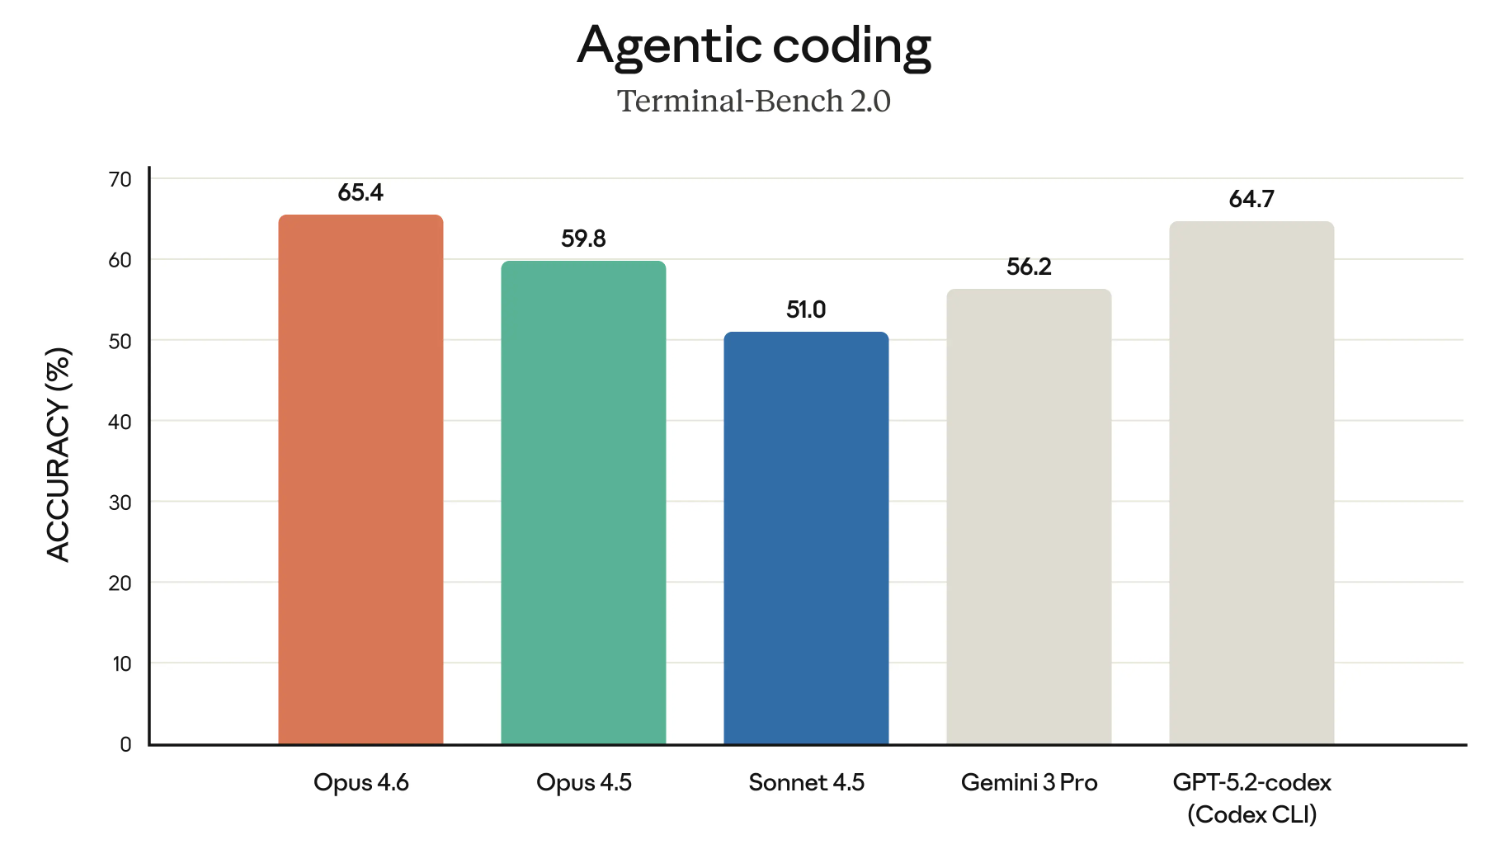
위 그래프가 Opus 4.6을 GPT-5.2-codex와 대비해 강조하는 듯 보인다면—그건 의도적일 겁니다. Anthropic은 최근 여러 영역에서 OpenAI에 직접 도전하며 엔터프라이즈 활용 근거를 제시하고 있습니다.
Humanity’s Last Exam은 가장 잘 알려진 벤치마크 중 하나로, 모두가 예의주시하는 지표입니다. 모델의 일반적 추론 능력을 측정합니다.
다음 그래프는 도구 사용 여부에 따른 HLE 벤치마크의 선도 모델 성과를 보여줍니다. (‘도구 사용’은 모델이 웹 검색, 코드 실행 같은 외부 기능을 활용할 수 있음을 의미합니다.)
이 그래프는 둘로 나누면 더 좋았을지도 모릅니다. 그럼에도 핵심은 분명합니다. Opus 4.6은 ‘도구 사용’과 ‘미사용’ 모두에서 선두입니다.
GDPval-AA는 이름에서 알 수 있듯 경제적 가치가 큰 지식 노동을 평가합니다. 금융 모델 실행이나 리서치 같은 작업을 떠올리면 됩니다.
GDPval-AA와 유사 벤치마크는 점점 중요해지고 있습니다. 실제로 기업이 비용을 지불하는 업무와 맞닿아 있기 때문입니다. Opus 4.6이 GDPval-AA에서 거둔 성과는 OpenAI의 GPT 제품군에도 직접적인 도전으로, 양사가 같은 고객층을 두고 경쟁하고 있음을 시사합니다.
BrowseComp은 마지막으로 언급할 만한 벤치마크입니다. 온라인에서 찾기 어려운 정보를 추적하는 능력을 측정합니다. 배경으로, OpenAI는 자사 모델의 검색 능력을 보여주기 위해 BrowseComp을 개발했습니다.
이번 릴리스에서 Anthropic은 Opus 4.6이 BrowseComp에서 최고 성적을 거뒀음을 강조하며, 2025년 4월 OpenAI의 BrowseComp 개발 발표를 직접 링크하는 다소 도발적인 방식을 취했습니다. OpenAI의 자체 벤치마크를 근거로 역공을 펼친 셈이죠.
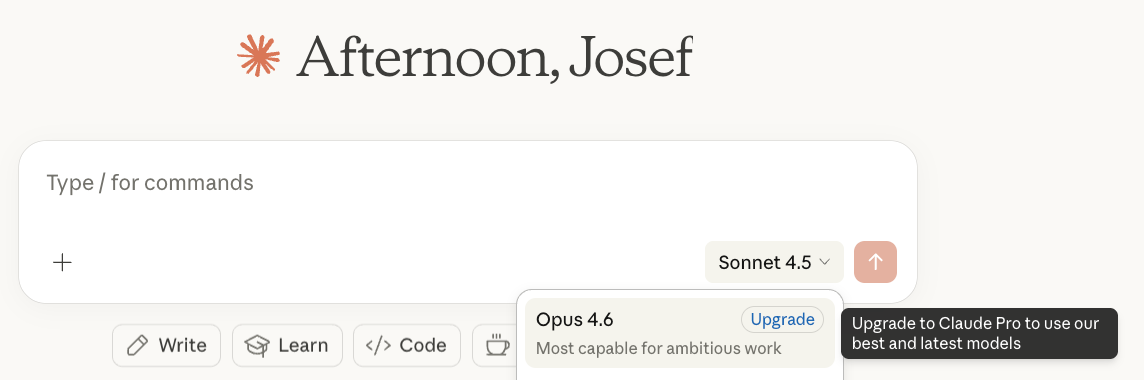
이 글을 작성하는 시점에 Opus 4.6은 널리 제공되고 있습니다. 다만 Pro 계정으로 업그레이드해야만 Opus 4.6에 접근할 수 있으며, 이를 통해 Excel용 Claude 같은 부가 혜택도 이용할 수 있습니다.
개발자라면 Claude API에서 claude-opus-4-6을 사용하면 됩니다. 가격은 변함없습니다. 여전히 백만 토큰당 $5/$25입니다. 두 숫자가 헷갈린다면, 첫 번째는 모델에 보내는 토큰(프롬프트)에 대한 비용, 두 번째는 모델이 생성해 돌려주는 토큰(응답)에 대한 비용입니다.
Claude Opus 4.6은 경제적으로 중요한 작업에 대한 성능을 측정하는 GPDVal-AA 같은 벤치마크에서 선두를 차지해, 대기업 고객이 중시하는 지표에서 강세를 보였습니다. OpenAI는 이 소식에 다소 긴장했을지 모릅니다. Opus 4.6 출시 몇 시간 전, OpenAI는 OpenAI Frontier를 발표했는데, 이는 프로덕션 환경에서 AI 에이전트를 구축·배포·관리하는 새로운 엔터프라이즈 플랫폼입니다.
즉, 모델 벤치마크 경쟁 대신 Frontier는 OpenAI가 자사 모델군을 둘러싼 인프라—특히 에이전트에 공유 비즈니스 컨텍스트와 권한을 부여하고, 시간이 지남에 따라 피드백을 수집·학습하도록 하는 능력—에 집중하고 있음을 보여줍니다. 벤치마크에서 다소 밀리는 상황에서, OpenAI는 자사 플랫폼이 기업 내에서 에이전트를 실제로 유용하게 만드는 데 더 적합하다는 메시지를 내고 있습니다.
이것이 전략적 전환인지, 아니면 모델 경쟁에서 밀리고 있음을 사실상 인정하는 것인지는 판단에 맡기겠습니다.
전반적으로, Anthropic이 Claude Opus 4.6으로 보여준 바는 인상적이며, 에이전트 팀을 직접 다뤄보는 것이 기대됩니다. Claude 제품군을 더 알아보고 싶다면 Introduction to Claude Models 강의를 꼭 확인해 보세요.
DataCamp로 AI를 배우세요
courses
courses
courses