
Kurs
Large Language Models (LLMs) Kavramları
2 sa
113.3K
Büyük Dil Modelleri (LLM’ler), makine öğrenimi modelleri geliştirirken özellikle doğal dil işleme algoritmalarının yeteneklerini artırmada çok önemli hale geldi. Sohbet botlarından içerik üreticilerine kadar bu modeller, teknolojiyle etkileşim biçimimizi dönüştürüyor.
Ancak, LLM’lerin sayısı ve karmaşıklığı arttıkça, performanslarını değerlendirmek daha da önemli oluyor. Uygun ve doğru bir değerlendirme olmadan, bir modelin beklenen şekilde çalışıp çalışmadığını veya ayarlamalara ihtiyaç duyup duymadığını bilmek zordur.
İşte bu noktada MLflow devreye giriyor. MLflow, makine öğrenimi deneylerinin yönetimini kolaylaştırmak için tasarlanmış açık kaynaklı bir araçtır. Farklı deneylerin sonuçlarını izlememize, modelleri yönetmemize ve her şeyi düzenli tutmamıza yardımcı olur!
Bu eğitimde, MLflow’un LLM iş akışlarını nasıl geliştirdiğini inceleyeceğiz. Kurulum adımlarını gösterecek, LLM deneylerinde metrikleri nasıl kaydedeceğinizi ve parametreleri nasıl takip edeceğinizi anlatacağım. Son olarak, MLflow’un etkili model yönetimi ve dağıtımını nasıl desteklediğini göreceğiz.
MLflow, uçtan uca makine öğrenimi yaşam döngüsünü yönetmek için tasarlanmış açık kaynaklı bir platformdur. Makine öğrenimi modellerinin geliştirilmesi, izlenmesi ve dağıtımını kolaylaştıran araçlar sunar.
İster küçük bir proje üzerinde çalışalım ister büyük modellerle karmaşık deneyleri yönetecek olalım, MLflow düzenli ve verimli kalmamıza yardımcı olabilir.
Makine öğrenimi yaşam döngüsünde MLflow kullanmanın bazı avantajları şunlardır:
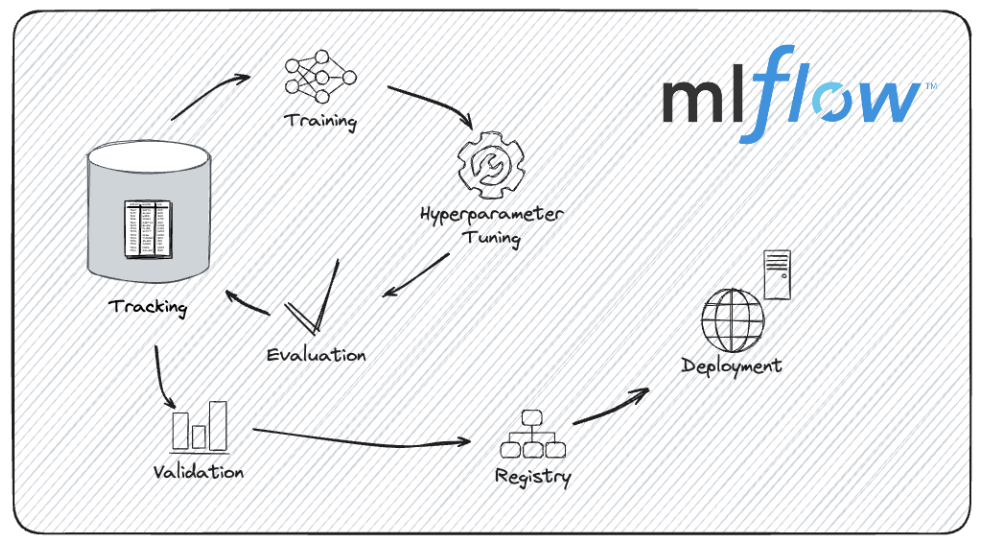
MLflow ile model geliştirme yaşam döngüsü. Görsel kaynağı: MLflow dokümantasyonu.
MLflow, makine öğrenimi projelerinin yönetimini daha sorunsuz ve şeffaf hale getirmek için tasarlanmıştır. Bu, özellikle LLM gibi karmaşık modellerle çalışırken faydalıdır; şimdi bunu göreceğiz.
LLM değerlendirmesinde MLflow kullanmanın; model sürümlerini izleme, değerlendirme metriklerini kaydetme ve alanlar genelinde performansı karşılaştırma gibi çeşitli faydaları vardır.
Bu faydaları şimdi daha ayrıntılı inceleyelim.
LLM’lerin geliştirilmesi sık yinelemeler ve iyileştirmeler içerir. Her yeni sürüm küçük iyileştirmeler veya davranış değişiklikleri getirir. MLflow, model sürümlerini sistematik olarak izleyerek bu farklı yinelemeleri yönetir. Bu sayede sonuçları yeniden üretmemize, farklı sürümleri etkili şekilde karşılaştırmamıza ve model evriminin net bir geçmişini tutmamıza olanak tanır.
Diyelim ki farklı ince ayar teknikleri deniyoruz; MLflow her sürümün sonuçlarını yönetmemize ve gözden geçirmemize yardımcı olarak hangi yinelemenin en iyi performansı verdiğini belirlemeyi kolaylaştırır.
MLflow her deneyi ve ilişkili sonuçları eksiksiz kaydettiği için, bulgularımızı güvenle paylaşabiliriz; başkalarının sonuçlarımızı birebir yeniden üretebileceğini biliriz.
Projemiz farklı LLM mimarileri veya eğitim metodolojileri ile denemeler yapmayı içeriyorsa, MLflow’un izleme yetenekleri çalışmamızı belgeleme ve paylaşmayı kolaylaştıracaktır.
LLM’leri değerlendirmek, doğruluk, perplexity ve F1 skoru gibi birkaç metriğin izlenmesini içerir.
MLflow’un günlükleme işlevi, bu metrikleri verimli ve düzenli bir biçimde kaydetmemizi sağlar. Bu metrikleri analiz etmek, model performansımızın net bir resmini sunar.
Örneğin, farklı hiperparametrelerin veya eğitim veri kümelerinin modelin performans metriklerini nasıl etkilediğini karşılaştırmak isteyebiliriz. MLflow ile bu metrikleri kaydedip görselleştirerek eyleme dönüştürülebilir içgörüler elde edebiliriz.
Modeller gerçek dünyada dağıtılıp kullanıldığında, model kayması yaşayabilir; veri veya ortam değişiklikleri nedeniyle performansları düşebilir. Zaman içinde model performansını izleyerek ve yöneterek model kaymasını takip etmek için MLflow’dan yararlanabiliriz.
Düzenli değerlendirmeler kurabilir ve MLflow’u kullanarak performans metriklerinin nasıl değiştiğini kaydedip analiz ederek gerçek zamanlı eyleme dönük kararlar alabiliriz.
MLflow’un en önemli avantajlarından biri, kapsamlı model karşılaştırmalarını basitleştirebilmesidir. Farklı deneylerin ayrıntılı kayıtlarını tutarak, çeşitli LLM’lerin ve hiperparametre yapılandırmalarının performansını yan yana karşılaştırmamıza olanak tanır.
Doğru hiperparametreleri bulmak, LLM geliştirirken bir modelin başarısını belirleyebilir.
Bir LLM’i ince ayar yaptığımızı ve farklı hiperparametre ayarlarının etkisini değerlendirmek istediğimizi hayal edin. MLFlow’u kullanarak, öğrenme oranları, yığın boyutları veya dropout oranları gibi farklı sonuçları kaydedip karşılaştırabilir, en iyi performansı veren yapılandırmayı belirleyerek model geliştirme sürecimizi optimize edebiliriz.
MLflow’un model kaydı ve izleme işlevleri, dağıtım için birden fazla LLM’yi değerlendirirken devreye girer.
Üretim ortamı için düşündüğümüz bir dil modelinin birkaç sürümüne sahip olduğumuzu varsayalım. MLflow, her modelin performans metriklerini kaydetmemize, karşılaştırmamıza ve yalnızca sezgiye dayanmak yerine ampirik kanıtlara dayalı bilinçli bir karar vermemize yardımcı olabilir.
Artık MLflow ve faydalarına dair daha net bir resme sahip olduğumuza göre pratiğe geçelim!
LLM’leri MLflow ile değerlendirmeden önce, platformu doğru şekilde kurmamız gerekir. Bu, MLflow’un kurulmasını, isteğe bağlı olarak uzaktan günlükleme için bir izleme sunucusunun yapılandırılmasını ve ortamımızın deneyleri yönetmeye ve sonuçları izlemeye hazır olduğundan emin olmayı içerir.
Bunu nasıl yapacağımıza bakalım.
1. Python’ın kurulu olduğundan emin olun:
Öncelikle, makinemizde Python’ın kurulu olduğundan emin olmamız gerekir. MLflow, Python 3.6 ve üzeri ile uyumludur (Python 3.8’in kullanım dışı bırakıldığını unutmayın; bu nedenle Python >= 3.9 kullanılması önerilir). Python sürümümüzü şu komutla kontrol edebiliriz:
python --version2. Sanal ortam oluşturun (isteğe bağlı ancak önerilir):
Özellikle Mac OS X ile çalışıyorsak, MLFlow ile deneyleri izlerken sanal bir ortam kullanmak iyi bir uygulamadır. venv veya virtualenv kullanarak bir ortam oluşturabiliriz.
python -m venv mlflow-envSanal ortamı etkinleştiriyoruz:
Windows’ta:
mlflow-env\Scripts\activateMac/Linux’ta:
source mlflow-env/bin/activate3. pip ile MLflow’u kurun:
Sanal ortam etkinleştirildikten sonra (kullanıldıysa), MLflow’u pip ile kurabiliriz:
pip install mlflow4. Ek bağımlılıkları yükleyin:
MLflow, gelişmiş işlevler için bazı isteğe bağlı bağımlılıklara sahiptir. MLflow’un model sunum özelliklerini kullanmamız gerekiyorsa gunicorn kurmamız gerekir.
pip install gunicornTensorFlow veya PyTorch gibi kütüphaneler kullanıyorsak, ilgili MLflow entegrasyonlarını kurmamız gerekebilir:
pip install mlflow[extras]4. Kurulumu doğrulayın:
Ardından MLflow’un doğru kurulduğundan emin olmak için sürümünü kontrol etmeliyiz:
mlflow --versionEğer işbirliğine dayalı bir ortamda çalışıyorsak veya uzaktan günlükleme yapmamız gerekiyorsa bir MLflow izleme sunucusu kurmalıyız. Bu özellik, deney takibini ve yönetimini merkezileştirmemize olanak tanır.
1. İzleme sunucusunu çalıştırın:
MLflow sunucusunu arka uç deposunu ve eser (artifact) konumunu belirterek başlatabiliriz.
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri, deney verilerinin nerede saklanacağını belirtir. Herhangi bir veritabanı sistemi (PostgreSQL, MySQL, vb.) kullanılabilir.--default-artifact-root, eserlerin (ör. model dosyaları) saklanacağı dizini belirtir.2. İzleme sunucusunu yapılandırın:
MLflow istemcilerimizin, günlükleri izleme sunucusuna yazacak şekilde yapılandırıldığından emin olmalıyız. Sunucumuzu işaret edecek şekilde MLFLOW_TRACKING_URI ortam değişkenini ayarlayabiliriz.
export MLFLOW_TRACKING_URI=http://localhost:50003. İzleme arayüzüne erişin:
Artık bir web tarayıcısı açıp http://localhost:5000 adresine giderek MLflow arayüzüne erişebiliriz. Bu arayüz, deneyleri görüntülememize, sonuçları karşılaştırmamıza ve MLflow projelerinizi yönetmemize olanak tanır; bunu ileride göreceğiz.
MLflow’u kurup hazır hale getirdikten sonra, LLM’leri yükleme ve değerlendirme gibi temel görevlere geçme zamanı. Önceden eğitilmiş bir LLM’i nasıl seçeceğimizi, farklı kütüphanelerle nasıl yükleyeceğimizi ve modelin performansını ölçmek için bir değerlendirme veri kümesini nasıl hazırlayacağımızı görelim.
Önceden eğitilmiş bir LLM seçerken, Hugging Face Transformers gibi kütüphaneler birçok seçenek sunar. Örneğin, önceden eğitilmiş bir modeli, GPT’yi (metin üretimi için) veya BERT’i (metin sınıflandırma ve diğer görevler için) yükleyebiliriz.
1. Hugging Face Transformers’ı yükleyin
Öncelikle, Hugging Face Transformers kütüphanesinin kurulu olduğundan emin olacağız. Bunu pip kullanarak yapabiliriz.
pip install transformers2. Önceden eğitilmiş bir model ve ayrıştırıcıyı yükleyin
Şimdi, metni işlemek ve tahminler üretmek için gerekli olan hem modeli hem de ayrıştırıcıyı (tokenizer) içeren transformers kütüphanesini kullanarak BERT modelini yüklüyoruz.
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
Üzerinde çalıştığımız metin verileri çoğunlukla küçük ve büyük harf içeriyor ancak modelin büyük/küçük harf ayrımı yapmasına gerek duymuyorsak, bert-base-uncased modeli kullanılır.
Bir LLM’i değerlendirmek için, değerlendirdiğimiz göreve uygun bir veri kümesine ihtiyaç duyarız. Duygu analizi için metin tabanlı bir değerlendirme veri kümesinin nasıl hazırlanacağına bakalım:
1. Veri kümesini yükleyin veya oluşturup ön işleyin
Verilerimiz çeşitli yerlerde saklanabilir: yerel makinemizin diskinde, bir Github deposunda veya topluluk tarafından derlenen ve popüler araştırma veri kümelerinin bulunduğu geniş bir koleksiyon olan Hugging Face Hub’da.
Bu eğitim için, duygu analizi için büyük bir film incelemesi veri kümesi olan IMDB’yi kullanacağız. Hazır veri kümesini yüklemek için datasets kütüphanesini kullanacağız:
Datasets kütüphanesini yükleme:
pip install datasetsBir veri kümesi yükleme:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. Duygu analizi için ön işleme
Veri kümesini duygu analizi için ön işlemek üzere daha önce yüklediğimiz BERT ayrıştırıcısını kullanacağız.
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)LLM’ler yüklendi ve değerlendirme veri kümemiz hazır olduğuna göre, değerlendirmeleri çalıştırma ve metrikleri kaydetme zamanı.
1. MLflow’u içe aktarın ve yeni bir deney başlatın
Deneyleri MLflow ile izlemek için önce yeni bir deney başlatmamız ve model adı, sürümü ve değerlendirme parametreleri gibi ilgili metaverileri kaydetmemiz gerekir.
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. Değerlendirme parametrelerini kaydedin
Şimdi değerlendirme süreciyle ilgili parametreleri, örneğin değerlendirme veri kümesi boyutu veya değerlendirme sırasında kullanılan belirli yapılandırmaları kaydedebiliriz.
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))Modelimizi eğitip ilgili tahminleri yaptıktan sonra, LLM’i değerlendirebilir ve performansını yansıtan çeşitli metrikleri kaydedebiliriz.
Duygu analizi bir sınıflandırma problemidir; bu nedenle modelimizi doğruluk ve F1 skoru gibi metriklerle değerlendirebiliriz. Metin üretimi görevleri için, BLEU skoru veya perplexity gibi metrikler yaygın olarak kullanılır.
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)Birden fazla değerlendirme çalışması MLflow ile izlendiğinde, en iyi performans gösteren model ve yapılandırmaları belirlemek için sonuçları karşılaştırmak kritik öneme sahiptir.
Birden fazla çalışmanın nasıl izleneceğini ve MLflow’un arayüzünün sonuçları etkili biçimde görselleştirip karşılaştırmak için nasıl kullanılacağını anlayalım.
Öncelikle, farklı LLM sürümlerinin performansını karşılaştırmak için aynı deney içinde veya farklı deneylerde birden çok çalışmayı izlememiz gerekir.
1. Birden çok çalışmayı kaydedin
Değerlendirmek istediğimiz her model veya yapılandırma için yeni çalışmalar başlatarak tek bir deney altında birden çok çalışmayı kaydedebiliriz.
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. Farklı modellerle deneyleri izleyin
Farklı türde modelleri değerlendirmek istediğimizi varsayalım. Bu amaçla MLFlow’u kullanarak bir deney oluşturabilir ve modelleri birlikte kaydedebiliriz.
MLFlow’da model günlükleme yapmak, makine öğrenimi modelleri için sürüm kontrolü yapmakla aynı mantıktadır. Model ve ortam ayrıntılarını kaydetmek tekrarlanabilirliği garanti eder.
Önce bir deney kuracağız. Ardından, her modeli ayrı bir MLFlow çalışmasında, çalışma kimlikleri (run ID) ve eser yolları (artifact path) dâhil olmak üzere kaydedeceğiz.
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
Şimdi modelleri değerlendirebilir ve sonuçları kaydedebiliriz. MLflow, LLM’lerimizi değerlendirmeye yardımcı olmak için mlflow.evaluate() API’sini sağlar.
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)Farklı metrikleri ve modelleri MLFlow’da kaydettikten sonra karşılaştırma yapabiliriz. MLflow’un kullanıcı dostu arayüzünü kullanarak farklı çalışmalardan elde edilen değerlendirme metriklerini görselleştirip karşılaştırabiliriz. Bunu yapmak için, MLflow sunucusu çalışmıyorsa başlatmamız gerekir
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsArdından bir web tarayıcısı açıp http://localhost:5000 adresine giderek MLflow arayüzüne erişiriz. MLflow arayüzünde, tüm deneylerimizi görmek için "Experiments" sayfasına gideriz. İlgili çalışmalara ait listeyi görmek için deney adına tıklarız.
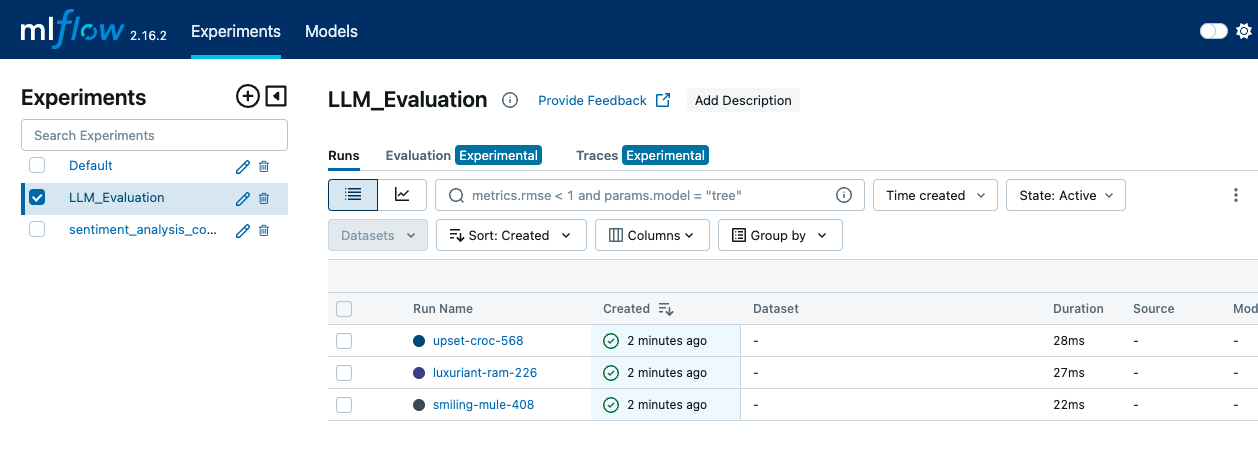
MLFLow arayüzü, farklı çalışmaların ve günlük olaylarının görülebildiği Experiments sekmesini gösteriyor — görsel: Yazar.
Bir deney içinde, birden fazla çalışmayı seçerek ve metriklerini yan yana görüntüleyerek farklı çalışmaları karşılaştırabiliriz.
Arayüz, doğruluk, F1 skoru ve diğer değerlendirme metriklerinin görsel temsillerini görmemizi sağlar. Daha ayrıntılı karşılaştırmalar için MLflow’un yerleşik görselleştirmelerini kullanarak grafikler ve çizimler üretebiliriz.
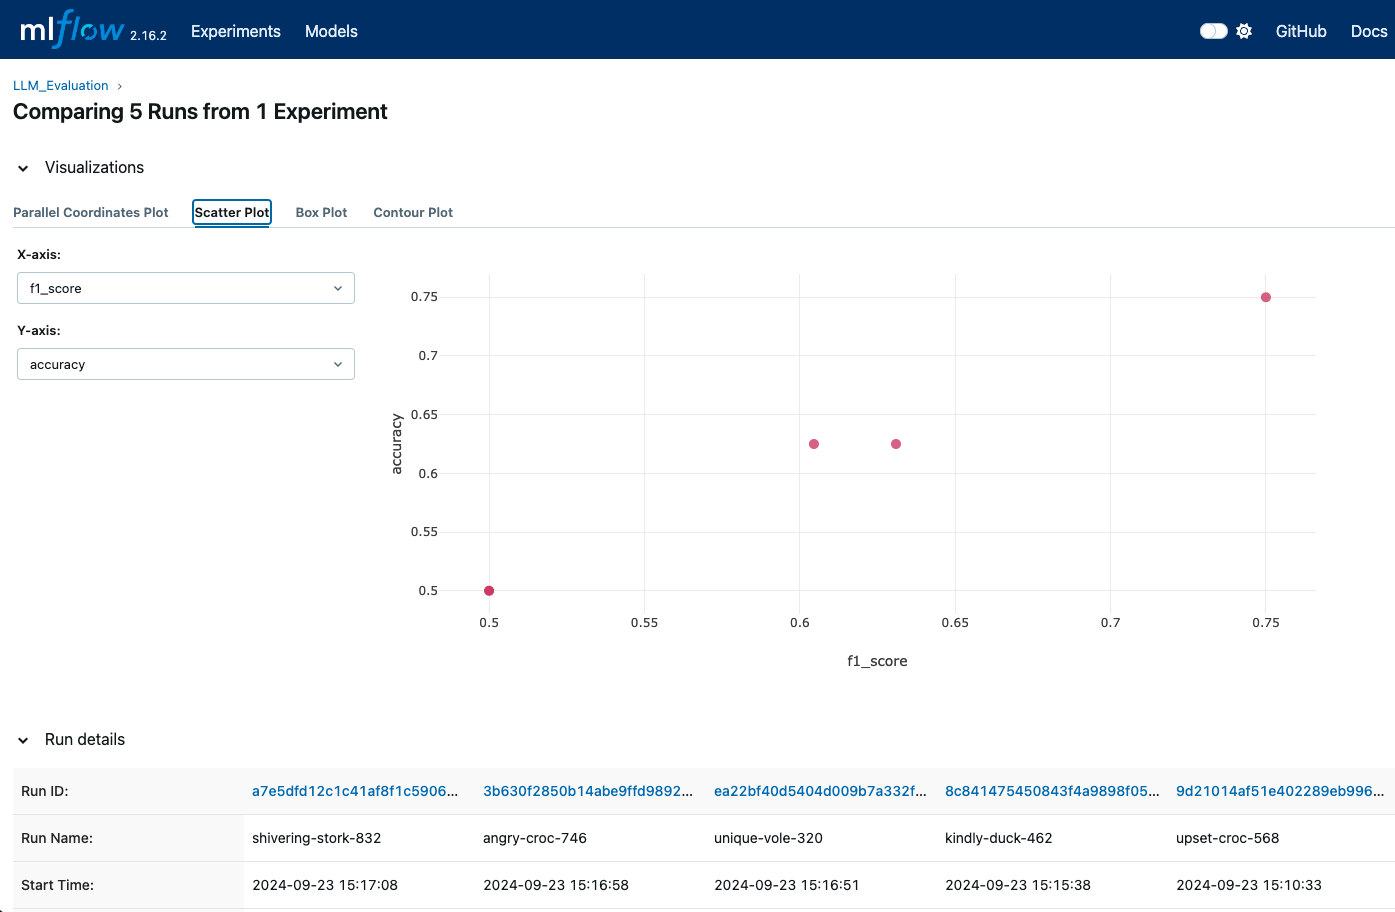
MLFlow görselleştirmeleri, farklı çalışmaların ne zaman günlüğe alındığını göstererek metrikleri karşılaştırmamıza yardımcı olabilir — görsel: Yazar.
MLflow arayüzü her çalışma için ayrıntılı grafikler ve günlükler sunar. Kaydedilen metriklere göre hangi modelin veya yapılandırmanın en iyi performansı gösterdiğini anlamak için bu günlük ve görselleştirmelere erişebiliriz.
LLM’lerin daha derin ve kapsamlı bir değerlendirmesi için MLflow, izleme ve analizi geliştiren ileri teknikler sunar. Deneylerimizin ayrıntılı takibi için model eserlerinin nasıl kaydedileceğini ve hiperparametre ayarı için MLflow’un nasıl kullanılacağını gözden geçireceğiz; böylece LLM performansını optimize ederiz.
Model eserlerini kaydetmek, deneylerimizin ayrıntılarını korumak ve analiz etmek için çok önemlidir. Eserler, model performansımıza dair eksiksiz bir resim sunabilir ve sonuçları yeniden üretmeye yardımcı olabilir.
Kaydedebileceğimiz eserler arasında şunlar bulunur:
joblib veya TensorFlow SavedModel formatı) model ağırlıklarını kaydedip günlüğe alabiliriz.İşte bir örnek:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
mlflow.log_artifact("generated_outputs.txt")Hiperparametre ayarı, LLM performansını optimize etmenin temel bir parçasıdır. Deneylerimizde, farklı hiperparametre yapılandırmalarını MLflow ile kaydedebiliriz. Bu, çeşitli ayarların etkilerini karşılaştırmayı ve en iyi yapılandırmayı bulmayı sağlar.
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
MLflow’un bir diğer avantajı, ayarlama sürecini otomatikleştirmek için Optuna veya Ray Tune gibi hiperparametre optimizasyon kütüphaneleriyle birlikte kullanılabilmesidir.
LLM’lerin doğru değerlendirilmesi, testleri çalıştırıp metrikleri kaydetmenin ötesinde bir yaklaşım gerektirir. Tutarlılık, doğruluk ve verimliliği sağlamak için stratejik bir yaklaşım gerekir. En iyi uygulamaları benimsemek, değerlendirme sürecinin güvenilirliğini ve etkinliğini artırabilir.
Kararlı ve temsil gücü yüksek veri kümeleri kullanmak, etkili değerlendirmeye katkıda bulunan ilk adımlardan biridir. Değerlendirme veri kümelerimizin, LLM’imizin gerçekleştirmek üzere tasarlandığı görevleri temsil ettiğinden ve kararlı olduğundan emin olarak, zaman içinde ve farklı modeller veya sürümler arasında anlamlı karşılaştırmalar elde ederiz. Veri kümesi değişirse, performans değişikliklerini model yerine veri kümesine atfetmek zor olabilir.
Sadece veri kümesi değil, veri kümesini nasıl ön işlediğimiz de önemlidir. Tüm değerlendirme veri kümelerine aynı ön işleme adımlarını uygulamalıyız ki sonuçlar karşılaştırılabilir olsun. Buna ayrıştırma (tokenization), normalizasyon ve özel durumların ele alınması dâhildir. Tutarlı ön işleme, model performansındaki farklılıkların verilerin işlenme biçiminden kaynaklanmamasını sağlar.
Yukarıda görüldüğü gibi, MLflow’un model kaydını kullanarak sürüm kontrolü yapmak, LLM’lerimizin farklı sürümlerini izlememize yardımcı olur. Bu, model performansını karşılaştırmayı kolaylaştırır ve gerekirse önceki sürümlere geri dönmeyi sağlar. Mimari, hiperparametreler veya eğitim verilerindeki değişiklikler dâhil olmak üzere tüm ayrıntıları kaydetmeli ve modellere yapılan değişiklikleri takip etmeliyiz.
Son olarak, değerlendirme sürecini sürekli entegrasyon/sürekli dağıtım (CI/CD) hatlarına entegre ederek otomatikleştirmek, güncellemeler yapıldığında modellerin tutarlı ve zamanında değerlendirilmesini sağlar. Model performansını periyodik olarak değerlendirmek için zamanlanmış değerlendirmeler kurmalıyız. Bu, model kaymasını izlememize ve modellerin zaman içinde performans standartlarını karşıladığından emin olmamıza yardımcı olur.
LLM’leri etkili bir şekilde değerlendirmek, yapılandırılmış ve sistematik bir yaklaşım gerektirir; MLflow bu süreci destekleyen bir çerçeve sunar.
Bu eğitimde MLflow’u kurduk ve bir izleme sunucusu yapılandırdık. Ardından, önemli metrikleri kaydederek LLM’imizi değerlendirdik, karşılaştırmak için birden çok çalışmayı izledik ve bu karşılaştırmaları etkili bir şekilde görselleştirip analiz etmek için MLflow arayüzünü kullandık.
MLflow bilgilerinizi bir üst seviyeye taşımak istiyorsanız, Introduction to MLflow kursumuza göz atın!
Bu kurslarla LLM’ler hakkında daha fazlasını öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



