
Program
AI Temelleri
10 sa
ChatGPT’nin lansmanından bu yana, bu teknolojiye odaklanan yeni şirketlerle birlikte her birkaç günde bir yeni bir Büyük Dil Modeli (LLM) ortaya çıkıyor gibi görünüyor. Her yeni LLM, çeşitli açılardan önceki modelleri geride bırakacak şekilde eğitiliyor. Örneğin, belirli bir kullanım senaryosunu geliştirmeye yönelik özelleştirilmiş LLM’leri giderek daha sık görüyoruz: sohbet modelleri, kodlama asistanları ve uzun bağlam anlama gibi.
Yeni bir LLM tabanlı uygulama veya proje için doğru modeli seçmek göz korkutucu olabilir; en yeni modelleri ve özelliklerini takip etmek de ayrı bir meydan okumadır.
Benim durumumda bu, çoğu zaman varsayılan olarak API çağrıları aracılığıyla ChatGPT veya GPT modellerini kullanmama yol açıyor.
Burada, mevcut modellerin sunduğu çeşitliliğe yakından bakmayı ve bir projeye uygun doğru modeli seçerken göz önünde bulundurulması gereken temel yetenekleri öne çıkarmayı amaçlıyorum.
Özellikle, mevcut tüm modeller arasından seçim yaparken dikkate alınması gereken temel özelliklerden biri olarak, bu modellere etkileşim yöntemlerinin farklılıklarına odaklanacağız.
Hedef, bu kapsamlı rehberin bir başvuru kağıdı işlevi görmesi ve belirli görevleriniz için mevcut geniş LLM yelpazesinde yolunuzu bulmanıza yardımcı olmasıdır.
LLM dünyasına yeniyseniz, temel kavram ve modellere aşina olmak için AI Fundamentals ve Large Language Models Concepts kurslarını takip etmenizi gerçekten öneririm.
LLM’lere erişmek ve LLM destekli bir uygulama veya projede onlarla arayüz kurmak, teknik gereksinimlere bağlı olarak çeşitli yöntemlerle yapılabilir.
LLM’lerle arayüz kurmanın en kullanıcı dostu yolu, tarayıcımızdaki konuşmaya dayalı arayüzlerdir. ChatGPT’de olduğu gibi, kullanıcı arayüzü yalnızca modelle etkileşim kurmanıza olanak tanıyan bir sohbet arayüzüdür.
Genel olarak, bu arayüzler kullanıcı tarafından çok az kontrol veya model özelleştirmesi sunar ya da hiç sunmaz; ancak basit görevler için modelleri denemenin kolay bir yoludur. OpenAI’nin ChatGPT’si ve Google’ın Gemini’si bu tür arayüzler sağlar:
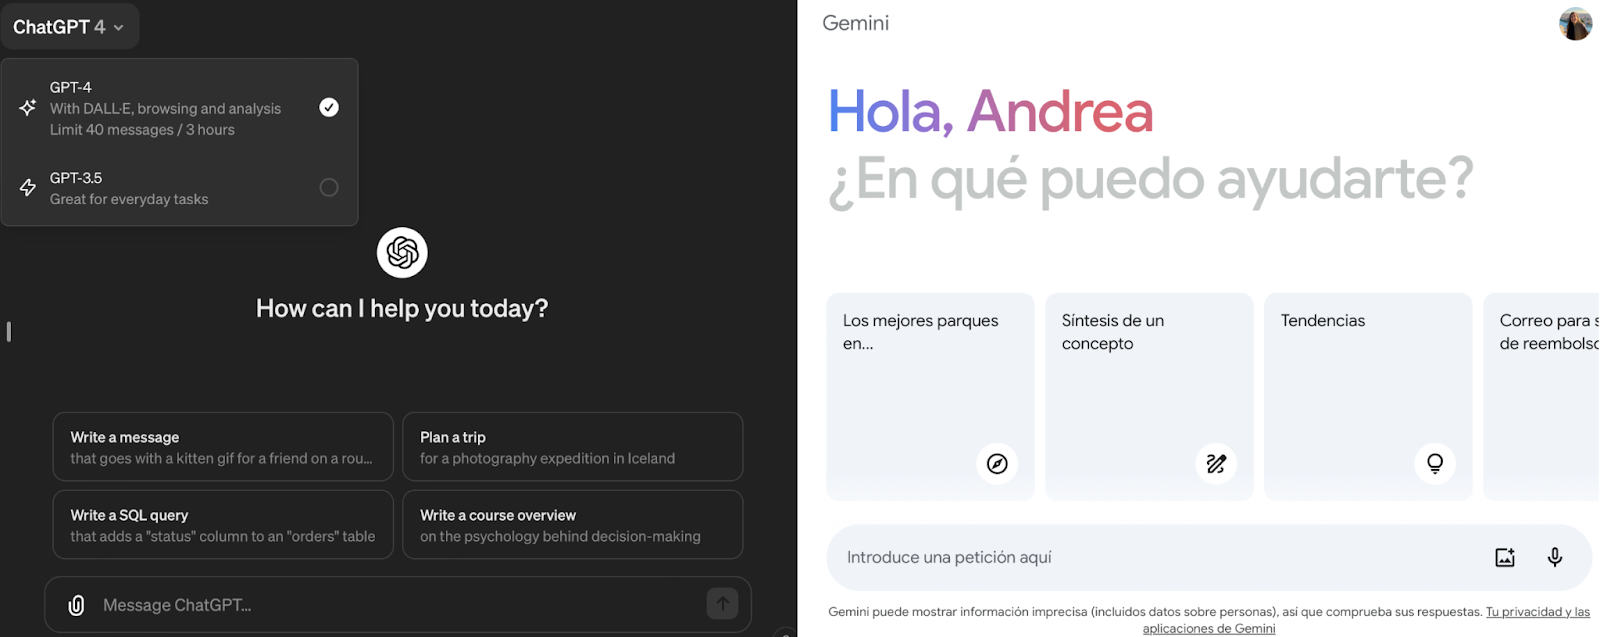
OpenAI’nin ChatGPT (solda) ve Google’ın Gemini (sağda) sohbet arayüzlerinden ekran görüntüsü.
Bazen sağlayıcılar, benzer kullanıcı dostu sohbet arayüzleri üzerinden belirli bir düzeyde özelleştirmeye de izin verir. OpenAI için bu platformun adı “Playground”dur.
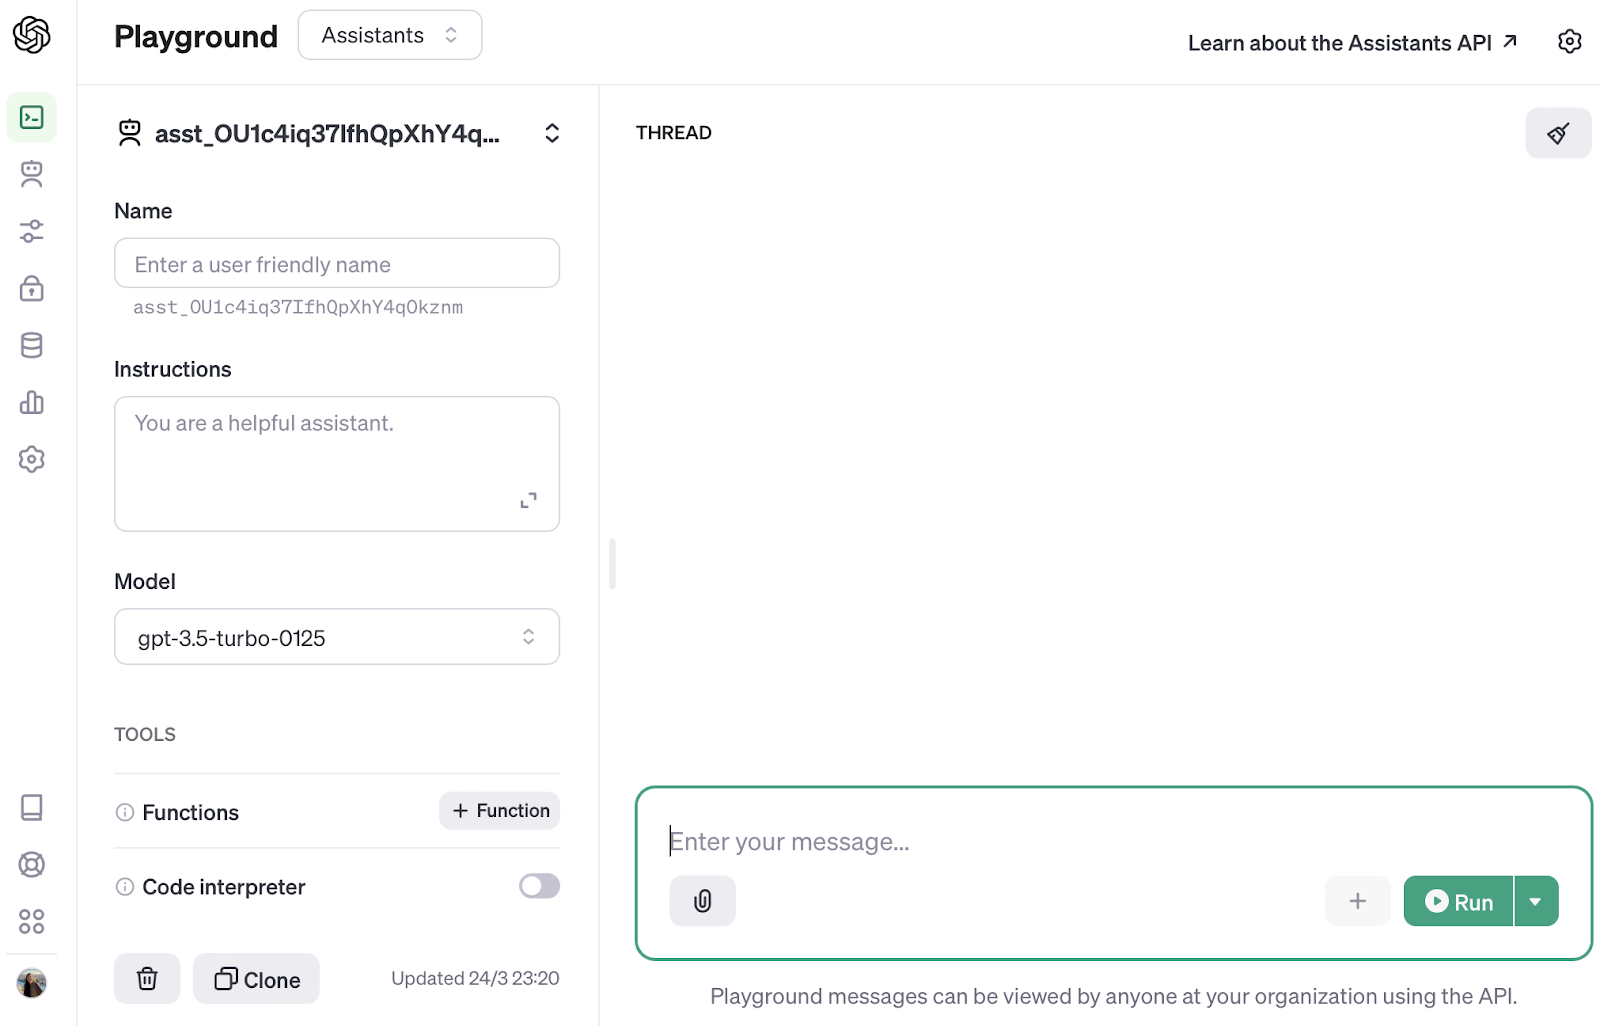
OpenAI Playground arayüzünden ekran görüntüsü.
Playground arayüzleri, ayarlar üzerinde sınırlı kontrolle farklı modelleri denememize olanak tanır. Bu sayede, görevinize uygun parametreleri keşfedebilirsiniz. Yine de, muhtemelen fark ettiğiniz gibi, playground veya sohbet arayüzleri, LLM ile etkileşimi bir uygulama veya projeye gömmemize izin vermez.
LLM’lere sorgu göndermenin en popüler arayüzlerinden biri API erişimidir. Bu yaklaşım, ek model özelleştirmesine ihtiyaç duymadığımız durumlarda özellikle avantajlıdır.
API çağrıları, komut dosyalarımıza zahmetsizce entegre edilebilir; altyapı kurma ve bakım ihtiyacını ortadan kaldırır.
Ancak bu kolaylığın bir bedeli vardır ve modeli kendiniz barındırmamayı ve gerekli altyapıyı yönetmemeyi tercih ettiğiniz sürece dış hizmetlere bağımlı kalınacağından, maliyetler kullanım oranıyla birlikte kaçınılmaz olarak artacaktır.
API çağrılarında iyi bir uygulama, modele modüler şekilde arayüz oluşturmak için API çağrısının etrafına basit bir sarmalayıcı yazmaktır. Şimdiye kadar en çok kullandığım OpenAI API’si için, kullanıcıya model seçiminin şeffaf olmasını sağlamak amacıyla bir sonraki bölümdeki sarmalayıcıyı her zaman kullanırım.
OpenAI API aracılığıyla GPT modellerine standartlaştırılmış ama esnek bir yöntemle sorgu göndermek, modelle sorunsuz ve hataya daha az açık biçimde arayüz kurmak istiyorsanız çok faydalıdır. Bu nedenle, programın başında GPT çağrısını bir sarmalayıcı işlev içinde kurar, böylece model kullanımının uygulama için şeffaf olmasını sağlarım.
openai kütüphanesi (pip install openai), .create yöntemiyle herhangi bir GPT modelini çağırmamıza olanak tanıyan bir ChatCompletion uç noktası zaten sağlar.
.create yönteminin iki zorunlu parametresi vardır:
gpt-4 dahil en gelişmiş modelleri tarafından desteklenir.Bu iki parametre verildiğinde, GPT çağrısını şu şekilde yazabiliriz:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Modeli çağırdığımızda, tamamlamayı JSON biçiminde geri alırız:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Bu nedenle, işlev çıktısı olarak yalnızca model tamamlamasını almak ilgi çekici olacaktır. Tüm parçaları bir araya getirirsek, sarmalayıcı uygulamamız şu şekilde yazılabilir:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Bu uygulama hakkında daha fazla ayrıntıyla ilgileniyorsanız, ChatGPT API Calls: A Gentle Introduction makalesi ayrıntıları daha da inceliyor!
Son olarak, OpenAI dahil çoğu API sağlayıcısının hesabınızı oluşturduğunuzda bir miktar ücretsiz çağrı sunduğunu da belirtmek gerekir. Yine de krediler sınırlıdır (genellikle 20 $’ın altında) ve genellikle bir zaman penceresiyle (genelde bir ay) kısıtlıdır.
Her durumda, sağlayıcıdan bağımsız olarak modelin uygulama için şeffaf olması amacıyla LLM çağrılarını bir işlev -ya da işlevler koleksiyonu- içine sarmak her zaman iyi bir pratiktir.
Modeli kendimizin barındırması, model ağırlıklarını indirip yerel makinelerde veya özel sunucularda çalıştırmayı içerir.
Bu yaklaşım, model altyapısı üzerinde tam denetim sağladığı için caziptir; ancak teknik çabanın ciddi ölçüde artması anlamına da gelir.
Bir LLM için altyapıyı çalıştırmanın hangi adımları içerdiğini merak ediyorsanız, LLMOps Essentials makalesine göz atın!
Modeli yerelde çalıştırmak, ihtiyaçlarımıza göre daha fazla özelleştirmeyi mümkün kılar. Bu bağlamda, kendi kendine barındırma için en popüler seçeneklerden biri Meta AI’nin tanınmış LLaMa modelleridir. Yalnızca 8 GB RAM’e sahip bir dizüstü bilgisayarda çalıştırılabilecek hafif modeller yayımladılar.
Ollama gibi platformlar sayesinde LLaMa modelini dizüstü bilgisayarımızda çalıştırmak oldukça kolaydır.
Ollama, LLaMa 2 ve Code LLaMa gibi LLM’leri cihazlarımızda yerelde çalıştırmaya yönelik bir platform sunar. macOS, Linux ve Windows’u destekler; özelleştirme ve mülkiyete tabi modeller oluşturmayı mümkün kılar. Daha fazla bilgi için Ollama’nın web sitesini ziyaret edebilirsiniz.
Ollama platformu resmi sayfadan indirilebilir; model ağırlıkları ise doğrudan terminal arayüzüyle çekilebilir.
Önce ana sayfasına giderek Ollama’yı kuralım!
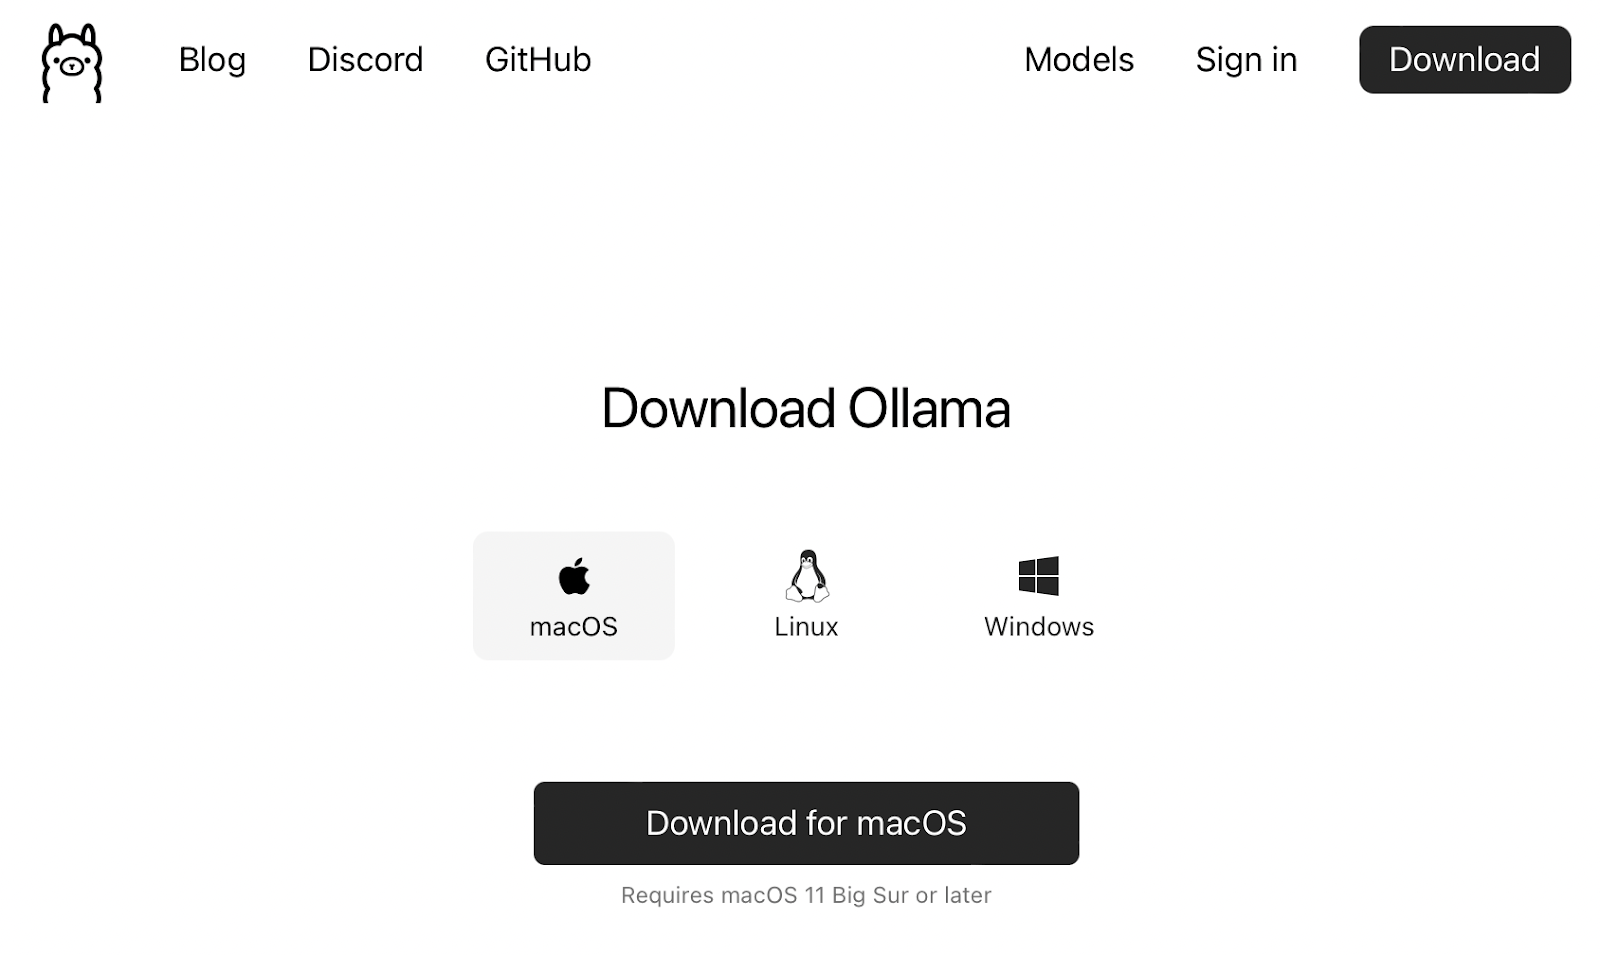 Ollama’nın web sitesinin ana sayfasından ekran görüntüsü.
Bu durumda Ollama bir komut satırı aracıdır:
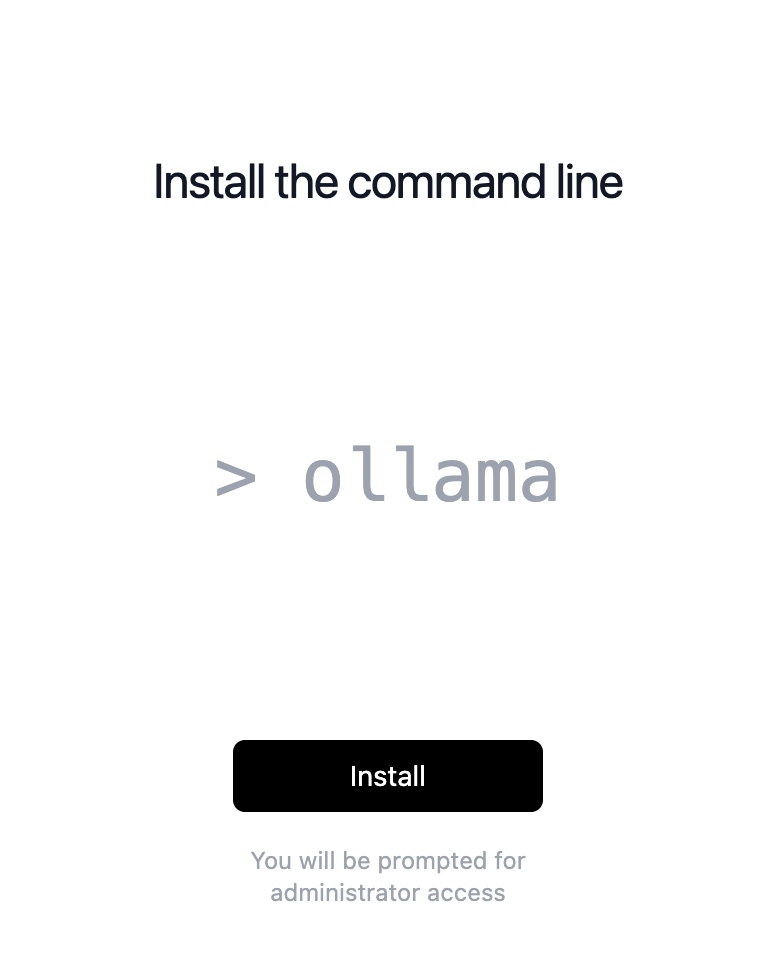
Ollama komut satırı aracı kurulumundan ekran görüntüsü.
Komut satırı aracı kurulduktan sonra, ollama run <model name> komutuyla modeli başlatabiliriz. Modeli cihazımızda ilk kez çalıştırıyorsak, Ollama modeli bizim için çekecektir:
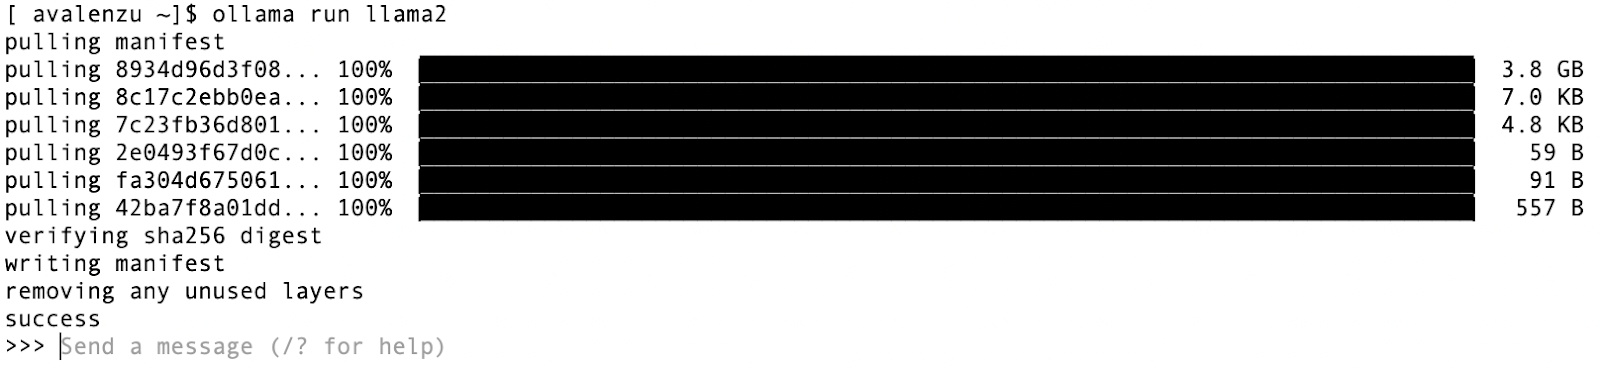
Ollama komut satırı aracıyla LLaMa 2 modelinin ilk çalıştırılmasından ekran görüntüsü. İlk kullanımda model otomatik olarak çekilir.
Bu andan itibaren, komut satırından modele prompt vermek ve çıkmak oldukça basittir:
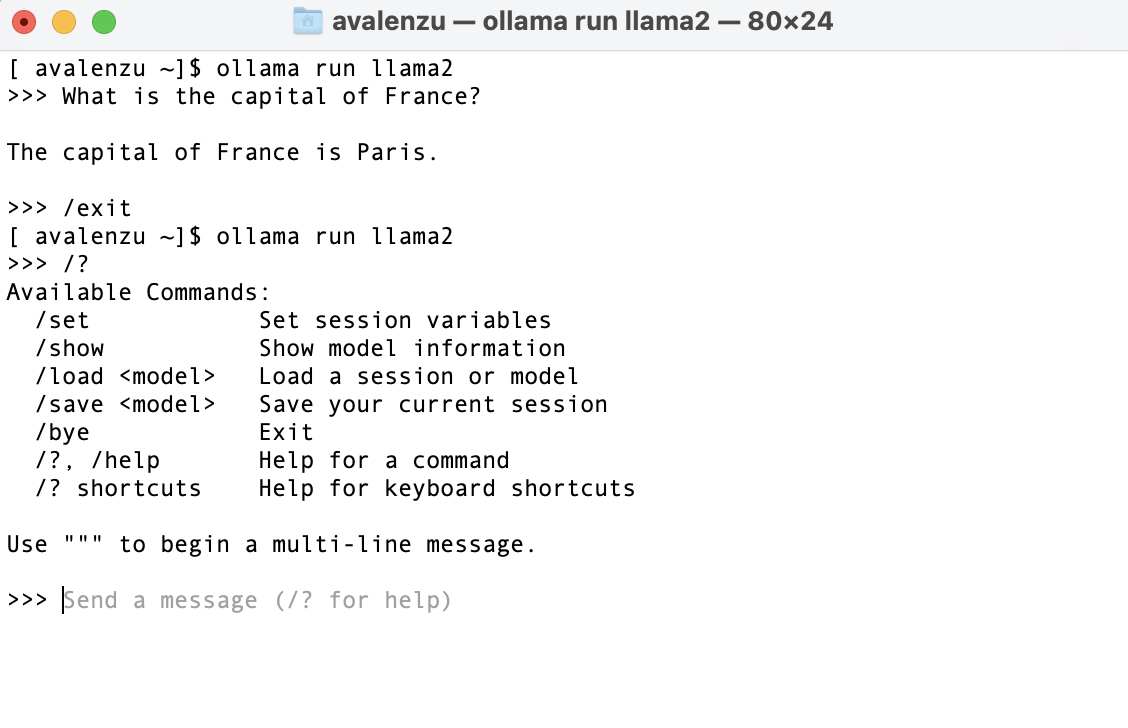
Ollama komut satırı aracı aracılığıyla modelle kullanıcı etkileşiminden ekran görüntüsü.
Yukarıdaki görselde de görülebileceği üzere, model ayrıca küçük bir ek komut kümesi sunar.
Ollama yeni Mistral gibi diğer modelleri de destekler:
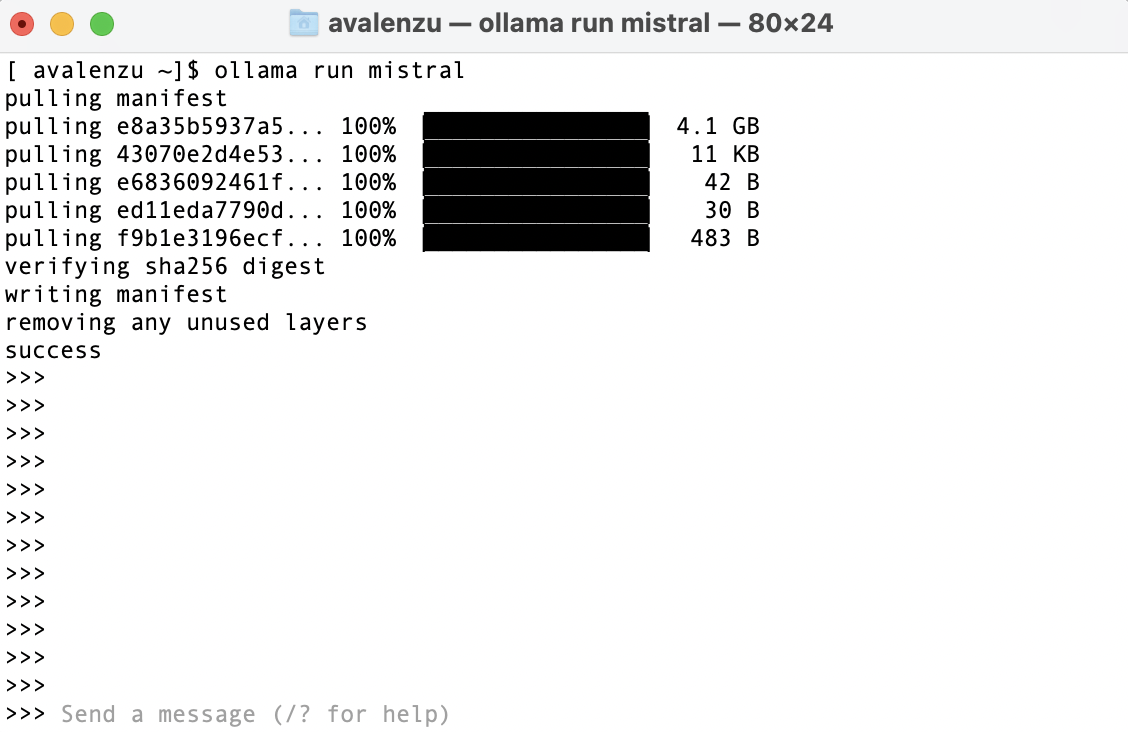
Ollama komut satırı aracıyla Mistral modelinin ilk çalıştırılmasından ekran görüntüsü. İlk kullanımda model otomatik olarak çekilir.
Model yine tek bir komutla kutudan çıktığı gibi kullanıma hazırdır!
Bu yaklaşım avantajlıdır çünkü yalnızca cihazımızın kaynaklarını tüketir. Ancak, model performansının genel olarak parametre sayısıyla arttığını unutmamak önemlidir.
Dolayısıyla, bir modelin parametre sayısı arttıkça ihtiyaç duyacağı kaynak da artar. Bu nedenle, daha büyük modelleri kendi kendine barındırılan LLM uygulamaları için muhtemelen özel sunucularda çalıştırmak gerekecektir.
Geniş ölçekli bir uygulama kurmak istersek, Ollama’nın Mac’te Docker Desktop ile ve Linux’ta GPU hızlandırmalı Docker konteynerleri içinde de çalışabildiğini not etmek gerekir.
Bu noktada aklınıza şu soru gelebilir: OLLAMA’yı betiklerime gömebilir miyim?
Elbette, modeli kendiniz barındırmanız, onu Python betiklerinize entegre edemeyeceğiniz anlamına gelmez! Ollama, kendi kendine barındırılan modelinizle Python üzerinden arayüz kurma olanağı da sunar.
Ollama’nın Python ve JavaScript kütüphaneleri, çıkarımı betiklerimize dahil etmemizi sağlar.
Modeli kendimiz barındırmak istersek Ollama tek seçenek değildir. Genel olarak, LLM’ler topluluk desteği de sunan çok sayıda açık kaynak platformda indirilebilir durumdadır.
Açık kaynak LLM’ler genellikle akademik ve araştırma amaçlı kullanım için ücretsizdir. Ancak ticari kullanım koşulları, modelin yayımlandığı belirli lisansa bağlı olarak değişebilir. LLM’lerle deney mi yaptığınız yoksa ticari amaçlı LLM tabanlı uygulamalar mı geliştirdiğiniz konusunda daima farkında olun.
Bugün LLM geliştirme yolculuğunuza başlamak ister misiniz? O halde Developing Large Language Models kursu sizin için!
Güçlü modelleri yerelde barındırmak çok kaynak tüketebilir; bu nedenle bulut hizmetleri ölçeklenebilir kaynak kullanımını talebe göre mümkün kılar ve bulut sağlayıcılarından destek sunar, dolayısıyla uygulanabilir bir alternatiftir.
Azure gibi geleneksel bulut hizmetlerinin artık Mistral gibi LLM’leri barındırmak için özelleştirilmiş işlem hatları sunduğunu, böylece özel barındırma uygulamanız gerekmediğini belirtmek gerekir.
Bu, kuruluş içinde uygulama dağıtmak için önemli bir avantajdır; zira birçok şirket zaten e-posta ve genel bulut çözümleri gibi hizmetler için bu sağlayıcılarla sözleşmelere sahiptir.
Üçüncü taraf sağlayıcıları tercih etmek, ana sağlayıcıya ait API hizmetini kullanmaya kıyasla sunucu altyapısını yönetmeme ile model üzerinde bir miktar kontrol sahibi olma arasında bir denge sağlayabilir.
Bu sağlayıcılar genellikle API erişimi sunar; ancak yoğun kullanımda maliyetlerin, OpenAI’nin yerel API’sini kullanmaya benzer şekilde, önemli ölçüde artabileceğini unutmamak gerekir.
Temel fark, barındıran tarafta yatar. Modeli, yerel LLM hizmetleri yerine üçüncü taraf sağlayıcılar kendi altyapılarında barındırır ve API uç noktasını sunarlar; sıklıkla farklı kaynaklardan çeşitli modeller sunarak esnek entegrasyon imkanı sağlarlar.
Popüler üçüncü taraf API sağlayıcılarından biri LLAMA API’dir.
LLAMA API web sitesinin ana sayfasından ekran görüntüsü.
API ücretsiz değildir; ancak her yeni hesap için 5 $ tutarında ücretsiz kredi tanımlandığından ücretsiz deneyebilirsiniz. Yine de bu kredilerin verildikten sonra yalnızca bir ay geçerli olduğunu unutmayın.
LLAMA API’yi kullanmak oldukça basittir. Kurulduktan sonra (pip install llamaapi), ilk deneme çağrısını şu şekilde yapabiliriz:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Ancak OpenAI API’sinde olduğu gibi, API çağrısını bir sarmalayıcı işlev içine gömmek iyi bir pratiktir. Daha öncekiyle aynı yaklaşımı izleyerek:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Bu uygulama sayesinde, llm_call() işlevini çağırarak LLM’den dize yanıtını geri alacağız:
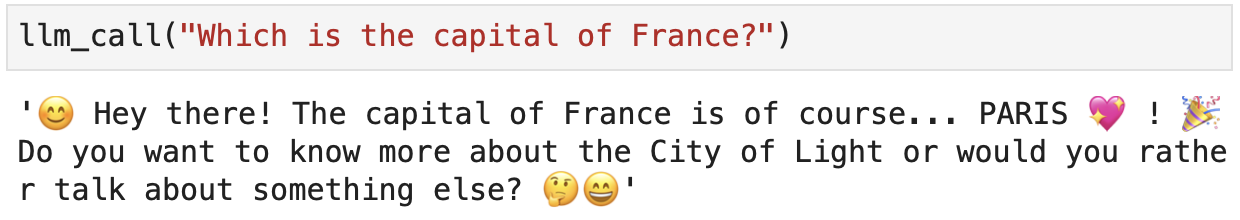
LLAMA API, yalnızca Meta’nın LLaMa’sını değil, çeşitli son teknoloji modelleri destekler. Hangi modelleri desteklediğini bir sonraki bölümde göreceğiz!
Son olarak, LLAMA API özelinde, API maliyeti modelin parametre sayısına bağlıdır ve tüm modellerde sabit gibi görünmektedir:
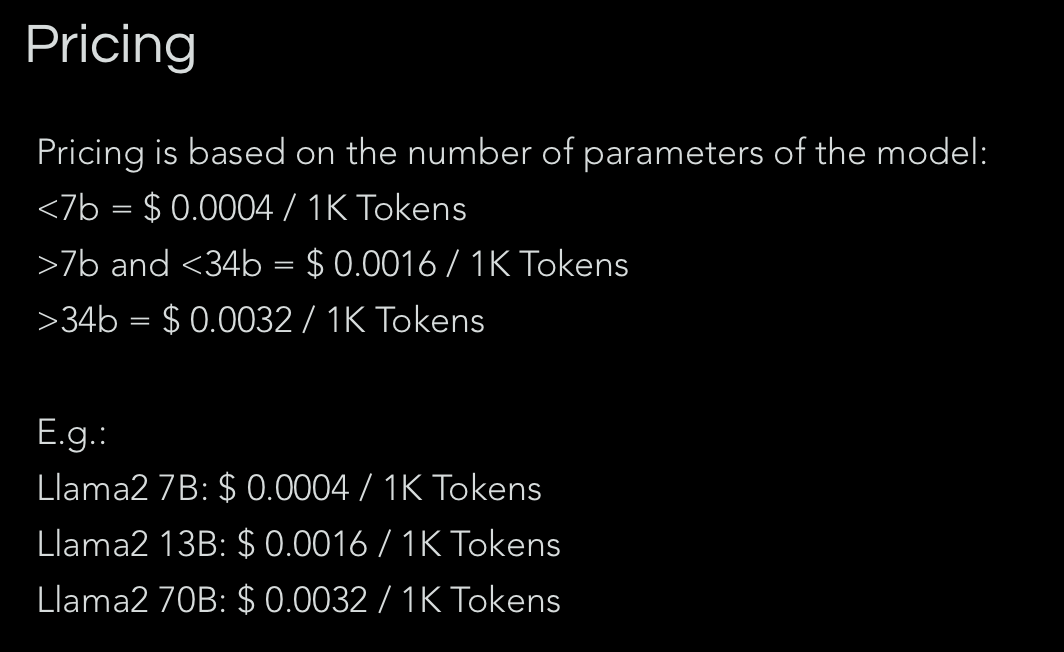
LLAMA API fiyatlandırmasının ekran görüntüsü. Bu bilgi yalnızca bir hesap oluşturduğunuzda görüntülenebilir.
LLM’ler için en popüler üçüncü taraf sağlayıcı Hugging Face’tir. Hugging Face, çoğunlukla Python’daki Doğal Dil İşleme için en popüler kütüphane olan transformers kütüphanesiyle bilinir.
Hugging Face, LLM’lere erişmek için birden fazla arayüz sağlar. “Spaces” adlı kullanıcı dostu bir playground arayüzü vardır:

Hugging Face’teki “Spaces” playground’undan ekran görüntüsü.
Ayrıca model barındırma ve uç nokta dağıtımı ile modellerin doğrudan indirilip yerelde kullanılmasına da olanak tanır.
Hugging Face’in bir tür “geliştirici sitesi” olduğunu akılda tutmak önemlidir; başlangıç için eğitimler bulabilseniz de, modellerini kullanarak bir uygulamayı ölçeklendirmek teknik bilgi gerektirir.
Hugging Face hakkında daha fazla bilgi edinmek isterseniz, What is Hugging Face? The AI Community's Open-Source Oasis makalesini şiddetle öneririm.
Sıfırdan LLM destekli uygulamalar oluştururken genellikle Hugging Face ile birlikte kullandığım tamamlayıcı araçlardan biri de LangChain’dir. How to Build LLM Applications with LangChain öğreticisi güzel bir uygulamalı giriş sağlar.
GPT, LLaMa ve Mistral gibi LLM’lere erişmenin ve bunları çalıştırmanın farklı yöntemlerini tartıştık. Ancak, adı geçenlerin çeşitli varyantları da dahil olmak üzere çok daha fazla model mevcut. Bu bölümde, bugün var olan başlıca modelleri sınıflandıracak, özelliklerini, fiyatlarını ve kullanım alanlarını listeleyeceğiz.
OpenAI modelleri, ChatGPT’nin lansmanından bu yana oldukça popüler hale geldi; aboneliğinize bağlı olarak artık GPT-3.5 veya GPT-4 tarafından destekleniyor. Birçok temel görev için GPT-3.5 ile GPT-4 arasındaki fark belirgin değildir.
Ancak GPT-4, önceki modellere kıyasla daha karmaşık akıl yürütme senaryolarında çok daha yüksek bir yetenek sergiler.
Ayrıca, GPT-4 metin veya görsel girdileri kabul eden ve metin çıktısı veren çok modlu bir modeldir. Dış kaynaklarla arayüz kurmak için eklentiler kullanma olanağı da sunar. İnternette gezinme, Bing aramalarının kullanımıyla gösterildiği gibi buna bir örnektir.
Ücretli müşteriler için OpenAI API üzerinden erişilebilen üç ana GPT-4 varyantı vardır:
|
Model |
Özellikler |
Bağlam Penceresi |
API |
Yerel |
Token Fiyatı |
Eğitim Verisi |
|
GPT-4 |
13 Haziran 2023 tarihli gpt-4 anlık görüntüsü. Bu uç nokta sürekli güncellemeler alır. Sohbet için optimize edilmiştir. |
8.192 token |
Hayır |
$0,03 / 1K token (girdi) $0,06 / 1K token (çıktı) |
Aralık 2023 |
|
|
GPT-4 Turbo |
API adı gpt-4-turbo-preview. Kod üretimi gibi görevlerde başarılıdır ve “tembellik” vakalarını azaltmayı amaçlar. |
128k token |
Hayır |
$0,01 / 1K token (girdi) $0,03 / 1K token (çıktı) |
Aralık 2023 |
|
|
GPT-4 Vision |
API adı gpt-4-vision-preview. GPT-4 Turbo’nun tüm yeteneklerine ek olarak görselleri anlama yeteneğine sahiptir. |
128k token |
Hayır |
$0,01 / 1K token (girdi) $0,03 / 1k token (çıktı) |
Nisan 2023 |
Genel olarak, LLaMa modellerinin aksine GPT modellerinin kapalı kaynaklı olduğunu belirtmek ilginçtir. Bu, onları yerelde çalıştıramayacağımız veya kendi uç noktamızı dağıtamayacağımız anlamına gelir.
Yine de OpenAI’nin Fine-tuning API’si aracılığıyla özelleştirme olanağı vardır. Ayrıca, Ollama, LLAMA API veya Hugging Face gibi üçüncü taraf sağlayıcılar üzerinden erişilebilir değillerdir.
OpenAI Playground’a gelince, alttaki model bilgisi net biçimde gösterilmiyor; ancak DALL-E, gezinme ve analiz yeteneklerine sahip GPT-4 tabanlı görünüyor.
Hadi bir de mevcut GPT-3 modellerine bakalım!
|
Model |
Özellikler |
Bağlam Penceresi |
API |
Yerel |
Token Fiyatı |
Eğitim Verisi |
|
GPT-3.5 Turbo |
API adı gpt-3.5-turbo. Bu ailenin amiral gemisi modelidir. Diyalog için optimize edilmiştir ve istenen biçimlerde yanıtlama doğruluğu daha yüksektir. |
16.385 token |
Hayır |
$0,0005 / 1K token (girdi) $0,0015 / 1K token (çıktı) |
Eylül 2021 |
|
|
GPT-3.5 Turbo Instruct |
API adı gpt-3.5-turbo-instruct. Yanıtlarda doğruluk ve alaka düzeyine odaklanır; kullanıcı ihtiyaçlarıyla yakından hizalanır. |
4.096 token |
Hayır |
$0,0015 / 1K token (girdi) $0,0020 / 1K token (çıktı) |
Eylül 2021 |
Tabloda sunulan GPT-3.5 Turbo Instruct modeli, İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) yoluyla kullanıcının niyetini daha iyi takip edecek şekilde ince ayar yapılmıştır.
RLHF, insan geri bildirimlerinin pekiştirmeli öğrenme sürecine entegre edilerek yapay zekâ ajanlarının öğrenme çıktılarının yönlendirilip iyileştirilmesini sağlayan bir tekniktir. Bu yaklaşım, eğitim döngüsüne insan yargıları, düzeltmeleri veya tercihlerini doğrudan dahil ederek insan değerleri ve tercihleriyle daha iyi hizalanan modellerin geliştirilmesini mümkün kılar.
Son olarak, tablodan da görülebileceği üzere, iki GPT-3.5 modelinden herhangi birinin kullanımı GPT-4’e göre oldukça daha ucuzdur.
Bu bakımdan, genellikle iyi tanımlanmış bir örnek setinde her modelin performansını karşılaştırmayı ve böylece eldeki görev için GPT-3.5’in yeterli olup olmadığını görerek çıkarım maliyetinden tasarruf etmeyi öneririm.
Önceki bölümlerde tartıştığımız gibi, LLaMa modelleri ücretsiz indirilebilir, yerelde çalıştırılabilir veya üzerine özelleştirmeler inşa etmek için kullanılabilir.
LLaMa modelleri, Meta AI tarafından sunulan boyutlar ve varyantlar açısından geniş bir açık model ailesidir:
|
Model |
Özellikler |
Bağlam Penceresi |
API |
Yerel |
Varyant |
Eğitim Verisi |
|
LLaMa 2 |
Tamamlama görevleri için taban sohbet-dışı model. |
4096 token |
Evet |
Evet* |
7B 13B 70B |
Eylül 2022 |
|
LLaMa 2 Chat |
Basit tamamlamaları, kullanıcı niyetini izleyen bir sohbet modeline dönüştürmek için talimat ayarı yapılmış taban LLaMa 2. |
4096 token |
Evet |
Evet* |
7B 13B 70B |
Eylül 2022 |
|
LLaMa 2 Guard |
Zararlı ve toksik içeriği tespit etmek üzere eğitilmiş girdi-çıktı güvenlik modeli. |
4096 token |
Evet** |
Hayır |
7B |
Eylül 2022* |
*Hugging Face, taban ve sohbet modelleri gibi LLaMa’nın bazı varyantlarını da sağlar. **Şimdilik LLaMa 2 Guard, Amazon SageMaker’ın bulut ortamında erişilebilirdir.
Kodlama yetenekleri entegre olan GPT modellerinin aksine, LLaMa modellerinin uzun bağlam ayarı yoluyla 16k token’lık daha geniş bağlam pencerelerine sahip, koda adanmış modelleri vardır.
|
Model |
Özellikler |
Bağlam Penceresi |
API |
Yerel |
Varyant |
Eğitim Verisi |
|
Code LLaMa |
GitHub Copilot gibi kod tamamlama görevleri için taban sohbet-dışı model. LLaMa 2 modeline ek kod eğitimi ve uzun bağlam ince ayarı eklenmiştir. |
16k |
Hayır |
Evet |
7B 13B 34B |
Eylül 2022* |
|
Code LLaMa - Instruct |
Instruct modellerinden türetilmiştir. Kod tamamlama ve kod parçaları açıklamalarında başarılıdır. |
16k |
Evet |
Evet |
7B 13B 34B |
Eylül 2022* |
|
Code LLaMa - Python |
Python programlama dili için ince ayar yapılmıştır. |
16k |
Hayır |
Evet |
34B |
Eylül 2022* |
* LLaMa modellerinin resmi kesim tarihi Eylül 2022’dir. Bununla birlikte, ayar verileri özellikle daha yeni varyantlar için 2023’e kadar uzanan daha güncel tarihlidir.
Google’ın Büyük Dil Modelleri geliştirme konusunda uzun bir geçmişi vardır. Gemini modelinin tanıtımıyla Google, çok modlu LLM neslini başlattı.
Google’ın sundukları bağlamında, Gemini tıpkı ChatGPT gibi kapalı kaynaklı bir amiral gemisi model olarak öne çıkar. Ancak yakın zamanda, Gemini’den türetilmiş bir dizi açık kaynak modeli sunan Gemma’yı piyasaya sürdüler; bu da erişilebilir yapay zekâ geliştirmeyi kolaylaştırmayı hedefler.
Bu makalede, hem Gemini hem de Gemma’ya odaklanacağız:
|
Model |
Özellikler |
API |
Yerel |
Varyantlar |
|
Gemini |
Genel amaçlı görevler için kapalı kaynak model (metin üretimi, çeviri, soru-cevap, kod vb.) |
Evet* |
Hayır |
Ultra - Karmaşık görevleri çözer. Pro - Geniş görev yelpazesi. Ölçeklenebilir. Nano - Cihaz üzerinde verimli kullanım. |
|
Gemma |
Gemini’ye benzer görevler; ancak özel uygulamalara entegrasyon ve araştırmaya odaklıdır. Hafif bir modeldir. |
Evet**LLAMA API |
EvetOllama |
2B 7B |
*Gemini için ticari amaçlı bir API vardır (dağıtımlara açık değildir). Yine de Playground arayüzü üzerinden modeli deneyebiliriz.
**Yerel bir Google uç noktası yoktur; ancak modele Kaggle ve Google Colab üzerinden erişilebilir. Daha fazla bilgi resmi Google dokümantasyonunda mevcuttur.
Gemini varyantları açısından, Gemini Ultra karmaşık analiz görevlerinde başarılı çok modlu bir modeldir. Gemini Pro performans ve ölçeklenebilirlik arasında denge kurar ve kod ile metin üretimi gibi işlerde öne çıkar. Son olarak, Gemini Nano ağır kaynak gereksinimleri olmaksızın mobil ve uç cihazlarda çalışarak cihaz üzerinde verimliliğe odaklanır.
Google’ın modelleriyle ilgili olarak, yazım sırasında bağlam pencereleri ve eğitim verisinin kesim tarihi hakkında kamuya açık çok fazla bilgi bulunmamaktadır.
Mistral AI, Nisan 2023’te Meta Platforms ve Google DeepMind’ın eski çalışanları tarafından kurulan Fransız bir yapay zekâ şirketidir. Kapalı modellere karşı açık kaynak yazılımın önemini vurgulayarak açık kaynak LLM’ler geliştirmeye odaklanır. Şirket, gelişmiş dil işleme yeteneklerine sahip Mistral 7B ve Mixtral 8x7B gibi modeller sunar.
|
Model |
Özellikler |
Bağlam Penceresi |
API |
Yerel |
Token Fiyatı |
Eğitim Verisi |
|
Mistral |
7B parametreli genel amaçlı model. İngilizce ve kod üretimi görevleri için optimize edilmiştir. |
32k |
Evet* |
Evet |
$0,25 / 1M token (girdi ve çıktı) |
Eylül 2023 |
|
Mixtral |
En güçlü genel amaçlı model. İngilizce, Fransızca, İtalyanca, Almanca, İspanyolca dillerinde akıcıdır ve kodlama görevlerinde güçlüdür. 7B parametreli seyrek Uzman Karışımı (Mixture-of-Experts) mimarisine dayanır. |
32k |
Evet* |
Evet |
$0,7 / 1M token (girdi ve çıktı) |
Aralık 2023 |
*Mistral AI’nin “La Plataforme” adlı Playground arayüzünü kullanarak modellerle etkileşime geçebiliriz.
** Hugging Face, bazı modeller için API’si aracılığıyla gerçek zamanlı çıkarım yapabileceğiniz bir test ortamı da sunar. Ayrıca, mevcut modellere ücretli uç noktalar dağıtmanıza olanak tanıyan bir üçüncü taraf sağlayıcıdır.
Mixtral modeline ilişkin olarak, “Uzman Karışımı” mimarisi, modelin toplam yeteneklerini farklı uzman grupları arasında bölmesine olanak tanır. Her uzman belirli türdeki görev veya veriler için optimize edilmiştir.
Bir girdi işlenirken, Mixtral yalnızca ilgili uzmanları devreye alır; böylece her token için toplam parametrelerinin bir bölümünü kullanarak karmaşık görevleri verimli biçimde ele alır. Bu yöntem, Mixtral’ın performansını artırarak onu çeşitli diller ve görevlere uygun hale getirirken hesaplama kaynaklarını da optimize eder. Mixtral modelinin adı olan "Mixtral 8x7B", 8 farklı “uzman” grubunu kullandığına atıfta bulunur.
Son olarak, Mistral AI üç ticari model daha sunar: Mistral Small, Mistral Medium ve Mistral Large. İlginizi çekiyorsa, resmi dokümantasyonda modeller ve fiyatlandırma hakkında daha fazla bilgi bulabilirsiniz.
Şimdiye kadar sektördeki en ünlü şirketlerin çok sayıda model ve varyantını gördük. Ancak keşfedilecek daha çok şey var!
Teknoloji İnovasyon Enstitüsü’nün Falcon modellerini vurgulamak isterim; hem Ollama hem de LLAMA API üzerinden kullanılabilir. Ayrıca, özellikle akıl yürütmede başarılı olan Microsoft Research’ün Orca2 modeli de vardır; Ollama ve Hugging Face’te mevcuttur.
Diğer açık kaynak, erişilebilir modeller hakkında 2024’ün En İyi 8 Açık Kaynak LLM’i ve Kullanım Alanları yazısını okuyabilirsiniz.
Bu yazıda, hedef uygulamamız için en iyi Büyük Dil modelini seçerken dikkate alınması gereken çeşitli yönleri tartıştık. Bu rehberin amacı bir başvuru kağıdı işlevi görmek olsa da, en iyi modeli ilk anda seçecek sihirli bir kural yoktur.
Kişisel deneyimlerime dayanarak, LLM ile nasıl arayüz oluşturmak istediğimizi tanımlamanın iyi bir başlangıç noktası olduğunu düşünüyorum; çünkü bu, mevcut model ve varyant sayısını zaten azaltacaktır.
İkinci olarak, modelin gerçekleştireceği nesnel görevi düşünmek gerekir: genel sohbet botu, özetleme uzmanı, kodlama asistanı vb.
Her zaman bir modeli istediğimiz görev için ince ayar yapabilsek de, belirli kullanım durumları için halihazırda ince ayar yapılmış varyantların bulunduğunu gördük; bu da bize zaman, hesaplama kaynakları ve teknik uzmanlık kazandıracaktır. Uygulama için gereken bağlam penceresini dikkate almak da en iyi modeli seçmek açısından kritik önemdedir.
Son olarak, fiyatlandırma hangi modelin kullanılacağına dair her zaman iyi bir göstergedir. Ne yazık ki çoğu zaman, projenin kendisi başlangıç yatırımı ve zaman içindeki bakım maliyetiyle sınırlıdır. Fiyata ilişkin olarak, proje geliştirme sürecinde eğitimin ve ince ayarın ücretsiz hizmetler olmadığını ve aslında oldukça zaman alıcı olduğunu daima akılda tutmak önemlidir.
Yapay Zekâ Yolculuğunuza Bugün Devam Edin!
Program
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




