
Program
Yapay Zeka Uygulamaları Geliştirme
21 sa
Alıştırma and program your progress.
Google Ile Devam EdinPekiştirmeli ince ayar (RFT), ödül güdümlü bir eğitim döngüsüyle büyük dil modellerinin bilgisini rafine etmeye yönelik bir tekniktir.
Sınır modeller (frontier models) dikkat çekici çok amaçlı dil modelleridir. En iyileri çeviri, asistanlık, programlama ve daha birçok alanda üstün performans sergiler. Ancak, bu modelleri verimli bir şekilde ince ayarlamak üzerine önemli bir araştırma alanı mevcuttur. Amaç, belirli ton ve stillere uyarlamak ya da uzman tıbbi danışmanlık sağlama veya alana özgü sınıflandırma görevlerini yürütme gibi dar alanlarda uzmanlaştırmaktır.
Zorluk, bu ince ayarı verimli bir şekilde gerçekleştirmektir. Verimlilik; daha az hesaplama gücü tüketmek, daha az etiketli veri gerektirmek ve yine de yüksek kaliteli sonuçlar elde etmek anlamına gelir. RFT tam da bu noktada devreye girer ve bu soruna umut verici bir çözüm sunar.
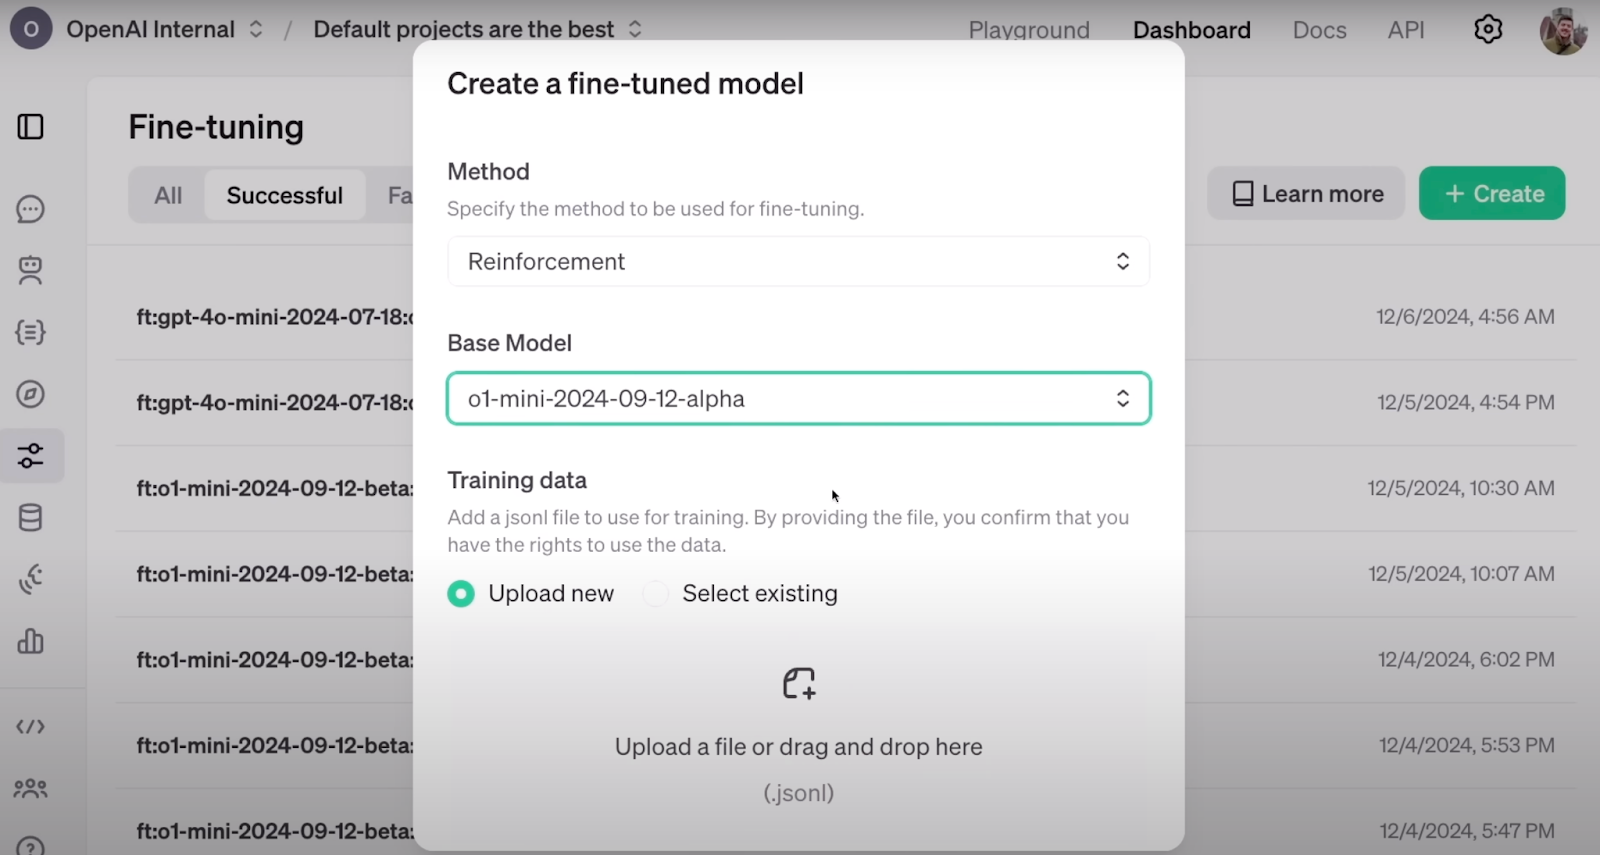
OpenAI’nin panosunda RFT yapılandırması böyle görünüyor. Kaynak: OpenAI
OpenAI’nin duyurusuna göre RFT, yalnızca birkaç düzine örnekle bir modeli etkin biçimde ince ayarlayabilir. Verinin kıt ve maliyetli olduğu sağlık sektörü gibi birçok alanda, az veri bile büyük fark yaratır.
RFT, pekiştirmeli öğrenme (RL) omurgası üzerine kuruludur; burada ajanlar eylemlerine bağlı olarak olumlu ya da olumsuz ödüller alır ve beklenen davranışla hizalanmaları sağlanır. Bu, ajanın çıktısına bir puan atanarak gerçekleştirilir. Bu puanlara dayalı yinelemeli eğitim sayesinde ajanlar, kuralları açıkça anlamaya ya da önceden tanımlanmış adımları ezberlemeye gerek kalmadan öğrenir.
LLM’leri uzmanlaşmış görevlerde iyileştirme çabalarıyla birleştiğinde, RFT; RL ve ince ayar tekniklerinden doğar. Fikir, şu adımlar üzerinden RFT uygulamaktır:
1. Modele öğrenmesini istediğiniz bilgiyi kazandıracak etiketli, yapılandırılmış bir veri kümesi sağlayın. Tipik bir makine öğrenimi görevinde olduğu gibi, bu veri kümesi eğitim ve doğrulama olarak bölünmelidir.
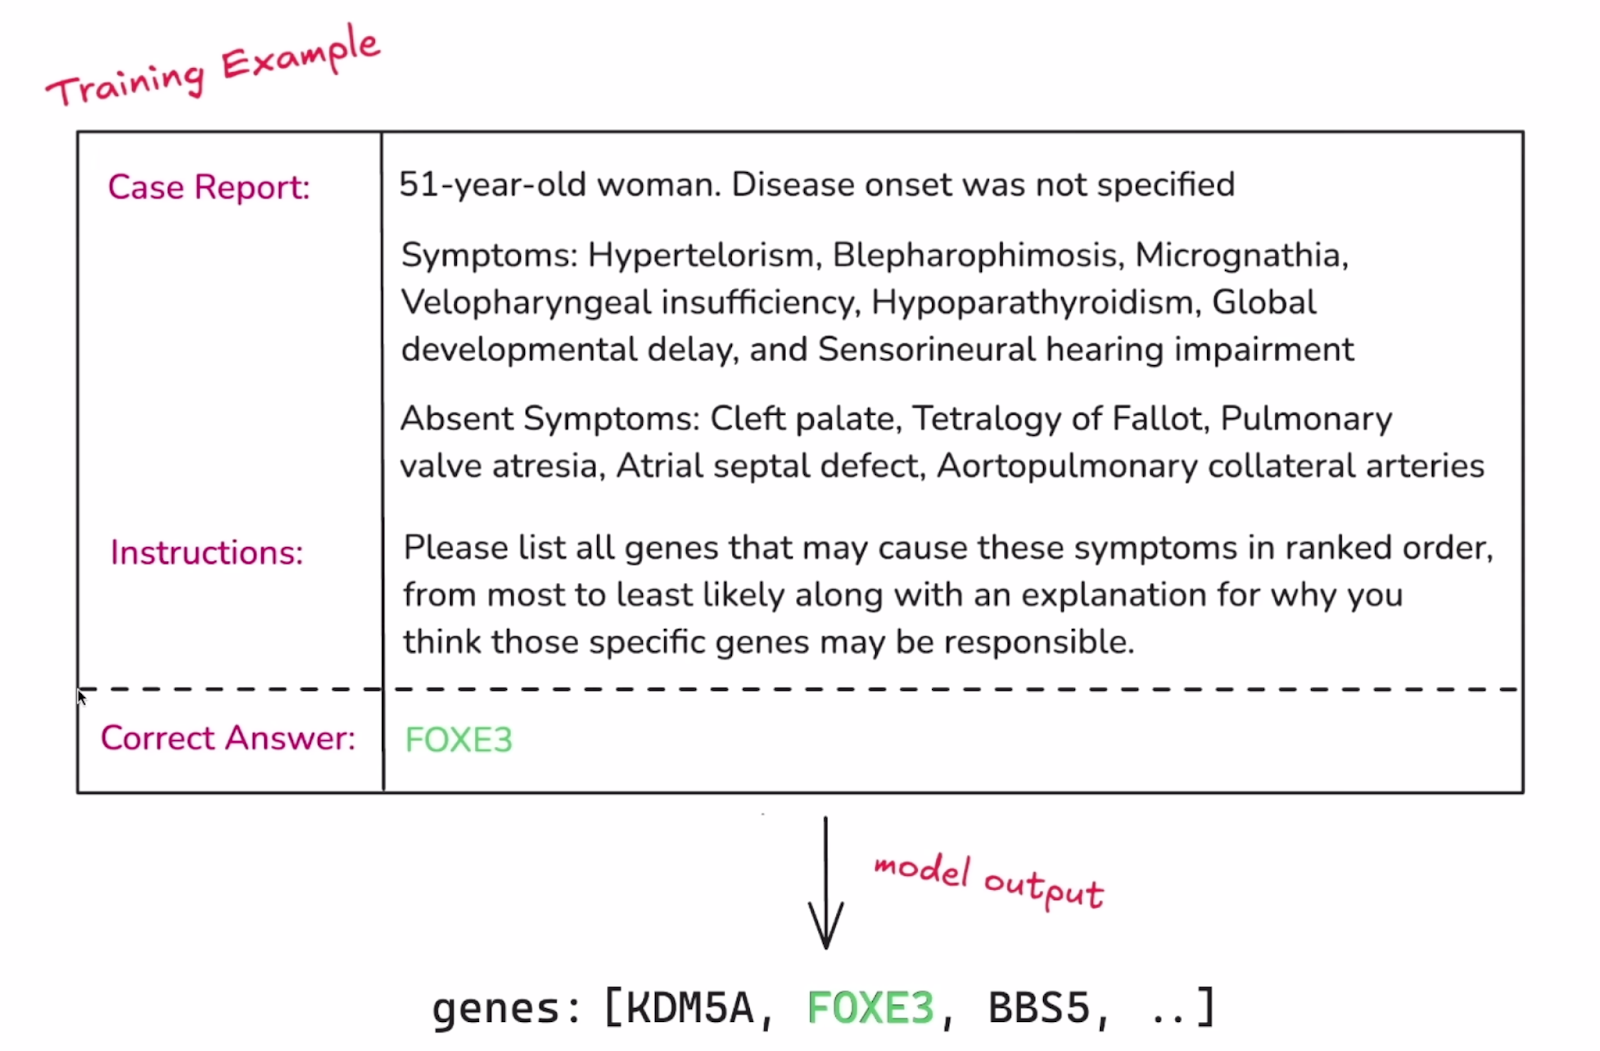
Veri kümesindeki tek bir örneğin örneği. Kaynak: OpenAI
2. RFT’nin bir sonraki kritik bileşeni, modelin çıktılarının nasıl değerlendirileceğini belirlemektir. Tipik bir ince ayar sürecinde model, etiketli hedef cevabı yeniden üretmeye çalışır. RFT’de ise modelin bu yanıtlara götüren bir akıl yürütme süreci geliştirmesi beklenir. Modelin çıktılarının notlandırılması, ince ayar sırasında ona rehberlik eden şeydir ve “Notlayıcılar (Graders)” kullanılarak yapılır. Not 0 ile 1 arasında bir değerde olabilir ve bir modelin çıktılar kümesine not vermenin birçok yolu vardır. OpenAI, daha fazla notlayıcı sunmayı ve muhtemelen kullanıcıların kendi özel notlayıcılarını uygulamalarına imkân tanıyacak bir yöntem getirmeyi planladığını duyurdu.
3. Model eğitim kümesindeki girdiye yanıt verdikten sonra, çıktısı notlayıcı tarafından puanlanır. Bu puan “ödül” sinyali işlevi görür. Ardından modelin ağırlıkları ve parametreleri, gelecekteki ödülleri en üst düzeye çıkaracak şekilde ayarlanır.
4. Model, tekrarlanan adımlarla ince ayar edilir. Her döngüde model stratejisini rafine eder ve doğrulama kümesi (eğitimden ayrı tutulan) periyodik olarak bu iyileştirmelerin yeni örneklere ne kadar iyi genellendiğini kontrol etmek için kullanılır. Modelin doğrulama verilerindeki puanları iyileştiğinde, modelin yalnızca çözümleri ezberlemek yerine gerçekten anlamlı stratejiler öğrendiğine dair iyi bir işarettir.
Bu açıklama RFT’nin özünü yakalıyor, ancak uygulama ve teknik ayrıntılar farklılık gösterebilir.
Aşağıda, ince ayarlı bir o1-mini modelinin standart o1-mini ve o1 modelle karşılaştırıldığı RFT değerlendirme sonuçlarına baktığımızda, yalnızca 1.100 örnekten oluşan bir veri kümesiyle RFT’nin, o1-mini’den daha büyük ve daha gelişmiş olmasına rağmen o1 modelinden daha yüksek doğruluk elde etmesi dikkat çekicidir.
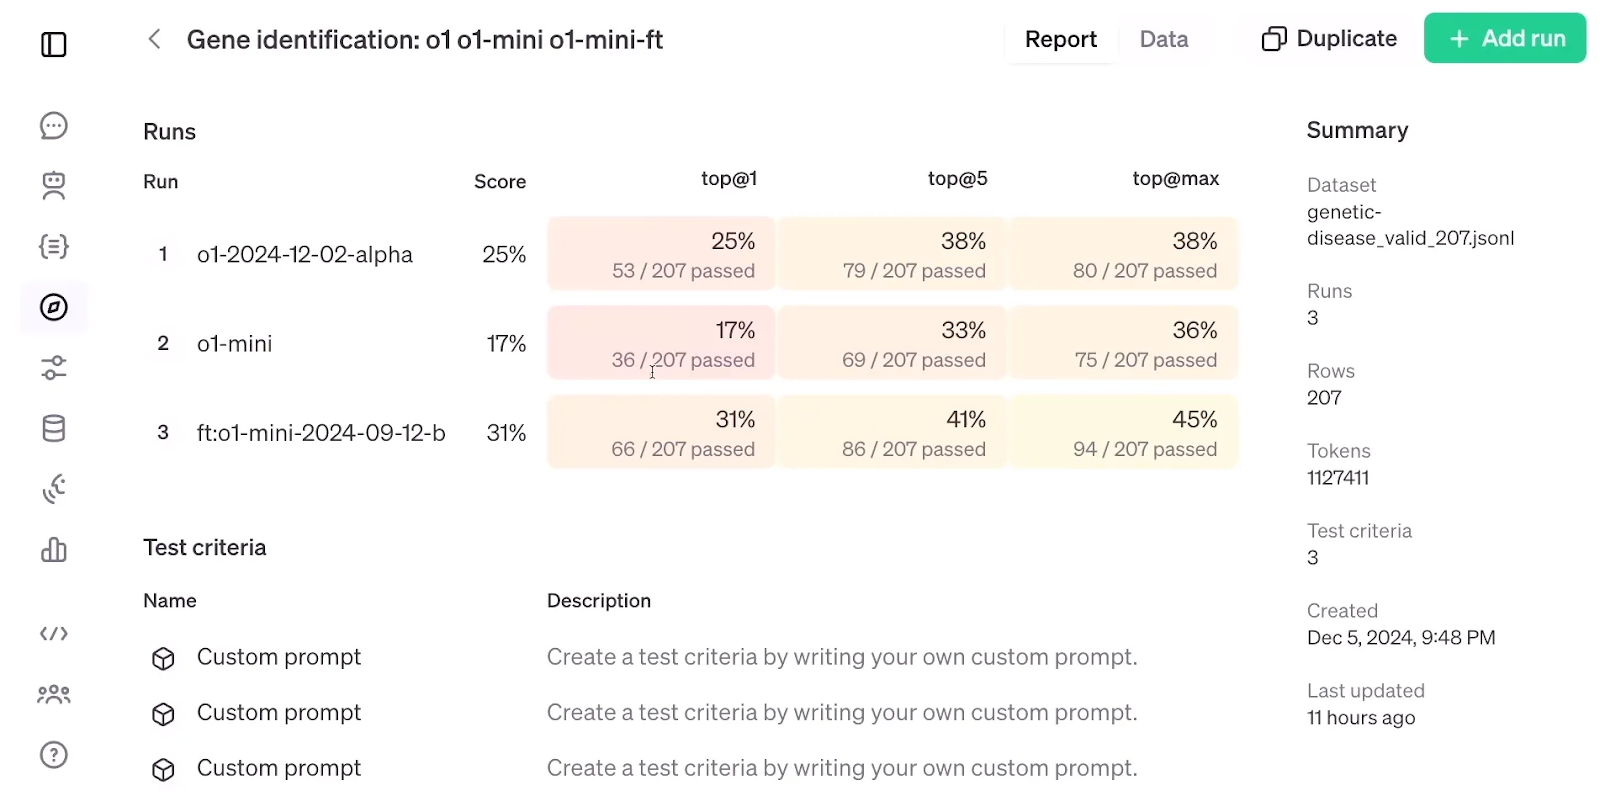
RFT’nin değerlendirmesi. Kaynak: OpenAI
Denetimli ince ayar (SFT), önceden eğitilmiş bir modeli denetimli öğrenme teknikleriyle ek veriler kullanarak ayarlamayı içerir. Uygulamada SFT, modelin çıktısını ya da formatını belirli bir veri kümesine hizalamak veya modelin belirli talimatları takip etmesini sağlamak istendiğinde en iyi sonucu verir.
Denetimli ince ayar ve pekiştirmeli ince ayar her ikisi de etiketli veriye dayanır; ancak bunu farklı kullanırlar. SFT’de etiketli veri doğrudan model güncellemelerini yönlendirir. Model bunu hedef çıktı olarak görür ve öngördüğü çıktı ile bilinen doğru cevap arasındaki farkı kapatacak şekilde parametrelerini ayarlar.
RFT’de ise modelin etikete maruziyeti dolaylıdır; etiket daha çok doğrudan hedef yerine ödül sinyalini oluşturmak için kullanılır. Bu nedenle modelin RFT’de daha az etiketli veriye ihtiyaç duyması beklenir — model, doğrudan çıktılarımızı üretmeyi hedeflemek yerine istediğimiz çıktıyı üretmeye götüren kalıpları bulmayı amaçlar ve bu da daha fazla genelleme eğilimi vadeder.
Farkları bu tabloyla özetleyelim:
|
Özellik |
Denetimli İnce Ayar (SFT) |
Pekiştirmeli İnce Ayar (RFT) |
|
Temel Fikir |
Modeli, istenen çıktıyla eşleşmesi için etiketli veride doğrudan eğitmek. |
Modele, istenen çıktıyı ürettiğinde ödül veren bir "Notlayıcı" kullanmak. |
|
Etiket Kullanımı |
Modelin taklit etmesi için doğrudan hedeftir. |
Modele ödül sinyali oluşturmak için dolaylı olarak kullanılır. |
|
Veri Verimliliği |
Daha fazla etiketli veri gerektirir. |
Genelleme sayesinde potansiyel olarak daha az etiketli veri gerektirir. |
|
İnsan Katılımı |
Yalnızca ilk veri etiketlemede. |
Yalnızca "Notlayıcı" işlevinin tasarımında. |
|
Genelleme |
Eğitim verisine aşırı uyum gösterebilir ve genellemeyi sınırlayabilir. |
Kalıplara ve ödüllere odaklanması nedeniyle daha yüksek genelleme potansiyeli. |
|
İnsan Tercihleriyle Hizalama |
Sınırlıdır; yalnızca etiketli veriyi taklide dayanır. |
"Notlayıcı" insan tercihlerini doğru yansıtıyorsa daha iyi hizalanabilir. |
|
Örnekler |
Bir dil modelini belirli metin formatlarını (şiir ya da kod gibi) üretmek üzere ince ayarlamak. |
Özgünlük ve tutarlılık temelinde bir "Notlayıcı" tarafından değerlendirilen yaratıcı içerik üretmek üzere bir dil modeli eğitmek. |
RFT hakkında okurken, bir diğer etkili ve klasik teknik olan insan geri bildiriminden pekiştirmeli öğrenme (RLHF) aklıma gelmeden edemedim. RLHF’de insan anotatörler istemlere nasıl yanıt verileceğine dair geri bildirim sağlar ve bu geri bildirimi sayısal ödül sinyallerine dönüştürmek için bir ödül modeli eğitilir. Bu sinyaller daha sonra, yakınsal politika optimizasyonu (PPO) aracılığıyla önceden eğitilmiş modelin parametrelerini ince ayarlamak için kullanılır.
RFT, insan geri bildirimini döngünün dışına alıp ödül sinyalini modelin yanıtına atamak için Notlayıcıya güvenirken, pekiştirmeli öğrenmenin LLM’in ince ayarına entegre edilmesi fikri RLHF ile tutarlılığını korur.
İlginç bir şekilde, ChatGPT eğitim sürecinde modeli daha iyi hizalamak için daha önce kullanılan yöntem RLHF idi. Duyuru videosuna göre RFT, OpenAI’nin GPT-4o veya o1 pro modu gibi sınır modellerini dahili olarak eğitmek için kullandığı yöntemdir.
Pekiştirmeli öğrenme daha önce de LLM’lerin ince ayarına entegre edilmişti, ancak OpenAI’nin pekiştirmeli ince ayarı bunu daha üst bir seviyeye taşıyor gibi görünüyor.
RFT’nin tam işleyişi, çıkış tarihi ve etkinliğine dair bilimsel bir değerlendirme henüz açıklanmış olmasa da, yakında erişilebilir olmasını ve vaat edildiği kadar güçlü olmasını umabiliriz.
Bu kurslarla AI öğrenin!
Program
Program
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




