
Lộ trình
Phát triển các ứng dụng trí tuệ nhân tạo
21 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleReinforcement fine-tuning (RFT) là một kỹ thuật tinh luyện tri thức của các mô hình ngôn ngữ lớn thông qua vòng lặp huấn luyện dựa trên phần thưởng.
Các mô hình frontier là những mô hình ngôn ngữ đa dụng ấn tượng. Những mô hình tốt nhất vượt trội ở nhiều tác vụ như dịch thuật, trợ lý, lập trình và hơn thế nữa. Tuy nhiên, một hướng nghiên cứu đáng kể đang tập trung vào việc tinh chỉnh các mô hình này một cách hiệu quả. Mục tiêu là điều chỉnh chúng để mang những sắc thái và phong cách cụ thể hoặc chuyên môn hóa trong các lĩnh vực hẹp, chẳng hạn như cung cấp tư vấn y khoa chuyên sâu hoặc thực hiện các tác vụ phân loại theo miền.
Thách thức nằm ở việc đạt được sự tinh chỉnh này một cách hiệu quả. Hiệu quả nghĩa là tiêu tốn ít tài nguyên tính toán và cần ít dữ liệu gán nhãn hơn nhưng vẫn đạt chất lượng cao. Đây chính là lúc RFT phát huy tác dụng, mang đến một lời giải đầy hứa hẹn cho vấn đề này.
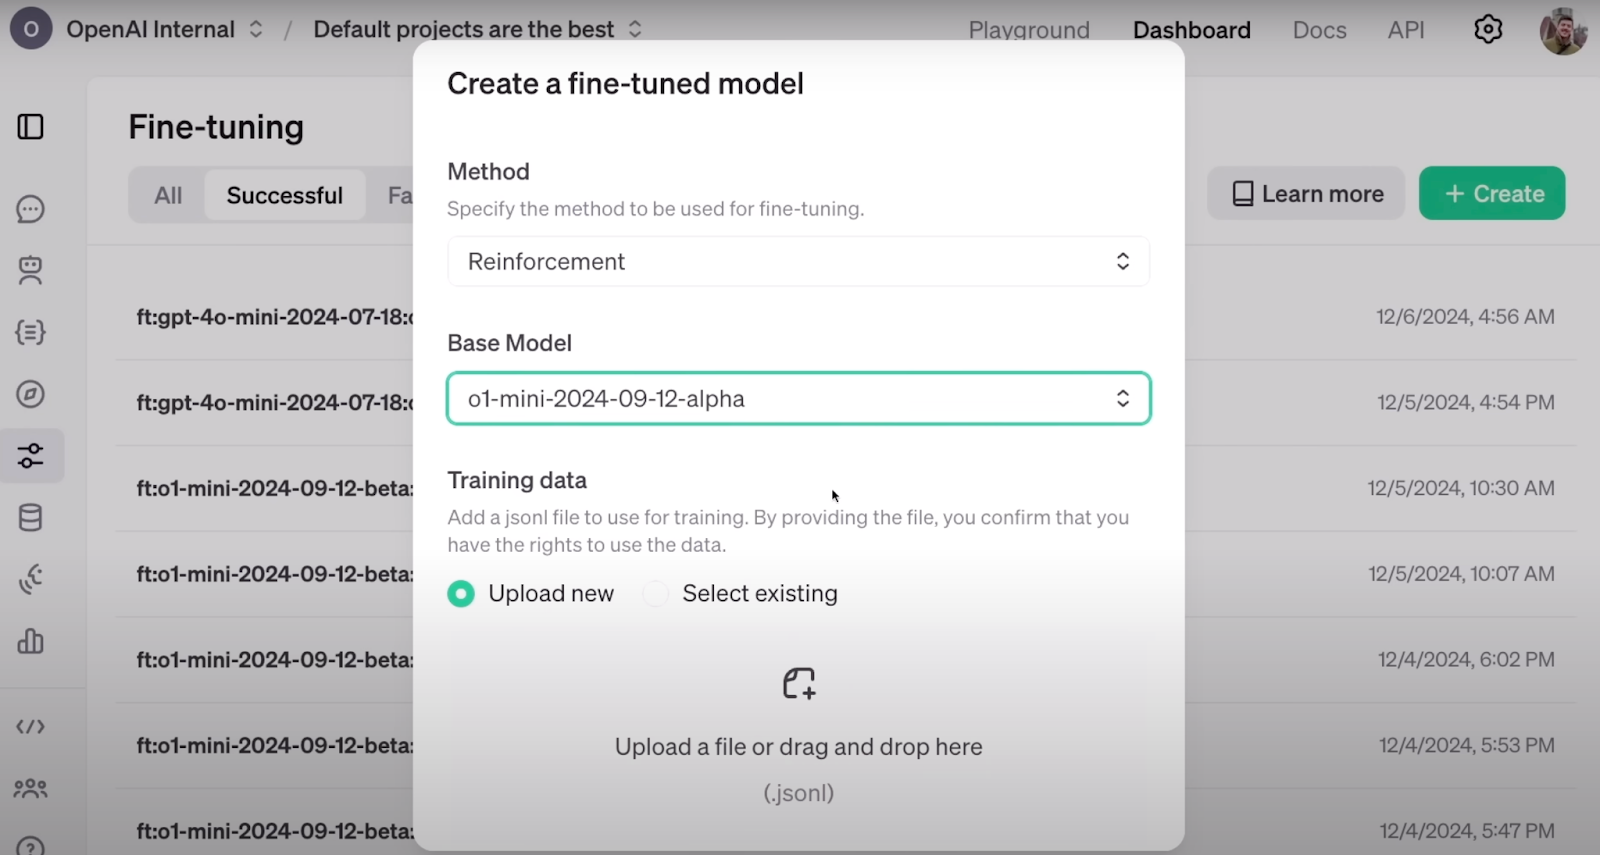
Cách cấu hình RFT trên bảng điều khiển của OpenAI. Nguồn: OpenAI
Theo thông báo của OpenAI, RFT có thể tinh chỉnh hiệu quả một mô hình chỉ với vài chục ví dụ. Ở nhiều lĩnh vực như y tế, nơi dữ liệu khan hiếm và đắt đỏ, ít dữ liệu cũng mang lại hiệu quả lớn.
RFT được xây dựng trên nền tảng học tăng cường (RL), trong đó các tác tử được thưởng hoặc phạt dựa trên hành động của mình, cho phép chúng điều chỉnh theo hành vi mong đợi. Điều này đạt được bằng cách gán một điểm số cho đầu ra của tác tử. Thông qua huấn luyện lặp đi lặp lại dựa trên các điểm số này, tác tử học được mà không cần hiểu tường minh các quy tắc hay ghi nhớ sẵn các bước giải quyết vấn đề.
Khi kết hợp với nỗ lực cải thiện LLM ở các tác vụ chuyên biệt, RFT xuất phát từ các kỹ thuật RL và tinh chỉnh. Ý tưởng là thực hiện RFT qua một chuỗi bước:
1. Cung cấp một bộ dữ liệu có cấu trúc đã gán nhãn để trang bị cho mô hình những tri thức bạn muốn nó học. Tương tự một bài toán máy học điển hình, bộ dữ liệu này nên được chia thành tập huấn luyện và tập kiểm định.
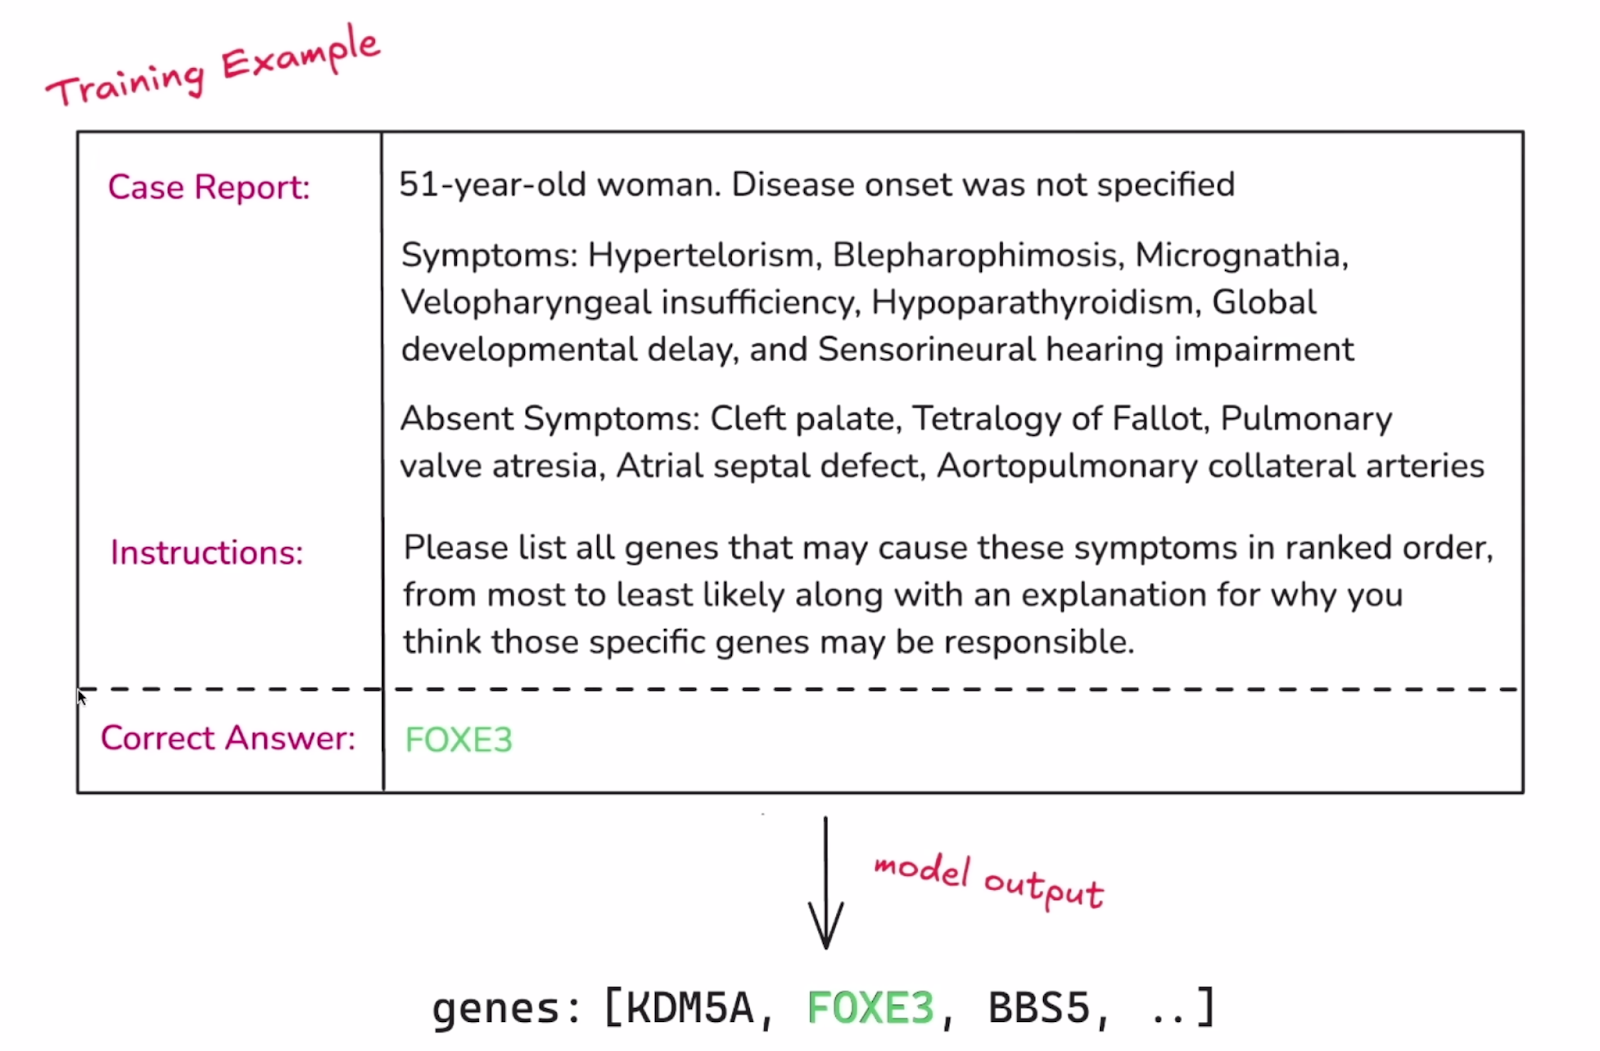
Ví dụ về một bản ghi đơn lẻ trong bộ dữ liệu. Nguồn: OpenAI
2. Thành phần then chốt tiếp theo của RFT là thiết lập cách đánh giá đầu ra của mô hình. Trong quy trình tinh chỉnh điển hình, mô hình chỉ cố gắng tái tạo đáp án mục tiêu đã gán nhãn. Tuy nhiên, với RFT, mô hình cần phát triển một quá trình suy luận dẫn đến các đáp án đó. Việc chấm điểm đầu ra của mô hình sẽ dẫn hướng nó trong quá trình tinh chỉnh và được thực hiện bằng “Graders.” Điểm số có thể từ 0 đến 1 hoặc ở giữa, và có nhiều cách để gán điểm cho một tập đầu ra của mô hình. OpenAI thông báo kế hoạch tung ra thêm các grader và có thể giới thiệu cách để người dùng tự triển khai grader tùy chỉnh.
3. Khi mô hình phản hồi với đầu vào từ tập huấn luyện, đầu ra của nó được grader chấm điểm. Điểm này đóng vai trò là tín hiệu “phần thưởng”. Trọng số và tham số của mô hình sau đó được điều chỉnh nhẹ để tối đa hóa phần thưởng trong tương lai.
4. Mô hình được tinh chỉnh qua các bước lặp lại. Mỗi chu kỳ, mô hình mài giũa chiến lược của mình và tập kiểm định (được giữ tách biệt khỏi huấn luyện) được sử dụng định kỳ để kiểm tra mức độ tổng quát hóa sang các ví dụ mới. Khi điểm số của mô hình cải thiện trên dữ liệu kiểm định, đó là dấu hiệu tốt cho thấy mô hình thực sự học được các chiến lược ý nghĩa chứ không chỉ ghi nhớ lời giải.
Lời giải thích này nêu bật cốt lõi của RFT, nhưng cách triển khai và chi tiết kỹ thuật có thể khác nhau.
Nhìn vào kết quả đánh giá RFT dưới đây, so sánh một mô hình o1-mini đã tinh chỉnh với o1-mini tiêu chuẩn và mô hình o1, điều đáng chú ý là RFT, chỉ dùng bộ dữ liệu 1.100 ví dụ, đã đạt độ chính xác cao hơn so với mô hình o1, dù mô hình sau lớn hơn và tiên tiến hơn o1-mini.
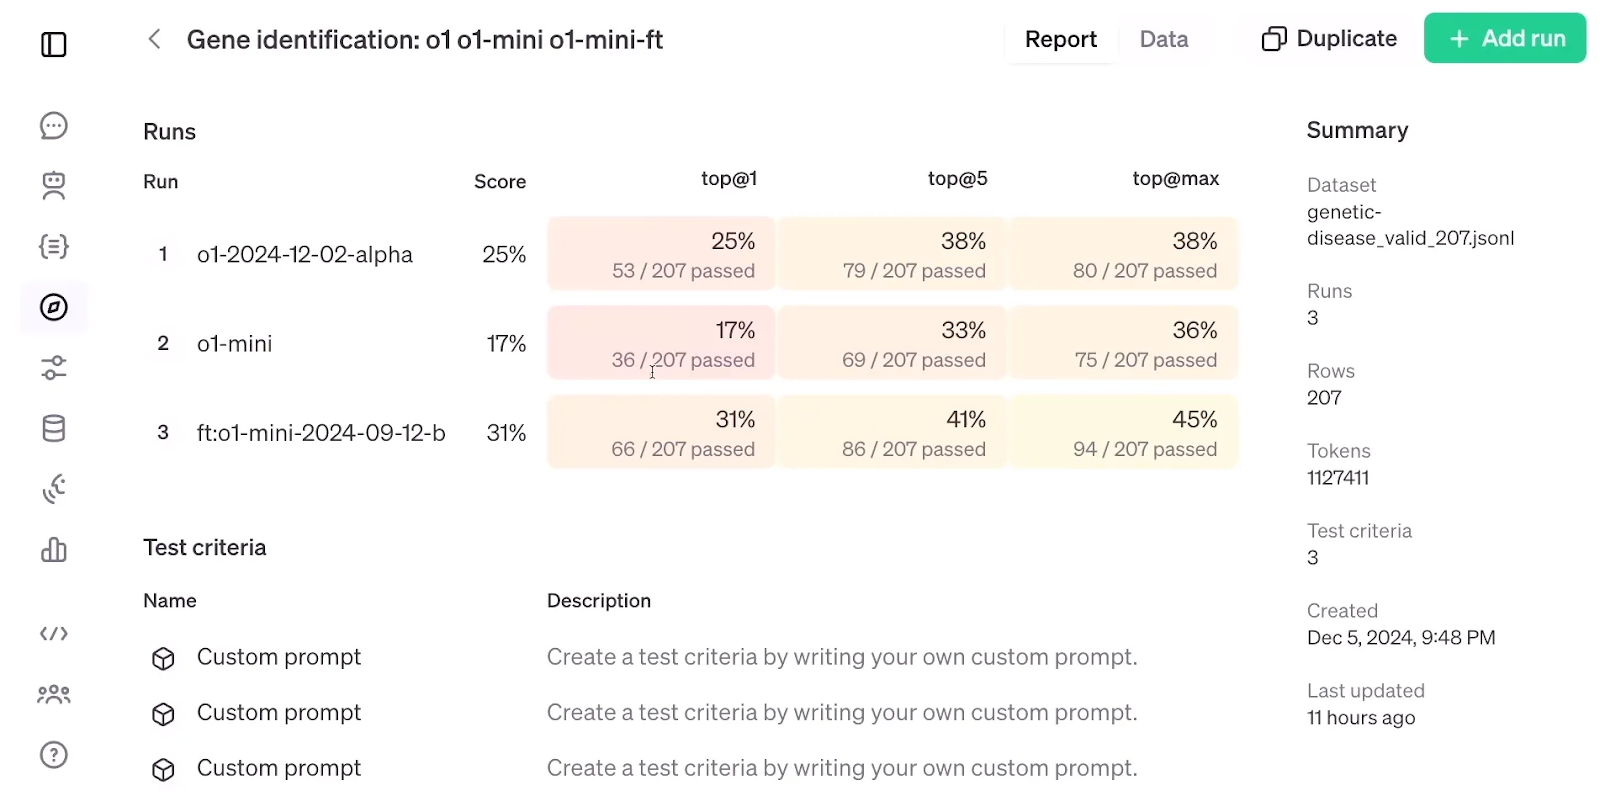
Đánh giá RFT. Nguồn: OpenAI
Tinh chỉnh có giám sát (SFT) là việc lấy một mô hình đã được tiền huấn luyện và điều chỉnh nó với dữ liệu bổ sung bằng các kỹ thuật học có giám sát. Trên thực tế, SFT hoạt động tốt nhất khi mục tiêu là điều chỉnh đầu ra hoặc định dạng của mô hình theo một bộ dữ liệu cụ thể hoặc đảm bảo mô hình tuân theo một số hướng dẫn nhất định.
Mặc dù tinh chỉnh có giám sát và reinforcement fine-tuning đều dựa vào dữ liệu gán nhãn, chúng sử dụng theo cách khác nhau. Trong SFT, dữ liệu gán nhãn trực tiếp thúc đẩy cập nhật của mô hình. Mô hình coi đó là đầu ra mục tiêu và điều chỉnh tham số để thu hẹp khoảng cách giữa dự đoán và đáp án đúng đã biết.
Trong RFT, việc mô hình tiếp xúc với nhãn là gián tiếp, vì nhãn chủ yếu được dùng để tạo tín hiệu phần thưởng thay vì mục tiêu trực tiếp. Đây là lý do mô hình được kỳ vọng cần ít dữ liệu gán nhãn hơn trong RFT—mô hình hướng tới việc tìm ra các mẫu để tạo ra đầu ra mong muốn thay vì nhắm trực tiếp vào việc sao chép đầu ra của chúng ta, và điều này hứa hẹn xu hướng khái quát hóa tốt hơn.
Hãy tóm lược sự khác biệt bằng bảng sau:
|
Tính năng |
Tinh chỉnh có giám sát (SFT) |
Reinforcement Fine-Tuning (RFT) |
|
Ý tưởng cốt lõi |
Huấn luyện trực tiếp mô hình trên dữ liệu gán nhãn để khớp đầu ra mong muốn. |
Dùng một "Grader" để cung cấp phần thưởng khi mô hình tạo ra đầu ra mong muốn. |
|
Việc sử dụng nhãn |
Mục tiêu trực tiếp để mô hình bắt chước. |
Dùng gián tiếp để tạo tín hiệu phần thưởng cho mô hình. |
|
Hiệu quả dữ liệu |
Cần nhiều dữ liệu gán nhãn hơn. |
Tiềm năng cần ít dữ liệu gán nhãn hơn nhờ khả năng khái quát hóa. |
|
Sự tham gia của con người |
Chỉ ở khâu gán nhãn dữ liệu ban đầu. |
Chỉ ở khâu thiết kế hàm "Grader". |
|
Khái quát hóa |
Dễ quá khớp với dữ liệu huấn luyện, hạn chế khả năng khái quát hóa. |
Tiềm năng khái quát hóa cao hơn do tập trung vào mẫu và phần thưởng. |
|
Phù hợp với sở thích của con người |
Hạn chế, vì chỉ dựa vào việc mô phỏng dữ liệu gán nhãn. |
Có thể phù hợp hơn nếu "Grader" phản ánh chính xác sở thích của con người. |
|
Ví dụ |
Tinh chỉnh một mô hình ngôn ngữ để tạo các định dạng văn bản cụ thể (như thơ hoặc mã). |
Huấn luyện mô hình ngôn ngữ tạo nội dung sáng tạo được "Grader" chấm theo độ độc đáo và tính mạch lạc. |
Khi tìm hiểu về RFT, tôi nhớ ngay đến một kỹ thuật cổ điển và hiệu quả khác là reinforcement learning from human feedback (RLHF). Trong RLHF, người gán nhãn cung cấp phản hồi về cách trả lời các lời nhắc, và một mô hình phần thưởng được huấn luyện để chuyển phản hồi này thành tín hiệu phần thưởng dạng số. Các tín hiệu đó sau đó được dùng để tinh chỉnh tham số của mô hình tiền huấn luyện thông qua proximal policy optimization (PPO).
Trong khi RFT loại bỏ phản hồi của con người khỏi vòng lặp và dựa vào Grader để gán tín hiệu phần thưởng cho phản hồi của mô hình, ý tưởng tích hợp học tăng cường vào quá trình tinh chỉnh LLM vẫn nhất quán với RLHF.
Điều thú vị là RLHF từng là phương pháp họ dùng trước đây để căn chỉnh mô hình tốt hơn trong quá trình huấn luyện ChatGPT. Theo video thông báo, RFT là phương pháp OpenAI sử dụng nội bộ để huấn luyện các mô hình frontier như GPT-4o hoặc chế độ o1 pro.
Học tăng cường đã từng được tích hợp vào quá trình tinh chỉnh LLM, nhưng reinforcement fine-tuning của OpenAI có vẻ đưa điều đó lên một tầm cao hơn.
Trong khi cơ chế chính xác của RFT, ngày phát hành và đánh giá khoa học về hiệu quả của nó vẫn chưa được công bố, chúng ta có thể hy vọng RFT sẽ sớm khả dụng và mạnh mẽ như những gì đã hứa hẹn.
Học AI với những khóa học này!
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
