
रिइनफोर्समेंट फाइन-ट्यूनिंग क्या है?
रिइनफोर्समेंट फाइन-ट्यूनिंग (RFT) एक तकनीक है जो रिवार्ड-चालित ट्रेनिंग लूप के माध्यम से बड़े भाषा मॉडलों के ज्ञान को परिष्कृत करती है।
फ्रंटियर मॉडल उल्लेखनीय जनरल-पर्पज़ भाषा मॉडल हैं। बेहतरीन मॉडल अनुवाद, सहायता, प्रोग्रामिंग आदि सहित कई कार्यों में उत्कृष्ट होते हैं। हालाँकि, चल रहे शोध का एक महत्वपूर्ण क्षेत्र इन मॉडलों को कुशलतापूर्वक फाइन-ट्यून करने पर केंद्रित है। लक्ष्य है इन्हें विशिष्ट टोन और शैली अपनाने के लिए अनुकूलित करना या संकीर्ण क्षेत्रों में विशेषज्ञ बनाना, जैसे विशेषज्ञ चिकित्सा सलाह देना या डोमेन-विशिष्ट वर्गीकरण कार्य करना।
चुनौती यह है कि इस फाइन-ट्यूनिंग को कुशलता से कैसे प्राप्त किया जाए। दक्षता का अर्थ है कम कम्प्यूटेशनल शक्ति और कम लेबल्ड डेटासेट का उपयोग करते हुए भी उच्च-गुणवत्ता के परिणाम पाना। यहीं पर RFT मददगार साबित होता है और इस समस्या का एक आशाजनक समाधान पेश करता है।
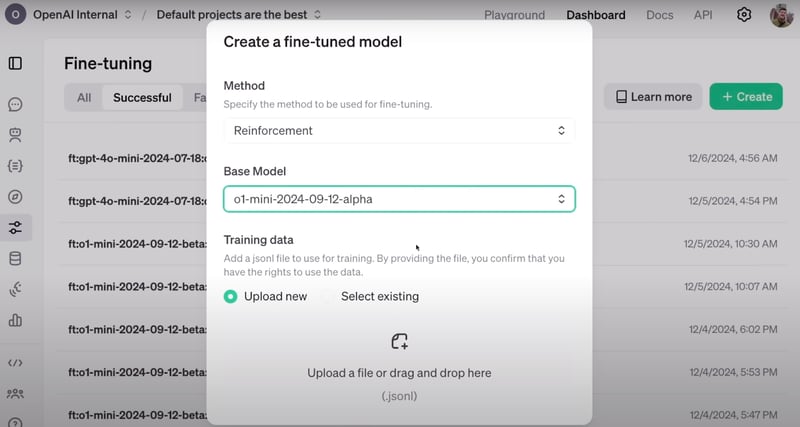
OpenAI के डैशबोर्ड पर RFT को कॉन्फ़िगर करना कुछ ऐसा दिखता है। स्रोत: OpenAI
OpenAI के घोषणा के अनुसार, RFT केवल चंद दर्जन उदाहरणों से किसी मॉडल को प्रभावी रूप से फाइन-ट्यून कर सकता है। कई क्षेत्रों में, जैसे चिकित्सा क्षेत्र, जहाँ डेटा दुर्लभ और महंगा होता है, कम डेटा भी काफी दूर तक जाता है।
RFT, रिइनफोर्समेंट लर्निंग (RL) की रीढ़ पर बना है, जहाँ एजेंट्स को अपने कार्यों के आधार पर सकारात्मक या नकारात्मक इनाम मिलता है, जिससे उनका व्यवहार हमारी अपेक्षाओं के अनुरूप आता है। यह एजेंट के आउटपुट को एक स्कोर देकर हासिल किया जाता है। इन स्कोरों पर आधारित आवर्तक प्रशिक्षण के जरिए, एजेंट्स बिना नियमों को स्पष्ट रूप से समझे या समाधान के पूर्वनिर्धारित चरण याद किए बिना सीखते हैं।
जब LLMs को विशिष्ट कार्यों पर सुधारने के प्रयासों के साथ जोड़ा जाता है, तो RFT, RL और फाइन-ट्यूनिंग तकनीकों से उभरता है। विचार है कि RFT को चरणों के एक सेट के माध्यम से किया जाए:
1. एक लेबल युक्त संरचित डेटासेट प्रदान करें जो मॉडल को वह ज्ञान देता है जो आप इसे सिखाना चाहते हैं। एक सामान्य मशीन लर्निंग कार्य की तरह, इस डेटासेट को प्रशिक्षण और वैलिडेशन सेट में विभाजित किया जाना चाहिए।
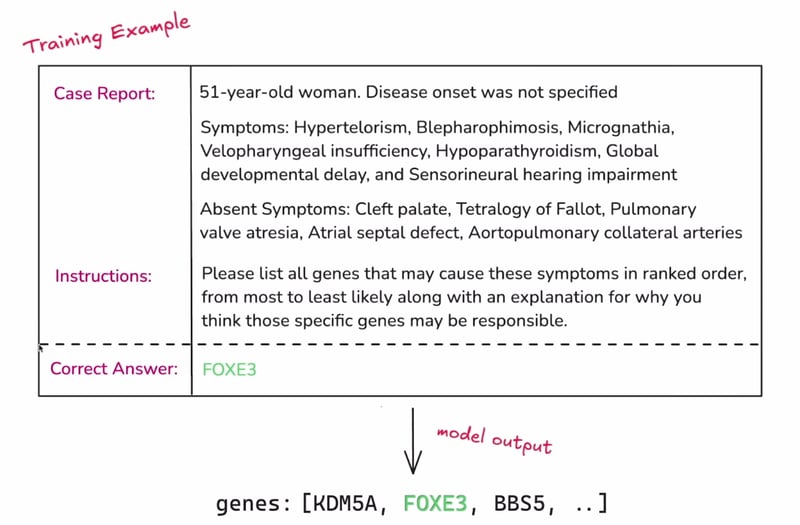
डेटासेट के एक एकल उदाहरण का नमूना। स्रोत: OpenAI
2. RFT का अगला महत्वपूर्ण घटक मॉडल के आउटपुट का मूल्यांकन करने का तरीका स्थापित करना है। एक सामान्य फाइन-ट्यूनिंग प्रक्रिया में, मॉडल केवल लेबल किए गए लक्ष्य उत्तर को पुन: उत्पन्न करने की कोशिश करता है। लेकिन RFT में, मॉडल को ऐसे तर्क-वितर्क की प्रक्रिया विकसित करनी चाहिए जो उन उत्तरों तक पहुँचाए। मॉडल के आउटपुट की ग्रेडिंग ही फाइन-ट्यूनिंग के दौरान इसे दिशा देती है, और यह “ग्रेडर्स” का उपयोग करके की जाती है। ग्रेड 0 से 1 के बीच हो सकता है, और मॉडल के आउटपुट के सेट को ग्रेड देने के कई तरीके हैं। OpenAI ने अधिक ग्रेडर्स पेश करने और संभवतः उपयोगकर्ताओं को अपने कस्टम ग्रेडर्स लागू करने का तरीका देने की योजना की घोषणा की है।
3. जब मॉडल प्रशिक्षण सेट के इनपुट पर प्रतिक्रिया देता है, तो उसका आउटपुट ग्रेडर द्वारा स्कोर किया जाता है। यह स्कोर “रिवार्ड” सिग्नल के रूप में कार्य करता है। फिर मॉडल के वेट्स और पैरामीटर्स को भविष्य के रिवार्ड को अधिकतम करने के लिए समायोजित किया जाता है।
4. मॉडल को दोहराए गए चरणों के माध्यम से फाइन-ट्यून किया जाता है। हर चक्र के साथ, मॉडल अपनी रणनीति को परिष्कृत करता है और वैलिडेशन सेट (जो प्रशिक्षण से अलग रखा जाता है) का समय-समय पर उपयोग किया जाता है यह जाँचने के लिए कि ये सुधार नए उदाहरणों पर कितने अच्छे से लागू होते हैं। जब मॉडल के स्कोर वैलिडेशन डेटा पर बेहतर होते हैं, तो यह इस बात का अच्छा संकेत है कि मॉडल वास्तव में सार्थक रणनीतियाँ सीख रहा है, न कि केवल समाधानों को याद कर रहा है।
यह व्याख्या RFT का सार प्रस्तुत करती है, लेकिन वास्तविक कार्यान्वयन और तकनीकी विवरण भिन्न हो सकते हैं।
नीचे दिए गए RFT के मूल्यांकन परिणामों को देखें, जो फाइन-ट्यून किए गए o1-mini मॉडल की तुलना मानक o1-mini और o1 मॉडल से करते हैं। यह उल्लेखनीय है कि मात्र 1,100 उदाहरणों वाले डेटासेट का उपयोग करते हुए RFT ने o1 मॉडल से अधिक सटीकता हासिल की, जबकि बाद वाला आकार में बड़ा और o1-mini से अधिक उन्नत है।
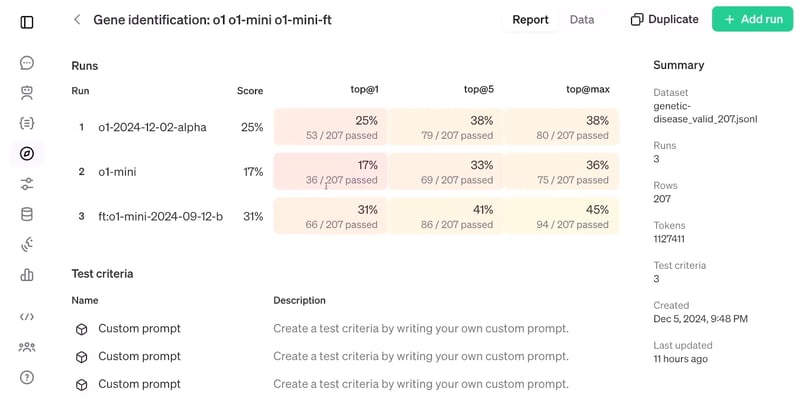
RFT का मूल्यांकन। स्रोत: OpenAI
सुपरवाइज़्ड फाइन-ट्यूनिंग बनाम रिइनफोर्समेंट फाइन-ट्यूनिंग
सुपरवाइज़्ड फाइन-ट्यूनिंग (SFT) में एक प्री-ट्रेंड मॉडल लेना और सुपरवाइज़्ड लर्निंग तकनीकों से अतिरिक्त डेटा के साथ उसे समायोजित करना शामिल है। व्यवहार में, SFT तब सबसे अच्छा काम करता है जब लक्ष्य किसी विशिष्ट डेटासेट के अनुरूप मॉडल के आउटपुट या फ़ॉर्मेट को संरेखित करना हो या यह सुनिश्चित करना हो कि मॉडल कुछ निर्देशों का पालन करे।
यद्यपि सुपरवाइज़्ड फाइन-ट्यूनिंग और रिइनफोर्समेंट फाइन-ट्यूनिंग दोनों लेबल्ड डेटा पर निर्भर करते हैं, वे इसका उपयोग अलग-अलग तरीके से करते हैं। SFT में, लेबल्ड डेटा सीधे मॉडल के अपडेट को संचालित करता है। मॉडल इसे लक्ष्य आउटपुट के रूप में देखता है और अपने पूर्वानुमानित आउटपुट और ज्ञात सही उत्तर के बीच के अंतर को कम करने के लिए अपने पैरामीटर्स समायोजित करता है।
RFT में, मॉडल का लेबल से संपर्क अप्रत्यक्ष होता है, क्योंकि इसका उपयोग मुख्यतः रिवार्ड सिग्नल बनाने के लिए किया जाता है, न कि प्रत्यक्ष लक्ष्य के रूप में। यही वजह है कि RFT में मॉडल से कम लेबल्ड डेटा की अपेक्षा की जाती है—मॉडल सीधे हमारे आउटपुट को उत्पन्न करने का लक्ष्य रखने की बजाय वांछित आउटपुट उत्पन्न करने के लिए पैटर्न खोजने का प्रयास करता है, और इससे जनरलाइज़ करने की प्रवृत्ति अधिक रहने का वादा होता है।
आइए इन अंतरों को इस तालिका के साथ संक्षेप में देखें:
|
विशेषता |
सुपरवाइज़्ड फाइन-ट्यूनिंग (SFT) |
रिइनफोर्समेंट फाइन-ट्यूनिंग (RFT) |
|
मूल विचार |
लेबल्ड डेटा पर सीधे मॉडल को प्रशिक्षित करना ताकि वांछित आउटपुट से मेल खाए। |
मॉडल को वांछित आउटपुट उत्पन्न करने पर "ग्रेडर" से रिवार्ड देना। |
|
लेबल का उपयोग |
मॉडल द्वारा अनुकरण करने के लिए प्रत्यक्ष लक्ष्य। |
मॉडल के लिए रिवार्ड सिग्नल बनाने में अप्रत्यक्ष रूप से उपयोग। |
|
डेटा दक्षता |
अधिक लेबल्ड डेटा की आवश्यकता। |
जनरलाइज़ेशन के कारण संभावित रूप से कम लेबल्ड डेटा की आवश्यकता। |
|
मानवीय सहभागिता |
केवल प्रारंभिक डेटा लेबलिंग में। |
केवल "ग्रेडर" फ़ंक्शन को डिज़ाइन करने में। |
|
जनरलाइज़ेशन |
ट्रेनिंग डेटा पर ओवरफिट हो सकता है, जिससे जनरलाइज़ेशन सीमित होता है। |
पैटर्न और रिवार्ड पर ध्यान केंद्रित करने से जनरलाइज़ेशन की अधिक संभावनाएँ। |
|
मानवीय प्राथमिकताओं के साथ संरेखण |
सीमित, क्योंकि यह केवल लेबल्ड डेटा की नकल पर निर्भर है। |
यदि "ग्रेडर" मानव प्राथमिकताओं को सटीक रूप से दर्शाता है, तो बेहतर संरेखण संभव। |
|
उदाहरण |
किसी भाषा मॉडल को विशिष्ट प्रकार के टेक्स्ट फ़ॉर्मेट (जैसे कविताएँ या कोड) जनरेट करने के लिए फाइन-ट्यून करना। |
ऐसा भाषा मॉडल प्रशिक्षित करना जो "ग्रेडर" द्वारा मौलिकता और सुसंगति के आधार पर आँके गए रचनात्मक कंटेंट का सृजन करे। |
जब मैं RFT के बारे में पढ़ रहा था, तो मुझे एक और प्रभावी और क्लासिक तकनीक की याद आई जिसे रीइनफोर्समेंट लर्निंग फ्रॉम ह्यूमन फ़ीडबैक (RLHF) कहते हैं। RLHF में, मानव एनोटेटर्स यह फ़ीडबैक देते हैं कि प्रॉम्प्ट्स का उत्तर कैसे दिया जाए, और एक रिवार्ड मॉडल प्रशिक्षित किया जाता है जो इस फ़ीडबैक को संख्यात्मक रिवार्ड सिग्नल में बदलता है। फिर इन सिग्नल्स का उपयोग प्रॉक्सिमल पॉलिसी ऑप्टिमाइज़ेशन (PPO) के जरिए प्री-ट्रेंड मॉडल के पैरामीटर्स को फाइन-ट्यून करने के लिए किया जाता है।
जहाँ RFT मानव फ़ीडबैक को लूप से बाहर कर देता है और मॉडल की प्रतिक्रिया को रिवार्ड सिग्नल देने के लिए ग्रेडर पर निर्भर करता है, वहीं LLM की फाइन-ट्यूनिंग में रिइनफोर्समेंट लर्निंग को एकीकृत करने का विचार RLHF के अनुरूप ही है।
दिलचस्प बात यह है कि ChatGPT के प्रशिक्षण प्रक्रिया में मॉडल को बेहतर संरेखित करने के लिए पहले RLHF का उपयोग किया गया था। घोषणा वीडियो के अनुसार, RFT वह विधि है जिसका उपयोग OpenAI आंतरिक रूप से अपने फ्रंटियर मॉडलों, जैसे GPT-4o या o1 pro mode, को प्रशिक्षित करने के लिए करता है।
निष्कर्ष
रिइनफोर्समेंट लर्निंग पहले भी LLMs की फाइन-ट्यूनिंग में एकीकृत की गई है, लेकिन OpenAI की रिइनफोर्समेंट फाइन-ट्यूनिंग इसे एक ऊँचे स्तर पर ले जाती दिखती है।
हालाँकि RFT की सटीक कार्यप्रणाली, इसकी रिलीज़ तिथि, और इसकी प्रभावशीलता का वैज्ञानिक मूल्यांकन अब तक सार्वजनिक नहीं किया गया है, हम उँगलियाँ पार कर सकते हैं और आशा कर सकते हैं कि RFT जल्द ही सुलभ होगा और उतना ही शक्तिशाली होगा जितना वादा किया गया है।

कृत्रिम बुद्धिमत्ता में मास्टर'स छात्र और एआई तकनीकी लेखक। मैं नवीनतम एआई तकनीक पर अंतर्दृष्टि साझा करता/करती हूँ, एमएल शोध को सुलभ बनाता/बनाती हूँ, और जटिल एआई विषयों को सरल करता/करती हूँ ताकि आप हमेशा अग्रिम पंक्ति में बने रहें।
“12 Days of OpenAI” कार्यक्रम के दूसरे दिन, OpenAI ने अपने मॉडलों को फाइन-ट्यून करने की एक नई तकनीक की घोषणा की, जिसे रिइनफोर्समेंट फाइन-ट्यूनिंग कहा जाता है।
रिइनफोर्समेंट फाइन-ट्यूनिंग, OpenAI के पहले से उपलब्ध डेवलपर डैशबोर्ड के साथ अच्छी तरह एकीकृत है, जहाँ आप अपने मॉडलों को फाइन-ट्यून कर सकते हैं या उनके प्लेटफ़ॉर्म पर नॉलेज डिस्टिलेशन कर सकते हैं।
इस लेख में, मैं अब तक रिइनफोर्समेंट फाइन-ट्यूनिंग के बारे में जो ज्ञात है, उसे कवर करूँगा और आगे क्या अपेक्षित है, इस पर चर्चा करूँगा।