
Programma
Sviluppare applicazioni AI
21 ore
Pratica and corso your progress.
Continua Con GoogleIl Reinforcement Fine-Tuning (RFT) è una tecnica per affinare le conoscenze dei large language model tramite un ciclo di addestramento guidato da ricompense.
I modelli frontier sono notevoli modelli linguistici generali. I migliori eccellono in un'ampia gamma di compiti, come traduzione, assistenza, programmazione e altro. Tuttavia, una parte significativa della ricerca in corso si concentra su come effettuare il fine-tuning di questi modelli in modo efficiente. L'obiettivo è adattarli a toni e stili specifici o specializzarli in ambiti ristretti, ad esempio per fornire consulenze mediche esperte o eseguire compiti di classificazione specifici di dominio.
La sfida è ottenere questo fine-tuning in modo efficiente. Efficienza significa consumare meno potenza computazionale e richiedere meno dataset etichettati, pur raggiungendo risultati di alta qualità. Qui entra in gioco l'RFT, offrendo una soluzione promettente al problema.
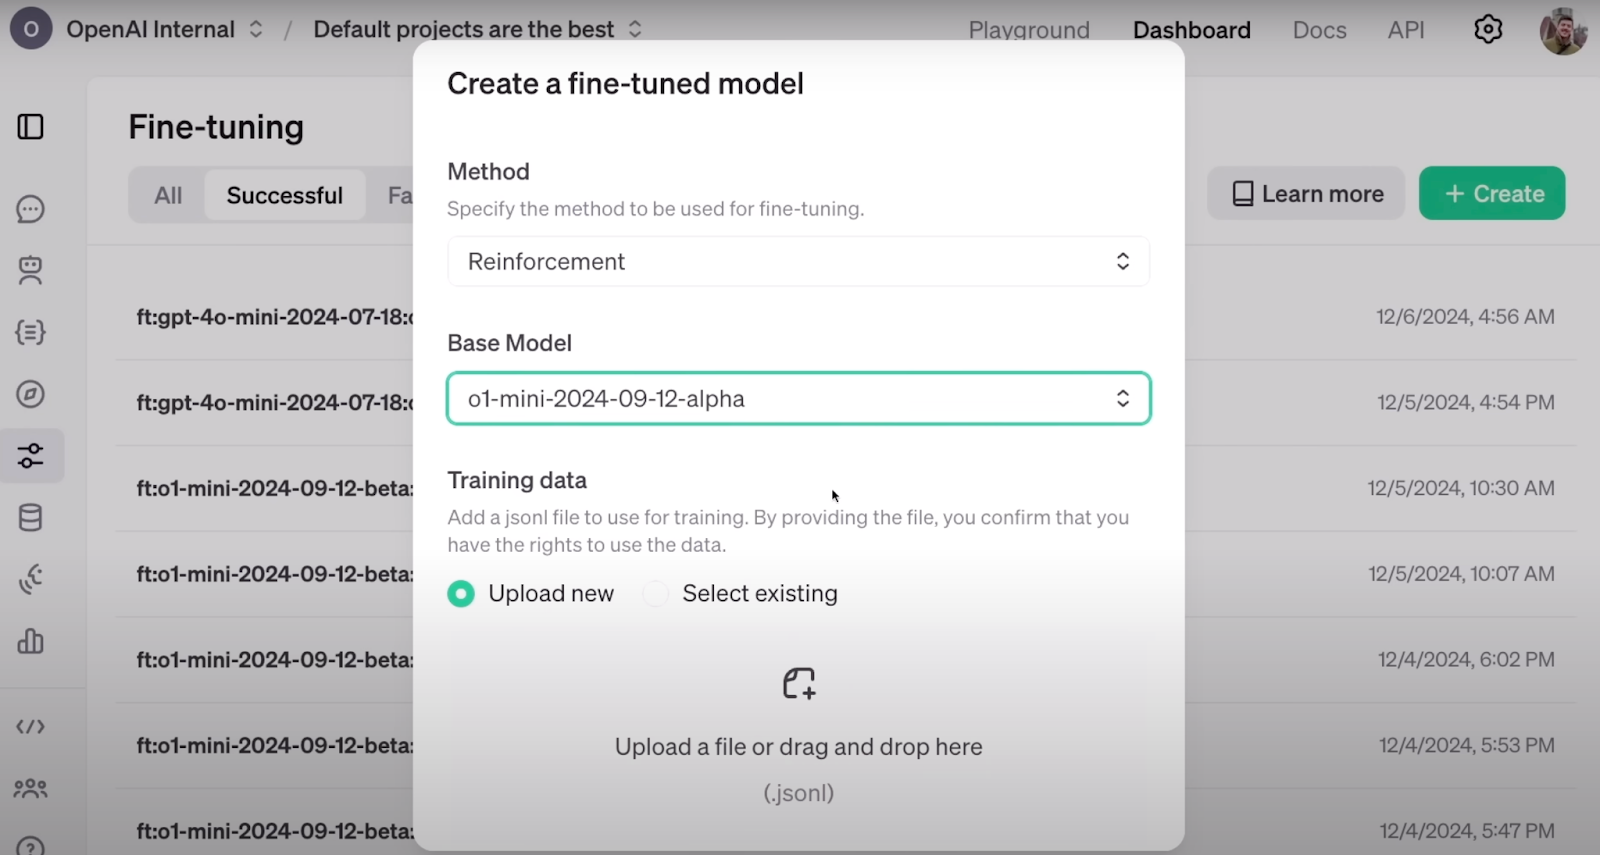
Ecco come appare la configurazione dell'RFT nella dashboard di OpenAI. Fonte: OpenAI
Secondo l' annuncio di OpenAI, l'RFT può effettuare il fine-tuning di un modello in modo efficace con appena poche dozzine di esempi. In molti ambiti, come quello medico, dove i dati sono scarsi e costosi, meno dati possono fare molta strada.
L'RFT si basa sull'ossatura del reinforcement learning (RL), in cui gli agenti sono ricompensati positivamente o negativamente in base alle loro azioni, permettendo loro di allinearsi al comportamento atteso. Ciò avviene assegnando un punteggio all'output dell'agente. Attraverso un addestramento iterativo basato su questi punteggi, gli agenti imparano senza dover comprendere esplicitamente le regole o memorizzare passaggi predefiniti per risolvere il problema.
Se combinato con gli sforzi per migliorare gli LLM su compiti specializzati, l'RFT nasce dall'integrazione di RL e tecniche di fine-tuning. L'idea è eseguire l'RFT attraverso una serie di passaggi:
1. Fornire un dataset strutturato e etichettato che doti il modello delle conoscenze che vuoi che apprenda. Come in un tipico compito di machine learning, questo dataset dovrebbe essere diviso in un set di addestramento e uno di validazione.
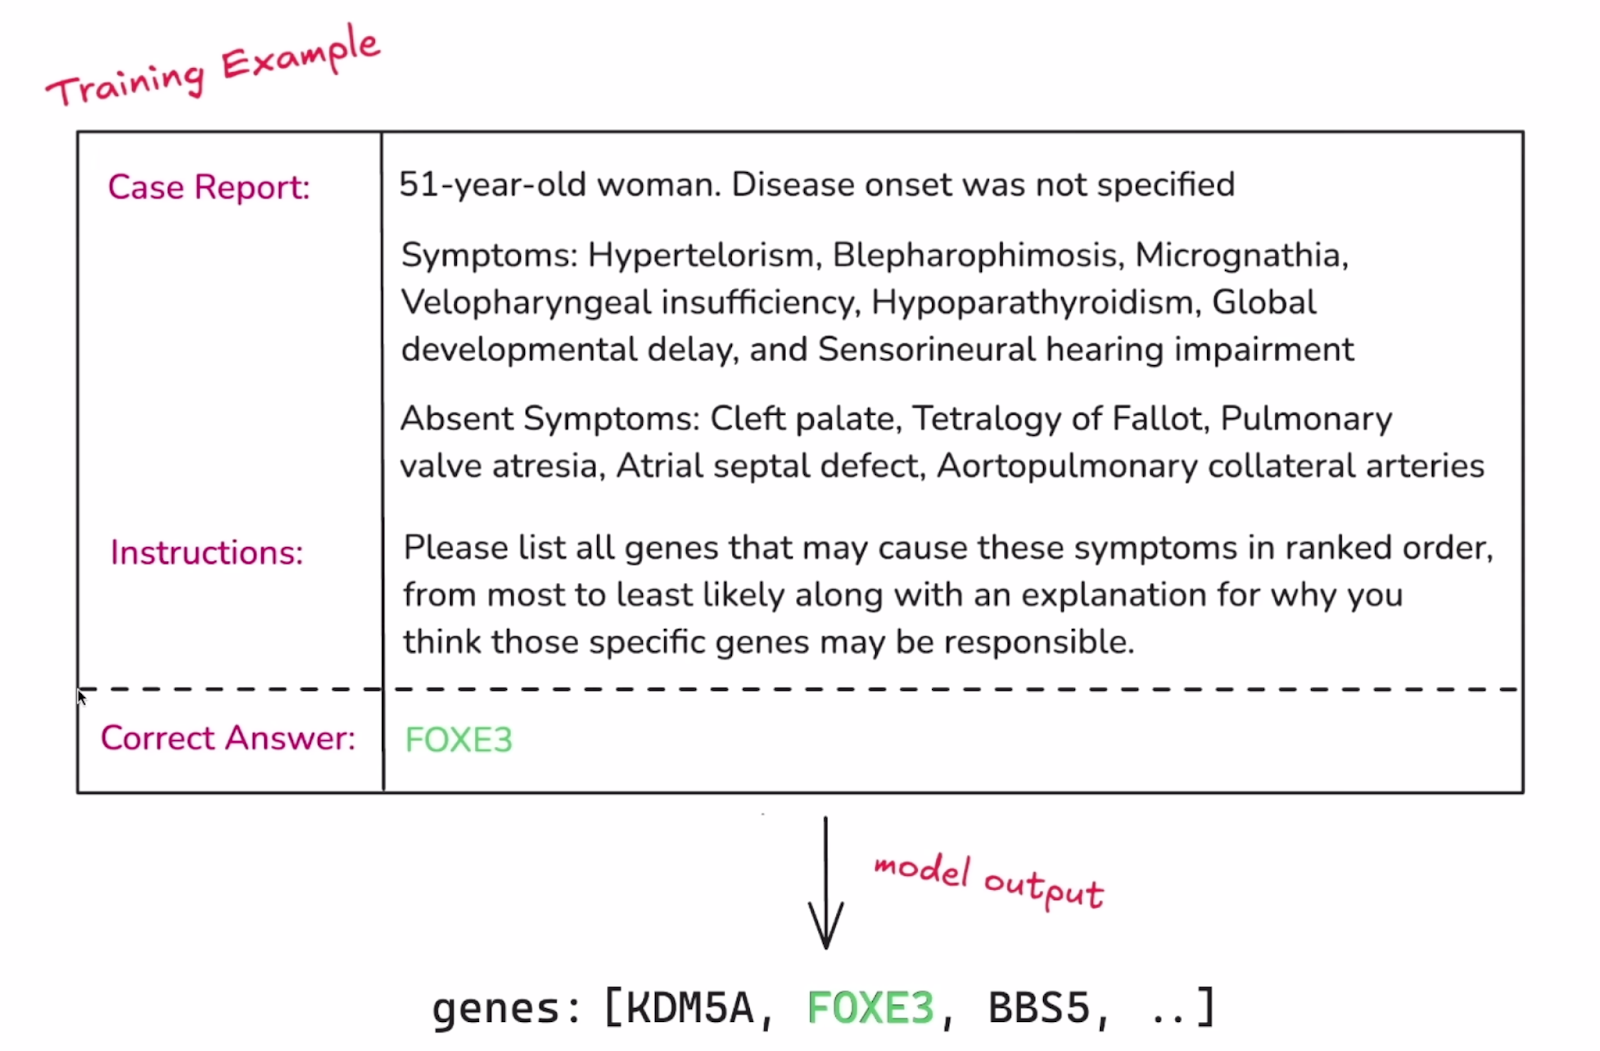
Esempio di una singola istanza del dataset. Fonte: OpenAI
2. Il componente successivo cruciale dell'RFT è definire un modo per valutare gli output del modello. In un tipico processo di fine-tuning, il modello cerca semplicemente di riprodurre la risposta target etichettata. Nell'RFT, invece, il modello dovrebbe sviluppare un processo di ragionamento che conduca a quelle risposte. La valutazione degli output del modello è ciò che lo guida durante il fine-tuning, ed è effettuata tramite i “Grader”. Il voto può andare da 0 a 1, o un valore intermedio, e ci sono molti modi per assegnare un voto a un insieme di output del modello. OpenAI ha annunciato che introdurrà più grader e forse offrirà un modo per implementare grader personalizzati.
3. Una volta che il modello risponde all'input del set di addestramento, il suo output viene valutato dal grader. Questo punteggio funge da segnale di “ricompensa”. I pesi e i parametri del modello vengono quindi spinti a massimizzare le ricompense future.
4. Il modello viene perfezionato attraverso ripetuti passaggi. A ogni ciclo, il modello affina la propria strategia e il set di validazione (tenuto separato dall'addestramento) viene utilizzato periodicamente per verificare quanto bene questi miglioramenti generalizzino a nuovi esempi. Quando i punteggi del modello migliorano sui dati di validazione, è un buon segnale che il modello stia davvero apprendendo strategie significative e non semplicemente memorizzando soluzioni.
Questa spiegazione cattura l'essenza dell'RFT, ma l'implementazione e i dettagli tecnici possono differire.
Osservando qui sotto i risultati di valutazione dell'RFT, che confrontano un modello o1-mini con fine-tuning con un o1-mini standard e un modello o1, colpisce che l'RFT, usando un dataset di appena 1.100 esempi, abbia ottenuto un'accuratezza superiore al modello o1, nonostante quest'ultimo sia più grande e avanzato dell'o1-mini.
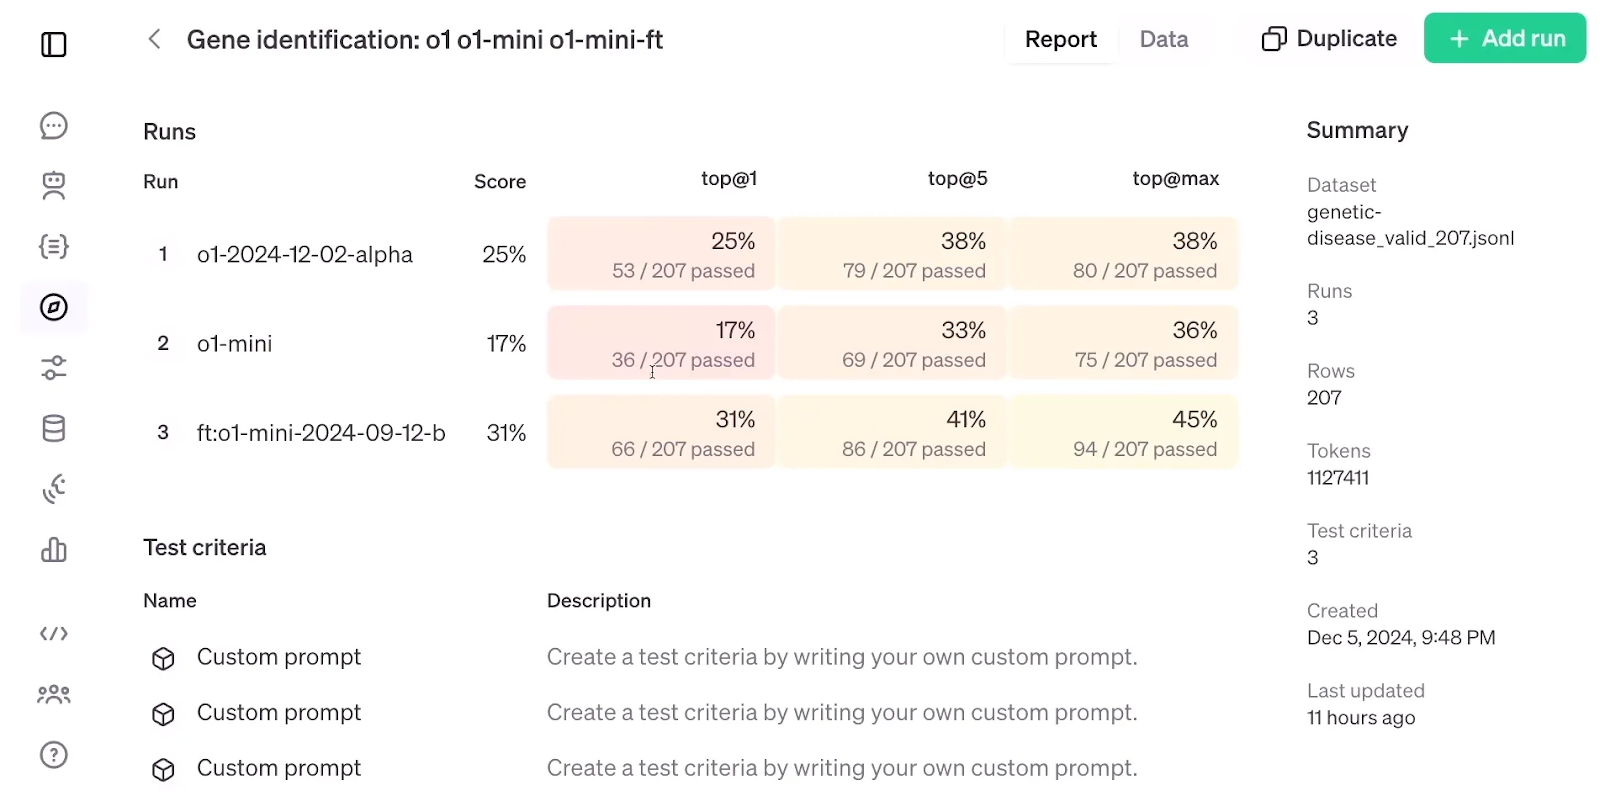
Valutazione dell'RFT. Fonte: OpenAI
Il supervised fine-tuning (SFT) consiste nel prendere un modello pre-addestrato e adattarlo con dati aggiuntivi usando tecniche di apprendimento supervisionato. In pratica, l'SFT funziona al meglio quando l'obiettivo è allineare l'output o il formato del modello a un particolare dataset o assicurarsi che il modello segua certe istruzioni.
Sebbene supervised fine-tuning e reinforcement fine-tuning si basino entrambi su dati etichettati, li usano in modo diverso. Nell'SFT, i dati etichettati guidano direttamente gli aggiornamenti del modello. Il modello li vede come l'output target e aggiusta i propri parametri per ridurre la differenza tra il suo output previsto e la risposta corretta nota.
Nell'RFT, l'esposizione del modello all'etichetta è indiretta, poiché è usata principalmente per creare il segnale di ricompensa più che come target diretto. È per questo che ci si aspetta che il modello richieda meno dati etichettati nell'RFT: il modello mira a trovare schemi per produrre l'output desiderato piuttosto che puntare direttamente a riprodurre i nostri output, e questo promette una maggiore tendenza a generalizzare.
Riepiloghiamo le differenze con questa tabella:
|
Caratteristica |
Supervised Fine-Tuning (SFT) |
Reinforcement Fine-Tuning (RFT) |
|
Idea di base |
Addestrare direttamente il modello su dati etichettati per far coincidere l'output desiderato. |
Usare un "Grader" per fornire ricompense al modello quando genera l'output desiderato. |
|
Uso delle etichette |
Target diretto che il modello deve imitare. |
Usate indirettamente per creare un segnale di ricompensa per il modello. |
|
Efficienza dei dati |
Richiede più dati etichettati. |
Potenzialmente richiede meno dati etichettati grazie alla generalizzazione. |
|
Coinvolgimento umano |
Solo nell'etichettatura iniziale dei dati. |
Solo nella progettazione della funzione di "Grader". |
|
Generalizzazione |
Può andare in overfitting sui dati di addestramento, limitando la generalizzazione. |
Maggiore potenziale di generalizzazione grazie all'attenzione su schemi e ricompense. |
|
Allineamento con le preferenze umane |
Limitato, poiché si basa solo sull'imitazione dei dati etichettati. |
Può essere migliore se il "Grader" riflette accuratamente le preferenze umane. |
|
Esempi |
Fine-tuning di un modello linguistico per generare formati di testo specifici (come poesie o codice). |
Addestrare un modello linguistico a generare contenuti creativi valutati da un "Grader" in base a originalità e coerenza. |
Quando ho letto dell'RFT, non ho potuto fare a meno di pensare a un'altra tecnica efficace e classica chiamata reinforcement learning from human feedback (RLHF). Nell'RLHF, annotatori umani forniscono feedback su come rispondere ai prompt, e un modello di ricompensa viene addestrato per convertire questo feedback in segnali di ricompensa numerici. Questi segnali sono poi usati per perfezionare i parametri del modello pre-addestrato tramite proximal policy optimization (PPO).
Mentre l'RFT toglie il feedback umano dal ciclo e si affida al Grader per assegnare il segnale di ricompensa alla risposta del modello, l'idea di integrare il reinforcement learning nel fine-tuning dell'LLM resta coerente con quella dell'RLHF.
È interessante notare che l'RLHF era il metodo utilizzato in precedenza per allineare meglio il modello nel processo di addestramento di ChatGPT. Secondo il video di annuncio, l'RFT è il metodo che OpenAI usa internamente per addestrare i suoi modelli frontier come GPT-4o o o1 pro mode.
Il reinforcement learning è già stato integrato nel fine-tuning degli LLM, ma il reinforcement fine-tuning di OpenAI sembra portarlo a un livello superiore.
Sebbene la meccanica esatta dell'RFT, la sua data di rilascio e una valutazione scientifica della sua efficacia debbano ancora essere rese note, possiamo incrociare le dita e sperare che l'RFT sia presto accessibile e potente come promesso.
Impara l'AI con questi corsi!
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



