
什么是强化微调?
强化微调(RFT)是一种通过奖励驱动的训练循环来优化大型语言模型知识的技术。
前沿模型是功能强大的通用语言模型。其中最优秀者在广泛任务上表现出色,例如翻译、助理、编程等。然而,当前一个重要的研究方向是如何高效地微调这些模型。目标是让它们适应特定语气和风格,或在狭窄领域中专精,例如提供专业医疗建议或执行特定领域的分类任务。
挑战在于如何高效地实现这种微调。高效意味着消耗更少的计算资源、需要更少的标注数据,同时仍能获得高质量结果。这正是 RFT 发挥作用的地方,它为这一问题提供了很有前景的解决方案。
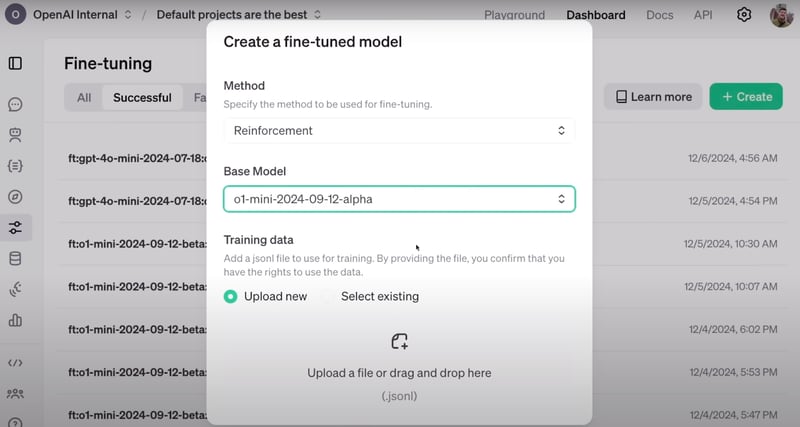
这是在 OpenAI 控制台中配置 RFT 的样子。来源:OpenAI
根据 OpenAI 的 公告,RFT 只需几十个样本就能有效微调模型。在许多领域(如医疗行业)中,数据稀缺且昂贵,少量数据也能发挥巨大作用。
RFT 的基础是强化学习(RL)。在强化学习中,智能体会根据其行为获得正或负的奖励,从而使其与我们期望的行为保持一致。具体做法是为智能体的输出打分。通过基于这些分数的迭代训练,智能体无需显式理解规则或记忆预设步骤,也能学会解决问题。
当与提升 LLM 专项任务能力的努力相结合时,RFT 融合了 RL 与微调技术。其思路是通过一系列步骤来执行 RFT:
1. 提供一个带标注的结构化数据集,为模型注入您希望其学习的知识。与典型的机器学习任务一样,该数据集应划分为训练集和验证集。
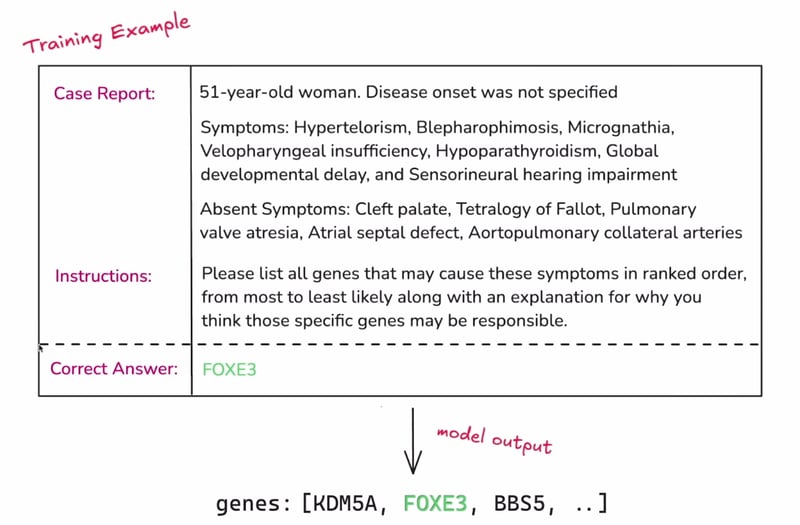
数据集中单个样本的示例。来源:OpenAI
2. RFT 的下一个关键环节是建立评估模型输出的方法。在常规微调流程中,模型只需尝试复现标注的目标答案。而在 RFT 中,模型需要形成通向这些答案的推理过程。对模型输出的评分将引导其在微调中的方向,这一评分由“评分器(Grader)”完成。分数可以在 0 到 1 之间(含中间任意值)取值,给模型的一组输出打分的方法有很多。OpenAI 宣布计划推出更多评分器,并可能引入用户自定义评分器的方式。
3. 一旦模型对训练集中的输入做出响应,其输出会由评分器打分。该分数即为“奖励”信号。随后会微调模型的权重与参数,以最大化未来的奖励。
4. 通过重复上述步骤对模型进行微调。每个循环中,模型都会优化其策略;与训练集分离的验证集会被定期用于检查这些改进在新样本上的泛化效果。当模型在验证数据上的得分提升时,通常意味着模型确实学到了有意义的策略,而非简单记忆解法。
以上解释概括了 RFT 的核心要义,但具体实现与技术细节可能有所不同。
从下图 RFT 的评估结果可以看到,将经过微调的 o1-mini 与标准 o1-mini 和 o1 模型进行比较时,令人瞩目的是,RFT 仅使用 1,100 个样本的数据集,就实现了高于o1 模型的准确率,尽管后者比 o1-mini 规模更大、也更先进。
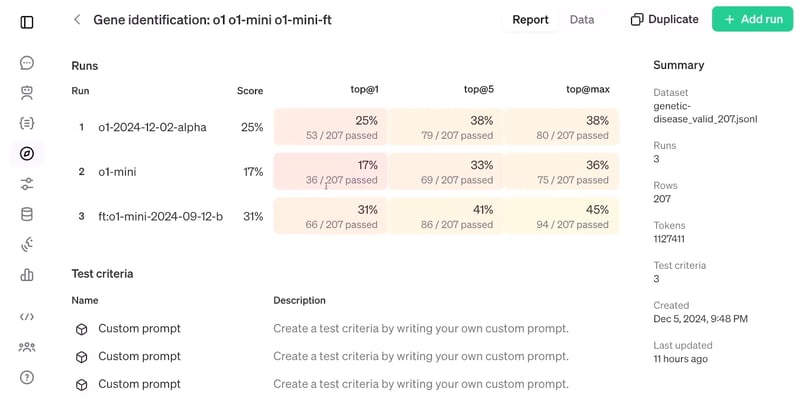
RFT 的评估结果。 来源:OpenAI
监督式微调 vs. 强化微调
监督式微调(SFT)是指基于预训练模型,使用监督学习技术结合额外数据进行调优。在实践中,当目标是让模型的输出或格式与特定数据集对齐,或确保模型遵循特定指令时,SFT 表现最佳。
尽管监督式微调与强化微调都依赖标注数据,但使用方式不同。在 SFT 中,标注数据直接驱动模型更新。模型将其视为目标输出,并通过调整参数来缩小预测输出与已知正确答案之间的差距。
在 RFT 中,模型对标签的接触是间接的,因为它主要用于构建奖励信号,而非直接作为目标。因此,RFT 预期需要更少的标注数据——模型旨在发现生成期望输出的模式,而不是直接对准我们的输出,这也意味着更强的泛化倾向。
让我们用下表来总结这两者的区别:
|
特性 |
监督式微调(SFT) |
强化微调(RFT) |
|
核心理念 |
直接在标注数据上训练模型,使其匹配期望输出。 |
使用“评分器”为模型生成期望输出提供奖励。 |
|
标签使用方式 |
作为模型模仿的直接目标。 |
间接用于为模型构建奖励信号。 |
|
数据效率 |
需要更多标注数据。 |
由于更强泛化,潜在地需要更少的标注数据。 |
|
人工参与 |
仅限于初始数据标注。 |
仅限于设计“评分器”函数。 |
|
泛化能力 |
可能对训练数据过拟合,从而限制泛化。 |
由于关注模式与奖励,具有更高的泛化潜力。 |
|
与人类偏好的一致性 |
有限,因为仅依赖模仿标注数据。 |
如果“评分器”能准确反映人类偏好,则更易对齐。 |
|
示例 |
微调语言模型以生成特定文本格式(如诗歌或代码)。 |
训练语言模型生成由“评分器”根据原创性与连贯性进行评判的创意内容。 |
当阅读 RFT 相关内容时,我不禁想到了另一种高效且经典的技术——人类反馈强化学习(RLHF)。在 RLHF 中,人类标注者会对如何响应提示给出反馈,然后训练一个奖励模型将这些反馈转化为数值化的奖励信号。这些信号再通过近端策略优化(PPO)对预训练模型的参数进行微调。
尽管 RFT 将人工反馈移出回路、依赖评分器为模型响应分配奖励信号,但将强化学习融入 LLM 微调的思想与 RLHF 一脉相承。
有趣的是,RLHF 曾被用于在 ChatGPT 的训练过程中更好地对齐模型。根据公告视频,RFT 是 OpenAI 在内部用于训练其前沿模型(如 GPT-4o或 o1 pro 模式)的方法。
结论
强化学习此前已被用于 LLM 的微调之中,而 OpenAI 的强化微调似乎将这一做法提升到了一个更高层次。
尽管 RFT 的具体机制、发布时间以及其有效性的科学评估尚未披露,但我们可以拭目以待,希望 RFT 能尽快面向更多用户,并如承诺般强大。

人工智能硕士生与 AI 技术写作者。我分享最新的 AI 技术见解,让机器学习研究更易理解,并将复杂的 AI 主题加以简化,助您始终走在前沿。
在“12 Days of OpenAI”活动的第二天,OpenAI 宣布了一种用于微调其模型的新技术,称为强化微调。
强化微调与 OpenAI 已提供的开发者控制台深度集成,您可以在其中微调模型,或在其平台上进行 知识蒸馏。
在本文中,我将介绍目前我们对强化微调的了解,并探讨未来的预期。