
Apa Itu Reinforcement Fine-Tuning?
Reinforcement fine-tuning (RFT) adalah teknik untuk memurnikan pengetahuan model bahasa besar melalui loop pelatihan berbasis reward.
Model frontier adalah model bahasa serbaguna yang luar biasa. Yang terbaik di antaranya unggul dalam berbagai tugas, seperti penerjemahan, asisten, pemrograman, dan lainnya. Namun, area riset yang signifikan berfokus pada fine-tuning model-model ini secara efisien. Tujuannya adalah menyesuaikan agar mampu mengambil nada dan gaya tertentu atau berspesialisasi di bidang sempit, seperti memberikan saran medis ahli atau melakukan tugas klasifikasi spesifik domain.
Tantangannya adalah mencapai fine-tuning ini secara efisien. Efisiensi berarti menggunakan daya komputasi lebih sedikit dan membutuhkan dataset berlabel yang lebih sedikit sambil tetap mencapai hasil berkualitas tinggi. Di sinilah RFT berperan, menawarkan solusi yang menjanjikan untuk masalah ini.
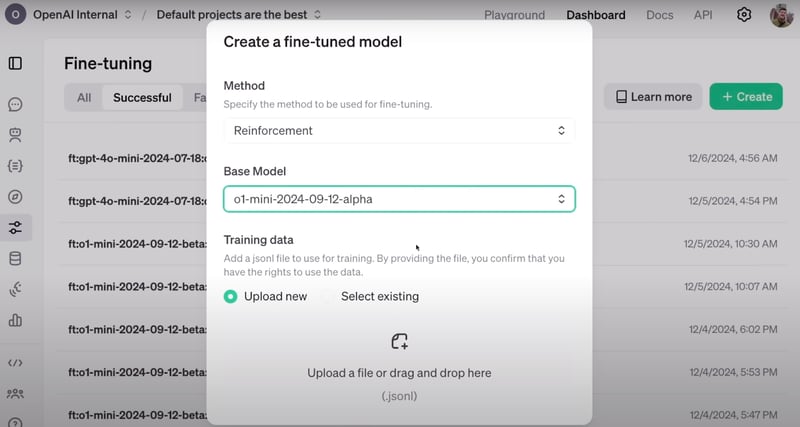
Beginilah tampilan konfigurasi RFT di dasbor OpenAI. Sumber: OpenAI
Menurut pengumuman OpenAI, RFT dapat menyetel model secara efektif hanya dengan beberapa lusin contoh. Di banyak bidang, seperti sektor medis, di mana data langka dan mahal, lebih sedikit data sudah sangat berarti.
RFT dibangun di atas tulang punggung reinforcement learning (RL), di mana agen diberi reward positif atau negatif berdasarkan tindakannya, sehingga mereka selaras dengan perilaku yang kita harapkan. Ini dicapai dengan memberikan skor pada keluaran agen. Melalui pelatihan iteratif berbasis skor tersebut, agen belajar tanpa perlu secara eksplisit memahami aturan atau menghafal langkah-langkah baku untuk memecahkan masalah.
Jika dikombinasikan dengan upaya meningkatkan LLM pada tugas-tugas spesialis, RFT muncul dari teknik RL dan fine-tuning. Gagasannya adalah melakukan RFT melalui serangkaian langkah:
1. Sediakan dataset terstruktur berlabel yang membekali model dengan pengetahuan yang ingin Anda ajarkan. Seperti tugas pembelajaran mesin pada umumnya, dataset ini harus dibagi menjadi set pelatihan dan validasi.
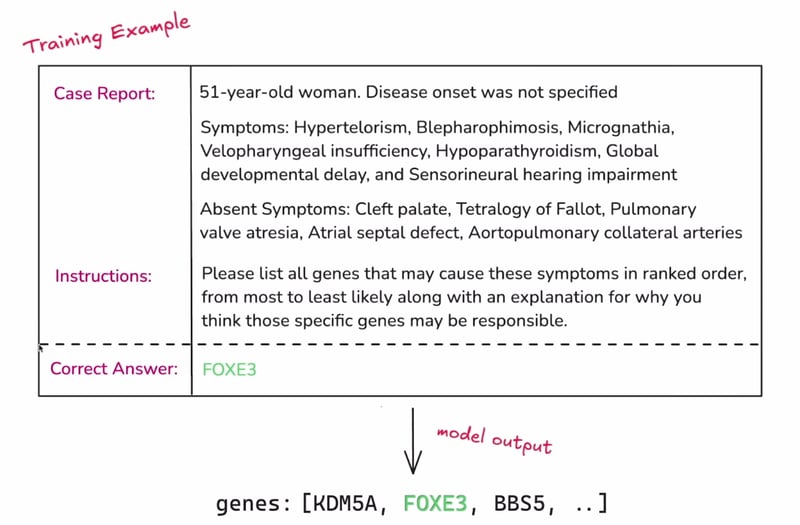
Contoh satu instance dari dataset. Sumber: OpenAI
2. Komponen krusial berikutnya dari RFT adalah menetapkan cara untuk mengevaluasi keluaran model. Dalam proses fine-tuning tipikal, model sekadar mencoba mereproduksi jawaban target berlabel. Namun, dalam RFT, model harus mengembangkan proses penalaran yang mengarah pada jawaban tersebut. Penilaian atas keluaran model inilah yang membimbingnya selama fine-tuning, dan dilakukan menggunakan “Grader.” Nilai dapat berkisar dari 0 hingga 1 atau di antaranya, dan ada banyak cara untuk memberikan nilai pada serangkaian keluaran model. OpenAI mengumumkan rencana untuk meluncurkan lebih banyak grader dan kemungkinan memperkenalkan cara bagi pengguna untuk menerapkan grader kustom mereka sendiri.
3. Setelah model merespons masukan dari set pelatihan, keluarannya diberi skor oleh grader. Skor ini berfungsi sebagai sinyal “reward”. Bobot dan parameter model kemudian didorong agar memaksimalkan reward di masa depan.
4. Model disetel melalui langkah-langkah berulang. Di setiap siklus, model memurnikan strateginya dan set validasi (yang dipisahkan dari pelatihan) digunakan secara berkala untuk memeriksa seberapa baik perbaikan tersebut digeneralisasi ke contoh baru. Saat skor model meningkat pada data validasi, ini pertanda baik bahwa model benar-benar mempelajari strategi bermakna dan bukan sekadar menghafal solusi.
Penjelasan ini menangkap esensi RFT, tetapi implementasi dan rincian teknisnya bisa berbeda.
Melihat hasil evaluasi RFT di bawah, yang membandingkan model o1-mini yang disetel dengan o1-mini standar dan model o1, terlihat mencolok bahwa RFT, menggunakan dataset hanya 1.100 contoh, mencapai akurasi lebih tinggi daripada model o1, meskipun yang terakhir lebih besar dan lebih canggih daripada o1-mini.
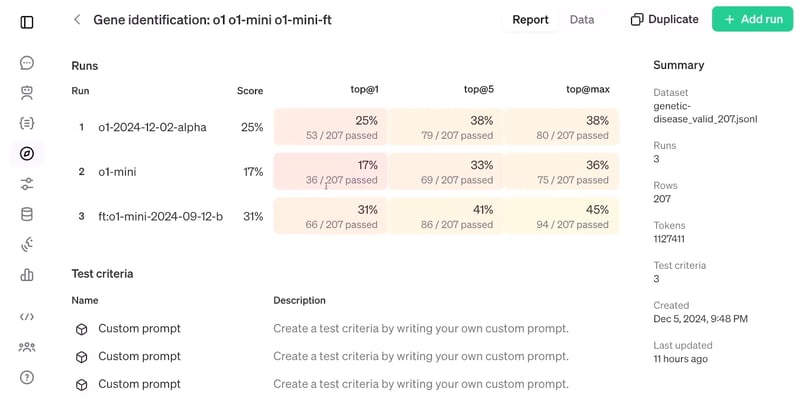
Evaluasi RFT. Sumber: OpenAI
Supervised Fine-Tuning vs. Reinforcement Fine-Tuning
Supervised fine-tuning (SFT) melibatkan pengambilan model yang telah dilatih sebelumnya dan menyesuaikannya dengan data tambahan menggunakan teknik pembelajaran terawasi. Dalam praktiknya, SFT bekerja paling baik saat tujuannya adalah menyelaraskan keluaran atau format model dengan dataset tertentu atau memastikan model mengikuti instruksi tertentu.
Meskipun supervised fine-tuning dan reinforcement fine-tuning sama-sama bergantung pada data berlabel, keduanya menggunakannya secara berbeda. Dalam SFT, data berlabel secara langsung mendorong pembaruan model. Model melihatnya sebagai keluaran target dan menyesuaikan parameternya untuk menutup selisih antara keluaran yang diprediksi dan jawaban benar yang diketahui.
Dalam RFT, paparan model terhadap label bersifat tidak langsung, karena label terutama digunakan untuk membuat sinyal reward alih-alih target langsung. Inilah mengapa model diperkirakan membutuhkan data berlabel yang lebih sedikit dalam RFT—model bertujuan menemukan pola untuk menghasilkan keluaran yang kita inginkan alih-alih langsung menargetkan keluaran kita, dan ini menjanjikan kecenderungan lebih tinggi untuk menggeneralisasi.
Mari kita rangkum perbedaan dengan tabel ini:
|
Fitur |
Supervised Fine-Tuning (SFT) |
Reinforcement Fine-Tuning (RFT) |
|
Gagasan Inti |
Melatih model secara langsung pada data berlabel untuk mencocokkan keluaran yang diinginkan. |
Menggunakan "Grader" untuk memberikan reward kepada model saat menghasilkan keluaran yang diinginkan. |
|
Penggunaan Label |
Target langsung yang ditiru model. |
Digunakan secara tidak langsung untuk membuat sinyal reward bagi model. |
|
Efisiensi Data |
Membutuhkan lebih banyak data berlabel. |
Berpotensi membutuhkan lebih sedikit data berlabel karena generalisasi. |
|
Keterlibatan Manusia |
Hanya pada pelabelan data awal. |
Hanya pada perancangan fungsi "Grader". |
|
Generalisasi |
Dapat overfit ke data pelatihan, membatasi generalisasi. |
Potensi generalisasi lebih tinggi karena fokus pada pola dan reward. |
|
Keselarasan dengan Preferensi Manusia |
Terbatas, karena hanya bergantung pada peniruan data berlabel. |
Dapat lebih selaras jika "Grader" secara akurat mencerminkan preferensi manusia. |
|
Contoh |
Menyetel model bahasa untuk menghasilkan jenis format teks tertentu (seperti puisi atau kode). |
Melatih model bahasa untuk menghasilkan konten kreatif yang dinilai oleh "Grader" berdasarkan orisinalitas dan koherensi. |
Saat membaca tentang RFT, saya teringat teknik klasik lain yang efektif bernama reinforcement learning from human feedback (RLHF). Dalam RLHF, anotator manusia memberikan umpan balik tentang cara merespons prompt, dan model reward dilatih untuk mengubah umpan balik ini menjadi sinyal reward numerik. Sinyal ini kemudian digunakan untuk menyetel parameter model pra-latih melalui proximal policy optimization (PPO).
Sementara RFT mengeluarkan umpan balik manusia dari loop dan mengandalkan Grader untuk memberikan sinyal reward pada respons model, gagasan mengintegrasikan reinforcement learning ke dalam fine-tuning LLM tetap selaras dengan RLHF.
Menariknya, RLHF adalah metode yang sebelumnya mereka gunakan untuk menyelaraskan model dengan lebih baik dalam proses pelatihan ChatGPT. Menurut video pengumuman, RFT adalah metode yang digunakan OpenAI secara internal untuk melatih model frontier mereka seperti GPT-4o atau mode o1 pro.
Kesimpulan
Reinforcement learning telah diintegrasikan ke dalam fine-tuning LLM sebelumnya, tetapi reinforcement fine-tuning dari OpenAI tampaknya membawanya ke tingkat yang lebih tinggi.
Meskipun mekanisme RFT yang tepat, tanggal rilis, dan evaluasi ilmiah atas efektivitasnya belum diungkapkan, kita bisa berharap RFT segera dapat diakses dan sekuat yang dijanjikan.

Mahasiswa magister Kecerdasan Buatan dan penulis teknis AI. Saya berbagi wawasan tentang teknologi AI terbaru, membuat riset ML lebih mudah diakses, dan menyederhanakan topik AI yang kompleks agar Anda tetap terdepan.





Pada hari kedua acara “12 Days of OpenAI”, OpenAI mengumumkan teknik baru untuk menyetel model mereka yang disebut reinforcement fine-tuning.
Reinforcement fine-tuning terintegrasi dengan baik ke dalam dasbor pengembang OpenAI yang sudah tersedia, tempat Anda dapat menyetel model atau melakukan knowledge distillation di platform mereka.
Dalam artikel ini, saya akan membahas apa yang kita ketahui sejauh ini tentang reinforcement fine-tuning dan mengeksplorasi apa yang bisa diharapkan ke depannya.