
Leerpad
AI-toepassingen ontwikkelen
21 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleReinforcement fine-tuning (RFT) is een techniek om de kennis van grote taalmodellen te verfijnen via een beloningsgestuurde trainingslus.
Frontier-modellen zijn indrukwekkende, generieke taalmodellen. De beste daarvan blinken uit in uiteenlopende taken, zoals vertaling, assistentie, programmeren en meer. Een belangrijk onderzoeksgebied richt zich echter op het fine-tunen van deze modellen op een efficiënte manier. Het doel is ze aan te passen aan specifieke toon en stijl, of te specialiseren in smalle domeinen, zoals het geven van deskundig medisch advies of het uitvoeren van domeinspecifieke classificatietaken.
De uitdaging is om dit fine-tunen efficiënt te bereiken. Efficiëntie betekent minder rekenkracht verbruiken en minder gelabelde datasets nodig hebben, terwijl je toch resultaten van hoge kwaliteit behaalt. Hier komt RFT om de hoek kijken, als veelbelovende oplossing voor dit probleem.
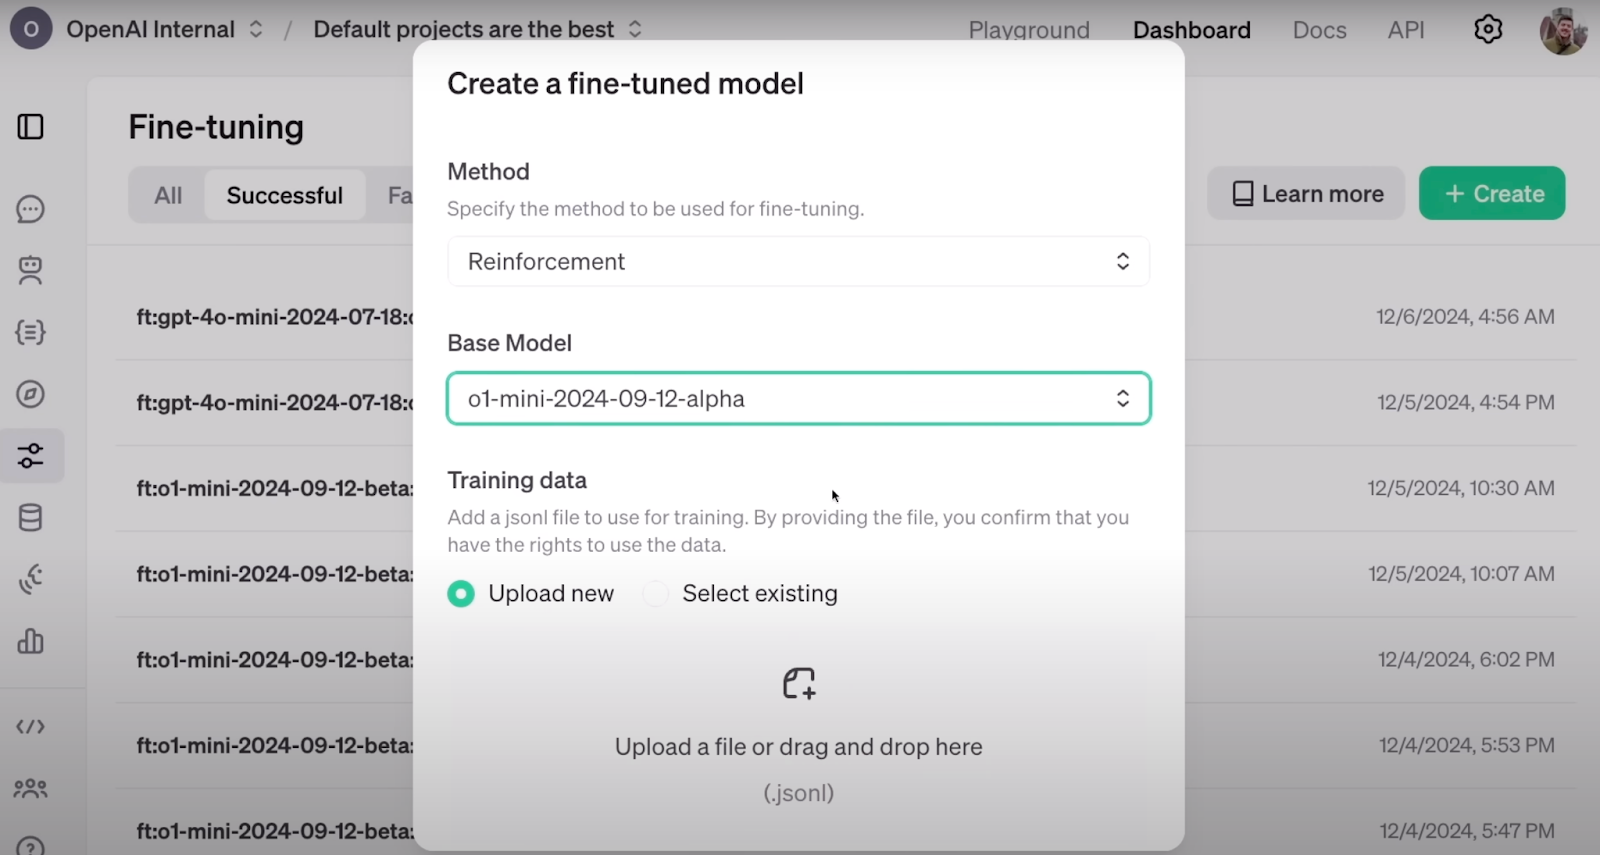
Zo ziet het configureren van RFT eruit in OpenAI’s dashboard. Bron: OpenAI
Volgens de aankondiging van OpenAI kan RFT een model effectief fine-tunen met slechts een paar dozijn voorbeelden. In veel domeinen, zoals de medische sector, waar data schaars en kostbaar is, kom je met minder data al een heel eind.
RFT is gebouwd op de ruggengraat van reinforcement learning (RL), waarbij agenten positief of negatief worden beloond op basis van hun acties, zodat ze zich kunnen richten naar het gewenste gedrag. Dit gebeurt door een score toe te kennen aan de output van de agent. Door iteratieve training op basis van deze scores leren agenten zonder de regels expliciet te hoeven begrijpen of vooraf gedefinieerde stappen uit het hoofd te leren om het probleem op te lossen.
In combinatie met inspanningen om LLM’s te verbeteren op gespecialiseerde taken, komt RFT voort uit RL- en fine-tuningtechnieken. Het idee is om RFT uit te voeren via een reeks stappen:
1. Voorzie in een gelabelde, gestructureerde dataset die het model uitrust met de kennis die je het wilt laten leren. Net als bij een typische machinelearningtaak moet deze dataset worden opgesplitst in een trainings- en een validatieset.
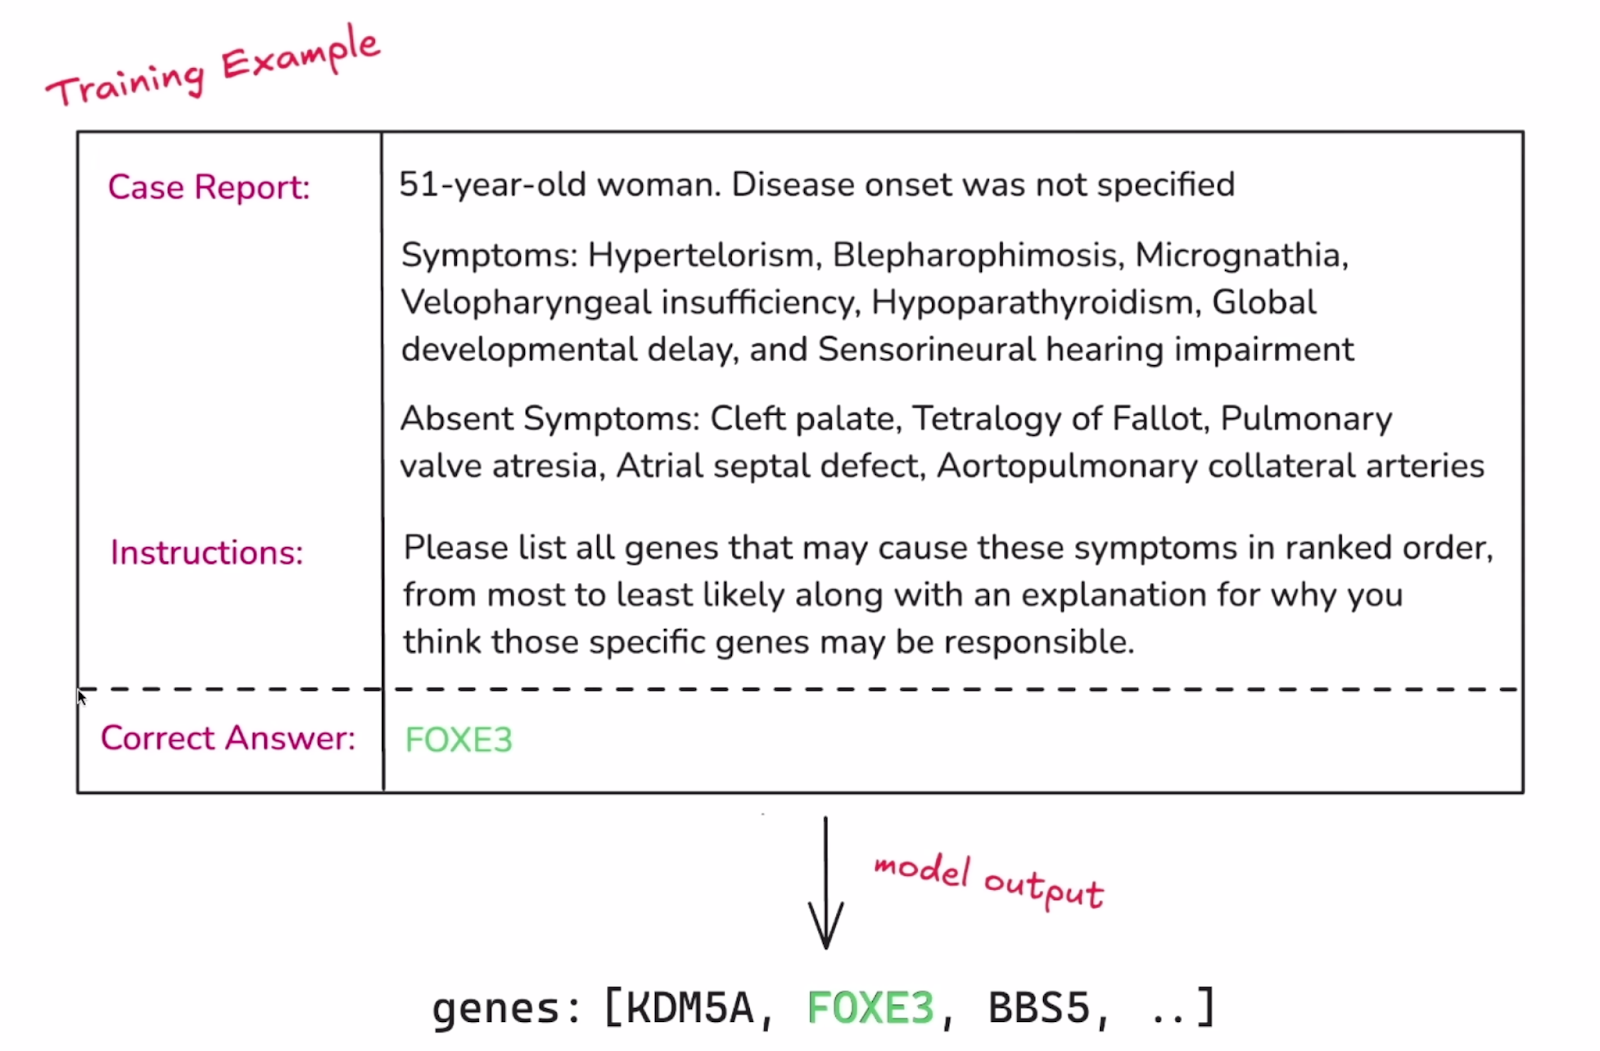
Voorbeeld van één instantie uit de dataset. Bron: OpenAI
2. De volgende cruciale component van RFT is het inrichten van een manier om de modeloutputs te evalueren. In een typisch fine-tuningproces probeert het model simpelweg het gelabelde doelantwoord te reproduceren. In RFT moet het model echter een redeneerproces ontwikkelen dat tot die antwoorden leidt. De beoordeling van de modeloutputs stuurt het model tijdens het fine-tunen, en gebeurt met de “Graders”. De score kan variëren van 0 tot 1 of ergens daartussen, en er zijn veel manieren om een score toe te kennen aan een set modeloutputs. OpenAI kondigde plannen aan om meer graders uit te rollen en mogelijk een manier te introduceren waarop gebruikers hun eigen aangepaste graders kunnen implementeren.
3. Zodra het model reageert op de input uit de trainingsset, wordt de output beoordeeld door de grader. Deze score fungeert als het “belonings”signaal. De gewichten en parameters van het model worden vervolgens bijgestuurd om toekomstige beloningen te maximaliseren.
4. Het model wordt via herhaalde stappen fijn-afgesteld. Bij elke cyclus verfijnt het model zijn strategie en wordt de validatieset (afzonderlijk gehouden van de training) periodiek gebruikt om te controleren hoe goed deze verbeteringen generaliseren naar nieuwe voorbeelden. Wanneer de scores van het model verbeteren op de validatiedata, is dat een goed teken dat het model echt zinvolle strategieën leert en niet simpelweg oplossingen memoriseert.
Deze uitleg vat de kern van RFT, maar de implementatie en technische details kunnen verschillen.
Als we hieronder kijken naar de evaluatieresultaten van RFT, waarin een gefinetunede o1-mini wordt vergeleken met een standaard o1-mini en o1-model, valt op dat RFT, met een dataset van slechts 1.100 voorbeelden, een hogere nauwkeurigheid behaalde dan het o1-model, hoewel dat laatste groter en geavanceerder is dan de o1-mini.
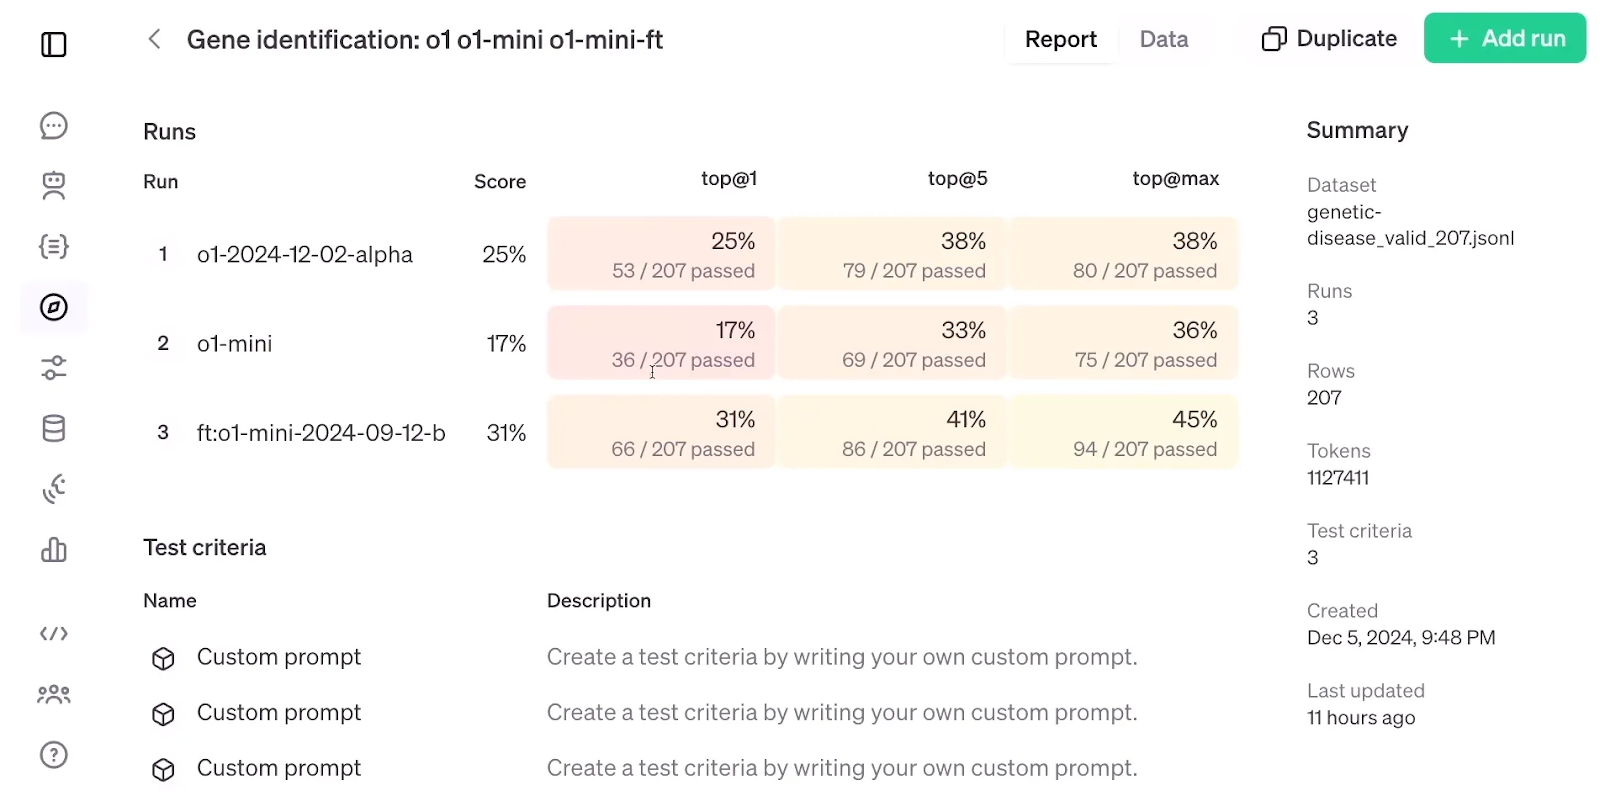
Evaluatie van de RFT. Bron: OpenAI
Supervised fine-tuning (SFT) houdt in dat je een voorgetraind model bijstelt met extra data via supervised learning-technieken. In de praktijk werkt SFT het best wanneer het doel is om de output of het formaat van het model af te stemmen op een specifieke dataset of om ervoor te zorgen dat het model bepaalde instructies volgt.
Hoewel supervised fine-tuning en reinforcement fine-tuning beide op gelabelde data steunen, gebruiken ze die anders. In SFT stuurt de gelabelde data de updates van het model direct aan. Het model ziet die als doeloutput en past zijn parameters aan om het verschil tussen zijn voorspelde output en het bekende juiste antwoord te verkleinen.
In RFT is de blootstelling van het model aan het label indirect, omdat het vooral wordt gebruikt om het beloningssignaal te creëren in plaats van als direct doel. Daarom is de verwachting dat het model in RFT minder gelabelde data nodig heeft—het model probeert patronen te vinden om de gewenste output te produceren in plaats van direct onze outputs na te bootsen, en dat biedt meer kans op generalisatie.
Laten we de differences met deze tabel samenvatten:
|
Kenmerk |
Supervised fine-tuning (SFT) |
Reinforcement fine-tuning (RFT) |
|
Kernidee |
Train het model rechtstreeks op gelabelde data om de gewenste output te evenaren. |
Gebruik een "Grader" om het model te belonen voor het genereren van de gewenste output. |
|
Gebruik van labels |
Direct doel voor het model om na te bootsen. |
Indirect gebruikt om een beloningssignaal voor het model te creëren. |
|
Data-efficiëntie |
Vereist meer gelabelde data. |
Vereist mogelijk minder gelabelde data dankzij generalisatie. |
|
Menselijke betrokkenheid |
Alleen bij het initieel labelen van data. |
Alleen bij het ontwerpen van de functie van de "Grader". |
|
Generalisatie |
Kan overfitten op de trainingsdata, wat generalisatie beperkt. |
Groter potentieel voor generalisatie door focus op patronen en beloningen. |
|
Afstemming op menselijke voorkeuren |
Beperkt, omdat het uitsluitend berust op het imiteren van de gelabelde data. |
Kan beter afgestemd zijn als de "Grader" menselijke voorkeuren nauwkeurig weerspiegelt. |
|
Voorbeelden |
Een taalmodel fine-tunen om specifieke tekstformaten te genereren (zoals gedichten of code). |
Een taalmodel trainen om creatieve content te genereren die door een "Grader" wordt beoordeeld op originaliteit en samenhang. |
Wanneer ik over RFT las, moest ik meteen denken aan een andere effectieve en klassieke techniek, namelijk reinforcement learning from human feedback (RLHF). Bij RLHF geven menselijke annotators feedback op hoe te antwoorden op prompts, en wordt een beloningsmodel getraind om deze feedback om te zetten in numerieke beloningssignalen. Deze signalen worden vervolgens gebruikt om de parameters van het voorgetrainde model te fine-tunen via proximal policy optimization (PPO).
Hoewel RFT menselijke feedback uit de lus haalt en vertrouwt op de Grader om het beloningssignaal toe te kennen aan de reactie van het model, blijft het idee om reinforcement learning te integreren in het fine-tunen van de LLM consistent met dat van RLHF.
Interessant genoeg was RLHF de methode die eerder werd gebruikt om het model beter af te stemmen in het ChatGPT-trainingsproces. Volgens de aankondigingsvideo is RFT de methode die OpenAI intern gebruikt om hun frontier-modellen te trainen, zoals GPT-4o of o1 pro mode.
Reinforcement learning is eerder al geïntegreerd in het fine-tunen van LLM’s, maar OpenAI’s reinforcement fine-tuning lijkt dat naar een hoger niveau te tillen.
Hoewel de exacte werking van RFT, de releasedatum en een wetenschappelijke evaluatie van de effectiviteit nog niet zijn bekendgemaakt, kunnen we duimen dat RFT snel toegankelijk wordt en zo krachtig is als beloofd.
Leer AI met deze cursussen!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

