
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.3K
Hãy tưởng tượng bạn kể cho một người bạn một câu chuyện dài, nhưng đến khi bạn chốt hạ thì họ đã quên mất phần đầu. Sự khó chịu này chính là điều xảy ra khi một AI hết "trí nhớ ngắn hạn", buộc nó phải bỏ bớt chi tiết quan trọng để nhường chỗ cho thông tin mới.
Trong thế giới của Mô hình Ngôn ngữ Lớn (LLM), khoảng chú ý này được xác định bởi context window.
Khi các mô hình ngày càng mạnh hơn và kích thước ngữ cảnh tăng lên, hiểu cách các window này hoạt động trở nên then chốt để xây dựng hệ thống AI tin cậy và có khả năng mở rộng. Trong hướng dẫn này, chúng tôi sẽ đi qua những điều cơ bản về context window, đánh đổi khi mở rộng chúng, và các chiến lược sử dụng hiệu quả.
Để đi xa hơn lý thuyết và học cách quản lý giới hạn ngữ cảnh trong các ứng dụng Python thực tế, hãy tham khảo khóa học Phát triển Ứng dụng LLM với LangChain của chúng tôi.
Context window của một mô hình AI quyết định lượng văn bản mà nó có thể giữ trong bộ nhớ làm việc khi tạo phản hồi. Nó giới hạn độ dài cuộc trò chuyện có thể diễn ra mà không quên các chi tiết từ tương tác trước đó.
Bạn có thể xem nó như trí nhớ ngắn hạn của con người. Nó tạm thời lưu trữ thông tin từ các cuộc trò chuyện trước để sử dụng cho nhiệm vụ đang thực hiện.
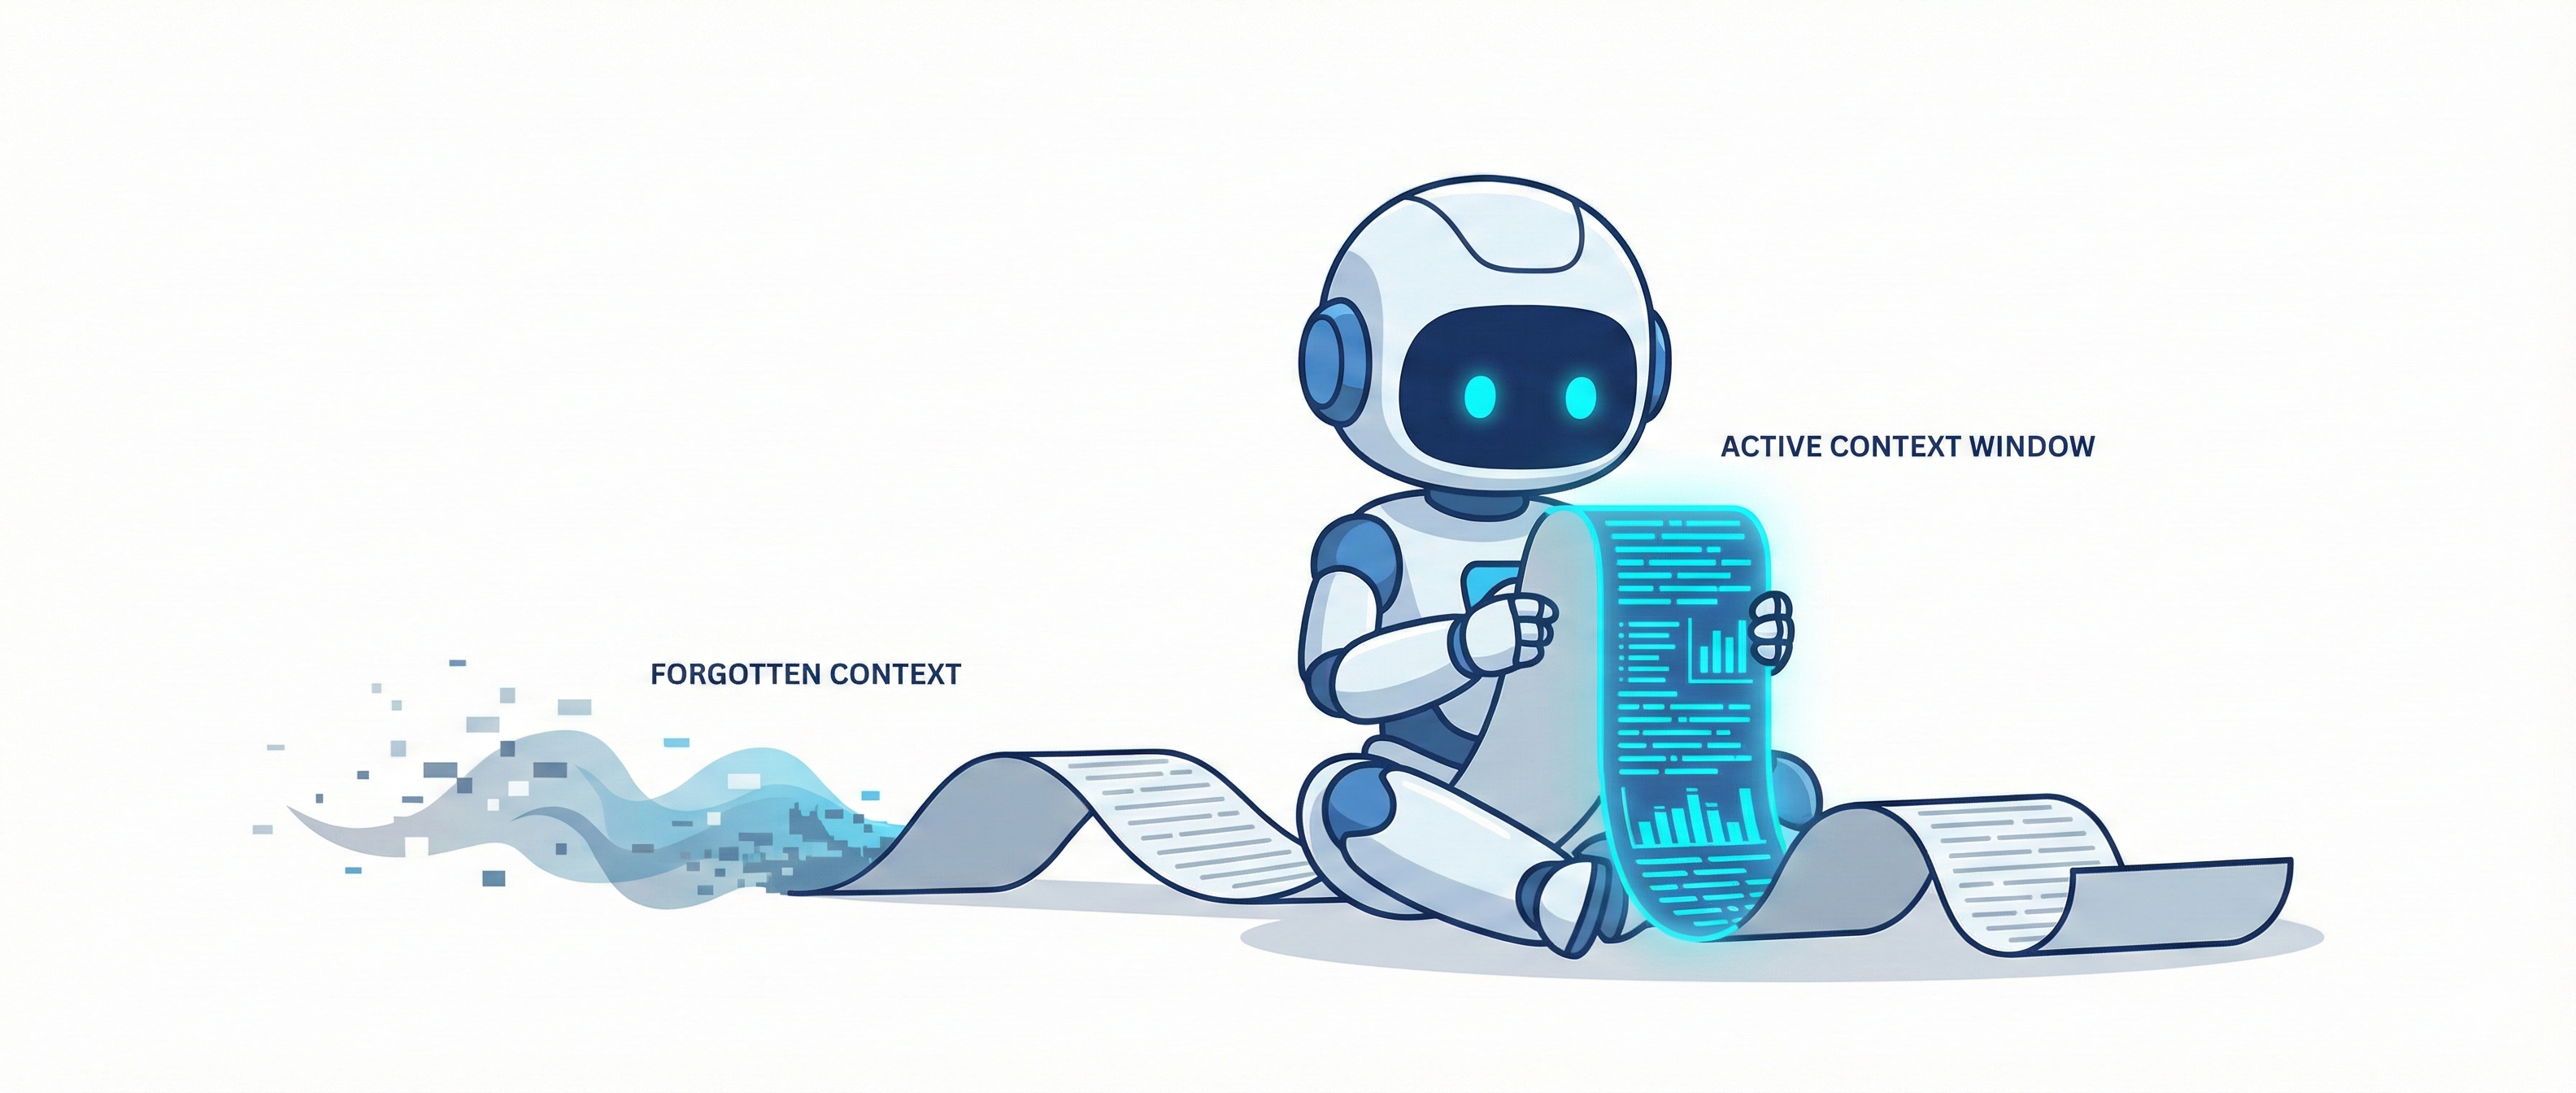
Context window ảnh hưởng đến nhiều khía cạnh, bao gồm chất lượng lập luận, chiều sâu hội thoại và khả năng cá nhân hóa phản hồi của mô hình. Nó cũng quyết định kích thước đầu vào tối đa mà mô hình có thể xử lý trong một lần. Khi lời nhắc hoặc ngữ cảnh cuộc trò chuyện vượt quá giới hạn đó, mô hình sẽ cắt bớt phần đầu tiên của văn bản để nhường chỗ.
Để hình dung rõ hơn điều này có nghĩa là gì, hãy xem một vài khái niệm cơ bản làm nền tảng cho các mô hình AI và context window.
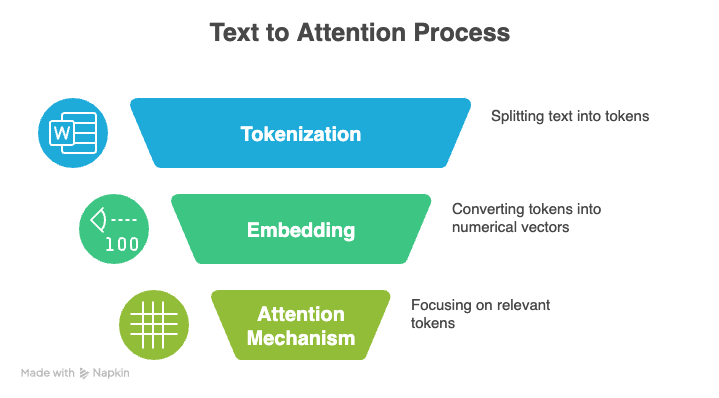
Ba khái niệm cốt lõi làm nền tảng cho LLM: tokenization, cơ chế attention và mã hóa vị trí.
Tokenization là quá trình chuyển văn bản thô thành một chuỗi các đơn vị nhỏ hơn, hay token, mà LLM có thể xử lý. Các token này có thể đại diện cho toàn bộ từ, ký tự riêng lẻ, hoặc thậm chí là một phần âm tiết. Tập hợp toàn bộ các token độc nhất mà mô hình nhận biết được gọi là từ vựng (vocabulary) của nó.
Ví dụ, câu “Hello, world” có thể được tách thành [“Hello”, “,”, “ world”].
Trong quá trình huấn luyện hoặc suy luận, mỗi token được chuyển thành một số nguyên duy nhất, và mô hình đọc các con số này thay vì văn bản gốc. Nó phân tích chuỗi số, học cách các token liên hệ với nhau và tạo văn bản mới bằng cách dự đoán token có khả năng tiếp theo.
Tokenization hiệu quả đóng vai trò lớn trong lượng thông tin có thể vừa với context window của mô hình. Khi tokenizer có thể biểu diễn văn bản với ít token hơn, nhiều nội dung hơn sẽ vừa trong cùng một window.
Các tokenizer biểu diễn các từ hoặc cụm từ phổ biến dưới dạng token đơn lẻ đặc biệt hiệu quả vì chúng giảm số lượng token, cho phép mô hình xử lý tài liệu dài hơn trong giới hạn ngữ cảnh.
Cái gọi là cơ chế attention là một nền tảng khác của các LLM hiện đại. Nó giúp mô hình tập trung vào các phần liên quan nhất của đầu vào khi tạo đầu ra.
Thay vì đối xử tất cả token như nhau, mô hình so sánh biểu diễn hiện tại với tất cả biểu diễn token khác và gán điểm cho từng phép so sánh. Việc gán trọng số có chọn lọc này cho phép mô hình xử lý các chuỗi dài và hiểu ngữ cảnh hiệu quả hơn.
Attention được xây dựng xung quanh ba thành phần: Query, Key và Value.
Query: Tín hiệu được gửi bởi token hiện tại để "tìm kiếm" thông tin liên quan trong phần còn lại của chuỗi.
Key: Định danh cho mỗi token trong chuỗi, xác định mức độ khớp với tín hiệu tìm kiếm.
Value: Nội dung thông tin thực tế được truy xuất và sử dụng khi có sự khớp giữa Query và Key.
Mô hình tính điểm tương đồng giữa query và key, chuyển các điểm đó thành trọng số bằng hàm kích hoạt softmax, rồi tạo đầu ra cuối cùng như một tổng có trọng số của các value.
Self-attention so sánh token hiện tại với mọi token khác trong chuỗi. Điều này tạo ra chi phí tính toán bậc hai: gấp đôi context window sẽ tăng gấp bốn lần công suất xử lý và bộ nhớ cần thiết.
Khi context window mở rộng, chi phí này nhanh chóng trở nên đắt đỏ, vì vậy các mô hình dựa vào những tối ưu như attention thưa (sparse attention), xấp xỉ hạng thấp (low-rank approximation) hoặc chia khối (chunking) để giữ cho tính toán ở mức khả thi.
Transformer, nền tảng của các mô hình ngôn ngữ hiện đại, vốn dĩ không hiểu thứ tự của token. Thay vào đó, chúng dựa vào mã hóa vị trí để đưa thông tin này vào.
Mã hóa vị trí thêm một tín hiệu nhỏ vào mỗi token giúp mô hình hiểu khoảng cách và sắp xếp tương đối.
Phương pháp thể hiện thông tin vị trí cũng xác định mô hình có thể theo dõi mối quan hệ trong một chuỗi xa đến mức nào, điều này quyết định kích thước và hiệu quả của context window. Hãy so sánh một số phương pháp phổ biến:
Embedding vị trí tuyệt đối: Mô hình học một vector riêng cho mỗi vị trí trong chuỗi, giống như gán cho mỗi token một địa chỉ cố định. Phương pháp này hiệu quả với chuỗi ngắn, nhưng mô hình không xử lý được vị trí vượt ngoài phạm vi đã huấn luyện, khiến việc mở rộng context window trở nên khó khăn.
Mã hóa hình sin: Các vị trí được mã hóa bằng các sóng sin và cos lặp lại, tạo cho mỗi token một mẫu độc nhất dựa trên vị trí của nó. Chúng tổng quát hóa tốt hơn với độ dài chưa thấy trong huấn luyện so với embedding tuyệt đối, dù trở nên kém ổn định với chuỗi cực dài.
Mã hóa vị trí tương đối: Thay vì đánh dấu vị trí chính xác, mô hình học khoảng cách giữa các token. Điều này giúp tổng quát hóa tốt với chuỗi dài hơn, nhưng giới hạn ngữ cảnh tổng thể vẫn phụ thuộc vào kiến trúc và bộ nhớ của mô hình.
Rotary Positional Embeddings (RoPE): RoPE mã hóa vị trí bằng cách xoay vector biểu diễn của mỗi token dựa trên vị trí tuyệt đối của nó, từ đó tính khoảng cách đến các token khác. Phương pháp này duy trì ổn định khi chuỗi dài ra và hỗ trợ context window lớn hơn nhiều.
ALiBi (Attention Linear Biases): ALiBi áp dụng một độ chệch theo khoảng cách đơn giản bên trong cơ chế attention, để các token gần nhau tự nhiên nhận trọng số cao hơn. Nó mở rộng tốt với chuỗi dài.
Tôi khuyến nghị xem hướng dẫn về cách transformer hoạt động để có cái nhìn chi tiết.
Nếu ngữ cảnh vượt quá context window, mô hình có thể cắt hoặc bỏ qua phần sớm nhất, có khả năng làm mất thông tin quan trọng. Vì vậy, các nhà nghiên cứu liên tục thử nghiệm kỹ thuật mới để đẩy các giới hạn này và cho phép context window dài hơn.
Cho đến năm 2022, các mô hình GPT của OpenAI thống trị lĩnh vực này. Mô hình GPT đầu tiên, phát hành năm 2018, hỗ trợ window 512 token. Hai phiên bản tiếp theo vào 2019 và 2020 mỗi phiên bản đều tăng gấp đôi giới hạn đó, đạt 2.048 token cho GPT-3. Các mô hình kế tiếp tiếp tục mở rộng ranh giới này lên đến một triệu token (GPT-4.1).
Gần đây, OpenAI đã bị đối thủ bắt kịp hoặc thậm chí vượt mặt. Gemini 2.5 và 3 Pro của Google đạt kích thước window lên đến một triệu token, giúp xử lý trọn vẹn sách, codebase lớn và khối lượng đa tài liệu trong một lần chạy.
Dòng Claude Sonnet 4.5 của Anthropic hiện đang thử nghiệm cùng kích thước context window ở bản beta, mở rộng từ kích thước ban đầu 200.000 token.
Các dòng mô hình mã nguồn mở như Llama và Mistral thường nằm trong khoảng 100k đến 200k, mang lại hiệu năng ngữ cảnh dài đáng nể trong khi vẫn thực tế để triển khai cục bộ hoặc fine-tune.
Ngoại lệ đáng chú ý gồm Llama Maverick, hỗ trợ window 1 triệu token được thiết kế cho lập luận mục đích chung trên tài liệu dài. Trong khi đó, Llama Scout còn đẩy xa hơn nữa với dung lượng 10 triệu token khổng lồ, được kỹ sư hóa đặc biệt để xử lý toàn bộ codebase hoặc kho lưu trữ pháp lý trong một lần chạy.
Tuy nhiên, việc ra mắt GPT-5.2 ngay tuần này báo hiệu một sự thay đổi chiến lược. Thay vì theo đuổi ngữ cảnh vô hạn, OpenAI giới hạn mẫu flagship mới nhất ở window 400.000 token, đánh đổi kích thước thuần túy để lấy 'khả năng ghi nhớ hoàn hảo' và năng lực lập luận vượt trội, tránh các vấn đề xao nhãng thường thấy ở mô hình lớn hơn.
Sự khác biệt về kích thước context window định hình cách mỗi mô hình thể hiện trong quy trình làm việc thực tế. Context window mở rộng giúp mô hình có độ chính xác, mạch lạc và lập luận tầm xa tốt, nhưng cũng đòi hỏi nhiều tính toán hơn và cần lựa chọn ngữ cảnh cẩn thận hơn.
Các mô hình tầm trung vẫn hiệu quả và xử lý tốt tài liệu dài cùng trò chuyện kéo dài, dù chúng cần cấu trúc phù hợp cho đầu vào rất lớn.
Các trường hợp sử dụng sau đây làm nổi bật cách điểm mạnh của các mô hình có context window lớn xuất hiện trong ứng dụng thực tế.
Với đủ chỗ để chứa toàn bộ báo cáo, bản ghi, codebase hoặc bài nghiên cứu cùng lúc, một mô hình có thể theo dõi mẫu, kết nối chi tiết xa nhau và duy trì hiểu biết mạch lạc từ đầu đến cuối. Điều này mở ra nhiều lĩnh vực ứng dụng:
Pháp lý: Window lớn cho phép mô hình phân tích trọn hợp đồng, so sánh điều khoản giữa nhiều tài liệu và theo dõi tham chiếu ẩn trong văn bản dài.
Y tế: Các nhóm có thể xem lại hướng dẫn lâm sàng dài, lịch sử bệnh nhân hoặc bộ dữ liệu đa nghiên cứu đồng thời vẫn giữ được ngữ cảnh quan trọng mà window nhỏ bỏ lỡ.
Nghiên cứu: Một mô hình có window lớn có thể đọc trọn bài báo và tổng quan tài liệu trong một lần, làm nổi bật các liên kết chỉ xuất hiện khi thấy toàn bộ tài liệu.
Context window lớn hơn khiến AI hội thoại trở nên tự nhiên hơn vì mô hình có thể nhớ nhiều phần của cuộc trò chuyện mà không quên các tin nhắn trước đó.
Trong chăm sóc khách hàng, điều này dẫn đến tương tác trôi chảy và cá nhân hóa hơn. Mô hình có thể sử dụng sở thích trước đây và các cuộc trò chuyện cũ để đưa ra phản hồi chính xác, phù hợp hơn.
Context window mở rộng hỗ trợ lập luận phức tạp trên văn bản, âm thanh và hình ảnh bằng cách cho mô hình đủ không gian để giữ tất cả các phương thức cùng nhau thay vì xử lý riêng rẽ.
Khi toàn bộ bản ghi, khung hình và tài liệu liên quan vừa trong một window, mô hình có thể so sánh chi tiết giữa các định dạng, theo dõi mối quan hệ và xây dựng hiểu biết thống nhất về ngữ cảnh.
Điều này loại bỏ các khoảng trống xuất hiện khi thông tin phải bị chia khối hoặc tóm tắt, và cho phép mô hình lập luận trên toàn bộ tập đầu vào cùng lúc.
Context window lớn mở khóa năng lực mạnh mẽ, nhưng cũng đưa ra thách thức hiệu năng mới khi kích thước đầu vào tăng. Ngay cả các mô hình tiên tiến cũng gặp khó khi duy trì attention hoàn hảo trên chuỗi cực dài, nên chúng không phải lúc nào cũng sử dụng thông tin từ mọi phần của ngữ cảnh một cách đáng tin cậy như bạn mong đợi.
Một vấn đề thường gặp ở mô hình ngữ cảnh dài là hiệu ứng “lost in the middle”. Mô hình nhớ phần đầu và cuối của một chuỗi dài khá tốt, nhưng thường bỏ lỡ hoặc phớt lờ các chi tiết quan trọng chôn giữa. Điều này có thể dẫn tới câu trả lời yếu, dù có đầy đủ ngữ cảnh.
Cấu trúc đầu vào một cách thông minh giúp tránh vấn đề này cho các nhiệm vụ quan trọng. Điều đó có nghĩa là chia thành các phần rõ ràng hoặc lặp lại các điểm chính để mô hình không bỏ sót.
Chi phí có thể tăng nhanh khi kích thước context window tăng. Mỗi token bổ sung sẽ tăng kích thước tính toán attention, làm tăng thời gian suy luận, yêu cầu bộ nhớ GPU và tải hệ thống tổng thể.
Để quản lý điều này, cần có cách hiệu quả hơn để đưa thông tin vào mô hình. Các kỹ thuật như truy xuất có chọn lọc, chia khối phân cấp hoặc tóm tắt nhanh giúp giữ đầu vào nhỏ hơn, tránh quá tải cho mô hình.
Window lớn cũng làm dấy lên lo ngại về an toàn, bảo mật và quyền riêng tư. Khi bạn cung cấp cho mô hình nhiều đầu vào hơn, khả năng lộ dữ liệu nhạy cảm cao hơn.
Đó là lý do các nhóm cần quy trình xử lý dữ liệu vững chắc, bước khử thông tin nhạy cảm và kiểm soát truy cập để đảm bảo context window lớn không tạo ra rủi ro mới.
Trong nhiều trường hợp, thông tin không cần thiết hoặc liên quan lỏng lẻo làm tăng tải nhận thức cho mô hình, gia tăng rủi ro ảo giác và mô hình hóa sai. Đầu vào dài cũng đưa thêm nhiễu có thể làm méo hiểu biết của mô hình về nhiệm vụ.
Trong thực tế, hiệu năng chất lượng cao thường đến từ ngữ cảnh được chọn lọc cẩn thận, đảm bảo mô hình thấy đúng thông tin thay vì chỉ phơi bày lượng thông tin lớn nhất.
Có thể áp dụng một số phương pháp để sử dụng context window tối ưu. Trong số đó có Retrieval Augmented Generation (RAG), context engineering, chia khối (chunking) và lựa chọn mô hình.
Retrieval Augmented Generation (RAG) hoạt động bằng cách lấy thêm thông tin từ cơ sở dữ liệu bên ngoài và đưa vào mô hình bất cứ khi nào cần ngữ cảnh.
Thay vì nhồi nhét toàn bộ tài liệu vào context window, RAG lưu mọi thứ riêng rẽ và chỉ truy xuất những phần phù hợp với câu hỏi hiện tại. Điều này giữ cho ngữ cảnh nhỏ gọn nhưng vẫn cung cấp cho mô hình mọi thông tin cần thiết.
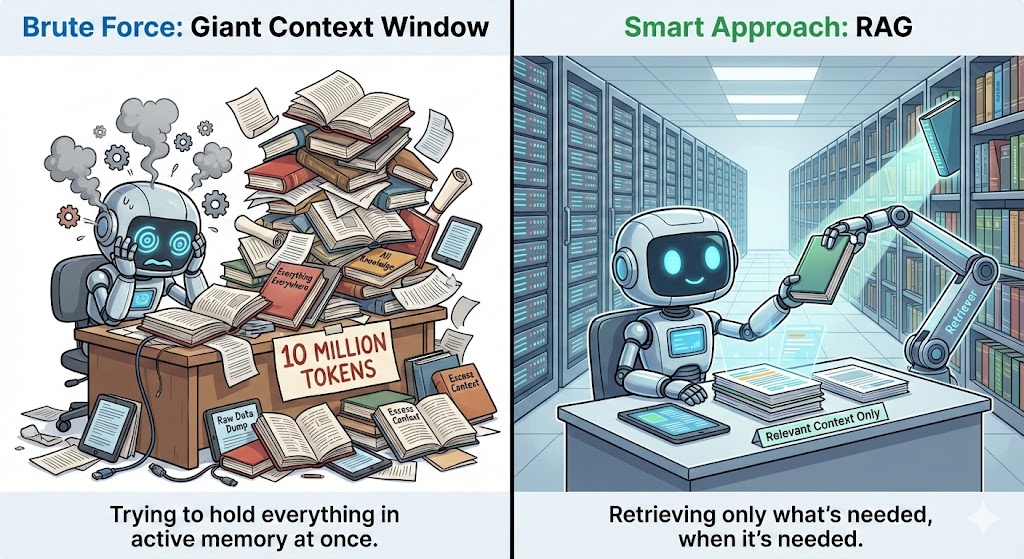
Nó thực hiện điều này bằng cách dùng embedding hoặc tìm kiếm vector để tìm các đoạn liên quan nhất và gửi chúng cho mô hình theo cách sạch sẽ, có cấu trúc. Điều này tăng độ chính xác bằng cách đảm bảo mô hình có thể sử dụng thông tin bổ sung phù hợp vượt ngoài dữ liệu huấn luyện.
Context engineering tập trung cung cấp thông tin liên quan cho mô hình thay vì làm nó quá tải với chi tiết không cần thiết. Chiến lược hiệu quả gồm phân đoạn tài liệu dài, tóm tắt các phần giá trị thấp và dùng bước tiền xử lý nhẹ để làm nổi bật điểm chính.
Tìm kiếm ngữ nghĩa hỗ trợ bằng cách xác định đoạn văn bản quan trọng cho truy vấn hiện tại. Bạn cũng có thể cải thiện kết quả bằng cách đưa thông tin quan trọng nhất lên đầu hoặc cuối ngữ cảnh, vì mô hình có xu hướng nhớ những vị trí đó tốt hơn.
Chunking chia tài liệu dài thành các phần nhỏ, mạch lạc hơn. Ý tưởng là nhóm nội dung dựa trên chủ đề, cấu trúc hoặc nhiệm vụ mà nó hỗ trợ.
Điều này giúp mỗi khối mạch lạc và hỗ trợ mô hình tập trung thay vì lạc trong một khối văn bản khổng lồ. Nếu bạn muốn biết thêm, hãy xem bài viết về các chiến lược chunking nâng cao.
Chunking theo ngữ nghĩa nhóm các câu có ý nghĩa tương tự thay vì cắt văn bản theo giới hạn ký tự ngẫu nhiên. Nó tách nội dung tại các điểm ngắt tự nhiên như chuyển chủ đề, chuyển đoạn hoặc tiêu đề phần.
Chunking theo nhiệm vụ tiến xa hơn bằng cách định hình mỗi khối xung quanh câu hỏi cụ thể bạn đang cố gắng trả lời. Mỗi phần khi đó chỉ chứa thông tin thực sự liên quan đến nhiệm vụ đó.
Các nhiệm vụ liên quan đến phân tích toàn bộ tài liệu, lập luận đa tệp, hoặc hội thoại dài hạn hưởng lợi từ các mô hình có window trong khoảng 200k–1M. Với các nhiệm vụ tập trung hơn như tóm tắt, rà soát mã hoặc hỏi đáp ngắn, mô hình trong khoảng 100k–200k thường cân bằng tốt giữa tốc độ, chi phí và độ chính xác.
Window nhỏ hơn vẫn có thể hoạt động tốt khi ghép với hệ thống truy xuất mạnh. Một hệ thống RAG tốt hoặc Model Context Protocol (MCP) có thể truy xuất đúng thông tin theo yêu cầu, để mô hình không cần giữ mọi thứ trong bộ nhớ.
Trước khi kết thúc, hãy xem công nghệ đang hướng đến đâu về context window.
Các kiến trúc mô hình tương lai đang hướng tới context window động, thay vì window kích thước cố định.
Các nhà nghiên cứu đang khám phá các cách tiếp cận kết hợp thế mạnh của transformer với hệ thống bộ nhớ tầm xa mới, tạo ra các mô hình có thể lưu trữ và truy hồi thông tin mà không chỉ dựa vào cơ chế attention.
Những kiến trúc này vượt qua giới hạn hiện nay bằng cách chuyển từ context window tĩnh sang lớp bộ nhớ động tăng trưởng theo nhiệm vụ.
Hệ thống bộ nhớ là một mảng đổi mới khác. Các mô hình tương lai được kỳ vọng sẽ dựa nhiều hơn vào hệ thống bộ nhớ nhận biết ngữ cảnh vượt ra ngoài một phiên làm việc, cung cấp tính liên tục theo thời gian.
Thay vì coi mỗi cuộc trò chuyện là một khởi đầu mới, các hệ thống này lưu trữ sở thích chính, quyết định trước đây và chủ đề lặp lại trong một lớp bộ nhớ có cấu trúc có thể được gọi lại khi phù hợp.
Điều này chuyển cá nhân hóa từ bị động sang chủ động, cho phép mô hình hiểu người dùng toàn diện hơn và hỗ trợ mục tiêu dài hạn nhất quán hơn nhiều.
Truy xuất bên ngoài cũng đang tiến hóa. Hiện tại, RAG hoạt động như một công cụ tìm kiếm, kéo văn bản liên quan vào prompt. Các phiên bản nâng cao như Corrective Retrieval-Augmented Generation (CRAG) đã xuất hiện, nhưng đó chỉ là khởi đầu.
Trong tương lai, truy xuất sẽ trở nên tích hợp hơn, gần như mô hình có bộ nhớ ngoài riêng. Chúng sẽ tự động thu thập, nén và đưa thông tin trở lại với sự can thiệp tối thiểu của người dùng.
Bộ nhớ bền vững cũng sẽ thay đổi cách chúng ta tương tác với AI. Thay vì quên mọi thứ khi kết thúc phiên, mô hình sẽ nhớ các chi tiết quan trọng qua nhiều ngày, tuần, thậm chí tháng. Khi nó học phong cách, thói quen và ưu tiên của bạn, nó có thể đưa ra phản hồi phù hợp và hữu ích hơn, mà không cần bạn lặp lại.
Công cụ như Mem0 đã tiên phong theo hướng này, hoạt động như một lớp bộ nhớ chuyên dụng giữa ứng dụng và LLM. Tuy nhiên, về lâu dài, chúng tôi kỳ vọng sẽ thấy nhiều khả năng như vậy được tích hợp trực tiếp vào kiến trúc mô hình thay vì dựa vào lớp bên ngoài.
Context window lớn mở khóa quy trình làm việc mới mạnh mẽ, nhưng cũng mang đến thách thức về attention, chi phí tính toán cao hơn và rủi ro chất lượng khi ngữ cảnh bị quá tải. Điều này khiến quản lý ngữ cảnh chiến lược trở nên thiết yếu.
Các kỹ thuật như tăng cường truy xuất, chunking theo ngữ nghĩa và context engineering giúp mô hình tập trung, hiệu quả và ổn định ngay cả khi năng lực của chúng mở rộng.
Nhìn về phía trước, những hệ thống vận hành bằng LLM tốt nhất kết hợp công cụ thông minh và hiểu biết vững chắc về cách ngữ cảnh ảnh hưởng đến lập luận. Bằng cách áp dụng các nguyên tắc này, các nhóm có thể tận dụng lợi ích của mô hình ngữ cảnh dài đồng thời chuẩn bị cho thế hệ kiến trúc tiếp theo đẩy ranh giới ngữ cảnh xa hơn nữa.
Nâng tầm kiến thức Python cơ bản của bạn với lộ trình kỹ năng Phát triển Mô hình Ngôn ngữ Lớn. Lộ trình này được thiết kế để dẫn bạn từ nền tảng mã nguồn đến xây dựng và fine-tune các ứng dụng AI mạnh mẽ của riêng bạn.
Khóa học về LLM
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
