Các phép toán trên ma trận là lõi của tính toán trong học máy, phân tích thống kê và tính toán khoa học. Chẳng hạn, nhiều phép toán trong thống kê cần đến phép nghịch đảo ma trận, chéo hóa và lũy thừa ma trận. Những phép toán này tốn kém về mặt tính toán, nhưng có các phương pháp để phân rã một ma trận thành một tập ma trận nhỏ hơn, nhờ đó tăng hiệu quả tính toán. Các phép toán này thường được gọi chung là phân tích ma trận (matrix factorization), và tùy thuộc vào bản chất của các ma trận nhỏ thu được, chúng có những tên gọi cụ thể.
Phân rã trị riêng (eigendecomposition) là một phương pháp phân tích ma trận, trong đó trị riêng và vectơ riêng tạo thành các phần tử của những ma trận đó. Hiểu về phân rã trị riêng cung cấp cho kỹ sư học máy và khoa học dữ liệu nền tảng toán học để nắm bắt các phương pháp như giảm chiều và xấp xỉ ma trận. Sau khi đọc bài viết này, hãy học khóa Đại số tuyến tính cho Khoa học dữ liệu bằng R để tìm hiểu các chủ đề toán học cốt lõi làm nền tảng cho khoa học dữ liệu.
Phân rã trị riêng là gì?
Phân rã trị riêng là một phương pháp phân tích ma trận, trong đó một ma trận vuông được phân tích (phân rã) thành ba ma trận nhân với nhau. Phép phân rã này được gọi là eigendecomposition vì các phần tử của các ma trận là trị riêng và vectơ riêng của ma trận vuông ban đầu. Về mặt toán học, một ma trận vuông A có thể được phân rã thành ba ma trận sao cho:
trong đó P là ma trận các vectơ riêng của A,D là ma trận đường chéo có các phần tử khác 0 là các trị riêng được sắp xếp của ma trận, và P-1 là ma trận nghịch đảo của P.
Cơ sở toán học của phân rã trị riêng
Tôi sẽ minh họa qua một ví dụ các phép toán để suy ra phân rã trị riêng của một ma trận vuông theo cách giải tích. Ma trận ví dụ của chúng ta là ma trận vuông 2x2 A. Nếu bạn gặp khó khăn với các kỹ thuật nhân ma trận, hãy học khóaĐại số tuyến tính cho Khoa học dữ liệu bằng Rđể nắm rõ cách phép nhân ma trận hoạt động.
Để thực hiện phân rã trị riêng trên ma trận A, chúng ta cần tìm các trị riêng và các vectơ riêng tương ứng của ma trận vuông này. Ta có thể dùng đa thức đặc trưng của ma trận để tính các trị riêng và vectơ riêng của ma trận này. Vì vậy nếu bạn chưa quen phần này, hãy đọc trước Phương trình đặc trưng: Mọi điều bạn cần biết cho khoa học dữ liệu.
Theo định nghĩa của đa thức đặc trưng, ta có:
Vậy đa thức đặc trưng cho ma trận A của chúng ta là pA(λ) = λ2 - 18λ + 56. Ta có thể tìm nghiệm của đa thức này bằng cách cho bằng 0 để suy ra các trị riêng:
Vậy các trị riêng là λ1 = 14 và λ1 = 4. Từ các trị riêng, ta có thể thu được các vectơ riêng của ma trận bằng công thức (A - λI)X = 0 cho mỗi trị riêng phân biệt:
Với λ1 = 14 ta thay 14 vào và giải hệ phương trình thuần nhất:
Điều này cho ta một không gian riêng một chiều (tức là một vectơ cơ sở). Ta lặp lại quy trình tương tự cho λ1 = 4 và được:
Giờ khi đã có các trị riêng và vectơ riêng của ma trận A, ta có thể viết phân rã trị riêng của A như sau:
Trong đó ta xây dựng P bằng cách ghép hai vectơ riêng (tức đặt chúng cạnh nhau) và đặt các trị riêng (theo thứ tự giảm dần) trên đường chéo của ma trận D.
Dĩ nhiên, ta có thể thực hiện phân rã trị riêng bằng máy tính và một ngôn ngữ lập trình như Python hoặc R. Lưu ý rằng Python và R có thể cho ra các vectơ riêng đã được chuẩn hóa (theo thang 0–1), tức là cơ sở trực chuẩn. Điều này quan trọng khi bạn thử tái dựng ma trận A từ PDP-1để kiểm chứng.
Ứng dụng của phân rã trị riêng trong khoa học dữ liệu
Phân rã trị riêng đóng vai trò quan trọng trong học máy và thống kê. Trong học máy, phân rã trị riêng được dùng cho các phương pháp giảm chiều như PCA. Trong PCA, ta tìm các chiều (hướng) mới cho hệ tọa độ ban đầu nhiều chiều sao cho giữ lại tối đa thông tin. Phân rã trị riêng của ma trận cho ta các trị riêng, và các vectơ riêng có trị riêng lớn hơn giữ lại nhiều thông tin hơn, vì vậy được chọn làm các thành phần chính của dữ liệu.
Thực hiện phân rã trị riêng trong Python và R
Sau khi đã học cách thực hiện phân rã trị riêng bằng bút và giấy, giờ ta có thể thực hiện nó bằng máy tính và một ngôn ngữ lập trình như Python và R chỉ với vài dòng lệnh. Lưu ý rằng các vectơ riêng tính bằng Python và R được chuẩn hóa (so với các ngôn ngữ hoặc gói lập trình ký hiệu như SymPy trong Python).
Phân rã trị riêng trong Python
Để thực hiện phân rã trị riêng trong Python, cần cài đặt và nhập mô-đun NumPy vào môi trường. Đoạn mã sau minh họa cách thực hiện phân rã trị riêng trong Python cho ma trận vuông không đối xứng A:
import numpy as np
A = np.array([[6,8],[2,12]])
eigVals, eigVecs = np.linalg.eig(A)print(eigVals)print(eigVecs)Được hỗ trợ bởi
[4.14.][[-0.9701425-0.70710678][0.24253563-0.70710678]]Được hỗ trợ bởi
# Reconstruct the original matrix A
D = np.diag(eigVals)
A_reconstructed = eigVecs @ D @ np.linalg.inv(eigVecs)print(A_reconstructed)Được hỗ trợ bởi
Trong R, phân rã trị riêng có thể được thực hiện bằng hàm dựng sẵn eigen(), do đó không cần cài đặt và nhập gói cho các ma trận nhỏ. Đoạn mã sau trong R thực hiện phân rã trị riêng trên ma trận A (R sắp xếp các trị riêng theo thứ tự giảm dần, nên thứ tự các vectơ riêng khác với đầu ra từ NumPy của Python):
A <- matrix(c(6,8,2,12),2,2, byrow =TRUE)
print(A)
eDecomp <- eigen(A)
eigValues <- eDecomp$values
eigVectors <- eDecomp$vectors
print(eigValues)
print(eigVectors)Được hỗ trợ bởi
[1]144[,1][,2][1,]-0.7071068-0.9701425[2,]-0.70710680.2425356Được hỗ trợ bởi
A_Reconstructed <- eigVectors %*% diag(eigValues)%*%(solve(eigVectors))
print(A_Reconstructed)Được hỗ trợ bởi
Phân rã trị riêng và Phân rã giá trị suy biến (SVD)
Phân rã trị riêng và phân rã giá trị suy biến (SVD) là hai phương pháp phân tích ma trận nổi bật được dùng trong học máy và tính toán khoa học. Mặc dù cả hai đều phân rã một ma trận thành ba ma trận, chúng có vài điểm khác biệt:
Phân rã trị riêng chỉ áp dụng cho ma trận vuông, trong khi SVD có thể áp dụng cho cả ma trận vuông và chữ nhật.
Trong SVD, các ma trận thu được bao gồm các giá trị suy biến, còn với phân rã trị riêng là các trị riêng.
Vì SVD có thể xử lý ma trận không vuông, nên phạm vi ứng dụng rộng hơn phân rã trị riêng.
Kết luận
Trong bài viết ngắn về đại số tuyến tính này, chúng ta đã tìm hiểu về phân rã trị riêng, cách thực hiện bằng tay, và cách tính bằng Python và R. Chúng ta cũng đã thấy phân rã trị riêng được dùng trong các thuật toán học máy như PCA.
Nếu bạn thực sự quan tâm đến việc trở thành nhà phân tích dữ liệu hoặc nhà khoa học dữ liệu, tôi rất khuyến nghị học khóa Đại số tuyến tính cho Khoa học dữ liệu bằng R để có nền tảng vững chắc về toán ứng dụng và lập trình. Ngoài ra, hãy đăng ký lộ trình sự nghiệp đầy đủ Nhà khoa học học máy với Python để khám phá học có giám sát, không giám sát và học sâu.
Tôi được đào tạo bài bản về toán học và thống kê. Tôi có nhiều kinh nghiệm trong mô hình thống kê và các ứng dụng học máy. Ngoài ra, tôi nghiên cứu về toán học của ML.
Câu hỏi thường gặp về phân rã trị riêng
Phân rã trị riêng là gì?⌄
Phân rã trị riêng là quá trình phân tách một ma trận vuông thành các trị riêng và vectơ riêng của nó.
Khi nào có thể thực hiện phân rã trị riêng?⌄
Phân rã trị riêng chỉ khả thi với các ma trận vuông. Tuy nhiên, không phải mọi ma trận vuông đều có thể phân rã theo cách này. Một ma trận phải khả chéo hóa, thường có nghĩa là nó cần có một tập đầy đủ các vectơ riêng độc lập tuyến tính. Với các ma trận không thỏa điều kiện này (như ma trận không chéo hóa được hoặc khiếm khuyết), phân rã trị riêng không thể thực hiện theo nghĩa thông thường.


Các phép toán trên ma trận là lõi của tính toán trong học máy, phân tích thống kê và tính toán khoa học. Chẳng hạn, nhiều phép toán trong thống kê cần đến phép nghịch đảo ma trận, chéo hóa và lũy thừa ma trận. Những phép toán này tốn kém về mặt tính toán, nhưng có các phương pháp để phân rã một ma trận thành một tập ma trận nhỏ hơn, nhờ đó tăng hiệu quả tính toán. Các phép toán này thường được gọi chung là phân tích ma trận (matrix factorization), và tùy thuộc vào bản chất của các ma trận nhỏ thu được, chúng có những tên gọi cụ thể.
Phân rã trị riêng (eigendecomposition) là một phương pháp phân tích ma trận, trong đó trị riêng và vectơ riêng tạo thành các phần tử của những ma trận đó. Hiểu về phân rã trị riêng cung cấp cho kỹ sư học máy và khoa học dữ liệu nền tảng toán học để nắm bắt các phương pháp như giảm chiều và xấp xỉ ma trận. Sau khi đọc bài viết này, hãy học khóa Đại số tuyến tính cho Khoa học dữ liệu bằng R để tìm hiểu các chủ đề toán học cốt lõi làm nền tảng cho khoa học dữ liệu.
Phân rã trị riêng là gì?
Phân rã trị riêng là một phương pháp phân tích ma trận, trong đó một ma trận vuông được phân tích (phân rã) thành ba ma trận nhân với nhau. Phép phân rã này được gọi là eigendecomposition vì các phần tử của các ma trận là trị riêng và vectơ riêng của ma trận vuông ban đầu. Về mặt toán học, một ma trận vuông A có thể được phân rã thành ba ma trận sao cho:
trong đó P là ma trận các vectơ riêng của A, D là ma trận đường chéo có các phần tử khác 0 là các trị riêng được sắp xếp của ma trận, và P-1 là ma trận nghịch đảo của P.
Cơ sở toán học của phân rã trị riêng
Tôi sẽ minh họa qua một ví dụ các phép toán để suy ra phân rã trị riêng của một ma trận vuông theo cách giải tích. Ma trận ví dụ của chúng ta là ma trận vuông 2x2 A. Nếu bạn gặp khó khăn với các kỹ thuật nhân ma trận, hãy học khóa Đại số tuyến tính cho Khoa học dữ liệu bằng R để nắm rõ cách phép nhân ma trận hoạt động.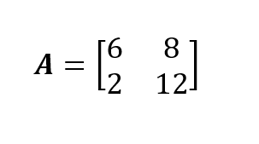
Để thực hiện phân rã trị riêng trên ma trận A, chúng ta cần tìm các trị riêng và các vectơ riêng tương ứng của ma trận vuông này. Ta có thể dùng đa thức đặc trưng của ma trận để tính các trị riêng và vectơ riêng của ma trận này. Vì vậy nếu bạn chưa quen phần này, hãy đọc trước Phương trình đặc trưng: Mọi điều bạn cần biết cho khoa học dữ liệu.
Theo định nghĩa của đa thức đặc trưng, ta có:
Vậy đa thức đặc trưng cho ma trận A của chúng ta là pA(λ) = λ2 - 18λ + 56. Ta có thể tìm nghiệm của đa thức này bằng cách cho bằng 0 để suy ra các trị riêng: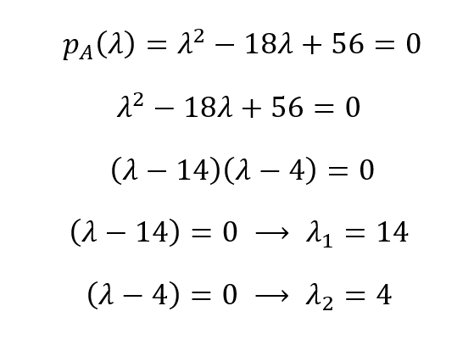
Vậy các trị riêng là λ1 = 14 và λ1 = 4. Từ các trị riêng, ta có thể thu được các vectơ riêng của ma trận bằng công thức (A - λI)X = 0 cho mỗi trị riêng phân biệt: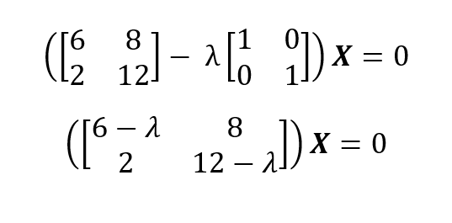
Với λ1 = 14 ta thay 14 vào và giải hệ phương trình thuần nhất:
Điều này cho ta một không gian riêng một chiều (tức là một vectơ cơ sở). Ta lặp lại quy trình tương tự cho λ1 = 4 và được:
Giờ khi đã có các trị riêng và vectơ riêng của ma trận A, ta có thể viết phân rã trị riêng của A như sau:
Trong đó ta xây dựng P bằng cách ghép hai vectơ riêng (tức đặt chúng cạnh nhau) và đặt các trị riêng (theo thứ tự giảm dần) trên đường chéo của ma trận D.
Dĩ nhiên, ta có thể thực hiện phân rã trị riêng bằng máy tính và một ngôn ngữ lập trình như Python hoặc R. Lưu ý rằng Python và R có thể cho ra các vectơ riêng đã được chuẩn hóa (theo thang 0–1), tức là cơ sở trực chuẩn. Điều này quan trọng khi bạn thử tái dựng ma trận A từ PDP-1 để kiểm chứng.
Ứng dụng của phân rã trị riêng trong khoa học dữ liệu
Phân rã trị riêng đóng vai trò quan trọng trong học máy và thống kê. Trong học máy, phân rã trị riêng được dùng cho các phương pháp giảm chiều như PCA. Trong PCA, ta tìm các chiều (hướng) mới cho hệ tọa độ ban đầu nhiều chiều sao cho giữ lại tối đa thông tin. Phân rã trị riêng của ma trận cho ta các trị riêng, và các vectơ riêng có trị riêng lớn hơn giữ lại nhiều thông tin hơn, vì vậy được chọn làm các thành phần chính của dữ liệu.
Thực hiện phân rã trị riêng trong Python và R
Sau khi đã học cách thực hiện phân rã trị riêng bằng bút và giấy, giờ ta có thể thực hiện nó bằng máy tính và một ngôn ngữ lập trình như Python và R chỉ với vài dòng lệnh. Lưu ý rằng các vectơ riêng tính bằng Python và R được chuẩn hóa (so với các ngôn ngữ hoặc gói lập trình ký hiệu như SymPy trong Python).
Phân rã trị riêng trong Python
Để thực hiện phân rã trị riêng trong Python, cần cài đặt và nhập mô-đun NumPy vào môi trường. Đoạn mã sau minh họa cách thực hiện phân rã trị riêng trong Python cho ma trận vuông không đối xứng A:
Phân rã trị riêng trong R
Trong R, phân rã trị riêng có thể được thực hiện bằng hàm dựng sẵn
eigen(), do đó không cần cài đặt và nhập gói cho các ma trận nhỏ. Đoạn mã sau trong R thực hiện phân rã trị riêng trên ma trận A (R sắp xếp các trị riêng theo thứ tự giảm dần, nên thứ tự các vectơ riêng khác với đầu ra từ NumPy của Python):Phân rã trị riêng và Phân rã giá trị suy biến (SVD)
Phân rã trị riêng và phân rã giá trị suy biến (SVD) là hai phương pháp phân tích ma trận nổi bật được dùng trong học máy và tính toán khoa học. Mặc dù cả hai đều phân rã một ma trận thành ba ma trận, chúng có vài điểm khác biệt:
Kết luận
Trong bài viết ngắn về đại số tuyến tính này, chúng ta đã tìm hiểu về phân rã trị riêng, cách thực hiện bằng tay, và cách tính bằng Python và R. Chúng ta cũng đã thấy phân rã trị riêng được dùng trong các thuật toán học máy như PCA.
Nếu bạn thực sự quan tâm đến việc trở thành nhà phân tích dữ liệu hoặc nhà khoa học dữ liệu, tôi rất khuyến nghị học khóa Đại số tuyến tính cho Khoa học dữ liệu bằng R để có nền tảng vững chắc về toán ứng dụng và lập trình. Ngoài ra, hãy đăng ký lộ trình sự nghiệp đầy đủ Nhà khoa học học máy với Python để khám phá học có giám sát, không giám sát và học sâu.