
在本指南中,我整理了数据科学家面试中最常见的问题,涵盖统计学、机器学习、编码(Python、SQL)以及产品思维。练习这些问题将帮助您通过所有技术面试环节——无论您是在校学生寻求实习,还是职场人士谋求下一份工作。
要点速览
- 数据科学家面试考察五大方面:统计与概率、机器学习、编码(Python/SQL)、行为面试,以及产品思维。
- 关键技术主题:线性回归假设、防止过拟合、特征选择方法(过滤、包裹、嵌入)、降维,以及 A/B 测试。
- 编码环节重点练习 Python(pandas、正则、列表操作)与 SQL(聚合、日期过滤、窗口函数)。
- 行为问题使用 STAR 法准备关于沟通、冲突解决和处理不确定性的答案。
- 大型科技公司(Meta、Google、Amazon)除了核心技术技能外,还考核指标分析、产品感知与应用统计。
- 使用我们的数据科学面试准备指南来为各阶段制定学习计划。
非技术类数据科学面试问题
先从一些您在面试中可能遇到的通用能力问题开始。这些问题考察作为数据科学家所需的软技能:
请谈谈您向非技术背景的人解释复杂数据概念的经历。您如何确保对方听懂?
此题评估您的沟通能力和简化复杂主题的能力。示例回答:
在上一份工作中,我需要向市场团队解释机器学习的概念。我用了教孩子识别不同水果的类比。就像您会给孩子看很多例子来帮助他们学习一样,机器学习模型也是用数据来训练的。这个类比让复杂概念更贴近日常,也更易理解。
请描述一个与难相处的团队成员合作的项目。您是如何处理的?
这考察您的团队协作与冲突解决能力。示例回答:
在一个项目中,我与一位同事的工作风格差异很大。为了解决分歧,我发起会议去理解他的视角。我们在项目目标上找到共同点,并约定了共享的方法。这次经历让我认识到开放沟通与同理心在团队合作中的价值。
请分享一次在紧迫期限下工作的经历。您如何管理任务并按时交付?
此题关于时间管理与优先级。示例回答:
有一次我需要在非常紧的期限内完成分析。我优先处理项目的关键部分,把计划告知团队,并专注于高效执行。通过拆分任务并设定小里程碑,我在不牺牲质量的前提下按时完成了项目。
您是否在分析中犯过重大错误?您如何处理,并从中学到了什么?
面试官关注您承担错误并从中学习的能力。示例回答:
有一次我误读了一个数据模型的结果。意识到错误后,我立即通知团队并重新分析了数据。这次经历让我明白复核结果的重要性,以及职场透明度的价值。
您如何保持对数据科学最新趋势与进展的了解?
这体现您对持续学习和保持专业性的投入。示例回答:
我通过阅读行业期刊、参加网络研讨会、参与线上社区来保持更新。我也每周预留时间尝试新工具与技术。这不仅让我保持前沿,也持续提升了技能。
请讲述一次在需求不清或频繁变化的项目中工作的经历。您如何适应?
此题评估适应力与问题解决能力。示例回答:
在一个项目中,需求频繁变化。我通过与利益相关方保持开放沟通来理解他们的需求,并采用敏捷方法提高灵活性,从而更有效地应对变化。
描述一个需要在数据驱动决策与其他考量(如伦理、业务需求等)之间平衡的情境。
这考察您在数据之外兼顾多方面因素的能力。示例回答:
在上一个岗位,我需要在数据驱动与伦理考量之间取得平衡。我确保所有数据使用符合伦理标准与隐私法规,并在必要时提出替代方案。这种做法既保障合规,也支持了明智决策。
通用数据科学面试问题
线性回归需要满足哪些假设?
线性回归的四个假设为:
- 线性关系:自变量 x 与因变量 y 之间应存在线性关系。
- 独立性:相邻残差之间不应相关,多见于时间序列数据。
- 同方差性:在每个 x 水平,方差应保持恒定。
- 正态性:残差应服从正态分布。
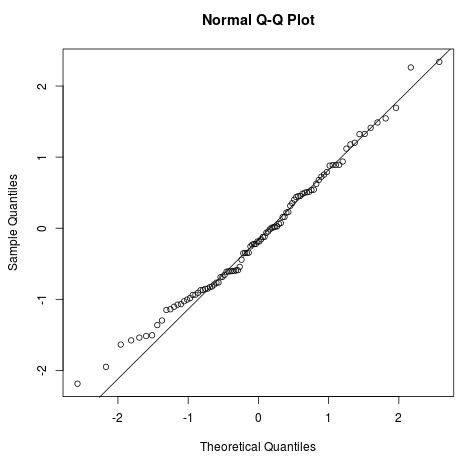
图片来源:Statology
您可以通过我们的Python 线性建模入门课程深入学习线性模型的概念及应用。
如何处理缺失值较多的数据集?
处理缺失数据的方法多种多样。您可以:
- 删除包含缺失值的行。
- 删除缺失值较多的列。
- 用字符串或数值常量填充缺失值。
- 用该列的均值或中位数替换缺失值。
- 使用多元回归分析估计缺失值。
- 利用多列以平均模拟值与随机误差来替换缺失。
通过完成用插补处理 R 中的缺失数据课程,学习如何诊断、可视化与处理缺失数据。
如何向非技术背景的利益相关方解释结果的技术细节?
首先,了解对方背景并据此调整措辞。如果对方有金融背景,先熟悉金融常用术语,并用这些术语解释复杂方法。
其次,多使用可视化与图表。多数人偏好视觉学习,创意化的沟通工具能显著提升理解。
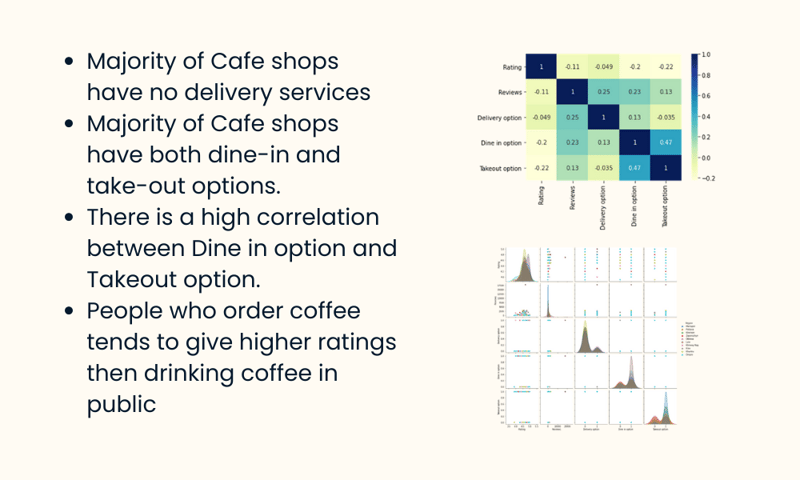
图片作者自制
第三,以结果为核心。不要拘泥于方法或统计本身,着重强调他们如何用分析信息改进业务或流程。
最后,鼓励他们提问。人们常因陌生主题而不敢提问。通过主动互动营造双向沟通的氛围。
通过我们的SQL 报表课程学习如何构建自己的 SQL 报表与仪表板。
什么是 p 值?应如何解读?
在原假设为真的前提下,p 值衡量的是观测到至少与已收集数据同等极端结果的概率。
当 p 值低于显著性水平(通常为 0.05)时,说明有证据拒绝原假设。比如在一次 A/B 测试中,若 p 值为 0.03,则在原假设成立时仅有 3% 的概率会出现如此结果,暗示变体确有真实影响。
常见误解:p 值并不表示原假设为真的概率,只反映数据与原假设的相容程度。
I 型错误与 II 型错误有何区别?
这是假设检验中的两类错误:
- I 型错误(假阳性):原假设为真却被拒绝。由显著性水平(α)控制。示例:得出新模型更优的结论,实际并非如此。
- II 型错误(假阴性):原假设为假却未被拒绝。由统计功效(1 − β)控制。示例:认为模型无改进,实际存在改进。
降低 α 可减少 I 型错误,但会增加 II 型错误。合适的权衡取决于您场景中各类错误的代价——在欺诈检测、医学诊断或 A/B 决策中尤为关键。
更多内容参见我们的轻松掌握假设检验教程。
数据科学技术面试问题
选择合适变量的特征选择方法有哪些?
特征选择主要有三类方法:过滤法(filter)、包裹法(wrapper)和嵌入法(embedded)。
过滤法
过滤法通常用于预处理步骤。它独立于任何机器学习算法来选择特征。此类方法速度快、资源占用少,并能去除重复、相关或冗余特征。
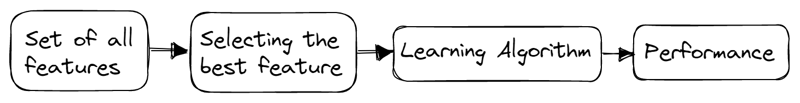
图片作者自制
常见技术包括:
- 方差阈值
- 相关系数
- 卡方检验
- 互信息
包裹法
包裹法通过在特征子集上迭代训练模型,根据结果增删特征。其计算成本高于过滤法,但通常能获得更好的模型准确率。
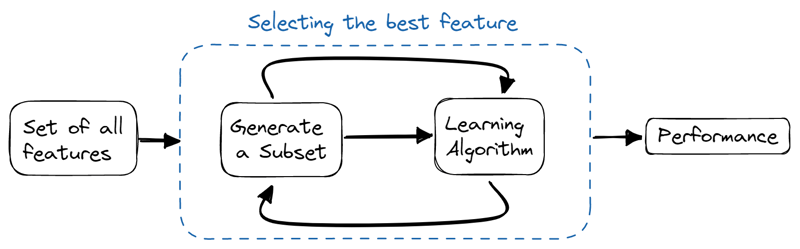
图片作者自制
常见技术包括:
- 前向选择
- 后向消除
- 双向消除
- 递归消除
嵌入法
嵌入法结合了过滤法与包裹法的优点。将特征选择算法融入学习算法之中,为模型提供内置的特征选择。它既具备过滤法的速度,又兼有包裹法的准确性,并能考虑特征组合。
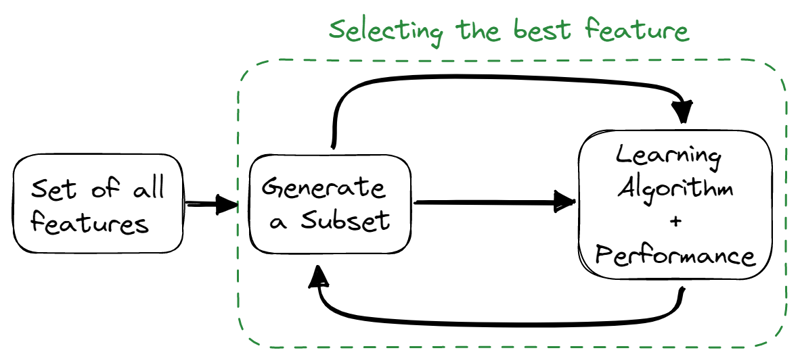
图片作者自制
常见技术包括:
- 正则化
- 基于树的方法
在我们的Python 特征选择教程中学习最常被考察的特征选择技术。
如何避免模型过拟合?
过拟合指模型在训练集上学习得过于充分,但在测试与验证集上表现欠佳。
避免过拟合的方法包括:
- 保持模型简单,降低复杂度、减少考虑的变量,并在神经网络中减少参数数量。
- 使用交叉验证技术。
- 用更多数据训练模型。
- 使用数据增强以增加样本量。
- 使用集成方法(Bagging 与 Boosting)。
- 采用正则化技术,对可能导致过拟合的参数进行惩罚。
欲了解防止过拟合的深入指南,请阅读什么是过拟合?以及我们的机器学习中的正则化教程。
列出 SQL 中不同类型的关系
SQL 关系主要有四种类型:
- 一对一:一张表中的每条记录仅关联另一张表中的一条记录。
- 一对多与多对一:最常见的关系,一张表中的每条记录关联到另一张表中的多条记录。
- 多对多:第一张表中的每条记录可关联第二张表中的多条记录,反之亦然。
- 自引用关系:一张表需要与自身建立关联。
通过完成我们的SQL 中的探索性数据分析课程,学习如何探索数据表、表间关系及其存储的数据。
什么是降维?它有哪些好处?
降维是将数据集从高维转换为低维,同时尽量保留相近信息的过程。
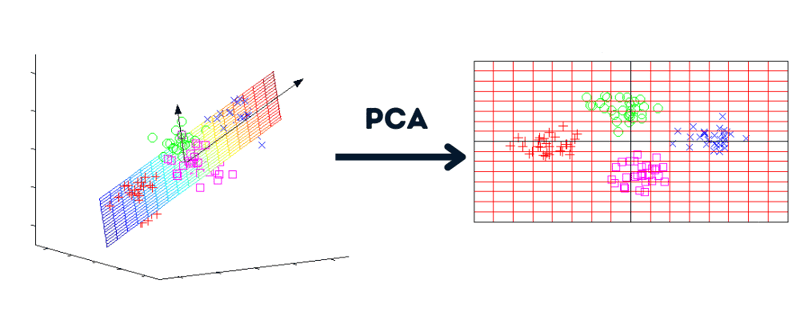
图片作者自制 | 图表来自 howecoresearch
降维的益处:
- 压缩数据,减少存储空间。
- 降低计算时间,加快数据处理。
- 消除冗余特征(若存在)。
通过练习我们的Python 降维课程,理解降维概念并掌握相关技术。
A/B 测试的目标是什么?
图片作者自制
A/B 测试消除拍脑袋决策,帮助我们做出数据驱动的优化产品或网站的决定。它也称为分流测试,通过随机化实验来分析两个或多个变量版本(网页、应用功能等),以确定哪个版本能带来最大流量与业务指标提升。
通过我们的Python 客户分析与 A/B 测试课程学习如何创建、运行与分析 A/B 测试。
数据科学编码面试问题
给定由多个词根组成的字典和一个句子,将句子中的词替换为生成它的词根。
词干提取在文本与情感分析中很常用。本题要求您编写一个 Python 函数,将列表中的特定词替换为其词根——Interview Query。
输入:
函数接收两个参数:词根列表和句子。
roots = ["cat", "bat", "rat"]
sentence = "the cattle was rattled by the battery"输出:
返回替换为词根后的句子。
"the cat was rat by the bat"在编写代码前,需明确两步:检查单词是否有词根并进行替换。
- 将句子拆分为单词。
- 外层循环遍历每个单词,内层循环遍历词根列表。
- 检查单词是否以该词根开头。Python 字符串提供
startswith()来完成此任务。 - 若单词以词根开头,使用列表索引用词根替换该单词。
- 将所有单词重新拼接为句子。
roots = ["cat", "bat", "rat"]
sentence = "the cattle was rattled by the battery"
def replace_words(roots, sentence):
words = sentence.split(" ")
# looping over each word
for index, word in enumerate(words):
# looping over each root
for root in roots:
# checking if words start with root
if word.startswith(root):
# replacing the word with its root
words[index] = root
return " ".join(words)
replace_words(roots, sentence)
# 'the cat was rat by the bat'检查字符串是否为回文
给定字符串 text,若其为回文返回 True,否则返回 False。
在将所有字母转为小写并移除所有非字母数字字符后,该词应正反读相同。
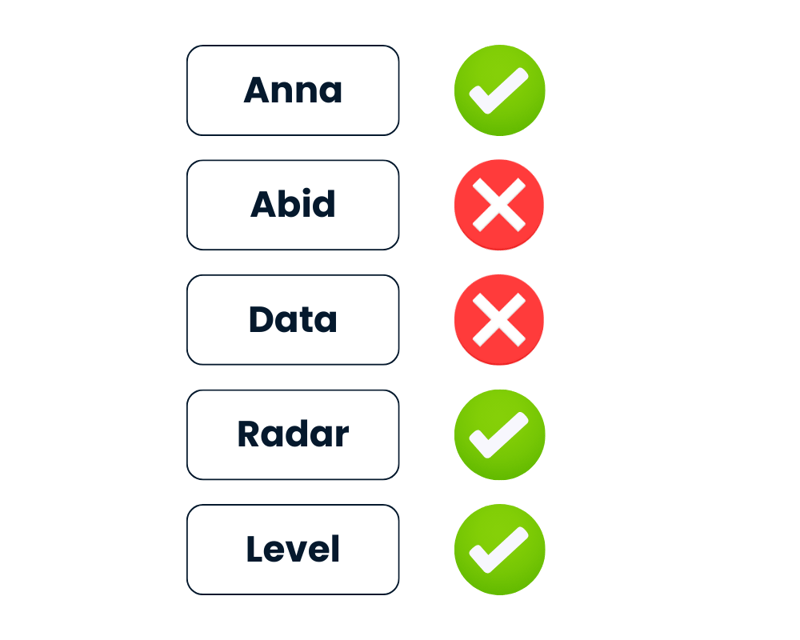
图片作者自制
Python 提供了简便方法解决该问题。您可以将字符串视为可迭代对象,并使用 text[::-1] 反转,或使用内置的 reversed(text) 方法。
- 先将文本转为小写。
- 使用正则去除非字母数字字符清洗文本。
- 使用
[::-1]反转文本。 - 将清洗后的文本与反转文本比较。
import re
def is_palindrome(text):
# lowering the string
text = text.lower()
# Cleaning the string
rx = re.compile('\W+')
text = rx.sub('',text).strip()
# Reversing and comparing the string
return text == text[::-1]第二种方法中,仅需用 ''.join(reversed(text)) 替换反转步骤,再与清洗后的文本比较。
两种方法都很直接。
def is_palindrome(text):
# lowering the string
text = text.lower()
# Cleaning the string
rx = re.compile('\W+')
text = rx.sub('',text).strip()
# Reversing the string
rev = ''.join(reversed(text))
return text == rev结果:
我们将单词列表传给 is_palindrome() 并打印结果。可以看到,即使包含特殊字符,函数也能识别 “Level” 和 “Radar” 为回文。
# Test cases
test_words = ['Anna', '**Radar****', 'Abid', '(Level)', 'Data']
for text in test_words:
print(f"Is {text} a palindrome? {is_palindrome(text)}")
# Is Anna a palindrome? True
# Is **Radar**** a palindrome? True
# Is Abid a palindrome? False
# Is (Level) a palindrome? True
# Is Data a palindrome? False通过我们的交互式课程练习 Python 编码面试题为下一次编码面试做好准备。若需更深入的 Python 编码准备,请参阅2026 年顶级 41 道 Python 面试题与答案。
查找第二高薪资
找最高和最低值很容易,但找第二高或第 n 高的值则更难。
题目给出包含 id 和 base_salary 的表。您需要编写 SQL 查询以找出第二高的薪资。
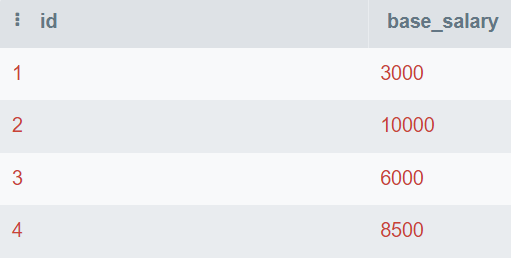
图片作者自制
在该查询中,先找出唯一值并按从高到低排序。然后使用 LIMIT 1 只显示最高值,最后通过将 OFFSET 设为 1 来显示第二高的数值。
您也可以调整 OFFSET 的值来获取第 n 高薪资。
SELECT DISTINCT base_salary AS "Second Highest Salary"
FROM employee
ORDER BY base_salary DESC
LIMIT 1
OFFSET 1;第二高的基础薪资是 8,500。
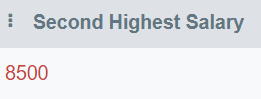
查找重复的邮箱
本题要求您写出查询,显示所有重复的邮箱。
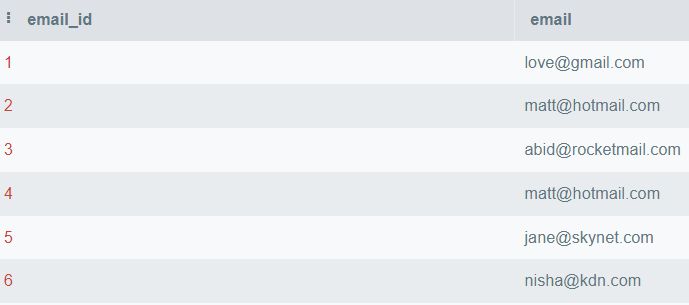
图片作者自制
在查询中,显示 email 列并按 email 分组。之后用 HAVING 子句找出出现次数超过一次的邮箱。
HAVING 与聚合一起使用,用于替代 WHERE。
SELECT email
FROM employee_email
GROUP BY email
HAVING COUNT(email) > 1;只有 “[email protected]” 出现超过一次。
通过将 SQL 应用于真实问题课程学习编写可维护的 SQL 代码来回答业务问题。
大型科技公司数据科学面试问题
Meta 数据科学面试题
Facebook 发帖工具(composer)的人均发帖占比从上月的 3% 降到今天的 2.5%。您会如何调查原因?
图片作者自制
相比一个月前从 3% 降至 2.5%。在下结论前,您需要先澄清问题背景。
您需要提出问题:
- 今天是否是工作日?
- 一个月前的今天是否是周末?
- 是否存在特殊节日、活动或季节性因素?
- 是逐步下滑的趋势,还是一次性波动?
第二部分,需要阐述导致下降的驱动因素。是用户数量变化,还是发帖数量减少?随后,面试官会让您基于其中一种或两种推理展开讨论。
您认为 Facebook 用户每日使用时长的分布是什么样的?用哪些度量来描述该分布?
就 Facebook 的每日使用时长分布而言,可假设存在两类人群:
- 快速刷信息流、停留时间较短的人。
- 在 Facebook 上花大量时间的重度用户。
第二部分,您需要用统计术语描述该分布,例如:
- 中心:均值、中位数、众数
- 离散程度:标准差、四分位距、极差
- 形状:偏度、峰度、单峰或双峰
- 异常值
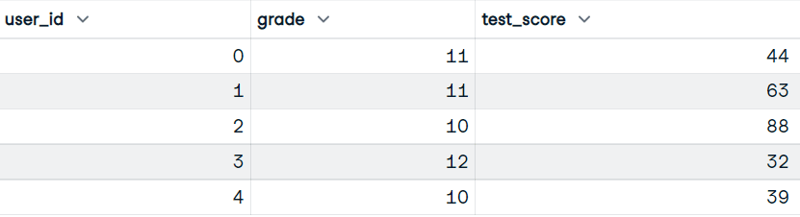
给定一组测试分数的数据集,编写 pandas 代码返回在 <50、<75、<90、<100 档位内的学生累计百分比。
本题要求您用 pandas 代码先将分数分桶,再计算各档位学生所占百分比。
输入:
数据集包含 user_id、grade 和 test_score 列。
图片作者自制
输出:
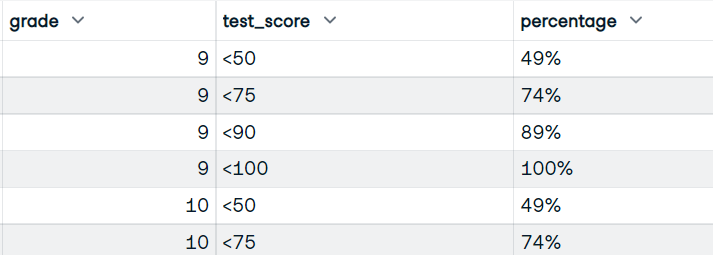
编写函数使用 grade 与 test_score 列,输出包含年级、分数档位和累计百分比的数据框。
图片作者自制
- 使用
pandas.cut()函数结合 bins 与 labels 将分数转换为分数档位。 - 按(grade,test_score)计算每组大小。
- 计算百分比所需的分子(累计和)与分母(总和)。
- 将分数转换为百分比:乘以 100 并加上 “%”。
- 重置索引并将列命名为 "percentage"。
def bucket_test_scores(df):
bins = [0, 50, 75, 90, 100]
labels = ["<50", "<75", "<90", "<100"]
# converting the scores into buckets
df["test_score"] = pd.cut(df["test_score"], bins, labels=labels, right=False)
# Calculate size of each group, by grade and test score
df = df.groupby(["grade", "test_score"]).size()
# Calculate numerator and denominator for percentage
NUM = df.groupby("grade").cumsum()
DEN = df.groupby("grade").sum()
# Calculate percentage, multiply by 100, and add %
percentage = (NUM / DEN).map(lambda x: f"{int(100*x):d}%")
# reset the index
percentage = percentage.reset_index(name="percentage")
return percentage
bucket_test_scores(df)您已得到包含分数档位与百分比的理想结果。
通过pandas 数据处理课程学习如何清洗数据、计算统计量并创建可视化。若需更深入内容,请参阅我们的2026 年顶级 35 道机器学习面试题指南。
Amazon 数据科学面试题
解释置信区间
置信区间是对未知参数的一组区间估计。当您重复实验或以相似方式重采样总体时,期望有一定百分比的次数该参数会落在该区间内。
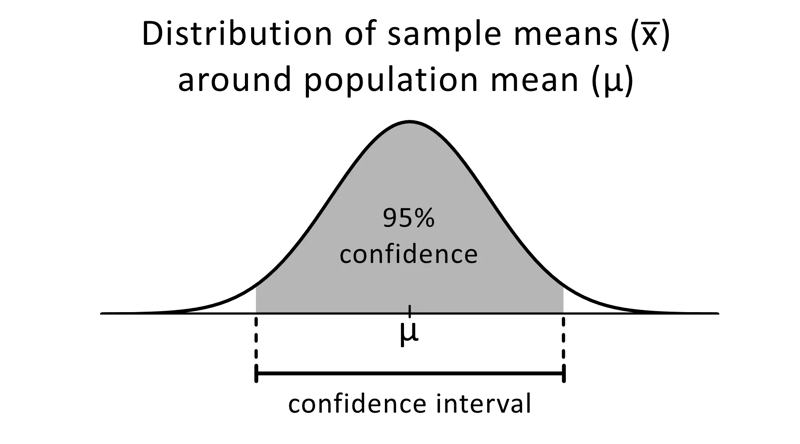
图片来源:omnicalculator
在统计实验中常用 95% 的置信水平,即您期望在该比例的重复实验中复现该参数估计。置信区间具有由 α 值设定的上下界。
您可以将置信区间用于多种统计估计,如比例、总体均值、总体均值或比例之差,以及各组间变异的估计。
通过完成我们的Python 的统计思维(第 1 部分)课程夯实统计基础。
如何处理不平衡数据集?
在不平衡数据集中,各类别分布不均。例如在欺诈检测数据集中,可能只有 400 条欺诈样本,而非欺诈样本有 300,000 条。不平衡数据会让模型在检测欺诈时表现较差。
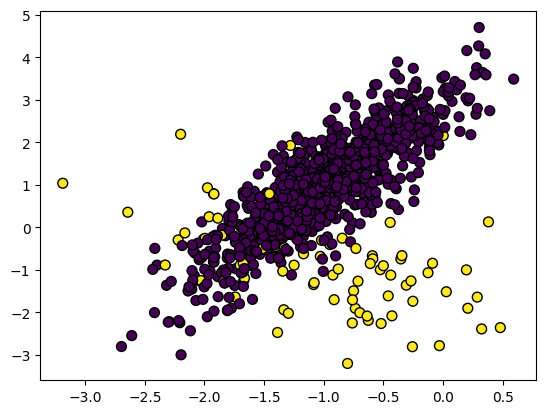
图片作者自制
处理不平衡数据,您可以使用:
- 欠采样
- 过采样
- 合成数据
- 过采样与欠采样结合
欠采样
对多数类进行重采样,使其数量与少数类相等。
在欺诈检测数据集中,两个类别都会被调整为 400 个样本。您可以使用 imblearn.under_sampling 便捷地重采样数据集。
from imblearn.under_sampling import RandomUnderSampler
RUS = RandomUnderSampler(random_state=1)
X_US, y_US = RUS.fit_resample(X_train, y_train)过采样
对少数类进行重采样,使其数量与多数类相等。常见方法包括重复或加权重复少数类特征。简言之,两个类别都会有 30 万个样本。
from imblearn.over_sampling import RandomOverSampler
ROS = RandomOverSampler(random_state=0)
X_OS, y_OS = ROS.fit_resample(X_train, y_train)合成数据
重复并不会带来额外信息,可能导致模型表现不佳。为此可使用 SMOTE(合成少数类过采样技术)来生成合成数据点。
from imblearn.over_sampling import SMOTE
SM = SMOTE(random_state=1)
X_OS, y_OS = SM.fit_resample(X_train, y_train)过采样与欠采样结合
为改进模型偏差与性能,可结合过采样与欠采样。我们将使用 SMOTE 进行过采样,并用 EEN(Edited Nearest Neighbours)进行清洗。
imblearn.combine 提供了多种函数,可自动执行两种采样。
from imblearn.combine import SMOTEENN
SMTN = SMOTEENN(random_state=0)
X_OUS, y_OUS = SMTN.fit_resample(X_train, y_train)写一个查询,返回 2022 年 3 月每个产品的销售总数。
作为数据科学家,您会编写类似的查询来抽取数据并进行分析。本题中,您可以使用带比较符的 WHERE 子句,或配合 BETWEEN 的 WHERE 子句进行过滤。
表:orders
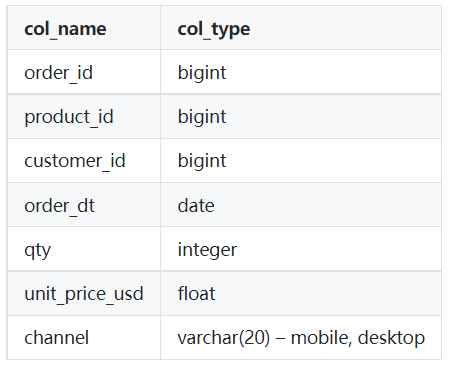
图片作者自制
示例输出:
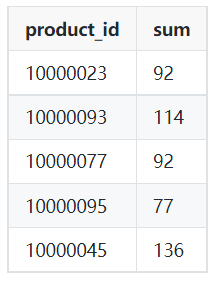
图片作者自制
- 从 orders 表中显示 product_id 并汇总数量。
- 使用 WHERE 与 AND 子句过滤日期在 ‘2022-03-01’ 到 '2022-04-01' 之间的数据。也可用 BETWEEN 实现类似操作。
- 按 product_id 分组,获取每个产品的销售总数。
SELECT product_id,
SUM(qty)
FROM orders
WHERE order_dt >= '2022-03-01'
AND order_dt < '2022-04-01'
GROUP BY product_id;Google 数据科学面试题
若在聚类项目中已知标签,您会如何评估模型性能?
在无监督学习中,评估聚类项目的性能并不容易。良好聚类的标准是组内相似、组间差异。
聚类模型没有“准确率”这样的度量,因此我们使用组间相异度或组内相似度来评估性能。
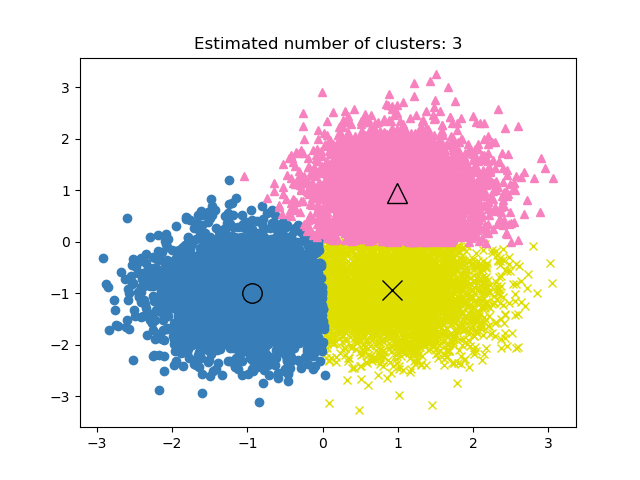
图片来源:scikit-learn 文档
三种常用指标为:
- 轮廓系数(Silhouette Score)
- Calinski-Harabasz 指数
- Davies-Bouldin 指数
轮廓系数
由平均簇内距离和最近簇间距离计算得到。
可用 scikit-learn 计算。轮廓系数介于 -1 到 1,值越高表示组间相似度越低、簇越分明。
from sklearn import metrics
model = KMeans().fit(X)
labels = model.labels_
metrics.silhouette_score(X, labels)Calinski-Harabasz 指数
基于类间离散度与类内离散度评估组间区分度。该指标无固定范围,类似轮廓系数,数值越大越好。
metrics.calinski_harabasz_score(X, labels)Davies-Bouldin 指数
计算每个簇与其最相似簇之间的平均相似度。与其他指标不同,数值越小越好,表示更好的聚类分离度。
metrics.davies_bouldin_score(X, labels)
通过我们的R 语言聚类分析课程学习如何应用层次聚类与 k-means 聚类。
一栋楼有四层,电梯里有四个人。每个人在不同楼层下电的概率是多少?
图片作者自制
我们将使用:
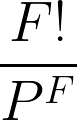
- F = 楼层数
- P = 人数
首先求每个人任意下电的总可能数:44 = 4x4x4x4 = 256 种。
再计算每个人都在不同楼层下电的种数:4! = 24。
所求概率为两者之比:
24/256 = 3/32
通过我们的R 概率谜题课程学习应对棘手概率问题的策略。
编写函数从正态分布生成 N 个样本并绘制直方图。
生成正态分布的 N 个样本,可用 Numpy 的 (np.random.randn(N)) 或 SciPy 的 (sp.stats.norm.rvs(size=N))。
绘制直方图可选择 Matplotlib 或 Seaborn。
- 使用 Numpy 的 randn 函数生成正态分布样本。
- 使用 Seaborn 绘制带 KDE 的直方图。
- 对 1 万个样本绘制直方图并返回 Numpy 数组。
import numpy as np
import seaborn as sns
N = 10_000
def norm_dist_hist(N):
# Generating Random normal distribution samples
x = np.random.randn(N)
# Plotting histogram
sns.histplot(x, bins = 20, kde=True);
return x
X = norm_dist_hist(N)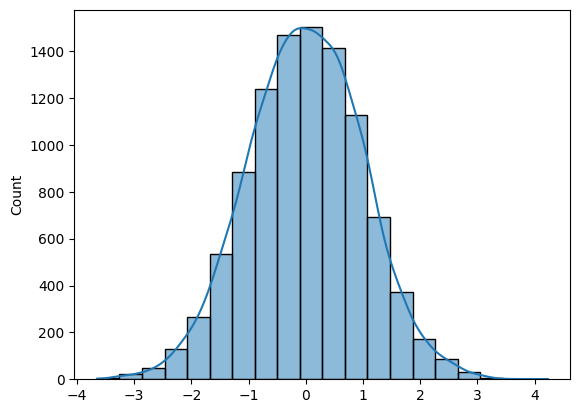
通过完成Seaborn 数据可视化入门课程,学习如何快速创建信息丰富、外观美观的可视化。
如何准备数据科学面试
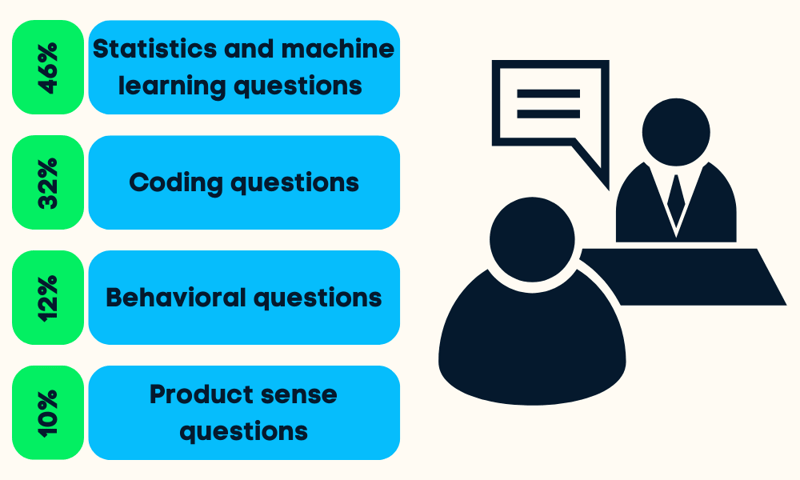
图片作者自制
数据科学面试通常分为四到五个阶段。您将被问到统计与机器学习、编码(Python、R、SQL)、行为面试、产品思维,有时还包括领导力问题。
您可以通过以下方式为各阶段做好准备:
- 研究公司与岗位职责:这将帮助您在某一数据科学领域(data science)优先投入精力。
- 回顾过往作品集项目:招聘经理会围绕您的项目提问以评估您的能力。
- 复习数据科学基础:概率、统计、假设检验、描述与贝叶斯统计、降维。速查表是快速掌握基础的最佳方式。
- 练习编码:参加测评、刷在线编程题、回顾高频编码问题。
- 实操端到端项目:通过数据清洗、处理、分析与可视化来打磨技能。
- 阅读常见面试问题:产品思维、统计、分析、行为与领导力问题。
- 进行模拟面试:与朋友演练,提升统计表达,增强自信。
阅读数据科学面试准备博文,了解面试期望与应对思路。
数据科学面试常见问答
数据科学的四大组成部分是什么?
数据科学的四大组成部分是:
- 业务理解与数据战略。
- 数据准备(清洗、插补、验证)。
- 数据分析与建模。
- 数据可视化与落地运营。
数据科学面试难吗?
通常是的。要通过数据科学面试,您需要在多个方面展现熟练度,如统计与概率、编码、数据分析、机器学习、产品思维与报告呈现。参阅我们的数据科学家面试问题指南助您备考!
数据科学是一份压力很大的工作吗?
视情况而定。您的团队或公司可能依赖您提供分析与可执行信息。有时您需要身兼多职,如数据工程师、数据分析师、机器学习工程师、MLOps 工程师、数据管理者与团队负责人。有些人觉得这既刺激又有挑战,也有人有时会感到压力或不堪重负。
一年时间足够学会数据科学吗?
也许可以,这取决于您的背景。如果您是软件工程师想转岗,一年内可以学会大部分内容。但如果从零开始,要在一年内具备就业准备会较难。以Python 数据科学家路径开启旅程,6 个月掌握所有基础。
数据科学对数学要求高吗?
是的。您需要学习统计、概率、数学、数据分析、数据可视化,以及构建与评估机器学习模型。
数据科学职业的薪资可观吗?
是的。根据 Glassdoor 数据,截至 2026 年,美国数据科学家的总薪资中位数约为每年 $130,000–$145,000,顶级科技公司的高级岗位远高于此。薪资会因公司、地区与经验年限而显著不同。更多关于职业发展与薪酬的信息,请参阅我们的2026 年如何成为数据科学家指南。