
进阶 dbt 面试题
在掌握基础问题后,下面是一些中级 dbt 问题,更侧重具体技术要点与概念。
dbt 中的 sources 是什么?
在 dbt 中,source 指原始数据表。我们不会直接对这些原始表写 SQL,而是指定架构与表名,将其定义为 source,便于在模型中引用数据对象。
想象在数据库中有一个位于 sales 架构下、名为 orders 的原始数据表。与其直接查询该表,不如在 dbt 中将其定义为 source:
在 sources.yml 文件中定义 source:
version: 2
sources:
- name: sales
tables:
- name: orders在 dbt 模型中使用该 source:
定义完成后,您可以在转换中这样引用原始 orders 表:
SELECT *
FROM {{ source('sales', 'orders') }}这种方式将原始表的定义抽象出来,便于集中管理。如果底层表结构发生变化,您只需在一个地方(source 定义处)更新,而不是修改每条查询。
在 dbt 中使用 sources 的好处:
- 组织性: 对原始数据进行组织,使其在项目中更易管理。
- 抽象化: 抽象架构细节,降低出错率并增强灵活性。
- 文档化: 为原始数据输入建立更完善的文档。
什么是 dbt 模型?
dbt 模型本质上是定义原始数据转换逻辑的 SQL 或 Python 文件。模型是编写转换(如聚合、关联或任意数据操作)的核心组件。
- SQL 模型 使用
SELECT语句定义转换,并以.sql文件保存。 - Python 模型 随dbt 对 Python 的支持引入,以
.py文件保存,允许使用 pandas 等库进行数据处理。
SQL 模型示例:
SQL 模型通过 SQL 查询对原始数据进行转换。例如,从 orders 表创建订单汇总:
--orders_summary.sql
WITH orders_cte AS (
SELECT
customer_id,
COUNT(order_id) AS total_orders,
SUM(order_amount) AS total_revenue
FROM {{ ref('orders') }}
GROUP BY customer_id
)
SELECT *
FROM orders_cte在此示例中:
orders_summary.sql模型为每位客户汇总订单数与营收。- 该模型引用了
orders表(已定义为 dbt 模型或 source)。
Python 模型示例:
Python 模型通过 Python 代码处理原始数据,适用于用 SQL 难以表达的复杂逻辑。
# orders_summary.py
import pandas as pd
def model(dbt, session):
# Load the source data
orders = dbt.ref("orders").to_pandas()
# Perform transformations using pandas
orders_summary = orders.groupby('customer_id').agg(
total_orders=('order_id', 'count'),
total_revenue=('order_amount', 'sum')
).reset_index()
return orders_summary在此示例中:
- Python 模型使用 pandas 按客户汇总订单数量与营收。
- 结果以 DataFrame 返回,dbt 会将其集成进管道。
如何创建一个 dbt 模型?
创建 dbt 模型的步骤:
- 在 dbt 项目的
models目录下创建子目录。 - 在该目录中新增后缀为
.sql的文本文件(若为 Python 模型则为.py)。 - 编写 SQL 查询或代码以转换原始数据。
- 执行
dbt run命令应用转换并创建模型。
dbt 如何处理模型之间的依赖?
dbt 使用 ref() 函数管理依赖关系,构建清晰的依赖链条。
定义转换时,不直接引用数据仓库中的表,而是通过 ref() 引用其他 dbt 模型。dbt 会据此识别依赖顺序,按正确次序构建模型。
例如,若 orders_summary 依赖 orders 模型,可如下定义:
WITH orders AS (
SELECT * FROM {{ ref('orders') }}
)
SELECT
customer_id,
COUNT(order_id) AS total_orders,
SUM(order_amount) AS total_revenue
FROM orders
GROUP BY customer_id在此示例中,{{ ref('orders') }} 确保 orders 模型先于 orders_summary 构建,因为 orders_summary 依赖 orders 模型中的数据。
dbt 中的宏(macro)是什么,如何运行?
dbt 宏是用 Jinja 模板引擎编写的可复用 SQL 代码块。宏可自动化重复任务、抽象复杂逻辑,并在多个模型间复用 SQL,从而提升项目效率与可维护性。
宏可在项目的 macros 目录下的 .sql 文件中定义。
当您需要在多个模型间执行相似转换,或根据环境编写特定逻辑(如不同架构名、按环境调整日期格式:开发、预发、生产)时,宏尤为有用。
创建宏的示例:
- 日期格式化宏: 可创建宏来统一日期格式,而无需重复添加日期格式逻辑,例如:
-- macros/date_format.sql
{% macro format_date(column) %}
FORMAT_TIMESTAMP('%Y-%m-%d', {{ column }})
{% endmacro %}在模型中的用法:
SELECT
customer_id,
{{ format_date('order_date') }} AS formatted_order_date
FROM {{ ref('orders') }}此示例中,format_date 宏用于统一任意模型里 order_date 列的格式。
- 自定义架构名宏: 根据环境(如开发或生产)动态切换架构名,便于无须手动改名即可管理多环境。
-- macros/custom_schema.sql
{% macro custom_schema_name() %}
{% if target.name == 'prod' %}
'production_schema'
{% else %}
'dev_schema'
{% endif %}
{% endmacro %}在模型中的用法:
SELECT *
FROM {{ custom_schema_name() }}.orders这里宏会检查环境(target.name)是否为 "prod",并返回对应的架构名。
如何运行宏:
宏不会像 SQL 模型一样直接运行。它们通过在模型或其他宏中被引用,并在运行 dbt 项目时一同执行。例如,当您在模型中使用宏时,执行 dbt run 时宏会随之执行。
- 在模型内调用宏: 当您在 SQL 模型内包含宏时,它会在模型运行时被执行。
- 手动运行宏:也可用
dbt run-operation手动调用某些宏,通常用于一次性任务,如投放种子数据或执行维护操作。
dbt 中的两类测试是什么?
dbt 中有两类测试:单独测试(Singular)与通用测试(Generic)。
- 单独测试(Singular) 聚焦模型中的特定条件。若条件不满足,将返回相应行。
示例: 假设要确保没有订单的 order_amount 为负数,您可以在 tests 目录下编写如下单独测试:
-- tests/no_negative_order_amount.sql
SELECT *
FROM {{ ref('orders') }}
WHERE order_amount < 0若此测试失败,dbt 会返回 orders 表中所有 order_amount 为负的行。
- 通用测试(Generic) 是可接受参数的预定义测试,进一步可分为以下类型:
|
通用测试 |
定义 |
|
Unique(唯一) |
检查列中的值是否唯一。 |
|
Not null(非空) |
检查是否存在空值字段。 |
|
Available values(可选值) |
验证列值是否匹配预期值列表,以保持标准化。 |
|
Relationships(关系) |
检查表间的参照完整性,消除不一致数据。 |
示例: 在 schema.yml 中轻松为 customers 表的 customer_id 添加唯一与非空测试:
version: 2
models:
- name: customers
columns:
- name: customer_id
tests:
- unique
- not_null在此示例中:
- unique 测试检查
customers表中每个customer_id是否唯一。 - not_null 测试检查是否存在缺失或空的
customer_id。
高级 dbt 面试题
继续深入时,您会遇到更复杂的场景与高级概念。以下是一些更具挑战的问题,帮助评估您的熟练程度并为高级数据工程岗位做准备。
如何在 dbt 中构建增量模型,何时使用?
dbt 的增量模型用于只处理新增或变更的数据,而非每次都重算整套数据。在处理大型数据集时尤为有用,因为从零重建成本高且耗时。
增量模型通常基于某个条件(典型是时间戳如 updated_at)来仅追加新数据或更新变更数据。
创建增量模型的方法:
1. 在模型配置中指定为增量:
{{ config(
materialized='incremental',
unique_key='id' -- or another unique column
) }}2. 使用 is_incremental() 过滤新增或变更行:
SELECT *
FROM source_table
{% if is_incremental() %}
WHERE updated_at > (SELECT MAX(updated_at) FROM {{ this }})
{% endif %}3. 首次运行会处理所有数据;后续仅处理 updated_at 大于当前模型中最大值的行。
何时使用增量模型:
- 大规模数据集:当表有上百万/上亿行,每次重建效率低下。
- 频繁更新:仓库频繁接收新数据或更新,但无需重算全量数据。
- 流式数据:数据持续流入或定期更新时,增量模型可在无需全量重跑的情况下保持最新。
如何使用 Jinja 改进 SQL 代码?
Jinja 让 SQL 更具灵活性。我们可为常见 SQL 模式定义可复用模板;随着需求变化,可用 Jinja 的 if 语句按条件调整查询。这样可拆分复杂逻辑,提升可读性。
例如,若要将日期从 "YYYY-MM-DD" 转为 "MM/DD/YYYY",可使用之前示例中的 dbt 宏:
{% macro change_date_format(column_name) %}
to_char({{ column_name }}::date, 'MM/DD/YYYY')
{% endmacro %}在此代码中,{{ column_name }} 是 Jinja 在使用宏时插入实际列名的位置。运行时会被替换。Jinja 使用 {{ }} 指示替换发生的位置。
如何在 dbt 中创建自定义物化(materialization)?
创建自定义物化的步骤如下:
- 创建自定义物化的 SQL 文件。
- 定义物化宏为
materialization_name:
{% materialization materialization_name, default -%}- 使用 dbt 的预定义宏
adapter.get_relation设置目标表(数据将加载到此)。 - 定义并执行创建与加载目标表数据的 SQL 命令:
{% set sql %}
SELECT * FROM {{ ref('your_source_table') }}
WHERE your_conditions = true
{% endset %}
{{ adapter.execute(sql) }}- 最后返回目标 relation,以更新 dbt 缓存并优化查询执行。
{{ return(target_relation) }}
{% endmaterialization %}如何调试 dbt 模型?请说两种方法。
两种常用调试方式:
1. 查看 target 文件夹中的已编译 SQL 文件以定位错误。
运行 dbt 项目时,dbt 会将含 Jinja 模板的模型编译为原生 SQL,并保存在 target 目录。这些编译后的 SQL 正是 dbt 在数据平台上实际执行的查询,检查这些文件可帮助定位问题:
- 运行模型(如
dbt run或dbt test)。 - 进入项目目录的
target/compiled/文件夹。 - 打开要调试模型的已编译 SQL 文件,里面包含 dbt 实际执行的原生 SQL(含宏与引用的展开)。
- 复制该 SQL 到数据平台(如 Postgres、BigQuery)的查询编辑器中直接运行,以获得更详细的报错或观察实际行为。
2. 使用 VS Code 的 dbt Power User 扩展 在 IDE 内直接查看查询结果。
VS Code 的 dbt Power User 扩展是调试 dbt 模型的利器。它允许您在 IDE 中直接审查与测试查询,减少在 dbt、终端与数据库之间的切换。
dbt 如何编译查询?
dbt 的查询编译流程如下:
- 解析(Parsing):读取项目中的所有 SQL 文件、YAML 配置与宏。
- 上下文创建(Context creation):为每个模型构建上下文(包含配置与可用宏)。
- Jinja 渲染:将 SQL 文件作为 Jinja 模板处理,替换标签与表达式为求值结果。
- SQL 编译:为每个模型生成纯 SQL 查询。
- 产物生成(Artifact generation): 将编译后的 SQL 保存在
target/compiled目录。 - 执行准备: 对于
dbt run,会进一步准备可执行查询(可能包含额外包装)。
该流程把模块化、模板化的 SQL 转换为针对您数据仓库的可执行查询。我们可以用 dbt compile 或查看 target/compiled 目录来审查并调试最终 SQL。
数据仓库与集成类 dbt 面试题
多数数据工程师的工作都围绕用 dbt 构建与集成数据仓库展开。相关问题在面试中很常见——因此我汇总了最常被问到的内容:
说明将 dbt 与 Airflow 集成的三大优势。
将 dbt 与 Airflow 集成有助于构建流畅的数据管道,优势包括:
- ETL 流程: Airflow 管理抽取与加载,让 dbt 专注转换步骤,整体工作流更顺畅。
- dbt 任务自动化: Airflow 自动调度与执行 dbt 模型,减少人工干预并提升转换效率。
- 并行任务执行: Airflow 支持任务并行运行,便于处理大型数据集且不牺牲性能,保持数据管道快速稳定。
dbt 的语义层架构是什么?
dbt 的语义层帮助我们把原始数据转化为业务可理解的语言。我们还能定义度量并通过命令行界面(CLI)进行查询。
这能优化成本,因为数据准备耗时更少。此外,组织内各方都使用一致的数据定义,使度量在全公司范围内保持一致性。
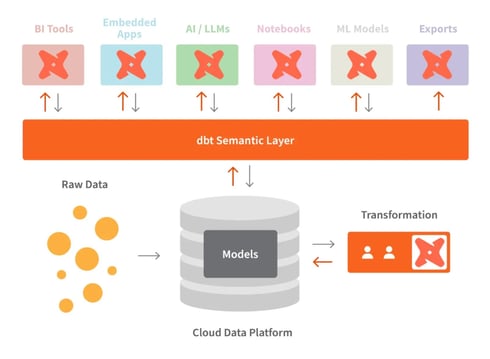
dbt 与语义层。图片来源:dbt
如果在使用 BigQuery,dbt 是否是多余的数据转换层?
尽管 BigQuery 功能强大,能原生处理许多转换,但 dbt 仍然有必要,原因包括:
- dbt 支持对转换进行版本控制,而 BigQuery 原生并不支持。
- dbt 提供内置测试框架与文档生成,提升数据质量与可理解性。
- dbt 的
ref()与宏让 SQL 更模块化、可复用。 - dbt 让在 BigQuery 中管理多环境(开发、测试、生产)更容易。
- dbt 提供一致的方式来管理转换之间的依赖关系。
dbt 是否提供数据安全?
正如前文所述,dbt 分为 dbt Core 与 dbt Cloud。dbt Core 是开源免费版本,不提供内置安全功能,部署与安全由用户自行负责。
而 dbt Cloud 致力于提供完整的安全保障,遵循 HIPAA 等常见合规框架,保障隐私不受侵害。应根据自身需求选择符合业务合规要求的版本。
如何优化大型数据集上的 dbt 转换性能?
在 Snowflake、BigQuery 或 Redshift 等云数仓中,优化 dbt 转换对提升性能、降低成本至关重要。关键技术包括:
1. 使用增量模型
增量模型只处理新增或更新数据,避免每次重算全量数据,显著缩短运行时间。
2. 利用分区与聚簇(适用于 Snowflake、BigQuery 等)
对大型表进行分区与聚簇有助于优化查询性能,通过高效组织数据,减少扫描量。
分区可确保仅查询相关数据片段;聚簇优化数据的物理布局以加速检索。
3. 优化物化方式(table、view、incremental)
按需选择物化方式以优化性能:
- View 适合轻量转换,不适合重负载。
- Table 将数据物化存储,性能更好但占用更多存储。
- Incremental 最适合定期更新的大型数据集。
4. 开发阶段使用 LIMIT
在开发调试时添加 LIMIT 限制处理行数,加快迭代,避免在测试阶段处理海量数据。
5. 并行运行查询
利用数仓的并行执行能力。例如,dbt Cloud 支持并行度设置,可根据基础设施调整。
6. 使用特定数据库的优化特性
许多云数仓提供性能优化特性:
- BigQuery:使用物化视图或分区表。
- Snowflake:启用自动聚簇与多集群仓库并行执行。
如何优化 Snowflake 上的 dbt 运行?
优化思路包括:
1. 使用表聚簇:
{{ config(
cluster_by = ["date_column", "category_column"]
) }}
SELECT ...2. 利用多集群仓库并行执行模型:
models:
my_project:
materialized: table
snowflake_warehouse: transforming_wh3. 按需使用增量模型:
{{ config(materialized='incremental', unique_key='id') }}
SELECT *
FROM source_table
{% if is_incremental() %}
WHERE updated_at > (SELECT MAX(updated_at) FROM {{ this }})
{% endif %}这些做法通常能提升 Snowflake 上 dbt 运行的性能与性价比。
行为与问题解决类 dbt 面试题
在面试尾声,面试官通常会考察您的问题解决能力,询问您在真实情境下的应对方式。
请记住这段关于岗位软技能的引言,来自 Azurelib Academy 的 CEO 与创始人 Deepak Goyal,他在 DataFramed 播客中曾这样说:
作为数据工程师,您必须具备沟通能力。数据工程师需要与众多相关方沟通,了解他们期望得到何种输出或结果。
以下是一些行为与问题解决类问题:
如何在多环境(开发、预发、生产)中管理 dbt 部署?
可按如下方式管理跨环境的 dbt 部署:
1. 环境特定配置
可在 dbt_project.yml 中为开发、预发、生产分别定义配置,如 schema、database 与数仓设置。
示例( dbt_project.yml):
models:
my_project:
dev:
schema: dev_schema
staging:
schema: staging_schema
prod:
schema: prod_schema运行项目时,dbt 会基于目标环境(开发、预发或生产)自动选择正确的 schema。
2. 使用 target 变量
target 变量用于指明当前所处环境。您可在模型或宏中引用该变量以按环境定制行为。
模型示例:
{% if target.name == 'prod' %}
SELECT * FROM production_table
{% else %}
SELECT * FROM {{ ref('staging_table') }}
{% endif %}该逻辑可根据环境使用不同的表或 schema。
3. 分支与版本控制
每个环境都应有对应的版本分支(如 Git)。开发者在 dev 分支工作,测试与分析在 staging,获批后才合并至 prod。
4. 持续集成(CI)与持续部署(CD)
生产环境中,应有自动化部署流水线在上线前运行测试与校验。在 dbt Cloud 中可设置按环境运行的作业计划;在 dbt Core 中可通过 GitHub Actions 或 Jenkins 等 CI/CD 工具实现。
在多成员协作时,如何在 dbt 中进行版本控制?
团队协作时,版本控制至关重要。我的做法如下:
1. 使用 Git 进行版本控制
我们以 Git 作为 dbt 项目的主要版本控制工具。每位成员在自己的分支上开发变更或功能,实现隔离开发,避免相互冲突。
示例:我在开发新模型时会创建分支 feature/customer_order_transformation。
2. 分支策略
我们遵循如下策略:
dev分支用于持续开发与测试。staging分支用于上线前准备。main或prod分支用于生产。
成员将变更推送至 dev 分支并发起 PR 进行代码评审;评审通过后合入 staging 做进一步测试,最终发布到 production。
3. 持续集成(CI)
我们集成了 CI(如 GitHub Actions、CircleCI),对每个 PR 自动运行 dbt 测试,确保新代码通过必要校验后再合并至主分支。
CI 会运行 dbt run 构建模型与 dbt test 校验数据,检查错误或不一致。
4. 解决合并冲突
当多人修改同一模型或文件时可能发生冲突。我会先检查冲突标记并决定保留哪些变更:
- 若两方变更均有效,我会合并为新的版本。
- 若仅一方正确,则保留正确修改,放弃另一方。
解决冲突后,我会在本地运行测试确保未引入新问题,再将变更推回分支。
5. 文档与协作
我们确保每次合并或 PR 都附带相应变更说明,并更新 dbt 自动生成的文档,使团队成员清晰了解新增或更新的模型。
如何在现有数据管道中落地 dbt?
我的实施步骤:
- 评估现有管道: 找出低效之处与可由 dbt 改进的转换环节。
- 搭建 dbt: 安装 dbt、创建项目并配置与数仓的连接。
- 迁移转换逻辑: 将现有 SQL 或转换逻辑迁移为 dbt 模型,确保模块化与清晰性。
- 添加测试与文档: 使用 dbt 内置测试与文档确保数据质量与透明度。
- 集成编排: 使用现有工具(如 Airflow 或 Prefect)调度 dbt 运行。
- 小步快跑: 先在管道的子集上实践 dbt,经验证后再扩展。
- 监控与优化: 持续监控性能并按需优化模型。
若某个 dbt 模型因 "relation does not exist" 报错,您如何排查?
出现 "relation does not exist" 通常说明模型引用的表/模型尚未创建或拼写错误。我的排查步骤:
- 检查拼写: 确认
ref()中的表或模型名拼写正确,并核对确实引用了正确对象。
SELECT * FROM {{ ref('orders') }} -- Ensure 'orders' is the correct model name- 验证依赖关系:查看 dbt DAG,确保上游模型在当前模型运行前已成功构建。
- 使用调试模式:运行
dbt debug,查看日志了解 dbt 的尝试与失败原因。 - 检查权限:确认 dbt 对所引用的表或模型在数据仓库中有足够访问权限。
- 单独运行模型:尝试单独运行依赖模型(如
dbt run --models orders),确保其存在且已正确构建。
dbt 面试准备技巧
dbt 是一个不断完善的新框架,边学旧内容边追新进展可能令人不知所措。建议采取平衡策略,从核心功能入手;掌握后再探索新增内容,理解发生了哪些变化。
我理解面试会让人紧张,尤其是围绕 dbt 这样专门化的工具。但别担心——这里有一些建议,助您准备充分、从容应对:
掌握 dbt 功能
务必熟悉 dbt 的基本概念:模型、测试、文档及其协作方式。扎实的基础能帮助您在技术交流中应对自如。
DataCamp 有一门非常合适的课程:Introduction to dbt
DataCamp 还提供一系列针对初学者的课程,深入覆盖其他数据工程主题:
- 数据工程基础:Understanding Data Engineering
- 数据库设计:Database Design
- 数据仓库基础:Data Warehousing Concepts
- Snowflake 基础:Introduction to Snowflake
- 数据架构:Understanding Modern Data Architecture
- 用 Python 学 ETL 与 ELT:ETL and ELT in Python
动手实践 dbt
纸上得来终觉浅,动手最见功。动手实践是掌握 dbt 的高效方式。您可以在网上找到大量原始数据集进行转换与测试;搭建自己的 dbt 项目,尝试不同功能,这将显著提升您在面试中谈论 dbt 的自信。
准备真实案例
面试官喜欢听实际应用。回想您是否用 dbt 解决过某个问题,或在假设场景下会如何使用?准备几个可分享的实例。您也可以在 dbt 官网上查阅多个案例研究,或从 Git 上的公共 dbt 项目获取灵感。
结语
本文覆盖了从基础到高级的 dbt 面试题,助您在求职路上更进一步。理解如何将 dbt 与云数据仓库集成,能让您具备更高级的数据转换技能——这正是任何数据集成流程的核心。
不过,学习 dbt 与 SQL 是相辅相成的。如果您刚接触 SQL,不妨看看 DataCamp 的 SQL 课程。
FAQs
学习 dbt 需要多长时间?
完全掌握 dbt 可能需要几个月时间。但如果您每天投入几小时,也能较快地上手学习。
如何自学 dbt?
您可以利用线上资源学习,如 DataCamp 课程、YouTube 教程与博文。此外,尝试通过重写现有项目来构建自己的项目,这将强化您的实操能力。
dbt 会取代数据工程师吗?
不会。dbt 不会取代数据工程师的角色,相反它能助力他们的工作。工程师可用该框架自动化诸如转换与测试等任务。

我是内容策略专家,热衷于将复杂主题化繁为简。我曾帮助 Splunk、Hackernoon 和 Tiiny Host 等公司为其受众打造兼具吸引力与信息量的内容。
dbt(data build tool)已成为现代数据工程与分析工作流中广泛使用的开发框架。过去,数据分析师大多依赖数据工程师用 SQL 编写转换脚本。有了 dbt,分析师也能自行编写转换并对数据拥有更大掌控。此外,它还能与 Git 等流行的版本控制系统集成,提升团队协作。
如果您正在准备数据仓库相关岗位(如数据工程师、数据分析师或数据科学家),您应当熟悉 dbt 的基础与进阶问题!
本文梳理了最常被问到的面试问题,帮助您夯实基础概念并提升高阶问题解决能力。
什么是 dbt?
dbt 是一个开源的数据转换框架,允许您在同一平台中完成数据转换、准确性测试与变更追踪。与其他 ETL(抽取、转换、加载)工具不同,dbt 仅负责转换(即 T)。
其他一些ETL 工具会从多种来源抽取数据、在仓库外完成转换、再加载回去,这通常需要专业编码知识与额外工具。而 dbt 简化了这一过程——它支持在数据仓库内、仅用 SQL 完成转换。
超过40,000 家大型公司使用 dbt 来简化数据流程——因此招聘方将其列为数据相关岗位最重要的技能之一。即便您是初学者,只要掌握它,也可能带来诸多职业机会!
dbt 语义层。图片来源: dbt
基础 dbt 面试题
面试一开始,面试官通常会考察您的基础知识,可能会问到如下奠基性问题:
dbt 的常见用途是什么?
dbt 让数据团队在同一平台上完成数据转换、文档撰写与测试,确保数据可靠、易于理解。常见用途包括:
dbt 是一门编程语言吗?
不是。dbt 不是编程语言,它是帮助在数据仓库中执行数据转换作业的工具。会写 SQL,便可轻松使用 dbt。它也开始在特定任务上支持 Python,但其核心仍是管理并运行基于 SQL 的转换。
dbt 与 Spark 有何比较?
dbt 与 Spark 面向的目的与工作流类型不同。以下是它们在数据基础设施中的角色对比:
特性
dbt
Spark
角色
基于 SQL 的数据转换与建模
分布式数据处理与分析
核心语言
以 SQL 为先,有限的 Python 支持
支持 SQL、Python、Scala、Java、R
数据治理
支持文档与血缘追踪
提供访问控制、审计与数据血缘
目标用户
SQL 用户、分析师与缺乏工程技能的团队
数据工程师、数据科学家、开发者
转换复杂度
仅专注于 SQL 转换与建模
也可用其他语言处理复杂转换
测试与校验
内置测试能力
需要自定义测试策略(单元与集成)
dbt 面临哪些挑战?
尽管 dbt 为数据团队带来巨大价值,但在规模与复杂度上升时也会出现挑战。常见问题包括:
了解如何规避上述潜在挑战是雇主非常看重的能力,因此不要忽视此类问题的重要性。
dbt Core 与 dbt Cloud 有何区别?
dbt 有两个主要版本:
dbt Core 是免费的开源版本,允许用户在本地编写、运行与管理基于 SQL 的转换。它提供命令行界面(CLI)来执行 dbt 项目、测试模型与构建数据管道。由于是开源版本,dbt Core 需要用户自行负责部署、编排与基础设施搭建,通常会与如 Airflow 或 Kubernetes 等工具集成以实现自动化。
dbt Cloud 则是由 dbt 的创建者(Fishtown Analytics)提供的托管服务。它包含 dbt Core 的全部能力,并额外提供基于 Web 的界面、集成的调度与作业管理、协作工具。dbt Cloud 还内置CI/CD(持续集成与持续部署)功能、API 访问,以及 SOC 2 与 HIPAA 等更严格的安全合规支持,满足高安全需求的组织。