
इंटरमीडिएट dbt इंटरव्यू प्रश्न
अब जब हमने बेसिक dbt प्रश्न देख लिए हैं, यहाँ कुछ इंटरमीडिएट-लेवल dbt प्रश्न हैं। ये विशिष्ट तकनीकी पहलुओं और कॉन्सेप्ट्स पर केंद्रित हैं।
dbt में sources क्या हैं?
dbt में sources कच्ची डेटा टेबल्स होती हैं। हम उन कच्ची टेबल्स पर सीधे SQL क्वेरी नहीं लिखते — हम स्कीमा और टेबल नाम निर्दिष्ट करते हैं और उन्हें sources के रूप में परिभाषित करते हैं। इससे टेबल्स में डेटा ऑब्जेक्ट्स का संदर्भ देना आसान होता है।
मान लें आपके डेटाबेस में sales स्कीमा में orders नाम की एक रॉ डेटा टेबल है। इसे सीधे क्वेरी करने के बजाय, आप इसे dbt में इस तरह source के रूप में परिभाषित करेंगे:
अपने sources.yml फाइल में source परिभाषित करें:
version: 2
sources:
- name: sales
tables:
- name: ordersअपने dbt मॉडलों में source का उपयोग करें:
एक बार परिभाषित करने के बाद, आप अपनी ट्रांसफॉर्मेशन में रॉ orders टेबल का इस तरह संदर्भ दे सकते हैं:
SELECT *
FROM {{ source('sales', 'orders') }}यह दृष्टिकोण रॉ टेबल डिफिनिशन को एब्स्ट्रैक्ट करता है, जिससे प्रबंधन आसान हो जाता है और यदि अंतर्निहित टेबल संरचना बदलती है, तो आप हर क्वेरी के बजाय एक ही जगह (source डेफिनिशन) में अपडेट कर सकते हैं।
dbt में sources के उपयोग के लाभ:
- संगठन: sources आपके रॉ डेटा को सुव्यवस्थित करते हैं और प्रोजेक्ट के भीतर प्रबंधन आसान बनाते हैं।
- एब्स्ट्रैक्शन: आप स्कीमा विवरण को एब्स्ट्रैक्ट करते हैं, जिससे त्रुटियाँ घटती हैं और लचीलेपन में वृद्धि होती है।
- डॉक्यूमेंटेशन: sources परिभाषित करने से आपके रॉ डेटा इनपुट्स के लिए बेहतर डॉक्यूमेंटेशन बनता है।
dbt मॉडल क्या है?
dbt मॉडल मूलतः एक SQL या Python फाइल होती है जो रॉ डेटा के लिए ट्रांसफॉर्मेशन लॉजिक परिभाषित करती है। dbt में, मॉडल्स वह कोर कम्पोनेंट हैं जहाँ आप अपने ट्रांसफॉर्मेशन लिखते हैं, चाहे वे एग्रीगेशन हों, जॉइन्स हों, या किसी भी प्रकार का डेटा मैनिपुलेशन।
- SQL मॉडल्स dbt में ट्रांसफॉर्मेशन परिभाषित करने के लिए
SELECTस्टेटमेंट्स का उपयोग करते हैं और इन्हें.sqlफाइल के रूप में सेव किया जाता है। - Python मॉडल्स, dbt के Python सपोर्ट के साथ पेश किए गए,
.pyफाइल के रूप में सेव किए जाते हैं और आपको pandas जैसी Python लाइब्रेरियों का उपयोग कर डेटा मैनिपुलेट करने देते हैं।
SQL मॉडल उदाहरण:
एक SQL मॉडल SQL क्वेरीज़ का उपयोग करके रॉ डेटा को ट्रांसफॉर्म करता है। उदाहरण के लिए, orders टेबल से ऑर्डर्स का सारांश बनाने के लिए:
--orders_summary.sql
WITH orders_cte AS (
SELECT
customer_id,
COUNT(order_id) AS total_orders,
SUM(order_amount) AS total_revenue
FROM {{ ref('orders') }}
GROUP BY customer_id
)
SELECT *
FROM orders_cteइस उदाहरण में:
- यह
orders_summary.sqlमॉडल प्रत्येक ग्राहक के लिए कुल ऑर्डर्स और राजस्व का सारांश बनाता है। - मॉडल
ordersटेबल का संदर्भ देता है (जिसे पहले से dbt मॉडल या source के रूप में परिभाषित किया गया है)।
Python मॉडल उदाहरण:
एक Python मॉडल Python कोड का उपयोग करके रॉ डेटा को मैनिपुलेट करता है। यह विशेष रूप से उस जटिल लॉजिक के लिए सहायक हो सकता है जो SQL में बोझिल लगे।
# orders_summary.py
import pandas as pd
def model(dbt, session):
# Load the source data
orders = dbt.ref("orders").to_pandas()
# Perform transformations using pandas
orders_summary = orders.groupby('customer_id').agg(
total_orders=('order_id', 'count'),
total_revenue=('order_amount', 'sum')
).reset_index()
return orders_summaryइस उदाहरण में:
- Python मॉडल pandas का उपयोग करके डेटा को ट्रांसफॉर्म करता है, ग्राहकों के अनुसार ऑर्डर्स को ग्रुप करता है और कुल ऑर्डर्स व राजस्व की गणना करता है।
- इसके बाद परिणाम एक DataFrame के रूप में रिटर्न किया जाता है, जिसे dbt अपनी पाइपलाइन में एकीकृत कर सकता है।
आप dbt मॉडल कैसे बनाएंगे?
dbt मॉडल इस तरह बनाएं:
modelsफ़ोल्डर के अंतर्गत प्रोजेक्ट में एक डायरेक्टरी बनाएं।- डायरेक्टरी में
.sqlएक्सटेंशन वाली एक नई टेक्स्ट फाइल जोड़ें (या यदि यह Python मॉडल है तो.pyजोड़ें)। - अब, रॉ डेटा को ट्रांसफॉर्म करने के लिए SQL क्वेरी या कोड लिखें।
dbt runकमांड निष्पादित करें ताकि ट्रांसफॉर्मेशन लागू हो और मॉडल बन जाए।
dbt मॉडल्स के बीच डिपेंडेंसी को dbt कैसे संभालता है?
dbt मॉडल डिपेंडेंसी को ref() फ़ंक्शन के जरिए मैनेज करता है, जो मॉडलों के बीच स्पष्ट डिपेंडेंसी चेन बनाता है।
जब आप dbt में ट्रांसफॉर्मेशन परिभाषित करते हैं, तो वेयरहाउस में टेबल्स का सीधे संदर्भ देने के बजाय, आप ref() फ़ंक्शन के जरिए अन्य dbt मॉडल्स का संदर्भ देते हैं। यह सुनिश्चित करता है कि dbt मॉडलों का निर्माण सही क्रम में करे, यह पहचान कर कि कौन से मॉडल अन्य पर निर्भर हैं।
उदाहरण के लिए, यदि आपके पास orders_summary नाम का मॉडल है जो orders मॉडल पर निर्भर है, तो आप इसे इस तरह परिभाषित करेंगे:
WITH orders AS (
SELECT * FROM {{ ref('orders') }}
)
SELECT
customer_id,
COUNT(order_id) AS total_orders,
SUM(order_amount) AS total_revenue
FROM orders
GROUP BY customer_idइस उदाहरण में, {{ ref('orders') }} फ़ंक्शन यह सुनिश्चित करता है कि orders मॉडल orders_summary से पहले बने, क्योंकि orders_summary में orders मॉडल के डेटा पर निर्भरता है।
dbt में मैक्रोज़ क्या हैं, और आप उन्हें कैसे चलाते हैं?
dbt में मैक्रोज़ Jinja टेम्पलेटिंग इंजन का उपयोग करके लिखे गए पुन: प्रयोज्य SQL कोड ब्लॉक होते हैं। ये दोहरावदार कार्यों को स्वचालित करने, जटिल लॉजिक को एब्स्ट्रैक्ट करने और कई मॉडलों में SQL कोड को पुन: उपयोग करने की अनुमति देते हैं, जिससे आपका dbt प्रोजेक्ट अधिक कुशल और मेन्टेनेबल बनता है।
मैक्रोज़ को आपके dbt प्रोजेक्ट की macros डायरेक्टरी के भीतर .sql फाइलों में परिभाषित किया जा सकता है।
जब आपको कई मॉडलों में समान ट्रांसफॉर्मेशन करने की आवश्यकता हो या वातावरण-विशिष्ट लॉजिक चाहिए — जैसे विभिन्न स्कीमा का उपयोग करना या डिप्लॉयमेंट एनवायरनमेंट (जैसे, डेवलपमेंट, स्टेजिंग, या प्रोडक्शन) के आधार पर दिनांक प्रारूप बदलना — तब मैक्रोज़ विशेष रूप से उपयोगी होते हैं।
मैक्रोज़ बनाने का उदाहरण:
- डेट फॉर्मेटिंग मैक्रो: आप मॉडलों में डेट फॉर्मेटिंग को मानकीकृत करने के लिए एक मैक्रो बना सकते हैं। डेट फॉर्मेट लॉजिक दोहराने के बजाय, आप इस तरह मैक्रो बना सकते हैं:
-- macros/date_format.sql
{% macro format_date(column) %}
FORMAT_TIMESTAMP('%Y-%m-%d', {{ column }})
{% endmacro %}मॉडल में उपयोग:
SELECT
customer_id,
{{ format_date('order_date') }} AS formatted_order_date
FROM {{ ref('orders') }}इस उदाहरण में, format_date मैक्रो का उपयोग किसी भी मॉडल में order_date कॉलम के फॉर्मेट को मानकीकृत करने के लिए किया जाता है।
- कस्टम स्कीमा नाम मैक्रो: यह मैक्रो वातावरण (जैसे, डेवलपमेंट या प्रोडक्शन) के आधार पर स्कीमा नामों को डायनेमिक रूप से बदलता है। इससे बिना मैनुअल बदलाव के एनवायरनमेंट्स को मैनेज करना आसान होता है।
-- macros/custom_schema.sql
{% macro custom_schema_name() %}
{% if target.name == 'prod' %}
'production_schema'
{% else %}
'dev_schema'
{% endif %}
{% endmacro %}मॉडल में उपयोग:
SELECT *
FROM {{ custom_schema_name() }}.ordersयहां मैक्रो चेक करता है कि एनवायरनमेंट (target.name) "prod" है या नहीं, और उसी के अनुसार सही स्कीमा नाम रिटर्न करता है।
मैक्रोज़ कैसे चलाएँ:
मैक्रोज़ सीधे SQL मॉडलों की तरह नहीं चलते। इन्हें आपके मॉडलों या अन्य मैक्रोज़ में रेफरेंस किया जाता है और जब dbt प्रोजेक्ट चलता है तब निष्पादित होते हैं। उदाहरण के लिए, यदि आप किसी मॉडल में मैक्रो का उपयोग करते हैं, तो वह dbt run कमांड चलाने पर निष्पादित होगा।
- मॉडल के अंदर मैक्रो कॉल करना: जब आप SQL मॉडल में मैक्रो शामिल करते हैं, तो वह मॉडल रन के दौरान निष्पादित होता है।
- मैक्रोज़ को मैन्युअली चलाना: आप कुछ मैक्रोज़ को
dbt run-operationकमांड से मैन्युअली भी चला सकते हैं। यह आमतौर पर एकमुश्त कार्यों, जैसे डेटा सीडिंग या मेंटेनेंस ऑपरेशंस, के लिए उपयोग होता है।
dbt में टेस्ट के दो प्रकार कौन से हैं?
dbt में दो प्रकार के टेस्ट होते हैं: Singular टेस्ट और Generic टेस्ट:
- Singular टेस्ट किसी dbt मॉडल में विशिष्ट शर्तों पर फोकस करते हैं। यदि टेस्ट शर्त असफल होती है, तो यह संबंधित पंक्तियाँ लौटाता है।
उदाहरण: मान लें आप सुनिश्चित करना चाहते हैं कि किसी भी ऑर्डर का order_amount नकारात्मक न हो। आप tests डायरेक्टरी में इस प्रकार singular टेस्ट लिख सकते हैं:
-- tests/no_negative_order_amount.sql
SELECT *
FROM {{ ref('orders') }}
WHERE order_amount < 0यदि यह टेस्ट असफल होता है, तो dbt orders टेबल की वे सभी पंक्तियाँ लौटाएगा जहाँ order_amount नकारात्मक है।
- Generic टेस्ट पूर्वनिर्धारित टेस्ट होते हैं जो आर्ग्युमेंट लेते हैं। इन्हें आगे निम्न प्रकारों में बाँटा जाता है:
|
Generic टेस्ट |
परिभाषा |
|
Unique |
कॉलम में मानों की विशिष्टता जाँचता है। |
|
Not null |
खाली फ़ील्ड की जाँच करता है। |
|
Available values |
मानकीकरण बनाए रखने के लिए जाँचता है कि कॉलम मान अपेक्षित मानों की सूची से मेल खाते हैं। |
|
Relationships |
टेबल्स के बीच रेफरेंशियल इंटेग्रिटी की जाँच करता है ताकि असंगत डेटा हटाया जा सके। |
उदाहरण: आप schema.yml फाइल में परिभाषित करके आसानी से यह सुनिश्चित कर सकते हैं कि customers टेबल में customer_id यूनिक और not null हो:
version: 2
models:
- name: customers
columns:
- name: customer_id
tests:
- unique
- not_nullइस उदाहरण में:
- unique टेस्ट जाँचता है कि
customersटेबल में हरcustomer_idयूनिक हो। - not_null टेस्ट जाँचता है कि कोई भी
customer_idमान गायब या null न हो।
एडवांस्ड dbt इंटरव्यू प्रश्न
जैसे-जैसे आप आगे बढ़ते हैं, आपको अधिक जटिल परिदृश्य और उन्नत कॉन्सेप्ट्स मिल सकते हैं। इसलिए यहाँ कुछ चुनौतीपूर्ण इंटरव्यू प्रश्न दिए गए हैं, जो आपकी विशेषज्ञता को परखने और सीनियर-लेवल डेटा इंजीनियरिंग पदों की तैयारी में मदद करेंगे।
आप dbt में इन्क्रीमेंटल मॉडल्स कैसे बनाते हैं, और उन्हें कब उपयोग करेंगे?
dbt में इन्क्रीमेंटल मॉडल्स का उपयोग हर बार पूरे डेटासेट को दोबारा प्रोसेस करने के बजाय केवल नए या बदले हुए डेटा को प्रोसेस करने के लिए किया जाता है। यह विशेष रूप से बड़े डेटासेट्स के साथ उपयोगी है, जहाँ हर बार पूरा मॉडल खरोंच से बनाना समय और संसाधन-भक्षी होगा।
इन्क्रीमेंटल मॉडल dbt को किसी शर्त के आधार पर केवल नया डेटा जोड़ने (या बदला हुआ डेटा अपडेट करने) की अनुमति देता है, जो आमतौर पर किसी टाइमस्टैम्प कॉलम (जैसे updated_at) पर आधारित होता है।
इन्क्रीमेंटल मॉडल कैसे बनाएं:
1. मॉडल की कॉन्फ़िग में इसे इन्क्रीमेंटल के रूप में परिभाषित करें:
{{ config(
materialized='incremental',
unique_key='id' -- or another unique column
) }}2. नए या बदले हुए रो फ़िल्टर करने के लिए is_incremental() फ़ंक्शन का उपयोग करें:
SELECT *
FROM source_table
{% if is_incremental() %}
WHERE updated_at > (SELECT MAX(updated_at) FROM {{ this }})
{% endif %}3. जब dbt पहली बार यह मॉडल चलाएगा, तो यह सारा डेटा प्रोसेस करेगा। बाद के रन में, यह केवल वे पंक्तियाँ प्रोसेस करेगा जहाँ updated_at वर्तमान मॉडल में मौजूद नवीनतम मान से बड़ा है।
इन्क्रीमेंटल मॉडल कब उपयोग करें:
- बड़े डेटासेट्स: जब आपके पास लाखों या अरबों पंक्तियों वाली बड़ी टेबल हो, हर रन में पूरी टेबल का पुनर्निर्माण अक्षम होगा।
- बार-बार अपडेट: यदि आपके वेयरहाउस में बार-बार अपडेट या नया डेटा आता है, पर पूरा डेटासेट दोबारा प्रोसेस करने की ज़रूरत नहीं है, तो इन्क्रीमेंटल मॉडल समय काफी घटा सकते हैं।
- स्ट्रीमिंग डेटा: जहाँ डेटा नियमित रूप से स्ट्रीम होता है या अपडेट होता है, वहाँ इन्क्रीमेंटल मॉडल बिना सबकुछ फिर से चलाए ट्रांसफॉर्मेशन को अप-टू-डेट रखते हैं।
आप Jinja का उपयोग करके अपने SQL कोड में कैसे सुधार करते हैं?
Jinja हमारे SQL कोड को अधिक लचीला बनाता है। Jinja के साथ, हम सामान्य SQL पैटर्न्स के लिए पुन: प्रयोज्य टेम्पलेट्स परिभाषित कर सकते हैं। और चूंकि आवश्यकताएँ बदलती रहती हैं, हम Jinja के if स्टेटमेंट्स का उपयोग कर शर्तों के अनुसार SQL क्वेरीज़ समायोजित कर सकते हैं। ऐसा करने से जटिल लॉजिक को विभाजित कर कोड अधिक समझने योग्य हो जाता है।
उदाहरण के लिए, यदि आप दिनांक प्रारूप को "YYYY-MM-DD" से "MM/DD/YYYY" में बदलना चाहते हैं, तो इसके लिए एक सैंपल dbt मैक्रो, जिसे हमने पहले भी देखा था:
{% macro change_date_format(column_name) %}
to_char({{ column_name }}::date, 'MM/DD/YYYY')
{% endmacro %}इस कोड उदाहरण में, {{ column_name }} वह स्थान है जहाँ मैक्रो का उपयोग करते समय Jinja वास्तविक कॉलम नाम डालता है। यह रनटाइम पर वास्तविक कॉलम नाम से बदल दिया जाएगा। जैसा कि हमने पिछले उदाहरणों में देखा, Jinja प्रतिस्थापन होने के स्थान को दिखाने के लिए {{ }} का उपयोग करता है।
आप dbt में कस्टम मैटेरियलाइज़ेशन कैसे बनाएंगे?
dbt में कस्टम मैटेरियलाइज़ेशन इस तरह बनाएं:
- कस्टम मैटेरियलाइज़ेशन के लिए SQL फाइल बनाएं।
- इसके बाद,
materialization_nameके रूप में एक मैटेरियलाइज़ेशन मैक्रो परिभाषित करें:
{% materialization materialization_name, default -%}- टारगेट टेबल सेट करने के लिए dbt के प्री-डिफाइंड मैक्रो
adapter.get_relationका उपयोग करें। यहीं डेटा लोड होगा। - अब, टेबल बनाने और उनमें डेटा लोड करने के लिए SQL कमांड्स परिभाषित करें और निष्पादित करें:
{% set sql %}
SELECT * FROM {{ ref('your_source_table') }}
WHERE your_conditions = true
{% endset %}
{{ adapter.execute(sql) }}- अंत में, dbt के कैश को अपडेट करने और क्वेरी निष्पादन को अनुकूलित करने के लिए टारगेट रिलेशन रिटर्न करें।
{{ return(target_relation) }}
{% endmaterialization %}आप अपने dbt मॉडलों को कैसे डिबग करेंगे? दो तरीकों के बारे में बताइए।
यहाँ हमारे dbt मॉडलों को डिबग करने के दो तरीके हैं:
1. त्रुटियों की पहचान और ट्रैक करने के लिए target फ़ोल्डर में compiled SQL फाइलें एक्सेस करें।
जब आप कोई dbt प्रोजेक्ट चलाते हैं, dbt आपके मॉडलों (जो Jinja टेम्पलेटिंग का उपयोग करके लिखे गए हैं) को रॉ SQL क्वेरीज़ में कम्पाइल करता है और उन्हें target डायरेक्टरी में सेव करता है। यह कम्पाइल्ड SQL वही है जिसे dbt आपके डेटा प्लेटफॉर्म पर चलाता है, इसलिए इन फाइलों की समीक्षा करने से आप पहचान सकते हैं कि समस्याएँ कहाँ हो रही हैं:
- अपने dbt मॉडल्स चलाएँ (जैसे
dbt runयाdbt test)। target/compiled/फ़ोल्डर पर जाएँ।- जिस मॉडल को आप डिबग कर रहे हैं, उसकी कम्पाइल्ड SQL फाइल खोलें। इसमें dbt द्वारा निष्पादित रॉ SQL होगा, जिसमें सभी Jinja मैक्रोज़ और रेफरेंसेज़ से हुए ट्रांसफॉर्मेशन शामिल होंगे।
- कम्पाइल्ड SQL क्वेरी कॉपी करें और उसे अपने डेटा प्लेटफॉर्म के SQL एडिटर (जैसे Postgres, BigQuery) में सीधे चलाएँ, ताकि विस्तृत एरर मैसेज मिलें या क्वेरी का वास्तविक व्यवहार दिखे।
2. VS Code के लिए dbt Power User एक्सटेंशन का उपयोग कर सीधे क्वेरी परिणाम देखें।
Visual Studio Code (VS Code) के लिए dbt Power User एक्सटेंशन dbt मॉडलों को डिबग करने का एक सहायक टूल है। यह एक्सटेंशन आपको अपने IDE में ही क्वेरी की समीक्षा और परीक्षण करने देता है, जिससे dbt, टर्मिनल और डेटाबेस के बीच स्विच करने की आवश्यकता घटती है।
dbt क्वेरीज़ को कैसे कम्पाइल करता है?
dbt निम्न चरणों के माध्यम से क्वेरीज़ कम्पाइल करता है:
- Parsing: dbt प्रोजेक्ट में सभी SQL फाइलें, YAML कॉन्फ़िग्स और मैक्रोज़ पढ़ता है।
- Context creation: यह प्रत्येक मॉडल के लिए संदर्भ बनाता है, जिसमें कॉन्फ़िग्स और उपलब्ध मैक्रोज़ शामिल होते हैं।
- Jinja rendering: इसके बाद यह SQL फाइलों को Jinja टेम्पलेट्स के रूप में प्रोसेस करता है और टैग/एक्सप्रेशंस को इवैल्युएटेड परिणामों से बदलता है।
- SQL compilation: प्रत्येक मॉडल के लिए शुद्ध SQL क्वेरीज़ जनरेट होती हैं।
- आर्टिफैक्ट जेनरेशन: कम्पाइल्ड SQL
target/compiledडायरेक्टरी में सेव होता है। - एक्जीक्यूशन की तैयारी:
dbt runके लिए क्वेरीज़ निष्पादन हेतु तैयार की जाती हैं, संभवतः अतिरिक्त रैपिंग के साथ।
यह प्रक्रिया मॉड्यूलर, टेम्पलेटेड SQL को आपके डेटा वेयरहाउस-विशिष्ट निष्पादन योग्य क्वेरीज़ में बदल देती है। हम dbt compile चला सकते हैं या target/compiled डायरेक्टरी देखकर प्रत्येक मॉडल के फाइनल SQL की जाँच और डिबग कर सकते हैं।
डेटा वेयरहाउसिंग और इंटीग्रेशन-आधारित dbt इंटरव्यू प्रश्न
अधिकांश डेटा इंजीनियरों का काम dbt के साथ डेटा वेयरहाउस बनाना और इंटीग्रेट करना होता है। इन परिदृश्यों से जुड़े प्रश्न इंटरव्यू में बहुत आम हैं — इसलिए मैंने सबसे सामान्य प्रश्नों को संकलित किया है:
Airflow के साथ dbt को एकीकृत करने के तीन फायदे समझाइए।
Airflow के साथ dbt को एकीकृत करने से सुव्यवस्थित डेटा पाइपलाइन बनती है। इसके कुछ फायदे हैं:
- ETL प्रक्रिया: Airflow डेटा के एक्सट्रैक्शन और लोडिंग को मैनेज करता है, जिससे dbt ट्रांसफॉर्मेशन स्टेप पर फोकस कर सकता है और समग्र वर्कफ़्लो स्मूद होता है।
- dbt कार्यों का स्वचालन: Airflow dbt मॉडलों के शेड्यूलिंग और निष्पादन को स्वचालित करता है, मैनुअल हस्तक्षेप घटाता है और डेटा ट्रांसफॉर्मेशन की दक्षता बढ़ाता है।
- समांतर कार्य निष्पादन: Airflow कार्यों को समानांतर में चलाने की अनुमति देता है, जिससे बड़े डेटासेट्स को परफॉर्मेंस से समझौता किए बिना प्रोसेस किया जा सकता है और तेज़, विश्वसनीय पाइपलाइंस बनी रहती हैं।
dbt की सेमांटिक लेयर आर्किटेक्चर क्या है?
dbt का सेमांटिक लेयर हमें रॉ डेटा को उस भाषा में अनुवाद करने देता है जिसे हम समझते हैं। हम मैट्रिक्स परिभाषित कर सकते हैं और उन्हें कमांड लाइन इंटरफेस (CLI) से क्वेरी कर सकते हैं।
इससे लागत का अनुकूलन संभव होता है क्योंकि डेटा तैयारी में कम समय लगता है। इसके अलावा, सभी लोग समान डेटा परिभाषाओं के साथ काम करते हैं क्योंकि यह पूरे संगठन में मैट्रिक्स को सुसंगत बनाता है।
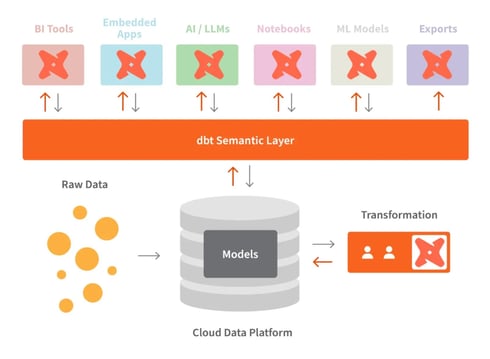
dbt और सेमांटिक लेयर। इमेज स्रोत: dbt
यदि आप BigQuery का उपयोग कर रहे हैं, तो क्या dbt एक अनावश्यक डेटा ट्रांसफॉर्मेशन लेयर है?
हालाँकि BigQuery काफी सहायक है और कई ट्रांसफॉर्मेशन नैटिवली संभाल सकता है, फिर भी dbt आवश्यक हो सकता है। कारण:
- dbt आपको ट्रांसफॉर्मेशन का वर्ज़न कंट्रोल करने देता है, जो BigQuery में नैटिव रूप से समर्थित नहीं है।
- dbt बिल्ट-इन टेस्टिंग फ्रेमवर्क और डॉक्यूमेंटेशन जेनरेशन देता है, जिससे डेटा गुणवत्ता और समझ बढ़ती है।
- dbt का
ref()फ़ंक्शन और मैक्रोज़ अधिक मॉड्यूलर और पुन: प्रयोज्य SQL कोड की अनुमति देते हैं। - dbt BigQuery में कई एनवायरनमेंट्स (dev, test, prod) का प्रबंधन आसान बनाता है।
- dbt ट्रांसफॉर्मेशन के बीच डिपेंडेंसी मैनेज करने का एक सुसंगत तरीका प्रदान करता है।
क्या dbt डेटा सुरक्षा प्रदान करता है?
जैसा कि पहले बताया गया, dbt दो संस्करणों में आता है: dbt Core और dbt Cloud। dbt Core ओपन सोर्स और मुफ्त संस्करण है। इसलिए यह कोई बिल्ट-इन सुरक्षा सुविधा प्रदान नहीं करता, और इसका डिप्लॉयमेंट व सुरक्षा उपयोगकर्ता की जिम्मेदारी होती है।
हालाँकि, dbt Cloud को पूर्ण सुरक्षा प्रदान करने के लिए डिज़ाइन किया गया है। यह HIPAA और अन्य सामान्य फ्रेमवर्क्स के अनुरूप है ताकि गोपनीयता से समझौता न हो। इसलिए, अपनी आवश्यकताओं के अनुसार हमें ऐसा dbt संस्करण चुनना चाहिए जो हमारे व्यवसायिक अनुपालन की जरूरतों के अनुकूल हो।
बड़े डेटासेट्स पर dbt ट्रांसफॉर्मेशन के प्रदर्शन को आप कैसे अनुकूलित करेंगे?
क्लाउड-आधारित डेटा वेयरहाउस जैसे Snowflake, BigQuery, या Redshift के साथ काम करते समय परफॉर्मेंस सुधारने और लागत घटाने के लिए dbt ट्रांसफॉर्मेशन का अनुकूलन महत्वपूर्ण है। कुछ प्रमुख तकनीकें:
1. इन्क्रीमेंटल मॉडल्स का उपयोग करें
इन्क्रीमेंटल मॉडल्स dbt को हर बार पूरे डेटासेट को प्रोसेस करने के बजाय केवल नया या अपडेटेड डेटा प्रोसेस करने देते हैं। इससे बड़े डेटासेट्स पर रन टाइम काफी घटता है। यह प्रक्रिया प्रोसेस होने वाले डेटा की मात्रा सीमित करती है और ट्रांसफॉर्मेशन समय तेज़ करती है।
2. पार्टिशनिंग और क्लस्टरिंग का लाभ लें (Snowflake और BigQuery जैसे डेटाबेस के लिए)
Snowflake या BigQuery जैसे डेटाबेस में बड़ी टेबल्स को पार्टिशन और क्लस्टर करने से डेटा को कुशलता से व्यवस्थित कर क्वेरी परफॉर्मेंस बेहतर होती है और क्वेरी के दौरान स्कैन हुए डेटा की मात्रा घटती है।
पार्टिशनिंग सुनिश्चित करती है कि केवल प्रासंगिक हिस्सों को क्वेरी किया जाए, जबकि क्लस्टरिंग डेटा के भौतिक लेआउट को तेज़ पुनर्प्राप्ति के लिए अनुकूलित करती है।
3. मैटेरियलाइज़ेशन का अनुकूलन करें (table, view, incremental)
प्रदर्शन अनुकूलन के लिए उपयुक्त मैटेरियलाइज़ेशन चुनें:
- Views हल्के ट्रांसफॉर्मेशन के लिए उपयोगी हैं, लेकिन भारी वर्कलोड के लिए आदर्श नहीं।
- Tables डेटा को भौतिक रूप से स्टोर करती हैं, प्रदर्शन बेहतर होता है पर स्टोरेज अधिक लगता है।
- Incremental मॉडल्स उन बड़े डेटासेट्स के लिए सर्वोत्तम हैं जिनमें नियमित अपडेट आते हैं।
4. डेवलपमेंट के दौरान LIMIT का उपयोग करें
डेवलपमेंट के समय क्वेरीज़ में LIMIT जोड़ना प्रोसेस होने वाली पंक्तियों की संख्या घटाने में सहायक है। इससे डेवलपमेंट साइकिल तेज़ होता है और टेस्टिंग के दौरान बड़े डेटासेट्स पर काम करने से बचाव होता है।
5. क्वेरीज़ को समानांतर चलाएँ
अपने डेटा वेयरहाउस की समानांतर क्वेरी निष्पादन क्षमता का लाभ लें। उदाहरण के लिए, dbt Cloud में पैरेललिज़्म सपोर्ट है, जिसे आपके इन्फ्रास्ट्रक्चर के अनुसार समायोजित किया जा सकता है।
6. डेटाबेस-विशिष्ट अनुकूलन सुविधाओं का उपयोग करें
कई क्लाउड डेटा वेयरहाउस परफॉर्मेंस अनुकूलन सुविधाएँ प्रदान करते हैं, जैसे:
- BigQuery: मैटेरियलाइज़्ड व्यूज़ या पार्टिशन्ड टेबल्स का उपयोग।
- Snowflake: ऑटो-क्लस्टरिंग सक्षम करें और समानांतर निष्पादन के लिए वेयरहाउस स्केलिंग।
आप Snowflake में dbt रन कैसे अनुकूलित करेंगे?
Snowflake में dbt रन को अनुकूलित करने के लिए:
1. टेबल क्लस्टरिंग का उपयोग करें:
{{ config(
cluster_by = ["date_column", "category_column"]
) }}
SELECT ...2. समांतर मॉडल निष्पादन के लिए Snowflake के मल्टी-क्लस्टर वेयरहाउस का लाभ लें:
models:
my_project:
materialized: table
snowflake_warehouse: transforming_wh3. उपयुक्त स्थानों पर इन्क्रीमेंटल मॉडल्स का उपयोग करें:
{{ config(materialized='incremental', unique_key='id') }}
SELECT *
FROM source_table
{% if is_incremental() %}
WHERE updated_at > (SELECT MAX(updated_at) FROM {{ this }})
{% endif %}ये अनुकूलन Snowflake में dbt रन के प्रदर्शन और लागत-प्रभावशीलता में सुधार ला सकते हैं।
व्यवहारिक और समस्या-समाधान आधारित dbt इंटरव्यू प्रश्न
इंटरव्यू प्रक्रिया के अंत में, इंटरव्यूअर आमतौर पर आपके समस्या-समाधान कौशल की जाँच करते हैं। वे आपसे ऐसे प्रश्न पूछ सकते हैं ताकि पता चले कि आप वास्तविक जीवन की समस्याओं पर कैसे प्रतिक्रिया देंगे।
इस उद्धरण को याद रखें — जो इस भूमिका के लिए आवश्यक सॉफ्ट स्किल्स से संबंधित है — जब Deepak Goyal, CEO & Founder, Azurelib Academy, ने DataFramed पॉडकास्ट पर बात की:
एक डेटा इंजीनियर के रूप में, आपको संवाद करने में सक्षम होना चाहिए। डेटा इंजीनियर को बहुत से स्टेकहोल्डर्स से बात करनी होती है ताकि वे समझ सकें कि वे किस तरह का आउटपुट या परिणाम चाहते हैं।
यहाँ कुछ व्यवहारिक और समस्या-समाधान से जुड़े प्रश्न हैं:
आप dbt डिप्लॉयमेंट को कई एनवायरनमेंट्स (dev, staging, production) में कैसे मैनेज करेंगे?
आप dbt डिप्लॉयमेंट को एनवायरनमेंट्स में इस तरह मैनेज कर सकते हैं:
1. एनवायरनमेंट-विशिष्ट कॉन्फ़िगरेशन
dbt आपको dbt_project.yml फाइल में प्रत्येक एनवायरनमेंट (dev, staging, production) के लिए अलग कॉन्फ़िगरेशन परिभाषित करने देता है। आप स्कीमा, डेटाबेस और वेयरहाउस कॉन्फ़िगरेशन जैसी सेटिंग्स अलग-अलग तय कर सकते हैं।
उदाहरण dbt_project.yml में:
models:
my_project:
dev:
schema: dev_schema
staging:
schema: staging_schema
prod:
schema: prod_schemaइस उदाहरण में, प्रोजेक्ट चलाते समय dbt टारगेट एनवायरनमेंट (dev, staging, या prod) के आधार पर सही स्कीमा स्वयं चुन लेता है।
2. target वेरिएबल का उपयोग
dbt में target वेरिएबल का उपयोग यह परिभाषित करने के लिए होता है कि आप किस एनवायरनमेंट (dev, staging, production) में काम कर रहे हैं। आप इस वेरिएबल को अपने मॉडल्स या मैक्रोज़ में रेफरेंस कर एनवायरनमेंट-आधारित व्यवहार कस्टमाइज़ कर सकते हैं।
मॉडल में उदाहरण:
{% if target.name == 'prod' %}
SELECT * FROM production_table
{% else %}
SELECT * FROM {{ ref('staging_table') }}
{% endif %}यह लॉजिक सुनिश्चित करता है कि एनवायरनमेंट के अनुसार अलग टेबल्स या स्कीमा उपयोग हों।
3. ब्रांचिंग और वर्शन कंट्रोल
प्रत्येक एनवायरनमेंट के लिए वर्शन कंट्रोल (जैसे, Git) में अलग ब्रांच होनी चाहिए। डेवलपर्स dev ब्रांच पर काम करते हैं, टेस्टर्स और विश्लेषक staging का उपयोग करते हैं, और केवल अनुमोदित बदलाव prod ब्रांच में मर्ज होते हैं।
4. Continuous Integration (CI) और Continuous Deployment (CD)
प्रोडक्शन में, यह महत्वपूर्ण है कि डिप्लॉयमेंट पाइपलाइन स्वचालित हो, जो डिप्लॉयमेंट से पहले टेस्ट और वैलिडेशन चलाए। dbt Cloud में, आप एनवायरनमेंट के आधार पर विशिष्ट कार्य चलाने हेतु जॉब शेड्यूल सेट कर सकते हैं। dbt Core के लिए, यह GitHub Actions या Jenkins जैसे CI/CD टूल्स के माध्यम से किया जा सकता है।
कई टीम सदस्यों के साथ काम करते समय आप dbt में वर्शन कंट्रोल कैसे संभालते हैं?
dbt प्रोजेक्ट्स पर काम करते समय वर्शन कंट्रोल आवश्यक है, खासकर जब कई लोग एक ही कोडबेस में योगदान दे रहे हों। मैं dbt में वर्शन कंट्रोल इस तरह संभालता/संभालती हूँ:
1. वर्शन कंट्रोल के लिए Git का उपयोग
हम अपने dbt प्रोजेक्ट्स में वर्शन कंट्रोल के लिए Git को प्राथमिक टूल के रूप में उपयोग करते हैं। प्रत्येक टीम सदस्य अपने बदलावों या फीचर्स के लिए अलग ब्रांच पर काम करता/करती है। इससे आइसोलेटेड डेवलपमेंट होता है और समानांतर कार्यों के दौरान कॉन्फ्लिक्ट्स से बचाव होता है।
उदाहरण: नए dbt मॉडल पर काम करते समय मैं feature/customer_order_transformation जैसा फीचर ब्रांच बनाता/बनाती हूँ।
2. ब्रांचिंग रणनीति
हम Git ब्रांचिंग रणनीति अपनाते हैं जहाँ:
devब्रांच चल रहे डेवलपमेंट और टेस्टिंग के लिए होती है।stagingब्रांच प्रोडक्शन के लिए बदलाव तैयार करने हेतु होती है।mainयाprodब्रांच प्रोडक्शन एनवायरनमेंट के लिए आरक्षित रहती है।
टीम सदस्य अपने बदलाव dev ब्रांच में पुश करते हैं और कोड रिव्यू के लिए पुल रिक्वेस्ट (PRs) खोलते हैं। बदलावों के रिव्यू और अनुमोदन के बाद, उन्हें आगे टेस्टिंग के लिए staging में मर्ज किया जाता है और फिर production में प्रमोट किया जाता है।
3. Continuous integration (CI)
हमने CI पाइपलाइन (जैसे, GitHub Actions, CircleCI) इंटीग्रेट की है जो हर पुल रिक्वेस्ट पर स्वतः dbt टेस्ट चलाती है। यह सुनिश्चित करता है कि नया कोड मुख्य ब्रांच में मर्ज होने से पहले आवश्यक टेस्ट पास कर ले।
CI प्रक्रिया dbt run चलाकर मॉडल्स बनाती है और dbt test से डेटा वैलिडेट कर त्रुटियों/असंगतियों की जाँच करती है।
4. मर्ज कॉन्फ्लिक्ट्स का समाधान
जब कई टीम सदस्य एक ही मॉडल या फाइल में बदलाव करते हैं, तो मर्ज कॉन्फ्लिक्ट्स हो सकते हैं। ऐसे में, मैं पहले कोड में कॉन्फ्लिक्ट मार्कर्स की समीक्षा करता/करती हूँ और तय करता/करती हूँ किन बदलावों को रखना है:
- यदि दोनों बदलाव मान्य हों, तो उन्हें मिलाकर नया संस्करण बनाता/बनाती हूँ।
- यदि केवल एक सेट सही हो, तो उसी को रखकर दूसरे को हटा देता/देती हूँ।
कॉन्फ्लिक्ट सुलझाने के बाद, मैं लोकली टेस्ट चलाता/चलाती हूँ ताकि यह सुनिश्चित हो सके कि समाधान ने कोई नई त्रुटि न ला दी हो। पुष्टि होने पर, हल किए गए बदलावों को ब्रांच में पुश कर देता/देती हूँ।
5. डॉक्यूमेंटेशन और सहयोग
हम सुनिश्चित करते हैं कि हर मर्ज या पुल रिक्वेस्ट में किए गए बदलावों का उपयुक्त डॉक्यूमेंटेशन हो। हम dbt के ऑटो-जेनरेटेड डॉक्यूमेंटेशन को अपडेट करते हैं ताकि टीम के सभी सदस्यों को नए/अपडेटेड मॉडल्स की स्पष्ट समझ रहे।
आप मौजूदा डेटा पाइपलाइन में dbt कैसे लागू करेंगे?
मैं मौजूदा पाइपलाइन में dbt इस तरह लागू करूँगा/करूँगी:
- वर्तमान पाइपलाइन का आकलन: अक्षमताओं और उन क्षेत्रों की पहचान करें जहाँ dbt ट्रांसफॉर्मेशन प्रक्रियाओं में सुधार ला सकता है।
- dbt सेटअप: dbt इंस्टॉल करें, नया प्रोजेक्ट बनाएं, और डेटा वेयरहाउस से कनेक्शन कॉन्फ़िगर करें।
- ट्रांसफॉर्मेशन कन्वर्ट करें: मौजूदा SQL या ट्रांसफॉर्मेशन लॉजिक को dbt मॉडल्स में माइग्रेट करें, मॉड्यूलरिटी और स्पष्टता सुनिश्चित करें।
- टेस्ट और डॉक्यूमेंटेशन जोड़ें: डेटा गुणवत्ता और पारदर्शिता सुनिश्चित करने के लिए dbt के बिल्ट-इन टेस्टिंग और डॉक्यूमेंटेशन लागू करें।
- ऑर्केस्ट्रेशन के साथ एकीकृत करें: Airflow या Prefect जैसे मौजूदा टूल्स से dbt रन शेड्यूल करें।
- छोटे से शुरू करें: बदलावों को स्केल करने से पहले पाइपलाइन के एक छोटे हिस्से पर dbt लागू कर मान्य करें।
- मॉनिटर और अनुकूलित करें: परफॉर्मेंस लगातार मॉनिटर करें और ज़रूरत पड़ने पर मॉडल्स को अनुकूलित करें।
कल्पना करें कि कोई dbt मॉडल "relation does not exist" त्रुटि के कारण फेल हो रहा है। आप ऐसी त्रुटि को कैसे डिबग करेंगे?
जब dbt में "relation does not exist" त्रुटि मिलती है, तो आमतौर पर इसका अर्थ है कि मॉडल ऐसी टेबल/मॉडल का संदर्भ दे रहा है जो बनी नहीं है या जिसका नाम गलत लिखा गया है। मैं इसे इस तरह डिबग करूँगा/करूँगी:
- टाइपोज़ जाँचें:
ref()फ़ंक्शन में टेबल या मॉडल का नाम सही लिखा है या नहीं, और यह सत्यापित करें कि सही मॉडल/टेबल का ही संदर्भ है।
SELECT * FROM {{ ref('orders') }} -- Ensure 'orders' is the correct model name- मॉडल डिपेंडेंसी सत्यापित करें: यदि आपका मॉडल अन्य मॉडलों पर निर्भर है, तो dbt DAG (Directed Acyclic Graph) में देखें कि अपस्ट्रीम मॉडल्स असफल मॉडल के चलने से पहले सफलतापूर्वक बन चुके हैं या नहीं।
- dbt को डिबग मोड में चलाएँ:
dbt debugचलाएँ और लॉग्स में विस्तृत जानकारी देखें कि dbt ने क्या प्रयास किया और असफल क्यों हुआ। - डेटा प्लेटफॉर्म परमिशन्स जाँचें: सुनिश्चित करें कि dbt के पास संदर्भित टेबल/मॉडल तक पहुँचने की उचित अनुमतियाँ हैं।
- इंडिविजुअल मॉडल्स चलाएँ: आश्रित मॉडलों को अलग से चलाकर देखें (जैसे,
dbt run --models orders) कि वे मौजूद हैं और असफल मॉडल से पहले सही से बन रहे हैं।
dbt इंटरव्यू की तैयारी के सुझाव
dbt एक नया फ्रेमवर्क है जो धीरे-धीरे विकसित हो रहा है। नई अपडेट्स के साथ तालमेल रखना, जबकि पुराने मैटेरियल को भी सीखना, भारी लग सकता है। इसलिए आपको संतुलित दृष्टिकोण अपनाना चाहिए — कोर फीचर्स से शुरुआत करें। उन्हें अच्छे से सीखने के बाद, जोड़े गए हिस्से एक्सप्लोर करें ताकि समझ सकें कि क्या बदला है।
मुझे पता है इंटरव्यू तनावपूर्ण हो सकते हैं, खासकर dbt जैसे विशेष टूल के लिए। लेकिन चिंता न करें — मैंने कुछ टिप्स एकत्र किए हैं जो आपकी तैयारी में मदद करेंगे और आपको आत्मविश्वास महसूस होगा:
dbt फीचर्स में महारत हासिल करें
मैं इसे पर्याप्त रूप से रेखांकित नहीं कर सकता/सकती — dbt के बुनियादी कॉन्सेप्ट्स जैसे मॉडल्स, टेस्ट्स, डॉक्यूमेंटेशन, और ये सब कैसे एक साथ काम करते हैं, में सहज हो जाइए। इन बुनियादों की ठोस समझ तकनीकी चर्चाओं में आपके काम आएगी।
DataCamp का इस पर एक उत्तम कोर्स है: Introduction to dbt
DataCamp अन्य डेटा इंजीनियरिंग विषयों को गहराई से कवर करने वाले कुछ शुरुआती-अनुकूल कोर्स भी प्रदान करता है:
- डेटा इंजीनियरिंग बेसिक्स के लिए: Understanding Data Engineering
- डेटाबेस डिज़ाइन के लिए: Database Design
- डेटा वेयरहाउसिंग बेसिक्स के लिए: Data Warehousing Concepts
- Snowflake बेसिक्स के लिए: Introduction to Snowflake
- डेटा आर्किटेक्चर के लिए: Understanding Modern Data Architecture
- Python में ETL और ELT सीखने के लिए: ETL and ELT in Python
dbt के साथ हाथों-हाथ अनुभव लें
किसी चीज़ के बारे में पढ़ना अच्छा है, लेकिन करना और भी बेहतर है। यह dbt कौशल में महारत हासिल करने के सबसे प्रभावी तरीकों में से एक है। आपको ऑनलाइन रॉ डेटासेट्स की एक बड़ी सूची मिल जाएगी, जिन पर ट्रांसफॉर्मेशन और टेस्ट चला सकते हैं। अपना खुद का dbt प्रोजेक्ट सेट करें और विभिन्न फीचर्स के साथ प्रयोग करें। जब आप वास्तव में इसका उपयोग कर चुके होंगे, तो dbt पर बात करते समय आपका आत्मविश्वास काफी बढ़ेगा।
वास्तविक दुनिया के उदाहरण तैयार करें
इंटरव्यूअर व्यावहारिक अनुप्रयोगों के बारे में सुनना पसंद करते हैं। क्या आप किसी ऐसी समस्या के बारे में सोच सकते हैं जिसे आपने dbt से हल किया हो या किसी काल्पनिक परिदृश्य में आप इसे कैसे उपयोग करेंगे? ऐसे कुछ उदाहरण साझा करने के लिए तैयार रखें। उदाहरण जुटाने के लिए आप dbt की आधिकारिक साइट से कई केस स्टडीज़ पढ़ सकते हैं या Git पर public dbt projects से आइडिया ले सकते हैं।
निष्कर्ष
हमने बेसिक से लेकर एडवांस्ड तक के व्यापक dbt इंटरव्यू प्रश्न कवर किए, जो आपकी जॉब-हंटिंग यात्रा में सहायक होंगे। क्लाउड डेटा वेयरहाउस के साथ dbt का एकीकरण समझकर, आप उन्नत डेटा ट्रांसफॉर्मेशन कौशल से लैस होंगे, जो किसी भी डेटा इंटीग्रेशन प्रक्रिया का मूल है।
हालाँकि, dbt और SQL साथ-साथ चलते हैं। इसलिए, यदि आप SQL में नए हैं, तो DataCamp के SQL कोर्स देखें।
FAQs
dbt सीखने में कितना समय लगता है?
dbt कौशल में पूरी तरह महारत हासिल करने में कुछ महीने लग सकते हैं। लेकिन यदि आप रोज़ कुछ घंटे समर्पित करें, तो आप इसे जल्दी सीख सकते हैं।
मैं dbt स्वयं कैसे सीख सकता/सकती हूँ?
आप ऑनलाइन संसाधनों का उपयोग कर सकते हैं, जैसे DataCamp के कोर्स, YouTube ट्यूटोरियल्स और ब्लॉग पोस्ट। इसके अलावा, मौजूदा प्रोजेक्ट्स को फिर से लिखकर अपने प्रोजेक्ट्स बनाइए। इससे आपका हैंड्स-ऑन कौशल मजबूत होगा।
क्या dbt डेटा इंजीनियरों की भूमिका समाप्त कर देता है?
नहीं, dbt डेटा इंजीनियरों की भूमिका को खत्म नहीं करता। इसके बजाय, यह उनके काम में सहायता करता है। वे इस फ्रेमवर्क का उपयोग ट्रांसफॉर्मेशन और टेस्ट जैसे कार्यों को स्वचालित करने के लिए कर सकते हैं।

मैं एक कंटेंट स्ट्रैटेजिस्ट हूँ जिसे जटिल विषयों को सरल बनाना पसंद है। मैंने Splunk, Hackernoon, और Tiiny Host जैसी कंपनियों को अपने दर्शकों के लिए आकर्षक और सूचनात्मक सामग्री बनाने में मदद की है।
dbt (data build tool) आधुनिक डेटा इंजीनियरिंग और एनालिटिक्स वर्कफ़्लो में व्यापक रूप से इस्तेमाल होने वाला डेवलपमेंट फ्रेमवर्क बन चुका है। डेटा विश्लेषक आमतौर पर SQL में ट्रांसफॉर्मेशन लिखने के लिए डेटा इंजीनियरों पर निर्भर रहते हैं। लेकिन dbt के साथ, वे स्वयं ट्रांसफॉर्मेशन लिख सकते हैं और डेटा पर अधिक नियंत्रण रख सकते हैं। यह Git जैसे लोकप्रिय संस्करण नियंत्रण प्रणालियों के साथ एकीकरण की सुविधा भी देता है, जिससे टीम सहयोग बेहतर होता है।
यदि आप डेटा वेयरहाउस से जुड़े रोल, जैसे डेटा इंजीनियर, डेटा विश्लेषक, या डेटा वैज्ञानिक की तैयारी कर रहे हैं, तो आपको बेसिक और एडवांस्ड dbt प्रश्नों में निपुण होना चाहिए!
इस लेख में, मैंने सबसे आम पूछे जाने वाले इंटरव्यू प्रश्नों को रेखांकित किया है ताकि आप अपने बुनियादी कॉन्सेप्ट और उन्नत समस्या-समाधान कौशल बना सकें।
dbt क्या है?
dbt एक ओपन-सोर्स डेटा ट्रांसफॉर्मेशन फ्रेमवर्क है जो आपको एक ही प्लेटफॉर्म पर डेटा को ट्रांसफॉर्म करने, उसकी शुद्धता की जाँच करने और बदलावों को ट्रैक करने की अनुमति देता है। अन्य ETL (extract, transform, load) टूल्स के विपरीत, dbt केवल ट्रांसफॉर्मेशन भाग (यानी T) करता है।
कुछ अन्य ETL टूल्स विभिन्न स्रोतों से डेटा निकालते हैं, वेयरहाउस के बाहर उसे ट्रांसफॉर्म करते हैं, और फिर वापस लोड कर देते हैं। इसमें अक्सर विशेष कोडिंग ज्ञान और अतिरिक्त टूल्स की आवश्यकता होती है। लेकिन dbt इसे आसान बनाता है — यह केवल SQL का उपयोग करते हुए वेयरहाउस के भीतर ट्रांसफॉर्मेशन की अनुमति देता है।
40,000 से अधिक बड़ी कंपनियां डेटा को सुव्यवस्थित करने के लिए dbt का उपयोग करती हैं — इसलिए भर्तीकर्ता इसे डेटा-संबंधित भूमिकाओं के लिए सबसे महत्वपूर्ण कौशलों में से एक के रूप में सूचीबद्ध करते हैं। अतः, यदि आप इसे एक शुरुआती डेटा प्रैक्टिशनर के रूप में भी सीख लेते हैं, तो यह कई करियर अवसर खोल सकता है!
dbt का सेमांटिक लेयर। इमेज स्रोत: dbt
बेसिक dbt इंटरव्यू प्रश्न
इंटरव्यू प्रक्रिया की शुरुआत में इंटरव्यूअर आपका बेसिक नॉलेज परखेगा। इसके लिए वे आपसे ऐसे कुछ बुनियादी प्रश्न पूछ सकते हैं:
dbt के सामान्य उपयोग क्या हैं?
dbt डेटा टीम को एक ही पेज पर लाता है, जहां वे अपने डेटा को ट्रांसफॉर्म, डॉक्यूमेंट और टेस्ट कर सकते हैं। यह सुनिश्चित करने में मदद करता है कि डेटा भरोसेमंद और समझने में आसान हो। dbt के सामान्य उपयोगों में शामिल हैं:
क्या dbt एक प्रोग्रामिंग भाषा है?
नहीं, dbt कोई प्रोग्रामिंग भाषा नहीं है। यह एक टूल है जो वेयरहाउस में डेटा ट्रांसफॉर्मेशन जॉब्स में मदद करता है। यदि आप SQL लिखना जानते हैं, तो आप आसानी से dbt के साथ काम कर सकते हैं। इसने कुछ विशिष्ट कार्यों के लिए Python का समर्थन भी शुरू किया है। लेकिन मूल रूप से, यह SQL-आधारित ट्रांसफॉर्मेशन को मैनेज और रन करता है।
क्या आप बता सकते हैं कि dbt की तुलना Spark से कैसे होती है?
dbt और Spark अलग उद्देश्यों की पूर्ति करते हैं और विभिन्न प्रकार के वर्कफ़्लो को लक्षित करते हैं। यहाँ उनके डेटा इन्फ्रास्ट्रक्चर में रोल की तुलना है:
फ़ीचर
dbt
Spark
भूमिका
SQL-आधारित डेटा ट्रांसफॉर्मेशन और मॉडलिंग
डिस्ट्रिब्यूटेड डेटा प्रोसेसिंग और एनालिटिक्स
कोर भाषा
मुख्यतः SQL, सीमित Python समर्थन के साथ
SQL, Python, Scala, Java, R का समर्थन
डेटा गवर्नेंस
डॉक्यूमेंटेशन और लिनेएज सपोर्ट
एक्सेस कंट्रोल, ऑडिटिंग, और डेटा लिनेएज प्रदान करता है
लक्षित उपयोगकर्ता
SQL उपयोगकर्ता, विश्लेषक, और गैर-इंजीनियरिंग कौशल वाली टीमें
डेटा इंजीनियर, डेटा वैज्ञानिक, डेवलपर्स
ट्रांसफॉर्मेशन की जटिलता
केवल SQL ट्रांसफॉर्मेशन और मॉडलिंग पर केंद्रित
अन्य भाषाओं में भी जटिल ट्रांसफॉर्मेशन संभाल सकता है
टेस्टिंग और वैलिडेशन
बिल्ट-इन टेस्टिंग क्षमताएँ हैं
कस्टम टेस्टिंग रणनीतियों (यूनिट और इंटीग्रेशन) की आवश्यकता
dbt के साथ चुनौतियाँ क्या हैं?
यद्यपि dbt डेटा टीमों के लिए बहुत मूल्य लाता है, पैमाना और जटिलता बढ़ने पर कुछ चुनौतियाँ भी आ सकती हैं। सबसे आम चुनौतियाँ हैं:
उपरोक्त संभावित चुनौतियों से निपटना जानना नियोक्ता देखते हैं, इसलिए इस प्रश्न के महत्व को नज़रअंदाज़ न करें।
dbt Core और dbt Cloud में क्या अंतर है?
dbt के दो मुख्य संस्करण हैं:
dbt Core dbt का मुफ्त और ओपन-सोर्स संस्करण है जो उपयोगकर्ताओं को लोकली SQL-आधारित ट्रांसफॉर्मेशन लिखने, चलाने और प्रबंधित करने की अनुमति देता है। यह dbt प्रोजेक्ट्स निष्पादित करने, मॉडल्स टेस्ट करने और डेटा पाइपलाइंस बनाने के लिए कमांड-लाइन इंटरफेस (CLI) प्रदान करता है। चूंकि यह ओपन-सोर्स है, dbt Core में उपयोगकर्ताओं को अपनी डिप्लॉयमेंट, ऑर्केस्ट्रेशन और इन्फ्रास्ट्रक्चर सेटअप स्वयं संभालना पड़ता है, आमतौर पर egrating with tools like Airflow या Kubernetes के साथ स्वचालन हेतु एकीकृत करना शामिल होता है।
dbt Cloud दूसरी ओर, dbt (Fishtown Analytics) के निर्माताओं द्वारा प्रदान की गई एक मैनेज्ड सर्विस है। यह dbt Core की सभी क्षमताओं के साथ अतिरिक्त सुविधाएँ प्रदान करता है जैसे वेब-आधारित इंटरफेस, एकीकृत शेड्यूलिंग, जॉब प्रबंधन, और सहयोग टूल्स। dbt Cloud में बिल्ट-इन CI/CD (continuous integration and deployment) सुविधाएँ, API एक्सेस, और SOC 2 तथा HIPAA जैसी उन्नत सुरक्षा अनुपालना भी शामिल है, जो उच्च सुरक्षा आवश्यकताओं वाले संगठनों के लिए उपयुक्त है।