
课程
使用 Llama 3
2 小时
15.7K
实践并学习路径你的进步。
使用 Google 继续Meta 刚刚发布了 Llama 4 模型套件,其中包含两款已发布模型——Llama 4 Scout 和 Llama 4 Maverick——以及第三款仍在训练中的模型:Llama 4 Behemoth。
Scout 和 Maverick 变体现已开放发布,遵循 Meta 一贯的开源权重许可——但有一项显著附加条款:如果您的服务月活跃用户超过 7 亿,您需要从 Meta 另行获取许可,是否授予许可由其自行决定。
Llama Scout 支持 1,000 万 Token 的上下文窗口,是目前公开发布模型中最大的。Llama Maverick 是通用型模型,瞄准 GPT-4o、Gemini 2.0 Flash 和 DeepSeek-V3。仍在训练中的 Llama Behemoth 则作为高容量的教师模型。
在这篇入门博客中,我将为您概览 Llama 4 套件。我们的团队已对模型进行了测试,如果您想进一步学习,推荐阅读以下教程:
更新:在大约一年的沉寂后,Meta 发布了其最新的 LLM。想快速了解,请查看我们的 Muse Spark 指南。
我们通过每周五发送的免费通讯 The Median 为读者带来最新 AI 动态,拆解本周重点新闻。订阅它,每周只需几分钟即可保持敏锐:
Llama 4 是 Meta 推出的新一代大语言模型家族。本次发布包含两款已可用的模型——Llama 4 Scout 和 Llama 4 Maverick——以及仍在训练中的 Llama 4 Behemoth。
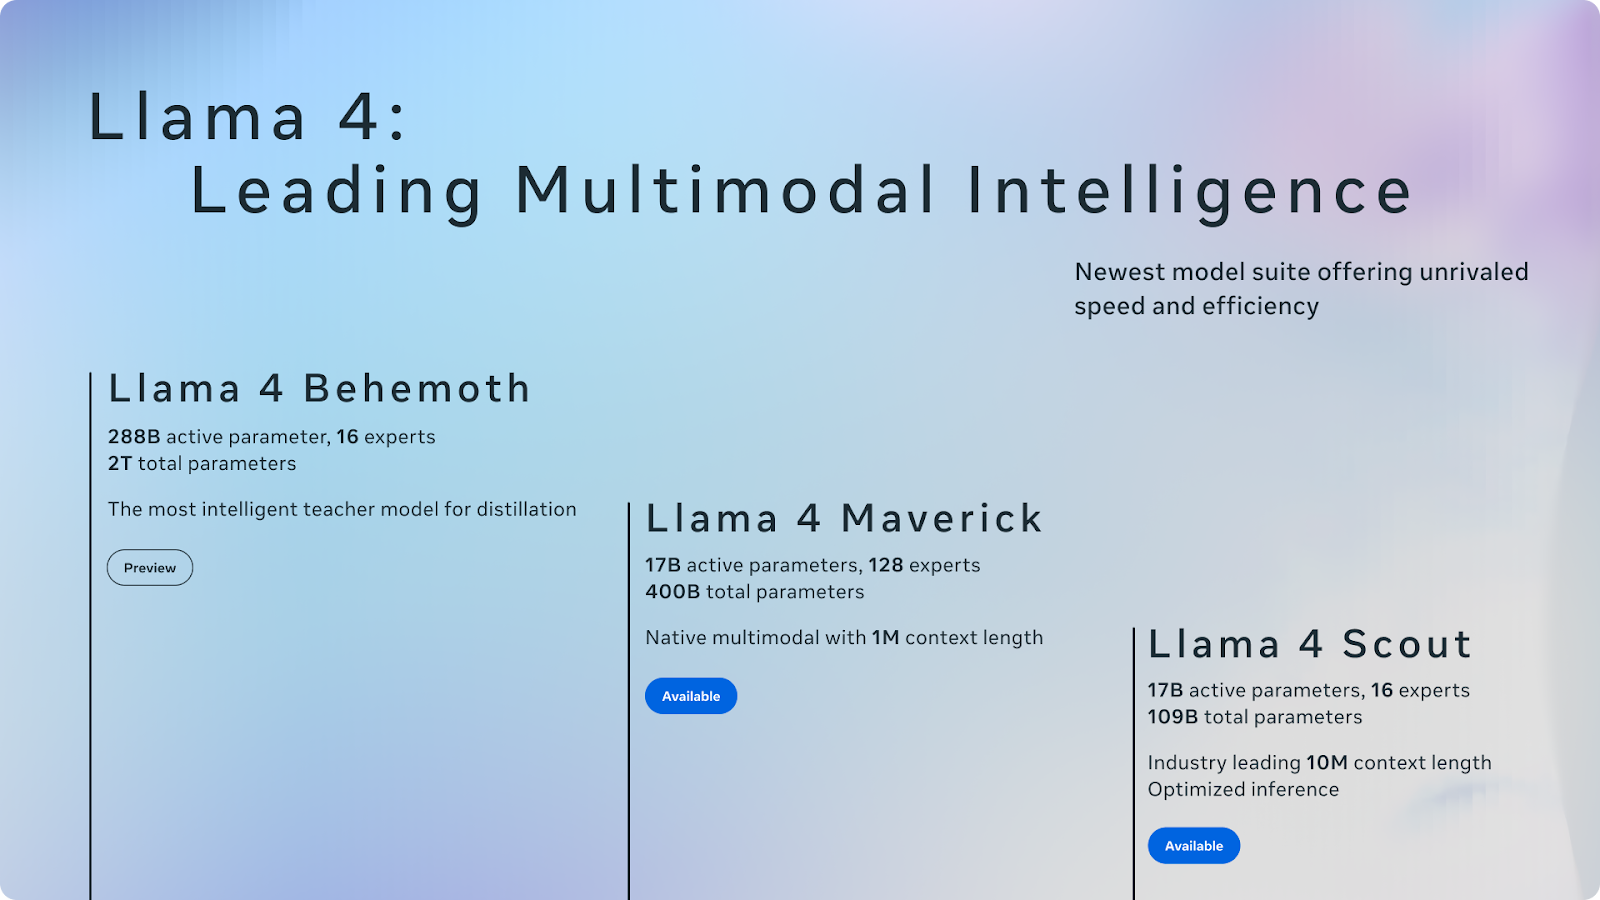
来源:Meta AI
Llama 4 带来了显著增强。值得注意的是,它采用了专家混合(MoE)架构,旨在通过按需激活特定任务所需组件来提升效率与性能(下文将进一步介绍)。这一设计标志着向更具可扩展性与更专业化的 AI 模型转变。
Llama 4 延续了 Meta 发布开源权重模型的策略——但带有附加条件。如果您的公司运营的服务月活跃用户超过 7 亿,您需要从 Meta 另行获取许可,且不保证一定获批。撇开这一限制,此次发布在开源权重领域仍是重大事件,尽管过去几个月该领域本身也在迅速变化。
如果说 Llama 2 和 3 曾经定义了这一类别,那么如今的 Llama 4 面对的是更加激烈的竞争格局。DeepSeek 以强大的推理能力登场。阿里巴巴的Qwen 系列在多语言与编码基准上表现不俗。谷歌的Gemma 模型也以更小更高效的架构切入同一赛道。就在几天前,OpenAI 也宣布计划发布开源权重模型——这一转变在一年前还难以想象。
下面来了解各模型的更多细节。
Llama 4 Scout 是该套件中较轻量的模型,但或许也是最引人注目的。它可在单张 H100 GPU 上运行,并支持 1,000 万 Token 的上下文窗口。这使得 Scout 成为迄今为止上下文容量最大的开源权重模型,并有望在多文档摘要、长代码推理和活动解析等任务中大显身手。
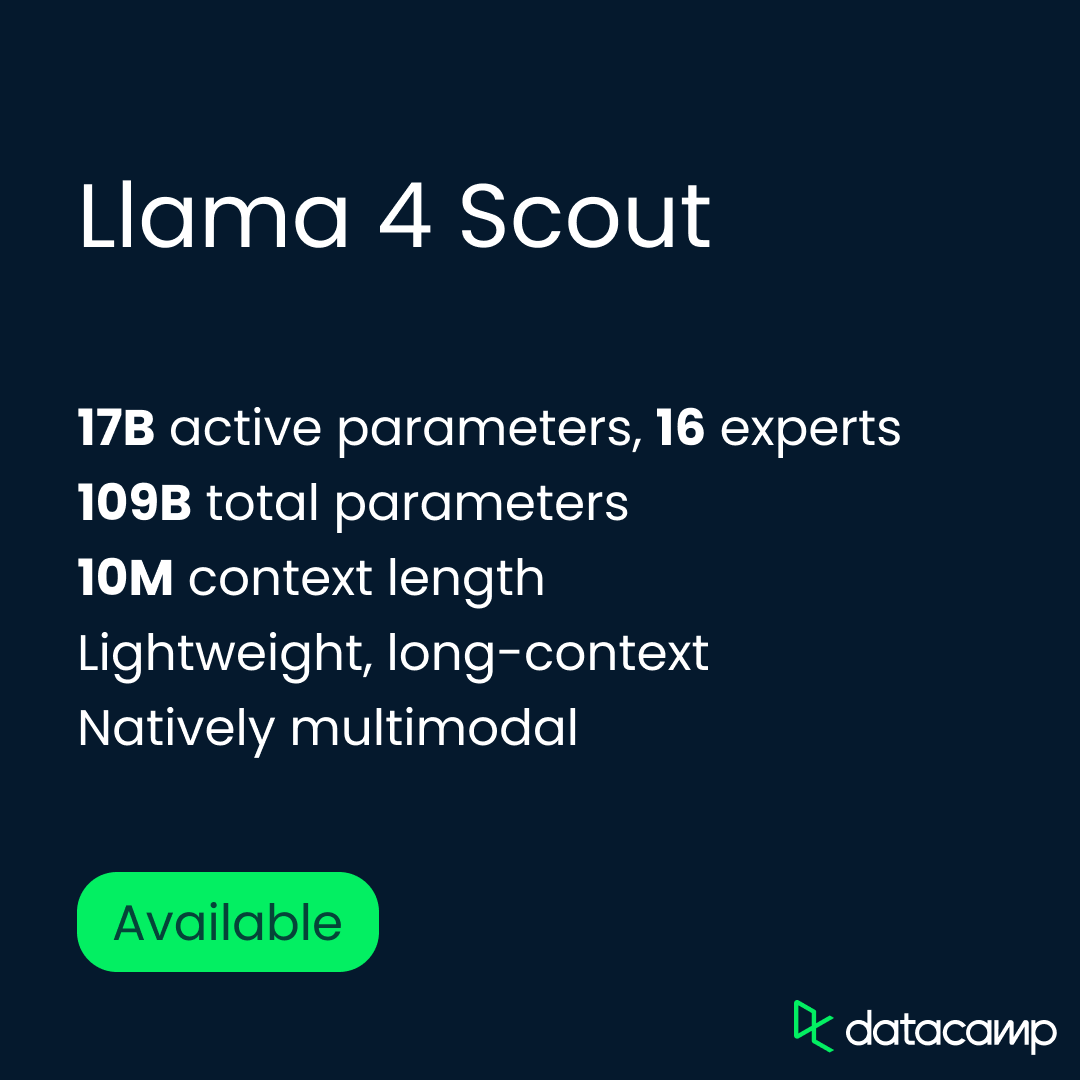
Scout 具有 170 亿个激活参数,通过 16 个专家组织,总参数量达 1,090 亿。其预训练与后训练均使用 256K 上下文窗口,但 Meta 表示它在远超该长度时也能很好泛化(这一说法仍待验证)。在实践中,这为涵盖整套代码库、会话历史或法律文书的工作流程打开了大门——且可在单次前向传播中完成处理。
在架构层面,Scout 基于 Meta 的专家混合(MoE)框架构建,每个 Token 仅激活部分参数——这不同于稠密模型(如 GPT-4o)会激活全部参数。这意味着它既算力高效,又高度可扩展。
除核心架构外,Meta 还强调了 Scout 的多模态能力。它在预训练阶段采用早期融合,使用文本、图像与视频数据进行训练,使其能够原生处理文本与视觉提示的组合。在视觉定位与 VQA(视觉问答)等图像密集型任务上,Scout 的表现优于以往任何 Llama 模型——并能与更大型系统一较高下。
简而言之,Scout 为广度与规模而生。它被设计为高效运行、可处理比以往任何开源模型更多的输入,并能在文本与图像任务上表现出色。我们很快就会测试其 1,000 万上下文的极限——并带回测试结果。
Llama 4 Maverick 是该系列中的通才——一款为对话、推理、图像理解与代码等多任务表现而打造的全尺寸多模态模型。相较于将上下文长度推至极限的 Scout,Maverick 更注重在各项任务上输出均衡而高质量的结果。它是 Meta 对标 GPT-4o、DeepSeek-V3 与 Gemini 2.0 Flash 的答案。
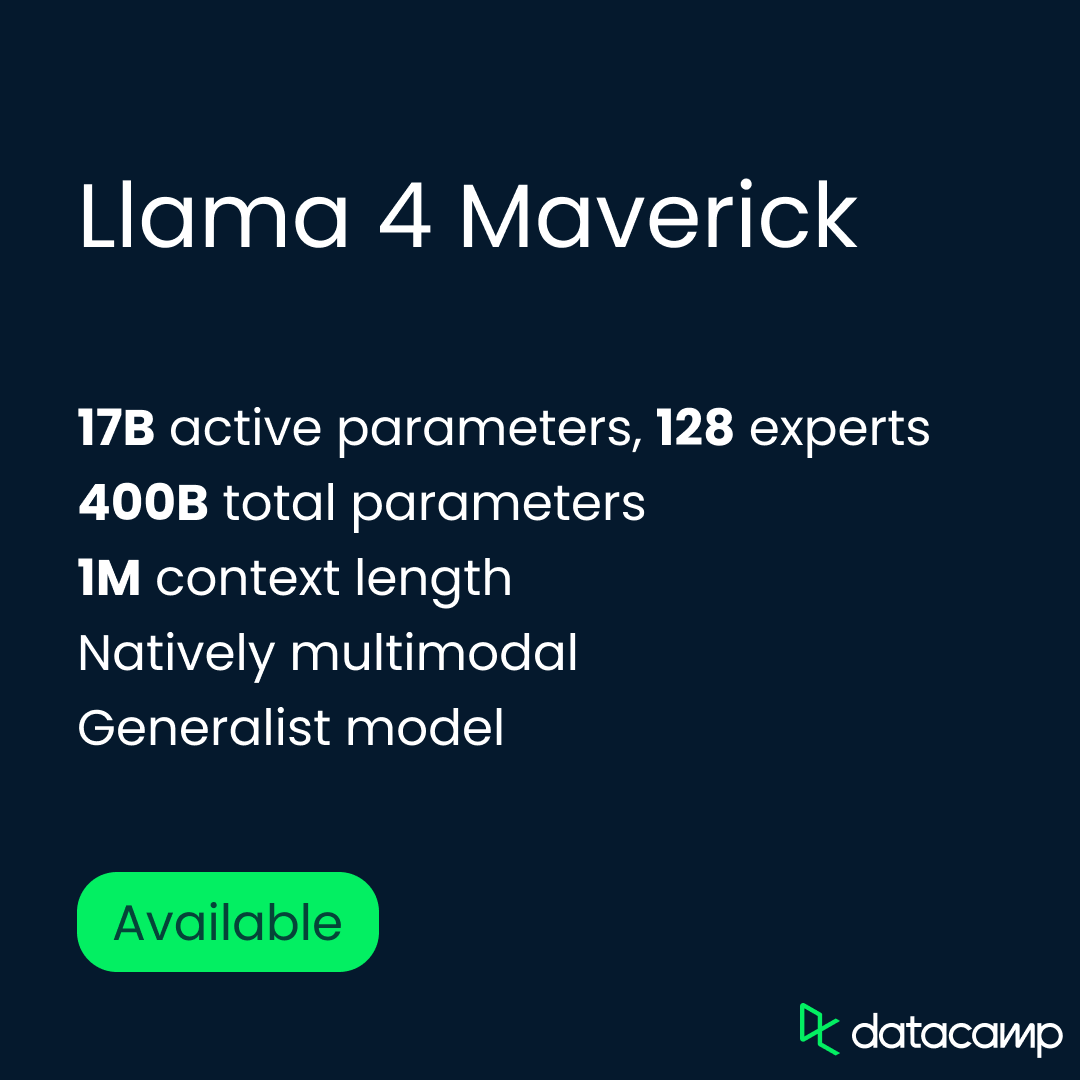
Maverick 与 Scout 一样拥有 170 亿个激活参数,但采用更大的 MoE 配置:128 个专家、总参数量 4,000 亿。与 Scout 相同,它使用专家混合架构,每个 Token 仅激活模型的一部分——在扩展容量的同时降低推理成本。该模型可在单台 H100 DGX 主机上运行,也可通过分布式推理部署到更大规模的应用中。
在后训练上,Meta 采用了不同方法,混合了轻量级的有监督微调、在线强化学习与直接偏好优化。目标是在不对模型过度约束的前提下强化对困难提示的表现。为此,Meta 过滤掉了超过 50% 被早期 Llama 模型标记为“简单”的训练样本,并构建了一套强调更难推理、编码与多模态任务的课程体系。
Maverick 还从 Meta 规模更大的内部模型 Llama 4 Behemoth 进行协同蒸馏,这帮助其在不增加训练成本的情况下提升性能。根据 Meta 的说法,这条蒸馏流程明显提升了推理与对话质量。
Llama 4 Behemoth 是 Meta 迄今最强大、体量最大的模型——但尚未开放。它仍在训练中,且并非与DeepSeek-R1 或 OpenAI 的 o3相同意义上的推理模型,它们专为多步思维链任务打造并进行优化。
就目前所知,它似乎也并非面向直接使用的产品。相反,它充当教师模型,用于对Scout 与 Maverick 进行蒸馏与塑形。一旦发布,它也可能让其他人得以基于其进行自有模型的蒸馏。
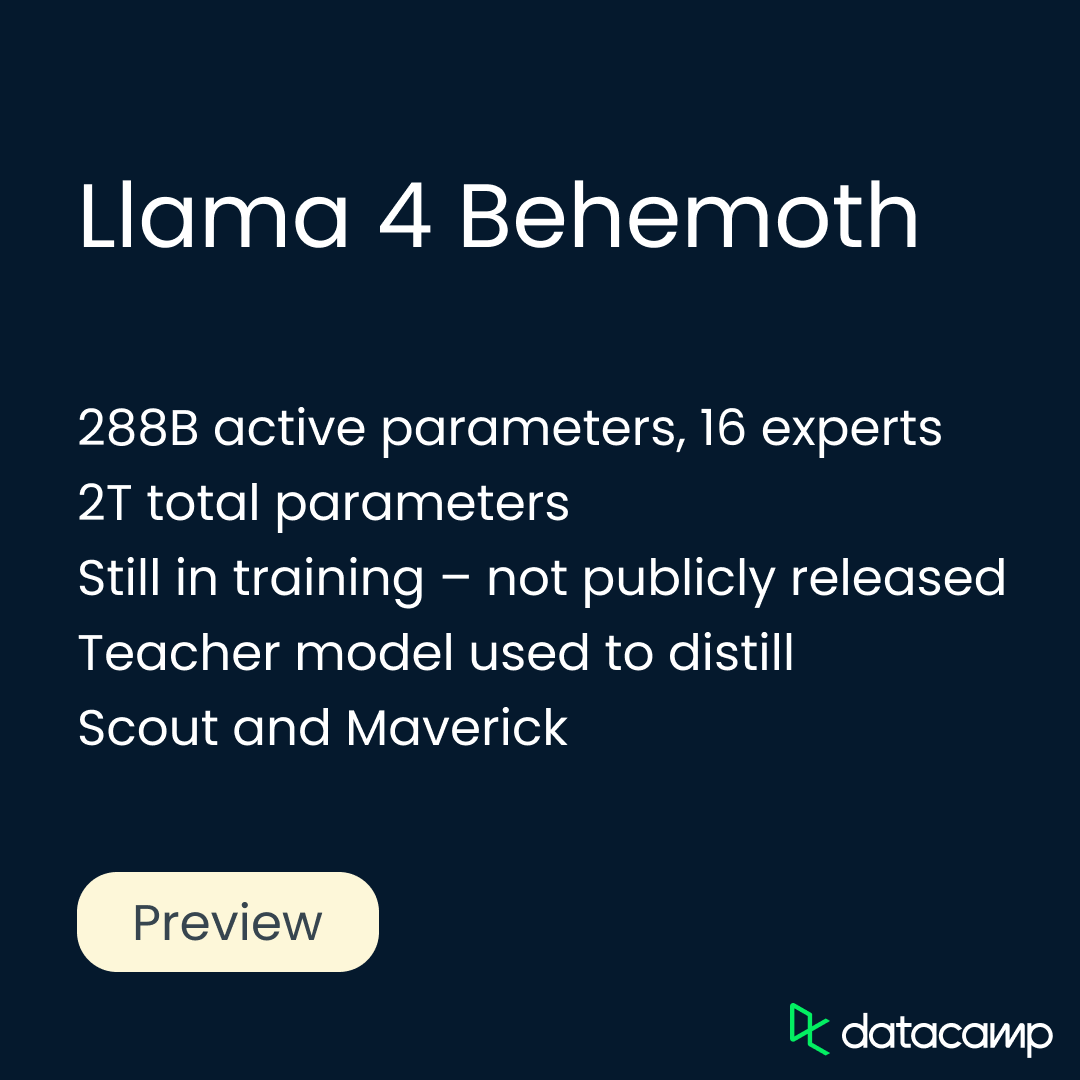
Behemoth 拥有 2,880 亿个激活参数,通过 16 个专家组织,总参数量接近 2 万亿。为支撑 Behemoth 的规模,Meta 构建了全新的训练基础设施。它引入了异步强化学习、基于提示难度的课程采样,以及可动态平衡软硬目标的新型蒸馏损失函数。
在后训练方面,Behemoth 也需要不同的配方。Meta 丢弃了 95% 以上的 SFT 样本以聚焦困难提示,并将强化学习集中在复杂推理、编码与多语言场景。来自多样系统指令的采样帮助模型实现泛化,而动态过滤则在 RL 训练期间移除了低价值提示。
Meta 发布了每个 Llama 4 模型的内部基准结果,并与先前 Llama 变体及若干竞品的开源权重与前沿模型进行了比较。
本节将基于 Meta 自身数据,带您浏览 Scout、Maverick 与 Behemoth 的基准亮点。与往常一样,面对厂商自报的基准应保持谨慎——但这些分数为我们提供了各模型在不同任务上的初步表现与其在当前格局中的位置。我们先从 Scout 开始。
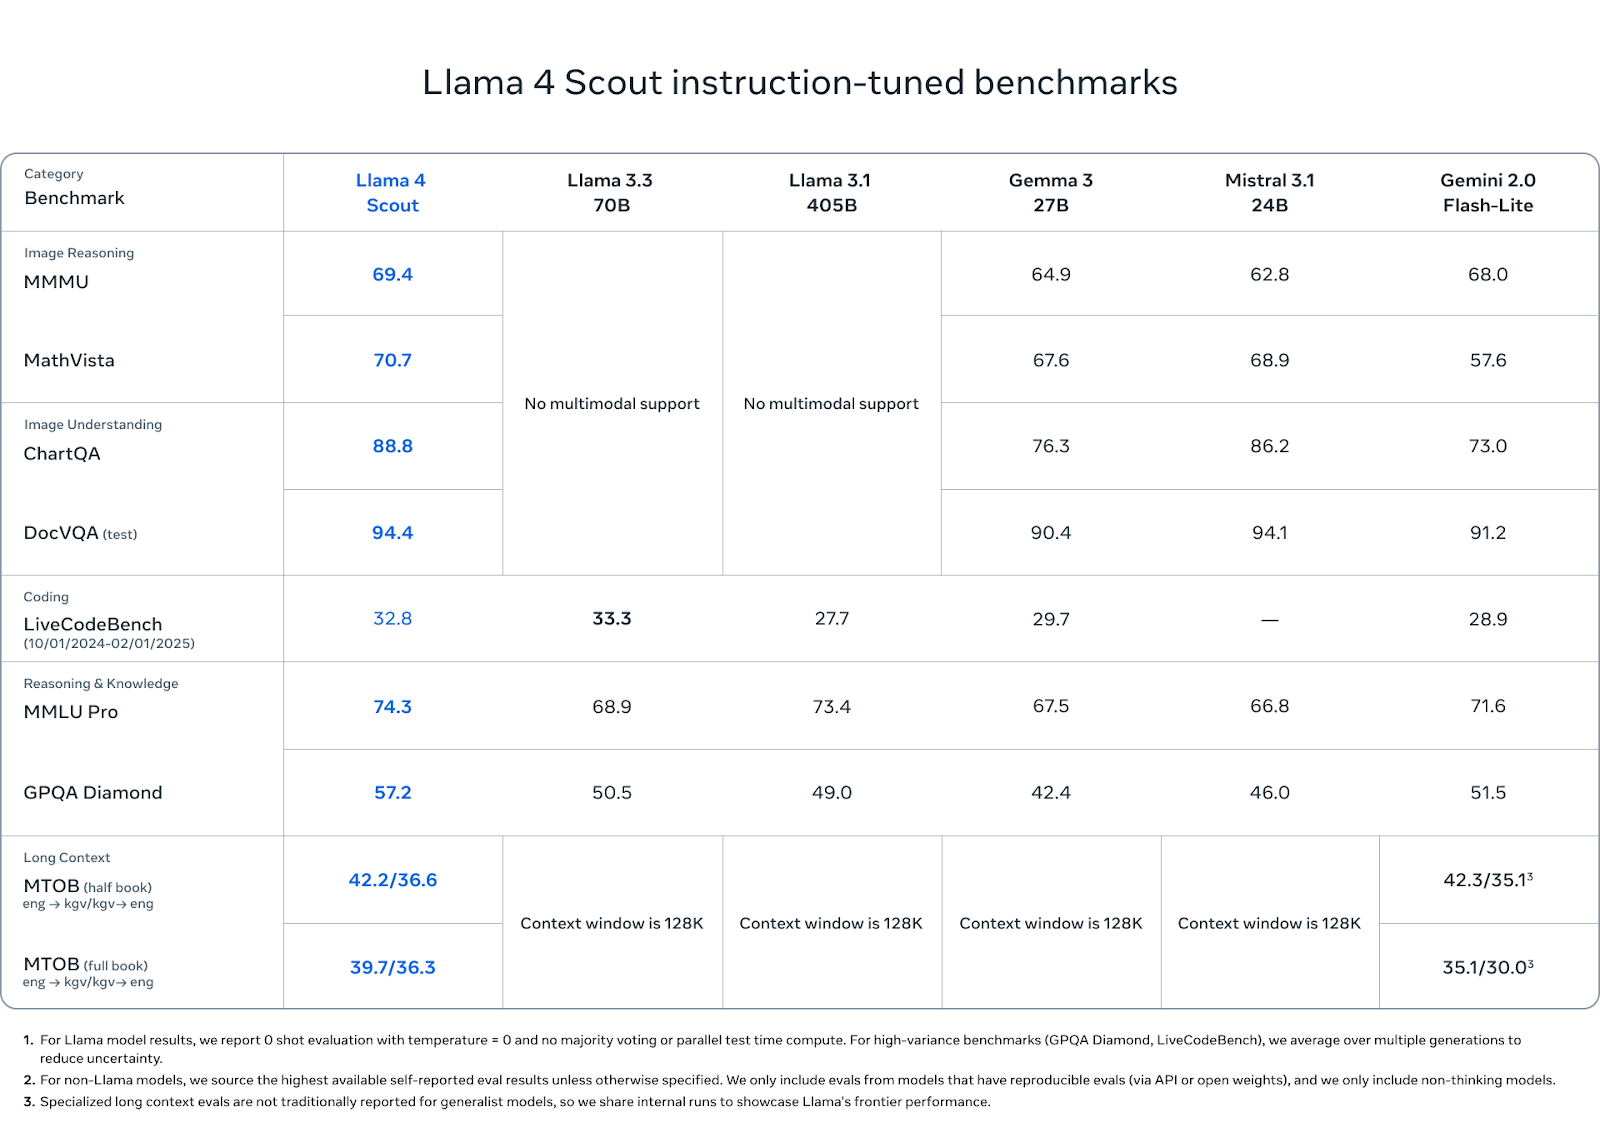
考虑到其较少的激活参数与单 GPU 运行足迹,Llama 4 Scout 在推理、编码与多模态基准上总体表现良好。
来源:MetaAI
在图像理解方面,Scout 略胜对手:它在 ChartQA 上得分 88.8、在 DocVQA(测试)上得分 94.4,优于 Gemini 2.0 Flash-Lite(分别为 73.0 与 91.2),并与 Mistral 3.1 和 Gemma 3 27B 持平或略有领先。
在 MMMU(69.4)与 MathVista(70.7)等图像推理基准中,它也领跑开源权重阵营,超越 Gemma 3(64.9、67.6)、Mistral 3.1(62.8、68.9)和 Gemini Flash-Lite(68.0、57.6)。
在编码方面,Scout 在 LiveCodeBench 上得分 32.8,领先于 Gemini Flash-Lite(28.9)与 Gemma 3 27B(29.7),但略低于 Llama 3.3 的 33.3。它并非以编码为先的模型,但依然表现稳健。
在知识与推理方面,Scout 在 MMLU Pro 上得分 74.3、在 GPQA Diamond 上得分 57.2,两项均优于其他开源权重模型。这些基准偏好长形式的多步推理,因此 Scout 在该尺度下的强劲表现尤为值得关注。
最后,Scout 的长上下文能力展现了真实世界潜力。在 MTOB(大规模文本重叠基准)中——该基准测试模型在英语与低资源语言 KGV 之间的翻译能力——它在半本测试中得分 42.2/36.6,在整本测试中得分 39.7/36.3。在半本测试中,Gemini 2.0 Flash-Lite 以 42.3 略胜,但在整本测试中 Scout 迅速缩小差距,并以 39.7/36.3 超过 Gemini 的 35.1/30.0。
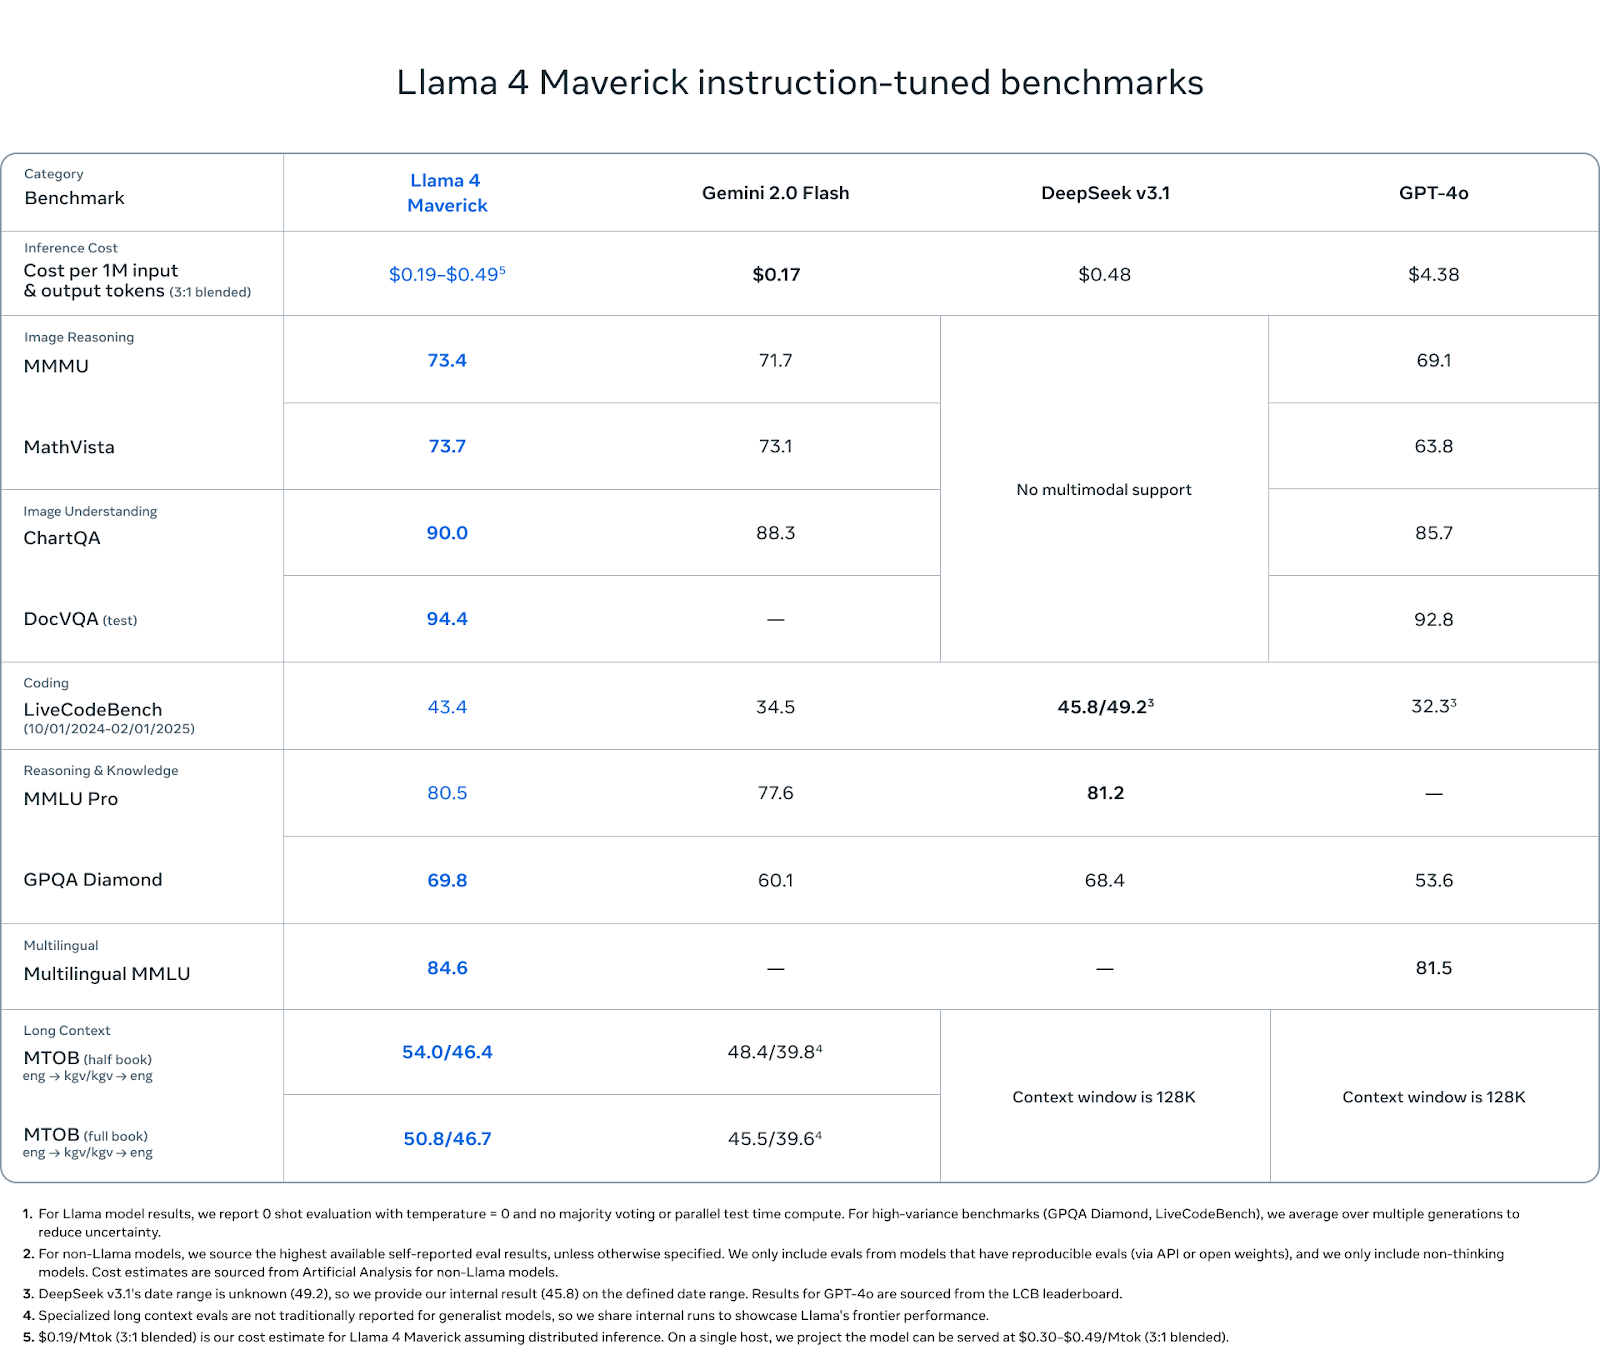
Maverick 是 Llama 4 阵容中最为全面的模型——基准结果也印证了这一点。虽然它并不追求 Scout 的极限上下文长度或 Behemoth 的原始规模,但在多模态推理、编码、语言理解与长上下文保持等所有关键类别中都表现稳定。
来源:MetaAI
在图像推理方面,Maverick 在 MMMU 上得分 73.4、在 MathVista 上得分 73.7,优于 Gemini 2.0 Flash(71.7 与 73.1)与 GPT-4o(69.1 与 63.8)。在 ChartQA(图像理解)中,它得分 90.0,略高于 Gemini 的 88.3,且明显高于 GPT-4o 的 85.7。在 DocVQA 中,Maverick 得分 94.4,与 Scout 持平并优于 GPT-4o 的 92.8。
在编码方面,Maverick 在 LiveCodeBench 上得分 43.4,高于 GPT-4o(32.3)、Gemini Flash(34.5),并接近 DeepSeek v3.1 的 45.8。
在推理与知识方面,Maverick 在 MMLU Pro 上得分 80.5、在 GPQA Diamond 上得分 69.8,再次优于 Gemini Flash(77.6 与 60.1)与 GPT-4o(未公布 MMLU Pro,GPQA 为 53.6)。DeepSeek v3.1 在 MMLU Pro 上以 0.7 的优势领先。
在多语言理解方面,Maverick 在 Multilingual MMLU 上得分 84.6,略高于 Gemini 的 81.5。这为跨多语言或多地域开展工作的开发者带来优势。
在长上下文评估(MTOB)中,Maverick 在半本测试上得分 54.0/46.4,在整本测试上得分 50.8/46.7——分别显著领先于 Gemini 的 48.4/39.8 与 45.5/39.6。这些分数表明,尽管 Maverick 并未像 Scout 那样大张旗鼓地宣传上下文长度,但它依然从更长窗口中获益良多。
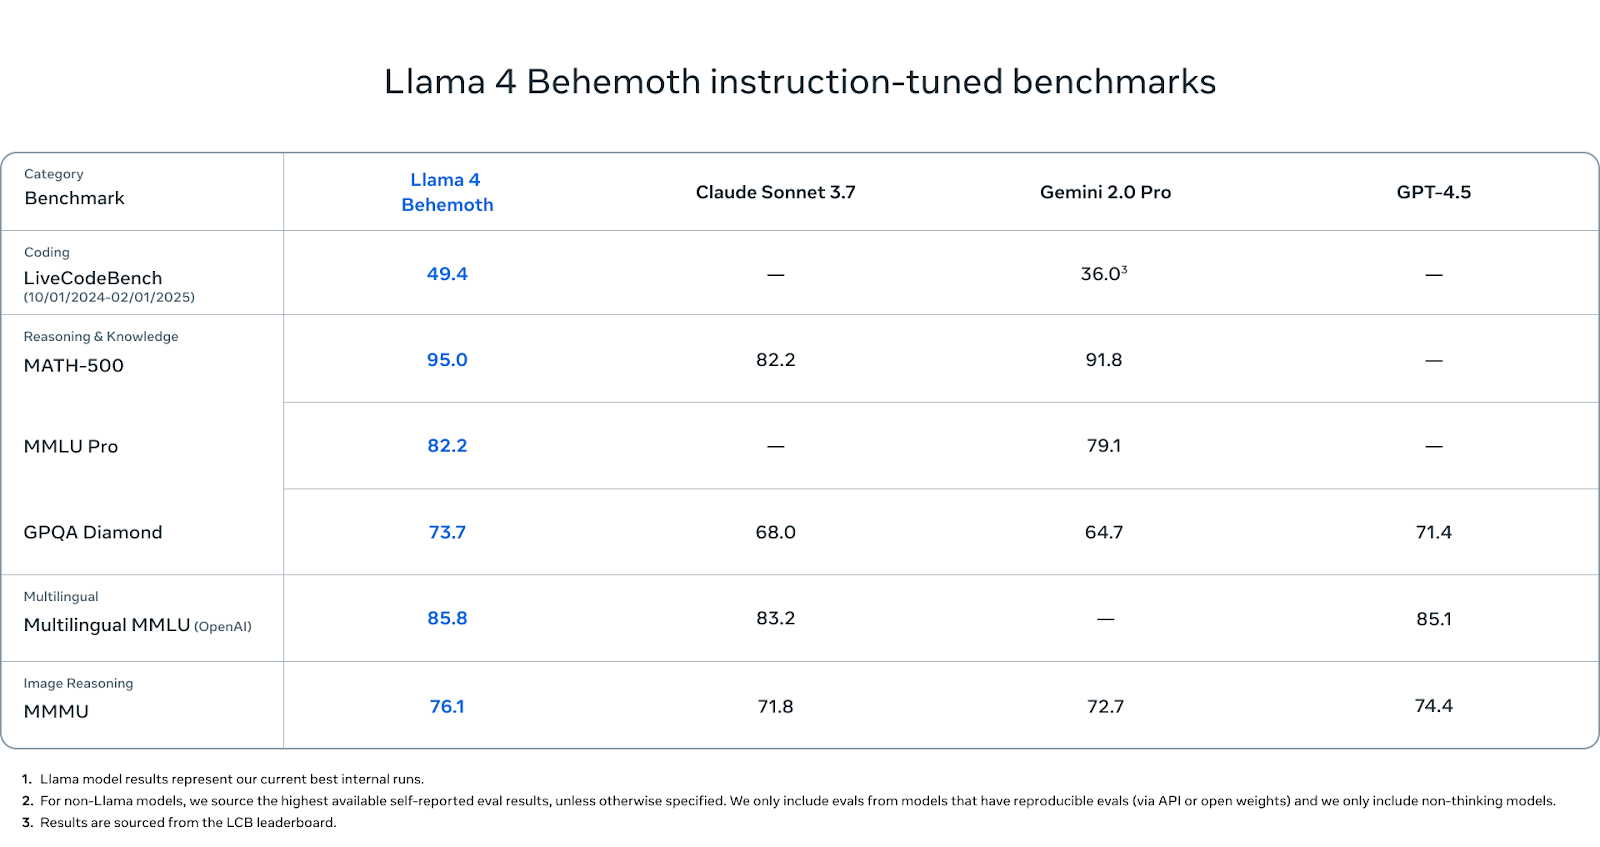
Behemoth 尚未发布,但其基准数据值得关注。
来源:MetaAI
在理工科占比高的基准中,Behemoth 表现尤为出色。它在 MATH-500 上得分 95.0——高于 Gemini 2.0 Pro(91.8),并显著领先于Claude Sonnet 3.7(82.2)。在 MMLU Pro 上,Behemoth 得分 82.2,而 Gemini Pro 为 79.1(Claude 未公布分数)。在另一项奖励事实深度与精确性的基准 GPQA Diamond 上,Behemoth 得分 73.7,领先于 Claude(68.0)、Gemini(64.7)与GPT-4.5(71.4)。
在多语言理解方面,Behemoth 在 Multilingual MMLU 上得分 85.8,略高于 Claude Sonnet(83.2)与 GPT-4.5(85.1)。对于在非英语环境中开展工作的全球开发者而言,这些分数尤为重要,而 Behemoth 目前在该类别中领先。
在图像推理方面,Behemoth 在 MMMU 上得分 76.1,高于 Gemini(71.8)、Claude(72.7)与 GPT-4.5(74.4)。尽管这并非其主要侧重领域,但它依旧能与领先的多模态模型竞争。
在代码生成上,Behemoth 在 LiveCodeBench 上得分 49.4,显著高于 Gemini 2.0 Pro(36.0)。
Llama 4 Scout 与 Llama 4 Maverick 均已可用,并遵循 Meta 的开源权重许可。您可以直接从官方 Llama 网站或通过 Hugging Face获取。
如果通过 Meta 自有服务访问模型,您可以在多个平台与 Meta AI 交互:WhatsApp、Messenger、Instagram 与 Facebook。目前访问需要使用 Meta 账号登录,且尚无独立的 Meta AI API 端点——至少目前还没有。
如果您计划将模型集成到自有应用或基础设施中,请注意许可条款:若您的产品或服务月活跃用户超过 7 亿,您需要从 Meta 另行获得许可。除此之外,这些模型可用于研究、实验以及大多数商业用例。
Scout 在单张 GPU 上带来了前所未有的上下文长度。Maverick 在推理、代码与多模态任务上与更大模型比肩。仍在训练中的 Behemoth 则展示了教师模型如何塑造更高效、可部署的变体。
开源权重领域的竞争比以往更为激烈。DeepSeek、Qwen、Gemma,以及即将加入的 OpenAI,都在不断推出强力版本。Llama 4 的到来,延续了 Meta 为多种用例提供可扩展、开放可用模型的持续努力。
用这些课程学习 AI!
课程
课程
实践并学习路径你的进步。
使用 Google 继续