
课程
Python 中的 Gymnasium 强化学习
4 小时
13.9K
实践并学习路径你的进步。
使用 Google 继续在讨论了动作价值函数的基本原理与用途后,接下来展示如何在 Python 中实现它。
导入必要的包,包括 Gymnasium 和 NumPy:
import gymnasium as gym
import numpy as np
import math
import random
从 Gymnasium 初始化一个 RL 环境。本文中,我们训练一个 RL 智能体来解决 CartPole 环境。
env = gym.make('CartPole-v1')CartPole 的观测空间包含四个状态:小车位置、小车速度、杆角度以及杆角速度。
在该示例中,我们仅关注杆角度与杆角速度两个观测。因此,按如下方式创建离散 Q 表:
列数基于动作空间大小确定,本例为 2。
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))
在 CartPole 环境中,状态空间是连续的。小车的角度、速度与位置可连续变化。动作空间是离散的——您可以将小车向左或向右推。
基于 Q 表的 Q-Learning 只能用于离散空间,因为需要对一组状态与动作的 Q 值进行显式列举。因此,第一步是将连续状态空间离散化。
我们先考虑状态空间变量的上下界。注意到小车速度与杆角速度的边界是无穷的,因此对这些状态变量人工设置上下界。
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]
创建一个函数,将连续状态值离散化:
def discretize_state(state):
    discrete_states = []

    for i in range(len(state)):
        if state[i] <= STATE_BOUNDS[i][0]:
            discrete_state = 0
        elif state[i] >= STATE_BOUNDS[i][1]:
            discrete_state = NUM_BUCKETS[i] - 1
        else:
            bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
            offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
            scaling = (NUM_BUCKETS[i] - 1) / bound_width
            discrete_state = int(round(scaling * state[i] - offset))
        discrete_states.append(discrete_state)
return tuple(discrete_states)贝尔曼方程给出了基于学习率、折扣率、进入下一步的奖励,以及下一状态的期望最大 Q 值来更新 Q 值的表达式。它将一个状态的期望值表示为两部分之和:
贝尔曼方程是递归的。因此,可以从一个随机初始状态出发,编写迭代程序来求解最优动作价值函数。
更新 Q 表的公式为:
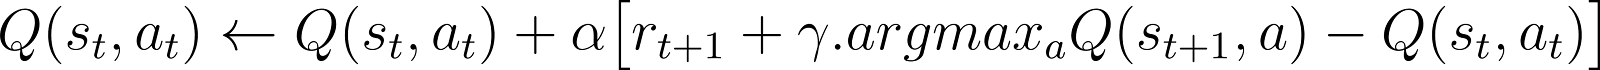
上式中:
state_current。state_next)。action)。reward 表示。best_q。下面的代码实现了更新 Q 表的函数
def update_q(state_current, state_next, action, reward, alpha):
    best_q = np.amax(q_table[state_next])
    q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_q声明训练参数:
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50
声明超参数:
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25
在训练智能体之前,编写两个函数以逐步衰减学习率与探索率。这些超参数会在整个训练过程中逐渐减小。
def decay_epsilon(step):
    return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))

def decay_alpha(step):
    return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
还需编写一个以随机方式选择动作的函数。我们先生成一个随机数。
def select_action(state, epsilon):
    if random.random() < epsilon:
        action = env.action_space.sample()
    else:
        action = np.argmax(q_table[state])
    return action
我们构建一个循环来训练智能体,步骤如下:
select_action() 函数选择动作。update_q() 函数更新 Q 表。下面的代码实现了训练循环的步骤:
def train():
    successful_episodes = 0
    for episode in range(MAX_EPISODES):
        epsilon = decay_epsilon(episode)
        alpha = decay_alpha(episode)
        observation, _ = env.reset()
        state_current = discretize_state(observation)
        for step in range(MAX_STEPS):
            action = select_action(state_current, epsilon)
            observation, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            state_next = discretize_state(observation)
            best_q = update_q(state_current, state_next, action, reward, alpha)
            state_current = state_next
            if done:
                print("Episode %d finished after %d time steps" % (episode, step))
                print("best q value: %f" % (float(best_q)))
                if (step >= SUCCESS_STEPS):
                    successful_episodes += 1
                    print("=============SUCCESS=============")
                else:
                    successful_episodes = 0
                    print("=============FAIL=============")
                break
            if successful_episodes > SUCCESS_STREAK:
                break
最后,运行训练循环,关闭环境,并打印 Q 表的最终值。
train()
env.close()
print(q_table)使用这份 DataLab 工作簿作为编辑并执行 Q-Learning 代码的起点。
在上一节中,我们将连续(状态)观测空间离散化以使用 Q 表。对于复杂环境,大型 Q 表在计算上低效。在此类情况下,可以使用神经网络来近似 Q 函数。这称为深度 Q 网络(DQN),记作 Q(s, a; θ),其中参数 θ 表示神经网络的权重。该方法称为深度 Q-learning。更广泛地说,使用深度神经网络的 RL 被称为深度强化学习。
DQN 不再使用 Q 表为每个状态选择动作,而是将状态作为输入,由神经网络返回该状态下每个可能动作的 Q 值。
网络通过传统方法(如反向传播)训练,以最小化时序差分(TD)误差。TD 误差 δ 为预测 Q 值与目标 Q 值之差(目标 Q 值计算为当前状态的奖励与下一状态期望最大奖励的折扣值之和)。
当以神经网络实现(网络参数为 θ)时,TD 误差表示为:

注意,预测的 Q 值与目标 Q 值均由同一神经网络计算。
在每次迭代中,网络参数(θ)都会更新。网络更新(通过反向传播)基于使用更新前的 θ 计算的目标值。如果用相同的已更新结果计算目标值,会导致目标不断移动,使训练不稳定。
为避免上述问题,我们创建一个新网络来计算目标 Q 值,即目标网络。它与策略网络具有相同的参数结构,但更新频率更低。这样,训练过程就有了一个相对稳定的目标来进行反向传播。
若用 θ- 表示目标网络的权重,则前式可改写为:

接下来的章节将展示如何在 CartPole 环境中实现并训练一个简单的 DQN。
安装必要的包,包括 Gymnasium 与 PyTorch。
!pip install gymnasium matplotlib torch在 Python 环境中导入所需包:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count

import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
创建 CartPole 环境:
env = gym.make("CartPole-v1")初始化环境,并用 Python 常量声明该环境的状态空间与动作空间的大小。
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.n
为一个包含单隐藏层的简单神经网络声明 Python 类。输入层数量等于状态空间(观测空间)大小。输出层数量等于 RL 智能体可采取的动作数。该网络在内部模拟 Q 表,并在给定输入状态时预测动作价值。
class DQN(nn.Module):

    def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
        super(DQN, self).__init__()
        self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
        self.layer2 = nn.Linear(128, 128)
        self.layer3 = nn.Linear(128, NUM_ACTIONS)

    def forward(self, x):
        x = F.relu(self.layer1(x))
        x = F.relu(self.layer2(x))
return self.layer3(x)创建策略网络与目标网络。使用状态字典将策略网络的参数加载到目标网络。初始化一个优化器以训练神经网络。
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())

optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)如上一节所述,off-policy 无模型 RL 方法(如 Q-Learning 与 DQN)通过随机采样智能体与环境的交互来训练。智能体的动作及环境的响应(奖励与下一状态)会被收集并存储。每次训练迭代会随机抽取一批交互样本组成训练批次。
声明一个元组对象,用于存储每次交互中的环境状态(观测):
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))创建回放缓冲区的 Python 类:
class ReplayMemory(object):

    def __init__(self, capacity):
        self.memory = deque([], maxlen=capacity)

    def push(self, *args):
        self.memory.append(Transition(*args))

    def sample(self, batch_size):
        return random.sample(self.memory, batch_size)

    def __len__(self):
        return len(self.memory)
创建一个存储大量交互的内存对象。这些交互用于训练智能体。
memory = ReplayMemory(10000)在训练前,声明参数与超参数:
LR)GAMMA)TAU)EPS_START、EPS_END 与 EPS_DECAY)MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4编写一个根据探索率选择动作的函数,步骤如下:
steps_done = 0
def select_action(state):
    global steps_done
    sample = random.random()
    eps_threshold = EPS_END + (EPS_START - EPS_END) * \
        math.exp(-1. * steps_done / EPS_DECAY)
    steps_done += 1
    if sample > eps_threshold:
        with torch.no_grad():
            action = policy_net(state).max(1).indices.view(1, 1)
            return action
    else:
        action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
        return action
编写优化模型的函数,步骤如下:
non_final_mask)来标识未进入终止状态的样本。non_final_next_states)。
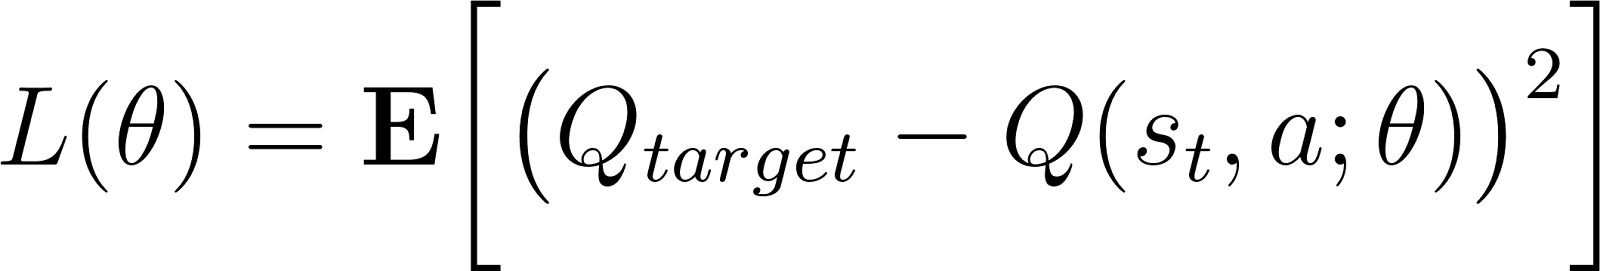
下面的代码展示了如何实现优化器:
batch = 0
def optimize_model():
    global batch
    if len(memory) < BATCH_SIZE:
        return
    transitions = memory.sample(BATCH_SIZE)
    batch = Transition(*zip(*transitions))

    non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
                                          batch.next_state)), dtype=torch.bool)
    non_final_next_states = torch.cat([s for s in batch.next_state
                                                if s is not None])
    state_batch = torch.cat(batch.state)
    action_batch = torch.cat(batch.action)
    reward_batch = torch.cat(batch.reward)

    state_action_values = policy_net(state_batch).gather(1, action_batch)
    next_state_values = torch.zeros(BATCH_SIZE )

    with torch.no_grad():
        next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values

    expected_state_action_values = (next_state_values * GAMMA) + reward_batch

    loss_func = nn.SmoothL1Loss()
    loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))

    optimizer.zero_grad()
    loss.backward()

    torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
    optimizer.step()
编写训练循环来训练智能体:
select_action() 函数决定智能体动作。以下代码实现了上述步骤:
def train():
    for episode in range(MAX_EPISODES):
        # Initialize the environment and get its state
        state, info = env.reset()
        state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
        for t in count():
            action = select_action(state)
            observation, reward, terminated, truncated, _ = env.step(action.item())
            reward = torch.tensor([reward])
            done = terminated or truncated

            if terminated:
                next_state = None
            else:
                next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)

            memory.push(state, action, next_state, reward)
            state = next_state
            optimize_model()

            target_net_state_dict = target_net.state_dict()
            policy_net_state_dict = policy_net.state_dict()
            for key in policy_net_state_dict:
                target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
            target_net.load_state_dict(target_net_state_dict)

            if done:
                episode_durations.append(t + 1)
                print('episode -- ', episode)
                print('count -- ', t)
                #plot_durations()
break您可以使用这份 DataLab 工作簿来查看、编辑并运行 DQN 训练程序。
在训练过程中进行可视化跟踪很有帮助。可视化动作价值有助于识别训练失败的环节,以及需要调整哪些参数或超参数。
例如,如果直观观察到模型性能提升过慢,您可能需要提高学习率;如果模型在学习但尚未完全收敛,增加训练回合数可能有所帮助;如果训练不稳定,您可能需要降低学习率,或调整探索系数,或目标网络(TAU)的更新速率。
除了 Q 值,绘制每个回合的成功步数也很有帮助。对于使用 Q 表的 Q-Learning,Q 值是显式存储的。然而,在 DQN 中并不显式存储 Q 值,网络根据其权重与状态输出动作。因此,对于 DQN,跟踪每回合的成功步数可能更有意义。
以下步骤描述了如何在训练 Q-learning 算法时绘制 Q 值与每回合的成功步数:
q_vals —— 用于存储每回合每一步的 Q 值。success_steps —— 用于存储每回合的成功步数。q_vals 数组success_steps 数组。下面的代码展示了对上一节 Q-Learning(使用 Q 表)训练循环的更新,以跟踪 Q 值与成功步数:
q_vals = []
success_steps = []

def train():
    global q_vals
    global success_steps
    successful_episodes = 0

    for episode in range(MAX_EPISODES):
        epsilon = decay_epsilon(episode)
        alpha = decay_alpha(episode)
        observation, _ = env.reset()
        state_current = discretize_state(observation)

        for step in range(MAX_STEPS):
            action = select_action(state_current, epsilon)
            observation, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            state_next = discretize_state(observation)
            best_q = update_q(state_current, state_next, action, reward, alpha)
            q_vals.append(best_q)
            state_current = state_next

            if done:
                q_vals.append(best_q)
                success_steps.append(step)
                print("Episode %d finished after %d time steps" % (episode, step))
                print("best q value: %f" % (float(best_q)))
                if (step >= SUCCESS_STEPS):
                    successful_episodes += 1
                else:
                    successful_episodes = 0
                break

            if successful_episodes > SUCCESS_STREAK:
                print("Training successful")
                return
下面代码展示了如何在每个回合中绘制 Q 值:
def plot_q():
    plt.plot(q_vals)
    plt.title('Q-values over training steps')
    plt.xlabel('Training steps')
    plt.ylabel('Q-value')
    plt.show()
下面代码展示了如何绘制每个回合的成功步数:
def plot_steps():
    plt.plot(success_steps)
    plt.title('Successful steps over training episodes')
    plt.xlabel('Training episode')
    plt.ylabel('Successful steps')
plt.show()需要明确判定智能体已成功训练的标准与时机。在传统机器学习中,训练目标是最小化损失:预测值与真实值的差异。在 RL 中,目标是最大化累积奖励。当智能体从环境中获得最大化的奖励时,训练被视为成功。
像 CartPole 这类环境,只有在达到某个终止条件(如撞边或倾斜过大)时才结束。在这种情况下,训练好的智能体可以无限期地与环境交互。因此,会人为设置最大成功步数。以 Gymnasium 的 CartPole-v1 为例,当在 500 个时间步内未终止时就结束回合。
我们在连续回合中评估智能体的表现,以判断训练是否成功。例如:
SUCCESS_STEPS)。本文示例将该阈值设为 450。SUCCESS_STREAK)。本例中 N 设为 50。作为一个实际示例,参考先前 DQN 训练循环中的这段代码。
if done:
  episode_durations.append(t + 1)
  print('episode -- ', episode)
  average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
  print('average steps over last 50 episodes -- ', average_steps)
  if average_steps > SUCCESS_STEPS:
      print("training successful.")
      return
  break
在每个训练回合结束(终止状态)时,执行以下步骤有助于评估智能体的表现:
SUCCESS_STREAK)为 50,因此计算最近 50 个回合的平均步数。SUCCESS_STEPS),则结束训练。本例中该阈值设为 450 步。以下是一些可帮助您更好地实现动作价值函数的最佳实践。
若已知真实动作价值函数,智能体可采用贪心策略,在每一步选择价值最高的动作以最大化期望回报。这称为对可用信息的利用。然而,用未训练的动作价值函数(尚未代表真实动作价值)进行贪心策略会导致陷入局部最优。
在训练过程中,同时探索环境与利用可用信息都很重要。
在训练初期,可用信息基于随机的价值函数,因此其可供贪心策略利用的价值不高。更重要的是探索环境,去发现不同状态下各种可能动作的奖励。
随着 Q 表被更新(或 DQN 被训练),逐步部分地利用可用信息来最大化奖励变得可行。到了训练后期,智能体会收敛到真实的价值函数;继续探索可能有害,因此应优先利用已知的价值函数。
与任何机器学习模型一样,超参数对成功训练 RL 算法至关重要。对于 Q-Learning 与 DQN,超参数包括 epsilon(探索率)、alpha(学习率)与 gamma(折扣率)。
最后,要理解 RL 训练对初始随机值较为敏感。若训练未能收敛,常见的做法是使用不同的随机种子或重新运行训练,以不同的随机初始值开始。
为复杂环境训练 RL 智能体具有挑战性。Q 函数被用于许多不同算法中,因此为基于 Q-learning 的 RL 智能体培养一定的直觉非常重要。最好的方法是在像 CartPole 这样更简单的环境中练习相关技术,再将类似方法应用到更复杂的环境中。
此外,复杂环境的训练成本更高,因此使用较简单的环境作为学习工具更为经济。
本文讨论了动作价值函数的基本理论原理及其在 RL 中的重要性。我们介绍了动作价值函数在 Q-learning 与深度 Q-learning 中的应用,并在 Python 中逐步实现了这两种方法。
若您希望继续学习,我强烈推荐《Python 深度强化学习》课程。
通过这些课程深入学习 AI!
课程
课程
实践并学习路径你的进步。
使用 Google 继续