

Triển khai Hàm Giá Trị Hành Động
Sau khi thảo luận các nguyên lý cơ bản và cách dùng của hàm giá trị hành động, bây giờ tôi trình bày các bước triển khai nó bằng Python.
Bước 1: Định nghĩa môi trường
Nhập các gói tiền đề, gồm Gymnasium và NumPy:
import gymnasium as gym
import numpy as np
import math
import randomKhởi tạo một môi trường RL từ Gymnasium. Trong bài này, chúng ta huấn luyện một tác tử RL để giải bài toán CartPole.
env = gym.make('CartPole-v1')Bước 2: Khởi tạo Q-table
Không gian quan sát của CartPole có bốn trạng thái: vị trí xe, vận tốc xe, góc cột, và vận tốc góc của cột.
Trong ví dụ này, chúng ta chỉ tập trung vào quan sát góc cột và vận tốc góc của cột. Do đó, tạo Q-table rời rạc như sau:
- Một trạng thái rời rạc cho vị trí xe — mọi giá trị khả dĩ được gom vào trạng thái đơn này.
- Một trạng thái rời rạc cho vận tốc xe
- Sáu trạng thái rời rạc cho góc cột
- Ba trạng thái rời rạc cho vận tốc của cột
Số cột dựa trên kích thước không gian hành động, trong trường hợp này là 2.
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))Trong môi trường CartPole, không gian trạng thái là liên tục. Góc, vận tốc và vị trí của cột xe thay đổi liên tục. Không gian hành động là rời rạc — bạn có thể đẩy xe sang trái hoặc phải.
Q-Learning dùng Q-table chỉ có thể áp dụng trên không gian rời rạc vì bạn cần lập bảng tường minh Q-value cho một tập các trạng thái và hành động. Vậy nên, bước đầu tiên là rời rạc hóa không gian trạng thái liên tục.
Trước hết, ta xét cận trên và cận dưới của các biến không gian trạng thái. Ta nhận thấy vận tốc xe và vận tốc góc của cột có cận vô hạn. Vì vậy, ta đặt cận trên và cận dưới nhân tạo cho các biến trạng thái này.
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]Tạo một hàm để rời rạc hóa các giá trị trạng thái liên tục thành rời rạc:
def discretize_state(state):
discrete_states = []
for i in range(len(state)):
if state[i] <= STATE_BOUNDS[i][0]:
discrete_state = 0
elif state[i] >= STATE_BOUNDS[i][1]:
discrete_state = NUM_BUCKETS[i] - 1
else:
bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
scaling = (NUM_BUCKETS[i] - 1) / bound_width
discrete_state = int(round(scaling * state[i] - offset))
discrete_states.append(discrete_state)
return tuple(discrete_states)Bước 3: Cập nhật Q-table
Phương trình Bellman cho biểu thức cập nhật Q-value dựa trên tốc độ học, hệ số chiết khấu, phần thưởng ở bước kế tiếp, và Q-value cực đại kỳ vọng của trạng thái tiếp theo. Nó biểu diễn giá trị kỳ vọng của một trạng thái như tổng của hai phần:
- Phần thưởng tức thời khi chuyển sang trạng thái kế tiếp
- Giá trị kỳ vọng đã chiết khấu của trạng thái kế tiếp
Phương trình Bellman là đệ quy. Do đó, có thể viết một chương trình lặp, bắt đầu từ một trạng thái khởi tạo ngẫu nhiên, để tìm hàm giá trị hành động tối ưu.
Phương trình cập nhật Q-table là:
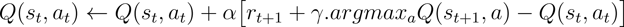
Trong biểu thức trên:
- Trạng thái hiện tại là st, được ký hiệu là
state_currenttrong mã. - Trạng thái kế tiếp là st+1 (
state_next). - Hành động thực hiện tại trạng thái hiện tại là at (
action). - Q(st, at) là Q-value hiện tại cho trạng thái st và hành động at
- α là tốc độ học (learning rate).
- γ là hệ số chiết khấu (discount factor).
- rt+1 là phần thưởng sau khi thực hiện hành động at ở bước hiện tại với trạng thái st. Trong mã dưới đây, điều này được biểu diễn là
reward. - argmaxa Q(st+1, a) là Q-value lớn nhất của trạng thái kế tiếp st+1. Trong đoạn mã dưới, điều này được biểu diễn là
best_q.
Đoạn mã dưới đây triển khai hàm để cập nhật Q-table
def update_q(state_current, state_next, action, reward, alpha):
best_q = np.amax(q_table[state_next])
q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qBước 4: Huấn luyện tác tử
Khai báo các tham số huấn luyện:
- Số tập huấn luyện tối đa
- Số bước tối đa mỗi tập đến từ tài liệu của môi trường. Với CartPole-v1, là 500.
- Số bước tác tử cần hoàn thành để tập được phân loại là thành công. Ta đặt là 450.
- Số tập liên tiếp tác tử cần hoàn thành để coi việc huấn luyện thành công. Ta đặt là 50.
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50Khai báo các siêu tham số:
- Giá trị nhỏ nhất và lớn nhất của tỷ lệ khám phá, ε
- Giá trị nhỏ nhất và lớn nhất của tốc độ học, α
- Tốc độ suy giảm của α và γ
- Hệ số chiết khấu, γ
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25Trước khi huấn luyện tác tử, ta viết hai hàm để giảm dần tốc độ học và tỷ lệ khám phá. Những siêu tham số này giảm dần giá trị trong suốt quá trình huấn luyện.
def decay_epsilon(step):
return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
def decay_alpha(step):
return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))Ta cũng viết một hàm để chọn hành động theo xác suất. Trước tiên sinh một số ngẫu nhiên.
- Nếu số ngẫu nhiên này nhỏ hơn ε, ta chọn ngẫu nhiên một hành động từ không gian hành động. Đây là chiến lược khám phá.
- Nếu số ngẫu nhiên lớn hơn ε, ta chọn hành động tương ứng với Q-value lớn nhất. Đây là chiến lược khai thác.
def select_action(state, epsilon):
if random.random() < epsilon:
action = env.action_space.sample()
else:
action = np.argmax(q_table[state])
return actionTa xây dựng một vòng lặp để huấn luyện tác tử dựa trên các bước sau:
- Lấy các giá trị suy giảm của α và ε cho tập hiện tại.
- Đặt lại môi trường và rời rạc hóa không gian quan sát để bắt đầu môi trường mới cho tập.
- Chạy tác tử trong môi trường cho đến khi đạt số bước tối đa hoặc kết thúc.
- Với mỗi bước:
- Chọn hành động theo hàm
select_action()đã khai báo trước. - Thực thi hành động trên môi trường để nhận phần thưởng và trạng thái kế tiếp.
- Lấy Q-value cao nhất từ Q-table.
- Cập nhật Q-table theo hàm
update_q()đã khai báo trước.
Đoạn mã dưới đây triển khai các bước của vòng lặp huấn luyện:
def train():
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
state_current = state_next
if done:
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
print("=============SUCCESS=============")
else:
successful_episodes = 0
print("=============FAIL=============")
break
if successful_episodes > SUCCESS_STREAK:
breakCuối cùng, chạy vòng lặp huấn luyện, đóng môi trường, và in giá trị cuối của Q-table.
train()
env.close()
print(q_table)Sử dụng DataLab workbook này làm điểm khởi đầu để chỉnh sửa và thực thi mã Q-Learning.
Mở rộng sang Deep Q-Learning
Ở phần trước, chúng ta đã rời rạc hóa không gian quan sát (trạng thái) liên tục để dùng Q-table. Một Q-table lớn (với môi trường phức tạp) kém hiệu quả tính toán. Trong các trường hợp đó, hàm Q có thể được xấp xỉ bằng mạng nơ-ron. Đây được gọi là Deep Q-Network, ký hiệu Q(s, a; θ), trong đó tham số θ biểu diễn trọng số của mạng nơ-ron. Phương pháp này gọi là Deep Q-learning. Nói chung hơn, RL dùng mạng nơ-ron sâu được gọi là Học tăng cường sâu.
Thay vì dùng Q-Table để chọn hành động cho mỗi trạng thái, mạng DQN nhận trạng thái làm đầu vào và trả về Q-value cho mỗi hành động khả dĩ tại trạng thái đó.
Mạng được huấn luyện bằng các phương pháp truyền thống (như lan truyền ngược) để giảm sai số khác biệt theo thời gian (TD). Sai số TD δ là chênh lệch giữa Q-value dự đoán và Q-value mục tiêu (tính là tổng phần thưởng từ trạng thái hiện tại và giá trị chiết khấu của phần thưởng kỳ vọng lớn nhất từ trạng thái kế tiếp).
Khi được triển khai dưới dạng mạng nơ-ron (với tham số mạng θ), sai số TD được biểu diễn như sau:
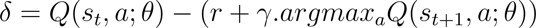
Lưu ý rằng cả Q-value và Q-value mục tiêu đều được tính bằng cùng một mạng nơ-ron.
Ở mỗi vòng lặp, các tham số mạng (θ) được cập nhật. Việc cập nhật mạng (qua backprop) dựa trên giá trị mục tiêu được tính bằng θ trước khi cập nhật. Tính giá trị mục tiêu bằng cùng tham số vừa cập nhật dẫn đến mục tiêu liên tục thay đổi. Điều này làm quá trình huấn luyện không ổn định.
Để tránh vấn đề trên, ta tạo một mạng mới để tính Q-value mục tiêu. Đây là mạng mục tiêu (target network). Nó dựa trên cùng tham số như mạng chính sách nhưng được cập nhật ít thường xuyên hơn. Nhờ vậy, quá trình huấn luyện có một mục tiêu ổn định để áp dụng lan truyền ngược.
Nếu biểu diễn trọng số của mạng mục tiêu là θ-, phương trình trước đó được viết lại như sau:
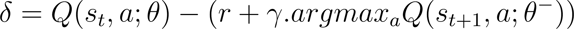
Các phần sau sẽ cho thấy cách triển khai và huấn luyện một DQN đơn giản trong môi trường CartPole.
Ví dụ triển khai
Cài đặt các gói tiền đề, gồm Gymnasium và PyTorch.
!pip install gymnasium matplotlib torchNhập các gói cần thiết trong môi trường Python:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as FTạo môi trường CartPole:
env = gym.make("CartPole-v1")Khởi tạo môi trường và khai báo hằng số Python với kích thước không gian trạng thái và hành động của môi trường.
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.nKhai báo một lớp Python cho mạng nơ-ron đơn giản với một tầng ẩn. Số lượng tầng vào bằng kích thước không gian trạng thái (không gian quan sát). Số lượng tầng ra bằng số hành động khả dĩ mà tác tử RL có thể thực hiện. Mạng này nội bộ mô phỏng Q-table và dự đoán giá trị hành động cho một trạng thái đầu vào.
class DQN(nn.Module):
def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
super(DQN, self).__init__()
self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
self.layer2 = nn.Linear(128, 128)
self.layer3 = nn.Linear(128, NUM_ACTIONS)
def forward(self, x):
x = F.relu(self.layer1(x))
x = F.relu(self.layer2(x))
return self.layer3(x)Tạo mạng chính sách và mạng mục tiêu. Nạp tham số của mạng mục tiêu từ mạng chính sách bằng state dictionary. Khởi tạo một bộ tối ưu để huấn luyện mạng nơ-ron.
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())
optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)Huấn luyện với bộ nhớ phát lại
Các phương pháp RL off-policy không dựa trên mô hình như Q-Learning (thảo luận ở phần trước) và DQN được huấn luyện bằng mẫu ngẫu nhiên từ các tương tác của tác tử với môi trường. Hành động của tác tử và phản hồi của môi trường (phần thưởng và trạng thái tiếp theo) được thu thập và lưu trữ. Mỗi vòng huấn luyện chọn ngẫu nhiên một mẫu các tương tác này để tạo một batch huấn luyện.
Khai báo một đối tượng tuple để lưu trạng thái (quan sát) của môi trường ở mỗi tương tác:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))Tạo một lớp Python cho bộ nhớ phát lại:
class ReplayMemory(object):
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, *args):
self.memory.append(Transition(*args))
def sample(self, batch_size):
return random.sample(self.memory, batch_size)
def __len__(self):
return len(self.memory)Tạo một đối tượng bộ nhớ để lưu trữ số lượng lớn các tương tác. Những tương tác này được dùng để huấn luyện tác tử.
memory = ReplayMemory(10000)Trước khi huấn luyện, khai báo các tham số và siêu tham số:
- Tham số:
- Kích thước batch
- Số tập huấn luyện tối đa
- Siêu tham số:
- Tốc độ học (
LR) - Hệ số chiết khấu (
GAMMA) - Tốc độ cập nhật mạng mục tiêu (
TAU) - Giá trị đầu và cuối của tỷ lệ khám phá, và tốc độ suy giảm (
EPS_START,EPS_END, vàEPS_DECAY)
MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4Viết hàm chọn hành động dựa trên tỷ lệ khám phá, theo các bước:
- Tính tỷ lệ khám phá dựa trên số bước trong tập (và giá trị đầu, cuối cùng như tốc độ suy giảm của tỷ lệ khám phá).
- Sinh một số ngẫu nhiên.
- Nếu số ngẫu nhiên lớn hơn tỷ lệ khám phá, chọn hành động được mạng chính sách dự đoán.
- Nếu nhỏ hơn tỷ lệ khám phá, chọn một hành động ngẫu nhiên từ không gian hành động.
steps_done = 0
def select_action(state):
global steps_done
sample = random.random()
eps_threshold = EPS_END + (EPS_START - EPS_END) * \
math.exp(-1. * steps_done / EPS_DECAY)
steps_done += 1
if sample > eps_threshold:
with torch.no_grad():
action = policy_net(state).max(1).indices.view(1, 1)
return action
else:
action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
return actionViết hàm tối ưu mô hình theo các bước:
- Tạo một batch bằng mẫu ngẫu nhiên các tương tác của tác tử với môi trường. Mỗi phần tử trong mẫu tương ứng một bước thời gian. Nó chứa:
- Trạng thái hiện tại của môi trường
- Hành động của tác tử
- Phần thưởng nhận được
- Trạng thái tiếp theo
- Trong CartPole, mong đợi tác tử tiếp tục điều khiển cột xe mà không kết thúc (đụng biên hoặc đổ). Vì vậy, ta chỉ xét các tương tác không dẫn đến trạng thái kết thúc. Tạo một mặt nạ (
non_final_mask) để xác định các trạng thái không theo sau bởi trạng thái kết thúc. - Xác định các trạng thái không theo sau bởi trạng thái kết thúc (
non_final_next_states). - Lấy các giá trị trạng thái–hành động cho tất cả trạng thái hiện tại st bằng cách đưa trạng thái hiện tại vào mạng chính sách.
- Lấy các giá trị trạng thái–hành động kỳ vọng cho tất cả trạng thái kế tiếp st+1 bằng cách đưa trạng thái kế tiếp vào mạng mục tiêu và sửdụng phương trình:
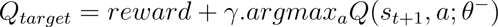
- Tính loss dựa trên chênh lệch giữa các giá trị hành động và các giá trị hành động kỳ vọng:
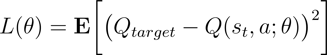
- Lan truyền ngược loss để tính gradient.
- Cắt (clip) giá trị gradient và cập nhật mạng chính sách để đảm bảo huấn luyện ổn định.
Mã dưới đây cho thấy cách triển khai bộ tối ưu:
batch = 0
def optimize_model():
global batch
if len(memory) < BATCH_SIZE:
return
transitions = memory.sample(BATCH_SIZE)
batch = Transition(*zip(*transitions))
non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
batch.next_state)), dtype=torch.bool)
non_final_next_states = torch.cat([s for s in batch.next_state
if s is not None])
state_batch = torch.cat(batch.state)
action_batch = torch.cat(batch.action)
reward_batch = torch.cat(batch.reward)
state_action_values = policy_net(state_batch).gather(1, action_batch)
next_state_values = torch.zeros(BATCH_SIZE )
with torch.no_grad():
next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values
expected_state_action_values = (next_state_values * GAMMA) + reward_batch
loss_func = nn.SmoothL1Loss()
loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))
optimizer.zero_grad()
loss.backward()
torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
optimizer.step()Viết một vòng lặp huấn luyện để huấn luyện tác tử:
- Đặt lại môi trường và bắt đầu một tập mới.
- Sử dụng hàm
select_action()để quyết định hành động của tác tử. - Nhận phần thưởng và trạng thái kế tiếp từ môi trường dựa trên hành động.
- Thêm trạng thái, hành động, trạng thái kế tiếp và phần thưởng vào bộ nhớ phát lại.
- Chạy bộ tối ưu (đã định nghĩa ở trên). Bộ tối ưu tính Q-value và loss, áp dụng lan truyền ngược để cập nhật mạng.
- Cập nhật mạng mục tiêu dựa trên mạng chính sách.
- Tiếp tục tập cho đến khi đạt trạng thái kết thúc.
Đoạn mã sau triển khai các bước này:
def train():
for episode in range(MAX_EPISODES):
# Initialize the environment and get its state
state, info = env.reset()
state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
for t in count():
action = select_action(state)
observation, reward, terminated, truncated, _ = env.step(action.item())
reward = torch.tensor([reward])
done = terminated or truncated
if terminated:
next_state = None
else:
next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)
memory.push(state, action, next_state, reward)
state = next_state
optimize_model()
target_net_state_dict = target_net.state_dict()
policy_net_state_dict = policy_net.state_dict()
for key in policy_net_state_dict:
target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
target_net.load_state_dict(target_net_state_dict)
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
print('count -- ', t)
#plot_durations()
breakBạn có thể xem, chỉnh sửa và chạy chương trình huấn luyện DQN bằng DataLab workbook này.
Trực quan hóa Hàm Giá Trị Hành Động
Việc theo dõi trực quan tiến trình huấn luyện rất hữu ích. Trực quan hóa các giá trị hành động giúp nhận ra nơi quá trình huấn luyện đang thất bại và các tham số hay siêu tham số nào cần thay đổi.
Ví dụ, nếu bạn quan sát thấy cải thiện hiệu năng mô hình quá chậm, có thể muốn tăng tốc độ học. Nếu nhận thấy mô hình đang học nhưng chưa được huấn luyện đầy đủ, tăng số tập huấn luyện có thể hữu ích. Nếu thấy huấn luyện không ổn định, bạn có thể giảm tốc độ học hoặc điều chỉnh hệ số khám phá, hoặc tốc độ cập nhật của mạng mục tiêu (TAU).
Ngoài Q-value, việc vẽ số bước thành công trong mỗi tập cũng hữu ích. Trong Q-Learning dùng Q-table, Q-value được lưu tường minh. Tuy nhiên, khi dùng DQN, Q-value không được lưu tường minh. Mạng xuất ra hành động tùy theo trọng số và trạng thái. Vì vậy, theo dõi số bước thành công trong mỗi tập có thể ý nghĩa hơn với DQN.
Các bước sau mô tả cách vẽ Q-value và số bước thành công mỗi tập khi huấn luyện thuật toán Q-learning:
- Tạo hai mảng rỗng ở đầu quá trình huấn luyện:
q_vals- để lưu Q-value ở mỗi bước của mỗi tập.success_steps- để lưu số bước thành công ở mỗi tập.- Ở mỗi bước (trong tất cả các tập):
- Thêm Q-value của bước đó vào mảng
q_vals. - Sau khi mỗi tập kết thúc, thêm vào mảng
success_stepssố bước thành công của tập đó. - Vẽ cả hai mảng.
Đoạn mã dưới đây cho thấy vòng lặp huấn luyện Q-Learning (dùng Q-table) ở phần trước được cập nhật để theo dõi Q-value và số bước thành công:
q_vals = []
success_steps = []
def train():
global q_vals
global success_steps
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
q_vals.append(best_q)
state_current = state_next
if done:
q_vals.append(best_q)
success_steps.append(step)
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
else:
successful_episodes = 0
break
if successful_episodes > SUCCESS_STREAK:
print("Training successful")
returnĐoạn sau cho thấy cách vẽ Q-value trong mỗi tập:
def plot_q():
plt.plot(q_vals)
plt.title('Q-values over training steps')
plt.xlabel('Training steps')
plt.ylabel('Q-value')
plt.show()Đoạn sau cho thấy cách vẽ số bước thành công trong mỗi tập:
def plot_steps():
plt.plot(success_steps)
plt.title('Successful steps over training episodes')
plt.xlabel('Training episode')
plt.ylabel('Successful steps')
plt.show()- DataLab workbook triển khai Q-learning bằng hàm giá trị hành động cũng bao gồm mã vẽ Q-value và số bước thành công mỗi tập.
- Notebook triển khai DQN cũng bao gồm mã vẽ số bước thành công mỗi tập.
Đánh giá hiệu năng tác tử
Cần chỉ định tiêu chí để quyết định khi nào tác tử đã được huấn luyện thành công. Trong ML truyền thống, mục tiêu huấn luyện là giảm thiểu loss: chênh lệch giữa giá trị dự đoán và giá trị thật. Trong RL, mục tiêu là tối đa hóa phần thưởng tích lũy. Việc huấn luyện được coi là thành công khi tác tử thu được phần thưởng tối đa từ môi trường.
Các môi trường như CartPole không kết thúc cho đến khi đạt điều kiện dừng, như đụng biên hoặc để cột xe nghiêng quá mức. Trong các trường hợp đó, một tác tử đã huấn luyện có thể tiếp tục tương tác với môi trường vô thời hạn. Vì vậy, số bước thành công tối đa được áp đặt nhân tạo. Với CartPole-v1 của Gymnasium, tập được kết thúc khi đạt 500 bước thời gian mà không dừng.
Chúng ta đánh giá hiệu năng của tác tử qua các tập liên tiếp để xác định việc huấn luyện có thành công hay không. Ví dụ:
- Tác tử có thể hoàn thành nhiều hơn một ngưỡng số bước (
SUCCESS_STEPS) trung bình trong N tập cuối. Trong ví dụ của bài viết, chúng ta đặt ngưỡng này là 450. - Tác tử vượt ngưỡng trong N tập liên tiếp (
SUCCESS_STREAK). Ở ví dụ này, N được đặt là 50.
Ví dụ thực tế, hãy xét đoạn mã trong vòng lặp huấn luyện DQN đã trình bày trước đó.
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
print('average steps over last 50 episodes -- ', average_steps)
if average_steps > SUCCESS_STEPS:
print("training successful.")
return
breakViệc đánh giá hiệu năng của tác tử hữu ích khi thực hiện các bước sau vào cuối (trạng thái kết thúc) của mỗi tập huấn luyện:
- Thêm tổng số bước trong tập này (trước khi kết thúc) vào một mảng. Mảng này theo dõi tổng số bước trong mỗi tập.
- Tính trung bình N giá trị cuối trong mảng này. Trong ví dụ này, N (
SUCCESS_STREAK) là 50. Vậy, ta tính trung bình số bước trên 50 tập cuối. - Nếu trung bình này lớn hơn một ngưỡng (
SUCCESS_STEPS), ta dừng huấn luyện. Trong ví dụ này, ngưỡng đặt ở 450 bước.
Thực hành tốt khi sử dụng Hàm Giá Trị Hành Động
Dưới đây là một số thực hành tốt bạn có thể áp dụng để đạt kết quả tốt hơn khi triển khai hàm giá trị hành động.
Cân bằng khám phá và khai thác
Khi biết đúng hàm giá trị hành động, tác tử có thể tối đa hóa return kỳ vọng bằng chiến lược tham lam, dựa trên chọn hành động có giá trị cao nhất ở mỗi bước. Đây gọi là khai thác thông tin sẵn có. Tuy nhiên, dùng chiến lược tham lam với một hàm giá trị hành động chưa được huấn luyện (chưa phản ánh đúng giá trị thật) sẽ dẫn đến mắc kẹt ở cực trị địa phương.
Trong quá trình huấn luyện, điều quan trọng là vừa khám phá môi trường vừa khai thác thông tin sẵn có.
Ở giai đoạn đầu của huấn luyện, thông tin sẵn có dựa trên một hàm giá trị ngẫu nhiên. Do đó, thông tin này không quá giá trị (để khai thác bằng chiến lược tham lam). Việc khám phá môi trường để phát hiện phần thưởng từ các hành động khả dĩ trong những trạng thái khác nhau quan trọng hơn.
Khi Q-table được cập nhật (hoặc DQN được huấn luyện), dần trở nên hợp lý để phần nào khai thác thông tin sẵn có nhằm tối đa hóa phần thưởng. Về cuối quá trình huấn luyện, tác tử hội tụ tới hàm giá trị thật; việc khám phá thêm có thể gây bất lợi. Do đó, tác tử ưu tiên khai thác hàm giá trị đã biết.
Điều chỉnh siêu tham số
Như với mọi mô hình học máy, siêu tham số rất quan trọng để huấn luyện thành công các thuật toán RL. Với Q-Learning và DQN, các siêu tham số gồm epsilon (tỷ lệ khám phá), alpha (tốc độ học), và gamma (tỷ lệ chiết khấu).
- ε (epsilon) điều khiển cân bằng giữa khám phá và khai thác (đã thảo luận ở trên). Epsilon càng cao thì khám phá càng quan trọng so với khai thác. Ở đầu quá trình huấn luyện, nó có giá trị cao như 0.9, được giảm dần xuống giá trị nhỏ như 0.05 về cuối quá trình.
- α (alpha) là tốc độ học (LR). Nó điều khiển mức độ mà các tham số mạng nơ-ron (trong DQN) hoặc giá trị của Q-Table thay đổi ở mỗi vòng huấn luyện. Nếu LR quá cao, mô hình trở nên không ổn định và không hội tụ. Ngược lại, LR thấp dẫn tới hội tụ chậm. Thông thường cũng bắt đầu với LR cao ở đầu quá trình khi tác tử cần khám phá môi trường. Khi tiến gần tới giá trị thật của hàm Q, LR được giảm để giúp mạng hội tụ.
- γ (gamma) là tỷ lệ chiết khấu. Nó quyết định tầm quan trọng của phần thưởng ở các bước sau so với phần thưởng tức thời. Giá trị gamma cao nghĩa là phần thưởng về sau quan trọng. Gamma bằng 0 nghĩa là chỉ phần thưởng ở bước hiện tại quan trọng, phần thưởng sau đó không có ý nghĩa. Trong các thuật toán như Q-learning, tổng return dựa trên phần thưởng kiếm được trong suốt cả tập. Vì vậy, dùng tỷ lệ chiết khấu cao như 0.99 là phổ biến.
Cuối cùng, hiểu rằng huấn luyện RL nhạy với các giá trị ngẫu nhiên khởi tạo. Nếu huấn luyện không hội tụ, thường hữu ích khi dùng seed ngẫu nhiên khác hoặc chạy lại để bắt đầu với tập giá trị khởi tạo ngẫu nhiên khác.
Bắt đầu với môi trường đơn giản
Huấn luyện tác tử RL cho môi trường phức tạp rất thách thức. Hàm Q được dùng trong nhiều thuật toán khác nhau, nên điều quan trọng là xây dựng trực giác cho việc huấn luyện các tác tử RL dựa trên Q-learning. Tốt nhất là thực hành các kỹ thuật trên các môi trường đơn giản như CartPole trước khi áp dụng phương pháp tương tự cho môi trường phức tạp hơn.
Hơn nữa, môi trường phức tạp tốn kém hơn để huấn luyện, nên dùng môi trường đơn giản làm công cụ học tập sẽ kinh tế hơn.
Kết luận
Bài viết này đã thảo luận các nguyên lý lý thuyết nền tảng của hàm giá trị hành động và tầm quan trọng của nó trong RL. Chúng ta đã đề cập cách sử dụng hàm giá trị hành động trong Q-learning và Deep Q-learning, và triển khai cả hai phương pháp từng bước bằng Python.
Để tiếp tục học, tôi rất khuyến nghị khóa Deep Reinforcement Learning in Python.
FAQs
Sự khác nhau giữa hàm giá trị và hàm giá trị hành động trong RL là gì?
Hàm giá trị ước lượng return kỳ vọng từ một trạng thái, trong khi hàm giá trị hành động (hàm Q) ước lượng return khi thực hiện một hành động cụ thể tại một trạng thái và sau đó theo sách lược. Hàm giá trị hành động cung cấp hướng dẫn chi tiết hơn cho việc ra quyết định.
Vì sao hàm giá trị hành động quan trọng trong Q-learning?
Q-learning sử dụng hàm giá trị hành động để dẫn tác tử tới các hành động mang lại phần thưởng kỳ vọng cao nhất. Hàm này cho phép học off-policy và giúp tác tử dần hội tụ tới chiến lược tối ưu theo thời gian.
Hàm giá trị hành động liên hệ với phương trình Bellman như thế nào?
Phương trình Bellman cung cấp công thức đệ quy để cập nhật Q-value dựa trên phần thưởng tức thời và phần thưởng tối đa trong tương lai đã chiết khấu. Đây là nền tảng để học hàm giá trị hành động một cách lặp.
Tôi có thể dùng hàm giá trị hành động trong không gian trạng thái liên tục không?
Có, nhưng Q-table trở nên không khả thi trong không gian liên tục. Khi đó, Deep Q-Network (DQN) được dùng để xấp xỉ hàm giá trị hành động bằng mạng nơ-ron thay vì bảng tường minh.
Vai trò của khám phá trong việc ước lượng hàm giá trị hành động là gì?
Khám phá đảm bảo tác tử không hội tụ sớm vào một sách lược kém tối ưu. Nó giúp tác tử thu thập trải nghiệm đa dạng, điều cần thiết để ước lượng chính xác hàm giá trị hành động trong quá trình huấn luyện.
Chiến lược ε-greedy ảnh hưởng đến học Q-value như thế nào?
Chiến lược ε-greedy cân bằng khám phá và khai thác. Với xác suất ε, tác tử khám phá hành động mới, và với 1–ε, nó khai thác hành động hiện được xem là tốt nhất. Sự đánh đổi này cải thiện độ ổn định và hội tụ khi học Q-value.
Khi nào nên chuyển từ Q-learning sang Deep Q-learning?
Khi môi trường có không gian trạng thái lớn hoặc liên tục, việc duy trì Q-table trở nên kém hiệu quả. Deep Q-learning thay thế bảng bằng mạng nơ-ron, có khả năng mở rộng tốt hơn cho môi trường phức tạp.
Làm thế nào để trực quan hóa hàm giá trị hành động trong lúc huấn luyện?
Bạn có thể vẽ các Q-value cực đại theo thời gian hoặc theo dõi phần thưởng mỗi tập để giám sát tiến trình học. Trực quan hóa giúp chẩn đoán các vấn đề như hội tụ kém hoặc thiếu khám phá.
Những thách thức chính khi huấn luyện hàm giá trị hành động là gì?
Thách thức gồm có huấn luyện không ổn định do mục tiêu thay đổi, khám phá kém, và thiết lập siêu tham số chưa tối ưu. Dùng kỹ thuật như bộ nhớ phát lại và mạng mục tiêu giúp giảm thiểu các vấn đề này.
Hàm giá trị hành động có được dùng trong các thuật toán on-policy không?
Có, các thuật toán như SARSA sử dụng hàm giá trị hành động nhưng cập nhật nó dựa trên hành động thực sự được thực hiện bởi sách lược hiện tại. Điều này khác với phương pháp off-policy như Q-learning vốn dùng Q-value cực đại của trạng thái kế tiếp.

Arun là cựu nhà sáng lập startup, yêu thích xây dựng những điều mới mẻ. Hiện tại, anh đang khám phá các nền tảng kỹ thuật và toán học của Trí tuệ Nhân tạo. Anh thích chia sẻ những gì mình học được, vì thế anh viết về chúng.
Bên cạnh DataCamp, bạn có thể đọc các bài viết của anh trên Medium, Airbyte và Vultr.


Học tăng cường (RL) là một mô hình học máy trong đó tác tử (agent) học cách đưa ra quyết định đúng đắn bằng cách tương tác với môi trường bên ngoài. Môi trường cung cấp phản hồi, dưới dạng phần thưởng, khi thực hiện hành động đúng.
Mục tiêu của tác tử là tối đa hóa tổng phần thưởng tích lũy. Trong nhiều bài toán thực tế, phản hồi cho tác tử đến từ con người; điều này được gọi là RL với phản hồi từ con người (RLHF).
RLHF thường được dùng để tinh chỉnh LLM nhằm tạo đầu ra phù hợp với các giá trị và sở thích của con người. Khi AI được dùng để cung cấp phản hồi, điều đó được gọi là RL với phản hồi từ AI.
Tác tử sử dụng hàm giá trị hành động để đánh giá hành động nên chọn ở mỗi bước. Một hàm giá trị hành động được tối ưu giúp tác tử chọn hành động tốt nhất ở mỗi bước để tối đa hóa phần thưởng tích lũy.
Trong hướng dẫn này, tôi sẽ giới thiệu hàm giá trị hành động, giải thích vai trò của nó trong RL, và chỉ cho bạn cách tự triển khai từ đầu.
Hàm Giá Trị Hành Động là gì?
Hàm giá trị hành động (Q) ước lượng phần thưởng tích lũy kỳ vọng (return) đạt được khi thực hiện một hành động cụ thể (a) tại một trạng thái nhất định (s) và sau đó đi theo sách lược π . Ký hiệu là Qπ(s,a). Khi hiển nhiên tác tử đang theo sách lược tối ưu, có thể viết gọn là Q(s,a).
Hàm giá trị hành động được dùng để chọn hành động dẫn đến return cao nhất kể từ một trạng thái cho trước. Sách lược tối ưu (π*) tối đa hóa return kỳ vọng. Vì vậy, tại mỗi trạng thái s, sách lược chọn hành động dẫn đến return kỳ vọng cao nhất. Sách lược tối ưu được biểu diễn là π* = argmaxa Q(s,a).
Hàm Q truyền thống được mô hình hóa dưới dạng Q-table. Bảng này lưu giá trị của mỗi hành động khả dĩ cho mỗi trạng thái khả dĩ của môi trường. Với môi trường phức tạp, bảng này trở nên quá lớn và kém hiệu quả. Do đó, với hầu hết môi trường không tầm thường, ta mô hình hóa Q-table bằng một mạng nơ-ron thay vì bảng. Mạng này xấp xỉ hàm của Q-table. Với một trạng thái đầu vào, nó xuất ra các giá trị hành động tương ứng với trạng thái đó.
Vì sao Hàm Giá Trị Hành Động quan trọng trong RL
Khi biết đúng hàm giá trị hành động, sách lược nên chọn hành động dẫn đến phần thưởng kỳ vọng cao nhất. Chiến lược này được gọi là khai thác (exploitation). Tuy nhiên, trong giai đoạn huấn luyện, hàm giá trị hành động thật chưa được biết. Vì thế, việc chọn hành động dựa trên thông tin không đầy đủ. Khai thác (tối đa hóa return) dựa trên thông tin thiếu hụt có thể dẫn đến không khám phá được hàm giá trị hành động thật và mắc kẹt ở cực trị địa phương.
Ngược lại, một chiến lược khám phá đôi khi chọn các hành động chưa tối ưu, nhưng có thể cuối cùng dẫn tới trạng thái có giá trị cao hơn. Điều này được triển khai bằng chiến lược ε - greedy, trong đó ε là một giá trị nhỏ. Sách lược chọn ngẫu nhiên một hành động chưa tối ưu với xác suất ε và hành động tối đa hóa phần thưởng với xác suất 1 - ε.
Áp dụng một chiến lược cân bằng giữa khai thác và khám phá cho phép tác tử khám phá các đường đi thay thế trong môi trường, dẫn đến phần thưởng tích lũy tốt hơn.
Nền tảng của các thuật toán RL
Thuật toán RL có thể được phân loại theo hai trục lớn: 1) dựa trên mô hình và không dựa trên mô hình, và 2) on-policy và off-policy.
Thuật toán dựa trên mô hình và không dựa trên mô hình
Trong các phương pháp dựa trên mô hình, bạn cố gắng dự đoán mô hình phân phối xác suất của môi trường P(r, s' | s, a) - xác suất nhận được phần thưởng r và đạt đến trạng thái s' khi xuất phát từ trạng thái s và thực hiện hành động a.
Các phương pháp này sử dụng tương tác của tác tử với môi trường để tinh chỉnh mô hình (của môi trường) và cải thiện dự đoán phần thưởng và trạng thái. Nhờ đó, tác tử có thể mô phỏng môi trường thông qua mô hình, mà không nhất thiết phải tương tác thực với môi trường ở mỗi bước.
Một số thuật toán dựa trên mô hình như Dyna-Q cập nhật hàm Q thông qua trải nghiệm mô phỏng. Những phương pháp này được dùng khi việc để một tác tử chưa được huấn luyện tương tác nhiều với môi trường là tốn kém hoặc không khả thi. Ví dụ, quá tốn kém khi để một robot chưa được huấn luyện liên tục ngã và có thể bị hỏng.
Ngược lại, các phương pháp không dựa trên mô hình như Q-learning trực tiếp cập nhật Q(s,a) theo một quá trình lặp để hội tụ về hàm giá trị hành động thật mà không cần mô hình hóa môi trường một cách tường minh. Tác tử tương tác trực tiếp với môi trường ở mỗi bước. Họ dùng thử–sai để hội tụ tới sách lược tối ưu. Vì không liên quan đến mô hình của môi trường, chúng đơn giản hơn nhưng cần nhiều mẫu tương tác với môi trường.
Các thuật toán không dựa trên mô hình như Q-learning, SARSA (State-Action-Reward-State-Action), và DQN, học tường minh hàm Q và sử dụng nó để ước lượng giá trị hành động ở mỗi bước.
Thuật toán on-policy và off-policy
Thuật toán off-policy (như DQN và Q-learning) dùng phát lại trải nghiệm (experience replay) để học giá trị của sách lược tối ưu. Chúng có một tập lớn các tương tác (thực hoặc mô phỏng) với môi trường và rút mẫu ngẫu nhiên từ các tương tác này để cập nhật hàm Q. Chúng không dùng sách lược tối ưu để quyết định hành động ở mỗi bước. Phương pháp off-policy sử dụng hàm Q để ước lượng giá trị hành động cho sách lược mục tiêu. Chúng nhằm tối đa hóa return tương lai bằng cách cập nhật hàm Q dựa trên phần thưởng kỳ vọng cao nhất từ bước kế tiếp.
Một số thuật toán on-policy (như SARSA) sử dụng chính sách để chọn hành động ở mỗi bước. Do đó, tác tử theo cùng một sách lược mà nó cập nhật. Hàm Q được cập nhật dựa trên phần thưởng tác tử nhận được khi theo sách lược. Các thuật toán on-policy khác, như policy gradient và actor-critic, không sử dụng hàm Q.
Vì vậy, các hàm giá trị hành động là nền tảng của nhiều thuật toán RL khác nhau.
Chọn hành động tối ưu
Giá trị Q Q(s,a) biểu thị return kỳ vọng khi thực hiện hành động a tại trạng thái s và sau đó theo sách lược. Vì vậy, với một Q-table đã huấn luyện, chọn hành động dẫn đến Q-value lớn nhất tại một trạng thái cụ thể tạo ra sách lược tối ưu dựa trên chiến lược tham lam (tập trung khai thác). Ở mỗi bước, tác tử chọn hành động a* = arg max a Q(s,a). Như vậy, trong cả tập (episode), nó chọn đường đi tối đa hóa phần thưởng dài hạn dựa trên khai thác thông tin hiện có.
Các phương pháp như Q-learning cập nhật các Q-value trong Q-table qua nhiều vòng lặp để hội tụ tới giá trị tối ưu. Vì thế, sau khi huấn luyện, thuật toán đạt đến sách lược tối ưu chọn hành động tối ưu từ mọi trạng thái, và con đường tối ưu xuyên suốt tập.