
कोर्स
Python में Gymnasium के साथ Reinforcement Learning
4 घंटा
13.9K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंएक्शन-वैल्यू फ़ंक्शन के सिद्धांतों और उपयोगों पर चर्चा करने के बाद, अब मैं आपको Python में इसे इम्प्लीमेंट करने के चरण दिखाता हूँ।
आवश्यक पैकेज इम्पोर्ट करें, जिनमें Gymnasium और NumPy शामिल हैं:
import gymnasium as gym
import numpy as np
import math
import random
Gymnasium से एक RL एनवायरनमेंट इनिशियलाइज़ करें। इस लेख में, हम CartPole एनवायरनमेंट को हल करने के लिए एक RL एजेंट को ट्रेन करते हैं।
env = gym.make('CartPole-v1')CartPole ऑब्ज़र्वेशन स्पेस में चार स्टेट्स होते हैं: कार्ट की स्थिति, कार्ट की वेग, पोल का कोण, और पोल की कोणीय वेग।
इस उदाहरण में, हम केवल पोल के कोण और पोल की कोणीय वेग ऑब्ज़र्वेशनों पर ध्यान केंद्रित करते हैं। इसलिए, हम डिस्क्रीट Q-टेबल इस प्रकार बनाते हैं:
कॉलम्स की संख्या एक्शन स्पेस के आकार पर आधारित है, जो यहाँ 2 है।
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))
CartPole एनवायरनमेंट में स्टेट-स्पेस कंटिन्युअस है। कार्ट-पोल का कोण, वेग और स्थिति सतत रूप से बदल सकते हैं। एक्शन-स्पेस डिस्क्रीट है—आप कार्ट को बाएँ या दाएँ धक्का दे सकते हैं।
Q-टेबल्स के साथ Q-Learning केवल डिस्क्रीट स्पेस पर उपयोग किया जा सकता है क्योंकि आपको स्टेट्स और एक्शन्स के सेट के लिए Q-वैल्यू को स्पष्ट रूप से टेबुलेट करना पड़ता है। इसलिए, पहला कदम कंटिन्युअस स्टेट स्पेस को डिस्क्रीटाइज़ करना है।
सबसे पहले हम स्टेट-स्पेस वेरिएबल्स की अपर और लोअर बाउंड्स पर विचार करते हैं। हम देखते हैं कि कार्ट की वेग और पोल की कोणीय वेग की बाउंड्स अनंत हैं। इसलिए, हम इन स्टेट वेरिएबल्स पर कृत्रिम रूप से अपर और लोअर बाउंड्स सेट करते हैं।
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]
हम एक फ़ंक्शन बनाते हैं जो कंटिन्युअस स्टेट वैल्यूज़ को डिस्क्रीट वैल्यूज़ में बदल दे:
def discretize_state(state):
    discrete_states = []

    for i in range(len(state)):
        if state[i] <= STATE_BOUNDS[i][0]:
            discrete_state = 0
        elif state[i] >= STATE_BOUNDS[i][1]:
            discrete_state = NUM_BUCKETS[i] - 1
        else:
            bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
            offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
            scaling = (NUM_BUCKETS[i] - 1) / bound_width
            discrete_state = int(round(scaling * state[i] - offset))
        discrete_states.append(discrete_state)
return tuple(discrete_states)बेलमैन समीकरण लर्निंग रेट, डिस्काउंट रेट, अगले स्टेप में जाने वाला रिवार्ड, और अगले स्टेट के प्रत्याशित अधिकतम Q-वैल्यू के आधार पर Q-वैल्यूज़ को अपडेट करने का निरूपण देते हैं। यह किसी स्टेट के अपेक्षित मान को दो भागों के योग के रूप में व्यक्त करता है:
बेलमैन समीकरण recursive है। इसलिए, किसी रैंडम प्रारंभिक स्टेट से शुरू करके ऑप्टिमल एक्शन-वैल्यू फ़ंक्शन पाने के लिए एक इटरटिव प्रोग्राम लिखा जा सकता है।
Q-टेबल को अपडेट करने का समीकरण इस प्रकार है:
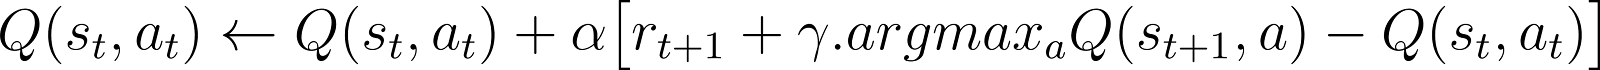
ऊपर के व्यंजक में:
state_current के रूप में दर्शाया गया है।state_next) है।action) है।reward के रूप में दर्शाया गया है। best_q के रूप में दर्शाया गया है। नीचे का कोड Q-टेबल को अपडेट करने का फ़ंक्शन इम्प्लीमेंट करता है
def update_q(state_current, state_next, action, reward, alpha):
    best_q = np.amax(q_table[state_next])
    q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qट्रेनिंग के पैरामीटर्स घोषित करें:
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50
हाइपरपैरामीटर्स घोषित करें:
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25
एजेंट को ट्रेन करने से पहले, हम लर्निंग रेट और एक्सप्लोरेशन रेट को धीरे-धीरे कम करने के लिए दो फ़ंक्शंस लिखते हैं। ये हाइपरपैरामीटर्स पूरे ट्रेनिंग के दौरान धीरे-धीरे कम होते जाते हैं।
def decay_epsilon(step):
    return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))

def decay_alpha(step):
    return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
हम एक फ़ंक्शन भी लिखते हैं जो एक्शन को स्टोकेस्टिकली चुनता है। हम पहले एक रैंडम नंबर जनरेट करते हैं।
def select_action(state, epsilon):
    if random.random() < epsilon:
        action = env.action_space.sample()
    else:
        action = np.argmax(q_table[state])
    return action
हम निम्नलिखित चरणों के आधार पर एजेंट को ट्रेन करने के लिए एक लूप बनाते हैं:
select_action() फ़ंक्शन के अनुसार एक्शन चुनें। update_q() फ़ंक्शन के अनुसार Q-टेबल को अपडेट करें। नीचे का कोड ट्रेनिंग लूप के चरणों को इम्प्लीमेंट करता है:
def train():
    successful_episodes = 0
    for episode in range(MAX_EPISODES):
        epsilon = decay_epsilon(episode)
        alpha = decay_alpha(episode)
        observation, _ = env.reset()
        state_current = discretize_state(observation)
        for step in range(MAX_STEPS):
            action = select_action(state_current, epsilon)
            observation, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            state_next = discretize_state(observation)
            best_q = update_q(state_current, state_next, action, reward, alpha)
            state_current = state_next
            if done:
                print("Episode %d finished after %d time steps" % (episode, step))
                print("best q value: %f" % (float(best_q)))
                if (step >= SUCCESS_STEPS):
                    successful_episodes += 1
                    print("=============SUCCESS=============")
                else:
                    successful_episodes = 0
                    print("=============FAIL=============")
                break
            if successful_episodes > SUCCESS_STREAK:
                break
अंत में, ट्रेनिंग लूप चलाएँ, एनवायरनमेंट बंद करें, और Q-टेबल का अंतिम मान प्रिंट करें।
train()
env.close()
print(q_table)
इस DataLab वर्कबुक का उपयोग Q-Learning के कोड को एडिट और एग्ज़िक्यूट करने के शुरुआती बिंदु के रूप में करें।
पिछले सेक्शन में, हमने Q-टेबल का उपयोग करने के लिए कंटिन्युअस (स्टेट) ऑब्ज़र्वेशन स्पेस को डिस्क्रीटाइज़ किया। एक बड़ी Q-टेबल (जटिल एनवायरनमेंट्स के लिए) कंप्यूटेशनली अकार्यक्षम है। ऐसे मामलों में, Q-फंक्शन को एक न्यूरल नेटवर्क का उपयोग करके एप्रॉक्सिमेट किया जा सकता है। इसे डीप Q-नेटवर्क कहा जाता है, जिसे Q(s, a; θ) के रूप में व्यक्त किया जाता है, जहाँ पैरामीटर θ न्यूरल नेटवर्क के वेट्स का प्रतिनिधित्व करता है। इस विधि को डीप Q-learning कहा जाता है। सामान्य रूप से, डीप न्यूरल नेटवर्क्स का उपयोग करने वाली RL को डीप रिइनफोर्समेंट लर्निंग कहा जाता है।
हर स्टेट के लिए एक्शन चुनने में Q-टेबल का उपयोग करने के बजाय, DQN न्यूरल नेटवर्क स्टेट को इनपुट के रूप में लेता है और उस स्टेट में प्रत्येक संभव एक्शन के लिए Q-वैल्यू लौटाता है।
नेटवर्क को पारंपरिक विधियों (जैसे बैकप्रोपेगेशन) के माध्यम से टेम्पोरल डिफरेंस (TD) एरर को न्यूनतम करने के लिए ट्रेन किया जाता है। TD एरर δ प्रेडिक्टेड Q-वैल्यूज़ और टार्गेट Q-वैल्यूज़ के बीच का अंतर है (जिसे करंट स्टेट से मिलने वाले रिवार्ड और अगले स्टेट से प्रत्याशित अधिकतम रिवार्ड के डिस्काउंटेड मान के योग के रूप में गणना किया जाता है)।
जब इसे एक न्यूरल नेटवर्क (नेटवर्क पैरामीटर्स θ के साथ) के रूप में लागू किया जाता है, तो TD एरर इस प्रकार व्यक्त होता है:

ध्यान दें कि Q-वैल्यूज़ और टार्गेट Q-वैल्यूज़ दोनों की गणना एक ही न्यूरल नेटवर्क से की जाती है।
प्रत्येक इटरेशन में, नेटवर्क पैरामीटर्स (θ) अपडेट होते हैं। नेटवर्क अपडेट (बैकप्रोप के माध्यम से) उस टार्गेट वैल्यू पर आधारित होता है जिसे प्री-अपडेट θ का उपयोग करके गणना किया गया। उसी अपडेटेड मान से टार्गेट वैल्यूज़ की गणना करने पर टार्गेट लगातार बदलता रहता है। इससे ट्रेनिंग अस्थिर हो जाती है।
उपरोक्त समस्या से बचने के लिए, हम टार्गेट Q-वैल्यूज़ की गणना के लिए एक नया नेटवर्क बनाते हैं। यह टार्गेट नेटवर्क है। यह पॉलिसी नेटवर्क के ही पैरामीटर्स पर आधारित होता है, लेकिन इसे कम आवृत्ति से अपडेट किया जाता है। इस प्रकार, ट्रेनिंग प्रक्रिया के पास एक स्थिर टार्गेट होता है जिसके संदर्भ में वह बैकप्रोपेगेशन लागू करती है।
यदि हम टार्गेट नेटवर्क के वेट्स को θ- से दर्शाएँ, तो पहले का समीकरण इस प्रकार दोबारा लिखा जाता है:

निम्नलिखित सेक्शन्स CartPole एनवायरनमेंट में एक सरल DQN को इम्प्लीमेंट और ट्रेन करना दिखाएँगे।
आवश्यक पैकेज इंस्टॉल करें, जिनमें Gymnasium और PyTorch शामिल हैं।
!pip install gymnasium matplotlib torchPython एनवायरनमेंट में आवश्यक पैकेज इम्पोर्ट करें:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count

import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
CartPole एनवायरनमेंट बनाएँ:
env = gym.make("CartPole-v1")एनवायरनमेंट को इनिशियलाइज़ करें और एनवायरनमेंट के स्टेट और एक्शन स्पेस के आकार के साथ Python कॉन्स्टेंट्स डिक्लेयर करें।
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.n
एक साधारण न्यूरल नेटवर्क के लिए Python क्लास डिक्लेयर करें, जिसमें एक हिडन लेयर हो। इनपुट लेयर्स की संख्या स्टेट स्पेस (ऑब्ज़र्वेशन स्पेस) के आकार के बराबर है। आउटपुट लेयर्स की संख्या वे संभावित एक्शन हैं जो RL एजेंट ले सकता है। यह नेटवर्क आंतरिक रूप से Q-टेबल का सिमुलेशन करता है और इनपुट स्टेट दिए जाने पर एक्शन वैल्यूज़ का अनुमान लगाता है।
class DQN(nn.Module):

    def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
        super(DQN, self).__init__()
        self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
        self.layer2 = nn.Linear(128, 128)
        self.layer3 = nn.Linear(128, NUM_ACTIONS)

    def forward(self, x):
        x = F.relu(self.layer1(x))
        x = F.relu(self.layer2(x))
        return self.layer3(x)
एक पॉलिसी नेटवर्क और एक टार्गेट नेटवर्क बनाएँ। स्टेट डिक्शनरी का उपयोग करके टार्गेट नेटवर्क में पॉलिसी नेटवर्क के पैरामीटर्स लोड करें। न्यूरल नेटवर्क को ट्रेन करने के लिए एक ऑप्टिमाइज़र इनिशियलाइज़ करें।
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())

optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)ऑफ-पॉलिसी मॉडल-रहित RL विधियाँ जैसे Q-Learning (जिसकी चर्चा पिछले सेक्शन में हुई) और DQNs, एजेंट की परिवेश के साथ अंतःक्रियाओं के यादृच्छिक सैंपल का उपयोग करके ट्रेन की जाती हैं। एजेंट के एक्शन्स और परिवेश की प्रतिक्रियाएँ (रिवार्ड और अगला स्टेट) इकट्ठा कर स्टोर की जाती हैं। प्रत्येक ट्रेनिंग इटरेशन में इन अंतःक्रियाओं का एक रैंडम सैंपल लेकर ट्रेनिंग बैच बनाया जाता है।
प्रत्येक अंतःक्रिया में एनवायरनमेंट के स्टेट (ऑब्ज़र्वेशन) को स्टोर करने हेतु एक ट्यूपल ऑब्जेक्ट डिक्लेयर करें:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))रिप्ले बफर के लिए एक Python क्लास बनाएँ:
class ReplayMemory(object):

    def __init__(self, capacity):
        self.memory = deque([], maxlen=capacity)

    def push(self, *args):
        self.memory.append(Transition(*args))

    def sample(self, batch_size):
        return random.sample(self.memory, batch_size)

    def __len__(self):
        return len(self.memory)
एजेंट को ट्रेन करने हेतु बड़ी संख्या में अंतःक्रियाओं को स्टोर करने के लिए एक मेमोरी ऑब्जेक्ट बनाएँ।
memory = ReplayMemory(10000)ट्रेनिंग से पहले, पैरामीटर्स और हाइपरपैरामीटर्स घोषित करें:
LR)GAMMA)TAU)EPS_START, EPS_END, और EPS_DECAY)MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4निम्न चरणों के आधार पर एक्सप्लोरेशन रेट के अनुसार एक्शन चुनने का फ़ंक्शन लिखें:
steps_done = 0
def select_action(state):
    global steps_done
    sample = random.random()
    eps_threshold = EPS_END + (EPS_START - EPS_END) * \
        math.exp(-1. * steps_done / EPS_DECAY)
    steps_done += 1
    if sample > eps_threshold:
        with torch.no_grad():
            action = policy_net(state).max(1).indices.view(1, 1)
            return action
    else:
        action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
        return action
मॉडल को ऑप्टिमाइज़ करने का फ़ंक्शन निम्न चरणों पर आधारित होकर लिखें:
non_final_mask) बनाते हैं ताकि उन स्टेट्स की पहचान हो जो टर्मिनल स्टेट द्वारा फॉलो नहीं होतीं। non_final_next_states)।
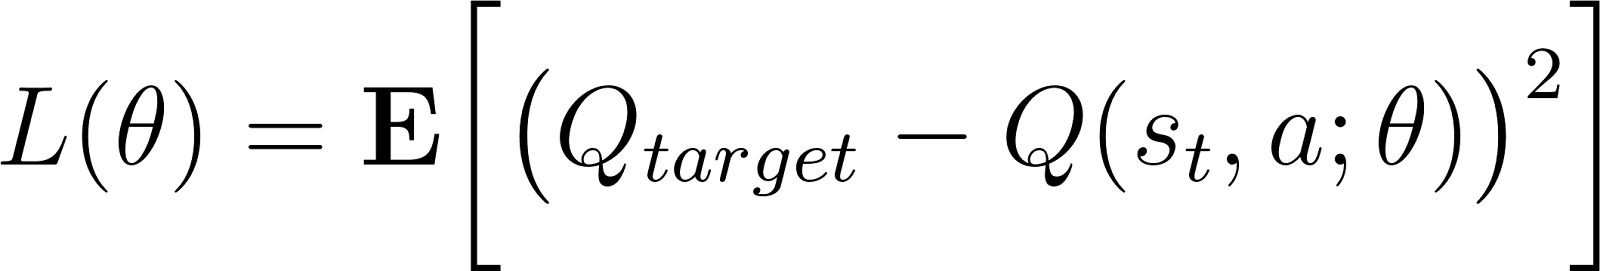
नीचे का कोड ऑप्टिमाइज़र को कैसे इम्प्लीमेंट करें, यह दिखाता है:
batch = 0
def optimize_model():
    global batch
    if len(memory) < BATCH_SIZE:
        return
    transitions = memory.sample(BATCH_SIZE)
    batch = Transition(*zip(*transitions))

    non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
                                          batch.next_state)), dtype=torch.bool)
    non_final_next_states = torch.cat([s for s in batch.next_state
                                                if s is not None])
    state_batch = torch.cat(batch.state)
    action_batch = torch.cat(batch.action)
    reward_batch = torch.cat(batch.reward)

    state_action_values = policy_net(state_batch).gather(1, action_batch)
    next_state_values = torch.zeros(BATCH_SIZE )

    with torch.no_grad():
        next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values

    expected_state_action_values = (next_state_values * GAMMA) + reward_batch

    loss_func = nn.SmoothL1Loss()
    loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))

    optimizer.zero_grad()
    loss.backward()

    torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
    optimizer.step()
एजेंट को ट्रेन करने के लिए एक ट्रेनिंग लूप लिखें:
select_action() फ़ंक्शन का उपयोग करके एजेंट का एक्शन तय करें।निम्न कोड इन चरणों को इम्प्लीमेंट करता है:
def train():
    for episode in range(MAX_EPISODES):
        # Initialize the environment and get its state
        state, info = env.reset()
        state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
        for t in count():
            action = select_action(state)
            observation, reward, terminated, truncated, _ = env.step(action.item())
            reward = torch.tensor([reward])
            done = terminated or truncated

            if terminated:
                next_state = None
            else:
                next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)

            memory.push(state, action, next_state, reward)
            state = next_state
            optimize_model()

            target_net_state_dict = target_net.state_dict()
            policy_net_state_dict = policy_net.state_dict()
            for key in policy_net_state_dict:
                target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
            target_net.load_state_dict(target_net_state_dict)

            if done:
                episode_durations.append(t + 1)
                print('episode -- ', episode)
                print('count -- ', t)
                #plot_durations()
                break
इस DataLab वर्कबुक का उपयोग करके आप DQN ट्रेनिंग प्रोग्राम को देख, एडिट और चला सकते हैं।
ट्रेनिंग प्रक्रिया की प्रगति को दृश्य रूप से ट्रैक करना उपयोगी है। एक्शन वैल्यूज़ का विज़ुअलाइज़ेशन यह पहचानने में मदद करता है कि ट्रेनिंग कहाँ विफल हो रही है और किन पैरामीटर्स या हाइपरपैरामीटर्स में बदलाव की आवश्यकता है।
उदाहरण के लिए, यदि आप दृश्य रूप से देखते हैं कि मॉडल के प्रदर्शन में सुधार बहुत धीमा है, तो आप लर्निंग रेट बढ़ाना चाह सकते हैं। यदि आपको लगता है कि मॉडल सीख रहा है लेकिन अभी पूरी तरह ट्रेन नहीं हुआ, तो ट्रेनिंग एपिसोड्स की संख्या बढ़ाना सहायक हो सकता है। यदि ट्रेनिंग अस्थिर लगती है, तो आप लर्निंग रेट कम करना या एक्सप्लोरेशन कोइफिशिएंट, या टार्गेट नेटवर्क (TAU) के अपडेट रेट को समायोजित करना चाह सकते हैं।
Q-वैल्यूज़ के अलावा, प्रत्येक एपिसोड में सफल स्टेप्स की संख्या को प्लॉट करना भी मददगार हो सकता है। Q-टेबल्स का उपयोग करने वाले Q-Learning में Q-वैल्यूज़ स्पष्ट रूप से स्टोर होती हैं। हालांकि, DQNs का उपयोग करते समय Q-वैल्यूज़ स्पष्ट रूप से स्टोर नहीं होतीं। नेटवर्क अपने वेट्स और स्टेट पर निर्भर करते हुए एक्शन आउटपुट करता है। इसलिए, DQN के लिए प्रत्येक एपिसोड में सफल स्टेप्स की संख्या को ट्रैक करना अधिक सार्थक हो सकता है।
नीचे दिए चरण बताते हैं कि Q-learning एल्गोरिदम की ट्रेनिंग के लिए Q-वैल्यूज़ और प्रति एपिसोड सफल स्टेप्स की संख्या को कैसे प्लॉट करें:
q_vals — प्रत्येक एपिसोड के हर स्टेप में Q-वैल्यूज़ स्टोर करने के लिए। success_steps — प्रत्येक एपिसोड में सफल स्टेप्स की संख्या स्टोर करने के लिए।q_vals एरे में जोड़ेंsuccess_steps एरे में जोड़ें। नीचे का कोड Q-Learning (Q-टेबल्स का उपयोग करते हुए) ट्रेनिंग लूप को अपडेट करके Q-वैल्यूज़ और सफल स्टेप्स को ट्रैक करने का तरीका दिखाता है:
q_vals = []
success_steps = []

def train():
    global q_vals
    global success_steps
    successful_episodes = 0

    for episode in range(MAX_EPISODES):
        epsilon = decay_epsilon(episode)
        alpha = decay_alpha(episode)
        observation, _ = env.reset()
        state_current = discretize_state(observation)

        for step in range(MAX_STEPS):
            action = select_action(state_current, epsilon)
            observation, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            state_next = discretize_state(observation)
            best_q = update_q(state_current, state_next, action, reward, alpha)
            q_vals.append(best_q)
            state_current = state_next

            if done:
                q_vals.append(best_q)
                success_steps.append(step)
                print("Episode %d finished after %d time steps" % (episode, step))
                print("best q value: %f" % (float(best_q)))
                if (step >= SUCCESS_STEPS):
                    successful_episodes += 1
                else:
                    successful_episodes = 0
                break

            if successful_episodes > SUCCESS_STREAK:
                print("Training successful")
                return
नीचे का स्निपेट प्रत्येक एपिसोड में Q-वैल्यूज़ को कैसे प्लॉट करें, यह दिखाता है:
def plot_q():
    plt.plot(q_vals)
    plt.title('Q-values over training steps')
    plt.xlabel('Training steps')
    plt.ylabel('Q-value')
    plt.show()
नीचे का स्निपेट प्रत्येक एपिसोड में सफल स्टेप्स की संख्या को कैसे प्लॉट करें, यह दिखाता है:
def plot_steps():
    plt.plot(success_steps)
    plt.title('Successful steps over training episodes')
    plt.xlabel('Training episode')
    plt.ylabel('Successful steps')
plt.show()यह आवश्यक है कि यह तय करने के मानदंड निर्दिष्ट किए जाएँ कि एजेंट कब और कैसे सफलतापूर्वक ट्रेन हो गया है। पारंपरिक ML में, ट्रेनिंग का लक्ष्य लॉस (प्रेडिक्टेड और वास्तविक मानों के बीच का अंतर) को न्यूनतम करना है। RL में, लक्ष्य संचयी रिवार्ड को अधिकतम करना है। ट्रेनिंग तब सफल मानी जाती है जब एजेंट एनवायरनमेंट से अधिकतम रिवार्ड प्राप्त करता है।
CartPole जैसे एनवायरनमेंट तब तक समाप्त नहीं होते जब तक वे किसी टर्मिनल कंडीशन (किनारों से टकराना या कार्टपोल का अत्यधिक झुकना) तक न पहुँचें। ऐसे मामलों में, एक ट्रेंड एजेंट अनिश्चितकाल तक एनवायरनमेंट के साथ अंतःक्रिया कर सकता है। इसलिए, सफल स्टेप्स की अधिकतम संख्या कृत्रिम रूप से लागू की जाती है। Gymnasium के CartPole-v1 के मामले में, एपिसोड 500 टाइमस्टेप्स तक बिना टर्मिनेट हुए पहुँचने पर समाप्त कर दिया जाता है।
हम यह मूल्यांकन करने के लिए कि ट्रेनिंग सफल है या नहीं, लगातार एपिसोड्स में एजेंट के प्रदर्शन का आकलन करते हैं। उदाहरण के लिए:
SUCCESS_STEPS) से अधिक स्टेप्स पूरे करने में सक्षम होना चाहिए। इस लेख के उदाहरणों में, हम यह थ्रेशहोल्ड 450 रखते हैं। SUCCESS_STREAK)। इस उदाहरण में, हम N = 50 रखते हैं। एक व्यावहारिक उदाहरण के रूप में, पहले दिखाए गए DQN ट्रेनिंग लूप के इस स्निपेट पर विचार करें।
if done:
  episode_durations.append(t + 1)
  print('episode -- ', episode)
  average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
  print('average steps over last 50 episodes -- ', average_steps)
  if average_steps > SUCCESS_STEPS:
      print("training successful.")
      return
  break
प्रत्येक ट्रेनिंग एपिसोड के अंत (टर्मिनल स्टेट) पर निम्न चरणों को एग्ज़ीक्यूट करके एजेंट के प्रदर्शन का मूल्यांकन करना सहायक होता है:
SUCCESS_STREAK) 50 है। इसलिए, हम पिछले 50 एपिसोड्स पर औसत स्टेप्स की गणना करते हैं। SUCCESS_STEPS) से अधिक है, तो हम ट्रेनिंग समाप्त कर देते हैं। इस उदाहरण में, यह थ्रेशहोल्ड 450 स्टेप्स पर सेट है। यहाँ कुछ सर्वोत्तम अभ्यास दिए गए हैं जिन्हें आप अपनी एक्शन-वैल्यू फ़ंक्शन इम्प्लीमेंटेशन से बेहतर परिणाम पाने के लिए अपना सकते हैं।
वास्तविक एक्शन-वैल्यू फ़ंक्शन दिए जाने पर, एजेंट प्रत्येक स्टेप पर सबसे उच्च वैल्यू वाले एक्शन को चुनकर एक ग्रीडी रणनीति अपनाकर प्रत्याशित रिटर्न को अधिकतम कर सकता है। इसे उपलब्ध जानकारी का exploitation कहते हैं। हालाँकि, किसी अनट्रेंड एक्शन-वैल्यू फ़ंक्शन (जो अभी वास्तविक एक्शन-वैल्यू का प्रतिनिधित्व नहीं करता) के साथ ग्रीडी रणनीति का उपयोग करने से एजेंट लोकल ऑप्टिमा में फँस सकता है।
ट्रेनिंग के दौरान, परिवेश का exploration और उपलब्ध जानकारी का exploitation—दोनों करना महत्वपूर्ण है।
ट्रेनिंग प्रक्रिया के प्रारंभिक चरणों में, उपलब्ध जानकारी एक रैंडम वैल्यू फ़ंक्शन पर आधारित होती है। इसलिए, यह जानकारी (ग्रीडी रणनीति से exploit करने के लिए) बहुत मूल्यवान नहीं होती। अलग-अलग स्टेट्स में विभिन्न संभावित एक्शन्स से मिलने वाले रिवार्ड्स की खोज करने के लिए परिवेश का exploration अधिक महत्वपूर्ण है।
जैसे-जैसे Q-टेबल अपडेट होती है (या DQN ट्रेन होता है), उपलब्ध जानकारी का आंशिक exploitation करके रिवार्ड्स को अधिकतम करना व्यावहारिक हो जाता है। ट्रेनिंग के अंतिम चरणों की ओर, एजेंट वास्तविक वैल्यू फ़ंक्शन पर अभिसरण कर लेता है; आगे का exploration हानिकरक हो सकता है। इसलिए, एजेंट ज्ञात वैल्यू फ़ंक्शन के exploitation को प्राथमिकता देता है।
किसी भी मशीन लर्निंग मॉडल की तरह, हाइपरपैरामीटर्स RL एल्गोरिदम को सफलतापूर्वक ट्रेन करने के लिए महत्वपूर्ण हैं। Q-Learning और DQNs के मामले में, हाइपरपैरामीटर्स हैं epsilon (एक्सप्लोरेशन रेट), alpha (लर्निंग रेट), और gamma (डिस्काउंट रेट)।
अंत में समझें कि RL ट्रेनिंग प्रारंभिक रैंडम मानों के प्रति संवेदनशील होती है। यदि ट्रेनिंग अभिसरण नहीं करती, तो अलग रैंडम सीड का उपयोग करना या ट्रेनिंग को फिर से चलाना—ताकि यह रैंडम प्रारंभिक मानों के अलग सेट से शुरू हो—अक्सर सहायक होता है।
जटिल एनवायरनमेंट्स के लिए RL एजेंट्स को ट्रेन करना चुनौतीपूर्ण होता है। Q-फंक्शंस कई अलग-अलग एल्गोरिदम में उपयोग होते हैं, इसलिए Q-learning-आधारित RL एजेंट्स को ट्रेन करने के लिए कुछ अंतर्ज्ञान बनाना आवश्यक है। यह सबसे अच्छा CartPole जैसे सरल एनवायरनमेंट्स पर अभ्यास करके किया जाता है, उसके बाद इसी तरह की विधियों को अधिक जटिल एनवायरनमेंट्स पर लागू करें।
इसके अलावा, जटिल एनवायरनमेंट्स में ट्रेनिंग अधिक महँगी होती है, इसलिए सीखने के औज़ार के रूप में सरल एनवायरनमेंट्स का उपयोग अधिक आर्थिक है।
इस लेख में एक्शन-वैल्यू फ़ंक्शन के बुनियादी सैद्धांतिक सिद्धांतों और RL में इसकी महत्ता पर चर्चा की गई। हमने देखा कि Q-learning और Deep Q-learning में एक्शन-वैल्यू फ़ंक्शंस का कैसे उपयोग होता है, और Python में दोनों विधियों को चरण-दर-चरण इम्प्लीमेंट किया।
अपनी सीख जारी रखने के लिए, मैं Deep Reinforcement Learning in Python कोर्स की अत्यधिक सिफारिश करता हूँ।
इन कोर्सेज़ के साथ AI के बारे में और जानें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें