

Een actiewaarde-functie implementeren
Na de basisprincipes en toepassingen van de actiewaarde-functie te hebben besproken, laat ik je nu de stappen zien om die in Python te implementeren.
Stap 1: Definieer de omgeving
Importeer de vereiste pakketten, waaronder Gymnasium en NumPy:
import gymnasium as gym
import numpy as np
import math
import randomInitialiseer een RL-omgeving uit Gymnasium. In dit artikel trainen we een RL-agent om de CartPole-omgeving op te lossen.
env = gym.make('CartPole-v1')Stap 2: Initialiseer de Q-tabel
De CartPole-observatieruimte heeft vier toestanden: karpositie, karsnelheid, hoek van de paal en hoeksnelheid van de paal.
In dit voorbeeld richten we ons alleen op de hoek van de paal en de hoeksnelheid van de paal. Daarom maken we de discrete Q-tabel als volgt:
- Eén discrete toestand voor de karpositie - alle mogelijke waarden worden gebundeld in deze ene toestand.
- Eén discrete toestand voor de karsnelheid
- Zes discrete toestanden voor de paalhoek
- Drie discrete toestanden voor de paalsnelheid
Het aantal kolommen is gebaseerd op de grootte van de actieruimte, in dit geval 2.
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))In de CartPole-omgeving is de toestandsruimte continu. De hoek, snelheid en positie van de paal kunnen continu variëren. De actieruimte is discreet - je kunt de kar naar links of rechts duwen.
Q-learning met Q-tabellen kan alleen worden gebruikt op een discrete ruimte, omdat je de Q-waarde expliciet moet tabelleren voor een set toestanden en acties. De eerste stap is dus om de continue toestandsruimte te disreteren.
We bekijken eerst de boven- en ondergrenzen van de variabelen in de toestandsruimte. We merken op dat de karsnelheid en de hoeksnelheid van de paal oneindige grenzen hebben. Daarom stellen we kunstmatig boven- en ondergrenzen in voor deze toestandsvariabelen.
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]We maken een functie om de continue toestandswaarden te disreteren naar discrete waarden:
def discretize_state(state):
discrete_states = []
for i in range(len(state)):
if state[i] <= STATE_BOUNDS[i][0]:
discrete_state = 0
elif state[i] >= STATE_BOUNDS[i][1]:
discrete_state = NUM_BUCKETS[i] - 1
else:
bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
scaling = (NUM_BUCKETS[i] - 1) / bound_width
discrete_state = int(round(scaling * state[i] - offset))
discrete_states.append(discrete_state)
return tuple(discrete_states)Stap 3: Werk de Q-tabel bij
De Bellman-vergelijkingen geven de uitdrukking om de Q-waarden bij te werken op basis van het leerpercentage, de disconteringsfactor, de beloning naar de volgende stap en de verwachte maximale Q-waarde van de volgende toestand. Ze drukken de verwachte waarde van een toestand uit als de som van twee delen:
- De directe beloning naar de volgende toestand
- De gedisconteerde verwachte waarde van de volgende toestand
De Bellman-vergelijking is recursief. Het is dus mogelijk om een iteratief programma te schrijven, beginnend vanaf een willekeurige initiële toestand, om de optimale actiewaarde-functie te vinden.
De vergelijking voor het bijwerken van de Q-tabel is:
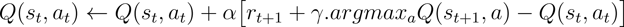
In de bovenstaande uitdrukking:
- De huidige toestand is st, in de code aangeduid als
state_current. - De volgende toestand is st+1 (
state_next). - De actie die in de huidige toestand wordt genomen is at (
action). - Q(st, at) is de huidige Q-waarde voor toestand st en actie at
- α is het leerpercentage.
- γ is de disconteringsfactor.
- rt+1 is de beloning na het nemen van actie at in de huidige stap met toestand st. In de code hieronder wordt dit weergegeven als
reward. - argmaxa Q(st+1, a) is de maximale Q-waarde van de volgende toestand st+1. In de onderstaande code wordt dit weergegeven als
best_q.
De onderstaande code implementeert de functie om de Q-tabel bij te werken
def update_q(state_current, state_next, action, reward, alpha):
best_q = np.amax(q_table[state_next])
q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qStap 4: Train de agent
Declareer de parameters van de training:
- Het maximale aantal trainings-episodes
- Het maximale aantal stappen per episode komt uit de documentatie van de omgeving. Voor CartPole-v1 is dat 500.
- Het aantal stappen dat de agent moet voltooien om de episode als een succes te classificeren. We zetten dit op 450.
- Het aantal opeenvolgende succesvolle episodes dat de agent moet voltooien om de training succesvol te noemen. We zetten dit op 50.
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50Declareer de hyperparameters:
- De minimale en maximale waarden van de exploratiesnelheid, ε
- De minimale en maximale waarden van het leerpercentage, α
- De afnamesnelheid van α en γ
- De disconteringsfactor, γ
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25Voordat we de agent trainen, schrijven we twee functies om het leerpercentage en de exploratiesnelheid geleidelijk af te laten nemen. Deze hyperparameters nemen gedurende de training geleidelijk af.
def decay_epsilon(step):
return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
def decay_alpha(step):
return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))We schrijven ook een functie om de actie stochastisch te selecteren. We genereren eerst een willekeurig getal.
- Als dit willekeurige getal kleiner is dan ε, kiezen we willekeurig een actie uit de actieruimte. Dit is de exploratiestrategie.
- Als het willekeurige getal groter is dan ε, kiezen we de actie die overeenkomt met de maximale Q-waarde. Dit is de exploitatiestrategie.
def select_action(state, epsilon):
if random.random() < epsilon:
action = env.action_space.sample()
else:
action = np.argmax(q_table[state])
return actionWe bouwen een lus om de agent te trainen op basis van de volgende stappen:
- Haal de afgenomen waarden van α en ε op voor de huidige episode.
- Reset de omgeving en disreteer de observatieruimte om een frisse omgeving voor de episode te starten.
- Laat de agent in de omgeving draaien tot het maximale aantal stappen is bereikt of hij beëindigt.
- Voor elke stap:
- Selecteer de actie volgens de eerder gedefinieerde functie
select_action(). - Voer de actie uit in de omgeving om de beloning en de volgende toestand te krijgen.
- Haal de hoogste Q-waarde uit de Q-tabel.
- Werk de Q-tabel bij volgens de eerder gedefinieerde functie
update_q().
De onderstaande code implementeert de stappen van de trainingslus:
def train():
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
state_current = state_next
if done:
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
print("=============SUCCESS=============")
else:
successful_episodes = 0
print("=============FAIL=============")
break
if successful_episodes > SUCCESS_STREAK:
breakVoer tot slot de trainingslus uit, sluit de omgeving af en print de uiteindelijke waarde van de Q-tabel.
train()
env.close()
print(q_table)Gebruik deze DataLab-workbook als startpunt om de code voor Q-learning te bewerken en uit te voeren.
Uitbreiden naar Deep Q-learning
In de vorige sectie hebben we de continue (toestands)observatieruimte gediscretiseerd om een Q-tabel te gebruiken. Een grote Q-tabel (voor complexe omgevingen) is computationeel inefficiënt. In zulke gevallen kan de Q-functie worden benaderd met een neuraal netwerk. Dit heet een Deep Q-Network, uitgedrukt als Q(s, a; θ), waarbij de parameter θ de gewichten van het neurale netwerk vertegenwoordigt. Deze methode heet Deep Q-learning. Algemenere RL met deep neural networks heet Deep Reinforcement Learning.
In plaats van de Q-tabel te gebruiken om de actie voor elke toestand te kiezen, neemt het DQN-neurale netwerk de toestand als input en geeft het de Q-waarde voor elke mogelijke actie in die toestand terug.
Het netwerk wordt getraind via traditionele methoden (zoals backpropagation) om de temporal difference (TD)-fout te minimaliseren. De TD-fout δ is het verschil tussen de voorspelde Q-waarden en de doel-Q-waarden (berekend als de som van de beloning uit de huidige toestand en de gedisconteerde waarde van de verwachte maximale beloning uit de volgende toestand).
Wanneer geïmplementeerd als een neuraal netwerk (met netwerkparameters θ), wordt de TD-fout uitgedrukt als:
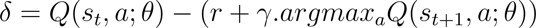
Merk op dat zowel de Q-waarden als de doel-Q-waarden met hetzelfde neurale netwerk worden berekend.
In elke iteratie worden de netwerkparameters (θ) bijgewerkt. De netwerkaanpassing (via backprop) is gebaseerd op de doelwaarde die is berekend met de pre-update-θ. Het berekenen van de doelwaarden met dezelfde geüpdatete waarden resulteert in een continu bewegend doelwit. Dit maakt de training instabiel.
Om het bovenstaande probleem te vermijden, maken we een nieuw netwerk om de doel-Q-waarden te berekenen. Dit is het targetnetwerk. Het is gebaseerd op dezelfde parameters als het beleidsnetwerk, maar wordt minder vaak bijgewerkt. Zo heeft het trainingsproces een stabiel doel ten opzichte waarvan het backpropagation toepast.
Als we de gewichten van het targetnetwerk aanduiden met θ-, dan wordt de eerdere vergelijking herzien als:
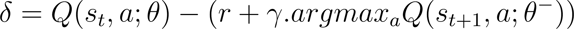
De volgende secties laten zien hoe je een eenvoudige DQN in de CartPole-omgeving implementeert en traint.
Voorbeeldimplementatie
Installeer de vereiste pakketten, waaronder Gymnasium en PyTorch.
!pip install gymnasium matplotlib torchImporteer de benodigde pakketten in de Python-omgeving:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as FMaak de CartPole-omgeving aan:
env = gym.make("CartPole-v1")Initialiseer de omgeving en declareer Python-constanten met de grootte van de toestand- en actieruimtes van de omgeving.
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.nDeclareer een Python-klasse voor een eenvoudig neuraal netwerk met één verborgen laag. Het aantal invoerlagen is de grootte van de toestandsruimte (observatieruimte). Het aantal uitvoerlagen is het aantal mogelijke acties dat de RL-agent kan nemen. Dit netwerk simuleert intern de Q-tabel en voorspelt de actiewaarden gegeven een invoertoestand.
class DQN(nn.Module):
def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
super(DQN, self).__init__()
self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
self.layer2 = nn.Linear(128, 128)
self.layer3 = nn.Linear(128, NUM_ACTIONS)
def forward(self, x):
x = F.relu(self.layer1(x))
x = F.relu(self.layer2(x))
return self.layer3(x)Maak een beleidsnetwerk en een targetnetwerk. Laad het targetnetwerk met de parameters van het beleidsnetwerk via de state dictionary. Initialiseer een optimizer om het neurale netwerk te trainen.
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())
optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)Trainen met replaybuffer
Off-policy model-free RL-methoden zoals Q-learning (besproken in de vorige sectie) en DQN’s worden getraind met een willekeurige steekproef van de interacties van de agent met de omgeving. De acties van de agent en de reacties van de omgeving (beloning en volgende toestand) worden verzameld en opgeslagen. In elke trainingsiteratie wordt een willekeurige steekproef van deze interacties gekozen om een trainingsbatch te vormen.
Declareer een tuple-object om de toestand (observatie) van de omgeving in elke interactie op te slaan:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))Maak een Python-klasse voor de replaybuffer:
class ReplayMemory(object):
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, *args):
self.memory.append(Transition(*args))
def sample(self, batch_size):
return random.sample(self.memory, batch_size)
def __len__(self):
return len(self.memory)Maak een geheugenobject om een groot aantal interacties op te slaan. Deze interacties worden gebruikt om de agent te trainen.
memory = ReplayMemory(10000)Declareer vóór het trainen de parameters en hyperparameters:
- Parameters:
- Batchgrootte
- Maximaal aantal trainings-episodes
- Hyperparameters:
- Leerpercentage (
LR) - Disconteringsfactor (
GAMMA) - De bijwerkfrequentie van het targetnetwerk (
TAU) - Begin- en eindwaarden van de exploratiesnelheid, en de afnamesnelheid (
EPS_START,EPS_ENDenEPS_DECAY)
MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4Schrijf een functie om de actie te selecteren op basis van de exploratiesnelheid, volgens deze stappen:
- Bereken de exploratiesnelheid op basis van het aantal stappen in de episode (en de begin- en eindwaarden en afnamesnelheid van de exploratiesnelheid).
- Genereer een willekeurig getal.
- Als het willekeurige getal groter is dan de exploratiesnelheid, kies dan de actie die wordt voorspeld door het beleidsnetwerk.
- Als het kleiner is dan de exploratiesnelheid, kies dan een willekeurige actie uit de actieruimte.
steps_done = 0
def select_action(state):
global steps_done
sample = random.random()
eps_threshold = EPS_END + (EPS_START - EPS_END) * \
math.exp(-1. * steps_done / EPS_DECAY)
steps_done += 1
if sample > eps_threshold:
with torch.no_grad():
action = policy_net(state).max(1).indices.view(1, 1)
return action
else:
action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
return actionSchrijf de functie om het model te optimaliseren op basis van deze stappen:
- Maak een batch met een willekeurige steekproef van de interacties van de agent met de omgeving. Elk item in de steekproef komt overeen met één tijdstap. Het bevat:
- De huidige toestand van de omgeving
- De actie van de agent
- De ontvangen beloning
- De volgende toestand
- In CartPole wordt verwacht dat de agent de kar en paal blijft manipuleren zonder te beëindigen (de randen raken of vallen). Daarom beschouwen we alleen die interacties die niet leiden tot een terminale toestand. We maken een masker (
non_final_mask) om die toestanden te identificeren die niet gevolgd worden door een terminale toestand. - Identificeer die toestanden die niet gevolgd worden door een terminale toestand (
non_final_next_states). - Haal de staat-actie-waarden op voor alle huidige toestanden st door de huidige toestanden door het beleidsnetwerk te sturen.
- Haal de verwachte staat-actie-waarden op voor alle volgende toestanden st+1 door de volgende toestanden door het targetnetwerk te sturen en de vergelijking te gebruiken:
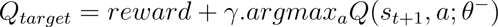
- Bereken het verlies op basis van het verschil tussen de actiewaarden en de verwachte actiewaarden:
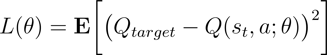
- Backpropagate de verliezen om de gradiënten te berekenen.
- Clip de gradiëntwaarden en werk het beleidsnetwerk bij om stabiele training te waarborgen.
De onderstaande code laat zien hoe je de optimizer implementeert:
batch = 0
def optimize_model():
global batch
if len(memory) < BATCH_SIZE:
return
transitions = memory.sample(BATCH_SIZE)
batch = Transition(*zip(*transitions))
non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
batch.next_state)), dtype=torch.bool)
non_final_next_states = torch.cat([s for s in batch.next_state
if s is not None])
state_batch = torch.cat(batch.state)
action_batch = torch.cat(batch.action)
reward_batch = torch.cat(batch.reward)
state_action_values = policy_net(state_batch).gather(1, action_batch)
next_state_values = torch.zeros(BATCH_SIZE )
with torch.no_grad():
next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values
expected_state_action_values = (next_state_values * GAMMA) + reward_batch
loss_func = nn.SmoothL1Loss()
loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))
optimizer.zero_grad()
loss.backward()
torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
optimizer.step()Schrijf een trainingslus om de agent te trainen:
- Reset de omgeving en start een nieuwe episode.
- Gebruik de functie
select_action()om de actie van de agent te bepalen. - Haal de beloning en de volgende toestand van de omgeving op basis van de actie.
- Voeg de toestand, actie, volgende toestand en beloning toe aan de replaybuffer.
- Voer de optimizer uit (hierboven gedefinieerd). De optimizer berekent de Q-waarden en het verlies, en past backpropagation toe om het netwerk bij te werken.
- Werk het targetnetwerk bij op basis van het beleidsnetwerk.
- Ga door met de episode totdat een terminale toestand is bereikt.
De volgende code implementeert deze stappen:
def train():
for episode in range(MAX_EPISODES):
# Initialize the environment and get its state
state, info = env.reset()
state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
for t in count():
action = select_action(state)
observation, reward, terminated, truncated, _ = env.step(action.item())
reward = torch.tensor([reward])
done = terminated or truncated
if terminated:
next_state = None
else:
next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)
memory.push(state, action, next_state, reward)
state = next_state
optimize_model()
target_net_state_dict = target_net.state_dict()
policy_net_state_dict = policy_net.state_dict()
for key in policy_net_state_dict:
target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
target_net.load_state_dict(target_net_state_dict)
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
print('count -- ', t)
#plot_durations()
breakJe kunt het DQN-trainingsprogramma bekijken, bewerken en uitvoeren met deze DataLab-workbook.
De actiewaarde-functie visualiseren
Het is nuttig om de voortgang van het trainingsproces visueel te volgen. Het visualiseren van de actiewaarden helpt te herkennen waar de training faalt en welke parameters of hyperparameters moeten worden aangepast.
Als je bijvoorbeeld visueel waarneemt dat de prestatieverbetering van het model te traag gaat, wil je misschien het leerpercentage verhogen. Als je ziet dat het model leert maar nog niet volledig getraind is, kan het helpen om het aantal trainings-episodes te verhogen. Als je de training instabiel vindt, wil je misschien het leerpercentage verlagen of de exploratiecoëfficiënt of de bijwerkfrequentie van het targetnetwerk (TAU) bijstellen.
Naast de Q-waarden kan het ook helpen om het aantal succesvolle stappen in elke episode te plotten. Bij Q-learning met Q-tabellen worden de Q-waarden expliciet opgeslagen. Bij DQN’s worden de Q-waarden echter niet expliciet opgeslagen. Het netwerk geeft de actie terug afhankelijk van zijn gewichten en de toestand. Het bijhouden van het aantal succesvolle stappen per episode kan dus zinvoller zijn voor DQN.
De volgende stappen beschrijven hoe je de Q-waarden en het aantal succesvolle stappen per episode plot tijdens het trainen van het Q-learning-algoritme:
- Maak twee lege arrays aan het begin van de training:
q_vals- voor het opslaan van Q-waarden in elke stap van elke episode.success_steps- voor het opslaan van het aantal succesvolle stappen in elke episode.- Bij elke stap (in alle episodes):
- Voeg de Q-waarde voor die stap toe aan de
q_vals-array - Na het beëindigen van elke episode, voeg je aan de
success_steps-array het aantal succesvolle stappen in die episode toe. - Plot beide arrays.
De onderstaande code toont de trainingslus voor Q-learning (met Q-tabellen) uit de vorige sectie, aangepast voor het bijhouden van de Q-waarden en het aantal succesvolle stappen:
q_vals = []
success_steps = []
def train():
global q_vals
global success_steps
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
q_vals.append(best_q)
state_current = state_next
if done:
q_vals.append(best_q)
success_steps.append(step)
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
else:
successful_episodes = 0
break
if successful_episodes > SUCCESS_STREAK:
print("Training successful")
returnHet onderstaande fragment laat zien hoe je de Q-waarden in elke episode plot:
def plot_q():
plt.plot(q_vals)
plt.title('Q-values over training steps')
plt.xlabel('Training steps')
plt.ylabel('Q-value')
plt.show()Het volgende fragment laat zien hoe je het aantal succesvolle stappen in elke episode plot:
def plot_steps():
plt.plot(success_steps)
plt.title('Successful steps over training episodes')
plt.xlabel('Training episode')
plt.ylabel('Successful steps')
plt.show()- De DataLab-workbook voor het implementeren van Q-learning met actiewaarde-functies bevat ook de code om de Q-waarden en succesvolle stappen per episode te plotten.
- De notebook voor het implementeren van DQN bevat ook de code om het aantal succesvolle stappen per episode te plotten.
De prestaties van de agent evalueren
Het is nodig om de criteria te specificeren om te bepalen of en wanneer de agent succesvol is getraind. In traditionele ML is het doel van training het minimaliseren van het verlies: het verschil tussen de voorspelde en ware waarden. In RL is het doel om de cumulatieve beloning te maximaliseren. De training wordt als succesvol beschouwd wanneer de agent de maximale beloningen uit de omgeving haalt.
Omgevingen zoals CartPole eindigen niet totdat ze een terminale conditie bereiken, zoals de randen raken of de paal te ver laten hellen. In zulke gevallen kan een getrainde agent oneindig blijven interageren met de omgeving. Daarom wordt het maximale aantal succesvolle stappen kunstmatig opgelegd. In het geval van Gymnasium’s CartPole-v1 wordt de episode beëindigd wanneer deze 500 tijdstappen bereikt zonder te beëindigen.
We evalueren de prestaties van de agent over opeenvolgende episodes om te beoordelen of de training succesvol is. Bijvoorbeeld:
- De agent moet gemiddeld over de laatste N episodes meer dan een drempelaantal stappen (
SUCCESS_STEPS) kunnen voltooien. In de voorbeelden in dit artikel zetten we deze drempel op 450. - De agent kan de drempel overschrijden in N opeenvolgende episodes (
SUCCESS_STREAK). In dit voorbeeld zetten we N op 50.
Als praktisch voorbeeld, bekijk dit fragment uit de eerder getoonde DQN-trainingslus.
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
print('average steps over last 50 episodes -- ', average_steps)
if average_steps > SUCCESS_STEPS:
print("training successful.")
return
breakHet helpt om de prestaties van de agent te evalueren door de volgende stappen uit te voeren aan het einde (terminale toestand) van elke trainings-episode:
- Voeg het totale aantal stappen in deze episode (voordat die eindigde) toe aan een array. Deze array houdt het totaal aantal stappen per episode bij.
- Bereken het gemiddelde van de laatste N waarden in deze array. In dit voorbeeld is N (
SUCCESS_STREAK) 50. We berekenen dus het gemiddelde aantal stappen over de laatste 50 episodes. - Als dit gemiddelde groter is dan een drempel (
SUCCESS_STEPS), beëindigen we de training. In dit voorbeeld is deze drempel ingesteld op 450 stappen.
Best practices voor het gebruik van actiewaarde-functies
Hier zijn enkele best practices die je kunt volgen voor betere resultaten met je implementatie van de actiewaarde-functie.
Balans tussen exploratie en exploitatie
Gegeven de ware actiewaarde-functie kan de agent de verwachte returns maximaliseren door een greedy strategie te hanteren, gebaseerd op het kiezen van de actie met de hoogste waarde in elke stap. Dit heet exploitatie van de beschikbare informatie. Het gebruik van een greedy strategie met een ongetrainde actiewaarde-functie (die de ware actiewaarden nog niet vertegenwoordigt) zal echter leiden tot vastlopen in een lokaal optimum.
Tijdens de training is het belangrijk om zowel de omgeving te verkennen als de beschikbare informatie te benutten.
In de beginfase van het trainingsproces is de beschikbare informatie gebaseerd op een willekeurige waardefunctie. Deze informatie is dus niet erg waardevol (om met een greedy strategie te exploiteren). Het is belangrijker om de omgeving te verkennen om de beloningen van verschillende mogelijke acties in verschillende toestanden te ontdekken.
Naarmate de Q-tabel wordt bijgewerkt (of de DQN wordt getraind), wordt het haalbaar om de beschikbare informatie gedeeltelijk te exploiteren om de beloningen te maximaliseren. Tegen de laatste fases van de training convergeert de agent naar de ware waardefunctie; verdere exploratie kan nadelig zijn. De agent geeft dan prioriteit aan het exploiteren van de bekende waardefunctie.
Hyperparameters afstemmen
Zoals bij elk machinelearningmodel zijn hyperparameters belangrijk voor het succesvol trainen van RL-algoritmes. In het geval van Q-learning en DQN’s zijn de hyperparameters epsilon (exploratiesnelheid), alpha (leerpercentage) en gamma (disconteringsfactor).
- ε (epsilon) regelt de balans tussen exploratie en exploitatie (hierboven besproken). Hoe hoger de epsilonwaarde, hoe belangrijker exploratie is ten opzichte van exploitatie. Aan het begin van de training neemt die een hoge waarde aan, zoals 0,9, die geleidelijk wordt verlaagd naar een kleine waarde zoals 0,05 richting het einde van de training.
- α (alpha) is het leerpercentage (LR). Het bepaalt hoeveel de parameters van het neurale netwerk (bij DQN’s) of de waarden van de Q-tabel veranderen in elke trainingsiteratie. Als de LR te hoog is, wordt het model instabiel en convergeert het niet. Een lage LR leidt daarentegen tot trage convergentie. Het is ook gebruikelijk om vroeg in het trainingsproces met een hoge LR te beginnen wanneer de agent de omgeving moet verkennen. Naarmate hij dichter bij de ware waarden van de Q-functie komt, wordt de LR verlaagd om het netwerk te helpen convergeren.
- γ (gamma) is de disconteringsfactor. Die bepaalt het belang van beloningen op latere tijdstappen ten opzichte van directe beloningen. Een hoge gammawaarde betekent dat latere beloningen belangrijk zijn. Een gammawaarde van 0 betekent dat alleen de beloning van de huidige tijdstap belangrijk is, en latere beloningen geen betekenis hebben. In algoritmes zoals Q-learning is de totale return gebaseerd op beloningen die gedurende de hele episode zijn verdiend. Het gebruik van een hoge disconteringsfactor, zoals 0,99, is dus gebruikelijk.
Begrijp tot slot dat RL-training gevoelig is voor initiële willekeurige waarden. Als de training niet convergeert, is het vaak verstandig om een andere random seed te gebruiken of de training opnieuw te starten zodat deze met een andere set willekeurige beginwaarden start.
Begin met eenvoudige omgevingen
Het trainen van RL-agents voor complexe omgevingen is uitdagend. Q-functies worden in veel verschillende algoritmes gebruikt, dus het is essentieel om gevoel te krijgen voor het trainen van Q-learning-gebaseerde RL-agents. Dit doe je het best door de technieken te oefenen op eenvoudigere omgevingen zoals CartPole, voordat je vergelijkbare methoden toepast op complexere omgevingen.
Bovendien zijn complexe omgevingen duurder om in te trainen, dus is het economischer om eenvoudigere omgevingen als leermiddel te gebruiken.
Conclusie
Dit artikel besprak de fundamentele theoretische principes van de actiewaarde-functie en het belang ervan in RL. We hebben behandeld hoe actiewaarde-functies worden gebruikt in Q-learning en Deep Q-learning, en beide methoden stap voor stap in Python geïmplementeerd.
Om je leerproces voort te zetten, beveel ik van harte de cursus Deep Reinforcement Learning in Python aan.
FAQs
Wat is het verschil tussen waardefunctie en actiewaarde-functie in RL?
De waardefunctie schat de verwachte return vanuit een toestand, terwijl de actiewaarde-functie (Q-functie) de return schat van het nemen van een specifieke actie in een toestand en daarna het beleid te volgen. De actiewaarde-functie biedt meer gedetailleerde sturing voor besluitvorming.
Waarom is de actiewaarde-functie belangrijk in Q-learning?
Q-learning gebruikt de actiewaarde-functie om de agent te sturen naar acties die de hoogste verwachte beloningen opleveren. De functie maakt off-policy leren mogelijk en helpt de agent om in de loop van de tijd naar de optimale strategie te convergeren.
Hoe verhoudt de actiewaarde-functie zich tot de Bellman-vergelijking?
De Bellman-vergelijking geeft een recursieve formulering om de Q-waarden bij te werken op basis van de directe beloning en de gedisconteerde maximale toekomstige beloning. Het is de basis voor het iteratief leren van de actiewaarde-functie.
Kan ik de actiewaarde-functie gebruiken in continue toestandsruimtes?
Ja, maar Q-tabellen worden onpraktisch in continue ruimtes. In zulke gevallen worden Deep Q-Networks (DQN’s) gebruikt om de actiewaarde-functie te benaderen met een neuraal netwerk in plaats van expliciete tabellen.
Wat is de rol van exploratie bij het schatten van de actiewaarde-functie?
Exploratie zorgt ervoor dat de agent niet te vroeg convergeert naar een suboptimaal beleid. Het helpt de agent om diverse ervaringen te verzamelen, die essentieel zijn voor het nauwkeurig schatten van de actiewaarde-functie tijdens de training.
Hoe beïnvloedt de ε-greedy strategie het leren van Q-waarden?
De ε-greedy strategie balanceert exploratie en exploitatie. Met kans ε verkent de agent nieuwe acties, en met 1–ε benut hij de momenteel best bekende actie. Deze afweging verbetert de stabiliteit en convergentie van het leren.
Wanneer moet je overstappen van Q-learning naar Deep Q-learning?
Wanneer de omgeving een grote of continue toestandsruimte heeft, wordt het bijhouden van een Q-tabel inefficiënt. Deep Q-learning vervangt de tabel door een neuraal netwerk dat beter schaalt naar complexe omgevingen.
Hoe kan ik een actiewaarde-functie visualiseren tijdens het trainen?
Je kunt de maximale Q-waarden in de tijd plotten of episodische beloningen bijhouden om de leerprogressie te monitoren. Visualisatie helpt problemen te diagnosticeren zoals slechte convergentie of onvoldoende exploratie.
Wat zijn de belangrijkste uitdagingen bij het trainen van een actiewaarde-functie?
Uitdagingen zijn onder meer instabiliteit tijdens training door bewegende doelen, slechte exploratie en suboptimale hyperparameters. Het gebruik van technieken als replaygeheugen en targetnetwerken helpt deze problemen te beperken.
Wordt de actiewaarde-functie gebruikt in on-policy algoritmes?
Ja, algoritmes zoals SARSA gebruiken de actiewaarde-functie maar werken die bij met de actie die daadwerkelijk is genomen door het huidige beleid. Dit contrasteert met off-policy methoden zoals Q-learning die de maximale Q-waarde van de volgende toestand gebruiken.



Reinforcement Learning (RL) is een machinelearningparadigma waarbij een agent leert de juiste beslissingen te nemen door te interageren met een externe omgeving. De omgeving geeft feedback, in de vorm van beloningen, voor het nemen van de juiste actie.
Het doel van de agent is om de cumulatieve beloningen te maximaliseren. In veel praktische problemen komt de feedback aan de agent van een mens; dit heet RL met menselijke feedback (RLHF).
RLHF wordt vaak gebruikt om LLM’s af te stemmen op menselijke waarden en voorkeuren. Wanneer een AI wordt gebruikt om feedback te geven, heet dit RL met AI-feedback.
De agent gebruikt de actiewaarde-functie om te beoordelen welke actie op elk moment te kiezen. Een geoptimaliseerde actiewaarde-functie helpt de agent bij elke stap de beste actie te kiezen om de cumulatieve beloningen te maximaliseren.
In deze tutorial introduceer ik de actiewaarde-functie, leg ik de rol ervan in RL uit en laat ik zien hoe je die vanaf nul implementeert.
Wat is een actiewaarde-functie?
De actiewaarde-functie (Q) schat de verwachte cumulatieve beloning (return) die wordt verkregen door een specifieke actie (a) te nemen in een bepaalde toestand (s) en daarna beleid π te volgen. Dit wordt genoteerd als Qπ(s,a). Wanneer het duidelijk is dat de agent het optimale beleid volgt, wordt het eenvoudiger uitgedrukt als Q(s,a).
De actiewaarde-functie wordt gebruikt om de actie te kiezen die leidt tot de hoogste return vanuit een gegeven toestand. Het optimale beleid (π*) maximaliseert de verwachte return. Dus kiest het beleid in elke toestand s de actie die tot de hoogste verwachte return leidt. Dit optimale beleid wordt uitgedrukt als π* = argmaxa Q(s,a).
De Q-functie wordt traditioneel gemodelleerd als een Q-tabel. Deze tabel slaat de waarde op van elke mogelijke actie voor elke mogelijke toestand van de omgeving. Voor complexe omgevingen wordt deze tabel onhandelbaar groot en inefficiënt. Daarom modelleren we de Q-tabel als een neuraal netwerk in plaats van een tabel voor de meeste niet-triviale omgevingen. Dit netwerk benadert de functie van de Q-tabel. Gegeven een toestand, geeft het de actiewaarden terug die bij die toestand horen.
Waarom actiewaarde-functies belangrijk zijn in RL
Gegeven de ware actiewaarde-functie zou het beleid de actie moeten kiezen die leidt tot de hoogste verwachte beloningen. Deze strategie staat bekend als exploitatie. Maar tijdens de trainingsfase is de ware actiewaarde-functie nog niet bekend. Het kiezen van de actie is dus gebaseerd op onvolledige informatie. Exploitatie (return maximaliseren) op basis van onvolledige informatie kan ertoe leiden dat de ware actiewaarde-functie niet wordt ontdekt en dat je vastloopt in een lokaal optimum.
Aan de andere kant kiest een exploratieve strategie soms suboptimale acties, die uiteindelijk kunnen leiden naar een toestand met een hogere waarde. Dit wordt geïmplementeerd als een ε -greedy-strategie, waarbij ε een kleine waarde is. Het beleid kiest willekeurig een suboptimale actie met kans ε en de belonings-maximaliserende actie met kans 1 - ε.
Een strategie die exploitatie en exploratie in balans brengt, stelt de agent in staat om alternatieve paden door de omgeving te ontdekken, wat leidt tot betere cumulatieve beloningen.
Fundament van RL-algoritmes
RL-algoritmes kunnen grofweg worden ingedeeld in twee categorieën: 1) model-based en model-free, en 2) on-policy en off-policy.
Model-based en model-free algoritmes
Bij model-based methoden probeer je het waarschijnlijkheidsmodel van de omgeving te voorspellen P(r, s' | s, a) - de kans op het ontvangen van een beloning r en het bereiken van een toestand s' wanneer je start vanuit een toestand s en actie a neemt.
Deze methoden gebruiken de interacties van de agent met de omgeving om het model (van de omgeving) te verfijnen en de voorspelde beloningen en toestanden te verbeteren. Zo kan de agent de omgeving via het model simuleren, zonder bij elke stap per se met de echte omgeving te interageren.
Sommige model-based algoritmes zoals Dyna-Q werken de Q-functie bij via gesimuleerde ervaringen. Deze methoden worden gebruikt wanneer het duur of onpraktisch is om een ongetrainde agent veel interacties met de omgeving te laten hebben. Het is bijvoorbeeld te kostbaar om een ongetrainde robot herhaaldelijk te laten vallen met mogelijk schade tot gevolg.
Daarentegen werken model-free methoden zoals Q-learning Q(s,a) direct bij via een iteratief proces om te convergeren naar de ware actiewaarde-functie zonder de omgeving expliciet te modelleren. De agent interageert bij elke stap direct met de omgeving. Ze gebruiken trial-and-error om te convergeren naar het optimale beleid. Omdat ze geen model van de omgeving gebruiken, zijn ze eenvoudiger maar vereisen ze veel interacties met de omgeving.
Model-free algoritmes, zoals Q-learning, SARSA (State-Action-Reward-State-Action) en DQN’s, leren de Q-functie expliciet en gebruiken die om bij elke stap de actiewaarde te schatten.
On-policy en off-policy algoritmes
Off-policy algoritmes (zoals DQN’s en Q-learning) gebruiken experience replay om de waarde van het optimale beleid te leren. Ze hebben een grote set (echte of gesimuleerde) interacties met de omgeving, en trekken willekeurige steekproeven uit deze interacties om de Q-functie bij te werken. Ze gebruiken niet het optimale beleid om de actie in elke stap te bepalen. Off-policy methoden gebruiken de Q-functie om de actiewaarde voor het doelbeleid te schatten. Ze streven ernaar toekomstige returns te maximaliseren door de Q-functie bij te werken op basis van de hoogste verwachte beloning van de volgende stap.
Sommige on-policy algoritmes (zoals SARSA) gebruiken het beleid om de actie in elke stap te selecteren. De agent volgt dus hetzelfde beleid dat het bijwerkt. De Q-functie wordt bijgewerkt op basis van de beloning die de agent ontvangt voor het volgen van het beleid. Andere on-policy algoritmes, zoals policy gradients en actor-critic, gebruiken de Q-functie niet.
Actiewaarde-functies vormen dus de basis van diverse RL-algoritmes.
Optimale actieselectie
De Q-waarde Q(s,a) vertegenwoordigt de verwachte return van het nemen van actie a in toestand s en daarna het beleid te volgen. Dus, gegeven een getrainde Q-tabel, leidt het selecteren van de actie die de maximale Q-waarde oplevert in een bepaalde toestand tot een optimaal beleid op basis van een greedy (op exploitatie gerichte) strategie. In elke stap kiest de agent de actie a* = arg max a Q(s,a). Zo kiest het over de hele episode het pad dat de langetermijnbeloningen maximaliseert op basis van het benutten van de beschikbare informatie.
Methoden zoals Q-learning werken de Q-waarden in de Q-tabel bij over veel iteraties om te convergeren naar hun optimale waarden. Na training bereikt het algoritme dus het optimale beleid dat vanuit elke toestand de optimale actie kiest, en het optimale pad door de episode.