

Mengimplementasikan Fungsi Nilai-Aksi
Setelah membahas prinsip dasar dan penggunaan fungsi nilai-aksi, kini saya tunjukkan langkah-langkah untuk mengimplementasikannya di Python.
Langkah 1: Definisikan lingkungan
Impor paket prasyarat, termasuk Gymnasium dan NumPy:
import gymnasium as gym
import numpy as np
import math
import randomInisialisasi sebuah lingkungan RL dari Gymnasium. Dalam artikel ini, kita melatih agen RL untuk menyelesaikan lingkungan CartPole.
env = gym.make('CartPole-v1')Langkah 2: Inisialisasi Q-table
Ruang observasi CartPole memiliki empat state: posisi kereta, kecepatan kereta, sudut tiang, dan kecepatan sudut tiang.
Pada contoh ini, kita hanya berfokus pada observasi sudut tiang dan kecepatan sudut tiang. Jadi, kita membuat Q-table diskret sebagai berikut:
- Satu state diskret untuk posisi kereta - semua nilai yang mungkin dikelompokkan ke dalam satu state ini.
- Satu state diskret untuk kecepatan kereta
- Enam state diskret untuk sudut tiang
- Tiga state diskret untuk kecepatan tiang
Jumlah kolom didasarkan pada ukuran ruang aksi, dalam kasus ini, 2.
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))Dalam lingkungan CartPole, ruang state bersifat kontinu. Sudut, kecepatan, dan posisi tiang pada kereta dapat bervariasi secara kontinu. Ruang aksi bersifat diskret — Anda dapat mendorong kereta ke kiri atau ke kanan.
Q-Learning menggunakan Q-table hanya dapat digunakan pada ruang diskret karena Anda perlu secara eksplisit membuat tabel nilai Q untuk sekumpulan state dan aksi. Jadi, langkah pertama adalah mendiskretisasi ruang state kontinu.
Kita terlebih dahulu mempertimbangkan batas atas dan bawah dari variabel ruang state. Kita melihat bahwa kecepatan kereta dan kecepatan sudut tiang memiliki batas tak hingga. Maka, kita secara artifisial menetapkan batas atas dan bawah pada variabel-variabel state ini.
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]Kita membuat fungsi untuk mendiskretisasi nilai state kontinu menjadi diskret:
def discretize_state(state):
discrete_states = []
for i in range(len(state)):
if state[i] <= STATE_BOUNDS[i][0]:
discrete_state = 0
elif state[i] >= STATE_BOUNDS[i][1]:
discrete_state = NUM_BUCKETS[i] - 1
else:
bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
scaling = (NUM_BUCKETS[i] - 1) / bound_width
discrete_state = int(round(scaling * state[i] - offset))
discrete_states.append(discrete_state)
return tuple(discrete_states)Langkah 3: Perbarui Q-table
Persamaan Bellman memberikan rumus untuk memperbarui nilai Q berdasarkan laju pembelajaran, tingkat diskonto, reward pada langkah berikutnya, dan nilai Q maksimal yang diharapkan dari state berikutnya. Ini menyatakan nilai ekspektasi suatu state sebagai jumlah dari dua bagian:
- Reward langsung menuju state berikutnya
- Nilai ekspektasi terdiskonto dari state berikutnya
Persamaan Bellman bersifat rekursif. Dengan demikian, dimungkinkan untuk menulis program iteratif, dimulai dari state awal acak, untuk menemukan fungsi nilai-aksi yang optimal.
Persamaan untuk memperbarui Q-table adalah:
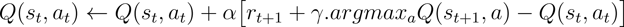
Pada ekspresi di atas:
- State saat ini adalah st, dinyatakan sebagai
state_currentdi dalam kode. - State berikutnya adalah st+1 (
state_next). - Aksi yang diambil pada state saat ini adalah at (
action). - Q(st, at) adalah nilai Q saat ini untuk state st dan aksi at
- α adalah laju pembelajaran (learning rate).
- γ adalah faktor diskonto.
- rt+1 adalah reward setelah mengambil aksi at pada langkah saat ini dengan state st. Kode di bawah merepresentasikannya sebagai
reward. - argmaxa Q(st+1, a) adalah nilai Q maksimum dari state berikutnya st+1. Pada potongan kode di bawah, ini direpresentasikan sebagai
best_q.
Kode berikut mengimplementasikan fungsi untuk memperbarui Q-table
def update_q(state_current, state_next, action, reward, alpha):
best_q = np.amax(q_table[state_next])
q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qLangkah 4: Latih agen
Deklarasikan parameter pelatihan:
- Jumlah maksimum episode pelatihan
- Jumlah maksimum langkah per episode berasal dari dokumentasi lingkungan. Untuk CartPole-v1, nilainya 500.
- Jumlah langkah yang harus diselesaikan agen agar episode diklasifikasikan sebagai sukses. Kita tetapkan di 450.
- Jumlah episode sukses yang harus diselesaikan agen berturut-turut agar pelatihan dianggap berhasil. Kita tetapkan di 50.
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50Deklarasikan hyperparameter:
- Nilai minimum dan maksimum tingkat eksplorasi, ε
- Nilai minimum dan maksimum laju pembelajaran, α
- Laju peluruhan α dan γ
- Faktor diskonto, γ
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25Sebelum melatih agen, kita menulis dua fungsi untuk meluruhkan laju pembelajaran dan tingkat eksplorasi secara bertahap. Hyperparameter ini menurun nilainya secara bertahap sepanjang pelatihan.
def decay_epsilon(step):
return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
def decay_alpha(step):
return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))Kita juga menulis fungsi untuk memilih aksi secara stokastik. Kita terlebih dahulu menghasilkan sebuah angka acak.
- Jika angka acak ini lebih kecil dari ε, kita secara acak memilih aksi dari ruang aksi. Ini adalah strategi eksplorasi.
- Jika angka acak lebih besar dari ε, kita memilih aksi yang sesuai dengan nilai Q maksimum. Ini adalah strategi eksploitasi.
def select_action(state, epsilon):
if random.random() < epsilon:
action = env.action_space.sample()
else:
action = np.argmax(q_table[state])
return actionKita membangun sebuah loop untuk melatih agen berdasarkan langkah-langkah berikut:
- Ambil nilai yang telah diluruhkan dari α dan ε untuk episode saat ini.
- Reset lingkungan dan diskretkan ruang observasi untuk memulai lingkungan baru bagi episode.
- Jalankan agen di dalam lingkungan hingga mencapai jumlah langkah maksimum atau terminasi.
- Untuk setiap langkah:
- Pilih aksi sesuai fungsi
select_action()yang telah dideklarasikan sebelumnya. - Jalankan aksi pada lingkungan untuk mendapatkan reward dan state berikutnya.
- Ambil nilai Q tertinggi dari Q-table.
- Perbarui Q-table sesuai fungsi
update_q()yang telah dideklarasikan sebelumnya.
Kode di bawah ini mengimplementasikan langkah-langkah dari loop pelatihan:
def train():
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
state_current = state_next
if done:
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
print("=============SUCCESS=============")
else:
successful_episodes = 0
print("=============FAIL=============")
break
if successful_episodes > SUCCESS_STREAK:
breakTerakhir, jalankan loop pelatihan, tutup lingkungan, dan cetak nilai akhir dari Q-table.
train()
env.close()
print(q_table)Gunakan buku kerja DataLab ini sebagai titik awal untuk mengedit dan mengeksekusi kode Q-Learning.
Perluasan ke Deep Q-Learning
Pada bagian sebelumnya, kita mendiskretisasi ruang observasi (state) kontinu untuk menggunakan Q-table. Q-table yang besar (untuk lingkungan yang kompleks) tidak efisien secara komputasi. Dalam kasus seperti itu, fungsi Q dapat diaproksimasi menggunakan jaringan saraf. Ini disebut Deep Q-Network, dinyatakan sebagai Q(s, a; θ), di mana parameter θ mewakili bobot jaringan saraf. Metode ini disebut Deep Q-learning. Secara lebih umum, RL menggunakan jaringan saraf dalam disebut Deep Reinforcement Learning.
Alih-alih menggunakan Q-Table untuk memilih aksi bagi setiap state, jaringan saraf DQN menerima state sebagai masukan dan mengembalikan nilai Q untuk setiap aksi yang mungkin pada state tersebut.
Jaringan dilatih melalui metode tradisional (seperti backpropagation) untuk meminimalkan temporal difference (TD) error. TD error δ adalah selisih antara nilai Q yang diprediksi dan nilai Q target (dihitung sebagai jumlah reward dari state saat ini dan nilai terdiskonto dari reward maksimum yang diharapkan dari state berikutnya).
Saat diimplementasikan sebagai jaringan saraf (dengan parameter jaringan θ), TD error dinyatakan sebagai:
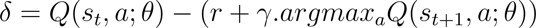
Perhatikan bahwa baik nilai Q maupun nilai Q target dihitung menggunakan jaringan saraf yang sama.
Pada setiap iterasi, parameter jaringan (θ) diperbarui. Pembaruan jaringan (melalui backprop) didasarkan pada nilai target yang dihitung menggunakan θ sebelum pembaruan. Menghitung nilai target dengan hasil yang sama yang terus diperbarui menghasilkan target yang terus bergerak. Ini membuat pelatihan tidak stabil.
Untuk menghindari masalah di atas, kita membuat jaringan baru untuk menghitung nilai Q target. Ini adalah target network. Jaringan ini berbasis parameter yang sama dengan policy network tetapi diperbarui lebih jarang. Dengan demikian, proses pelatihan memiliki target yang stabil terhadapnya backpropagation diterapkan.
Jika kita merepresentasikan bobot target network dengan θ-, persamaan sebelumnya dinyatakan ulang sebagai:
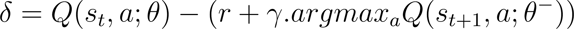
Bagian berikut akan menunjukkan cara mengimplementasikan dan melatih DQN sederhana di lingkungan CartPole.
Contoh implementasi
Instal paket prasyarat, termasuk Gymnasium dan PyTorch.
!pip install gymnasium matplotlib torchImpor paket yang diperlukan dalam lingkungan Python:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as FBuat lingkungan CartPole:
env = gym.make("CartPole-v1")Inisialisasi lingkungan dan deklarasikan konstanta Python dengan ukuran ruang state dan ruang aksi lingkungan.
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.nDeklarasikan kelas Python untuk jaringan saraf sederhana dengan satu hidden layer. Jumlah layer input adalah ukuran ruang state (ruang observasi). Jumlah layer output adalah jumlah aksi yang mungkin diambil agen RL. Jaringan ini secara internal mensimulasikan Q-table dan memprediksi nilai aksi berdasarkan state masukan.
class DQN(nn.Module):
def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
super(DQN, self).__init__()
self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
self.layer2 = nn.Linear(128, 128)
self.layer3 = nn.Linear(128, NUM_ACTIONS)
def forward(self, x):
x = F.relu(self.layer1(x))
x = F.relu(self.layer2(x))
return self.layer3(x)Buat policy network dan target network. Muat target network dengan parameter milik policy network menggunakan state dictionary. Inisialisasi optimizer untuk melatih jaringan saraf.
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())
optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)Pelatihan dengan replay buffer
Metode RL off-policy tanpa model seperti Q-Learning (dibahas pada bagian sebelumnya) dan DQN dilatih menggunakan sampel acak dari interaksi agen dengan lingkungan. Aksi agen dan respons lingkungan (reward dan state berikutnya) dikumpulkan dan disimpan. Sampel acak dari interaksi ini dipilih pada setiap iterasi pelatihan untuk membentuk batch pelatihan.
Deklarasikan objek tuple untuk menyimpan state (observasi) lingkungan pada setiap interaksi:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))Buat kelas Python untuk replay buffer:
class ReplayMemory(object):
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, *args):
self.memory.append(Transition(*args))
def sample(self, batch_size):
return random.sample(self.memory, batch_size)
def __len__(self):
return len(self.memory)Buat objek memori untuk menyimpan sejumlah besar interaksi. Interaksi ini digunakan untuk melatih agen.
memory = ReplayMemory(10000)Sebelum pelatihan, deklarasikan parameter dan hyperparameter:
- Parameter:
- Ukuran batch
- Jumlah maksimum episode pelatihan
- Hyperparameter:
- Laju pembelajaran (
LR) - Faktor diskonto (
GAMMA) - Laju pembaruan target network (
TAU) - Nilai awal dan akhir tingkat eksplorasi, serta laju peluruhan (
EPS_START,EPS_END, danEPS_DECAY)
MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4Tulis fungsi untuk memilih aksi berdasarkan tingkat eksplorasi, dengan langkah-langkah berikut:
- Hitung tingkat eksplorasi berdasarkan jumlah langkah dalam episode (serta nilai awal, akhir, dan laju peluruhannya).
- Hasilkan sebuah angka acak.
- Jika angka acak lebih besar daripada tingkat eksplorasi, pilih aksi yang diprediksi oleh policy network.
- Jika lebih kecil daripada tingkat eksplorasi, pilih aksi acak dari ruang aksi.
steps_done = 0
def select_action(state):
global steps_done
sample = random.random()
eps_threshold = EPS_END + (EPS_START - EPS_END) * \
math.exp(-1. * steps_done / EPS_DECAY)
steps_done += 1
if sample > eps_threshold:
with torch.no_grad():
action = policy_net(state).max(1).indices.view(1, 1)
return action
else:
action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
return actionTulis fungsi untuk mengoptimalkan model berdasarkan langkah-langkah berikut:
- Buat batch menggunakan sampel acak dari interaksi agen dengan lingkungan. Setiap item dalam sampel berkaitan dengan satu langkah waktu. Isinya meliputi:
- State lingkungan saat ini
- Aksi agen
- Reward yang diterima
- State berikutnya
- Dalam CartPole, diharapkan agen terus memanipulasi tiang kereta tanpa terminasi (menabrak tepi atau jatuh). Oleh karena itu, kita hanya mempertimbangkan interaksi yang tidak mengarah ke state terminal. Kita membuat mask (
non_final_mask) untuk mengidentifikasi state yang tidak diikuti oleh state terminal. - Identifikasi state yang tidak diikuti oleh state terminal (
non_final_next_states). - Ambil state-action values untuk semua state saat ini st dengan meneruskan state saat ini ke policy network.
- Ambil expected state-action values untuk semua state berikutnya st+1 dengan meneruskan state berikutnya ke target network dan menggunakan persamaan:
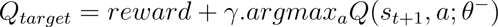
- Hitung loss berdasarkan selisih antara action values dan expected action values:
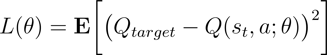
- Backpropagate loss untuk menghitung gradien.
- Klip nilai gradien dan perbarui policy network untuk memastikan pelatihan yang stabil.
Kode berikut menunjukkan cara mengimplementasikan optimizer:
batch = 0
def optimize_model():
global batch
if len(memory) < BATCH_SIZE:
return
transitions = memory.sample(BATCH_SIZE)
batch = Transition(*zip(*transitions))
non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
batch.next_state)), dtype=torch.bool)
non_final_next_states = torch.cat([s for s in batch.next_state
if s is not None])
state_batch = torch.cat(batch.state)
action_batch = torch.cat(batch.action)
reward_batch = torch.cat(batch.reward)
state_action_values = policy_net(state_batch).gather(1, action_batch)
next_state_values = torch.zeros(BATCH_SIZE )
with torch.no_grad():
next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values
expected_state_action_values = (next_state_values * GAMMA) + reward_batch
loss_func = nn.SmoothL1Loss()
loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))
optimizer.zero_grad()
loss.backward()
torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
optimizer.step()Tulis loop pelatihan untuk melatih agen:
- Reset lingkungan dan mulai episode baru.
- Gunakan fungsi
select_action()untuk menentukan aksi agen. - Dapatkan reward dan state berikutnya dari lingkungan berdasarkan aksi.
- Tambahkan state, aksi, state berikutnya, dan reward ke replay buffer.
- Jalankan optimizer (didefinisikan di atas). Optimizer menghitung nilai Q dan loss, menerapkan backpropagation untuk memperbarui jaringan.
- Perbarui target network berdasarkan policy network.
- Lanjutkan episode hingga mencapai state terminal.
Kode berikut mengimplementasikan langkah-langkah tersebut:
def train():
for episode in range(MAX_EPISODES):
# Initialize the environment and get its state
state, info = env.reset()
state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
for t in count():
action = select_action(state)
observation, reward, terminated, truncated, _ = env.step(action.item())
reward = torch.tensor([reward])
done = terminated or truncated
if terminated:
next_state = None
else:
next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)
memory.push(state, action, next_state, reward)
state = next_state
optimize_model()
target_net_state_dict = target_net.state_dict()
policy_net_state_dict = policy_net.state_dict()
for key in policy_net_state_dict:
target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
target_net.load_state_dict(target_net_state_dict)
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
print('count -- ', t)
#plot_durations()
breakAnda dapat melihat, mengedit, dan menjalankan program pelatihan DQN menggunakan buku kerja DataLab ini.
Memvisualisasikan Fungsi Nilai-Aksi
Akan sangat membantu untuk melacak kemajuan proses pelatihan secara visual. Memvisualisasikan nilai aksi membantu mengenali di mana pelatihan gagal dan parameter atau hyperparameter apa yang perlu diubah.
Misalnya, jika Anda mengamati secara visual bahwa peningkatan performa model terlalu lambat, Anda mungkin ingin meningkatkan laju pembelajaran. Jika Anda melihat model sedang belajar tetapi belum sepenuhnya terlatih, menambah jumlah episode pelatihan mungkin membantu. Jika Anda menemukan pelatihan tidak stabil, Anda mungkin ingin menurunkan laju pembelajaran atau menyetel koefisien eksplorasi, atau laju pembaruan target network (TAU).
Selain nilai Q, akan membantu juga untuk memplot jumlah langkah sukses di setiap episode. Pada Q-Learning menggunakan Q-table, nilai Q disimpan secara eksplisit. Namun, saat menggunakan DQN, nilai Q tidak disimpan secara eksplisit. Jaringan menghasilkan aksi bergantung pada bobotnya dan state. Jadi, melacak jumlah langkah sukses di setiap episode dapat lebih bermakna untuk DQN.
Langkah-langkah berikut menjelaskan cara memplot nilai Q dan jumlah langkah sukses per episode untuk melatih algoritma Q-learning:
- Buat dua array kosong di awal pelatihan:
q_vals- untuk menyimpan nilai Q pada setiap langkah di setiap episode.success_steps- untuk menyimpan jumlah langkah sukses di setiap episode.- Pada setiap langkah (di semua episode):
- Tambahkan nilai Q untuk langkah tersebut ke array
q_vals - Setelah setiap episode berakhir, tambahkan ke array
success_stepsjumlah langkah sukses pada episode tersebut. - Plot kedua array tersebut.
Kode di bawah menunjukkan loop pelatihan Q-Learning (menggunakan Q-table) yang ditampilkan pada bagian sebelumnya, diperbarui untuk melacak nilai Q dan jumlah langkah sukses:
q_vals = []
success_steps = []
def train():
global q_vals
global success_steps
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
q_vals.append(best_q)
state_current = state_next
if done:
q_vals.append(best_q)
success_steps.append(step)
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
else:
successful_episodes = 0
break
if successful_episodes > SUCCESS_STREAK:
print("Training successful")
returnPotongan berikut menunjukkan cara memplot nilai Q di setiap episode:
def plot_q():
plt.plot(q_vals)
plt.title('Q-values over training steps')
plt.xlabel('Training steps')
plt.ylabel('Q-value')
plt.show()Potongan berikut menunjukkan cara memplot jumlah langkah sukses di setiap episode:
def plot_steps():
plt.plot(success_steps)
plt.title('Successful steps over training episodes')
plt.xlabel('Training episode')
plt.ylabel('Successful steps')
plt.show()- Buku kerja DataLab untuk mengimplementasikan Q-learning menggunakan fungsi nilai-aksi juga mencakup kode untuk memplot nilai Q dan langkah sukses per episode.
- Notebook untuk mengimplementasikan DQN juga mencakup kode untuk memplot jumlah langkah sukses per episode.
Mengevaluasi kinerja agen
Perlu untuk menentukan kriteria untuk memutuskan apakah dan kapan agen telah berhasil dilatih. Dalam ML tradisional, tujuan pelatihan adalah meminimalkan loss: selisih antara nilai prediksi dan nilai benar. Dalam RL, tujuannya adalah memaksimalkan reward kumulatif. Pelatihan dianggap berhasil ketika agen memperoleh reward maksimum dari lingkungan.
Lingkungan seperti CartPole tidak berakhir sampai mencapai kondisi terminal, seperti menabrak tepi atau membiarkan tiang kereta miring berlebihan. Dalam kasus seperti itu, agen yang terlatih dapat terus berinteraksi dengan lingkungan tanpa batas. Oleh karena itu, jumlah maksimum langkah sukses diberlakukan secara artifisial. Pada CartPole-v1 milik Gymnasium, episode diakhiri ketika mencapai 500 timestep tanpa terminasi.
Kita mengevaluasi kinerja agen selama beberapa episode berturut-turut untuk menilai apakah pelatihan berhasil. Misalnya:
- Agen harus dapat menyelesaikan lebih dari ambang jumlah langkah (
SUCCESS_STEPS) rata-rata pada N episode terakhir. Pada contoh di artikel ini, kita menetapkan ambang ini di 450. - Agen dapat melampaui ambang tersebut dalam N episode berturut-turut (
SUCCESS_STREAK). Pada contoh ini, kita menetapkan N sebesar 50.
Sebagai contoh praktis, pertimbangkan potongan dari loop pelatihan DQN yang ditunjukkan sebelumnya.
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
print('average steps over last 50 episodes -- ', average_steps)
if average_steps > SUCCESS_STEPS:
print("training successful.")
return
breakAkan membantu untuk mengevaluasi kinerja agen berdasarkan mengeksekusi langkah-langkah berikut pada akhir (state terminal) setiap episode pelatihan:
- Tambahkan total jumlah langkah dalam episode ini (sebelum berakhir) ke sebuah array. Array ini melacak total jumlah langkah di setiap episode.
- Hitung rata-rata dari N nilai terakhir dalam array ini. Pada contoh ini, N (
SUCCESS_STREAK) adalah 50. Jadi, kita menghitung rata-rata langkah selama 50 episode terakhir. - Jika rata-rata ini lebih besar dari ambang batas (
SUCCESS_STEPS), kita mengakhiri pelatihan. Pada contoh ini, ambang tersebut ditetapkan pada 450 langkah.
Praktik Terbaik untuk Menggunakan Fungsi Nilai-Aksi
Berikut adalah beberapa praktik terbaik yang dapat Anda ikuti untuk hasil yang lebih baik dari implementasi fungsi nilai-aksi Anda.
Seimbangkan eksplorasi dan eksploitasi
Dengan fungsi nilai-aksi yang benar, agen dapat memaksimalkan imbal hasil yang diharapkan dengan mengadopsi strategi serakah (greedy), yakni memilih aksi dengan nilai tertinggi di setiap langkah. Ini disebut eksploitasi terhadap informasi yang tersedia. Namun, menggunakan strategi serakah dengan fungsi nilai-aksi yang belum terlatih (yang belum merepresentasikan nilai-aksi sesungguhnya) akan membuat agen terjebak pada optimum lokal.
Selama pelatihan, penting untuk mengeksplorasi lingkungan sekaligus mengeksploitasi informasi yang tersedia.
Pada tahap awal proses pelatihan, informasi yang tersedia didasarkan pada fungsi nilai yang acak. Karena itu, informasi ini tidak terlalu bernilai (untuk dieksploitasi dengan strategi serakah). Lebih penting untuk mengeksplorasi lingkungan guna menemukan imbalan dari berbagai kemungkinan aksi di keadaan yang berbeda.
Seiring Q-table diperbarui (atau DQN dilatih), menjadi layak untuk sebagian mengeksploitasi informasi yang tersedia guna memaksimalkan imbalan. Menjelang tahap akhir pelatihan, agen mengonvergensi ke fungsi nilai yang benar; eksplorasi lebih lanjut bisa merugikan. Karena itu, agen memprioritaskan eksploitasi fungsi nilai yang sudah diketahui.
Sesuaikan hiperparameter
Seperti pada model machine learning mana pun, hiperparameter penting untuk berhasil melatih algoritma RL. Dalam kasus Q-Learning dan DQN, hiperparameternya adalah epsilon (laju eksplorasi), alpha (laju pembelajaran), dan gamma (tingkat diskonto).
- ε (epsilon) mengendalikan keseimbangan antara eksplorasi dan eksploitasi (dibahas di atas). Semakin tinggi nilai epsilon, semakin penting eksplorasi relatif terhadap eksploitasi. Di awal pelatihan, nilainya tinggi seperti 0,9, lalu secara bertahap diturunkan menjadi nilai kecil seperti 0,05 menjelang akhir pelatihan.
- α (alpha) adalah laju pembelajaran (LR). Ini mengendalikan seberapa besar parameter jaringan saraf (dalam kasus DQN) atau nilai pada Q-Table berubah di setiap iterasi pelatihan. Jika LR terlalu tinggi, model menjadi tidak stabil dan gagal konvergen. Sebaliknya, LR yang rendah membuat konvergensi lambat. Umum juga untuk memulai dengan nilai LR yang tinggi pada awal proses pelatihan saat agen perlu mengeksplorasi lingkungan. Saat semakin mendekati nilai sebenarnya dari fungsi Q, LR diturunkan untuk membantu jaringan berkonsvergensi.
- γ (gamma) adalah tingkat diskonto. Ini menentukan pentingnya imbalan pada timestep berikutnya dibandingkan imbalan langsung. Nilai gamma yang tinggi berarti imbalan di masa mendatang penting. Nilai gamma 0 berarti hanya imbalan dari timestep saat ini yang penting, dan imbalan selanjutnya tidak memiliki arti. Dalam algoritma seperti Q-learning, total return didasarkan pada imbalan yang diperoleh sepanjang episode. Jadi, menggunakan tingkat diskonto tinggi, seperti 0,99, adalah hal yang umum.
Terakhir, pahami bahwa pelatihan RL sensitif terhadap nilai acak awal. Jika pelatihan tidak konvergen, sering kali berguna untuk menggunakan seed acak yang berbeda atau menjalankan ulang pelatihan agar dimulai dengan kumpulan nilai awal acak yang berbeda.
Mulailah dari lingkungan sederhana
Melatih agen RL untuk lingkungan kompleks itu menantang. Fungsi Q digunakan di banyak algoritma berbeda, sehingga penting untuk membangun intuisi dalam melatih agen RL berbasis Q-learning. Ini paling baik dilakukan dengan mempraktikkan teknik-teknik tersebut pada lingkungan yang lebih sederhana seperti CartPole sebelum menerapkannya ke lingkungan yang lebih kompleks.
Selain itu, lingkungan kompleks lebih mahal untuk dilatih, sehingga lebih ekonomis menggunakan lingkungan yang lebih sederhana sebagai sarana belajar.
Kesimpulan
Artikel ini membahas prinsip-prinsip teoretis mendasar dari fungsi nilai-aksi dan signifikansinya dalam RL. Kita membahas bagaimana fungsi nilai-aksi digunakan dalam Q-learning dan Deep Q-learning, serta mengimplementasikan keduanya langkah demi langkah di Python.
Untuk melanjutkan pembelajaran Anda, saya sangat merekomendasikan kursus Deep Reinforcement Learning in Python.
FAQ
Apa perbedaan antara fungsi nilai dan fungsi nilai-aksi dalam RL?
Fungsi nilai memperkirakan imbal hasil yang diharapkan dari suatu keadaan, sedangkan fungsi nilai-aksi (fungsi Q) memperkirakan imbal hasil dari melakukan aksi tertentu dalam suatu keadaan dan kemudian mengikuti kebijakan tersebut. Fungsi nilai-aksi memberikan panduan yang lebih terperinci untuk pengambilan keputusan.
Mengapa fungsi nilai-aksi penting dalam Q-learning?
Q-learning menggunakan fungsi nilai-aksi untuk membimbing agen menuju aksi yang menghasilkan imbal hasil yang diharapkan tertinggi. Fungsi ini memungkinkan pembelajaran off-policy dan membantu agen berkonsvergensi pada strategi optimal seiring waktu.
Bagaimana hubungan fungsi nilai-aksi dengan persamaan Bellman?
Persamaan Bellman memberikan formulasi rekursif untuk memperbarui nilai Q berdasarkan imbalan langsung dan imbalan masa depan maksimum yang didiskontokan. Ini adalah landasan untuk mempelajari fungsi nilai-aksi secara iteratif.
Bisakah saya menggunakan fungsi nilai-aksi di ruang keadaan kontinu?
Ya, tetapi Q-table menjadi tidak praktis di ruang kontinu. Dalam kasus seperti itu, Deep Q-Network (DQN) digunakan untuk mendekati fungsi nilai-aksi dengan jaringan saraf alih-alih tabel eksplisit.
Apa peran eksplorasi dalam memperkirakan fungsi nilai-aksi?
Eksplorasi memastikan agen tidak terlalu cepat berkonsvergensi pada kebijakan yang suboptimal. Ini membantu agen mengumpulkan pengalaman yang beragam, yang penting untuk memperkirakan fungsi nilai-aksi secara akurat selama pelatihan.
Bagaimana strategi ε-greedy memengaruhi pembelajaran nilai Q?
Strategi ε-greedy menyeimbangkan eksplorasi dan eksploitasi. Dengan probabilitas ε, agen mengeksplorasi aksi baru, dan dengan probabilitas 1–ε, agen mengeksploitasi aksi terbaik yang diketahui saat ini. Pertukaran ini meningkatkan stabilitas pembelajaran dan konvergensi.
Kapan sebaiknya Anda beralih dari Q-learning ke Deep Q-learning?
Saat lingkungan memiliki ruang keadaan yang besar atau kontinu, memelihara Q-table menjadi tidak efisien. Deep Q-learning menggantikan tabel dengan jaringan saraf yang lebih skalabel untuk lingkungan kompleks.
Bagaimana saya dapat memvisualisasikan fungsi nilai-aksi selama pelatihan?
Anda dapat memplot nilai Q maksimum dari waktu ke waktu atau melacak imbalan per episode untuk memantau kemajuan pembelajaran. Visualisasi membantu mendiagnosis masalah seperti konvergensi yang buruk atau eksplorasi yang tidak memadai.
Apa tantangan utama dalam melatih fungsi nilai-aksi?
Tantangannya meliputi ketidakstabilan pelatihan karena target yang berubah, eksplorasi yang buruk, dan pengaturan hiperparameter yang suboptimal. Menggunakan teknik seperti replay memory dan target network membantu mengurangi masalah ini.
Apakah fungsi nilai-aksi digunakan dalam algoritma on-policy?
Ya, algoritma seperti SARSA menggunakan fungsi nilai-aksi tetapi memperbaruinya menggunakan aksi yang benar-benar diambil oleh kebijakan saat ini. Ini kontras dengan metode off-policy seperti Q-learning yang menggunakan nilai Q maksimum dari keadaan berikutnya.

Arun adalah mantan pendiri startup yang gemar membangun hal-hal baru. Saat ini ia mengeksplorasi landasan teknis dan matematis Kecerdasan Buatan. Ia senang berbagi apa yang dipelajarinya, sehingga ia menulis tentang topik tersebut.
Selain di DataCamp, Anda dapat membaca publikasinya di Medium, Airbyte, dan Vultr.




Reinforcement Learning (RL) adalah paradigma machine learning di mana sebuah agen belajar membuat keputusan yang tepat dengan berinteraksi dengan lingkungan eksternal. Lingkungan memberikan umpan balik berupa ganjaran (reward) saat agen mengambil aksi yang benar.
Tujuan agen adalah memaksimalkan ganjaran kumulatif. Dalam banyak kasus praktis, umpan balik kepada agen berasal dari manusia; ini disebut RL dengan umpan balik manusia (RLHF).
RLHF umum digunakan untuk menyetel LLM agar menghasilkan keluaran yang selaras dengan nilai dan preferensi manusia. Ketika AI digunakan untuk memberikan umpan balik, ini disebut RL dengan umpan balik AI.
Agen menggunakan fungsi nilai aksi untuk mengevaluasi aksi apa yang harus dipilih pada setiap langkah. Fungsi nilai aksi yang teroptimasi membantu agen memilih aksi terbaik di setiap langkah untuk memaksimalkan ganjaran kumulatifnya.
Dalam tutorial ini, saya akan memperkenalkan fungsi nilai aksi, menjelaskan perannya dalam RL, dan menunjukkan cara mengimplementasikannya dari nol.
Apa itu Fungsi Nilai Aksi?
Fungsi nilai aksi (Q) memperkirakan ekspektasi ganjaran kumulatif (return) yang diperoleh dengan mengambil aksi tertentu (a) dalam keadaan (state) tertentu (s) dan mengikuti kebijakan π selanjutnya. Ini dilambangkan sebagai Qπ(s,a). Ketika jelas bahwa agen mengikuti kebijakan optimal, ini dinyatakan lebih sederhana sebagai Q(s,a).
Fungsi nilai aksi digunakan untuk memilih aksi yang mengarah pada return tertinggi dengan mulai dari suatu state tertentu. Kebijakan optimal (π*) memaksimalkan ekspektasi return. Jadi, pada setiap state s, kebijakan memilih aksi yang mengarah pada ekspektasi return tertinggi. Kebijakan optimal ini dinyatakan sebagai π* = argmaxa Q(s,a).
Fungsi Q secara tradisional dimodelkan sebagai Q-table. Tabel ini menyimpan nilai setiap kemungkinan aksi untuk setiap kemungkinan state dari lingkungan. Untuk lingkungan yang kompleks, tabel ini menjadi sangat besar dan tidak efisien. Karena itu, kita memodelkan Q-table sebagai jaringan saraf alih-alih tabel untuk sebagian besar lingkungan non-sepele. Jaringan ini mendekati fungsi Q-table. Diberikan sebuah state, jaringan mengeluarkan nilai aksi yang sesuai dengan state tersebut.
Mengapa Fungsi Nilai Aksi Penting dalam RL
Dengan fungsi nilai aksi yang sebenarnya, kebijakan seharusnya memilih aksi yang mengarah pada ekspektasi ganjaran tertinggi. Strategi ini dikenal sebagai eksploitasi. Namun, fungsi nilai aksi yang sebenarnya belum diketahui selama fase pelatihan. Maka, pemilihan aksi didasarkan pada informasi yang tidak lengkap. Eksploitasi (memaksimalkan return) berdasarkan informasi yang tidak lengkap ini dapat menyebabkan tidak ditemukannya fungsi nilai aksi yang sebenarnya dan terjebak pada optimum lokal.
Di sisi lain, strategi eksploratif terkadang memilih aksi yang suboptimal, yang pada akhirnya dapat mengarah ke state dengan nilai lebih tinggi. Ini diimplementasikan sebagai strategi ε - greedy, di mana ε adalah nilai kecil. Kebijakan secara acak memilih aksi suboptimal dengan probabilitas ε dan aksi yang memaksimalkan ganjaran dengan probabilitas 1 - ε.
Mengadopsi strategi yang menyeimbangkan eksploitasi dan eksplorasi memungkinkan agen menemukan jalur alternatif melalui lingkungan, yang menghasilkan ganjaran kumulatif yang lebih baik.
Landasan algoritma RL
Algoritma RL dapat diklasifikasikan dalam dua kategori besar: 1) berbasis model dan tanpa model, serta 2) on-policy dan off-policy.
Algoritma berbasis model dan tanpa model
Dalam metode berbasis model, Anda mencoba memprediksi model distribusi probabilitas lingkungan P(r, s' | s, a) - probabilitas menerima ganjaran r dan mencapai state s' saat mulai dari state s dan mengambil aksi a.
Metode ini menggunakan interaksi agen dengan lingkungan untuk menyetel model (lingkungan) dan meningkatkan prediksi ganjaran serta state. Dengan demikian, agen dapat mensimulasikan lingkungan melalui model, tanpa harus berinteraksi langsung dengan lingkungan pada setiap langkah.
Beberapa algoritma berbasis model seperti Dyna-Q memperbarui fungsi Q melalui pengalaman tersimulasikan. Metode ini digunakan ketika mahal atau tidak praktis membiarkan agen yang belum terlatih melakukan banyak interaksi dengan lingkungan. Misalnya, terlalu mahal membiarkan robot yang belum terlatih berulang kali terjatuh dan berpotensi rusak.
Sebaliknya, metode tanpa model seperti Q-learning secara langsung memperbarui Q(s,a) mengikuti proses iteratif untuk berkongergensi ke fungsi nilai aksi yang sebenarnya tanpa memodelkan lingkungan secara eksplisit. Agen berinteraksi langsung dengan lingkungan pada setiap langkah. Mereka menggunakan coba-coba untuk berkongergensi ke kebijakan optimal. Karena tidak melibatkan model lingkungan, metode ini lebih sederhana namun memerlukan sampel interaksi dalam jumlah besar dengan lingkungan.
Algoritma tanpa model seperti Q-learning, SARSA (State-Action-Reward-State-Action), dan DQN secara eksplisit mempelajari fungsi Q dan menggunakannya untuk memperkirakan nilai aksi pada setiap langkah.
Algoritma on-policy dan off-policy
Algoritma off-policy (seperti DQN dan Q-learning) menggunakan pengalaman yang diputar ulang (experience replay) untuk mempelajari nilai kebijakan optimal. Mereka memiliki himpunan besar interaksi (nyata atau tersimulasikan) dengan lingkungan, dan mengambil sampel acak dari interaksi ini untuk memperbarui fungsi Q. Mereka tidak menggunakan kebijakan optimal untuk menentukan aksi pada setiap langkah. Metode off-policy menggunakan fungsi Q untuk memperkirakan nilai aksi bagi kebijakan target. Mereka bertujuan memaksimalkan return masa depan dengan memperbarui fungsi Q berdasarkan ekspektasi ganjaran tertinggi dari langkah berikutnya.
Beberapa algoritma on-policy (seperti SARSA) menggunakan kebijakan untuk memilih aksi pada setiap langkah. Dengan demikian, agen mengikuti kebijakan yang sama dengan yang diperbaruinya. Fungsi Q diperbarui berdasarkan ganjaran yang diterima agen karena mengikuti kebijakan tersebut. Algoritma on-policy lainnya, seperti policy gradient dan actor-critic, tidak menggunakan fungsi Q.
Dengan demikian, fungsi nilai aksi menjadi dasar dari berbagai algoritma RL.
Pemilihan aksi optimal
Nilai Q Q(s,a) mewakili ekspektasi return dari mengambil aksi a pada state s dan kemudian mengikuti kebijakan. Maka, dengan Q-table yang telah dilatih, memilih aksi yang menghasilkan nilai Q maksimum pada state tertentu mengarah pada kebijakan optimal berdasarkan strategi serakah (berfokus pada eksploitasi). Pada setiap langkah, agen memilih aksi a* = arg max a Q(s,a). Dengan demikian, sepanjang episode, agen memilih jalur yang memaksimalkan ganjaran jangka panjang berdasarkan eksploitasi informasi yang tersedia.
Metode seperti Q-learning memperbarui nilai Q dalam Q-table melalui banyak iterasi untuk berkongergensi ke nilai optimalnya. Jadi, setelah pelatihan, algoritma mencapai kebijakan optimal yang memilih aksi optimal dari setiap state, dan jalur optimal sepanjang episode.