

Aksiyon-Değeri Fonksiyonunun Uygulanması
Aksiyon-değeri fonksiyonunun temel ilkelerini ve kullanım alanlarını tartıştığımıza göre, şimdi bunu Python’da uygulama adımlarını göstereceğim.
Adım 1: Ortamı tanımlayın
Gymnasium ve NumPy dahil önkoşul paketlerini içe aktarın:
import gymnasium as gym
import numpy as np
import math
import randomGymnasium’dan bir RL ortamı başlatın. Bu yazıda, bir RL ajanını CartPole ortamını çözmek üzere eğiteceğiz.
env = gym.make('CartPole-v1')Adım 2: Q-tablosunu başlatın
CartPole gözlem uzayı dört durumdan oluşur: araba konumu, araba hızı, direk açısı ve direğin açısal hızı.
Bu örnekte yalnızca direk açısı ve direğin açısal hızı gözlemlerine odaklanıyoruz. Bu nedenle ayrık Q-tablosunu aşağıdaki şekilde oluşturuyoruz:
- Araba konumu için tek bir ayrık durum — tüm olası değerler bu tek duruma kovalanır (bucketed).
- Araba hızı için tek bir ayrık durum
- Direk açısı için altı ayrık durum
- Direk hızı için üç ayrık durum
Sütun sayısı, eylem uzayının boyutuna bağlıdır; bu örnekte 2’dir.
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))CartPole ortamında durum uzayı süreklidir. Araba-direnin açısı, hızı ve konumu sürekli olarak değişebilir. Eylem uzayı ayrık — arabayı sola veya sağa itebilirsiniz.
Q-tabloları kullanan Q-Learning yalnızca ayrık bir uzayda kullanılabilir; çünkü belirli bir durum ve eylem kümesi için Q-değerini açıkça tabloya dökmeniz gerekir. Bu nedenle ilk adım, sürekli durum uzayını ayrıklaştırmaktır.
Önce durum uzayı değişkenlerinin üst ve alt sınırlarını ele alıyoruz. Araba hızı ve direğin açısal hızının sonsuz sınırlara sahip olduğunu görüyoruz. Bu yüzden bu durum değişkenlerine yapay üst ve alt sınırlar koyuyoruz.
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]Sürekli durum değerlerini ayrık olanlara dönüştürmek için bir fonksiyon oluşturuyoruz:
def discretize_state(state):
discrete_states = []
for i in range(len(state)):
if state[i] <= STATE_BOUNDS[i][0]:
discrete_state = 0
elif state[i] >= STATE_BOUNDS[i][1]:
discrete_state = NUM_BUCKETS[i] - 1
else:
bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
scaling = (NUM_BUCKETS[i] - 1) / bound_width
discrete_state = int(round(scaling * state[i] - offset))
discrete_states.append(discrete_state)
return tuple(discrete_states)Adım 3: Q-tablosunu güncelleyin
Bellman denklemleri, öğrenme oranı, iskonto oranı, bir sonraki adıma giren ödül ve bir sonraki durumun beklenen maksimum Q-değerine dayalı olarak Q-değerlerini güncellemenin ifadesini verir. Bir durumun beklenen değerini iki parçanın toplamı olarak ifade eder:
- Bir sonraki duruma geçişteki anlık ödül
- Bir sonraki durumun iskonto edilmiş beklenen değeri
Bellman denklemi özyinelemelidir. Dolayısıyla, rastgele bir başlangıç durumundan başlayarak optimal aksiyon-değeri fonksiyonunu bulmak için yinelemeli bir program yazmak mümkündür.
Q-tablosunu güncelleme denklemi şöyledir:
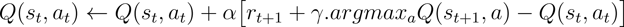
Yukarıdaki ifadede:
- Geçerli durum st olup, kodda
state_currentolarak gösterilir. - Bir sonraki durum st+1 (
state_next). - Geçerli durumda alınan eylem at (
action). - Q(st, at), st durumu ve at eylemi için geçerli Q-değeridir.
- α öğrenme oranıdır.
- γ iskonto katsayısıdır.
- rt+1 geçerli adımda at eylemini aldıktan sonra elde edilen ödüldür; kodda
rewardolarak gösterilmiştir. - argmaxa Q(st+1, a), bir sonraki durum olan st+1 durumunun maksimum Q-değeridir; aşağıdaki kod parçasında
best_qolarak temsil edilir.
Aşağıdaki kod, Q-tablosunu güncelleme fonksiyonunu uygular
def update_q(state_current, state_next, action, reward, alpha):
best_q = np.amax(q_table[state_next])
q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qAdım 4: Ajana eğitim verin
Eğitimin parametrelerini tanımlayın:
- Maksimum eğitim bölümü sayısı
- Bölüm başına maksimum adım sayısı, ortamın dokümantasyonundan gelir. CartPole-v1 için 500’dür.
- Bir bölümün başarılı sayılması için ajanın tamamlaması gereken adım sayısı. Bunu 450 olarak belirliyoruz.
- Eğitimin başarılı sayılması için ajanın art arda tamamlaması gereken başarılı bölüm sayısı. Bunu 50 olarak belirliyoruz.
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50Hiperparametreleri tanımlayın:
- Keşif oranının minimum ve maksimum değerleri, ε
- Öğrenme oranının minimum ve maksimum değerleri, α
- α ve γ sönüm oranı
- İskonto katsayısı, γ
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25Ajanı eğitmeden önce, öğrenme oranını ve keşif oranını kademeli olarak azaltacak iki fonksiyon yazıyoruz. Bu hiperparametreler, eğitim boyunca kademeli olarak azalır.
def decay_epsilon(step):
return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
def decay_alpha(step):
return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))Eylemi stokastik olarak seçmek için bir fonksiyon da yazıyoruz. Önce rastgele bir sayı üretiriz.
- Bu rastgele sayı ε’dan küçükse, eylem uzayından rastgele bir eylem seçeriz. Bu keşif stratejisidir.
- Rastgele sayı ε’dan büyükse, maksimum Q-değerine karşılık gelen eylemi seçeriz. Bu sömürücü stratejidir.
def select_action(state, epsilon):
if random.random() < epsilon:
action = env.action_space.sample()
else:
action = np.argmax(q_table[state])
return actionAjanı aşağıdaki adımlara göre eğitmek için bir döngü kuruyoruz:
- Geçerli bölüm için sönümlenmiş α ve ε değerlerini alın.
- Ortamı sıfırlayın ve bölüm için taze bir ortam başlatmak üzere gözlem uzayını ayrıklaştırın.
- Ajanı ortamda maksimum adım sayısına ulaşana veya sonlanana kadar çalıştırın.
- Her adım için:
- Önceden tanımlanan
select_action()fonksiyonuna göre eylemi seçin. - Eylemi ortamda çalıştırarak ödülü ve bir sonraki durumu alın.
- Q-tablosundan en yüksek Q-değerini alın.
- Önceden tanımlanan
update_q()fonksiyonuna göre Q-tablosunu güncelleyin.
Aşağıdaki kod, eğitim döngüsü adımlarını uygular:
def train():
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
state_current = state_next
if done:
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
print("=============SUCCESS=============")
else:
successful_episodes = 0
print("=============FAIL=============")
break
if successful_episodes > SUCCESS_STREAK:
breakSon olarak, eğitim döngüsünü çalıştırın, ortamı kapatın ve Q-tablosunun son değerini yazdırın.
train()
env.close()
print(q_table)Bu DataLab çalışma kitabını Q-Learning kodunu düzenleyip çalıştırmak için başlangıç noktası olarak kullanın.
Derin Q-Learning’e Genişletme
Önceki bölümde, Q-tablosu kullanmak için sürekli (durum) gözlem uzayını ayrıklaştırdık. Büyük bir Q-tablosu (karmaşık ortamlar için) hesaplama açısından verimsizdir. Bu gibi durumlarda Q-fonksiyonu bir sinir ağıyla yaklaştırılabilir. Bu, Q(s, a; θ) olarak ifade edilen Derin Q-Ağı’dır (DQN); burada θ , sinir ağının ağırlıklarını temsil eder. Bu yönteme Derin Q-learning denir. Daha genel olarak, derin sinir ağları kullanan RL’e Derin Pekiştirmeli Öğrenme denir.
Her durum için eylemi seçmekte Q-Tablosu kullanmak yerine, DQN sinir ağı durumu girdi olarak alır ve o durumdaki her olası eylem için Q-değerini döndürür.
Ağ, zamansal fark (TD) hatasını en aza indirmek için geleneksel yöntemlerle (geri yayılım gibi) eğitilir. TD hatası δ , tahmin edilen Q-değerleri ile hedef Q-değerleri arasındaki farktır (geçerli durumdaki ödül ile bir sonraki durumdan beklenen maksimum ödülün iskonto edilmiş değerinin toplamı olarak hesaplanır).
Bir sinir ağı olarak uygulandığında (ağ parametreleri θ ile), TD hatası şu şekilde ifade edilir:
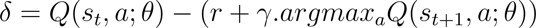
Dikkat edin; hem Q-değerleri hem de hedef Q-değerleri aynı sinir ağı kullanılarak hesaplanır.
Her yinelemede ağ parametreleri (θ) güncellenir. Ağ güncellemesi (geri yayılım ile), güncelleme öncesi θ kullanılarak hesaplanan hedef değere dayanır. Hedef değerleri aynı güncellenmiş sonuçlarla hesaplamak, sürekli hareket eden bir hedefe yol açar. Bu da eğitimi dengesiz hale getirir.
Yukarıdaki sorundan kaçınmak için hedef Q değerlerini hesaplamak üzere yeni bir ağ oluştururuz. Bu, hedef ağdır. Politika ağı ile aynı parametrelere dayanır, ancak daha seyrek güncellenir. Böylece eğitim süreci, geri yayılım uyguladığı daha sabit bir hedefe sahip olur.
Hedef ağın ağırlıklarını θ- ile gösterirsek, önceki denklem şu şekilde yeniden ifade edilir:
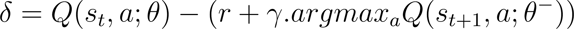
Aşağıdaki bölümler, CartPole ortamında basit bir DQN’in nasıl uygulanıp eğitileceğini gösterecek.
Örnek uygulama
Gymnasium ve PyTorch dahil önkoşul paketleri yükleyin.
!pip install gymnasium matplotlib torchGerekli paketleri Python ortamına içe aktarın:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as FCartPole ortamını oluşturun:
env = gym.make("CartPole-v1")Ortamı başlatın ve ortamın durum ve eylem uzaylarının boyutlarıyla ilgili Python sabitlerini tanımlayın.
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.nTek gizli katmanlı basit bir sinir ağı için bir Python sınıfı tanımlayın. Girdi katmanlarının sayısı, durum uzayının (gözlem uzayı) boyutudur. Çıkış katmanlarının sayısı, RL ajanının alabileceği olası eylem sayısıdır. Bu ağ, Q-tablosunu içsel olarak simüle eder ve bir giriş durumu verildiğinde eylem değerlerini tahmin eder.
class DQN(nn.Module):
def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
super(DQN, self).__init__()
self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
self.layer2 = nn.Linear(128, 128)
self.layer3 = nn.Linear(128, NUM_ACTIONS)
def forward(self, x):
x = F.relu(self.layer1(x))
x = F.relu(self.layer2(x))
return self.layer3(x)Bir politika ağı ve bir hedef ağ oluşturun. Hedef ağı, durum sözlüğünü kullanarak politika ağının parametreleriyle yükleyin. Sinir ağını eğitmek için bir optimize edici başlatın.
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())
optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)Tekrar oynatma tamponuyla eğitim
Q-Learning (önceki bölümde tartışıldı) ve DQN gibi off-policy modelsiz RL yöntemleri, ajanın ortamla etkileşimlerinin rastgele bir örneklemi kullanılarak eğitilir. Ajanın eylemleri ve ortamın yanıtları (ödül ve sonraki durum) toplanıp saklanır. Her eğitim yinelemesinde bu etkileşimlerin rastgele bir örneklemi çekilerek bir eğitim yığını oluşturulur.
Her etkileşimde ortamın durumunu (gözlemini) saklamak için bir tuple nesnesi tanımlayın:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))Tekrar oynatma tamponu için bir Python sınıfı oluşturun:
class ReplayMemory(object):
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, *args):
self.memory.append(Transition(*args))
def sample(self, batch_size):
return random.sample(self.memory, batch_size)
def __len__(self):
return len(self.memory)Çok sayıda etkileşimi saklamak için bir bellek nesnesi oluşturun. Bu etkileşimler, ajanın eğitiminde kullanılır.
memory = ReplayMemory(10000)Eğitimden önce, parametreleri ve hiperparametreleri tanımlayın:
- Parametreler:
- Yığın boyutu
- Maksimum eğitim bölümü sayısı
- Hiperparametreler:
- Öğrenme oranı (
LR) - İskonto katsayısı (
GAMMA) - Hedef ağın güncelleme oranı (
TAU) - Keşif oranının başlangıç ve nihai değerleri ile sönüm oranı (
EPS_START,EPS_ENDveEPS_DECAY)
MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4Eylemi keşif oranına göre seçen bir fonksiyon yazın; adımlar şunlardır:
- Keşif oranını, bölümdeki adım sayısına (ve keşif oranının başlangıç/nihai değerleri ve sönüm oranına) göre hesaplayın.
- Rastgele bir sayı üretin.
- Rastgele sayı keşif oranından büyükse, politika ağının tahmin ettiği eylemi seçin.
- Daha küçükse, eylem uzayından rastgele bir eylem seçin.
steps_done = 0
def select_action(state):
global steps_done
sample = random.random()
eps_threshold = EPS_END + (EPS_START - EPS_END) * \
math.exp(-1. * steps_done / EPS_DECAY)
steps_done += 1
if sample > eps_threshold:
with torch.no_grad():
action = policy_net(state).max(1).indices.view(1, 1)
return action
else:
action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
return actionModeli optimize edecek fonksiyonu aşağıdaki adımlara göre yazın:
- Ajanın ortamla etkileşimlerinden rastgele bir örnek kullanarak bir yığın oluşturun. Örnekteki her öğe bir zaman adımına karşılık gelir ve şunları içerir:
- Ortamın geçerli durumu
- Ajanın eylemi
- Alınan ödül
- Bir sonraki durum
- CartPole’da ajan, (kenarlara çarpmak veya düşmek yerine) ortamla etkileşime son vermeden kart direğini manipüle etmeye devam etmelidir. Bu nedenle, terminal duruma gitmeyen etkileşimleri dikkate alırız. Terminal durumla takip edilmeyen durumları tanımlamak için bir maske (
non_final_mask) oluştururuz. - Terminal durumla takip edilmeyen durumları belirleyin (
non_final_next_states). - Geçerli durumların tümü için durum-eylem değerlerini, geçerli durumları politika ağına vererek alın (st).
- Tüm bir sonraki durumlar için beklenen durum-eylem değerlerini, bir sonraki durumları hedef ağına vererek ve şu denklemi kullanarak alın:
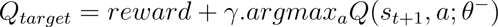
- Kayıpları, eylem değerleri ile beklenen eylem değerleri arasındaki farka dayalı olarak hesaplayın:
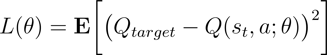
- Kayıpları geri yayarak gradyanları hesaplayın.
- Dengeli bir eğitim için gradyan değerlerini kırpın ve politika ağını güncelleyin.
Aşağıdaki kod, optimize edicinin nasıl uygulanacağını gösterir:
batch = 0
def optimize_model():
global batch
if len(memory) < BATCH_SIZE:
return
transitions = memory.sample(BATCH_SIZE)
batch = Transition(*zip(*transitions))
non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
batch.next_state)), dtype=torch.bool)
non_final_next_states = torch.cat([s for s in batch.next_state
if s is not None])
state_batch = torch.cat(batch.state)
action_batch = torch.cat(batch.action)
reward_batch = torch.cat(batch.reward)
state_action_values = policy_net(state_batch).gather(1, action_batch)
next_state_values = torch.zeros(BATCH_SIZE )
with torch.no_grad():
next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values
expected_state_action_values = (next_state_values * GAMMA) + reward_batch
loss_func = nn.SmoothL1Loss()
loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))
optimizer.zero_grad()
loss.backward()
torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
optimizer.step()Ajanı eğitmek için bir eğitim döngüsü yazın:
- Ortamı sıfırlayın ve yeni bir bölüm başlatın.
- Ajanın eylemine karar vermek için
select_action()fonksiyonunu kullanın. - Eyleme bağlı olarak ortamın ödülünü ve bir sonraki durumunu alın.
- Durum, eylem, bir sonraki durum ve ödülü tekrar oynatma tamponuna ekleyin.
- Optimize ediciyi (yukarıda tanımlanan) çalıştırın. Optimize edici, Q-değerlerini ve kaybı hesaplayarak ağı güncellemek için geri yayılım uygular.
- Hedef ağı, politika ağına göre güncelleyin.
- Terminal duruma ulaşana kadar bölüme devam edin.
Aşağıdaki kod bu adımları uygular:
def train():
for episode in range(MAX_EPISODES):
# Initialize the environment and get its state
state, info = env.reset()
state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
for t in count():
action = select_action(state)
observation, reward, terminated, truncated, _ = env.step(action.item())
reward = torch.tensor([reward])
done = terminated or truncated
if terminated:
next_state = None
else:
next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)
memory.push(state, action, next_state, reward)
state = next_state
optimize_model()
target_net_state_dict = target_net.state_dict()
policy_net_state_dict = policy_net.state_dict()
for key in policy_net_state_dict:
target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
target_net.load_state_dict(target_net_state_dict)
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
print('count -- ', t)
#plot_durations()
breakBu DataLab çalışma kitabını DQN eğitim programını görüntülemek, düzenlemek ve çalıştırmak için kullanabilirsiniz.
Aksiyon-Değeri Fonksiyonunun Görselleştirilmesi
Eğitim sürecinin ilerlemesini görsel olarak takip etmek faydalıdır. Aksiyon değerlerini görselleştirmek, eğitimin nerede başarısız olduğunu ve hangi parametre veya hiperparametrelerin değiştirilmesi gerektiğini anlamaya yardımcı olur.
Örneğin, modelin performansındaki iyileşmenin çok yavaş olduğunu görsel olarak gözlemlerseniz, öğrenme oranını artırmak isteyebilirsiniz. Modelin öğrendiğini ancak henüz tam olarak eğitilmediğini fark ederseniz, eğitim bölümlerinin sayısını artırmak yardımcı olabilir. Eğitimin dengesiz olduğunu görürseniz, öğrenme oranını azaltmak veya keşif katsayısı ile hedef ağın güncelleme oranını (TAU) ayarlamak isteyebilirsiniz.
Q-değerlerine ek olarak, her bölümdeki başarılı adım sayısını da çizmek yardımcı olabilir. Q-tablosu kullanan Q-Learning’de Q-değerleri açıkça saklanır. Ancak DQN kullanıldığında Q-değerleri açıkça saklanmaz. Ağ, ağırlıkları ve duruma bağlı olarak eylemi çıktılar. Bu nedenle DQN için her bölümdeki başarılı adım sayısını izlemek daha anlamlı olabilir.
Aşağıdaki adımlar, Q-learning algoritmasının eğitiminde Q-değerlerini ve bölüm başına başarılı adım sayısını nasıl çizeceğinizi açıklar:
- Eğitimin başında iki boş dizi oluşturun:
q_vals— her bölümün her adımındaki Q-değerlerini saklamak için.success_steps— her bölümdeki başarılı adım sayısını saklamak için.- Her adımda (tüm bölümlerde):
- O adıma ait Q-değerini
q_valsdizisine ekleyin - Her bölüm sonlandığında, o bölümdeki başarılı adım sayısını
success_stepsdizisine ekleyin. - Her iki diziyi de çizin.
Aşağıdaki kod, Q-değerlerini ve başarılı adım sayılarını izlemek üzere (önceki bölümde gösterilen) Q-Tablolarıyla Q-Learning eğitim döngüsünün güncellenmiş hâlini gösterir:
q_vals = []
success_steps = []
def train():
global q_vals
global success_steps
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
q_vals.append(best_q)
state_current = state_next
if done:
q_vals.append(best_q)
success_steps.append(step)
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
else:
successful_episodes = 0
break
if successful_episodes > SUCCESS_STREAK:
print("Training successful")
returnAşağıdaki parça, her bölümdeki Q-değerlerini nasıl çizeceğinizi gösterir:
def plot_q():
plt.plot(q_vals)
plt.title('Q-values over training steps')
plt.xlabel('Training steps')
plt.ylabel('Q-value')
plt.show()Aşağıdaki parça, her bölümdeki başarılı adım sayısını nasıl çizeceğinizi gösterir:
def plot_steps():
plt.plot(success_steps)
plt.title('Successful steps over training episodes')
plt.xlabel('Training episode')
plt.ylabel('Successful steps')
plt.show()- Aksiyon-değeri fonksiyonlarını kullanarak Q-learning uygulaması için DataLab çalışma kitabı, Q-değerlerini ve bölüm başına başarılı adım sayılarını çizme kodunu da içerir.
- DQN uygulaması için not defteri de bölüm başına başarılı adım sayısını çizme kodunu içerir.
Ajan performansının değerlendirilmesi
Ajanın ne zaman ve nasıl başarıyla eğitildiğine karar verme ölçütlerini belirtmek gerekir. Geleneksel ML’de eğitim hedefi, tahmin edilen ve gerçek değerler arasındaki fark olan kaybı en aza indirmektir. RL’de hedef, kümülatif ödülü en üst düzeye çıkarmaktır. Ajan, ortamdan maksimum ödülleri elde ettiğinde eğitim başarılı kabul edilir.
CartPole gibi ortamlar, kenarlara çarpma veya direğin aşırı yatmasına izin verme gibi terminal bir koşula ulaşılana kadar bitmez. Bu gibi durumlarda, eğitilmiş bir ajan ortamla süresiz olarak etkileşmeye devam edebilir. Bu nedenle maksimum başarılı adım sayısı yapay olarak dayatılır. Gymnasium’un CartPole-v1’i için bölüm, sonlanmadan 500 zaman adımına ulaştığında sonlandırılır.
Eğitimin başarılı olup olmadığını değerlendirmek için ajanın performansını ardışık bölümler üzerinden değerlendiririz. Örneğin:
- Ajan, son N bölümde ortalama olarak eşik bir adım sayısından (
SUCCESS_STEPS) fazlasını tamamlayabilmelidir. Bu yazıdaki örneklerde bu eşiği 450 olarak ayarlıyoruz. - Ajan, N ardışık bölümde eşiği aşabilir (
SUCCESS_STREAK). Bu örnekte N’yi 50 olarak belirliyoruz.
Pratik bir örnek olarak, daha önce gösterilen DQN eğitim döngüsünden bu parçayı ele alalım.
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
print('average steps over last 50 episodes -- ', average_steps)
if average_steps > SUCCESS_STEPS:
print("training successful.")
return
breakHer eğitim bölümünün sonunda (terminal durumda) aşağıdaki adımların yürütülmesine dayalı olarak ajanın performansını değerlendirmek faydalıdır:
- Bu bölümdeki (bitmeden önceki) toplam adım sayısını bir diziye ekleyin. Bu dizi, her bölümdeki toplam adım sayısını izler.
- Bu dizideki son N değerin ortalamasını hesaplayın. Bu örnekte N (
SUCCESS_STREAK) 50’dir. Dolayısıyla son 50 bölümün ortalama adım sayısını hesaplarız. - Bu ortalama bir eşikten (
SUCCESS_STEPS) büyükse eğitimi bitiririz. Bu örnekte bu eşik 450 adımdır.
Aksiyon-Değeri Fonksiyonlarını Kullanırken En İyi Uygulamalar
Aşağıda, aksiyon-değeri fonksiyonu uygulamanızdan daha iyi sonuçlar almak için izleyebileceğiniz bazı en iyi uygulamalar yer alıyor.
Keşif ve sömürüyü dengeleyin
Gerçek aksiyon-değeri fonksiyonu verildiğinde, ajan her adımda en yüksek değere sahip eylemi seçmeye dayalı açgözlü bir strateji benimseyerek beklenen geri dönüşleri en üst düzeye çıkarabilir. Bu, mevcut bilginin sömürülmesi olarak adlandırılır. Ancak, eğitilmemiş bir aksiyon-değeri fonksiyonu (henüz gerçek aksiyon değerlerini temsil etmeyen) ile açgözlü bir strateji kullanmak, yerel optimumda takılı kalmaya yol açar.
Eğitim sırasında hem ortamı keşfetmek hem de mevcut bilgiyi sömürmek önemlidir.
Eğitimin başlangıç aşamalarında mevcut bilgi rastgele bir değer fonksiyonuna dayanır. Bu nedenle bu bilgi (açgözlü bir stratejiyle sömürmek için) çok değerli değildir. Farklı durumlarda çeşitli olası eylemlerden elde edilen ödülleri keşfetmek daha önemlidir.
Q-tablosu güncellendikçe (veya DQN eğitildikçe), ödülleri en çoklamak için mevcut bilgiyi kısmen sömürmek mümkün hâle gelir. Eğitimin son aşamalarında, ajan gerçek değer fonksiyonuna yakınsar; daha fazla keşif zararlı olabilir. Bu nedenle ajan bilinen değer fonksiyonunun sömürülmesini önceliklendirir.
Hiperparametreleri ayarlayın
Her makine öğrenimi modelinde olduğu gibi, hiperparametreler RL algoritmalarını başarıyla eğitmek için önemlidir. Q-Learning ve DQN’lerde hiperparametreler epsilon (keşif oranı), alfa (öğrenme oranı) ve gama (iskonto oranı)dır.
- ε (epsilon), keşif ve sömürü dengesini kontrol eder (yukarıda tartışıldı). Epsilon değeri ne kadar yüksekse keşif, sömürüye göre o kadar önemlidir. Eğitimin başında 0,9 gibi yüksek bir değer alır ve eğitim sonunda kademeli olarak 0,05 gibi küçük bir değere düşürülür.
- α (alfa) öğrenme oranıdır (LR). DQN’lerde sinir ağının parametrelerinin veya Q-Tablosundaki değerlerin her eğitim yinelemesinde ne kadar değişeceğini kontrol eder. LR çok yüksekse model dengesizleşir ve yakınsamaz. Öte yandan düşük LR yavaş yakınsamaya yol açar. Ajanın ortamı keşfetmesi gereken eğitim sürecinin başlarında LR’ın yüksek bir değerle başlaması da yaygındır. Ajan Q-fonksiyonunun gerçek değerlerine yaklaştıkça, ağın yakınsamasına yardımcı olmak için LR azaltılır.
- γ (gama) iskonto oranıdır. Gelecekteki zaman adımlarındaki ödüllerin, anlık ödüllere göre önemini belirler. Gama’nın yüksek olması, sonraki ödüllerin önemli olduğu anlamına gelir. Gama değeri 0 ise yalnızca geçerli zaman adımındaki ödül önemlidir ve sonraki ödüllerin önemi yoktur. Q-learning gibi algoritmalarda toplam geri dönüş, tüm bölüm boyunca kazanılan ödüllere dayanır. Bu nedenle 0,99 gibi yüksek bir iskonto oranı kullanmak yaygındır.
Son olarak, RL eğitimlerinin başlangıçtaki rastgele değerlere hassas olduğunu unutmayın. Eğitim yakınsamıyorsa, farklı bir rastgele tohum kullanmak veya eğitimi farklı rastgele başlangıç değerleriyle başlayacak şekilde yeniden çalıştırmak çoğu zaman yardımcı olur.
Basit ortamlardan başlayın
Karmaşık ortamlar için RL ajanlarını eğitmek zorludur. Q-fonksiyonları birçok farklı algoritmada kullanılır; bu nedenle Q-learning tabanlı RL ajanlarını eğitme konusunda sezgi geliştirmek önemlidir. Bunu, benzer yöntemleri daha karmaşık ortamlara uygulamadan önce CartPole gibi daha basit ortamlarda teknikleri pratik ederek yapmak en iyisidir.
Ayrıca, karmaşık ortamların eğitimi daha maliyetlidir, bu nedenle daha basit ortamları bir öğrenme aracı olarak kullanmak daha ekonomiktir.
Sonuç
Bu yazıda, aksiyon-değeri fonksiyonunun temel kuramsal ilkelerini ve RL’deki önemini ele aldık. Aksiyon-değeri fonksiyonlarının Q-learning ve Derin Q-learning’de nasıl kullanıldığını inceledik ve her iki yöntemi de Python’da adım adım uyguladık.
Öğrenmeye devam etmek için şiddetle Python ile Derin Pekiştirmeli Öğrenme kursunu öneririm.
SSS
RL’de değer fonksiyonu ile aksiyon-değeri fonksiyonu arasındaki fark nedir?
Değer fonksiyonu bir durumdan beklenen geri dönüşü tahmin ederken, aksiyon-değeri fonksiyonu (Q-fonksiyonu) bir durumda belirli bir eylemi alıp sonrasında politikayı izleyerek elde edilecek geri dönüşü tahmin eder. Aksiyon-değeri fonksiyonu, karar verme için daha ayrıntılı bir yol gösterir.
Q-learning’de aksiyon-değeri fonksiyonu neden önemlidir?
Q-learning, aksiyon-değeri fonksiyonunu ajanın en yüksek beklenen ödülleri getiren eylemlere yönelmesini sağlamak için kullanır. Fonksiyon, off-policy öğrenmeyi mümkün kılar ve ajanın zamanla optimal stratejiye yakınsamasına yardımcı olur.
Aksiyon-değeri fonksiyonu Bellman denklemiyle nasıl ilişkilidir?
Bellman denklemi, Q-değerlerini anlık ödül ve iskonto edilmiş maksimum gelecekteki ödüle göre güncellemek için özyinelemeli bir formülasyon sağlar. Aksiyon-değeri fonksiyonunun yinelemeli olarak öğrenilmesinin temelini oluşturur.
Sürekli durum uzaylarında aksiyon-değeri fonksiyonunu kullanabilir miyim?
Evet, ancak sürekli uzaylarda Q-tabloları pratik değildir. Bu gibi durumlarda, aksiyon-değeri fonksiyonunu açık tablolar yerine bir sinir ağıyla yaklaştırmak için Derin Q-Ağlar (DQN) kullanılır.
Aksiyon-değeri fonksiyonunu tahmin etmede keşfin rolü nedir?
Keşif, ajanın alt-optimal bir politikaya erken yakınsamasını engeller. Eğitim sırasında aksiyon-değeri fonksiyonunun doğru biçimde tahmin edilmesi için gerekli olan çeşitli deneyimleri toplamaya yardımcı olur.
ε-açgözlü strateji Q-değeri öğrenimini nasıl etkiler?
ε-açgözlü strateji keşif ve sömürüyü dengeler. ε olasılıkla ajan yeni eylemleri keşfeder, 1–ε olasılıkla mevcut en iyi bilinen eylemi sömürür. Bu denge, öğrenmenin istikrarını ve yakınsamayı iyileştirir.
Q-learning’den Derin Q-learning’e ne zaman geçmelisiniz?
Ortamın büyük veya sürekli bir durum uzayına sahip olduğu durumlarda Q-tablosunu sürdürmek verimsizleşir. Derin Q-learning, tabloyu daha karmaşık ortamlara daha iyi ölçeklenen bir sinir ağı ile değiştirir.
Eğitim sırasında bir aksiyon-değeri fonksiyonunu nasıl görselleştirebilirim?
Öğrenme ilerlemesini izlemek için zaman içinde maksimum Q-değerlerini çizebilir veya bölüm ödüllerini takip edebilirsiniz. Görselleştirme, zayıf yakınsama veya yetersiz keşif gibi sorunları teşhis etmeye yardımcı olur.
Aksiyon-değeri fonksiyonunu eğitmedeki temel zorluklar nelerdir?
Başlıca zorluklar, hareketli hedefler nedeniyle eğitimdeki dengesizlik, yetersiz keşif ve optimal olmayan hiperparametre ayarlarıdır. Tekrar oynatma belleği ve hedef ağlar gibi tekniklerin kullanılması bu sorunları hafifletmeye yardımcı olur.
Aksiyon-değeri fonksiyonu on-policy algoritmalarda kullanılır mı?
Evet, SARSA gibi algoritmalar aksiyon-değeri fonksiyonunu kullanır ancak güncellemeyi mevcut politikanın fiilen aldığı eylemle yapar. Bu, bir sonraki durumun maksimum Q-değerini kullanan Q-learning gibi off-policy yöntemlerden farklıdır.





Pekiştirmeli Öğrenme (RL), bir ajanın harici bir ortamla etkileşerek doğru kararları almayı öğrendiği bir makine öğrenimi paradigmasıdır. Ortam, doğru eylem için ödül biçiminde geri bildirim verir.
Ajanın hedefi, kümülatif ödülleri en üst düzeye çıkarmaktır. Birçok pratik problemde, ajana gelen geri bildirim bir insandan gelir; buna insan geri bildirimiyle RL (RLHF) denir.
RLHF, LLM’leri insan değerleriyle uyumlu çıktılar üretmeleri için ayarlamada yaygın olarak kullanılır. Geri bildirimin bir yapay zekâ tarafından verildiği durumda buna yapay zekâ geri bildirimiyle RL denir.
Ajan, her adımda hangi eylemi seçeceğini değerlendirmek için aksiyon-değeri fonksiyonunu kullanır. Optimize edilmiş bir aksiyon-değeri fonksiyonu, ajanın her adımda kümülatif ödüllerini en üst düzeye çıkaracak en iyi eylemi seçmesine yardımcı olur.
Bu öğreticide, aksiyon-değeri fonksiyonunu tanıtacak, RL içindeki rolünü açıklayacak ve sıfırdan nasıl uygulanacağını göstereceğim.
Aksiyon-Değeri Fonksiyonu Nedir?
Aksiyon-değeri fonksiyonu (Q), belirli bir durumda (s) belirli bir eylemi (a) alıp sonrasında politika π izlendiğinde elde edilmesi beklenen kümülatif ödülü (geri dönüş) tahmin eder. Qπ(s,a) şeklinde gösterilir. Ajansın optimal politikayı izlediğinin açık olduğu durumlarda, daha basit biçimde Q(s,a) olarak ifade edilir.
Aksiyon-değeri fonksiyonu, verilen bir durumdan başlayarak en yüksek geri dönüşe götüren eylemi seçmek için kullanılır. Optimal politika (π*) beklenen geri dönüşü en çoklar. Dolayısıyla her s durumunda, politika en yüksek beklenen geri dönüşe götüren eylemi seçer. Bu optimal politika π* = argmaxa Q(s,a) olarak ifade edilir.
Q-fonksiyonu geleneksel olarak bir Q-tablosu olarak modellenir. Bu tablo, ortamın her olası durumu için her olası eylemin değerini saklar. Karmaşık ortamlarda bu tablo yönetilemeyecek kadar büyük ve verimsiz hale gelir. Bu nedenle, çoğu ciddi ortam için Q-tablosunu bir tablo yerine bir sinir ağı olarak modellemeyi tercih ederiz. Bu ağ, Q-tablosunun fonksiyonunu yaklaştırır. Bir durum verildiğinde, o duruma karşılık gelen eylem değerlerini çıktılar.
Aksiyon-Değeri Fonksiyonlarının RL’de Önemli Olmasının Nedeni
Gerçek aksiyon-değeri fonksiyonu verildiğinde, politika en yüksek beklenen ödüllere götüren eylemi seçmelidir. Bu strateji, sömürü (exploitation) olarak bilinir. Ancak, eğitim aşamasında gerçek aksiyon-değeri fonksiyonu henüz bilinmez. Dolayısıyla, eylem seçimi eksik bilgiye dayanır. Bu eksik bilgiye dayanarak sömürü (geri dönüşü en çoklama), gerçek aksiyon-değeri fonksiyonunun keşfedilememesine ve yerel bir optimumda sıkışmaya yol açabilir.
Öte yandan, keşif odaklı bir strateji bazen sonunda daha yüksek değerli bir duruma götürebilecek alt-optimal eylemleri seçer. Bu, ε - açgözlü (greedy) stratejisi olarak uygulanır; burada ε küçük bir değerdir. Politika, ε olasılıkla rastgele bir alt-optimal eylem ve 1 - ε olasılıkla ödülü en çoklayan eylemi seçer.
Sömürü ve keşfi dengeleyen bir strateji benimsemek, ajanın ortam üzerinden alternatif yollar keşfetmesine ve daha iyi kümülatif ödüllere ulaşmasına olanak tanır.
RL algoritmalarının temeli
RL algoritmaları iki geniş kategoride sınıflandırılabilir: 1) modele dayalı ve modelsiz, 2) politika-üzerinde (on-policy) ve politika-dışı (off-policy).
Modele dayalı ve modelsiz algoritmalar
Modele dayalı yöntemlerde, ortamın olasılık dağılım modelini P(r, s' | s, a) tahmin etmeye çalışırsınız — bir r ödülü alma ve bir s' durumuna ulaşma olasılığı; başlangıç durumu s ve eylem a ile.
Bu yöntemler, ajanın ortamla etkileşimlerini kullanarak (ortamın) modelini ince ayar yapar ve tahmin edilen ödül ve durumları iyileştirir. Böylece ajan, her adımda ortamla etkileşmek zorunda kalmaksızın modeli üzerinden ortamı simüle edebilir.
Dyna-Q gibi bazı modele dayalı algoritmalar, Q-fonksiyonunu simüle edilmiş deneyimler yoluyla günceller. Bu yöntemler, eğitilmemiş bir ajanın ortamla çok sayıda etkileşim kurmasının pahalı veya uygulanamaz olduğu durumlarda kullanılır. Örneğin, eğitilmemiş bir robotun tekrar tekrar düşmesi ve hasar görmesi çok maliyetlidir.
Buna karşılık, Q-learning gibi modelsiz yöntemler, ortamı açıkça modellemeden, gerçek aksiyon-değeri fonksiyonuna yakınsamak için yinelemeli bir süreç izleyerek doğrudan Q(s,a) değerini günceller. Ajan her adımda doğrudan ortamla etkileşir. Optimal politikaya yakınsamak için deneme-yanılma kullanırlar. Ortamın bir modeli dahil edilmediği için daha basittirler, ancak ortamla çok sayıda etkileşim örneği gerektirirler.
Modelsiz algoritmalar, Q-learning, SARSA (State-Action-Reward-State-Action) ve DQN’ler gibi, Q-fonksiyonunu açıkça öğrenir ve her adımda aksiyon değerini tahmin etmek için kullanır.
On-policy ve off-policy algoritmalar
Off-policy algoritmalar (DQN’ler ve Q-learning gibi) optimal politikanın değerini öğrenmek için deneyim tekrarını kullanır. Ortamla (gerçek veya simüle) çok sayıda etkileşimleri vardır ve Q-fonksiyonunu güncellemek için bu etkileşimlerden rastgele örnekler çekerler. Her adımda eylemi belirlemek için optimal politikayı kullanmazlar. Off-policy yöntemler, hedef politika için aksiyon değerini tahmin etmek üzere Q-fonksiyonunu kullanır. Bir sonraki adımda beklenen en yüksek ödüle göre Q-fonksiyonunu güncelleyerek gelecekteki geri dönüşleri en üst düzeye çıkarmayı amaçlarlar.
Bazı on-policy algoritmalar (SARSA gibi), her adımda eylemi seçmek için politikayı kullanır. Böylece ajan, güncellediği aynı politikayı izler. Ajanın politikayı takip ederek aldığı ödüle göre Q-fonksiyonu güncellenir. Diğer on-policy algoritmalar, politika gradyanları ve aktör-eleştirmen (actor-critic) gibi, Q-fonksiyonunu kullanmaz.
Dolayısıyla, aksiyon-değeri fonksiyonları çeşitli RL algoritmalarının temelini oluşturur.
Optimal eylem seçimi
Q-değeri Q(s,a), s durumunda a eylemini alıp sonrasında politikayı izlemekten beklenen geri dönüşü temsil eder. Dolayısıyla, eğitilmiş bir Q-tablosu verildiğinde, belirli bir durumda maksimum Q-değerine götüren eylemin seçilmesi, açgözlü (sömürü odaklı) bir stratejiye dayalı optimal bir politika sağlar. Her adımda ajan a* = arg max a Q(s,a) eylemini seçer. Böylece tüm bölüm (episode) boyunca, mevcut bilgiyi sömürerek uzun vadeli ödülleri en çoklayan yolu seçer.
Q-learning gibi yöntemler, Q-değerlerini Q-tablosunda birçok yineleme boyunca güncelleyerek optimal değerlerine yakınsar. Böylece eğitimden sonra algoritma, her durumdan optimal eylemi ve bölüm boyunca optimal yolu seçen optimal politikaya ulaşır.