

Implementare una funzione di valore d’azione
Dopo aver discusso i principi di base e gli utilizzi della funzione di valore d’azione, ora ti mostro i passaggi per implementarla in Python.
Passaggio 1: definisci l’ambiente
Importa i pacchetti necessari, inclusi Gymnasium e NumPy:
import gymnasium as gym
import numpy as np
import math
import randomInizializza un ambiente RL da Gymnasium. In questo articolo alleniamo un agente RL a risolvere l’ambiente CartPole.
env = gym.make('CartPole-v1')Passaggio 2: inizializza la Q-table
Lo spazio di osservazione di CartPole ha quattro stati: posizione del carrello, velocità del carrello, angolo dell’asta e velocità angolare dell’asta.
In questo esempio, ci concentriamo solo sulle osservazioni dell’angolo dell’asta e della velocità angolare dell’asta. Creiamo quindi la Q-table discreta come segue:
- Uno stato discreto per la posizione del carrello: tutti i possibili valori vengono raggruppati in questo singolo stato.
- Uno stato discreto per la velocità del carrello
- Sei stati discreti per l’angolo dell’asta
- Tre stati discreti per la velocità dell’asta
Il numero di colonne si basa sulla dimensione dello spazio delle azioni, in questo caso 2.
NUM_BUCKETS = (1, 1, 6, 3)
NUM_ACTIONS = env.action_space.n
q_table = np.zeros(NUM_BUCKETS + (NUM_ACTIONS,))Nell’ambiente CartPole, lo spazio degli stati è continuo. L’angolo, la velocità e la posizione del carrello-asta possono variare in modo continuo. Lo spazio delle azioni è discreto: puoi spingere il carrello a sinistra o a destra.
Il Q-Learning con Q-table può essere usato solo su uno spazio discreto perché devi tabulare esplicitamente il valore Q per un insieme di stati e azioni. Quindi, il primo passo è discretizzare lo spazio degli stati continuo.
Consideriamo innanzitutto i limiti superiori e inferiori delle variabili dello spazio degli stati. Notiamo che la velocità del carrello e la velocità angolare dell’asta hanno limiti infiniti. Pertanto impostiamo artificialmente limiti superiori e inferiori su queste variabili di stato.
STATE_BOUNDS = list(zip(env.observation_space.low, env.observation_space.high))
STATE_BOUNDS[1] = [-0.5, 0.5]
STATE_BOUNDS[3] = [-math.radians(50), math.radians(50)]Creiamo una funzione per discretizzare i valori di stato continui in valori discreti:
def discretize_state(state):
discrete_states = []
for i in range(len(state)):
if state[i] <= STATE_BOUNDS[i][0]:
discrete_state = 0
elif state[i] >= STATE_BOUNDS[i][1]:
discrete_state = NUM_BUCKETS[i] - 1
else:
bound_width = STATE_BOUNDS[i][1] - STATE_BOUNDS[i][0]
offset = (NUM_BUCKETS[i] - 1) * STATE_BOUNDS[i][0] / bound_width
scaling = (NUM_BUCKETS[i] - 1) / bound_width
discrete_state = int(round(scaling * state[i] - offset))
discrete_states.append(discrete_state)
return tuple(discrete_states)Passaggio 3: aggiorna la Q-table
Le equazioni di Bellman forniscono l’espressione per aggiornare i valori Q in base al learning rate, al fattore di sconto, alla ricompensa nel passo successivo e al valore Q massimo atteso dello stato successivo. Esprimono il valore atteso di uno stato come somma di due parti:
- La ricompensa immediata nel passaggio allo stato successivo
- Il valore atteso scontato dello stato successivo
L’equazione di Bellman è ricorsiva. È quindi possibile scrivere un programma iterativo, partendo da uno stato iniziale casuale, per trovare la funzione di valore d’azione ottimale.
L’equazione per aggiornare la Q-table è:
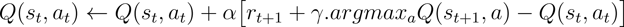
Nell’espressione sopra:
- Lo stato corrente è st, indicato come
state_currentnel codice. - Lo stato successivo è st+1 (
state_next). - L’azione intrapresa nello stato corrente è at (
action). - Q(st, at) è il valore Q corrente per lo stato st e l’azione at
- α è il learning rate.
- γ è il fattore di sconto.
- rt+1 è la ricompensa dopo aver eseguito l’azione at nel passo corrente con stato st. Nel codice qui sotto è rappresentata come
reward. - argmaxa Q(st+1, a) è il valore Q massimo dello stato successivo st+1. Nel seguente snippet è rappresentato come
best_q.
Il codice seguente implementa la funzione per aggiornare la Q-table
def update_q(state_current, state_next, action, reward, alpha):
best_q = np.amax(q_table[state_next])
q_table[state_current + (action,)] += alpha * (reward + GAMMA*(best_q) - q_table[state_current + (action,)])
return best_qPassaggio 4: addestra l’agente
Definisci i parametri dell’addestramento:
- Il numero massimo di episodi di addestramento
- Il numero massimo di passi per episodio proviene dalla documentazione dell’ambiente. Per CartPole-v1 è 500.
- Il numero di passi che l’agente deve completare perché l’episodio sia classificato come successo. Lo impostiamo a 450.
- Il numero di episodi di successo consecutivi che l’agente deve completare per considerare l’addestramento riuscito. Lo impostiamo a 50.
MAX_EPISODES = 5000
MAX_STEPS = 500
SUCCESS_STEPS = 450
SUCCESS_STREAK = 50Definisci gli iperparametri:
- I valori minimo e massimo del tasso di esplorazione, ε
- I valori minimo e massimo del learning rate, α
- Il tasso di decadimento di α e γ
- Il fattore di sconto, γ
EPSILON_MIN = 0.01
EPSILON_MAX = 1
ALPHA_MIN = 0.1
ALPHA_MAX = 0.5
GAMMA = 0.99
DECAY_COEFF = 25Prima di addestrare l’agente, scriviamo due funzioni per far decadere gradualmente il learning rate e il tasso di esplorazione. Questi iperparametri diminuiscono gradualmente di valore durante l’addestramento.
def decay_epsilon(step):
return max(EPSILON_MIN, min(EPSILON_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))
def decay_alpha(step):
return max(ALPHA_MIN, min(ALPHA_MAX, 1.0-math.log10((step+1)/DECAY_COEFF)))Scriviamo anche una funzione per selezionare l’azione in modo stocastico. Generiamo prima un numero casuale.
- Se questo numero casuale è minore di ε, scegliamo casualmente un’azione dallo spazio delle azioni. Questa è la strategia di esplorazione.
- Se il numero casuale è maggiore di ε, scegliamo l’azione corrispondente al valore Q massimo. Questa è la strategia di sfruttamento.
def select_action(state, epsilon):
if random.random() < epsilon:
action = env.action_space.sample()
else:
action = np.argmax(q_table[state])
return actionCostruiamo un loop per addestrare l’agente in base ai seguenti passi:
- Recupera i valori decaduti di α e ε per l’episodio corrente.
- Reimposta l’ambiente e discretizza lo spazio di osservazione per avviare un ambiente nuovo per l’episodio.
- Esegui l’agente nell’ambiente fino a raggiungere il numero massimo di passi o la terminazione.
- Per ogni passo:
- Seleziona l’azione secondo la funzione
select_action()dichiarata prima. - Esegui l’azione nell’ambiente per ottenere la ricompensa e lo stato successivo.
- Ottieni il valore Q più alto dalla Q-table.
- Aggiorna la Q-table secondo la funzione
update_q()dichiarata prima.
Il codice seguente implementa i passi del training loop:
def train():
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
state_current = state_next
if done:
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
print("=============SUCCESS=============")
else:
successful_episodes = 0
print("=============FAIL=============")
break
if successful_episodes > SUCCESS_STREAK:
breakInfine, esegui il training loop, chiudi l’ambiente e stampa il valore finale della Q-table.
train()
env.close()
print(q_table)Usa questo workbook DataLab come punto di partenza per modificare ed eseguire il codice del Q-Learning.
Estendere al Deep Q-Learning
Nella sezione precedente abbiamo discretizzato lo spazio (degli stati) continuo per usare una Q-table. Una Q-table di grandi dimensioni (per ambienti complessi) è computazionalmente inefficiente. In tali casi, la Q-function può essere approssimata usando una rete neurale. Questa è chiamata Deep Q-Network, espressa come Q(s, a; θ), dove il parametro θ rappresenta i pesi della rete neurale. Questo metodo è chiamato Deep Q-learning. Più in generale, l’RL che usa reti neurali profonde è detto Deep Reinforcement Learning.
Invece di usare la Q-Table per scegliere l’azione per ogni stato, la rete neurale DQN prende lo stato in input e restituisce il valore Q per ogni possibile azione in quello stato.
La rete è addestrata con metodi tradizionali (come la backpropagation) per minimizzare l’errore di differenza temporale (TD). L’errore TD δ è la differenza tra i valori Q previsti e i valori Q target (calcolati come somma della ricompensa dallo stato corrente e del valore scontato della ricompensa massima attesa dallo stato successivo).
Quando è implementata come rete neurale (con parametri di rete θ), l’errore TD è espresso come:
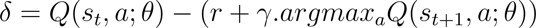
Nota che sia i valori Q sia i valori Q target sono calcolati usando la stessa rete neurale.
A ogni iterazione, i parametri della rete (θ) vengono aggiornati. L’aggiornamento della rete (via backprop) si basa sul valore target calcolato usando il θ pre-aggiornamento. Calcolare i valori target con gli stessi risultati aggiornati crea un target in continuo movimento. Questo rende l’addestramento instabile.
Per evitare il problema sopra, creiamo una nuova rete per calcolare i valori Q target. Questa è la target network. Si basa sugli stessi parametri della policy network ma viene aggiornata meno frequentemente. Così il processo di addestramento ha un target stabile rispetto al quale applicare la backpropagation.
Se rappresentiamo i pesi della target network con θ-, l’equazione precedente si riscrive come:
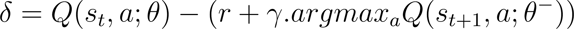
Le sezioni seguenti mostrano come implementare e addestrare un semplice DQN nell’ambiente CartPole.
Implementazione di esempio
Installa i pacchetti necessari, inclusi Gymnasium e PyTorch.
!pip install gymnasium matplotlib torchImporta i pacchetti necessari nell’ambiente Python:
import gymnasium as gym
import math
import random
import matplotlib
import matplotlib.pyplot as plt
from collections import namedtuple, deque
from itertools import count
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as FCrea l’ambiente CartPole:
env = gym.make("CartPole-v1")Inizializza l’ambiente e dichiara costanti Python con la dimensione degli spazi degli stati e delle azioni dell’ambiente.
state, info = env.reset()
NUM_OBSERVATIONS = len(state)
NUM_ACTIONS = env.action_space.nDichiara una classe Python per una semplice rete neurale con un singolo livello nascosto. Il numero di input è la dimensione dello spazio degli stati (spazio di osservazione). Il numero di output è il numero di azioni possibili che l’agente RL può intraprendere. Questa rete simula internamente la Q-table e predice i valori d’azione dato uno stato in input.
class DQN(nn.Module):
def __init__(self, NUM_OBSERVATIONS, NUM_ACTIONS):
super(DQN, self).__init__()
self.layer1 = nn.Linear(NUM_OBSERVATIONS, 128)
self.layer2 = nn.Linear(128, 128)
self.layer3 = nn.Linear(128, NUM_ACTIONS)
def forward(self, x):
x = F.relu(self.layer1(x))
x = F.relu(self.layer2(x))
return self.layer3(x)Crea una policy network e una target network. Carica la target network con i parametri della policy network usando lo state dictionary. Inizializza un ottimizzatore per addestrare la rete neurale.
policy_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net = DQN(NUM_OBSERVATIONS, NUM_ACTIONS)
target_net.load_state_dict(policy_net.state_dict())
optimizer = optim.AdamW(policy_net.parameters(), lr=LR, amsgrad=True)Addestramento con replay buffer
I metodi off-policy model-free come il Q-Learning (discusso nella sezione precedente) e i DQN sono addestrati usando un campione casuale delle interazioni dell’agente con l’ambiente. Le azioni dell’agente e le risposte dell’ambiente (ricompensa e stato successivo) sono raccolte e memorizzate. Un campione casuale di queste interazioni viene scelto in ogni iterazione di training per formare un batch di addestramento.
Dichiara un oggetto tupla per memorizzare lo stato (osservazione) dell’ambiente in ogni interazione:
Transition = namedtuple('Transition', ('state', 'action', 'next_state', 'reward'))Crea una classe Python per il replay buffer:
class ReplayMemory(object):
def __init__(self, capacity):
self.memory = deque([], maxlen=capacity)
def push(self, *args):
self.memory.append(Transition(*args))
def sample(self, batch_size):
return random.sample(self.memory, batch_size)
def __len__(self):
return len(self.memory)Crea un oggetto memoria per archiviare un gran numero di interazioni. Queste interazioni sono usate per addestrare l’agente.
memory = ReplayMemory(10000)Prima dell’addestramento, dichiara parametri e iperparametri:
- Parametri:
- Batch size
- Numero massimo di episodi di addestramento
- Iperparametri:
- Learning rate (
LR) - Fattore di sconto (
GAMMA) - Tasso di aggiornamento della target network (
TAU) - Valori iniziale e finale del tasso di esplorazione e tasso di decadimento (
EPS_START,EPS_ENDeEPS_DECAY)
MAX_EPISODES = 600
BATCH_SIZE = 128
GAMMA = 0.99
EPS_START = 0.9
EPS_END = 0.05
EPS_DECAY = 1000
TAU = 0.005
LR = 1e-4Scrivi una funzione per selezionare l’azione in base al tasso di esplorazione, seguendo questi passi:
- Calcola il tasso di esplorazione in base al numero di passi dell’episodio (e ai valori iniziale e finale e al tasso di decadimento del tasso di esplorazione).
- Genera un numero casuale.
- Se il numero casuale è maggiore del tasso di esplorazione, scegli l’azione prevista dalla policy network.
- Se è minore del tasso di esplorazione, scegli un’azione casuale dallo spazio delle azioni.
steps_done = 0
def select_action(state):
global steps_done
sample = random.random()
eps_threshold = EPS_END + (EPS_START - EPS_END) * \
math.exp(-1. * steps_done / EPS_DECAY)
steps_done += 1
if sample > eps_threshold:
with torch.no_grad():
action = policy_net(state).max(1).indices.view(1, 1)
return action
else:
action = torch.tensor([[env.action_space.sample()]], dtype=torch.long)
return actionScrivi la funzione per ottimizzare il modello seguendo questi passi:
- Crea un batch usando un campione casuale delle interazioni dell’agente con l’ambiente. Ogni elemento del campione corrisponde a un passo temporale. Contiene:
- Lo stato corrente dell’ambiente
- L’azione dell’agente
- La ricompensa ricevuta
- Lo stato successivo
- In CartPole, è previsto che l’agente continui a manipolare il carrello-asta senza terminare (colpire i bordi o cadere). Pertanto consideriamo solo quelle interazioni che non portano a uno stato terminale. Creiamo una maschera (
non_final_mask) per identificare gli stati che non sono seguiti da uno stato terminale. - Identifica gli stati che non sono seguiti da uno stato terminale (
non_final_next_states). - Ottieni i valori stato-azione per tutti gli stati correnti st passando gli stati correnti alla policy network.
- Ottieni i valori stato-azione attesi per tutti gli stati successivi st+1 passando gli stati successivi alla target network e usindo l’equazione:
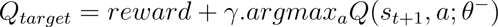
- Calcola la loss in base alla differenza tra i valori d’azione e i valori d’azione attesi:
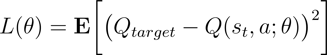
- Backpropaga le perdite per calcolare i gradient.
- Clippa i gradienti e aggiorna la policy network per garantire un addestramento stabile.
Il codice seguente mostra come implementare l’ottimizzatore:
batch = 0
def optimize_model():
global batch
if len(memory) < BATCH_SIZE:
return
transitions = memory.sample(BATCH_SIZE)
batch = Transition(*zip(*transitions))
non_final_mask = torch.tensor(tuple(map(lambda s: s is not None,
batch.next_state)), dtype=torch.bool)
non_final_next_states = torch.cat([s for s in batch.next_state
if s is not None])
state_batch = torch.cat(batch.state)
action_batch = torch.cat(batch.action)
reward_batch = torch.cat(batch.reward)
state_action_values = policy_net(state_batch).gather(1, action_batch)
next_state_values = torch.zeros(BATCH_SIZE )
with torch.no_grad():
next_state_values[non_final_mask] = target_net(non_final_next_states).max(1).values
expected_state_action_values = (next_state_values * GAMMA) + reward_batch
loss_func = nn.SmoothL1Loss()
loss = loss_func(state_action_values, expected_state_action_values.unsqueeze(1))
optimizer.zero_grad()
loss.backward()
torch.nn.utils.clip_grad_value_(policy_net.parameters(), 100)
optimizer.step()Scrivi un training loop per addestrare l’agente:
- Reimposta l’ambiente e avvia un nuovo episodio.
- Usa la funzione
select_action()per decidere l’azione dell’agente. - Ottieni la ricompensa e lo stato successivo dell’ambiente in base all’azione.
- Aggiungi stato, azione, stato successivo e ricompensa al replay buffer.
- Esegui l’ottimizzatore (definito sopra). L’ottimizzatore calcola i valori Q e la loss, applicando la backpropagation per aggiornare la rete.
- Aggiorna la target network in base alla policy network.
- Continua l’episodio fino a raggiungere uno stato terminale.
Il codice seguente implementa questi passaggi:
def train():
for episode in range(MAX_EPISODES):
# Initialize the environment and get its state
state, info = env.reset()
state = torch.tensor(state, dtype=torch.float32).unsqueeze(0)
for t in count():
action = select_action(state)
observation, reward, terminated, truncated, _ = env.step(action.item())
reward = torch.tensor([reward])
done = terminated or truncated
if terminated:
next_state = None
else:
next_state = torch.tensor(observation, dtype=torch.float32).unsqueeze(0)
memory.push(state, action, next_state, reward)
state = next_state
optimize_model()
target_net_state_dict = target_net.state_dict()
policy_net_state_dict = policy_net.state_dict()
for key in policy_net_state_dict:
target_net_state_dict[key] = policy_net_state_dict[key]*TAU + target_net_state_dict[key]*(1-TAU)
target_net.load_state_dict(target_net_state_dict)
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
print('count -- ', t)
#plot_durations()
breakPuoi visualizzare, modificare ed eseguire il programma di addestramento DQN usando questo workbook DataLab.
Visualizzare la funzione di valore d’azione
È utile tracciare visivamente l’avanzamento del processo di addestramento. Visualizzare i valori d’azione aiuta a riconoscere dove l’addestramento fallisce e quali parametri o iperparametri vanno modificati.
Per esempio, se osservi visivamente che il miglioramento delle prestazioni del modello è troppo lento, potresti voler aumentare il learning rate. Se noti che il modello sta imparando ma non è ancora completamente addestrato, può essere utile aumentare il numero di episodi di addestramento. Se trovi l’addestramento instabile, potresti ridurre il learning rate o ritoccare il coefficiente di esplorazione, o il tasso di aggiornamento della target network (TAU).
Oltre ai valori Q, può essere utile anche tracciare il numero di passi riusciti in ogni episodio. Nel Q-Learning con Q-table, i valori Q sono memorizzati esplicitamente. Tuttavia, usando i DQN, i valori Q non sono memorizzati esplicitamente. La rete restituisce l’azione in base ai suoi pesi e allo stato. Quindi, tracciare il numero di passi riusciti in ogni episodio può essere più significativo per i DQN.
I passaggi seguenti descrivono come tracciare i valori Q e il numero di passi riusciti per episodio durante l’addestramento dell’algoritmo di Q-learning:
- Crea due array vuoti all’inizio dell’addestramento:
q_vals- per memorizzare i valori Q in ogni passo di ciascun episodio.success_steps- per memorizzare il numero di passi riusciti in ogni episodio.- A ogni passo (in tutti gli episodi):
- Aggiungi il valore Q di quel passo all’array
q_vals - Dopo la terminazione di ogni episodio, aggiungi all’array
success_stepsil numero di passi riusciti in quell’episodio. - Traccia entrambi gli array.
Il codice seguente mostra il training loop del Q-Learning (con Q-table) illustrato nella sezione precedente, aggiornato per tracciare i valori Q e il numero di passi riusciti:
q_vals = []
success_steps = []
def train():
global q_vals
global success_steps
successful_episodes = 0
for episode in range(MAX_EPISODES):
epsilon = decay_epsilon(episode)
alpha = decay_alpha(episode)
observation, _ = env.reset()
state_current = discretize_state(observation)
for step in range(MAX_STEPS):
action = select_action(state_current, epsilon)
observation, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
state_next = discretize_state(observation)
best_q = update_q(state_current, state_next, action, reward, alpha)
q_vals.append(best_q)
state_current = state_next
if done:
q_vals.append(best_q)
success_steps.append(step)
print("Episode %d finished after %d time steps" % (episode, step))
print("best q value: %f" % (float(best_q)))
if (step >= SUCCESS_STEPS):
successful_episodes += 1
else:
successful_episodes = 0
break
if successful_episodes > SUCCESS_STREAK:
print("Training successful")
returnLo snippet seguente mostra come tracciare i valori Q in ogni episodio:
def plot_q():
plt.plot(q_vals)
plt.title('Q-values over training steps')
plt.xlabel('Training steps')
plt.ylabel('Q-value')
plt.show()Il seguente snippet mostra come tracciare il numero di passi riusciti in ogni episodio:
def plot_steps():
plt.plot(success_steps)
plt.title('Successful steps over training episodes')
plt.xlabel('Training episode')
plt.ylabel('Successful steps')
plt.show()- Il workbook DataLab per implementare il Q-learning usando le funzioni di valore d’azione include anche il codice per tracciare i valori Q e i passi riusciti per episodio.
- Il notebook per implementare il DQN include anche il codice per tracciare il numero di passi riusciti per episodio.
Valutare le prestazioni dell’agente
È necessario specificare i criteri per decidere se e quando l’agente è stato addestrato con successo. Nel ML tradizionale, l’obiettivo dell’addestramento è minimizzare la loss: la differenza tra i valori previsti e quelli veri. Nell’RL, l’obiettivo è massimizzare la ricompensa cumulativa. L’addestramento è considerato riuscito quando l’agente ottiene le ricompense massime dall’ambiente.
Ambienti come CartPole non terminano finché non raggiungono una condizione terminale, come colpire i bordi o inclinare eccessivamente l’asta. In tali casi, un agente addestrato può continuare a interagire con l’ambiente indefinitamente. Pertanto, il numero massimo di passi riusciti è imposto artificialmente. Nel caso del CartPole-v1 di Gymnasium, l’episodio termina quando raggiunge 500 timestep senza terminare.
Valutiamo le prestazioni dell’agente su episodi consecutivi per stabilire se l’addestramento ha successo. Per esempio:
- L’agente dovrebbe essere in grado di completare più di una soglia di passi (
SUCCESS_STEPS) in media negli ultimi N episodi. Negli esempi di questo articolo, impostiamo questa soglia a 450. - L’agente può superare la soglia in N episodi consecutivi (
SUCCESS_STREAK). In questo esempio, impostiamo N a 50.
Come esempio pratico, considera questo snippet dal training loop del DQN mostrato in precedenza.
if done:
episode_durations.append(t + 1)
print('episode -- ', episode)
average_steps = sum(episode_durations[-SUCCESS_STREAK:])/SUCCESS_STREAK
print('average steps over last 50 episodes -- ', average_steps)
if average_steps > SUCCESS_STEPS:
print("training successful.")
return
breakÈ utile valutare le prestazioni dell’agente eseguendo i seguenti passi alla fine (stato terminale) di ogni episodio di addestramento:
- Aggiungi a un array il numero totale di passi in questo episodio (prima che finisca). Questo array tiene traccia del numero totale di passi in ciascun episodio.
- Calcola la media degli ultimi N valori in questo array. In questo esempio, N (
SUCCESS_STREAK) è 50. Quindi, calcoliamo la media dei passi negli ultimi 50 episodi. - Se questa media è superiore a una soglia (
SUCCESS_STEPS), terminiamo l’addestramento. In questo esempio, questa soglia è fissata a 450 passi.
Best practice per usare le funzioni di valore d’azione
Ecco alcune best practice che puoi seguire per ottenere risultati migliori dall’implementazione della tua funzione di valore d’azione.
Bilancia esplorazione e sfruttamento
Con la vera funzione di valore d’azione nota, l’agente può massimizzare i ritorni attesi adottando una strategia greedy, scegliendo a ogni passo l’azione con il valore più alto. Questo è lo sfruttamento delle informazioni disponibili. Tuttavia, usare una strategia greedy con una funzione di valore d’azione non addestrata (che ancora non rappresenta i veri valori d’azione) porterà a bloccarsi in un ottimo locale.
Durante l’addestramento è importante sia esplorare l’ambiente sia sfruttare le informazioni disponibili.
Nelle fasi iniziali del processo di addestramento, le informazioni disponibili si basano su una funzione di valore casuale. Quindi queste informazioni non sono molto preziose (da sfruttare con una strategia greedy). È più importante esplorare l’ambiente per scoprire le ricompense delle varie possibili azioni in diversi stati.
Man mano che la Q-table viene aggiornata (o il DQN è addestrato), diventa possibile sfruttare parzialmente le informazioni disponibili per massimizzare le ricompense. Verso le fasi finali dell’addestramento, l’agente converge verso la vera funzione di valore; un’ulteriore esplorazione può essere dannosa. Quindi l’agente dà priorità allo sfruttamento della funzione di valore nota.
Ottimizza gli iperparametri
Come in qualsiasi modello di machine learning, gli iperparametri sono importanti per addestrare con successo gli algoritmi di RL. Nel caso di Q-Learning e DQN, gli iperparametri sono epsilon (tasso di esplorazione), alpha (learning rate) e gamma (tasso di sconto).
- ε (epsilon) controlla il bilanciamento tra esplorazione e sfruttamento (discusso sopra). Più alto è epsilon, più l’esplorazione è importante rispetto allo sfruttamento. All’inizio dell’addestramento assume un valore alto come 0,9, che viene gradualmente ridotto a un valore piccolo come 0,05 verso la fine dell’addestramento.
- α (alpha) è il learning rate (LR). Controlla quanto cambiano i parametri della rete neurale (nel caso dei DQN) o i valori della Q-Table in ogni iterazione di addestramento. Se il LR è troppo alto, il modello diventa instabile e non converge. D’altra parte, un LR basso porta a una convergenza lenta. È anche comune iniziare con un LR alto nelle fasi iniziali dell’addestramento, quando l’agente deve esplorare l’ambiente. Man mano che si avvicina ai veri valori della Q-function, il LR viene ridotto per aiutare la rete a convergere.
- γ (gamma) è il tasso di sconto. Decide l’importanza delle ricompense nei timestep successivi rispetto a quelle immediate. Un valore alto di gamma significa che le ricompense future sono importanti. Un valore di gamma pari a 0 significa che conta solo la ricompensa dell’istante corrente, e le ricompense successive non hanno importanza. Negli algoritmi come il Q-learning, il ritorno totale si basa sulle ricompense ottenute durante l’intero episodio. Quindi è comune usare un alto tasso di sconto, come 0,99.
Infine, considera che l’addestramento RL è sensibile ai valori casuali iniziali. Se l’addestramento non converge, spesso è utile usare un random seed diverso o rieseguire l’addestramento per partire con un diverso insieme di valori iniziali casuali.
Parti da ambienti semplici
Addestrare agenti RL in ambienti complessi è impegnativo. Le Q-function sono usate in molti algoritmi diversi, quindi è essenziale costruire un po’ di intuizione addestrando agenti RL basati su Q-learning. Questo si fa al meglio esercitandosi con ambienti più semplici come CartPole prima di applicare metodi simili a ambienti più complessi.
Inoltre, gli ambienti complessi sono più costosi da addestrare, quindi è più economico usare ambienti semplici come strumento di apprendimento.
Conclusione
Questo articolo ha discusso i principi teorici fondamentali della funzione di valore d’azione e la sua importanza nell’RL. Abbiamo visto come le funzioni di valore d’azione sono utilizzate nel Q-learning e nel Deep Q-learning, e implementato entrambi i metodi passo dopo passo in Python.
Per proseguire l’apprendimento, ti consiglio vivamente il corso Deep Reinforcement Learning in Python.
FAQ
Qual è la differenza tra value function e action-value function nell’RL?
La value function stima il ritorno atteso da uno stato, mentre la funzione di valore d’azione (Q-function) stima il ritorno derivante dall’eseguire una specifica azione in uno stato e seguire poi la politica. La funzione di valore d’azione offre una guida più granulare per il processo decisionale.
Perché la funzione di valore d’azione è importante nel Q-learning?
Il Q-learning usa la funzione di valore d’azione per guidare l’agente verso le azioni che producono le ricompense attese più alte. La funzione abilita l’apprendimento off-policy e aiuta l’agente a convergere nel tempo verso la strategia ottimale.
Come è correlata la funzione di valore d’azione all’equazione di Bellman?
L’equazione di Bellman fornisce una formulazione ricorsiva per aggiornare i valori Q in base alla ricompensa immediata e alla massima ricompensa futura scontata. È il fondamento per apprendere iterativamente la funzione di valore d’azione.
Posso usare la funzione di valore d’azione in spazi di stato continui?
Sì, ma le Q-table diventano impraticabili in spazi continui. In tali casi, si usano i Deep Q-Network (DQN) per approssimare la funzione di valore d’azione con una rete neurale invece di tabelle esplicite.
Qual è il ruolo dell’esplorazione nella stima della funzione di valore d’azione?
L’esplorazione assicura che l’agente non converga prematuramente a una politica subottimale. Aiuta l’agente a raccogliere esperienze diversificate, essenziali per stimare accuratamente la funzione di valore d’azione durante l’addestramento.
Come influisce la strategia ε-greedy sull’apprendimento dei valori Q?
La strategia ε-greedy bilancia esplorazione e sfruttamento. Con probabilità ε, l’agente esplora nuove azioni, e con 1–ε sfrutta l’azione migliore nota al momento. Questo compromesso migliora la stabilità e la convergenza dell’apprendimento.
Quando dovresti passare dal Q-learning al Deep Q-learning?
Quando l’ambiente ha uno spazio degli stati ampio o continuo, mantenere una Q-table diventa inefficiente. Il Deep Q-learning sostituisce la tabella con una rete neurale che scala meglio su ambienti complessi.
Come posso visualizzare una funzione di valore d’azione durante l’addestramento?
Puoi tracciare i valori Q massimi nel tempo o monitorare le ricompense per episodio per seguire i progressi dell’apprendimento. La visualizzazione aiuta a diagnosticare problemi come scarsa convergenza o esplorazione insufficiente.
Quali sono le principali sfide nell’addestrare una funzione di valore d’azione?
Le sfide includono instabilità dell’addestramento dovuta a target variabili, scarsa esplorazione e impostazioni subottimali degli iperparametri. Tecniche come replay memory e target network aiutano a mitigare questi problemi.
La funzione di valore d’azione è usata negli algoritmi on-policy?
Sì, algoritmi come SARSA usano la funzione di valore d’azione ma la aggiornano usando l’azione effettivamente intrapresa dalla politica corrente. Questo contrasta con i metodi off-policy come il Q-learning, che usano il valore Q massimo dello stato successivo.






Il Reinforcement Learning (RL) è un paradigma di machine learning in cui un agente impara a prendere le decisioni giuste interagendo con un ambiente esterno. L’ambiente fornisce un feedback, sotto forma di ricompense, quando viene intrapresa l’azione corretta.
L’obiettivo dell’agente è massimizzare le ricompense cumulative. In molti problemi pratici, il feedback all’agente proviene da un essere umano; questo è chiamato RL con feedback umano (RLHF).
RLHF è comunemente usato per ottimizzare gli LLM affinché producano output allineati ai valori e alle preferenze umane. Quando è un’IA a fornire il feedback, si parla di RL con feedback dell’IA.
L’agente usa la funzione di valore d’azione per valutare quale azione scegliere a ogni passo. Una funzione di valore d’azione ottimizzata aiuta l’agente a scegliere l’azione migliore a ogni passo per massimizzare le ricompense cumulative.
In questo tutorial introdurrò la funzione di valore d’azione, spiegherò il suo ruolo nell’RL e ti mostrerò come implementarla da zero.
Cos’è una funzione di valore d’azione?
La funzione di valore d’azione (Q) stima il ritorno atteso (ricompensa cumulativa) ottenuto eseguendo una specifica azione (a) in uno stato particolare (s) e seguendo poi la politica π . Si indica come Qπ(s,a). Quando è ovvio che l’agente segue la politica ottimale, si usa più semplicemente Q(s,a).
La funzione di valore d’azione si usa per scegliere l’azione che porta al ritorno più alto a partire da uno stato dato. La politica ottimale (π*) massimizza il ritorno atteso. Quindi, in ogni stato s, la politica sceglie l’azione che porta al ritorno atteso più alto. Questa politica ottimale si esprime come π* = argmaxa Q(s,a).
La Q-function è tradizionalmente modellata come una Q-table. Questa tabella memorizza il valore di ogni possibile azione per ciascuno stato possibile dell’ambiente. Per ambienti complessi, la tabella diventa ingestibile e inefficiente. Perciò, nella maggior parte degli ambienti non banali modelliamo la Q-table come una rete neurale. Questa rete approssima la funzione della Q-table. Dato uno stato, restituisce i valori d’azione corrispondenti a quello stato.
Perché le funzioni di valore d’azione sono importanti nell’RL
Nota la vera funzione di valore d’azione, la politica dovrebbe scegliere l’azione che porta alle ricompense attese più alte. Questa strategia è detta sfruttamento. Tuttavia, durante l’addestramento la vera funzione di valore d’azione non è ancora nota. Di conseguenza, la scelta dell’azione si basa su informazioni incomplete. Lo sfruttamento (massimizzare il ritorno) basato su informazioni incomplete può impedire di scoprire la vera funzione di valore d’azione e intrappolare in un ottimo locale.
D’altra parte, una strategia esplorativa a volte sceglie azioni subottimali che potrebbero alla fine portare a uno stato con valore più alto. Questo è implementato come strategia ε - greedy, in cui ε è un valore piccolo. La politica sceglie casualmente un’azione subottimale con probabilità ε e l’azione che massimizza la ricompensa con probabilità 1 - ε.
Adottare una strategia che bilanci sfruttamento ed esplorazione permette all’agente di scoprire percorsi alternativi nell’ambiente, portando a ricompense cumulative migliori.
Fondamenti degli algoritmi di RL
Gli algoritmi di RL possono essere classificati in due grandi categorie: 1) model-based e model-free, e 2) on-policy e off-policy.
Algoritmi model-based e model-free
Nei metodi model-based, cerchi di prevedere il modello di distribuzione di probabilità dell’ambiente P(r, s' | s, a) - la probabilità di ricevere una ricompensa r e raggiungere uno stato s' partendo da uno stato s ed eseguendo l’azione a.
Questi metodi usano le interazioni dell’agente con l’ambiente per perfezionare il modello (dell’ambiente) e migliorare le ricompense e gli stati previsti. Così l’agente può simulare l’ambiente tramite il modello, senza dover necessariamente interagire con l’ambiente a ogni passo.
Alcuni algoritmi model-based come Dyna-Q aggiornano la Q-function tramite esperienze simulate. Questi metodi si usano quando è costoso o impraticabile far interagire un agente non addestrato molte volte con l’ambiente. Per esempio, è troppo costoso far cadere ripetutamente un robot non addestrato rischiando di danneggiarlo.
Al contrario, i metodi model-free come il Q-learning aggiornano direttamente Q(s,a) seguendo un processo iterativo per convergere verso la vera funzione di valore d’azione senza modellare esplicitamente l’ambiente. L’agente interagisce direttamente con l’ambiente a ogni passo. Usano il trial-and-error per convergere alla politica ottimale. Poiché non coinvolgono un modello dell’ambiente, sono più semplici ma richiedono un ampio campione di interazioni con l’ambiente.
Gli algoritmi model-free come Q-learning, SARSA (State-Action-Reward-State-Action) e i DQN, apprendono esplicitamente la Q-function e la usano per stimare il valore d’azione a ogni passo.
Algoritmi on-policy e off-policy
Gli algoritmi off-policy (come DQN e Q-learning) usano l’esperienza replay per apprendere il valore della politica ottimale. Dispongono di un ampio set di interazioni (reali o simulate) con l’ambiente e campionano casualmente queste interazioni per aggiornare la Q-function. Non usano la politica ottimale per determinare l’azione a ogni passo. I metodi off-policy usano la Q-function per stimare il valore d’azione per la politica target. Mirano a massimizzare i ritorni futuri aggiornando la Q-function in base alla ricompensa attesa più alta dal passo successivo.
Alcuni algoritmi on-policy (come SARSA) usano la politica per selezionare l’azione a ogni passo. Così l’agente segue la stessa politica che aggiorna. La Q-function è aggiornata in base alla ricompensa che l’agente riceve seguendo la politica. Altri algoritmi on-policy, come i policy gradient e gli actor-critic, non usano la Q-function.
Dunque, le funzioni di valore d’azione sono alla base di vari algoritmi di RL.
Selezione ottimale delle azioni
Il valore Q Q(s,a) rappresenta il ritorno atteso dall’eseguire l’azione a nello stato s e seguendo poi la politica. Quindi, data una Q-table addestrata, selezionare l’azione che porta al valore Q massimo in uno stato particolare conduce a una politica ottimale basata su una strategia greedy (incentrata sullo sfruttamento). A ogni passo, l’agente sceglie l’azione a* = arg max a Q(s,a). Così, sull’intero episodio, sceglie il percorso che massimizza le ricompense di lungo termine sfruttando le informazioni disponibili.
Metodi come il Q-learning aggiornano i valori Q nella Q-table in molte iterazioni per convergere ai loro valori ottimali. Quindi, dopo l’addestramento, l’algoritmo raggiunge la politica ottimale che sceglie l’azione ottimale da ogni stato e il percorso ottimale nell’episodio.