Curso
Desarrollo de aplicaciones LLM con LangChain
3 h
51.8K
Practica y programa tu progreso.
Continuar Con GoogleImagina que ejecutas exactamente el mismo modelo de lenguaje grande (LLM) dos veces, pero a cada uno le das un arnés completamente distinto. Una ejecución termina una compleja tarea de refactorización sin problemas. La segunda se detiene y falla por completo. El modelo no cambió, pero sí el andamiaje que lo rodea.
En pocas palabras, agent harness engineering es la práctica de construir la lógica, el acceso al sistema de archivos, la memoria y las reglas que permiten a un LLM actuar de forma fiable.
En este tutorial de agent harness engineering, te enseñaré a montar un setup mínimo en Python con un bucle Reason and Act (ReAct), herramientas y hooks. Necesitas Python 3, pip instalado en tu máquina y familiaridad básica con realizar llamadas a APIs de LLM.
Agent harness engineering es la práctica de construir la infraestructura, las configuraciones y la lógica de ejecución que envuelven a un modelo de lenguaje grande, llevándolo de ser un generador de texto LLM estático a un agente de IA autónomo
Agent harness engineering es la configuración estructural que convierte un generador de texto estático en un trabajador autónomo.
La ecuación básica es sencilla: agente = modelo + arnés. El arnés incluye prompts de sistema, definiciones de herramientas, espacios de trabajo en el sistema de archivos, lógica de orquestación y hooks de observabilidad.
Addy Osmani sistematizó este concepto en su artículo de abril de 2026 en O'Reilly sobre flujos de trabajo de IA. Definió el arnés como todo el código, la configuración y la lógica de ejecución que no es el propio modelo: tu superficie de trabajo como desarrollador, distinta del API del proveedor.
Cuando empecé a construir flujos de machine learning, culpaba al modelo cada vez que un agente alucinaba una dependencia de Python. Aprendí por las malas que la mayoría de fallos son problemas de configuración.
La misma versión exacta de un modelo, con un arnés mejor, supera de forma medible a sí misma con uno malo.
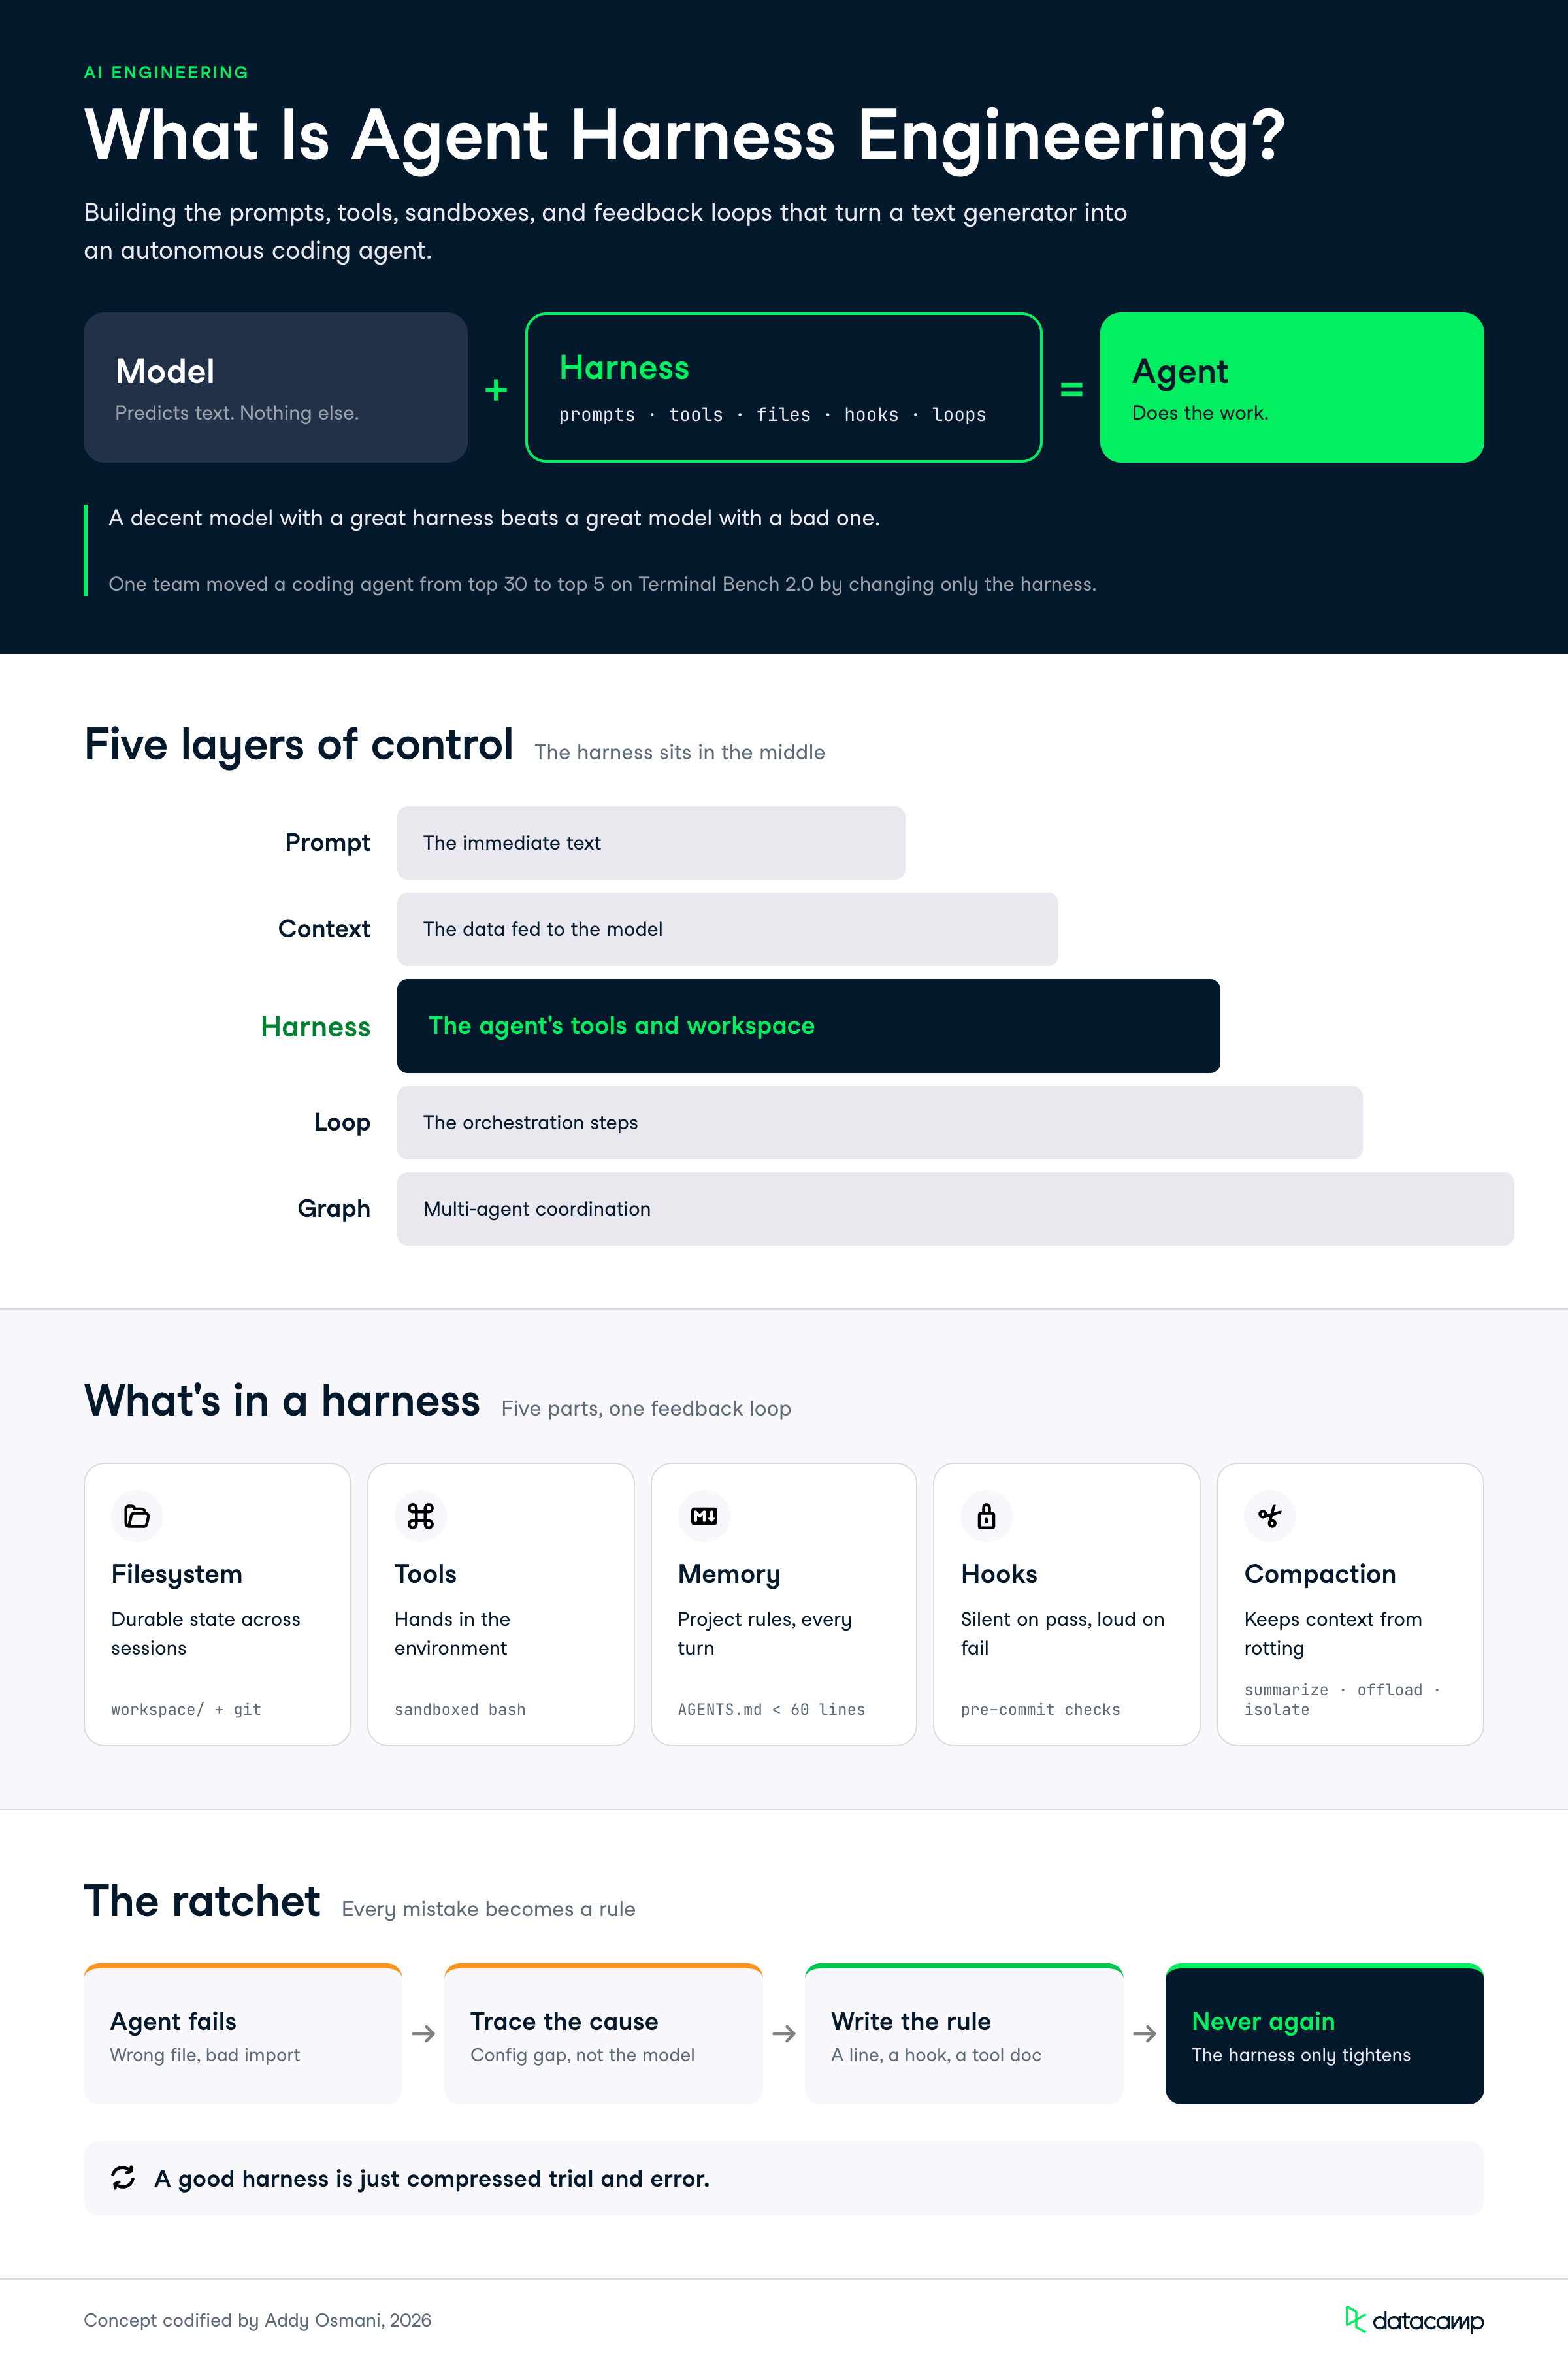
Podemos desglosar el desarrollo de IA en capas de control diferenciadas.
Harness engineering se sitúa justo en el centro de esta jerarquía.
|
Capa |
Qué controla |
Acción de ejemplo |
|
Prompt engineering |
El texto inmediato |
Ajustar instrucciones |
|
Context engineering |
Los datos que das al modelo |
Ajuste de una canalización RAG |
|
Harness engineering |
Las herramientas físicas del agente |
Añadir una herramienta de Bash |
|
Loop engineering |
Los pasos de orquestación |
Cambiar el flujo ReAct |
|
Graph engineering |
Coordinación multiagente |
Crear nodos de enrutamiento |
pandas o lee un CSV local. La mentalidad clave del agent harness engineering es el efecto trinquete.
Cuando un agente comete un error, diseñas una solución para que no lo repita nunca más. Un buen arnés es prueba y error comprimidos.
En lugar de dejar que el agente repita fallos, añades una línea a tu AGENTS.md, escribes un nuevo hook o afinas la descripción de una herramienta.
No te lanzas instintivamente a por un modelo nuevo; construyes un corpus que te permita rastrear fallos concretos y cómo te has blindado contra ellos.
Los componentes clave de un agent harness de IA son el sistema de archivos, las herramientas, la memoria, los hooks y los sistemas de gestión de contexto que permiten operar al modelo.
Estas piezas trabajan juntas para transformar llamadas aisladas a la API en un bucle continuo de feedback. Quiero darte un mapa claro antes de empezar a programar.
|
Componente |
Función |
Implementación en Python |
|
Sistema de archivos |
Estado duradero |
Directorio local workspace/ |
|
Herramientas |
Actuar en el entorno |
Funciones de Python para Bash |
|
Memoria |
Contexto del proyecto |
Un archivo AGENTS.md |
|
Hooks |
Aplicación de reglas |
Scripts de validación pre-commit |
|
Compactación |
Gestión del contexto |
Lógica de resumen |
Un modelo solo puede procesar información dentro de su ventana de contexto limitada. Un sistema de archivos proporciona un espacio de trabajo estable para leer datos, escribir resultados intermedios y coordinar entre sesiones.
Añadir control de versiones con Git aporta una red de seguridad necesaria. El agente puede seguir el progreso, crear ramas para experimentos con distintos hiperparámetros y revertir código roto automáticamente.
El bucle ReAct opera en un ciclo de razonamiento, acción mediante una llamada a herramienta y observación del resultado. Las descripciones de herramientas forman la interfaz directa entre el modelo y el entorno. Descripciones vagas producen comportamientos vagos.
Bash es una gran herramienta de propósito general. En lugar de crear previamente una función de Python específica para cada acción posible, Bash permite al agente construir al vuelo los comandos exactos que necesita. Debes aislar cuidadosamente estos comandos para evitar daños en el sistema.
AGENTS.md e inyección de conocimientoTu agente necesita memoria específica del proyecto para entender convenciones locales. Un archivo AGENTS.md es un documento markdown plano en la raíz del repositorio que se incluye en el prompt del sistema en cada turno. Define tu stack, las reglas de formato y las acciones prohibidas.
Mantén este archivo por debajo de 60 líneas. Trátalo como la checklist de un piloto, no como una guía de estilo exhaustiva. Puedes leer un tutorial completo de AGENTS.md para ver ejemplos más profundos. También deberías considerar herramientas de Model Context Protocol (MCP) para conocimiento posterior al cutoff.
Los hooks son pequeños scripts que se ejecutan en momentos específicos del ciclo de vida.
Puedes ejecutar un hook antes de una llamada a herramienta, después de editar un archivo o antes de un commit de Git. Consulta esta guía sobre Claude Code Hooks para patrones avanzados.
El principio de diseño principal para los hooks es que el éxito sea silencioso y los fallos, ruidosos. Un typecheck que pasa no produce salida.
Un fallo inyecta el error exacto de vuelta en el bucle del agente para su autocorrección.
La degradación del contexto ocurre cuando el seguimiento de instrucciones empeora a medida que la ventana se llena con historiales de conversación largos. Un buen andamiaje de agente de IA debe gestionarlo activamente. Lee más sobre la ventana de contexto para entender estos límites.
Puedes reducir el contexto resumiendo mensajes antiguos. Puedes descargar salidas voluminosas de herramientas a disco y mantener solo una referencia corta en el prompt.
Por último, puedes aislar subtareas intensivas en tokens en un subagente con su propio contexto fresco.
Construir un agent harness de IA implica escribir el código de orquestación en Python que une el bucle ReAct, las herramientas y los hooks.
Ten clara la relación antes de escribir nada: harness.py es el agente, y lo ejecutas tú mismo con python harness.py como cualquier otro script.
El modelo es una API remota que nunca ve este archivo; solo recibe el prompt de sistema, el historial de mensajes y los esquemas de herramientas que tu script le envía.
Cada fragmento de esta sección es una pieza de un único archivo, harness.py, y las 4 primeras secciones lo construyen de arriba abajo. Las 2 últimas (hooks y compactación) lo mejoran, y como el bucle se ejecuta en cuanto Python lo alcanza, sus definiciones deben ir por encima del bucle; cada sección te indica exactamente dónde va su código.
Para construir esto, necesitas una cuenta de desarrollador con tu proveedor elegido. Las suscripciones de consumo estándar (como ChatGPT Plus o Claude Pro) no dan acceso a la API.
ANTHROPIC_API_KEY (o OPENAI_API_KEY).En este ejemplo usaremos Anthropic, así que asegúrate de instalar el paquete de Python de Anthropic con pip install anthropic.
Después, crea el esqueleto del proyecto. Poner nombre a cada archivo desde el principio importa: nuestro bucle leerá AGENTS.md al arrancar, así que ese archivo debe existir antes de que el bucle se ejecute.
agent-harness/
├── AGENTS.md        # Memoria del proyecto (esto va primero)
├── harness.py       # El bucle ReAct, herramientas y hooks
└── workspace/       # El único directorio que el agente puede tocar
El directorio workspace/ es el sandbox del agente. Todo lo que el agente lee, escribe o ejecuta sucede dentro de él, nunca en la raíz del proyecto.
Escribimos AGENTS.md antes del bucle porque el bucle depende de él.
Crea el archivo en la raíz del proyecto e incluye detalles específicos de tu stack y límites arquitectónicos:
# Contexto del proyecto
Stack: Python 3.11, Pytest
Workspace: Todos los comandos se ejecutan dentro del directorio workspace/.

# Reglas
1. Nunca uses rm -rf. Usa rm estándar con nombres de archivo concretos.
2. No escribas tests dentro del archivo principal de la aplicación.
3. Cuando termines la tarea, responde con un resumen en texto plano y sin llamada a herramienta.
Nuestro bucle tratará "el modelo respondió sin solicitar una herramienta" como la señal de tarea completada, así que le indicamos explícitamente al modelo cómo debe señalar el final.
Las reglas que hacen referencia a la mecánica de tu propio bucle son la clave del harness engineering. El archivo de memoria y el código de orquestación se diseñan juntos.
Ahora inicia harness.py creando este archivo como prompt del sistema y preparando el workspace:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Memoria del proyecto: AGENTS.md se incluye en el prompt del sistema en cada turno
system_prompt = Path("AGENTS.md").read_text()
Como el SDK envía system_prompt en cada llamada a la API, las reglas de AGENTS.md se reinyectan en cada turno. El modelo no puede "olvidarlas" como olvida instrucciones a mitad de conversación.
Definimos 2 herramientas: run_bash para ejecución de propósito general y write_file para crear archivos.
La segunda puede parecer redundante porque Bash puede escribir archivos con heredocs, pero una write_file dedicada nos da un evento de edición limpio al que podrá engancharse nuestro hook posterior.
Las decisiones de diseño del arnés siempre van de qué quieres observar y hacer cumplir.
Las descripciones de herramientas son la interfaz, y su calidad controla directamente el comportamiento del agente:
Siguiendo en nuestro archivo harness.py, ahora podemos definir los esquemas de herramientas en la línea siguiente:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
El siguiente bloque define las funciones de Python que ejecutarán estos comandos.
Fíjate en estas medidas de seguridad incorporadas: un timeout estricto para que un comando bloqueado no cuelgue el arnés, el código de salida incluido en cada resultado para que el agente pueda distinguir éxito de fallo, y una comprobación de ruta para que write_file() no se escape del sandbox.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
El fallback or '(no output)' no es cosmético.
Un comando como touch data.csv tiene éxito en silencio, y devolver una cadena vacía no le da al modelo nada que observar.
Dale siempre al agente una señal explícita, incluso para el silencio.
El núcleo de nuestro arnés es un bucle for estándar de Python con un límite de iteraciones.
Cada pasada llama a la API, comprueba si el modelo pidió una herramienta, ejecuta todas las herramientas solicitadas y devuelve los resultados como un único mensaje.
Este bloque va al final de harness.py, ya que empieza a ejecutarse en el momento en que Python llega a él.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Dos detalles de este bucle evitan fallos reales.
Primero, un único turno del modelo puede contener múltiples llamadas a herramientas, y la API de Anthropic requiere que todos sus resultados vuelvan en un único mensaje de usuario.
Segundo, la construcción for/else informa cuando el agente alcanza el límite de iteraciones, de modo que una ejecución estancada falla en voz alta en lugar de acabar en silencio.
Esta estructura explícita te permite ver exactamente dónde el modelo deja de pensar, dónde toma el relevo Python para ejecutar el comando y cómo la salida vuelve al bucle.
Los hooks capturan errores antes de que se conviertan en problemas estructurales mayores.
En nuestro arnés, un hook es una función que inspecciona una llamada de herramienta completada y devuelve texto extra para añadir al resultado de la herramienta.
El éxito devuelve una cadena vacía; el fallo devuelve un informe detallado.
Añade esta función a harness.py por encima del bucle ReAct, junto a los ejecutores de herramientas. El bucle empieza a ejecutarse en cuanto Python lo alcanza, así que todo lo que llame debe estar definido ya.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
Conectarlo al bucle es un cambio de una línea dentro del bloque de ejecución de herramientas:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Sin el hook, el agente escribe un archivo roto, ve Wrote 412 characters to fizzbuzz.py y sigue adelante con confianza.
Con el hook, el mismo resultado de herramienta lleva el traceback exacto de pytest. En la siguiente iteración, el agente lee el error y corrige el bug por sí mismo, sin prompts adicionales.
Para combatir la degradación del contexto, monitoriza la longitud de tu lista messages y resume los turnos más antiguos cuando crezca demasiado.
Hay una trampa: no puedes cortar el historial en un punto arbitrario, porque un bloque tool_use del asistente y su mensaje tool_result emparejado deben permanecer juntos. Separar una pareja produce un error inmediato de la API.
Nuestra función de compactación mueve el punto de corte hacia delante hasta caer en un límite seguro. Construye esto por encima de harness.py:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Añade una línea al principio del bucle ReAct, antes de la llamada a la API:
messages = compact(messages)Usamos un modelo más pequeño y barato para el resumen porque la compactación se ejecuta a menudo y necesita velocidad.
Además, mantenemos el mensaje de tarea original literal en lugar de confiar en que el resumen lo conserve.
El arnés ya está completo.
Antes de seguir, comprueba que tu harness.py queda en este orden de arriba abajo:
client, WORKSPACE y system_promptTOOLSrun_bash(), write_file() y TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() y compact()Para que veas cómo debería quedar el bucle final de la API tras añadir las secciones de hook y compactación, aquí tienes el bucle terminado al completo:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Ahora ejecuta el agente desde la raíz del proyecto con python harness.py.
El script envía la tarea de la lista messages a la API.
El arnés hace el trabajo y deberías ver cada iteración impresa en tu terminal:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
El programa sale cuando el modelo responde sin llamada a herramienta, o cuando salta el límite de 15 iteraciones.
Para darle al agente otra tarea, cambia la cadena content en la lista inicial messages; un arnés en producción la leería de input() o de un argumento de línea de comandos.
El trinquete es el proceso continuo de diagnosticar fallos del agente y actualizar tu arnés para evitarlos.
Un arnés mejora estrictamente con exposición a casos límite reales.
Vamos a recorrer un ciclo completo de fallo y arreglo basado en un proyecto real de optimización de rutas.
Imagina que tu agente sigue importando una librería interna de enrutamiento obsoleta llamada legacy_route_math en lugar de la versión actualizada.
El agente escribe el script, los tests fallan y se queda atascado intentando arreglar la sintaxis en lugar de cambiar la librería.
El diagnóstico aquí es directo.
El agente simplemente no sabe que la librería está obsoleta. Es una regla que falta, no un fallo de la red neuronal subyacente.
La solución 1 actualiza la capa de memoria: añade esta regla a AGENTS.md:
# Reglas
1. Nunca uses rm -rf. Usa rm estándar con nombres de archivo concretos.
2. No escribas tests dentro del archivo principal de la aplicación.
3. Cuando termines la tarea, responde con un resumen en texto plano y sin llamada a herramienta.
4. No importes legacy_route_math; está obsoleta. Usa routes_v2 en su lugar.
La solución 2 añade un hook de aplicación permanente.
Las reglas son consejos para el agente; los hooks son órdenes. Esta corrección son pocas líneas y puede añadirse junto a post_edit_hook(), siempre que esté antes del bucle ReAct.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Regístralo junto al hook de pytest en el bloque de ejecución de herramientas:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
Así es como se ve la autocorrección en la transcripción tras aplicar ambas soluciones.
El agente escribe el archivo, salta el hook y en el siguiente turno corrige el import sin intervención humana:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
Esto es importante porque se conecta con la degradación del contexto. Sesiones muy largas con contexto degradado acabarán ignorando reglas de memoria.
La regla en AGENTS.md evita el error la mayor parte del tiempo, y el hook garantiza que, cuando la regla falle, el error no cause daños.
Cada fallo que diagnostiques debería hacerte dos preguntas: ¿qué regla faltaba y qué comprobación lo habría detectado igualmente?
Las buenas prácticas se centran en mantener configuraciones ligeras y diseñar pensando en futuras actualizaciones de modelos.
El objetivo es construir un andamiaje que apoye al modelo sin abrumarlo.
He aprendido unas cuantas lecciones a base de construir habilidades de agentes y arquitecturas diversas.
Apunta a un máximo de 60 líneas para tu archivo de contexto.
Cada regla debe remontarse a un fallo real y documentado que viviste. Si no recuerdas el incidente para esa regla, probablemente merezca la pena borrarla.
Esta disciplina importa porque AGENTS.md se paga en cada turno.
Una guía de estilo de 300 líneas te cuesta tokens en cada llamada a la API y diluye las reglas importantes, ya que los modelos siguen mucho mejor 10 reglas claras que 80 vagas.
Añadir una marca de fecha incluso puede ayudar con la práctica que recomiendo a continuación.
Los arneses necesitan re-arquitecturas constantes a medida que los modelos base mejoran sus capacidades nativas.
Construye los componentes para poder retirarlos fácilmente.
El patrón de hooks de este tutorial es deliberadamente modular por este motivo.
Cada hook es una función separada que luego se añade con una sola línea. Si lo deprecas, borras una línea del bucle.
Nada más del bucle cambia.
Compáralo con lógica de validación tejida directamente en tu bucle ReAct, donde quitar una comprobación obsoleta implica re-probar todo el camino de orquestación.
Lo que hoy parece una muleta necesaria será sobrecarga innecesaria el próximo trimestre.
Cuando salga un modelo nuevo, vuelve a ejecutar tus casos de fallo antiguos desactivando cada hook de uno en uno, y trata cualquier hook que ya no capture nada como candidato a eliminación.
Consulta Claude Code Best Practices para más consejos de arquitectura.
Un bucle ReAct básico con un sistema de archivos y una herramienta de Bash ya es muy práctico.
Resiste la tentación de construir preventivamente un sistema de grafos complejo con frameworks pesados. El trinquete solo funciona en una dirección: del fallo observado a la solución dirigida. Las soluciones especulativas lo invierten.
Añade hooks personalizados solo después de haber visto el fallo exacto que los justifica. Para estructurar sistemas básicos, echa un vistazo a esta guía sobre agentes LLM.
No puedes ajustar con trinquete lo que no ves.
Nuestro bucle ya imprime cada llamada a herramienta, y ese es el mínimo de observabilidad viable: cuando una ejecución falla, la transcripción impresa es tu material de diagnóstico.
A medida que tu arnés madure, escribe el historial completo de mensajes de cada sesión en un JSON con marca temporal al final de la ejecución.
Las transcripciones fallidas se convierten en tu suite de regresión; tras cada cambio en el arnés, reejecuta las tareas que fallaban y confirma que la solución se mantiene.
Esta es la versión del ingeniero de arnés de una batería de tests, y es lo que diferencia un arnés que mejora de uno que solo cambia.
Agent harness engineering es la realidad práctica de conseguir que los modelos de IA hagan trabajo útil.
La brecha entre lo que los modelos actuales pueden hacer en teoría y lo que realmente ves en producción es, en gran medida, una brecha de arnés.
Esta disciplina no va de aprender un framework específico.
El agent harness adecuado para tu base de código depende por completo de tu historial único de fallos, y se construye de forma incremental con el método del trinquete.
¿Listo para poner estos conceptos en práctica?
Echa un vistazo al itinerario de habilidades AI Agent Fundamentals de DataCamp para seguir construyendo sistemas listos para producción. También puedes explorar el tutorial del Claude Agent SDK para más ejemplos prácticos.
Quizá también te interese el itinerario de habilidades AI for Software Engineering.
Los mejores cursos de DataCamp
Curso
Curso
Practica y programa tu progreso.
Continuar Con GoogleTutorial
Tutorial
Arjun Sarkar
15 min
Tutorial
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
12 min
Tutorial
Zoumana Keita
14 min