

Cours
Développement d'applications LLM avec LangChain
3 h
51.8K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleImaginez exécuter exactement le même grand modèle de langage (LLM) deux fois, mais avec deux harnais complètement différents. Dans le premier cas, la refactorisation complexe se termine proprement. Dans le second, l’agent s’arrête et échoue totalement. Le modèle n’a jamais changé, mais tout l’échafaudage autour, si.
En bref, l’agent harness engineering consiste à concevoir la logique, l’accès au système de fichiers, la mémoire et les règles qui permettent à un LLM d’agir de façon fiable.
Dans ce tutoriel d’agent harness engineering, je vous montre comment construire un setup Python minimal avec une boucle Reason and Act (ReAct), des outils et des hooks. Vous avez besoin de Python 3, de pip installé sur votre machine, et d’une familiarité de base avec les appels d’API LLM.
L’agent harness engineering désigne la conception de l’infrastructure, des configurations et de la logique d’exécution qui enveloppent un grand modèle de langage pour le faire passer d’un simple générateur de texte LLM à un agent IA autonome
L’agent harness engineering est la configuration structurelle qui transforme un générateur de texte statique en véritable exécutant autonome.
L’équation de base est simple : agent = modèle + harnais. Le harnais inclut des prompts système, des définitions d’outils, des espaces de travail sur le système de fichiers, une logique d’orchestration et des hooks d’observabilité.
Addy Osmani a formalisé ce concept dans son article O’Reilly d’avril 2026 sur les workflows IA. Il y définit le harnais comme tout le code, la configuration et la logique d’exécution qui ne sont pas le modèle lui‑même : votre surface d’intervention en tant que développeur, distincte de l’API du fournisseur.
Quand j’ai commencé à bâtir des workflows de machine learning, j’accusais le modèle à chaque fois qu’un agent hallucinait une dépendance Python. J’ai appris à la dure que la plupart des échecs sont des problèmes de configuration.
La même version d’un modèle, avec un meilleur harnais, surpasse nettement sa propre performance avec un mauvais harnais.
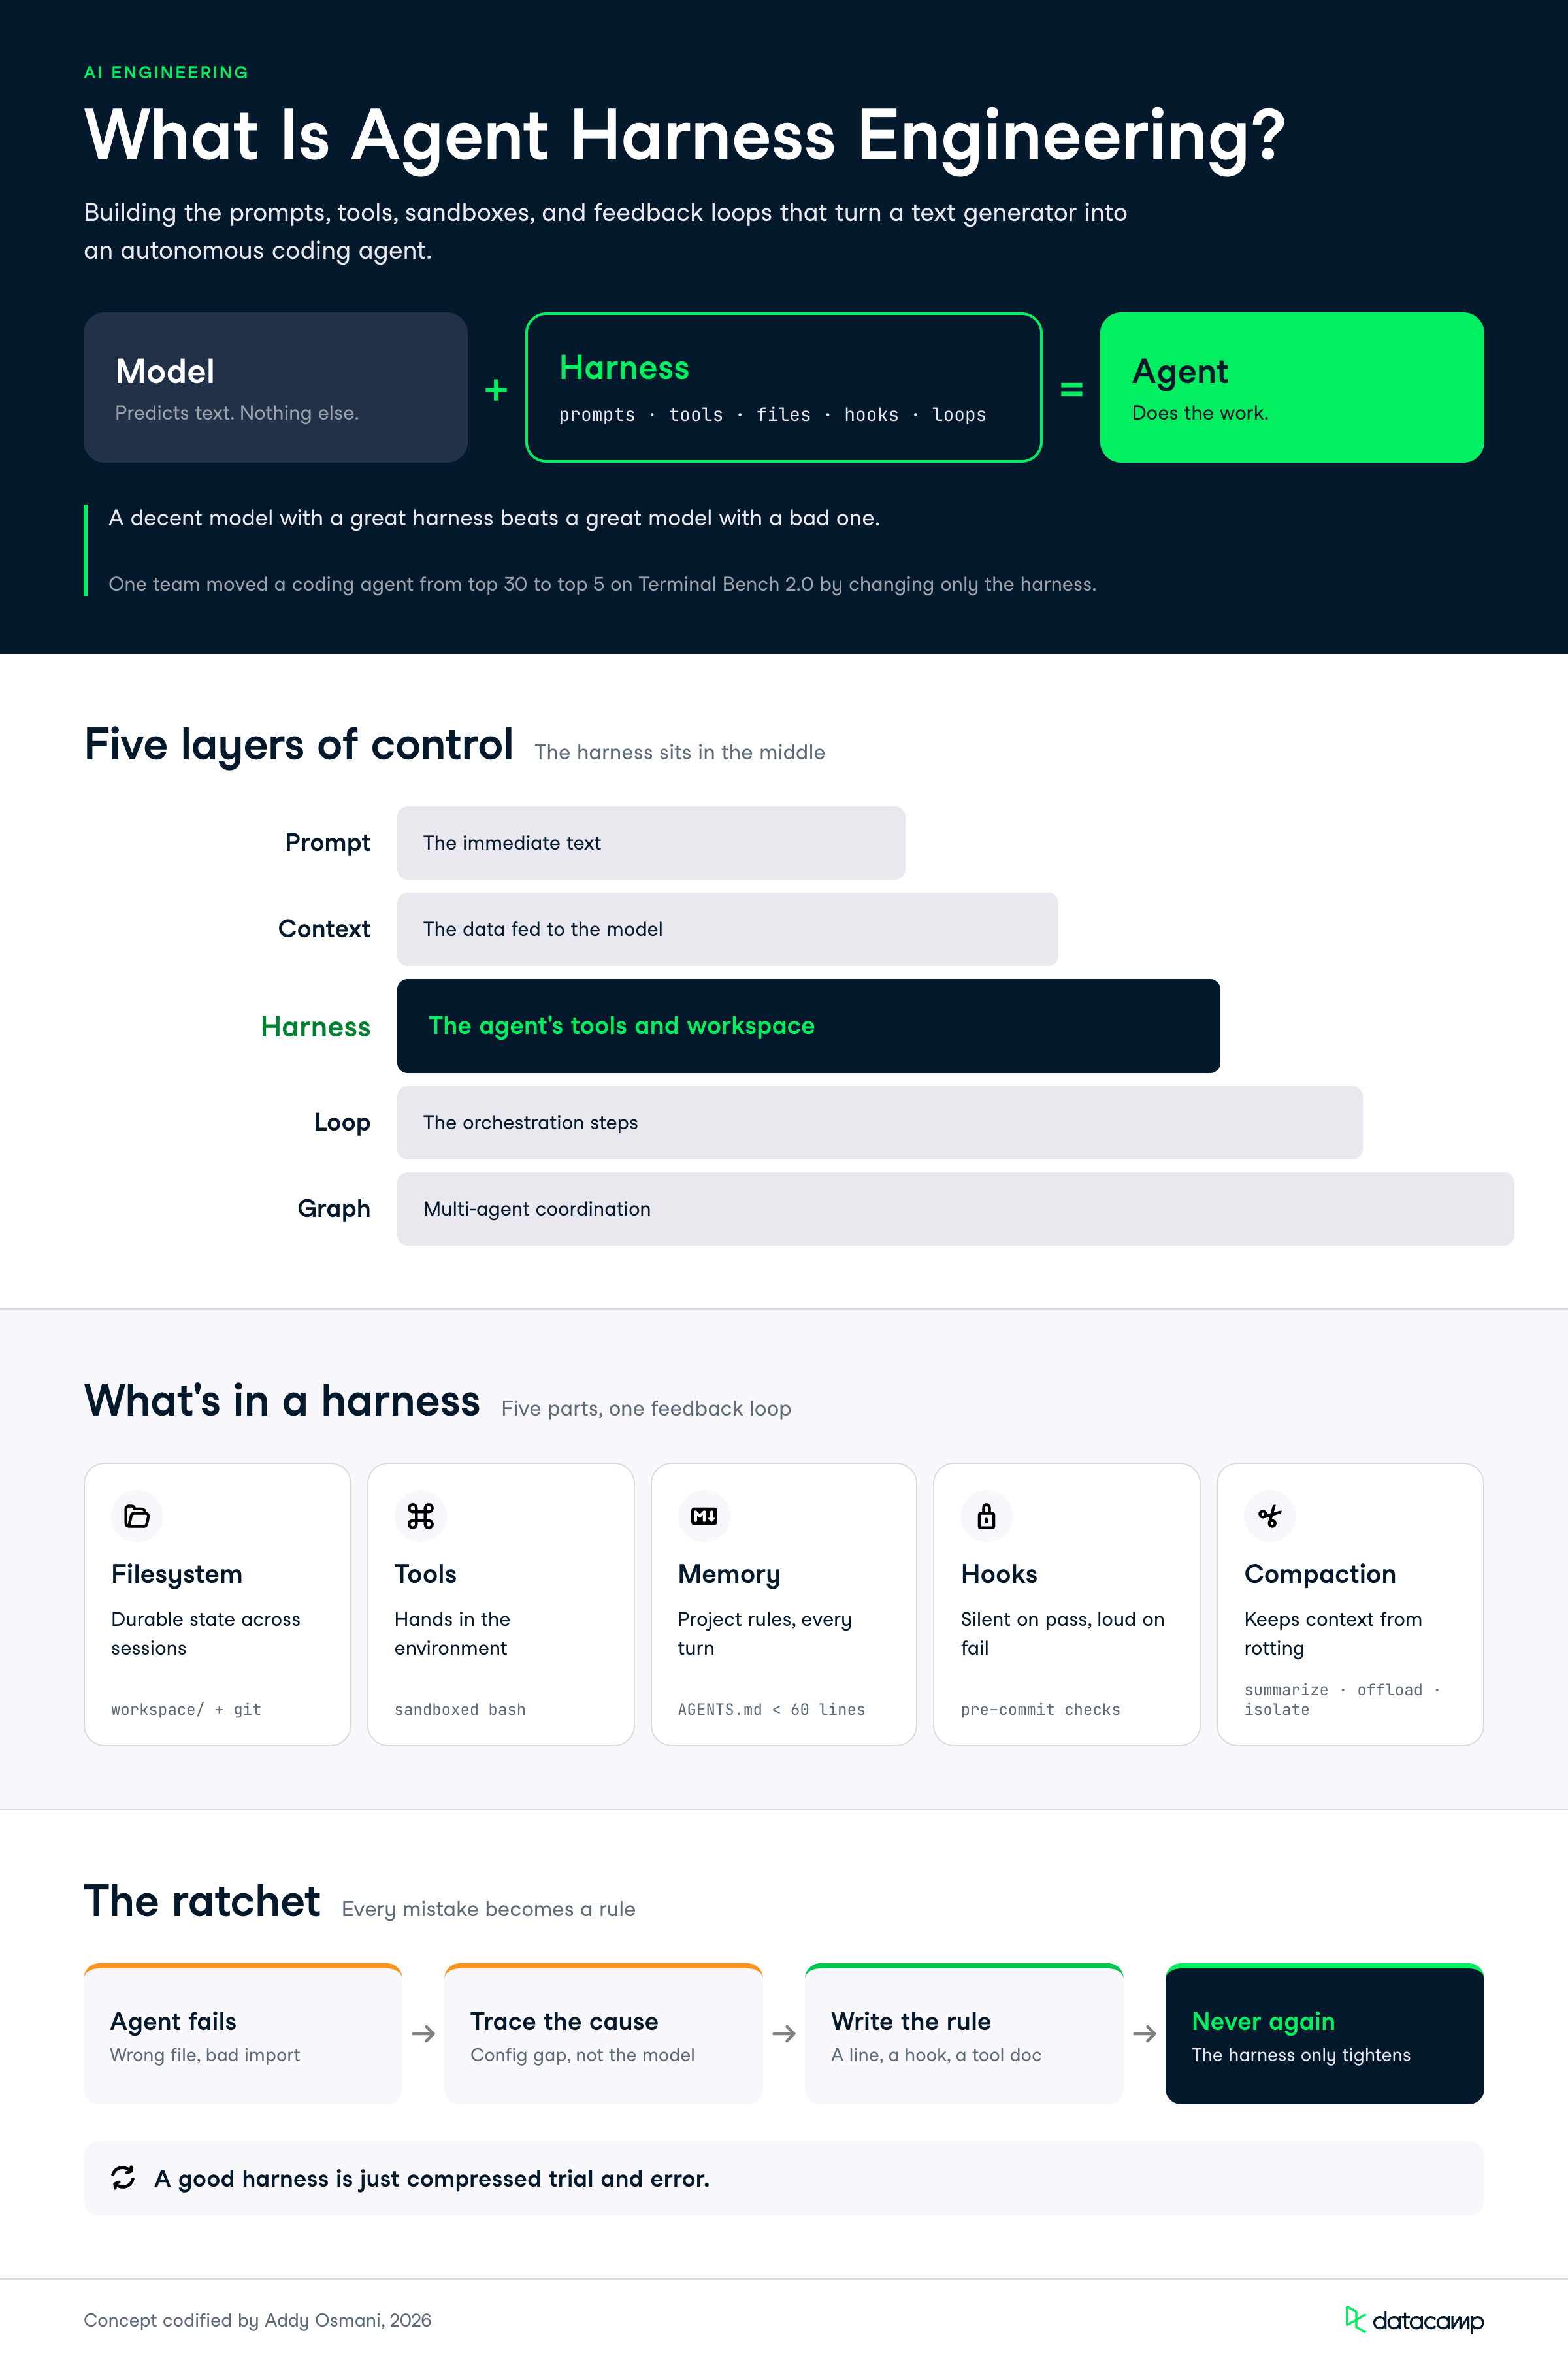
On peut décomposer le développement IA en couches de contrôle distinctes.
Le harness engineering se situe en plein milieu de cette hiérarchie.
|
Couche |
Ce qu’elle contrôle |
Action exemple |
|
Prompt engineering |
Le texte immédiat |
Ajuster les consignes |
|
Context engineering |
Les données fournies au modèle |
Ajuster un pipeline RAG |
|
Harness engineering |
Les outils matériels de l’agent |
Ajouter un outil Bash |
|
Loop engineering |
Les étapes d’orchestration |
Modifier le flux ReAct |
|
Graph engineering |
La coordination multi‑agents |
Construire des nœuds de routage |
pandas ou lit un CSV local. L’état d’esprit clé de l’agent harness engineering, c’est l’effet cliquet.
Quand un agent commet une erreur, vous concevez un correctif pour qu’elle ne se reproduise jamais. Un bon harnais, c’est de l’essai‑erreur compressé.
Au lieu de laisser l’agent répéter ses erreurs, vous ajoutez une ligne à votre AGENTS.md, écrivez un nouveau hook, ou précisez la description d’un outil.
Vous ne sautez pas instinctivement sur un nouveau modèle ; vous construisez plutôt un corpus qui vous permet de tracer les échecs précis et la façon dont vous vous en êtes prémuni.
Les composants essentiels d’un harnais d’agent IA sont le système de fichiers, les outils, la mémoire, les hooks et les mécanismes de gestion du contexte qui permettent au modèle d’opérer.
Ces éléments transforment des appels d’API isolés en boucle de rétroaction continue. Avant de coder, je vous donne une carte claire.
|
Composant |
Rôle |
Implémentation Python |
|
Système de fichiers |
État persistant |
Dossier local workspace/ |
|
Outils |
Agir sur l’environnement |
Fonctions Python pour Bash |
|
Mémoire |
Contexte projet |
Un fichier AGENTS.md |
|
Hooks |
Contrôle/garanties |
Scripts de validation pré‑commit |
|
Compactage |
Gestion du contexte |
Logique de synthèse |
Un modèle ne peut traiter que l’information qui tient dans sa fenêtre de contexte. Un système de fichiers offre un espace de travail stable pour lire des données, écrire des résultats intermédiaires et se coordonner entre sessions.
Ajouter Git apporte un filet de sécurité indispensable. L’agent peut suivre sa progression, créer des branches pour expérimenter différents hyperparamètres, et revenir en arrière automatiquement en cas de code cassé.
La boucle ReAct alterne raisonnement, action via un appel d’outil, et observation du résultat. Les descriptions d’outils sont l’interface directe entre le modèle et l’environnement. Des descriptions vagues produisent des comportements vagues.
Bash est un excellent outil polyvalent. Plutôt que de pré‑construire une fonction Python spécifique pour chaque action possible, Bash permet à l’agent de construire à la volée les commandes exactes dont il a besoin. Il faut toutefois le placer en sandbox avec soin pour éviter tout dommage système.
AGENTS.md et injection de connaissancesVotre agent a besoin d’une mémoire spécifique au projet pour comprendre les conventions locales. Un fichier AGENTS.md est un document markdown plat à la racine du dépôt, injecté dans le prompt système à chaque tour. Il définit votre stack, vos règles de formatage et les actions interdites.
Gardez ce fichier sous 60 lignes. Traitez‑le comme la checklist d’un pilote, pas comme un guide de style exhaustif. Vous pouvez lire un tutoriel complet AGENTS.md pour des exemples avancés. Considérez aussi les outils Model Context Protocol (MCP) pour des connaissances postérieures au cutoff.
Les hooks sont de petits scripts exécutés à des moments précis du cycle de vie.
Vous pouvez exécuter un hook avant un appel d’outil, après l’édition d’un fichier, ou avant un commit Git. Consultez ce guide sur les Claude Code Hooks pour des modèles avancés.
Le principe de conception principal : en cas de succès, silence ; en cas d’échec, verbosité. Un typecheck qui passe ne produit aucune sortie.
Un échec réinjecte le message d’erreur exact dans la boucle de l’agent pour autocorrection.
La « pourriture » du contexte survient lorsque l’obéissance aux consignes se dégrade à mesure que la fenêtre de contexte se remplit d’un historique trop long. Un bon échafaudage d’agent IA doit gérer cela activement. Lisez‑en plus sur la fenêtre de contexte pour comprendre ces limites.
Vous pouvez réduire le contexte en résumant les anciens messages. Vous pouvez déporter sur disque les sorties volumineuses des outils et ne garder qu’une courte référence dans le prompt.
Enfin, vous pouvez isoler les sous‑tâches gourmandes en tokens dans un sous‑agent doté d’un contexte neuf.
Construire un harnais d’agent IA, c’est écrire le code d’orchestration Python qui relie la boucle ReAct, les outils et les hooks.
Avant de coder, clarifiez la relation : harness.py est l’agent, et vous le lancez vous‑même via python harness.py comme n’importe quel script.
Le modèle est une API distante qui ne voit jamais ce fichier ; il ne reçoit que le prompt système, l’historique des messages et les schémas d’outils que votre script lui envoie.
Chaque extrait de cette section est une partie d’un seul fichier, harness.py, et les 4 premières sections le construisent de haut en bas. Les 2 dernières (hooks et compactage) l’améliorent ; comme la boucle s’exécute dès que Python y arrive, leurs définitions doivent se situer au‑dessus de la boucle ; chaque section indique exactement où placer son code.
Pour construire cela, vous avez besoin d’un compte développeur chez votre fournisseur choisi. Les abonnements grand public (comme ChatGPT Plus ou Claude Pro) ne donnent pas accès à l’API.
ANTHROPIC_API_KEY (ou OPENAI_API_KEY).Dans cet exemple, nous utiliserons Anthropic ; installez donc le paquet Python Anthropic avec pip install anthropic.
Ensuite, créez le squelette du projet. Le nommage initial compte : notre boucle lira AGENTS.md au démarrage, il doit donc exister avant la première exécution.
agent-harness/
├── AGENTS.md        # Project memory (we write this first)
├── harness.py       # The ReAct loop, tools, and hooks
└── workspace/       # The only directory the agent may touch
Le dossier workspace/ est le bac à sable de l’agent. Tout ce que l’agent lit, écrit ou exécute se passe dedans, jamais à la racine de votre projet.
Nous écrivons AGENTS.md avant la boucle, car la boucle en dépend.
Créez le fichier à la racine du projet et incluez les détails de votre stack et vos frontières architecturales :
# Project Context
Stack: Python 3.11, Pytest
Workspace: All commands run inside the workspace/ directory.

# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
Notre boucle interprétera « le modèle a répondu sans demander d’outil » comme signal de fin de tâche, donc nous indiquons explicitement au modèle comment le signifier.
Les règles qui font référence à la mécanique de votre propre boucle sont la clé du harness engineering. Le fichier mémo et le code d’orchestration se conçoivent ensemble.
Démarrez maintenant harness.py en créant ce fichier, en définissant le prompt système et en préparant l’espace de travail :
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Project memory: AGENTS.md lands in the system prompt on every turn
system_prompt = Path("AGENTS.md").read_text()
Parce que le SDK envoie system_prompt à chaque appel d’API, les règles d’AGENTS.md sont réinjectées à chaque tour. Le modèle ne peut pas les « oublier » comme des consignes en milieu de conversation.
Nous définissons 2 outils : run_bash pour l’exécution générale et write_file pour créer des fichiers.
Le second peut sembler redondant (Bash peut écrire via heredoc), mais un write_file dédié nous donne un événement d’édition net sur lequel accrocher un hook post‑édition plus tard.
Les décisions de design d’un harnais reflètent toujours ce que vous souhaitez observer et faire respecter.
Les descriptions d’outils sont l’interface, et leur qualité conditionne directement le comportement de l’agent :
En poursuivant dans notre fichier harness.py, définissons maintenant les schémas d’outils à la ligne suivante :
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
Le bloc suivant définit les fonctions Python qui exécutent réellement ces commandes.
Notez les dispositifs de sécurité intégrés : un timeout dur pour éviter qu’une commande bloquée ne fige le harnais, le code de sortie dans chaque résultat pour distinguer succès et échec, et un contrôle de chemin pour empêcher write_file() de sortir du bac à sable.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
Le fallback or '(no output)' n’est pas cosmétique.
Une commande comme touch data.csv réussit en silence ; renvoyer une chaîne vide ne donne rien à observer au modèle.
Donnez toujours un signal explicite à l’agent, même pour le silence.
Le cœur de notre harnais est une boucle for Python standard avec un plafond d’itérations.
À chaque passage, on appelle l’API, on vérifie si le modèle demande un outil, on exécute chaque outil demandé, puis on réinjecte les résultats dans un seul message.
Ce bloc se place en bas de harness.py, puisqu’il commence à s’exécuter dès que Python l’atteint.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Deux détails de cette boucle évitent des plantages réels.
D’abord, un seul tour du modèle peut contenir plusieurs appels d’outils, et l’API Anthropic exige que tous leurs résultats reviennent dans un seul message utilisateur.
Ensuite, la construction for/else signale lorsque l’agent atteint le plafond d’itérations, de sorte qu’une exécution bloquée échoue bruyamment au lieu de s’arrêter en silence.
Cette structure explicite vous montre où le modèle s’arrête de « penser », où Python prend la main pour exécuter la commande, et comment la sortie revient dans la boucle.
Les hooks interceptent les erreurs avant qu’elles ne se transforment en problèmes structurels.
Dans notre harnais, un hook est une fonction qui inspecte un appel d’outil terminé et renvoie du texte additionnel à ajouter au résultat de l’outil.
En cas de succès, la fonction ne renvoie rien ; en cas d’échec, elle renvoie un rapport détaillé.
Ajoutez cette fonction dans harness.py au‑dessus de la boucle ReAct, à côté des exécuteurs d’outils. La boucle s’exécute dès que Python l’atteint ; tout ce qu’elle appelle doit donc déjà être défini.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
L’intégrer à la boucle se fait en une ligne dans le bloc d’exécution d’outil :
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Sans le hook, l’agent écrit un fichier cassé, voit Wrote 412 characters to fizzbuzz.py, et poursuit en toute confiance.
Avec le hook, le même résultat d’outil contient la trace pytest exacte. À l’itération suivante, l’agent lit l’erreur et corrige le bug tout seul, sans prompt additionnel.
Pour lutter contre la pourriture du contexte, surveillez la longueur de votre liste messages et résumez les tours les plus anciens quand elle devient trop longue.
Un piège : vous ne pouvez pas couper l’historique à un point arbitraire, car un bloc tool_use de l’assistant et son tool_result associé doivent rester ensemble. Scinder une paire provoque une erreur d’API immédiate.
Notre fonction de compactage avance le point de coupe jusqu’à tomber sur une frontière sûre. Construisez‑la au‑dessus de harness.py :
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Ajoutez une ligne en haut de la boucle ReAct, avant l’appel d’API :
messages = compact(messages)Nous utilisons un modèle plus petit et moins coûteux pour la synthèse, car le compactage s’exécute souvent et doit rester rapide.
Nous conservons également la tâche initiale textuellement, plutôt que de nous fier à la synthèse pour la préserver.
Le harnais est maintenant complet.
Avant de poursuivre, vérifiez que votre harness.py se lit dans cet ordre, de haut en bas :
client, WORKSPACE et system_promptTOOLSrun_bash(), write_file() et TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() et compact()Pour vous donner une idée de la boucle finale de l’API après l’ajout des sections hook et compactage, voici la boucle complète :
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Lancez maintenant l’agent depuis la racine du projet : python harness.py.
Le script envoie la tâche de la liste messages à l’API.
Le harnais fait le travail et vous devriez voir chaque itération s’imprimer dans votre terminal :
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
Le programme se termine quand le modèle répond sans appel d’outil, ou quand le plafond de 15 itérations est atteint.
Pour donner une autre tâche à l’agent, modifiez la chaîne content dans la liste messages initiale ; un harnais de production la lirait plutôt depuis input() ou un argument de ligne de commande.
Le cliquet, c’est le processus continu qui consiste à diagnostiquer les échecs de l’agent et à mettre à jour votre harnais pour les empêcher.
Un harnais s’améliore strictement au contact des cas limites réels.
Parcourons un cycle complet échec/correctif basé sur un vrai projet d’optimisation d’itinéraires.
Imaginez que votre agent continue d’importer une bibliothèque interne obsolète appelée legacy_route_math au lieu de la version à jour.
L’agent écrit le script, les tests échouent, et il boucle à tenter de corriger la syntaxe plutôt que de changer de bibliothèque.
Le diagnostic est simple.
L’agent ne sait pas que la bibliothèque est obsolète. C’est une règle manquante, pas une défaillance du réseau de neurones sous‑jacent.
Correctif 1 au niveau mémoire : ajoutez cette règle à AGENTS.md :
# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
4. Do not import legacy_route_math; it is deprecated. Use routes_v2 instead.
Correctif 2 : ajoutez un hook d’application permanent.
Les règles conseillent l’agent, les hooks commandent. Ce correctif tient en quelques lignes et peut être ajouté près de post_edit_hook(), tant qu’il se trouve avant la boucle ReAct.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Enregistrez‑le à côté du hook pytest dans le bloc d’exécution des outils :
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
Voici à quoi ressemble l’autocorrection dans la transcription après application des deux correctifs.
L’agent écrit le fichier, le hook se déclenche, et dès le tour suivant, l’import est corrigé sans intervention humaine :
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
C’est important car cela se rattache à la pourriture du contexte. Des sessions très longues, avec un contexte dégradé, finissent par ignorer des règles mémoires.
La règle dans AGENTS.md évite l’erreur la plupart du temps, et le hook garantit que, quand la règle glisse, l’erreur ne cause aucun dégât.
Chaque échec diagnostiqué doit vous faire poser 2 questions : quelle règle manquait, et quel contrôle l’aurait quand même intercepté ?
Les bonnes pratiques se concentrent sur des configurations légères et une conception adaptée aux futures mises à niveau des modèles.
L’objectif est de bâtir un échafaudage qui soutient le modèle sans l’encombrer.
J’ai tiré quelques leçons parfois coûteuses en construisant diverses compétences d’agent et architectures.
Visez un maximum de 60 lignes pour votre fichier de contexte.
Chaque règle doit découler d’un échec réel et documenté. Si vous ne vous souvenez pas de l’incident à l’origine de la règle, elle mérite d’être supprimée.
Cette discipline est essentielle car AGENTS.md est « payé » à chaque tour.
Un guide de 300 lignes vous coûte des tokens à chaque appel et dilue les règles essentielles, les modèles suivant bien mieux 10 règles nettes que 80 vagues.
Ajouter une date peut même aider pour la pratique suivante que je recommande.
Les harnais doivent être régulièrement réarchitecturés à mesure que les modèles de base gagnent en capacités natives.
Concevez vos composants pour pouvoir les retirer facilement.
Le motif de hook de ce tutoriel est volontairement modulaire pour cette raison.
Chaque hook est une fonction séparée ajoutée via une seule ligne. Si vous dépréciez le hook, vous supprimez une ligne dans la boucle.
Rien d’autre ne change dans la boucle.
Comparez cela à une validation entremêlée à votre boucle ReAct, où retirer un contrôle obsolète impose de retester tout le chemin d’orchestration.
Ce qui semble indispensable aujourd’hui deviendra une charge inutile le trimestre prochain.
À chaque nouveau modèle, relancez vos anciens cas d’échec en désactivant chaque hook un à un, et considérez tout hook qui ne détecte plus rien comme candidat à la suppression.
Consultez les meilleures pratiques Claude Code pour d’autres conseils d’architecture.
Une boucle ReAct nue avec un système de fichiers et un seul outil Bash est déjà très utile.
Résistez à la tentation de construire d’emblée un graphe complexe avec des frameworks lourds. Le cliquet ne fonctionne que dans un sens : de l’échec observé au correctif ciblé. Les correctifs spéculatifs l’inversent.
Ajoutez des hooks personnalisés seulement après avoir vu l’échec exact qui les justifie. Pour structurer des systèmes de base, consultez ce guide sur les agents LLM.
Vous ne pouvez pas actionner le cliquet sur ce que vous ne voyez pas.
Notre boucle affiche déjà chaque appel d’outil ; c’est l’observabilité minimale viable : quand une exécution échoue, la transcription imprimée sert de matière au diagnostic.
À mesure que votre harnais mûrit, écrivez l’historique complet des messages de chaque session dans un fichier JSON horodaté en fin d’exécution.
Les transcriptions échouées deviennent votre suite de régression ; après chaque changement de harnais, rejouez les anciennes tâches en échec et confirmez que le correctif tient.
C’est l’équivalent, pour un ingénieur harnais, d’une suite de tests ; cela distingue un harnais qui s’améliore d’un harnais qui ne fait que changer.
L’agent harness engineering est la réalité pratique qui permet aux modèles d’IA de produire un travail utile.
L’écart entre ce que les modèles actuels peuvent théoriquement faire et ce que vous observez réellement en production est largement un écart de harnais.
Cette discipline ne consiste pas à apprendre un framework spécifique.
Le bon harnais d’agent IA pour votre base de code est façonné entièrement par votre historique d’échecs unique, construit progressivement via la méthode du cliquet.
Prêt à mettre ces concepts en pratique ?
Découvrez le parcours de compétences AI Agent Fundamentals de DataCamp pour continuer à construire des systèmes prêts pour la production. Vous pouvez aussi explorer le tutoriel Claude Agent SDK pour davantage d’exemples de code concrets.
Vous pouvez également consulter le parcours de compétences AI for Software Engineering.
Meilleurs cours DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Aditya Sharma
5 min
Tutoriel
Sejal Jaiswal
24 min




