Curso
Desenvolvimento de aplicativos de LLM com LangChain
3 h
51.8K
Pratique e programa seu progresso.
Continuar Com O GoogleImagine rodar exatamente o mesmo modelo de linguagem grande (LLM) duas vezes, mas dar a cada execução dois harnesses completamente diferentes. Uma termina uma refatoração complexa com tranquilidade. A outra trava e falha por completo. O modelo não mudou, mas a estrutura em volta dele, sim.
Em poucas palavras, agent harness engineering é a prática de construir a lógica, o acesso ao filesystem, a memória e as regras ao redor de um LLM para que ele aja com confiabilidade.
Neste tutorial de agent harness engineering, vou te mostrar como montar um setup minimalista em Python com um loop Reason and Act (ReAct), ferramentas e hooks. Você precisa de Python 3, pip instalado na sua máquina e familiaridade básica com chamadas de API para LLMs.
Agent harness engineering é a prática de construir a infraestrutura, as configurações e a lógica de execução que envolvem um modelo de linguagem grande, levando-o de um gerador de texto estático (LLM) a um agente de IA autônomo
Agent harness engineering é a configuração estrutural que transforma um gerador de texto estático em um trabalhador autônomo.
A equação central é simples: agente = modelo + harness. O harness inclui prompts de sistema, definições de ferramentas, workspaces no filesystem, lógica de orquestração e hooks de observabilidade.
Addy Osmani consolidou esse conceito no artigo da O'Reilly de abril de 2026 sobre fluxos de trabalho em IA. Ele definiu o harness como todo código, configuração e lógica de execução que não é o modelo em si: a sua superfície de atuação como desenvolvedor, distinta da API do provedor.
Quando comecei a construir fluxos de machine learning, eu culpava o modelo toda vez que um agente alucinava uma dependência do Python. Aprendi na prática que a maioria das falhas é problema de configuração.
A mesma versão de um modelo com um harness melhor supera a si mesma de forma mensurável quando usa um harness ruim.
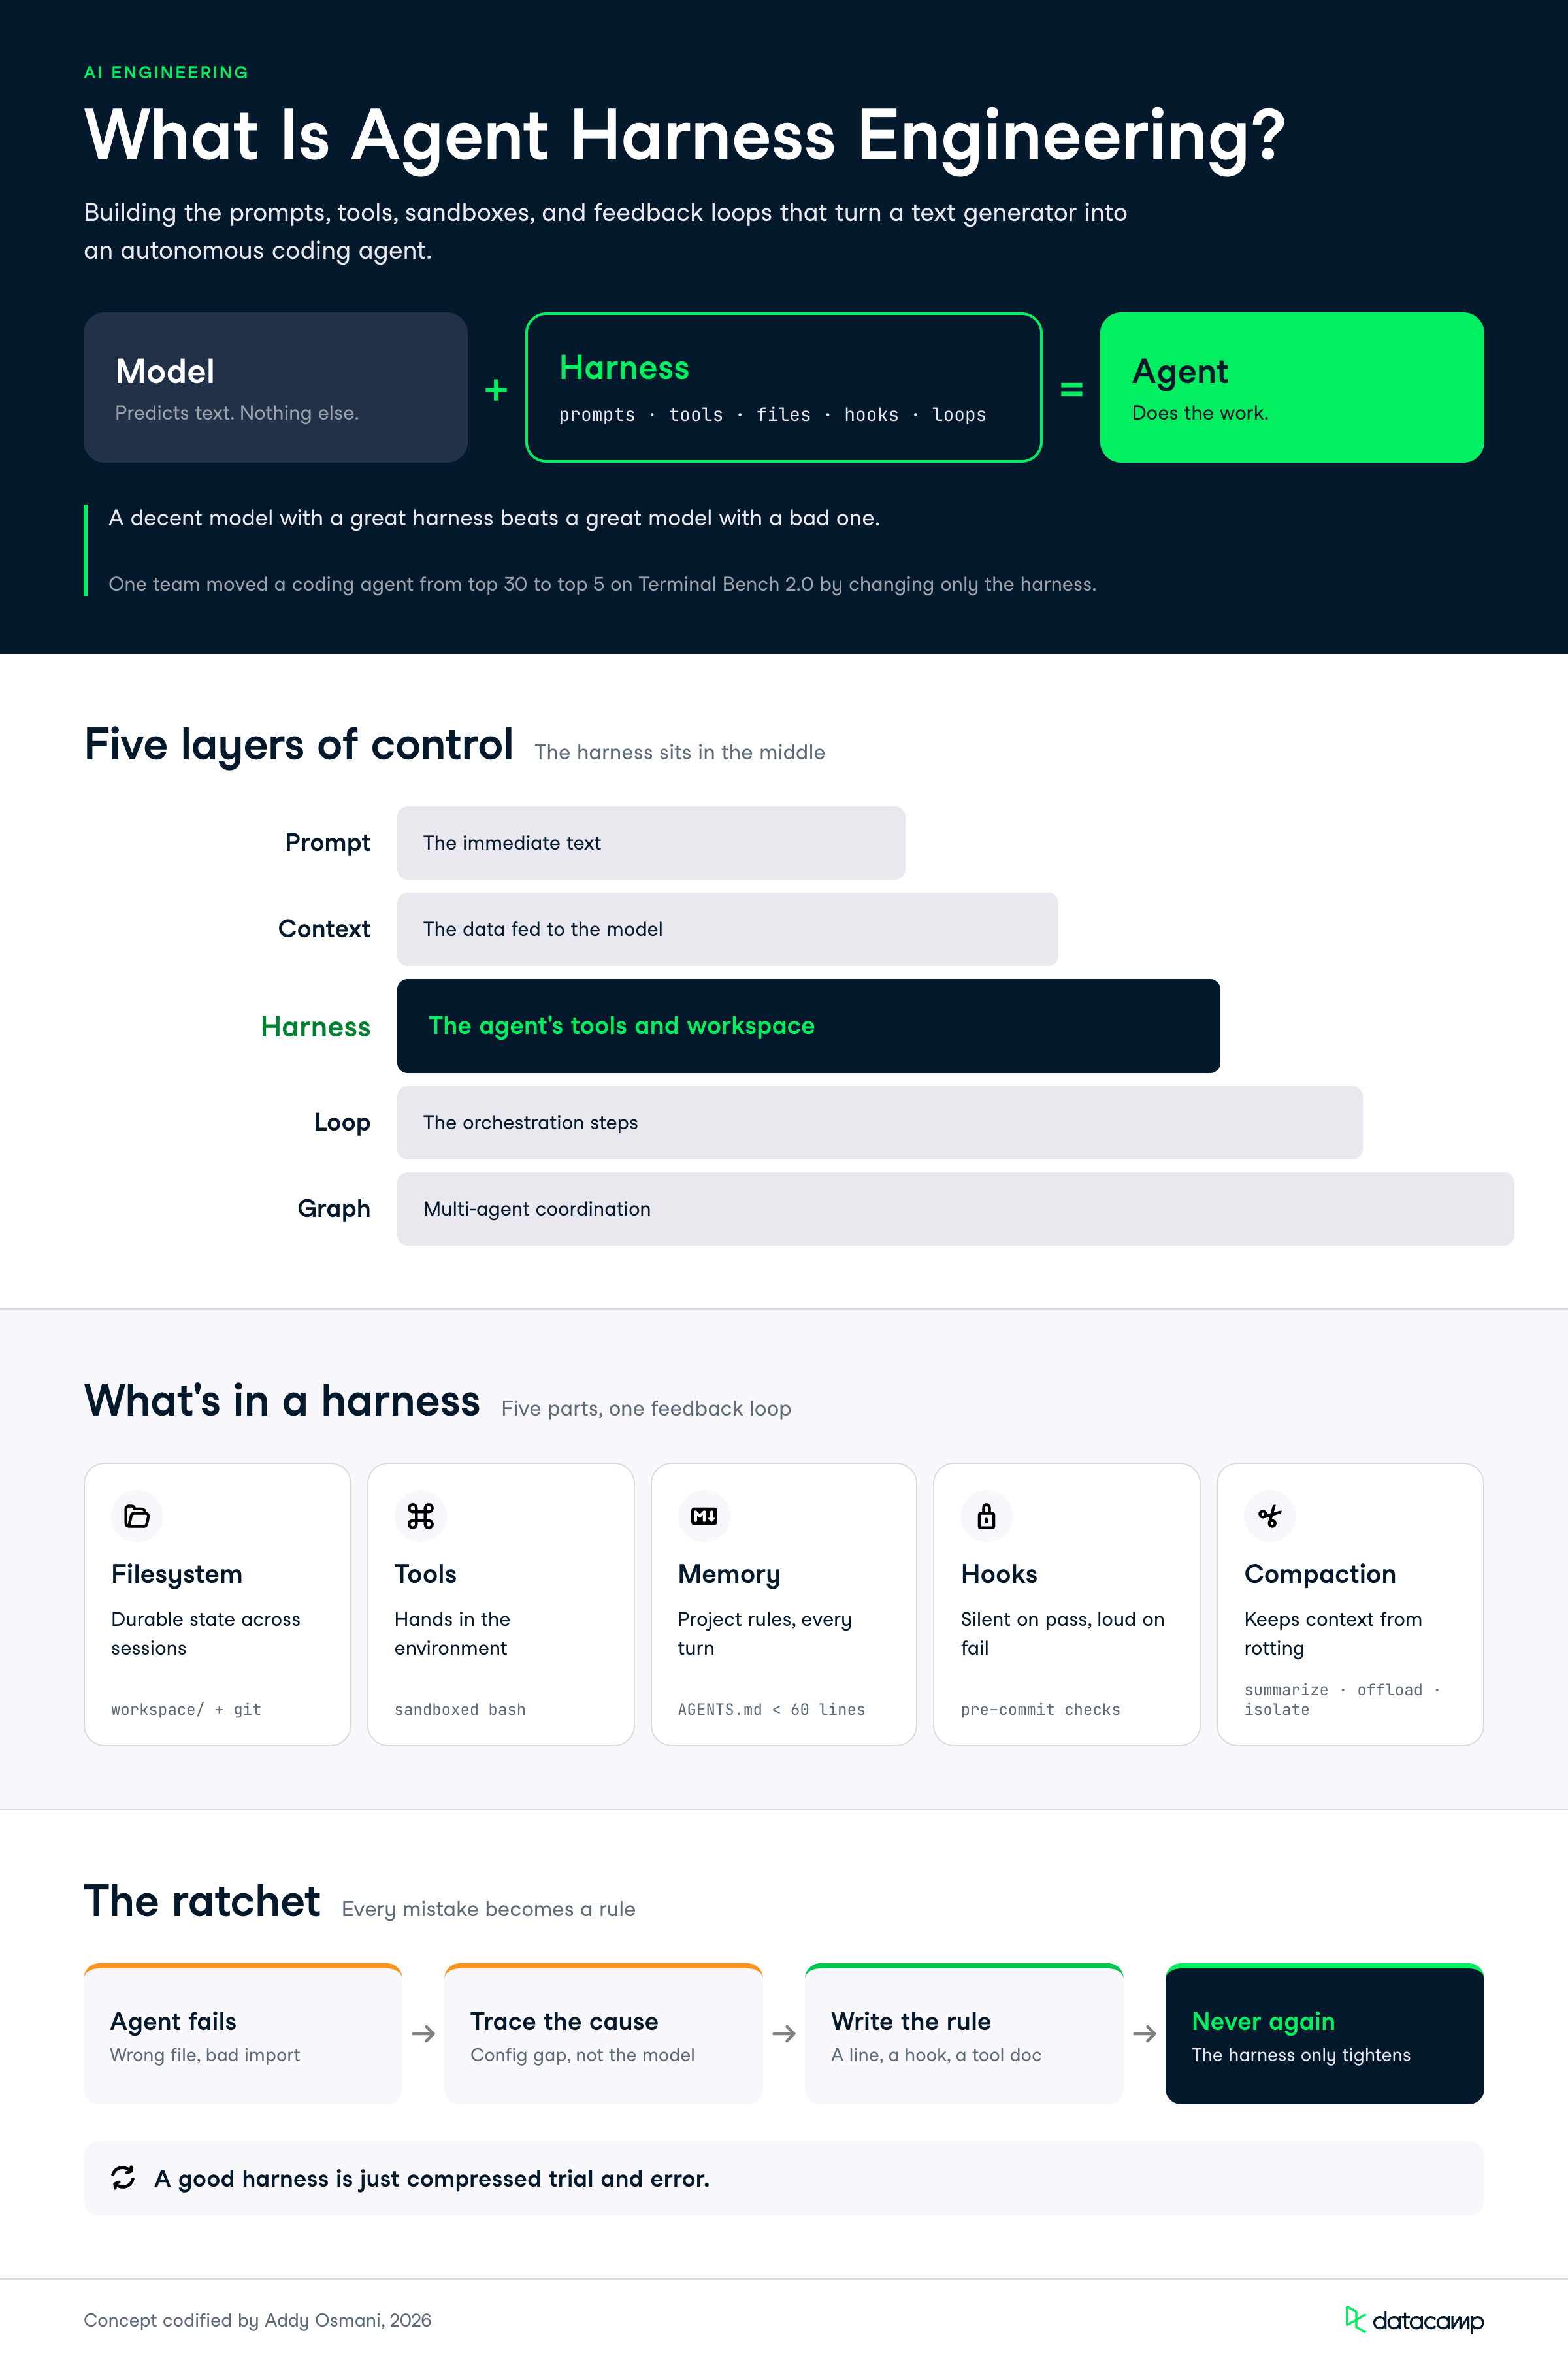
Podemos decompor o desenvolvimento de IA em camadas distintas de controle.
Harness engineering fica bem no meio dessa hierarquia.
|
Camada |
O que controla |
Ação de exemplo |
|
Prompt engineering |
O texto imediato |
Ajustar instruções |
|
Context engineering |
Os dados enviados ao modelo |
Ajuste de pipeline RAG |
|
Harness engineering |
As ferramentas físicas do agente |
Adicionar uma ferramenta Bash |
|
Loop engineering |
Os passos de orquestração |
Alterar o fluxo ReAct |
|
Graph engineering |
Coordenação multiagente |
Construir nós de roteamento |
pandas ou lê um CSV local. A mentalidade que define agent harness engineering é o efeito catraca.
Quando o agente erra, você cria uma correção para nunca mais repetir aquele erro. Um bom harness é tentativa e erro comprimidos.
Em vez de deixar o agente repetir falhas, você adiciona uma linha ao seu AGENTS.md, escreve um novo hook ou deixa a descrição de uma ferramenta mais rigorosa.
Você não corre para trocar de modelo por instinto; em vez disso, constrói um corpus que permite rastrear falhas específicas e como você blindou o sistema contra elas.
Os componentes centrais de um agent harness de IA são o filesystem, as ferramentas, a memória, os hooks e os sistemas de gestão de contexto que permitem o funcionamento do modelo.
Essas partes trabalham juntas para transformar chamadas isoladas de API em um loop contínuo de feedback. Quero te dar um mapa claro antes de começarmos a escrever código.
|
Componente |
Função |
Implementação em Python |
|
Filesystem |
Estado durável |
Diretório local de workspace |
|
Ferramentas |
Ação no ambiente |
Funções Python para Bash |
|
Memória |
Contexto do projeto |
Um arquivo AGENTS.md |
|
Hooks |
Aplicação de regras |
Scripts de validação pré-commit |
|
Compactação |
Gestão de contexto |
Lógica de sumarização |
Um modelo só consegue processar informações dentro da sua janela de contexto limitada. Um filesystem oferece um workspace estável para ler dados, escrever resultados intermediários e coordenar sessões.
Adicionar controle de versão com Git cria uma rede de segurança necessária. O agente acompanha o progresso, cria branches para experimentar hiperparâmetros diferentes e faz rollback automático de código quebrado.
O loop ReAct opera em um ciclo de raciocinar, agir via chamada de ferramenta e observar o resultado. As descrições das ferramentas formam a interface direta entre o modelo e o ambiente. Descrições vagas geram comportamentos vagos.
Bash é uma ótima ferramenta genérica. Em vez de pré-construir uma função Python para cada ação possível, o Bash permite que o agente monte os comandos exatos de que precisa em tempo real. É essencial isolar esses comandos com cuidado para evitar danos ao sistema.
AGENTS.md e injeção de conhecimentoSeu agente precisa de memória específica do projeto para entender convenções locais. Um arquivo AGENTS.md é um documento markdown plano na raiz do repositório que entra no prompt de sistema a cada turno. Ele define sua stack, regras de formatação e ações proibidas.
Mantenha esse arquivo com menos de 60 linhas. Trate-o como a checklist de um piloto, não como um guia de estilo completo. Você pode ler um tutorial completo de AGENTS.md para exemplos mais avançados. Também vale considerar ferramentas do Model Context Protocol (MCP) para conhecimento pós-cutoff.
Hooks são pequenos scripts que rodam em momentos específicos do ciclo de vida.
Você pode rodar um hook antes de uma chamada de ferramenta, depois de editar um arquivo ou antes de um commit no Git. Confira este guia sobre Claude Code Hooks para padrões avançados.
O princípio de design principal dos hooks é: sucesso é silencioso e falhas são verbosas. Um typecheck aprovado não produz saída nenhuma.
Uma falha injeta o erro exato de volta no loop do agente para autocorreção.
A "apodrecimento" do contexto ocorre quando a obediência às instruções degrada à medida que a janela de contexto enche com históricos longos. Uma boa estrutura de agente de IA precisa gerenciar isso ativamente. Leia mais sobre a janela de contexto para entender esses limites.
Você pode reduzir o contexto resumindo mensagens antigas. Pode descarregar saídas grandes de ferramentas para o disco e manter só uma referência curta no prompt.
Por fim, você pode isolar subtarefas que consomem muitos tokens em um subagente com contexto novo.
Construir um agent harness de IA envolve escrever o código de orquestração em Python que conecta o loop ReAct, as ferramentas e os hooks.
Entenda a relação antes de escrever qualquer código: harness.py é o agente, e você mesmo o inicia com python harness.py como qualquer outro script.
O modelo é uma API remota que nunca vê esse arquivo; ele só recebe o prompt de sistema, o histórico de mensagens e os esquemas de ferramentas que seu script envia.
Cada trecho desta seção é parte de um único arquivo, o harness.py, e as 4 primeiras partes o constroem de cima para baixo. As 2 últimas (hooks e compactação) o aprimoram e, como o loop executa assim que o Python o alcança, as definições dessas funções devem ficar acima do loop; cada seção indica exatamente onde seu código entra.
Para construir isso, você precisa de uma conta de desenvolvedor no provedor escolhido. Assinaturas de consumo padrão (como ChatGPT Plus ou Claude Pro) não concedem acesso à API.
ANTHROPIC_API_KEY (ou OPENAI_API_KEY).Neste exemplo, usaremos a Anthropic, então instale o pacote Anthropic para Python com pip install anthropic.
Em seguida, crie o esqueleto do projeto. Nomear os arquivos desde o início importa: nosso loop lerá o AGENTS.md na inicialização, então esse arquivo precisa existir antes de o loop rodar.
agent-harness/
├── AGENTS.md        # Memória do projeto (escrevemos este primeiro)
├── harness.py       # O loop ReAct, ferramentas e hooks
└── workspace/       # O único diretório que o agente pode tocar
O diretório workspace/ é a sandbox do agente. Tudo que o agente lê, escreve ou executa acontece ali dentro, nunca na raiz do projeto.
Escrevemos o AGENTS.md antes do loop porque o loop depende dele.
Crie o arquivo na raiz do projeto e inclua detalhes da sua stack e limites arquiteturais:
# Contexto do projeto
Stack: Python 3.11, Pytest
Workspace: todos os comandos rodam dentro do diretório workspace/.

# Regras
1. Nunca use rm -rf. Use rm padrão com nomes de arquivos específicos.
2. Nunca escreva testes dentro do arquivo principal da aplicação.
3. Quando terminar a tarefa, responda com um resumo em texto simples e sem chamar ferramentas.
Nosso loop tratará "o modelo respondeu sem pedir uma ferramenta" como o sinal de conclusão da tarefa, então dizemos explicitamente ao modelo como sinalizar que terminou.
Regras que fazem referência à sua própria mecânica de loop são a chave do harness engineering. O arquivo de memória e o código de orquestração são projetados juntos.
Agora comece o harness.py criando esse arquivo como o prompt de sistema e preparando o workspace:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Memória do projeto: AGENTS.md vai no prompt de sistema a cada turno
system_prompt = Path("AGENTS.md").read_text()
Como o SDK envia o system_prompt em cada chamada de API, as regras do AGENTS.md são reinjetadas a cada turno. O modelo não pode "esquecer" delas como esquece instruções em conversas longas.
Definimos 2 ferramentas: run_bash para execução geral e write_file para criar arquivos.
A segunda pode parecer redundante, já que o Bash escreve arquivos com heredocs, mas um write_file dedicado nos dá um evento de edição limpo para o qual nosso hook pós-edição pode reagir depois.
Decisões de design do harness sempre giram em torno do que você quer observar e aplicar.
As descrições das ferramentas são a interface, e a qualidade delas controla diretamente o comportamento do agente:
Continuando no arquivo harness.py, agora podemos definir os esquemas das ferramentas na linha seguinte:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Execute um comando bash dentro do diretório workspace/ e retorne "
            "seu stdout, stderr e código de saída. Use para listar arquivos, "
            "rodar scripts e executar testes. Não use para criar arquivos Python; "
            "use write_file."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "O comando bash a executar."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Crie ou sobrescreva um arquivo dentro do diretório workspace/. "
            "Forneça um caminho relativo a workspace/ e o conteúdo completo do arquivo."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Caminho relativo a workspace/."},
                "content": {"type": "string", "description": "Conteúdo completo do arquivo."},
            },
            "required": ["path", "content"],
        },
    },
]
O próximo bloco define as funções Python que executam esses comandos.
Note os recursos de segurança embutidos: timeout rígido para que um comando travado não congele o harness, código de saída incluído em cada resultado para o agente distinguir sucesso de falha e checagem de caminho para o write_file() não sair da sandbox.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
O fallback or '(no output)' não é cosmético.
Um comando como touch data.csv tem sucesso silencioso, e retornar string vazia não dá nada para o modelo observar.
Sempre dê ao agente um sinal explícito, até para o silêncio.
O núcleo do nosso harness é um for padrão em Python, com limite de iterações.
Cada passada chama a API, verifica se o modelo pediu uma ferramenta, executa todas as ferramentas solicitadas e retroalimenta os resultados como uma única mensagem.
Este bloco fica no final do harness.py, já que começa a executar no momento em que o Python chega nele.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Dois detalhes neste loop evitam travamentos reais.
Primeiro, um único turno do modelo pode conter múltiplas chamadas de ferramentas, e a API da Anthropic exige que todos os resultados voltem em uma única mensagem do usuário.
Segundo, a construção for/else avisa quando o agente atinge o limite de iterações, então uma execução estagnada falha de forma barulhenta em vez de acabar no silêncio.
Essa estrutura explícita permite ver exatamente onde o modelo para de pensar, onde o Python assume para rodar o comando e como a saída volta para o loop.
Hooks capturam erros antes que se transformem em problemas estruturais maiores.
No nosso harness, um hook é uma função que inspeciona uma chamada de ferramenta concluída e retorna texto extra para anexar ao resultado da ferramenta.
Sucesso retorna string vazia; falha retorna um relatório verboso.
Adicione esta função ao harness.py acima do loop ReAct, ao lado dos executores de ferramentas. O loop começa a rodar assim que o Python o alcança, então tudo que ele chama já deve estar definido.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
Conectar ao loop é uma mudança de uma linha dentro do bloco de execução da ferramenta:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Sem o hook, o agente escreve um arquivo quebrado, lê Wrote 412 characters to fizzbuzz.py e segue confiante.
Com o hook, o mesmo resultado de ferramenta carrega o traceback exato do pytest. Na próxima iteração, o agente lê o erro e corrige o bug sozinho, sem prompt extra.
Para combater a degradação do contexto, monitore o tamanho da lista messages e resuma os turnos mais antigos quando ela crescer demais.
Há uma armadilha: você não pode cortar o histórico em qualquer ponto, porque um bloco tool_use do assistente e sua mensagem pareada tool_result precisam ficar juntos. Separar o par gera erro imediato na API.
Nossa função de compactação move o ponto de corte para frente até cair em um limite seguro. Construa isto acima do harness.py:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Adicione uma linha no topo do loop ReAct, antes da chamada de API:
messages = compact(messages)Usamos um modelo menor e mais barato para o resumo porque a compactação roda com frequência e precisa ser rápida.
Também mantemos a mensagem original da tarefa literalmente, em vez de confiar que o resumo a preserve.
O harness agora está completo.
Antes de seguir, verifique se seu harness.py está nesta ordem, de cima para baixo:
client, WORKSPACE e system_promptTOOLSrun_bash(), write_file() e TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() e compact()Para te dar uma noção de como o loop final da API deve ficar desde que adicionamos as seções de hook e compactação, aqui está o loop completo:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Agora rode o agente a partir da raiz do projeto com python harness.py.
O script envia a tarefa da lista messages para a API.
O harness faz o trabalho e você deve ver cada iteração impressa no terminal:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
O programa sai quando o modelo responde sem chamar ferramenta, ou quando atinge o limite de 15 iterações.
Para dar outra tarefa ao agente, altere a string content na lista inicial messages; um harness de produção leria isso de um input() ou argumento de linha de comando.
A catraca é o processo contínuo de diagnosticar falhas do agente e atualizar seu harness para evitá-las no futuro.
Um harness evolui estritamente com exposição a casos extremos do mundo real.
Vamos percorrer um ciclo completo de falha e correção baseado em um projeto real de otimização de rotas.
Imagine que seu agente continua importando uma biblioteca interna obsoleta chamada legacy_route_math em vez da versão atualizada.
O agente escreve o script, os testes falham e ele fica preso tentando corrigir sintaxe, em vez de trocar a biblioteca.
O diagnóstico aqui é direto.
O agente simplesmente não sabe que a biblioteca está obsoleta. Falta uma regra — não é falha da rede neural subjacente.
A correção 1 atualiza a camada de memória, adicionando esta regra ao AGENTS.md:
# Regras
1. Nunca use rm -rf. Use rm padrão com nomes de arquivos específicos.
2. Nunca escreva testes dentro do arquivo principal da aplicação.
3. Quando terminar a tarefa, responda com um resumo em texto simples e sem chamar ferramentas.
4. Não importe legacy_route_math; está obsoleta. Use routes_v2.
A correção 2 adiciona um hook de aplicação permanente.
Regras são conselhos ao agente; hooks são comandos. Esta correção tem poucas linhas e pode ser adicionada ao lado do post_edit_hook(), desde que venha antes do loop ReAct.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Registre-o ao lado do hook do pytest no bloco de execução da ferramenta:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
Veja como fica a autocorreção na transcrição após as duas correções entrarem.
O agente escreve o arquivo, o hook dispara e, no turno seguinte, corrige o import sem intervenção humana:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
Isso é importante porque se conecta de volta à degradação do contexto. Sessões muito longas com contexto degradado eventualmente ignoram regras de memória.
A regra no AGENTS.md evita o erro na maior parte do tempo, e o hook garante que, quando a regra escapar, o erro não cause danos.
Cada falha que você diagnosticar deve te fazer duas perguntas: qual regra faltou e que checagem a teria pego mesmo assim?
As melhores práticas de agent harness engineering focam em manter configurações enxutas e projetar para futuras atualizações de modelo.
O objetivo é construir uma estrutura que apoie o modelo sem sobrecarregá-lo.
Aprendi algumas lições difíceis construindo várias habilidades de agentes e arquiteturas.
Defina um máximo de 60 linhas para o seu arquivo de contexto.
Cada regra deve se conectar a uma falha real, documentada, que você viveu. Se você não consegue lembrar o incidente que originou a regra, vale a pena apagá-la.
Essa disciplina importa porque o AGENTS.md é pago a cada turno.
Um guia de 300 linhas te custa tokens em toda chamada de API e dilui as regras que importam, já que modelos seguem 10 regras afiadas muito melhor do que 80 vagas.
Adicionar um carimbo de data pode até ajudar na próxima prática que recomendo.
Harnesses precisam de reengenharia constante à medida que os modelos-base melhoram suas capacidades nativas.
Construa seus componentes para que possam ser removidos facilmente.
O padrão de hooks neste tutorial é deliberadamente modular por isso.
Cada hook é uma função separada adicionada com uma linha. Se você o aposentar, basta apagar uma linha no loop.
Nada mais no loop muda.
Compare com lógica de validação entrelaçada diretamente no seu loop ReAct, em que remover uma checagem obsoleta exige retestar todo o caminho de orquestração.
O que hoje parece muleta necessária vira sobrecarga desnecessária no próximo trimestre.
Quando sair um novo modelo, reexecute seus casos antigos de falha com cada hook desativado, um de cada vez, e trate qualquer hook que não pegue mais nada como candidato a exclusão.
Veja também Claude Code Best Practices para mais dicas de arquitetura.
Um loop ReAct básico com filesystem e uma ferramenta Bash já é altamente prático.
Resista à tentação de construir preventivamente um grafo complexo com frameworks pesados. A catraca só funciona em uma direção: de falha observada para correção direcionada. Correções especulativas invertem isso.
Adicione hooks customizados só depois de ver a falha exata que os justifica. Para mais sobre como estruturar sistemas básicos, confira este guia sobre agentes LLM.
Você não consegue aplicar a catraca no que não vê.
Nosso loop já imprime cada chamada de ferramenta, e isso é o mínimo de observabilidade viável: quando uma execução falha, a transcrição impressa é seu material de diagnóstico.
À medida que seu harness amadurece, grave o histórico completo de mensagens de cada sessão em um JSON com timestamp ao final da execução.
Transcrições com falha viram seu conjunto de regressão; após cada mudança no harness, reproduza as tarefas que falharam antes e confirme que a correção se mantém.
Esse é o equivalente do engenheiro de harness a uma suíte de testes — e é o que separa um harness que evolui de um que só muda.
Agent harness engineering é a realidade prática de fazer modelos de IA entregarem trabalho útil.
O gap entre o que os modelos de hoje podem fazer teoricamente e o que você realmente vê em produção é, em grande parte, um gap de harness.
Essa disciplina não é sobre aprender um framework específico.
O agent harness certo para o seu código é moldado inteiramente pelo seu histórico único de falhas, construído de forma incremental pelo método da catraca.
Pronto para colocar esses conceitos em prática?
Conheça a trilha de habilidades AI Agent Fundamentals da DataCamp para continuar a construir sistemas prontos para produção. Você também pode explorar o Claude Agent SDK Tutorial para mais exemplos de código práticos.
Você também pode conferir a trilha de habilidades AI for Software Engineering.
Principais cursos da DataCamp
Curso
Curso
Pratique e programa seu progresso.
Continuar Com O Googleblog
Tutorial
Tutorial
Arjun Sarkar
15 min
Tutorial
Moez Ali
12 min
Tutorial
Zoumana Keita
8 min
Tutorial
Zoumana Keita
14 min