

Corso
Sviluppare applicazioni LLM con LangChain
3 ore
51.8K
Pratica and corso your progress.
Continua Con GoogleImmagina di eseguire due volte lo stesso identico large language model (LLM), ma di dargli due harness completamente diversi. Una run porta a termine in modo pulito un complesso refactoring. La seconda si blocca e fallisce del tutto. Il modello non è mai cambiato: è cambiata l’impalcatura attorno al modello.
In poche parole, agent harness engineering è la pratica di costruire la logica circostante, l’accesso al filesystem, la memoria e le regole che permettono a un LLM di agire in modo affidabile.
In questo tutorial di agent harness engineering, ti insegnerò a costruire un setup minimo in Python con un loop Reason and Act (ReAct), strumenti e hook. Ti servono Python 3, pip installato sulla tua macchina e una familiarità di base con le chiamate API verso un LLM.
L’agent harness engineering è la pratica di costruire l’infrastruttura, le configurazioni e la logica di esecuzione che avvolgono un large language model, portandolo da un generatore di testo LLM statico a un agente AI autonomo
L’agent harness engineering è la configurazione strutturale che trasforma un generatore di testo statico in un lavoratore autonomo.
L’equazione di base è semplice: agente = modello + harness. L’harness include system prompt, definizioni degli strumenti, workspace su filesystem, logica di orchestrazione e hook per l’osservabilità.
Addy Osmani ha codificato questo concetto nel suo articolo O’Reilly di aprile 2026 sui workflow AI. Ha definito l’harness come ogni pezzo di codice, configurazione e logica d’esecuzione che non è il modello in sé: la tua superficie come sviluppatore, distinta dall’API del provider.
Quando ho iniziato a costruire workflow di machine learning, davo la colpa al modello ogni volta che un agente allucinava una dipendenza Python. Ho imparato a mie spese che la maggior parte dei fallimenti sono problemi di configurazione.
La stessa identica versione di un modello, con un harness migliore, supera misurabilmente se stessa con uno scarso.
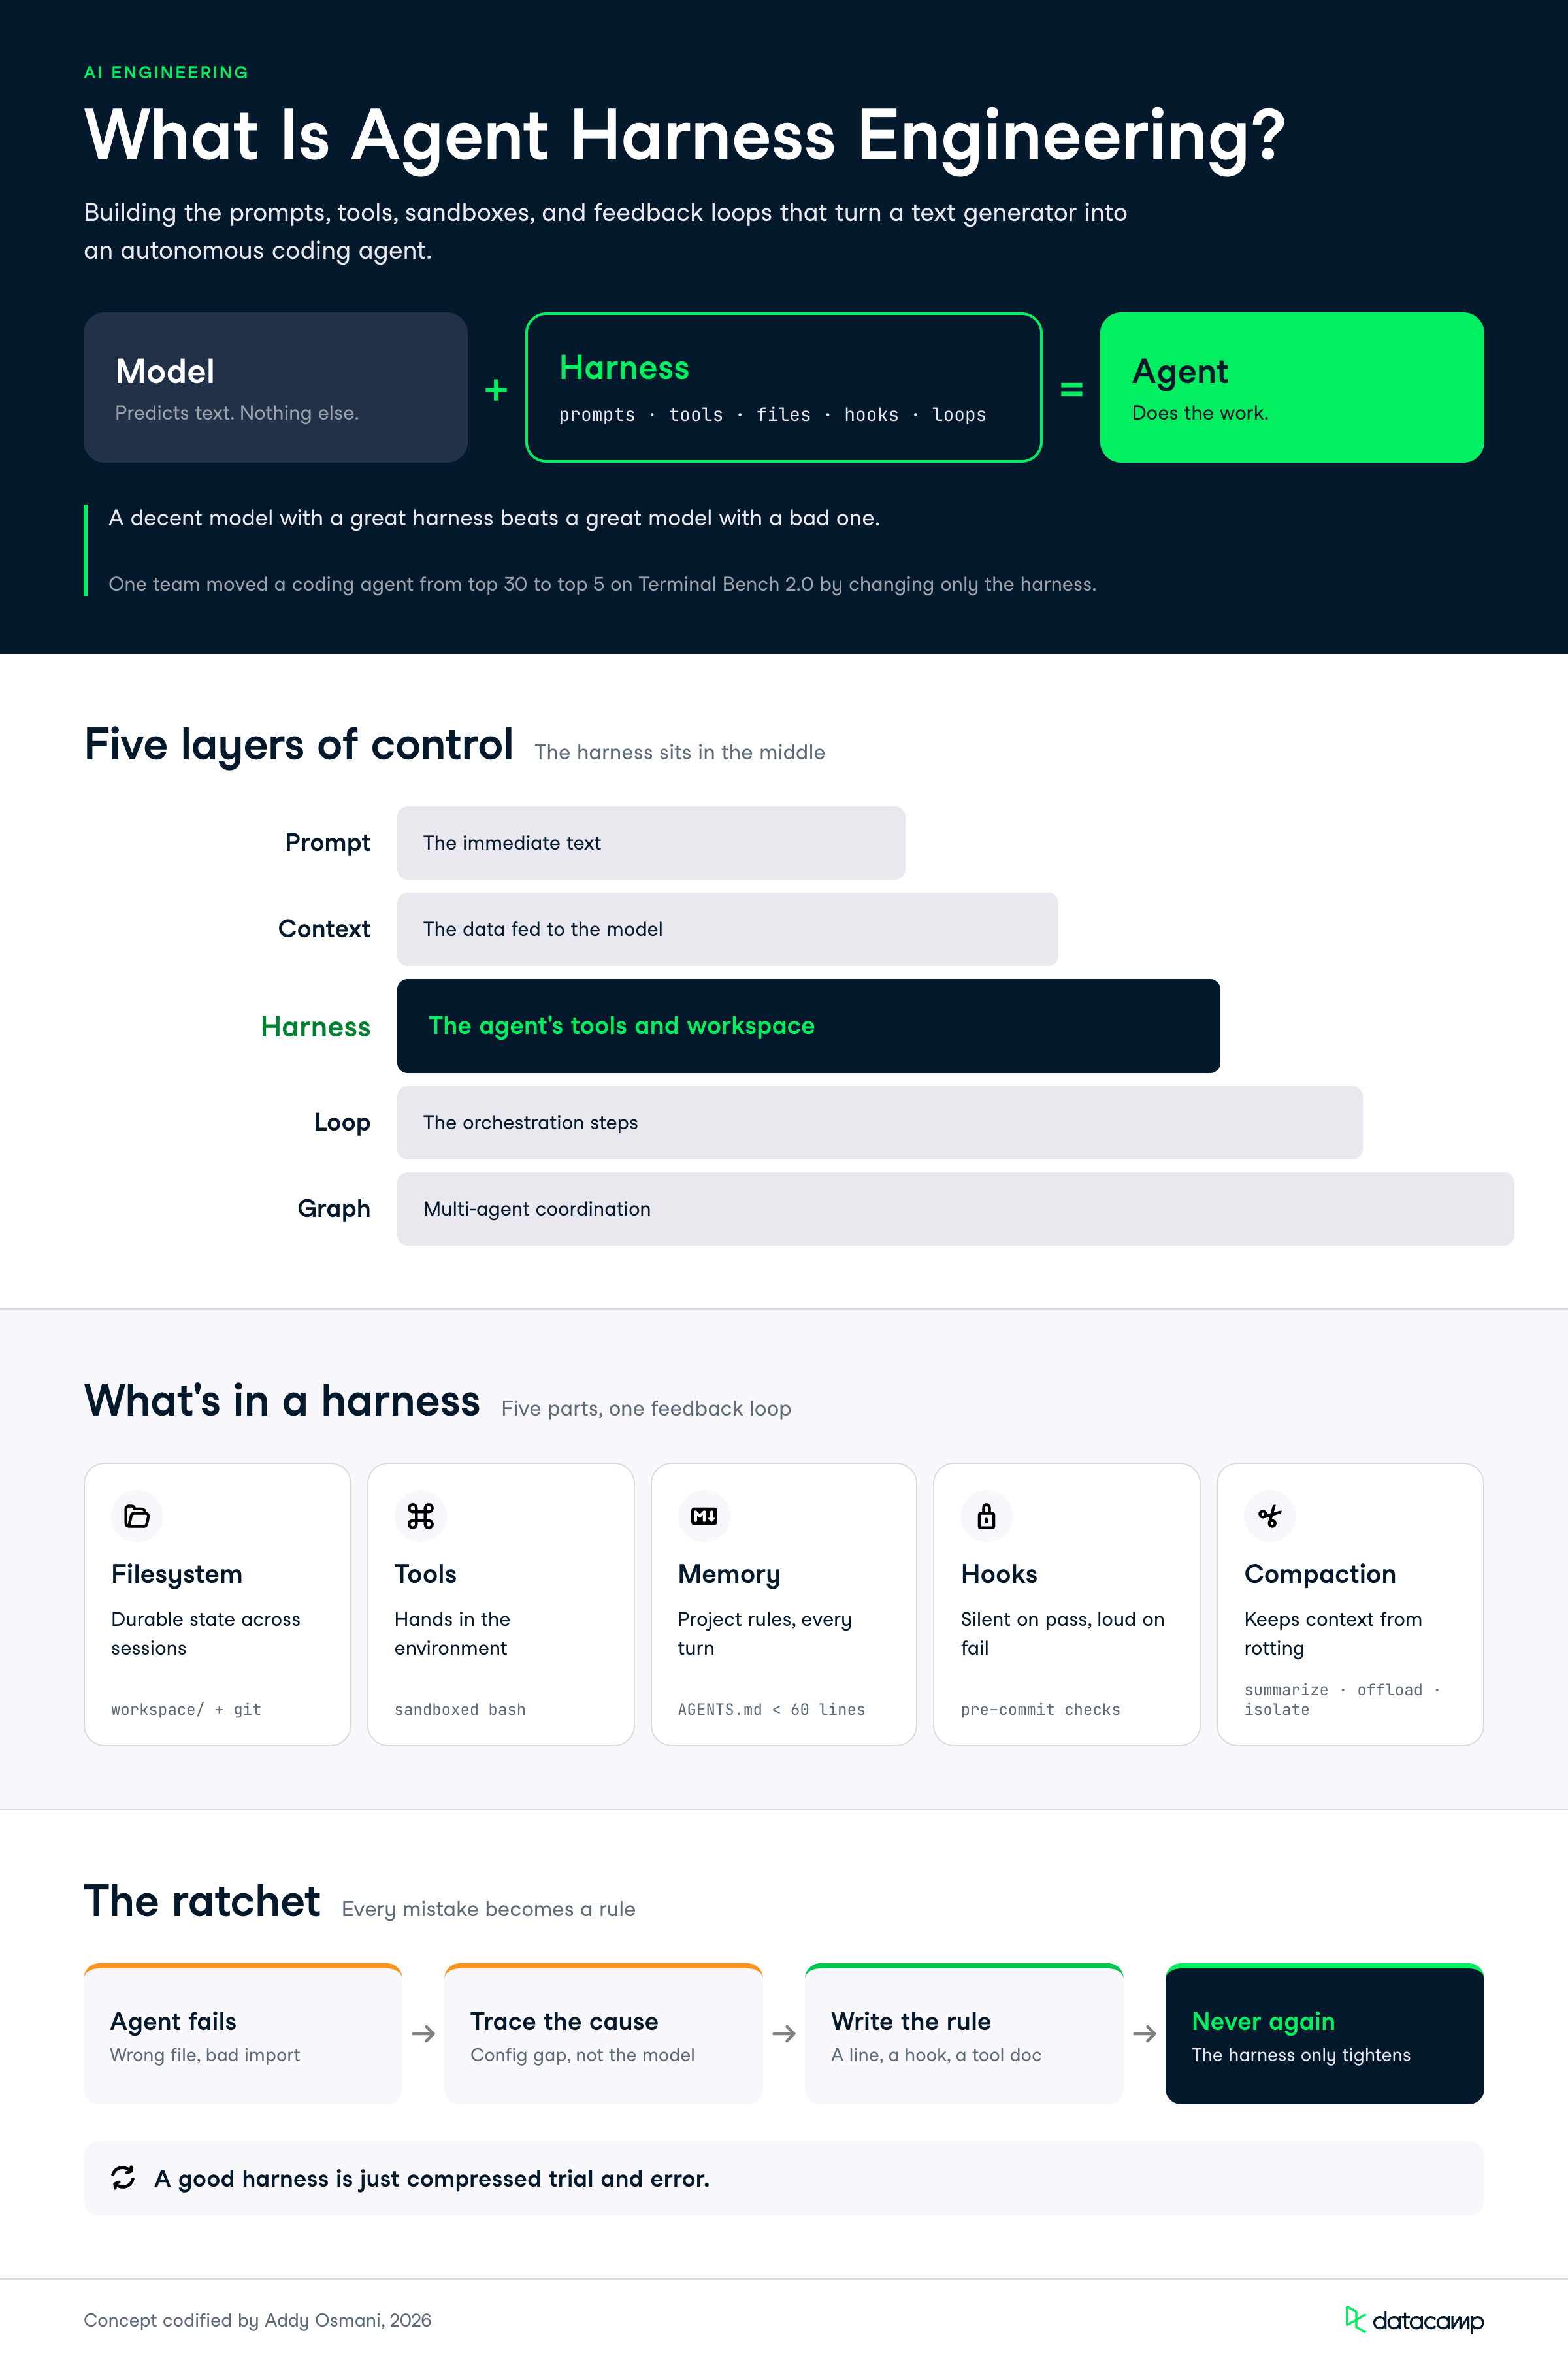
Possiamo scomporre lo sviluppo AI in livelli distinti di controllo.
L’harness engineering si colloca esattamente al centro di questa gerarchia.
|
Livello |
Che cosa controlla |
Azione d’esempio |
|
Prompt engineering |
Il testo immediato |
Ritoccare le istruzioni |
|
Context engineering |
I dati forniti al modello |
Tuning della pipeline RAG |
|
Harness engineering |
Gli strumenti fisici dell’agente |
Aggiungere uno strumento Bash |
|
Loop engineering |
I passaggi di orchestrazione |
Modificare il flusso ReAct |
|
Graph engineering |
Coordinamento multi-agente |
Costruire nodi di instradamento |
pandas o legge un CSV locale. Il mindset distintivo dell’agent harness engineering è l’effetto cricchetto.
Quando un agente commette un errore, progetti una correzione affinché non si ripeta mai più. Un buon harness è solo tentativi ed errori compressi.
Invece di lasciare che l’agente ripeta gli errori, aggiungi una riga al tuo AGENTS.md, scrivi un nuovo hook o rendi più stringente la descrizione di uno strumento.
Non corri istintivamente a cercare un nuovo modello; costruisci invece un corpus che ti consenta di rintracciare i fallimenti specifici e come ti sei irrobustito contro di essi.
I componenti fondamentali di un AI agent harness sono il filesystem, gli strumenti, la memoria, gli hook e i sistemi di gestione del contesto che permettono al modello di operare.
Queste parti collaborano per trasformare chiamate API isolate in un loop di feedback continuo. Voglio darti una mappa chiara prima di iniziare a scrivere codice.
|
Componente |
Compito |
Implementazione in Python |
|
Filesystem |
Stato durevole |
Directory di lavoro locale/workspace |
|
Strumenti |
Agire nell’ambiente |
Funzioni Python per Bash |
|
Memoria |
Contesto di progetto |
|
|
Hook |
Applicazione delle regole |
Script di validazione pre-commit |
|
Compattazione |
Gestione del contesto |
Logica di sintesi |
Un modello può elaborare solo le informazioni all’interno della sua limitata finestra di contesto. Un filesystem fornisce uno spazio di lavoro stabile per leggere dati, scrivere risultati intermedi e coordinarsi tra sessioni.
Aggiungere il controllo di versione Git fornisce una rete di sicurezza necessaria. L’agente può tracciare i progressi, creare branch per esperimenti con iperparametri diversi e ripristinare automaticamente codice rotto.
Il loop ReAct opera in un ciclo di ragionamento, azione tramite una chiamata a uno strumento e osservazione del risultato. Le descrizioni degli strumenti costituiscono l’interfaccia diretta tra il modello e l’ambiente. Descrizioni vaghe producono comportamenti vaghi.
Bash è un ottimo strumento generico. Invece di pre-costruire una funzione Python specifica per ogni possibile azione, Bash permette all’agente di costruire al volo i comandi esatti di cui ha bisogno. Devi isolare con cura questi comandi per prevenire danni al sistema.
AGENTS.md e knowledge injectionIl tuo agente ha bisogno di una memoria specifica al progetto per comprendere le convenzioni locali. Un file AGENTS.md è un semplice documento markdown alla radice del repository che finisce nel system prompt a ogni turno. Definisce il tuo stack tecnologico, le regole di formattazione e le azioni proibite.
Mantieni questo file sotto le 60 righe. Trattalo come la checklist di un pilota, non come una guida di stile completa. Puoi leggere un tutorial completo su AGENTS.md per esempi più approfonditi. Dovresti anche considerare gli strumenti del Model Context Protocol (MCP) per conoscenze successive al cutoff.
Gli hook sono piccoli script che girano in momenti specifici del ciclo di vita.
Potresti eseguire un hook prima di una chiamata a uno strumento, dopo una modifica a un file o prima di un commit Git. Dai un’occhiata a questa guida su Claude Code Hooks per pattern avanzati di hook.
Il principio di design principale per gli hook è che il successo è silenzioso, mentre i fallimenti sono verbosi. Un typecheck superato non produce output.
Un fallimento inietta l’esatto testo dell’errore nel loop dell’agente per l’auto-correzione.
Il context rot si verifica quando la capacità di seguire le istruzioni degrada man mano che la finestra di contesto si riempie con lunghe cronologie di conversazione. Un solido scaffolding per agenti AI deve gestire attivamente questo aspetto. Leggi di più sulla finestra di contesto per capirne i limiti.
Puoi ridurre il contesto riassumendo i messaggi più vecchi. Puoi scaricare su disco gli output voluminosi degli strumenti e mantenere nel prompt solo un breve riferimento.
Infine, puoi isolare sottotask ad alto consumo di token in un sotto-agente con un contesto nuovo.
Costruire un AI agent harness significa scrivere il codice di orchestrazione in Python che collega il loop ReAct, gli strumenti e gli hook.
Chiarisci il rapporto prima di scrivere codice: harness.py è l’agente e lo avvii tu stesso con python harness.py come qualsiasi altro script.
Il modello è un’API remota che non vede mai questo file; riceve solo il system prompt, la cronologia dei messaggi e gli schemi degli strumenti che il tuo script gli invia.
Ogni snippet in questa sezione è un pezzo di un unico file, harness.py, e le prime 4 sezioni lo costruiscono dall’alto verso il basso. Le ultime 2 sezioni (hook e compattazione) lo migliorano e, poiché il loop si esegue non appena Python vi arriva, le loro definizioni di funzione devono trovarsi sopra il loop; ogni sezione ti dice esattamente dove inserire il suo codice.
Per costruire questo, ti serve un account sviluppatore con il provider scelto. Gli abbonamenti consumer standard (come ChatGPT Plus o Claude Pro) non forniscono accesso alle API.
ANTHROPIC_API_KEY (o OPENAI_API_KEY).Per questo esempio useremo Anthropic, quindi assicurati di installare il pacchetto Python di Anthropic con pip install anthropic.
Poi crea lo scheletro del progetto. Dare un nome a ogni file in anticipo conta: il nostro loop leggerà AGENTS.md all’avvio, quindi quel file deve esistere prima che il loop parta.
agent-harness/
├── AGENTS.md        # Project memory (we write this first)
├── harness.py       # The ReAct loop, tools, and hooks
└── workspace/       # The only directory the agent may touch
La directory workspace/ è la sandbox dell’agente. Tutto ciò che l’agente legge, scrive o esegue avviene al suo interno, mai nella root del tuo progetto.
Scriviamo AGENTS.md prima del loop perché il loop ne dipende.
Crea il file nella root del progetto e includi i dettagli specifici del tuo stack e i confini architetturali:
# Project Context
Stack: Python 3.11, Pytest
Workspace: All commands run inside the workspace/ directory.

# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
Il nostro loop tratterà "il modello ha risposto senza richiedere uno strumento" come segnale di completamento del task, quindi diciamo esplicitamente al modello come segnalare la fine.
Le regole che fanno riferimento alle meccaniche del tuo loop sono la chiave dell’harness engineering. Il file di memoria e il codice di orchestrazione sono progettati insieme.
Ora avvia harness.py creando questo file come system prompt e preparando il workspace:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Project memory: AGENTS.md lands in the system prompt on every turn
system_prompt = Path("AGENTS.md").read_text()
Poiché l’SDK invia system_prompt con ogni chiamata API, le regole in AGENTS.md vengono re-iniettate a ogni singolo turno. Il modello non può “dimenticarle” come fa con le istruzioni a metà conversazione.
Definiamo 2 strumenti: run_bash per l’esecuzione generica e write_file per creare file.
Il secondo strumento può sembrare ridondante poiché Bash può scrivere file con gli heredoc, ma un write_file dedicato ci dà un evento di modifica pulito a cui il nostro hook post-edit potrà agganciarsi più avanti.
Decisioni di design dell’harness come questa riguardano sempre ciò che vuoi osservare e applicare.
Le descrizioni degli strumenti sono l’interfaccia e la loro qualità controlla direttamente il comportamento dell’agente:
Proseguendo nel nostro file harness.py, possiamo ora definire gli schemi degli strumenti alla riga successiva:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
Il prossimo blocco definisce le funzioni Python che eseguiranno effettivamente questi comandi.
Nota le seguenti misure di sicurezza integrate: un timeout rigido per evitare che un comando bloccato congeli l’harness, il codice di uscita incluso in ogni risultato in modo che l’agente possa distinguere successo e fallimento, e un controllo del percorso affinché write_file() non esca dalla sandbox.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
Il fallback or '(no output)' non è cosmetico.
Un comando come touch data.csv ha successo in silenzio e restituire una stringa vuota non dà nulla da osservare al modello.
Dai sempre all’agente un segnale esplicito, anche per il silenzio.
Il cuore del nostro harness è un normale loop for in Python con un limite di iterazioni.
Ogni passaggio chiama l’API, verifica se il modello ha richiesto uno strumento, esegue tutte le richieste di strumenti e reinvia i risultati come un unico messaggio.
Questo blocco si trova in fondo a harness.py, poiché inizia a eseguire nel momento in cui Python vi arriva.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Due dettagli in questo loop evitano crash reali.
Primo, un singolo turno del modello può contenere più chiamate di strumenti e l’API Anthropic richiede che tutti i risultati tornino in un unico messaggio utente.
Secondo, il costrutto for/else segnala quando l’agente raggiunge il limite di iterazioni, così una run bloccata fallisce in modo rumoroso invece di finire nel silenzio.
Questa struttura esplicita ti consente di vedere esattamente dove il modello smette di pensare, dove Python subentra per eseguire il comando e come l’output rientra nel loop.
Gli hook intercettano errori prima che diventino problemi strutturali più grandi.
Nel nostro harness, un hook è una funzione che ispeziona una chiamata a strumento completata e restituisce testo extra da aggiungere al risultato dello strumento.
Il successo restituisce una stringa vuota; il fallimento restituisce un report verboso.
Aggiungi questa funzione a harness.py sopra il loop ReAct, accanto agli executor degli strumenti. Il loop inizia a girare non appena Python ci arriva, quindi tutto ciò che chiama deve essere già definito.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
Collegarlo al loop è un cambiamento di una sola riga all’interno del blocco di esecuzione degli strumenti:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Senza l’hook, l’agente scrive un file rotto, vede Wrote 412 characters to fizzbuzz.py e prosegue con sicurezza.
Con l’hook, lo stesso risultato dello strumento porta l’esatto traceback di pytest. All’iterazione successiva, l’agente legge l’errore e corregge il bug da solo, senza prompt aggiuntivi.
Per combattere il context rot, monitora la lunghezza della tua lista messages e riassumi i turni più vecchi quando diventa troppo lunga.
C’è una trappola: non puoi tagliare la cronologia in un punto arbitrario, perché un blocco tool_use dell’assistente e il suo messaggio tool_result associato devono rimanere insieme. Separare una coppia produce un errore API immediato.
La nostra funzione di compattazione sposta in avanti il punto di taglio finché non atterra su un confine sicuro. Costruiscila sopra harness.py:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Aggiungi una riga in cima al loop ReAct, prima della chiamata all’API:
messages = compact(messages)Usiamo un modello più piccolo ed economico per il riassunto perché la compattazione gira spesso e ha bisogno di velocità.
Manteniamo anche il messaggio del task originale alla lettera invece di fidarci che il riassunto lo preservi.
L’harness è ora completo.
Prima di proseguire, verifica che il tuo harness.py legga in questo ordine dall’alto verso il basso:
client, WORKSPACE e system_promptTOOLSrun_bash(), write_file() e TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() e compact()Per darti un’idea di come dovrebbe apparire il loop API finale, dato che abbiamo aggiunto le sezioni su hook e compattazione, ecco il loop completo:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Ora esegui l’agente dalla root del progetto con python harness.py.
Lo script invia il task dalla lista messages all’API.
L’harness fa il lavoro e dovresti vedere ogni iterazione stampata nel tuo terminale:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
Il programma esce quando il modello risponde senza una chiamata a strumento o quando scatta il limite di 15 iterazioni.
Per dare all’agente un task diverso, cambia la stringa content nella lista iniziale messages; un harness di produzione la leggerebbe da input() o da un argomento da riga di comando.
Il cricchetto è il processo continuo di diagnosi dei fallimenti dell’agente e aggiornamento del tuo harness per prevenirli.
Un harness migliora soltanto attraverso l’esposizione a edge case reali.
Percorriamo un ciclo completo di fallimento e correzione basato su un vero progetto di ottimizzazione di percorsi.
Immagina che il tuo agente continui a importare una libreria interna di routing deprecata chiamata legacy_route_math invece della versione aggiornata.
L’agente scrive lo script, i test falliscono e rimane bloccato in un loop cercando di correggere la sintassi invece di cambiare libreria.
La diagnosi qui è semplice.
L’agente semplicemente non sa che la libreria è deprecata. È una regola mancante, non un fallimento della rete neurale sottostante.
La correzione 1 aggiorna il layer di memoria: aggiungi questa regola a AGENTS.md:
# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
4. Do not import legacy_route_math; it is deprecated. Use routes_v2 instead.
La correzione 2 aggiunge un hook di enforcement permanente.
Le regole sono consigli per l’agente, gli hook sono comandi. Questa correzione richiede poche righe e può essere aggiunta accanto a post_edit_hook(), purché sia prima del loop ReAct.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Registralo accanto all’hook di pytest nel blocco di esecuzione degli strumenti:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
Ecco come appare l’auto-correzione nel transcript dopo che entrambe le correzioni sono attive.
L’agente scrive il file, l’hook scatta e al turno successivo corregge l’import senza intervento umano:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
Questo è importante perché si ricollega al context rot. Sessioni molto lunghe con contesto degradato finiranno per ignorare le regole di memoria.
La regola in AGENTS.md previene l’errore nella maggior parte dei casi, e l’hook garantisce che quando la regola sfugge, l’errore non causi danni.
Ogni fallimento che diagnostichi dovrebbe farti porre 2 domande: quale regola mancava e quale controllo l’avrebbe comunque intercettato?
Le best practice per l’agent harness engineering si concentrano sul mantenere le configurazioni snelle e sul progettare pensando ai futuri upgrade dei modelli.
L’obiettivo è costruire un’impalcatura che supporti il modello senza sovraccaricarlo.
Ho imparato alcune lezioni a caro prezzo costruendo varie skill di agenti e architetture.
Punta a un massimo di 60 righe per il tuo file di contesto.
Ogni singola regola deve risalire a un fallimento reale e documentato che hai vissuto. Se non ricordi l’incidente per una regola, vale la pena eliminarla.
Questa disciplina è fondamentale perché AGENTS.md si paga a ogni turno.
Una guida di stile da 300 righe ti costa token a ogni chiamata API e diluisce le regole che contano, poiché i modelli seguono 10 regole nette molto meglio di 80 vaghe.
Aggiungere una data può persino aiutare con la prossima pratica che consiglio.
Gli harness richiedono continue ri-architetture man mano che i modelli di base migliorano le loro capacità native.
Costruisci i tuoi componenti in modo da poterli rimuovere facilmente.
Il pattern degli hook in questo tutorial è volutamente modulare per questo motivo.
Ogni hook è una funzione separata che poi viene aggiunta con una singola riga. Se deprecchi l’hook, ti basta eliminare una riga nel loop.
Nient’altro nel loop cambia.
Confrontalo con la logica di validazione intrecciata direttamente nel tuo loop ReAct, dove rimuovere un controllo obsoleto significa ritestare tutto il percorso di orchestrazione.
Ciò che oggi sembra una stampella necessaria diventerà un overhead inutile il prossimo trimestre.
Quando esce un nuovo modello, riesegui i tuoi vecchi casi di fallimento con ciascun hook disabilitato uno alla volta e considera candidato all’eliminazione qualsiasi hook che non intercetti più nulla.
Dai un’occhiata a Claude Code Best Practices per altri consigli architetturali.
Un semplice loop ReAct con un filesystem e uno strumento Bash è già altamente pratico.
Resisti alla tentazione di costruire in anticipo un sistema a grafo complesso usando framework pesanti. Il cricchetto funziona solo in una direzione, dal fallimento osservato alla correzione mirata. Le correzioni speculative lo invertirebbero.
Aggiungi hook personalizzati solo dopo aver visto l’esatto fallimento che li giustifica. Per approfondire la strutturazione di sistemi di base, consulta questa guida sugli agenti LLM.
Non puoi azionare il cricchetto su ciò che non vedi.
Il nostro loop stampa già ogni chiamata a strumento, e questo è il minimo di osservabilità: quando una run fallisce, il transcript stampato è il tuo materiale diagnostico.
Quando il tuo harness matura, scrivi l’intera cronologia dei messaggi di ogni sessione in un file JSON con timestamp a fine run.
I transcript falliti diventano la tua suite di regressione; dopo ogni modifica all’harness, riproduci i vecchi task falliti e conferma che la correzione regge.
Questa è l’equivalente, per l’harness engineer, di una test suite, ed è ciò che distingue un harness che migliora da uno che semplicemente cambia.
L’agent harness engineering è la realtà pratica di far svolgere lavori utili ai modelli di AI.
Il divario tra ciò che i modelli di oggi possono teoricamente fare e ciò che vedi davvero in produzione è in gran parte un divario di harness.
Questa disciplina non riguarda l’apprendimento di un framework specifico.
Il giusto AI agent harness per il tuo codebase è modellato interamente dalla tua storia unica di fallimenti, costruito in modo incrementale con il metodo del cricchetto.
Pronto a mettere in pratica questi concetti?
Dai un’occhiata al percorso di skill AI Agent Fundamentals di DataCamp per continuare a costruire sistemi pronti per la produzione. Puoi anche esplorare il tutorial sul Claude Agent SDK per esempi di codice più pratici.
Potresti anche voler dare un’occhiata al percorso di skill AI for Software Engineering.
I migliori corsi DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



