

Kurs
Entwickeln von LLM-Anwendungen mit LangChain
3 Std.
51.8K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleStell dir vor, du führst zweimal exakt dasselbe Large Language Model (LLM) aus, gibst ihm aber zwei völlig unterschiedliche Harnesses. Ein Lauf beendet eine komplexe Refactoring-Aufgabe sauber. Der zweite Lauf bricht ab und scheitert komplett. Das Modell blieb gleich, doch das Gerüst rund um das Modell änderte sich.
Kurz gesagt ist Agent-Harness-Engineering die Praxis, die umgebende Logik, Dateisystemzugriffe, Speicher und Regeln zu bauen, die ein LLM zuverlässig handeln lassen.
In diesem Tutorial zum Agent-Harness-Engineering zeige ich dir ein minimales Python-Setup mit Reason-and-Act- (ReAct-) Loop, Tools und Hooks. Du brauchst Python 3, pip auf deinem Rechner und grundlegende Erfahrung mit LLM-API-Calls.
Agent-Harness-Engineering ist die Praxis, die Infrastruktur, Konfigurationen und Ausführungslogik rund um ein Large Language Model zu bauen, um es vom statischen LLM-Textgenerator in einen autonomen KI-Agenten zu verwandeln.
Agent-Harness-Engineering ist die strukturelle Konfiguration, die aus einem statischen Textgenerator einen autonomen Worker macht.
Die Kerngleichung ist simpel: Agent = Modell + Harness. Das Harness umfasst Systemprompts, Tool-Definitionen, Dateisystem-Workspaces, Orchestrierungslogik und Observability-Hooks.
Addy Osmani hat dieses Konzept in seinem O'Reilly-Beitrag zu KI-Workflows vom April 2026 präzisiert. Er definierte das Harness als jeglichen Code, jede Konfiguration und Ausführungslogik, die nicht das Modell selbst sind: deine Entwicklungsoberfläche, getrennt von der API des Providers.
Als ich anfing, Machine-Learning-Workflows zu bauen, gab ich jedes Mal dem Modell die Schuld, wenn ein Agent eine Python-Abhängigkeit halluzinierte. Ich habe gelernt: Die meisten Fehler sind Konfigurationsprobleme.
Dieselbe Modellversion mit einem besseren Harness übertrifft sich selbst messbar gegenüber einem schlechten.
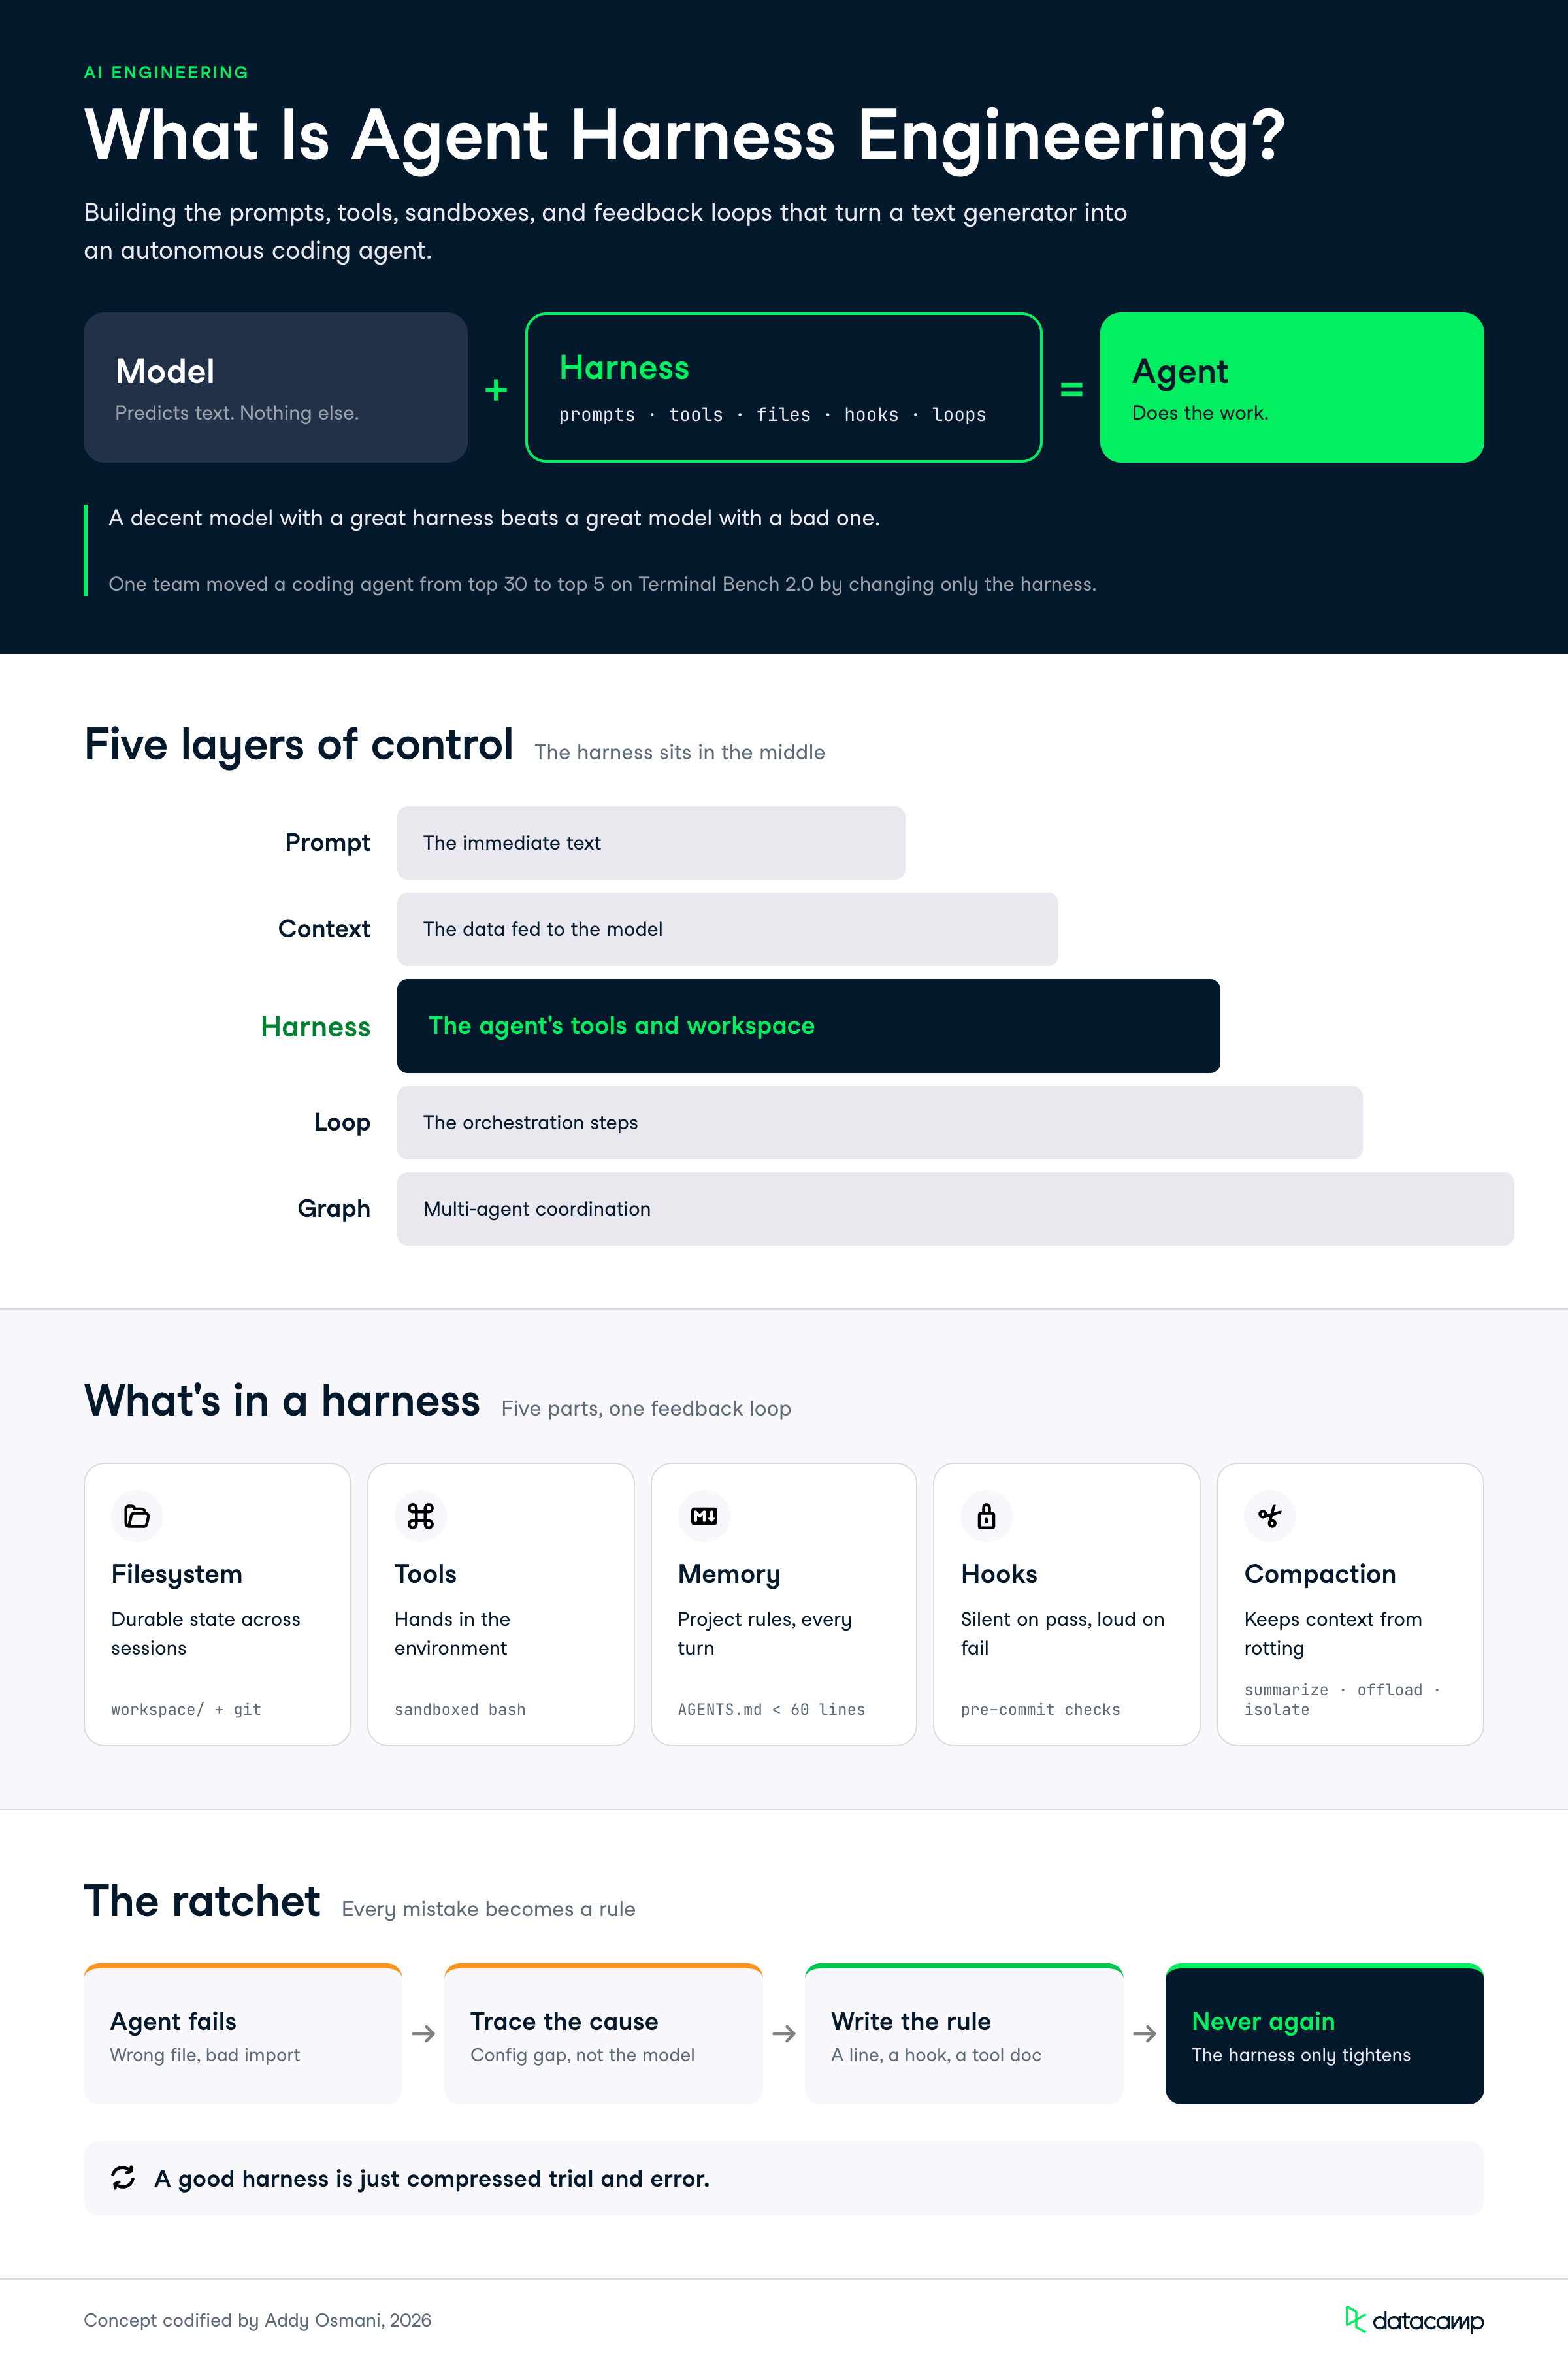
Wir können KI-Entwicklung in klar getrennte Steuerungsebenen aufteilen.
Harness-Engineering sitzt genau in der Mitte dieser Hierarchie.
|
Ebene |
Was sie steuert |
Beispielaktion |
|
Prompt-Engineering |
Den unmittelbaren Text |
Anweisungen feinjustieren |
|
Context-Engineering |
Die dem Modell zugeführten Daten |
RAG-Pipeline-Tuning |
|
Harness-Engineering |
Die physischen Werkzeuge des Agenten |
Ein Bash-Tool hinzufügen |
|
Loop-Engineering |
Die Orchestrierungsschritte |
ReAct-Flow ändern |
|
Graph-Engineering |
Koordination mehrerer Agenten |
Routing-Knoten bauen |
pandas-Script ausführt oder eine lokale CSV liest. Die prägende Denkweise im Agent-Harness-Engineering ist der Ratschen-Effekt.
Wenn ein Agent einen Fehler macht, baust du eine Abhilfe, damit er diesen Fehler nie wiederholt. Ein gutes Harness ist verdichtetes Trial-and-Error.
Statt den Agenten Fehler wiederholen zu lassen, fügst du eine Zeile zu deiner AGENTS.md hinzu, schreibst einen neuen Hook oder schärfst eine Toolbeschreibung nach.
Du greifst nicht reflexartig nach einem neuen Modell, sondern baust einen Korpus auf, der es dir erlaubt, spezifische Fehler nachzuverfolgen und zu dokumentieren, wie du dich dagegen gehärtet hast.
Die Kernbausteine eines KI-Agent-Harnesses sind Dateisystem, Tools, Speicher, Hooks und Systeme zum Kontextmanagement, die dem Modell das Arbeiten ermöglichen.
Diese Teile greifen ineinander und verwandeln isolierte API-Calls in eine kontinuierliche Feedbackschleife. Bevor wir Code schreiben, gebe ich dir eine klare Landkarte.
|
Komponente |
Aufgabe |
Python-Implementierung |
|
Dateisystem |
Dauerhafter Zustand |
Lokales workspace/-Verzeichnis |
|
Tools |
Handeln in der Umgebung |
Python-Funktionen für Bash |
|
Speicher |
Projektkontext |
Eine AGENTS.md-Datei |
|
Hooks |
Durchsetzung |
Pre-Commit-Validierungsskripte |
|
Kompaktion |
Kontextmanagement |
Zusammenfassungslogik |
Ein Modell kann nur Informationen innerhalb seines begrenzten Kontextfensters verarbeiten. Ein Dateisystem liefert einen stabilen Workspace, um Daten zu lesen, Zwischenergebnisse zu schreiben und Sitzungen zu übergreifen.
Git-Versionskontrolle ist das nötige Sicherheitsnetz. Der Agent kann Fortschritt tracken, für Experimente mit verschiedenen Hyperparametern branchen und fehlerhaften Code automatisch zurückrollen.
Der ReAct-Loop läuft zyklisch: überlegen, über einen Tool-Call handeln und das Ergebnis beobachten. Toolbeschreibungen sind die Schnittstelle zwischen Modell und Umgebung. Vage Beschreibungen erzeugen vages Verhalten.
Bash ist ein starkes Allzweck-Tool. Statt für jede mögliche Aktion eine eigene Python-Funktion vorzubauen, kann der Agent mit Bash die exakten Kommandos on the fly zusammenstellen. Du musst diese Befehle sorgfältig sandboxes, um Systemschäden zu verhindern.
AGENTS.md und Knowledge InjectionDein Agent braucht projektspezifisches Gedächtnis, um lokale Konventionen zu verstehen. Eine AGENTS.md ist ein flaches Markdown-Dokument im Repository-Root, das in jedem Zug in den Systemprompt gelangt. Es definiert Tech-Stack, Formatierungsregeln und verbotene Aktionen.
Halte diese Datei unter 60 Zeilen. Behandle sie wie die Checkliste eines Piloten, nicht wie einen umfassenden Styleguide. Eine vollständige AGENTS.md-Anleitung liefert tiefere Beispiele. Du solltest außerdem Model Context Protocol (MCP)-Tools für Wissen nach dem Cutoff in Betracht ziehen.
Hooks sind kleine Skripte, die an bestimmten Lifecycle-Punkten laufen.
Du kannst einen Hook vor einem Tool-Call, nach einem File-Edit oder vor einem Git-Commit auslösen. Sieh dir diesen Guide zu Claude Code Hooks für fortgeschrittene Muster an.
Das wichtigste Gestaltungsprinzip: Erfolg bleibt stumm, Fehler sind ausführlich. Ein erfolgreicher Typecheck produziert keine Ausgabe.
Ein Fehler injiziert den genauen Fehlertest zurück in den Agent-Loop zur Selbstkorrektur.
Kontextverfall tritt auf, wenn das Befolgen von Anweisungen nachlässt, weil das Kontextfenster mit langen Konversationshistorien gefüllt ist. Ein solides KI-Agentengerüst muss das aktiv managen. Lies mehr über das Kontextfenster, um diese Grenzen zu verstehen.
Du kannst Kontext reduzieren, indem du ältere Nachrichten zusammenfasst. Große Tool-Ausgaben kannst du auf die Festplatte auslagern und im Prompt nur eine kurze Referenz behalten.
Schließlich kannst du tokenlastige Teilaufgaben an einen Subagenten mit frischem Kontext auslagern.
Ein KI-Agent-Harness zu bauen heißt, die Python-Orchestrierung zu schreiben, die ReAct-Loop, Tools und Hooks verbindet.
Kläre die Rollen, bevor du Code schreibst: harness.py ist der Agent, und du startest ihn selbst mit python harness.py wie jedes andere Script.
Das Modell ist eine entfernte API, die diese Datei nie sieht; sie erhält nur Systemprompt, Nachrichtenhistorie und Toolschemata, die dein Script sendet.
Jeder Schnipsel in diesem Abschnitt ist Teil einer Datei, harness.py, und die ersten 4 Abschnitte bauen sie von oben nach unten. Die letzten 2 Abschnitte (Hooks und Kompaktion) rüsten sie auf. Da der Loop startet, sobald Python ihn erreicht, müssen deren Funktionsdefinitionen oberhalb des Loops stehen; jeder Abschnitt sagt dir genau, wo sein Code hingehört.
Dafür brauchst du ein Developer-Konto bei deinem gewählten Provider. Normale Consumer-Abos (wie ChatGPT Plus oder Claude Pro) bieten keinen API-Zugang.
ANTHROPIC_API_KEY (oder OPENAI_API_KEY).In diesem Beispiel verwenden wir Anthropic. Installiere also das Anthropic-Python-Paket mit pip install anthropic.
Erstelle als Nächstes das Projektskelett. Das Vorab-Benennen aller Dateien ist wichtig: Unser Loop liest AGENTS.md beim Start, daher muss diese Datei existieren, bevor der Loop läuft.
agent-harness/
├── AGENTS.md        # Projektspeicher (schreiben wir zuerst)
├── harness.py       # Der ReAct-Loop, Tools und Hooks
└── workspace/       # Das einzige Verzeichnis, das der Agent anfassen darf
Das Verzeichnis workspace/ ist die Sandbox des Agenten. Alles, was der Agent liest, schreibt oder ausführt, passiert darin, nie im Projekt-Root.
Wir schreiben AGENTS.md vor dem Loop, weil der Loop davon abhängt.
Erstelle die Datei im Projekt-Root und trage deinen spezifischen Stack und die architektonischen Grenzen ein:
# Projektkontext
Stack: Python 3.11, Pytest
Workspace: Alle Kommandos laufen im Verzeichnis workspace/.

# Regeln
1. Niemals rm -rf verwenden. Nutze rm mit konkreten Dateinamen.
2. Schreibe keine Tests in die Hauptapplikationsdatei.
3. Wenn du die Aufgabe beendest, antworte mit einer Klartext-Zusammenfassung und ohne Tool-Call.
Unser Loop behandelt „das Modell antwortete ohne Tool-Anforderung“ als Signal für den Abschluss, daher sagen wir dem Modell explizit, wie es den Abschluss signalisieren soll.
Regeln, die sich auf deine eigenen Loop-Mechaniken beziehen, sind der Schlüssel zum Harness-Engineering. Speicherdatei und Orchestrierungscode werden gemeinsam entworfen.
Jetzt beginnen wir harness.py, indem wir diese Datei als Systemprompt laden und den Workspace vorbereiten:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Projektspeicher: AGENTS.md landet in jedem Zug im Systemprompt
system_prompt = Path("AGENTS.md").read_text()
Da das SDK den system_prompt bei jedem API-Call sendet, werden die Regeln aus AGENTS.md in jedem einzelnen Zug neu injiziert. Das Modell kann sie nicht „vergessen“, wie es mitten im Gespräch mit Anweisungen passiert.
Wir definieren 2 Tools: run_bash für allgemeine Ausführung und write_file zum Erstellen von Dateien.
Zweites mag redundant wirken, da Bash per Heredoc Dateien schreiben kann. Ein dediziertes write_file liefert uns jedoch ein sauberes Edit-Event, an das sich unser Post-Edit-Hook später hängen kann.
Solche Harness-Designentscheidungen richten sich immer danach, was du beobachten und durchsetzen willst.
Toolbeschreibungen sind die Schnittstelle und bestimmen das Verhalten des Agenten direkt:
Weiter in unserer Datei harness.py definieren wir direkt im Anschluss die Tool-Schemata:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
Der nächste Block definiert die eigentlichen Python-Funktionen, die diese Kommandos ausführen.
Beachte die eingebauten Sicherheitsfeatures: ein hartes Timeout, damit hängen gebliebene Kommandos das Harness nicht blockieren, ein Exit-Code in jedem Ergebnis, damit der Agent Erfolg von Fehler unterscheiden kann, und eine Pfadprüfung, damit write_file() die Sandbox nicht verlässt.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
Das Fallback or '(no output)' ist nicht kosmetisch.
Ein Kommando wie touch data.csv läuft stillschweigend erfolgreich, und ein leerer String lässt dem Modell nichts zu beobachten.
Gib dem Agenten immer ein explizites Signal – selbst bei Stille.
Der Kern unseres Harnesses ist eine normale Python-for-Schleife mit Iterationslimit.
Jeder Durchlauf ruft die API auf, prüft, ob das Modell ein Tool angefordert hat, führt alle angeforderten Tools aus und speist die Ergebnisse als eine einzige Nachricht zurück.
Dieser Block steht am Ende von harness.py, weil er startet, sobald Python ihn erreicht.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Zwei Details verhindern echte Abstürze.
Erstens kann ein einzelner Modellzug mehrere Tool-Calls enthalten, und die Anthropic-API verlangt, dass alle Ergebnisse in einer einzigen User-Nachricht zurückkommen.
Zweitens meldet die for/else-Konstruktion, wenn das Iterationslimit erreicht wurde, sodass ein hängender Lauf laut scheitert statt still zu enden.
Diese klare Struktur zeigt dir exakt, wo das Modell denkt, wo Python übernimmt, um das Kommando auszuführen, und wie die Ausgabe zurück in den Loop fließt.
Hooks fangen Fehler ab, bevor sie sich zu strukturellen Problemen auswachsen.
In unserem Harness ist ein Hook eine Funktion, die einen abgeschlossenen Tool-Call inspiziert und zusätzlichen Text zurückgibt, der an das Tool-Ergebnis angehängt wird.
Erfolg gibt einen leeren String zurück; Fehler liefern einen ausführlichen Bericht.
Füge diese Funktion in harness.py oberhalb des ReAct-Loops hinzu, neben den Tool-Executors. Der Loop startet, sobald Python ihn erreicht, daher muss alles, was er aufruft, schon definiert sein.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
Die Einbindung in den Loop ist eine Ein-Zeilen-Änderung im Tool-Execution-Block:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Ohne den Hook schreibt der Agent eine kaputte Datei, sieht Wrote 412 characters to fizzbuzz.py und macht selbstbewusst weiter.
Mit dem Hook trägt dasselbe Tool-Ergebnis das genaue pytest-Traceback. Im nächsten Durchlauf liest der Agent den Fehler und behebt den Bug selbst – ganz ohne weiteres Prompting.
Um Kontextverfall zu bekämpfen, beobachte die Länge deiner messages-Liste und fasse die ältesten Züge zusammen, wenn sie zu lang wird.
Es gibt eine Falle: Du kannst die Historie nicht an einer beliebigen Stelle abschneiden, denn ein tool_use-Block des Assistenten und seine zugehörige tool_result-Nachricht müssen zusammenbleiben. Ein geteiltes Paar produziert sofort einen API-Fehler.
Unsere Kompaktionsfunktion verschiebt den Schnittpunkt nach vorne, bis er sicher liegt. Baue dies oberhalb von harness.py ein:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Füge eine Zeile am Anfang des ReAct-Loops ein, vor dem API-Call:
messages = compact(messages)Für die Zusammenfassung nutzen wir ein kleineres, günstigeres Modell, weil Kompaktion häufig läuft und Geschwindigkeit braucht.
Außerdem behalten wir die ursprüngliche Aufgaben-Nachricht wortwörtlich, statt der Zusammenfassung zu vertrauen.
Das Harness ist jetzt komplett.
Bevor es weitergeht, prüfe, dass deine harness.py von oben nach unten in dieser Reihenfolge liest:
client, WORKSPACE und system_promptTOOLS-Schematarun_bash(), write_file() und TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() und compact()Um dir ein Gefühl dafür zu geben, wie der finale API-Loop nach Hinzufügen von Hook und Kompaktion aussieht, hier der vollständige Loop:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Starte den Agenten nun aus dem Projekt-Root mit python harness.py.
Das Script sendet die Aufgabe aus der messages-Liste an die API.
Das Harness erledigt die Arbeit und du solltest jede Iteration im Terminal sehen:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
Das Programm beendet sich, wenn das Modell ohne Tool-Call antwortet oder das 15-Iterationen-Limit erreicht wird.
Um dem Agenten eine andere Aufgabe zu geben, ändere den content-String in der initialen messages-Liste; ein produktives Harness würde ihn stattdessen aus input() oder einem Kommandozeilen-Argument lesen.
Die Ratsche ist der kontinuierliche Prozess, Agentenfehler zu diagnostizieren und dein Harness so zu aktualisieren, dass sie künftig ausbleiben.
Ein Harness verbessert sich strikt durch reale Edge-Cases.
Gehen wir einen kompletten Zyklus aus Fehlschlag und Fix durch, basierend auf einem realen Routenoptimierungsprojekt.
Stell dir vor, dein Agent importiert ständig eine veraltete interne Routing-Bibliothek namens legacy_route_math statt der aktualisierten Version.
Der Agent schreibt das Script, die Tests scheitern, und er steckt in einer Schleife, in der er Syntax fixt, statt die Bibliothek zu wechseln.
Die Diagnose ist hier eindeutig.
Der Agent weiß schlicht nicht, dass die Bibliothek veraltet ist. Das ist eine fehlende Regel, kein Versagen des neuronalen Netzes darunter.
Fix 1 aktualisiert die Speicherebene. Füge diese Regel zu AGENTS.md hinzu:
# Regeln
1. Niemals rm -rf verwenden. Nutze rm mit konkreten Dateinamen.
2. Schreibe keine Tests in die Hauptapplikationsdatei.
3. Wenn du die Aufgabe beendest, antworte mit einer Klartext-Zusammenfassung und ohne Tool-Call.
4. Importiere legacy_route_math nicht; es ist veraltet. Verwende stattdessen routes_v2.
Fix 2 fügt einen dauerhaften Durchsetzungs-Hook hinzu.
Regeln sind Ratschläge an den Agenten, Hooks sind Anweisungen. Dieser Fix sind ein paar Zeilen und kann neben post_edit_hook() hinzugefügt werden, solange er vor dem ReAct-Loop steht.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Registriere ihn neben dem Pytest-Hook im Tool-Execution-Block:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
So sieht Selbstkorrektur im Transcript aus, nachdem beide Fixes gelandet sind.
Der Agent schreibt die Datei, der Hook feuert, und im nächsten Zug behebt er den Import – ganz ohne Menschen in der Schleife:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
Das ist wichtig im Hinblick auf den Kontextverfall. Sehr lange Sessions mit degradierendem Kontext ignorieren irgendwann Memory-Regeln.
Die AGENTS.md-Regel verhindert den Fehler meist, und der Hook garantiert, dass – wenn die Regel verrutscht – der Fehler keinen Schaden anrichtet.
Jeder diagnostizierte Fehlschlag sollte zwei Fragen auslösen: Welche Regel fehlte, und welche Prüfung hätte ihn sowieso gefangen?
Best Practices im Agent-Harness-Engineering zielen darauf, Konfigurationen schlank zu halten und für zukünftige Modell-Upgrades zu designen.
Das Ziel ist ein Gerüst, das das Modell unterstützt, ohne es zu überfrachten.
Ich habe ein paar harte Lektionen gelernt, während ich verschiedene Agenten-Skills und Architekturen gebaut habe.
Ziele auf maximal 60 Zeilen für deine Kontextdatei.
Jede einzelne Regel muss auf einen realen, dokumentierten Vorfall zurückgehen. Wenn du dich an keinen Auslöser erinnern kannst, lohnt sich das Löschen.
Diese Disziplin ist wichtig, denn AGENTS.md bezahlst du in jedem Zug.
Ein 300-zeiliger Styleguide kostet bei jedem API-Call Tokens und verwässert die wichtigen Regeln, denn Modelle befolgen 10 scharfe Regeln deutlich besser als 80 vage.
Ein Datumsstempel kann sogar beim nächsten Tipp helfen, den ich empfehle.
Harnesses brauchen ständige Re-Architektur, wenn Basismodelle ihre nativen Fähigkeiten ausbauen.
Baue deine Komponenten so, dass du sie leicht entfernen kannst.
Das Hook-Pattern in diesem Tutorial ist genau deshalb modular.
Jeder Hook ist eine eigene Funktion, die per Einzeiler hinzugefügt wird. Wenn du den Hook deprecierst, löschst du eine Zeile im Loop.
Sonst ändert sich im Loop nichts.
Vergleiche das mit Validierungslogik, die direkt in den ReAct-Loop verwoben ist: Entfernst du dort einen veralteten Check, musst du den gesamten Orchestrierungspfad neu testen.
Was sich heute wie eine notwendige Krücke anfühlt, wird im nächsten Quartal unnötiger Overhead.
Wenn ein neues Modell erscheint, spiele deine alten Fehlfälle erneut durch, deaktiviere jeden Hook einzeln und betrachte jeden Hook, der nichts mehr abfängt, als Streichkandidaten.
Sieh dir Claude Code Best Practices für weitere Architektur-Tipps an.
Ein nackter ReAct-Loop mit Dateisystem und einem Bash-Tool ist bereits sehr praxisnah.
Widerstehe dem Drang, vorab ein komplexes Graphsystem mit schweren Frameworks zu bauen. Die Ratsche funktioniert nur in eine Richtung: vom beobachteten Fehler zum gezielten Fix. Spekulative Fixes verkehren das Prinzip.
Füge Custom-Hooks erst hinzu, nachdem du den genauen Fehler gesehen hast, der sie rechtfertigt. Für den Aufbau einfacher Systeme schau dir diesen Guide zu LLM-Agenten an.
Du kannst nicht nachschärfen, was du nicht siehst.
Unser Loop druckt bereits jeden Tool-Call – das ist die minimale Observability: Wenn ein Lauf scheitert, ist das gedruckte Transcript dein Diagnosematerial.
Wenn dein Harness reift, schreibe am Ende jedes Laufs die komplette Nachrichtenhistorie in eine JSON-Datei mit Zeitstempel.
Fehlgeschlagene Transcripts werden zu deiner Regression-Suite; nach jeder Harness-Änderung spielst du die alten Fehlaufgaben erneut ab und bestätigst, dass der Fix hält.
Das ist das Äquivalent eines Test-Suites für Harness-Engineers und trennt ein Harness, das besser wird, von einem, das sich nur verändert.
Agent-Harness-Engineering ist die praktische Realität, KI-Modelle zu nützlicher Arbeit zu bewegen.
Die Lücke zwischen dem, was heutige Modelle theoretisch können, und dem, was sie in Produktion tatsächlich leisten, ist größtenteils eine Harness-Lücke.
Diese Disziplin dreht sich nicht darum, ein bestimmtes Framework zu lernen.
Das richtige KI-Agent-Harness für deinen Code entsteht aus deiner individuellen Fehlerhistorie – schrittweise gebaut mit der Ratschenmethode.
Bereit, diese Konzepte in die Praxis zu bringen?
Sieh dir den Lernpfad AI Agent Fundamentals von DataCamp an, um produktionsreife Systeme weiter aufzubauen. Du kannst dir auch das Claude Agent SDK Tutorial für weitere praxisnahe Codebeispiele ansehen.
Vielleicht interessiert dich auch der Lernpfad AI for Software Engineering.
Top-DataCamp-Kurse
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Tutorial
Matt Crabtree
5 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Sejal Jaiswal
9 Min.




