
Curso
Muestreo en R
4 h
25.5K
En este artículo exploraremos una técnica clave en estadística y aprendizaje automático llamada bootstrapping. Su nombre viene de la expresión inglesa “pulling yourself up by your bootstraps”, porque el bootstrapping te permite hacer mucho con muy poco. Con bootstrapping puedes tomar una distribución de cualquier forma o tamaño, crear una nueva distribución de remuestras y usarla para aproximar la distribución de probabilidad real. Por eso es especialmente eficaz para asignar medidas de precisión como sesgo, varianza, intervalos de confianza y error de predicción a estimaciones muestrales.
Antes de empezar, si te interesa la ciencia de datos, echa un vistazo a estos cursos de DataCamp sobre ciencia de datos y estadística, como nuestro itinerario de habilidades Statistical Inference in R y el curso Foundations of Inference in Python.
Empecemos situando bien el bootstrapping entre los métodos de remuestreo. Aunque hay distintos tipos, comparten algo importante: imitan el proceso de muestreo. Recurrrimos al remuestreo porque no es práctico tomar nuevas muestras de nuestra población de interés constantemente, y el remuestreo actúa como un atajo.
Por ejemplo, si queremos entender algo sobre nuestra población objetivo, podríamos lanzar una encuesta y aspirar a mil respuestas. Sin embargo, nadie administrará la misma encuesta mil veces a la misma población. Por esta limitación práctica, usamos un método de remuestreo para generar estadísticas sobre nuestra muestra, como el error estándar.
Hay cuatro tipos principales de remuestreo. Merece la pena mencionarlos porque comparten una historia común de innovación y mejora estadística. En particular, el bootstrapping se ha desarrollado como extensión, modificación o mejora del método jackknife.
Conviene hablar del jackknife porque es el precursor del bootstrapping: el bootstrapping se introdujo como una extensión y mejora del jackknife, desarrollado en los años 50 cuando los ordenadores tenían alrededor de un kilobyte de memoria.
El jackknife es un método de dejar-una-fuera que calcula una estadística de interés de forma sucesiva o iterativa hasta que cada observación ha sido eliminada. Con jackknife, el número de remuestras se limita al número de observaciones y, en gran medida por ello, funciona algo peor con tamaños muestrales pequeños. También es limitado en cuanto a los tipos de datos que admite. En cambio, a diferencia del bootstrap, el jackknife es reproducible siempre.
El bootstrapping tiene un amplio abanico de aplicaciones en estadística y en aprendizaje automático. Uno de sus usos más comunes es estimar intervalos de confianza cuando se desconoce la distribución subyacente o cuando el tamaño muestral es pequeño. Esto lo hace especialmente valioso en situaciones donde los métodos paramétricos tradicionales no serían adecuados.
Además, se usa a menudo en contrastación de hipótesis y validación de modelos, donde ayuda a evaluar la solidez de las predicciones. En aprendizaje automático, el bootstrapping está en la base del conocido método de conjunto bagging, utilizado en modelos como los random forests para mejorar la precisión reduciendo la varianza.
Para ilustrar el bootstrapping, necesitamos un lenguaje como R porque nos permite generar múltiples conjuntos de datos remuestrados; sin un entorno de programación, el proceso sería demasiado lento y complejo para hacerlo a mano. En este artículo veremos cómo bootstrapear intervalos de confianza para una distribución y para una regresión lineal usando el conjunto de datos de Fish Market en Kaggle.
Antes de ver el bootstrapping en sí, conviene familiarizarse con el muestreo con reemplazo. En R base, la función sample() recibe al menos dos argumentos que debemos decidir explícitamente: x y size. x define la lista o rango de valores de los que elegimos la muestra y size define el tamaño muestral. Suele especificarse también el argumento replace. Si no se indica, el valor por defecto es replace = FALSE.
El bootstrapping es muestreo con reemplazo. Al muestrear con reemplazo, devolvemos el valor tras cada extracción. Cada extracción es independiente de la anterior. Al muestrear sin reemplazo, no devolvemos los valores: una vez seleccionado un valor, no puede volver a seleccionarse; por tanto, las extracciones no son independientes y lo obtenido en una afecta a la siguiente. Como consecuencia, no podemos elegir un tamaño muestral mayor que la longitud del vector de entrada salvo que indiquemos replace = TRUE. Con el bootstrapping este problema no existe y podemos generar un conjunto remuestrado mucho mayor que el original.
sample_without_replacement <- sample(x = 1:10, size = 10) # replace = FALSE as defaultsample_with_replacement <- sample(x = 1:10, size = 10, replace = TRUE)sample_with_replacement_and_weighted_probability <- sample(x = c(1, 0), size = 10, replace = TRUE, prob = c(0.8, 0.2))Descarguemos ahora el dataset y leámoslo desde la carpeta de descargas en RStudio con la función read.csv().
fish_df <- read.csv('~/Downloads/FISH.csv')Para empezar, creemos un histograma de la raíz cuadrada del peso del pez para ver la distribución. Como se observa, está lejos de ser normal o gaussiana. Si acaso, es algo bimodal.
fish_df <- fish_df %>% mutate(sqrt_Weight = sqrt(Weight))ggplot(fish_df, aes(x = sqrt(Weight))) + geom_histogram(color = 'black', fill = '#ef8a47', alpha = 0.75) + labs(title = "Fish", subtitle = "Histogram of Weight")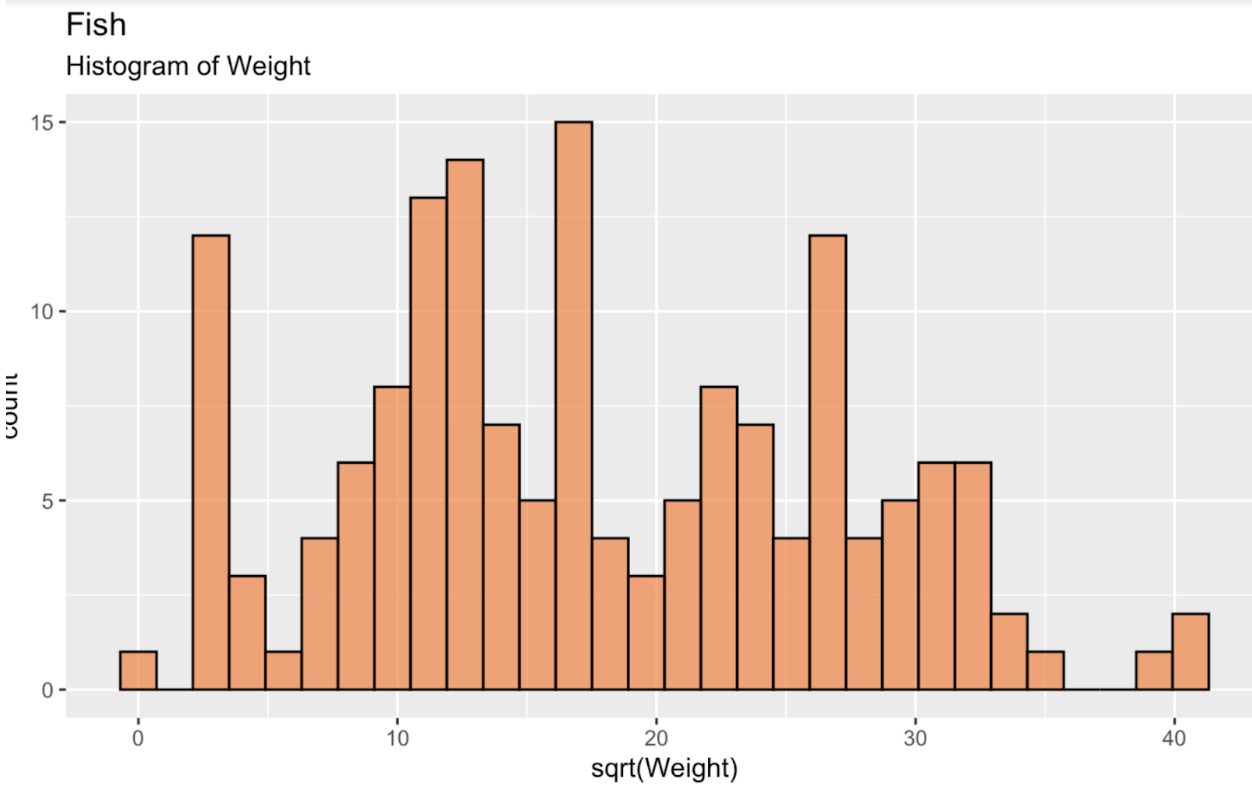
Histograma del peso del pez. Imagen del autor.
Podemos hacer bootstrapping en R con el paquete infer de tidymodels. Al imprimir esta tabla en la consola obtenemos un data frame con la estadística deseada para cada réplica. Al crear una nueva distribución de estas réplicas, esta seguirá aproximadamente una normal de la que podemos extraer intervalos de confianza.
library(tidymodels)fish_df %>% dplyr::select(sqrt_Weight) %>% specify(response = sqrt_Weight) %>% generate(reps = 10000, type = 'bootstrap') %>% calculate(stat = 'mean') -> fish_bootstrapped_ci_dfggplot(fish_bootstrapped_ci_df, aes(x = stat)) + geom_histogram(color = 'black', fill = '#ef8a47', alpha = 0.75) + labs(title = "Fish", subtitle = "Histogram of Weight")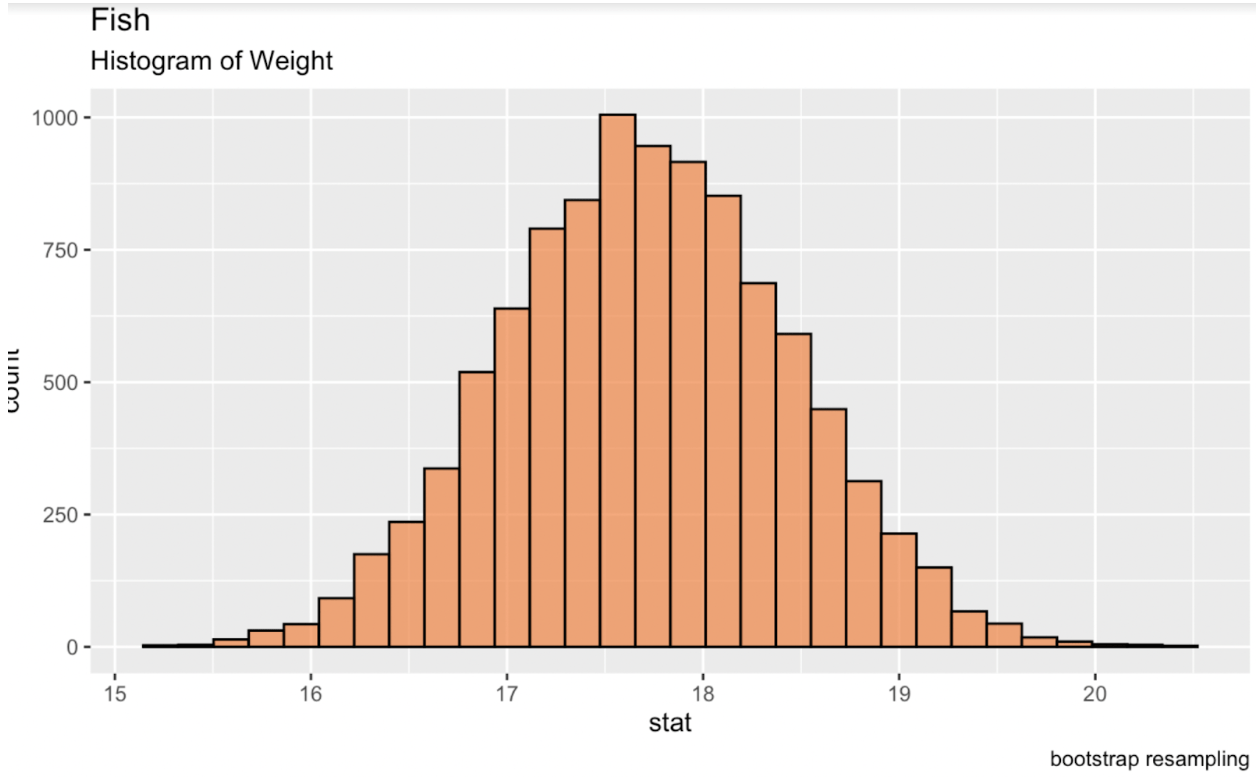 Histograma de la media bootstrapeada del peso del pez. Imagen del autor.
La regresión lineal, piedra angular del modelado estadístico, se usa para mostrar la relación entre una o más variables independientes y una dependiente. Cuando trabajamos con modelos de regresión, es habitual evaluar la incertidumbre de las estimaciones. Una forma de hacerlo es calculando intervalos de confianza, que aportan un rango de valores en el que probablemente caiga el parámetro verdadero, como la media. Aquí crearemos intervalos de confianza con bootstrapping y también con el método de aproximación normal, conocido como intervalo de confianza de Wald.
En el contexto de la regresión lineal, el remuestreo bootstrap consiste en muestrear aleatoriamente del conjunto de datos para crear múltiples muestras bootstrap. Ajustamos un modelo de regresión a cada muestra y, a partir de la distribución de los coeficientes, estimamos los intervalos de confianza. En el siguiente código, usamos la función bootstraps() de tidymodels para remuestrear nuestro dataset. Luego creamos histogramas para mostrar el rango de valores presentes en las remuestras para el intercepto y el coeficiente de peso.
boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)ggplot(boot_coefs, aes(estimate)) + geom_histogram(bins = 30) + facet_wrap( ~ term, scales = "free") + labs(title="fish", subtitle = "Height ~ Square Root of Weight") + labs(caption = "95% confidence interval parameter estimates, intercept + estimate") + geom_vline(aes(xintercept = .lower), data = percentile_intervals, col = '#528fad') + geom_vline(aes(xintercept = .upper), data = percentile_intervals, col = '#528fad')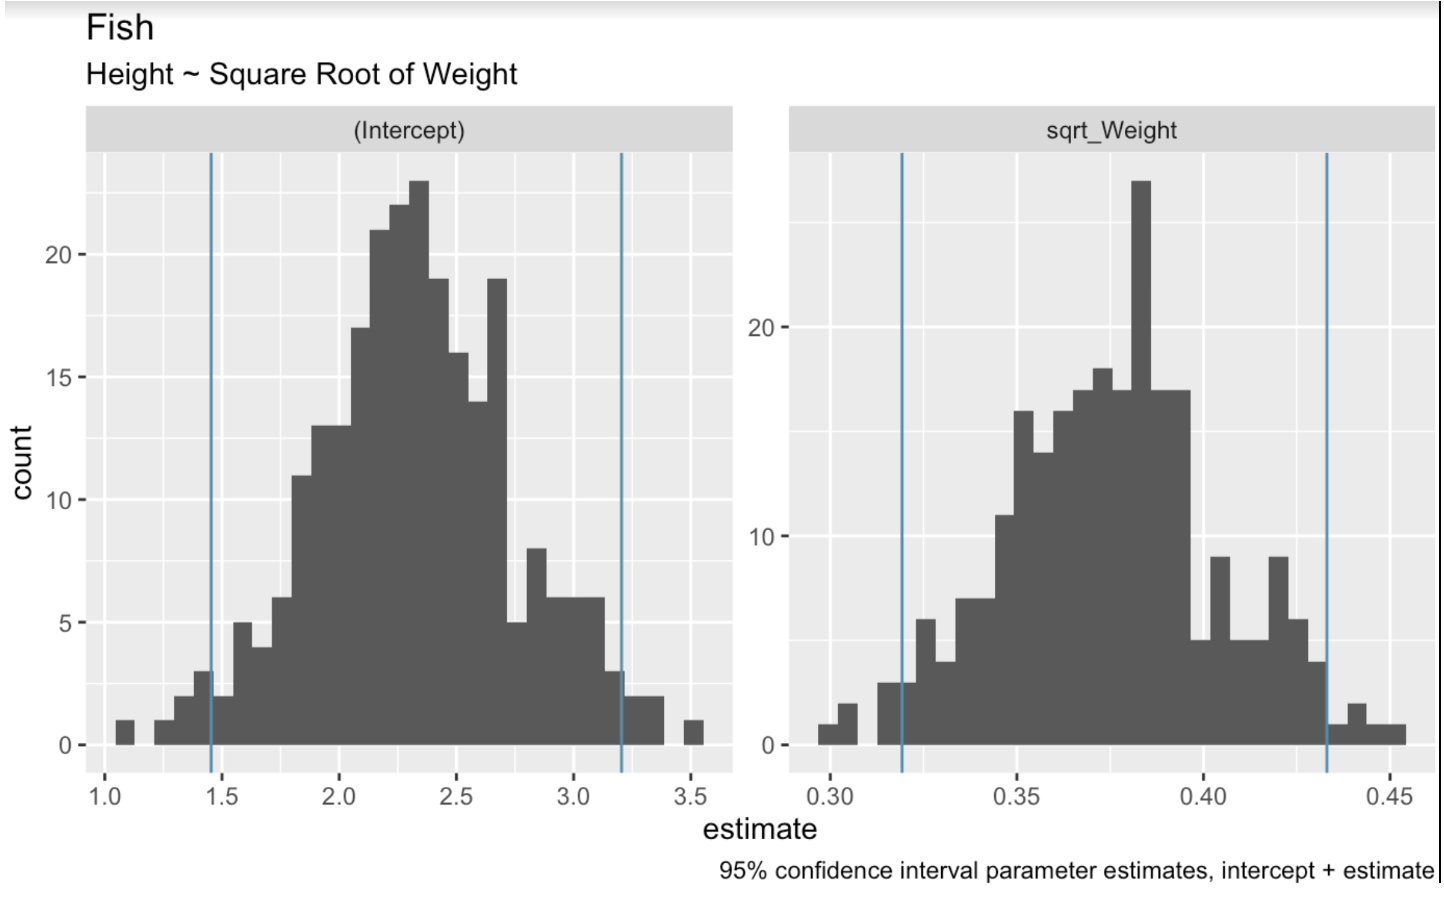
Coeficientes bootstrapeados del modelo lineal. Imagen del autor.
Al graficar las posibles rectas de regresión, recortaremos las más extremas por ambos lados para obtener un intervalo del 95%. La función int_pctl() lo facilita.
boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)boots <- bootstraps(fish_df, times = 250, apparent = TRUE)fit_lm_on_bootstrap <- function(split) { lm(Height ~ sqrt_Weight, analysis(split))}boot_models <- boots %>% dplyr::mutate(model = map(splits, fit_lm_on_bootstrap), coef_info = map(model, tidy))boot_coefs <- boot_models %>% unnest(coef_info)percentile_intervals <- int_pctl(boot_models, coef_info)boot_aug <- boot_models %>% sample_n(50) %>% mutate(augmented = map(model, augment)) %>% unnest(augmented)Como último paso, creemos ahora los intervalos de confianza que se obtienen con ecuaciones más teóricas y en forma cerrada. Podemos encontrar los parámetros con summary() aplicado al objeto del modelo lineal.
linear_model <- lm(Height ~ sqrt(Weight), fish_df)summary(linear_model)Call:lm(formula = Height ~ sqrt(Weight), data = fish_df)Residuals: Min 1Q Median 3Q Max-7.7425 -1.3611 -0.5628 2.2606 5.0131Coefficients: Estimate Std. Error t value Pr(>|t|)(Intercept) 2.31506 0.43636 5.305 3.77e-07 ***sqrt(Weight) 0.37569 0.02186 17.183 < 2e-16 ***---Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1Residual standard error: 2.533 on 157 degrees of freedomMultiple R-squared: 0.6529, Adjusted R-squared: 0.6506F-statistic: 295.3 on 1 and 157 DF, p-value: < 2.2e-16Aquí, el coeficiente estimado para sqrt_Weight es 0,37569. Su error estándar es 0,02186. Los grados de libertad son 157 (159 observaciones menos dos parámetros estimados). Y el valor t para un intervalo de confianza bilateral del 95% es 1,975189. Este último número lo obtenemos con la función qt(): qt(0.975, 157). En la visualización de abajo, las líneas azules son las regresiones lineales bootstrapeadas y las líneas rojas discontinuas el intervalo de confianza generado por la fórmula analítica habitual.
# Wald confidence interval(CI_upper <- 0.37569 + 1.975 * 0.02186)(CI_lower <- 0.37569 - 1.975 * 0.02186)(CI_intercept_upper <- 2.31506 + 1.975 * 0.43636)(CI_intercept_lower <- 2.31506 - 1.975 * 0.43636)ggplot(boot_aug, aes(sqrt_Weight, Height)) + geom_line(aes(y = .fitted, group = id), alpha = .3, col = '#528fad') + geom_point(alpha = 0.005) + labs(title="fish", subtitle = "Height ~ Weight") + labs(caption = "linear regression bootstrap resampling") + geom_abline(intercept = 1.453249, slope = 0.4188635, linetype = "dashed", color = "#e76254") + geom_abline(intercept = 3.176871, slope = 0.3325165, linetype = "dashed", color = "#e76254")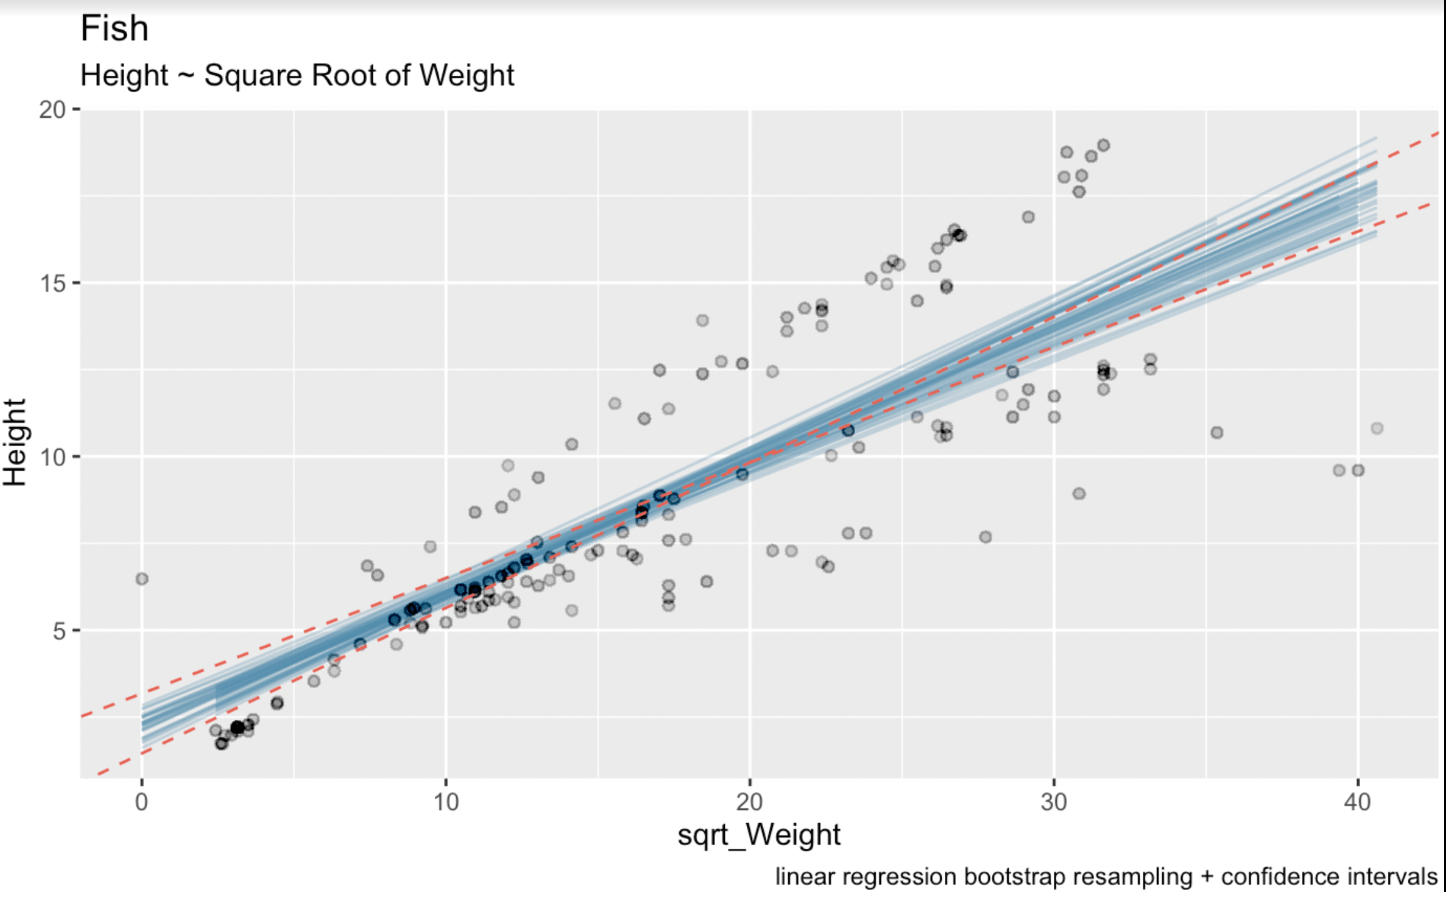
Regresiones lineales bootstrapeadas con intervalos de confianza. Imagen del autor.
Aquí se ve claramente que el proceso de remuestreo bootstrap ha introducido algo más de incertidumbre en la estimación. Esto se debe a que los intervalos para los coeficientes de regresión lineal se calcularon con fórmulas teóricas basadas en supuestos sobre la distribución de los errores y las propiedades del estimador, como normalidad de los errores y varianza constante.
El remuestreo bootstrap, en cambio, es libre de distribución: hace supuestos mínimos sobre la distribución subyacente. En su lugar, estima directamente la distribución muestral de la estadística de interés remuestreando a partir de los datos observados. Como resultado, los intervalos de confianza bootstrap pueden ser más robustos y fiables cuando se violan los supuestos de los métodos tradicionales o cuando trabajamos con muestras pequeñas, como en nuestro Fish Market con 159 observaciones.
En el bootstrapping paramétrico se asumen ciertas formas para la distribución subyacente de los datos y se generan remuestras basadas en esos supuestos. Es útil cuando tienes conocimiento previo o supuestos sólidos sobre la distribución. Piensa en un muestreo que quizá no sea normal, pero se conoce bien el mecanismo generador de los datos y puedes construir una distribución usando parámetros de la población.
El bootstrapping no paramétrico, en cambio, no hace supuestos sobre la distribución. Remuestrea directamente de los datos observados con reemplazo, lo que es especialmente valioso cuando la distribución real es desconocida o difícil de definir. En el ejemplo anterior usamos bootstrapping no paramétrico. Ambos permiten estimar estadísticas como errores estándar e intervalos de confianza. Sin embargo, el no paramétrico ofrece más flexibilidad para datos reales, sobre todo con muestras pequeñas o complejas, y es el más usado en la práctica.
En la previsión de series temporales, el bootstrapping puede aplicarse para remuestrear datos históricos y generar predicciones futuras, proporcionando una distribución de posibles resultados en lugar de una sola estimación puntual. Así modelamos el rango de escenarios futuros y creamos intervalos de confianza para las predicciones. El bootstrapping también sustenta métodos de conjunto como el bagging en modelos de series temporales, que pueden reducir el sobreajuste y mejorar la precisión global de la previsión al combinar múltiples modelos. Nuestro curso Forecasting in R te enseñará a remuestrear en pronósticos de series temporales, ya uses modelos ARIMA u otros métodos.
Espero que el bootstrapping te haya ganado, si aún no lo había hecho. Como hemos visto, es una herramienta potente tanto en estadística como en aprendizaje automático, y ofrece una forma atractiva de estimar la variabilidad y la confianza de las medidas estadísticas sin requerir supuestos fuertes sobre los datos subyacentes.
Plantéate empezar nuestro itinerario de carrera Machine Learning Scientist in Python y domina el trabajo con tipos de distribución y conjuntos de datos complejos. Nuestro itinerario de habilidades Statistical Inference in R es otra gran opción, con foco en contrastes de hipótesis, aleatorización y medición de la incertidumbre.
Aprende con DataCamp
Curso
Curso
programa