

在 Excel 中计算偏度的方法
设想您是一名数据分析师,负责分析一家热门零售连锁店的顾客等待时间。公司在不同门店的顾客满意度不一,管理层怀疑结账时的长等待时间可能是原因之一。
为此,他们抽样收集了某家门店几天内的顾客等待时间数据。
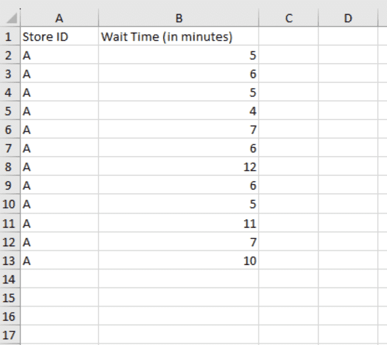
顾客等待时间数据集。图片作者自制
在分析顾客等待时间的过程中,您意识到计算偏度指标将提供有用见解。以下是两种在 Microsoft Excel 中计算偏度的可用方法。
使用 SKEW() 函数
该函数计算样本的偏度程度。以下是 SKEW() 函数的语法:
SKEW(number1, [number2], ...)对于 SKEW() 函数,我们最多可包含 255 个参数,每个参数可以是单个数据点或数据点数组。
针对手头的数据,我们可在某个单元格(例如 F2)中输入如下公式:
=SKEW(B2:B13)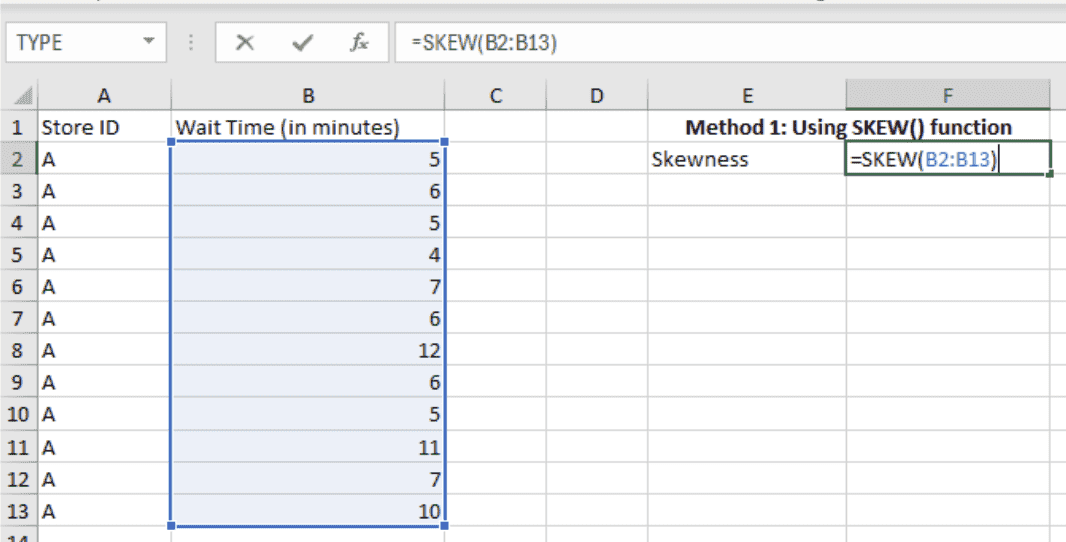
使用 SKEW() 函数计算偏度。图片作者自制
接着,在该单元格按下Enter,即可看到计算出的偏度系数:
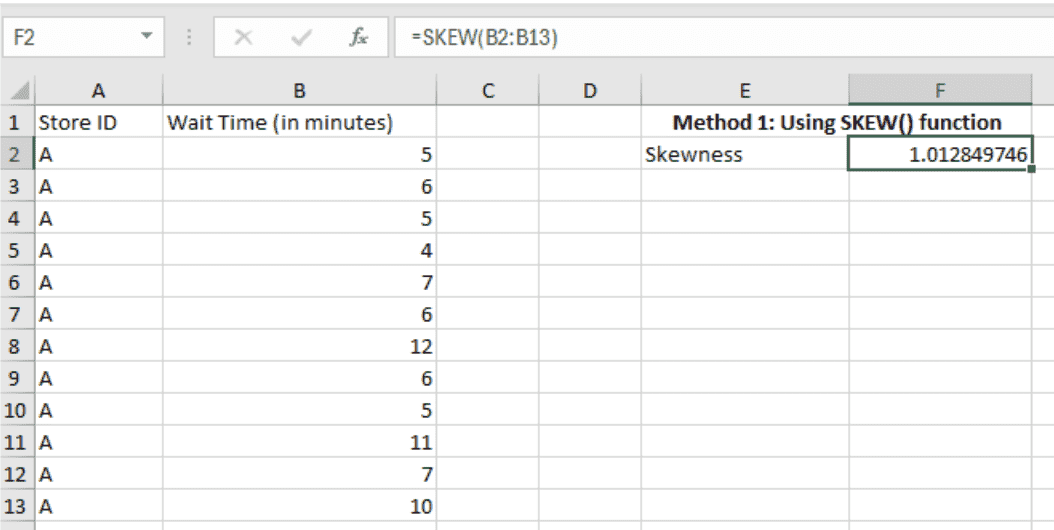 偏度结果。图片作者自制
正值输出表明等待时间呈右偏分布。在解读该数值前,我们再看另一种计算偏度的方法。
使用数据分析工具库(Toolpak)
数据分析工具库是 Microsoft Excel 的一款额外加载项,帮助计算数据分析任务中常用的指标。
由于该加载项默认未启用,您需要在 Excel 工作簿右上方的数据选项卡下,检查是否有数据分析图标,如下所示。
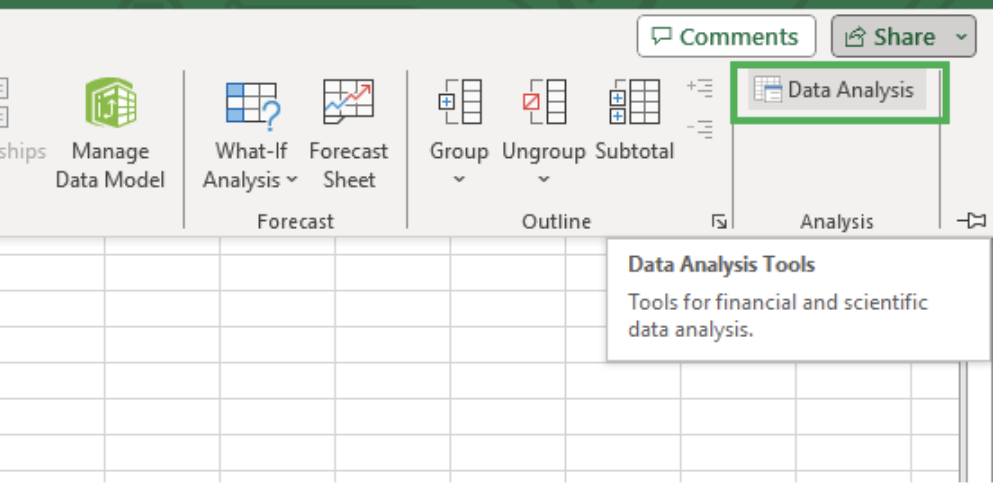
Excel 中的数据分析工具库。图片作者自制
如果看不到该图标,说明尚未启用。要启用它,从菜单中点击文件并选择选项。
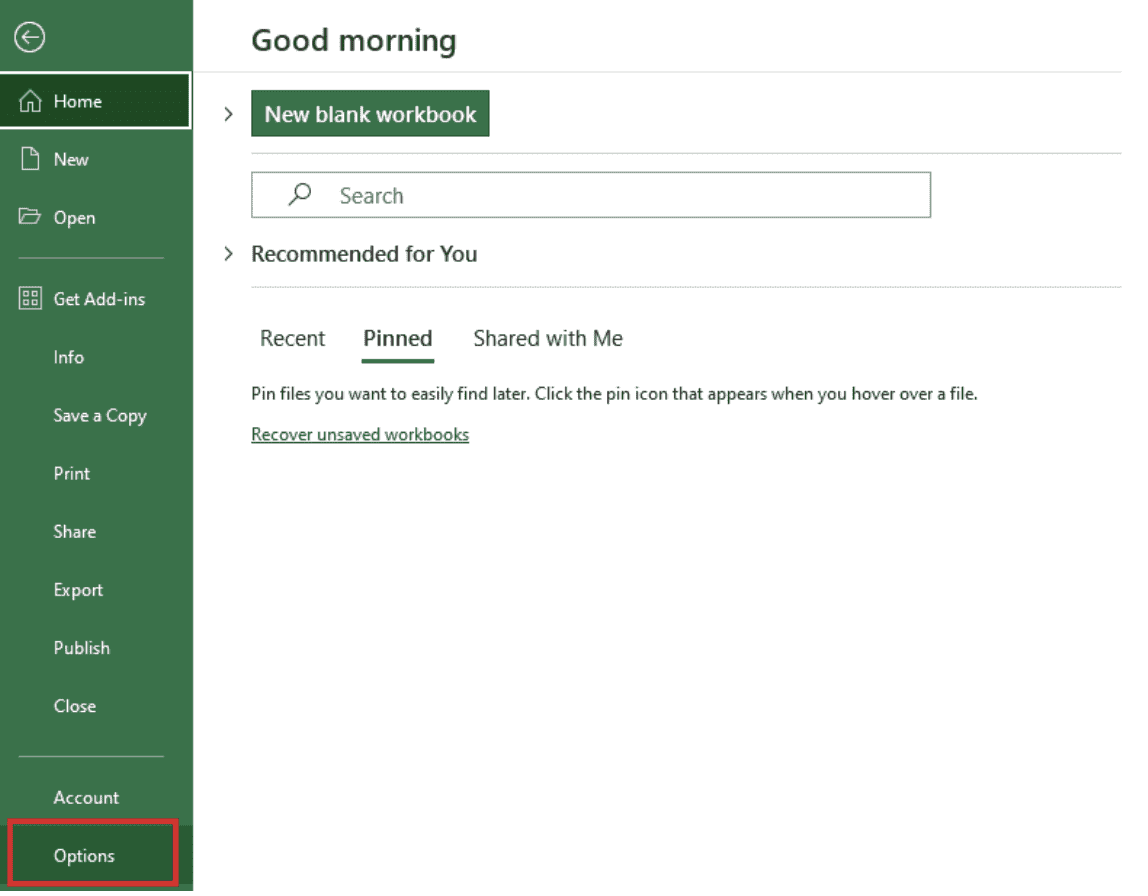
在“文件”选项卡中选择“选项”。图片作者自制
当Excel 选项对话框打开后,选择加载项。
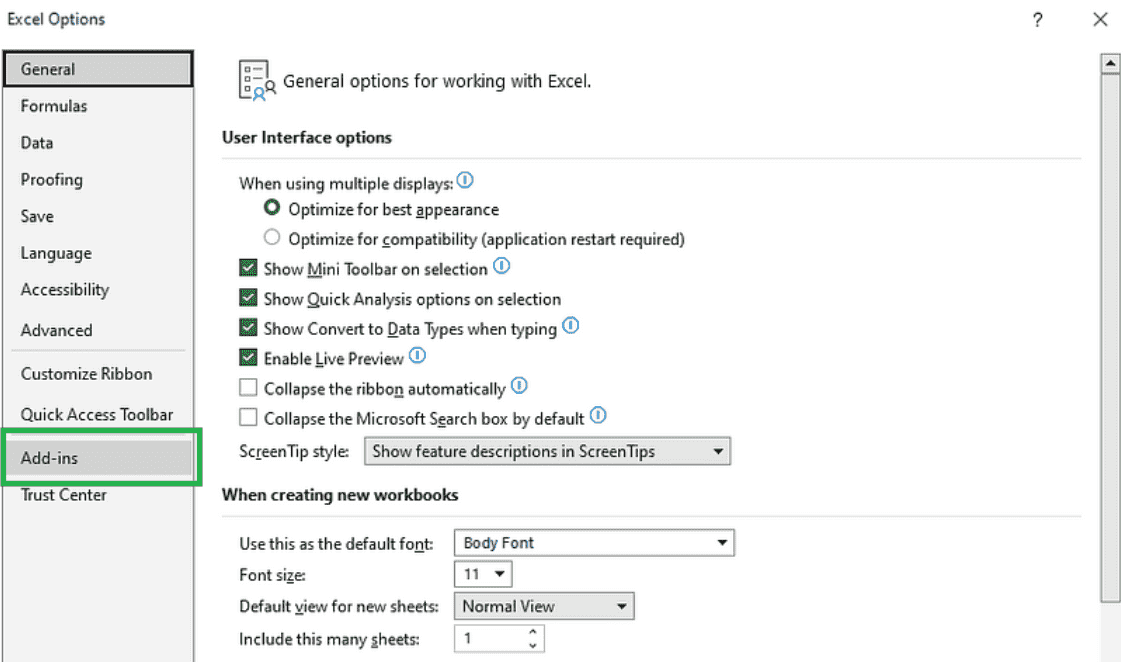
在 Excel 选项对话框中选择加载项。图片作者自制
接着,在底部的管理框中选择 Excel 加载项,然后点击转到。
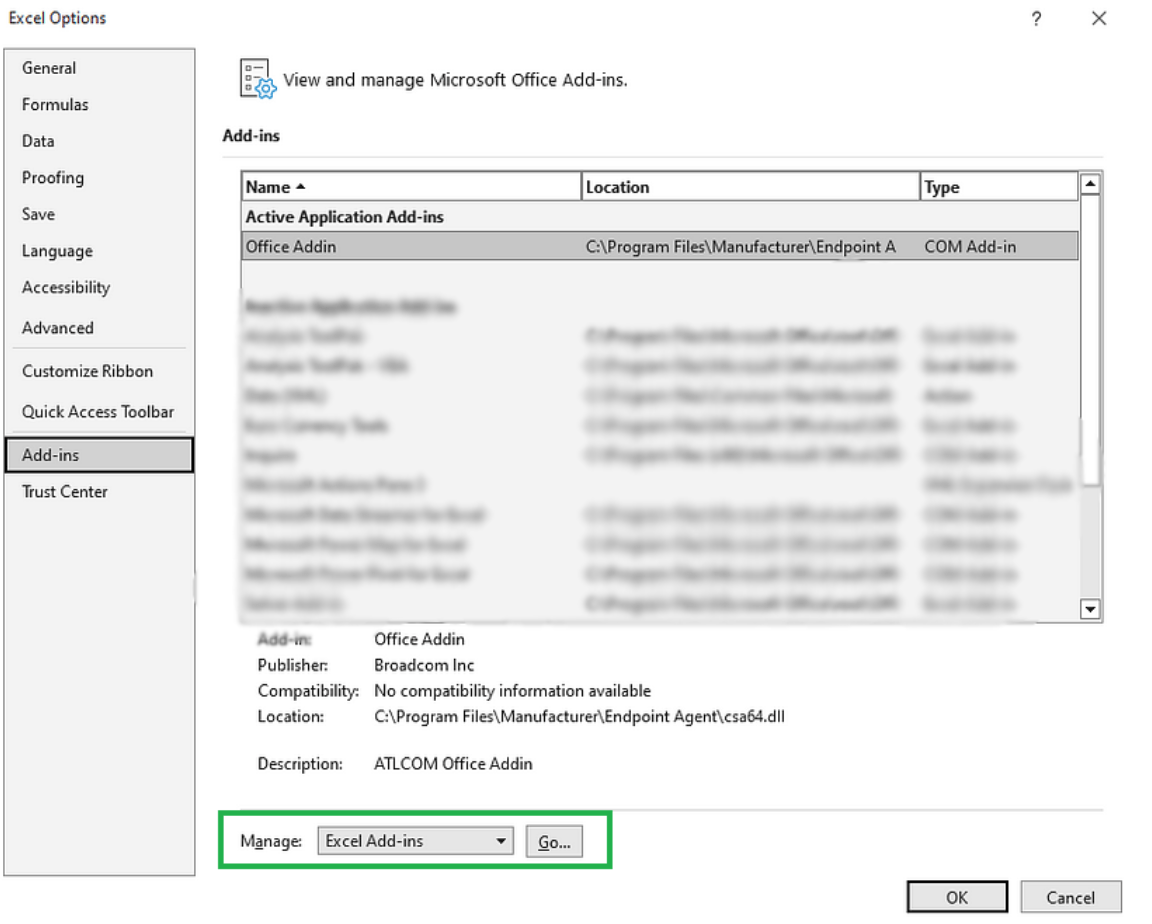 管理 Excel 加载项。图片作者自制
当加载宏对话框打开后,勾选分析工具库,然后点击确定。
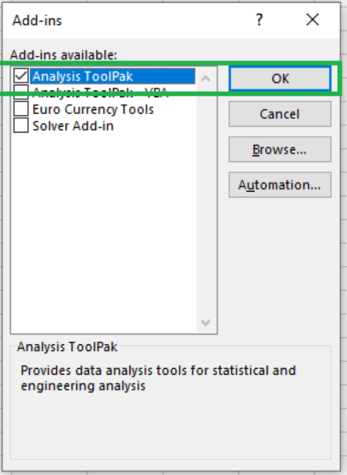
启用数据分析工具库。图片作者自制
现在,数据选项卡下会显示数据分析图标。启用加载项是一次性操作,无需重复。
使用已启用的加载项计算偏度的第一步是选择数据点范围(包含列标题),然后点击数据分析图标,如下所示。
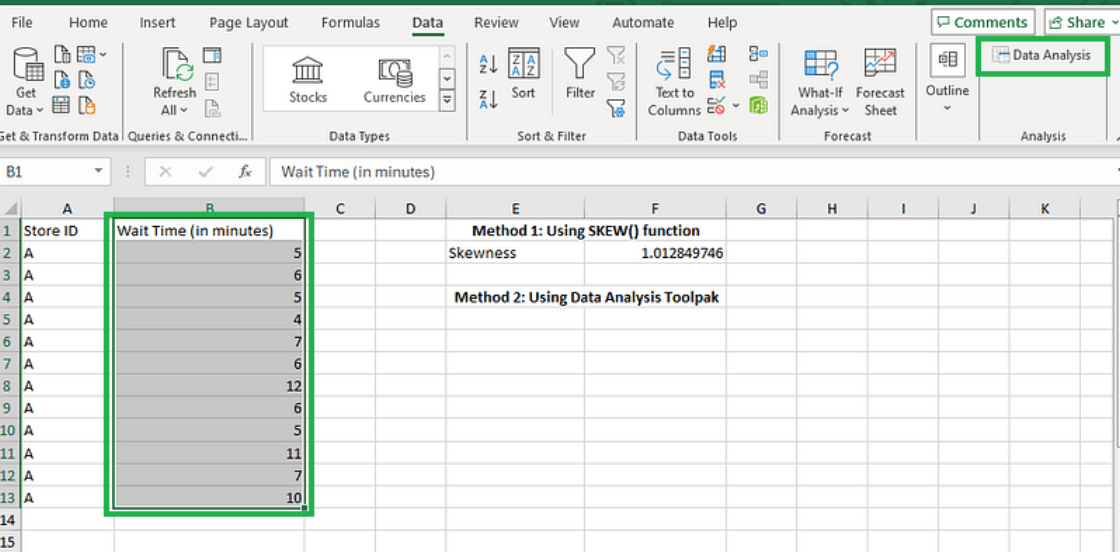
调用数据分析工具库加载项。图片作者自制
接下来,在对话框中选择描述统计并点击确定。
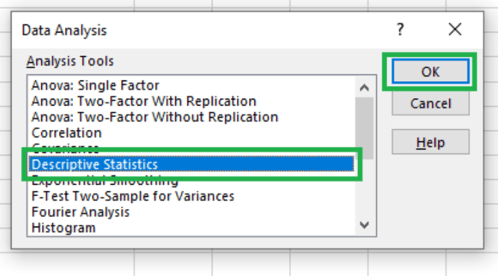
选择描述统计。图片作者自制
随后会出现如下对话框。
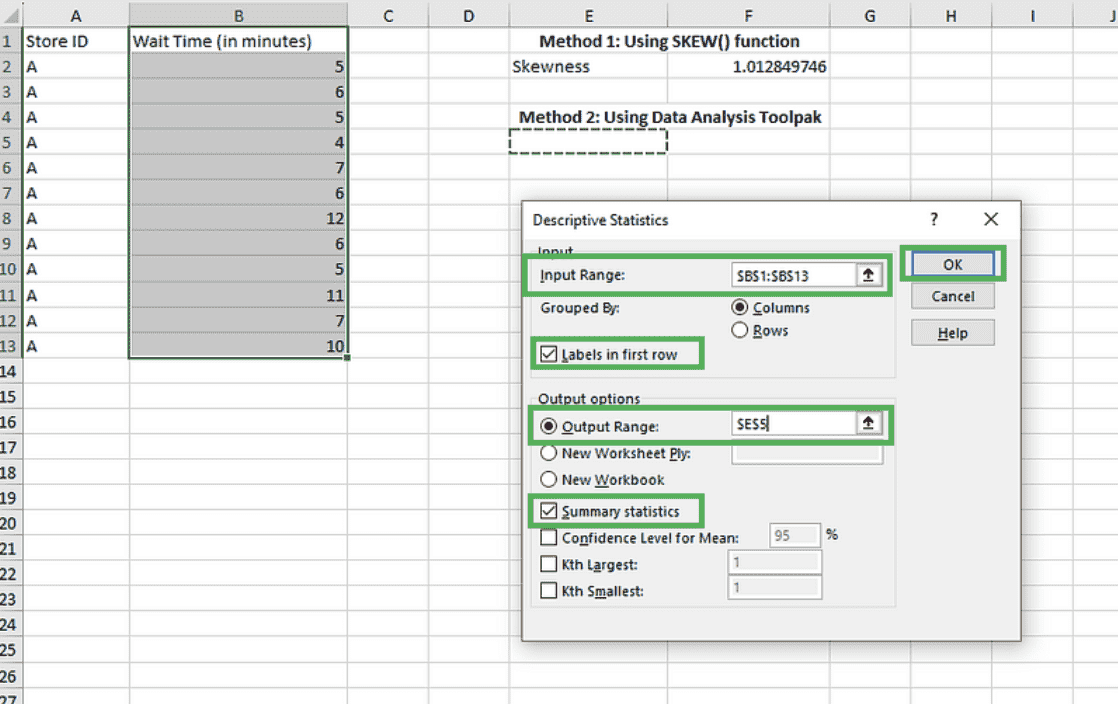 填写描述统计的参数。图片作者自制
输入区域已预先填充,因为我们在调用加载项前已选择。勾选“第一行包含标签”,输出区域选择同一工作表中的一个单元格,例如 $E$5。勾选“汇总统计信息”,其中包含偏度指标。
点击确定,即可在同一工作表中查看计算结果。
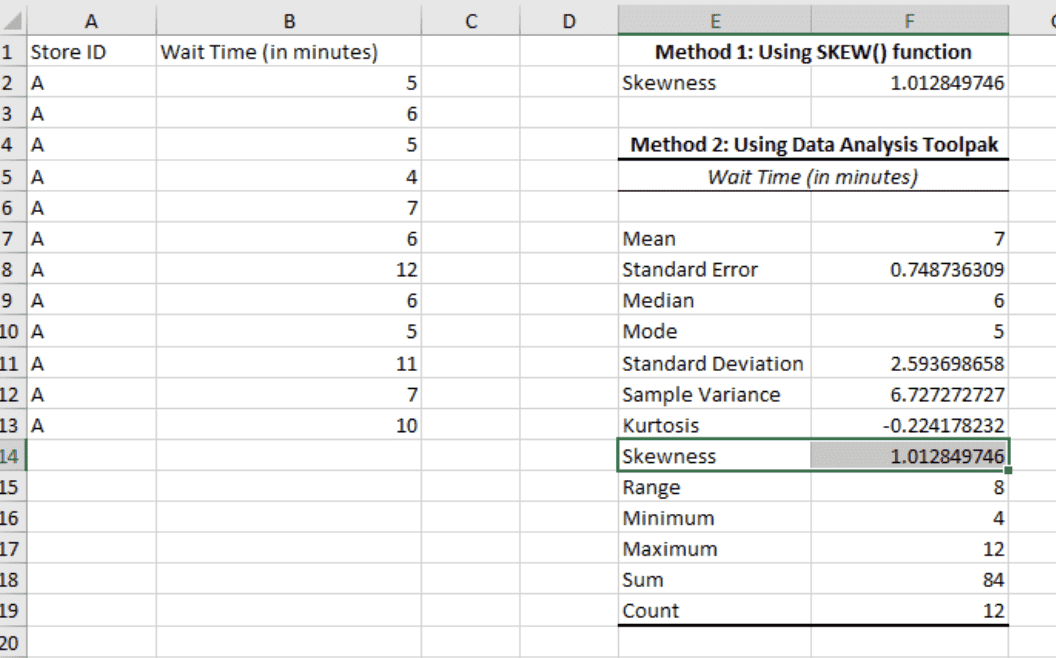 描述统计结果。图片作者自制
就是这样!您已一次性计算出偏度和其他有用的描述性统计。
如果您想进一步了解数据分析工具库,请查看我们的教程在 Excel 中使用 ANOVA 的全指南,其中提供了另一个实用示例。
解读偏度结果
既然我们已经得到偏度和其他描述统计,就可以对该样本数据进行解读,挖掘一些有用见解。
- 右偏分布:使用两种方法,我们都得到顾客等待时间的偏度值为 1.0128,表明分布右偏(正偏)。这意味着数据中存在异常高等待时间的离群值。
- 均值与中位数:平均等待时间高于中位数。这表明尽管大多数顾客的等待时间相对较短,但有不少情况等待时间明显更长,从而拉高了平均值。因此,中位数可能是更好的中心位置度量。
- 业务洞察:等待时间的众数为 5 分钟,这是最常见的等待时间,说明大多数顾客能较快得到服务。然而,右偏的存在以及 8 分钟的极差突显等待时间存在显著波动。管理层应着力减少这些波动,以提升整体顾客满意度。
假设得到的偏度系数为负——您的解读会如何改变?以下是对顾客等待时间出现负偏时的解读方式。
- 左偏分布:负偏度值表明顾客等待时间呈左偏分布,分布左侧(较低数值)的尾部比右侧更长。
- 低值离群点:这说明数据的大部分集中在较高区间,但存在少数极低等待时间的低值离群点。
- 业务洞察:顾客等待时间的负偏分布可能表明在大多数时间里运营较为高效。不过,仍需探索导致这些异常低值的因素,因为这些因素可能揭示出可在更广范围内借鉴的效率或运营做法,从而改进整体服务。
请记住,计算能与偏度互为补充的其他描述统计有助于强化我们的结论。这在数据分析中是常见做法。
深入了解 Excel 偏度函数的原理
在大多数实际应用中,尤其是在一般统计分析或 Excel 等软件工具中,常使用矩偏度,因为其鲁棒且全面。除非数据集的特性或分析目标另有要求,它通常是默认选择。
矩偏度(momental skewness),也称为第三标准化矩,是用于量化数据分布相对于其均值不对称性的一种统计度量。
理论定义是:将度量偏离均值立方的第三中心矩,除以标准差的立方。然而,在对来自更大总体的样本进行分析,尤其是在实际数据分析场景中,样本偏度的推导公式为:
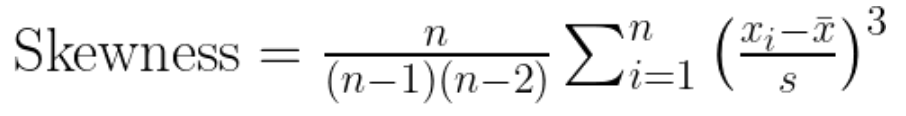
矩偏度公式。图片作者自制
其中:
- n 为数据点数量。
- Xi 为每个数据点。
- xˉ 为数据点的均值。
- s 为数据点的标准差。
延伸阅读:其他类型的偏度
皮尔逊(Pearson)的偏度系数
皮尔逊的偏度度量包含两个系数,分别使用众数和中位数。
先来看皮尔逊第一偏度系数(众数偏度)。它将众数与均值作比较,并用标准差对该差异进行标准化。公式为:
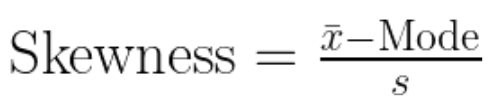 众数偏度公式。图片作者自制
其中:
- xˉ 为数据点的均值。
- s 为数据点的标准差。
由于在许多数据集中很难准确确定众数,该偏度版本使用较少。
再来看皮尔逊第二偏度系数(中位数偏度)。它通过比较中位数与均值,并以标准差进行缩放来量化分布的不对称性。公式为:
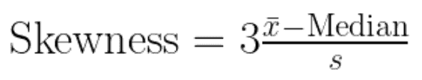 中位数偏度公式。图片作者自制
其中:
- xˉ 为数据点的均值。
- s 为数据点的标准差。
由于该度量使用中位数,因此更不受离群值影响,能提供更稳健的偏度指标。
凯利(Kelly)的偏度度量
凯利偏度度量基于数据的分位数。它根据中位数在第 10 和第 90 百分位之间的位置来衡量分布的不对称性。
凯利偏度的公式为:
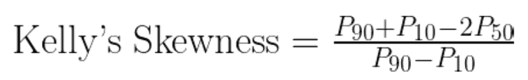 凯利偏度公式。图片作者自制
其中:
- P90 为第 90 百分位。
- P10 为第 10 百分位。
- P50 为中位数(第 50 百分位)。
凯利偏度关注分布的尾部,对于理解那些极端值尤为重要的数据集的偏度很有用。
鲍利(Bowley)的偏度度量
鲍利偏度(亦称四分位偏度系数)基于四分位数来衡量分布的偏度。其公式为:
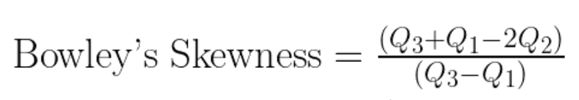
鲍利偏度公式。图片作者自制
其中:
- Q1 为第一四分位数(第 25 百分位)。
- Q2 为第二四分位数(中位数,第 50 百分位)。
- Q3 为第三四分位数(第 75 百分位)。
该度量对极端值不太敏感,基于四分位间距提供了稳健的偏度测度。
结语
本教程向您介绍了偏度的多个定义和概念。通过一个简单示例,我们学习了在 Excel 中计算偏度的多种方法并对结果进行了阐释。
学习不必止步于此。面向初学者的统计学入门课程全面涵盖数据分析中常用的统计技术和指标。Excel 基础学习路径非常适合深入掌握使用 Excel 开展类似分析任务,而Excel 公式速查表也可作为快速参考。
学习愉快!

作为一名高级数据科学家,我设计、开发并部署大规模机器学习解决方案,帮助企业做出更明智的数据驱动决策。作为数据科学写作者,我分享所学心得、职业建议以及深入的实践型教程。
常见问题解答
Excel 中 SKEW() 与 SKEW.P() 有何区别?
SKEW() 函数用于计算总体样本的偏度,并包含对样本量的调整。SKEW.P() 函数用于计算整个总体的偏度,不包含此类调整。
偏度能用于识别数据中的离群值吗?
是的,偏度可以帮助识别离群值,尤其当偏度值显著偏高或偏低时,这表明分布的尾部可能包含离群点。
如何解读在 Excel 中计算得到的偏度值?
偏度值接近零表明围绕均值对称的分布。正值表示右偏分布,尾部延伸至较高数值;负值表示左偏分布,尾部延伸至较低数值。
为什么在计算偏度时,Excel 会给出 #VALUE! 错误?
当偏度函数的范围包含诸如文本或布尔值等非数值条目时,会出现#VALUE! 错误。请确保范围内所有单元格仅包含数值数据以避免该错误。
为什么在尝试计算偏度时,Excel 会给出 #DIV/0! 错误?
当数据集中数据点少于三个,或数据的标准差为零时,在 Excel 中计算偏度会出现#DIV/0! 错误。请确保您的数据集至少包含三个且彼此不同的数值条目,以避免该错误。
理解偏度有助于识别数据中的潜在离群值或异常,这可能表明数据质量问题或需要进一步调查的领域。偏度还能揭示数据的不对称性,这会影响统计方法和后续模型的选择。因此,在分析项目中理解底层数据的偏度至关重要。
在本教程中,我们将学习偏度的概念、其数学定义,以及数据分布中不同类型的偏度。借助一个简单的真实示例,我们将使用 Microsoft Excel 计算偏度并解读结果。如果在本教程结束后,您希望继续提升技能,建议探索我们的Excel 数据分析课程。
快速答案:如何在 Excel 中计算偏度
要在 Excel 中计算偏度,可使用
SKEW()函数或SKEW.P()函数。按以下步骤操作:
=SKEW(range)或=SKEW.P(range),其中range是您的数据单元格范围。使用 SKEW() 函数计算偏度。图片作者自制
SKEW()函数假设提供的数据是总体的一个样本。它以n−1为分母,其中n为数据点数量。这被称为贝塞尔校正(Bessel's correction)。SKEW.P()函数用于计算整体总体的偏度。它以n为分母,而非n-1。什么是偏度?
偏度是一种衡量分布不对称性的统计指标。它指示数据点是否更倾向于落在均值的一侧。
分布的四阶矩包括:
偏态分布
根据偏度系数为正、为负或为零,偏度有三种类型。
偏态分布。来源:维基百科
偏度关注分布的扩散程度(尾部),而另一统计指标峰度更关注高度。它告诉我们正态(或近似正态)分布有多尖或多平。两者结合可同时突出数据集中的不对称性和偏离程度。我们的另一篇教程理解偏度与峰度及其可视化解释了为何这两个指标常结合使用,以完整刻画数据分布。
既然我们已经理解了偏度的概念及其类型,接下来用 Excel 为样本数据计算偏度。