
कोर्स
Excel में Data Analysis
3 घंटा
153.3K
Skewness को समझना डेटा में संभावित आउटलाईयर या विसंगतियों की पहचान करने में मदद कर सकता है, जो डेटा गुणवत्ता की समस्याओं या आगे जांच की आवश्यकता वाले क्षेत्रों का संकेत हो सकते हैं। Skewness डेटा की असममिति के बारे में अंतर्दृष्टि भी प्रदान करता है, जो सांख्यिकीय विधियों और डाउनस्ट्रीम मॉडलों के चयन को प्रभावित करता है। इसलिए, किसी भी विश्लेषिकी परियोजना में अंतर्निहित डेटा की skewness को समझना महत्वपूर्ण है।
इस ट्यूटोरियल में, हम skewness की अवधारणा, इसकी गणितीय परिभाषाएँ, और डेटा वितरणों में skewness के विभिन्न प्रकारों को सीखेंगे। एक सरल वास्तविक-जीवन उदाहरण का उपयोग करते हुए, हम Microsoft Excel के जरिए skewness की गणना करेंगे और परिणामों की व्याख्या करेंगे। यदि इस ट्यूटोरियल के अंत में आप अपने कौशल को और बढ़ाना चाहते हैं, तो हमारे Data Analysis in Excel पाठ्यक्रम को देखें।
Excel में skewness की गणना करने के लिए, SKEW() या SKEW.P() फ़ंक्शन का उपयोग करें।
इन चरणों का पालन करें:
=SKEW(range) या =SKEW.P(range) टाइप करें, जहाँ range आपके डेटा सेल्स की रेंज है।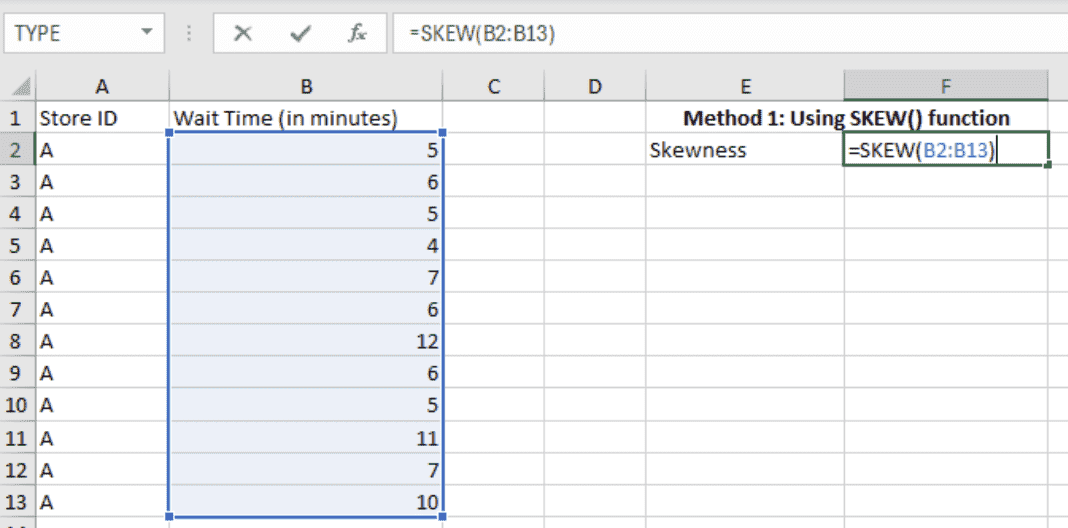
SKEW() फ़ंक्शन का उपयोग करके skewness की गणना। चित्र: लेखक
SKEW() फ़ंक्शन मानता है कि दिया गया डेटा पूरी जनसंख्या के एक सैम्पल का प्रतिनिधित्व करता है। यह n−1 से भाग देता है, जहाँ n डेटा बिंदुओं की संख्या है। इसे Bessel का सुधार (Bessel's correction) कहते हैं।
SKEW.P() फ़ंक्शन पूरी जनसंख्या की skewness की गणना करता है। यह n से भाग देता है, न कि n-1 से।
Skewness एक सांख्यिकीय मीट्रिक है जो किसी वितरण की असममिति को मापता है। यह दर्शाता है कि डेटा बिंदु औसत के एक तरफ दूसरी तरफ की तुलना में अधिक गिरते हैं या नहीं।
किसी वितरण के चार मोमेंट ये हैं:
Skewness गुणांक सकारात्मक, नकारात्मक, या शून्य होने पर तीन प्रकार की skewness होती है।
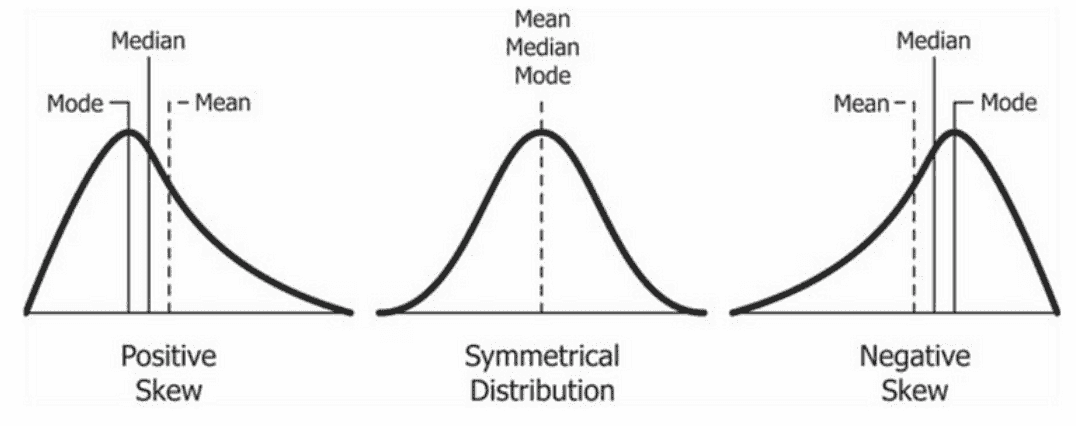
Skewed वितरण। स्रोत: Wikipedia
जहाँ skewness वितरण के प्रसार (टेल्स) पर केंद्रित है, वहीं एक अन्य सांख्यिकीय मीट्रिक, kurtosis, ऊँचाई पर अधिक ध्यान देता है। यह बताता है कि हमारा सामान्य (या सामान्य-जैसा) वितरण कितना नुकीला या चपटा है। साथ मिलकर, ये डेटासेट में विचलनों की असममिति और चरम सीमा दोनों को उजागर करते हैं। हमारा अलग ट्यूटोरियल, Understanding Skewness And Kurtosis And How to Plot Them, बताता है कि डेटा वितरण की पूरी तस्वीर देने के लिए ये मीट्रिक साथ में क्यों उपयोग किए जाते हैं।
अब जब हमने skewness की अवधारणा और इसके विभिन्न प्रकार समझ लिए हैं, तो Excel का उपयोग करके सैंपल डेटा के लिए इसकी गणना करें।
कल्पना कीजिए कि आप एक डेटा विश्लेषक हैं जिन्हें एक लोकप्रिय रिटेल चेन में ग्राहकों के प्रतीक्षा समय का विश्लेषण करने का काम सौंपा गया है। कंपनी अपने स्टोर्स में अलग-अलग ग्राहक संतुष्टि स्तरों का अनुभव कर रही है, और प्रबंधन को संदेह है कि चेकआउट पर लंबे प्रतीक्षा समय एक योगदान कारक हो सकते हैं।
इसे संबोधित करने के लिए, उन्होंने कुछ दिनों में एक स्टोर से ग्राहक प्रतीक्षा समय का सैम्पल डेटा एकत्र किया है।
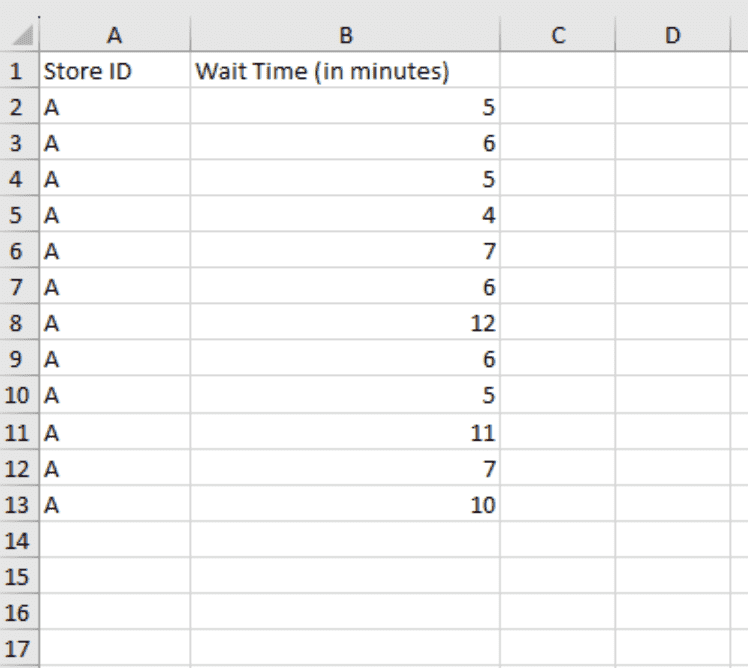
ग्राहक प्रतीक्षा समय का डेटासेट। चित्र: लेखक
ग्राहक प्रतीक्षा समय का विश्लेषण करते हुए, आपने महसूस किया कि skewness मीट्रिक की गणना उपयोगी अंतर्दृष्टि देगी। यहाँ Microsoft Excel का उपयोग करके skewness मीट्रिक की गणना करने के दो तरीके दिए गए हैं।
यह फ़ंक्शन सैंपल की skewness की डिग्री की गणना करता है। SKEW() फ़ंक्शन का सिंटैक्स इस प्रकार है:
SKEW(number1, [number2], ...)SKEW() फ़ंक्शन के लिए, हम अधिकतम 255 पैरामीटर शामिल कर सकते हैं, जिनमें से प्रत्येक एक एकल डेटा बिंदु या डेटा बिंदुओं की एक सरणी हो सकता है।
हमारे हाथ के डेटा के लिए, हम किसी सेल में, मान लीजिए F2, निम्नलिखित फ़ॉर्मूला दर्ज करेंगे:
=SKEW(B2:B13)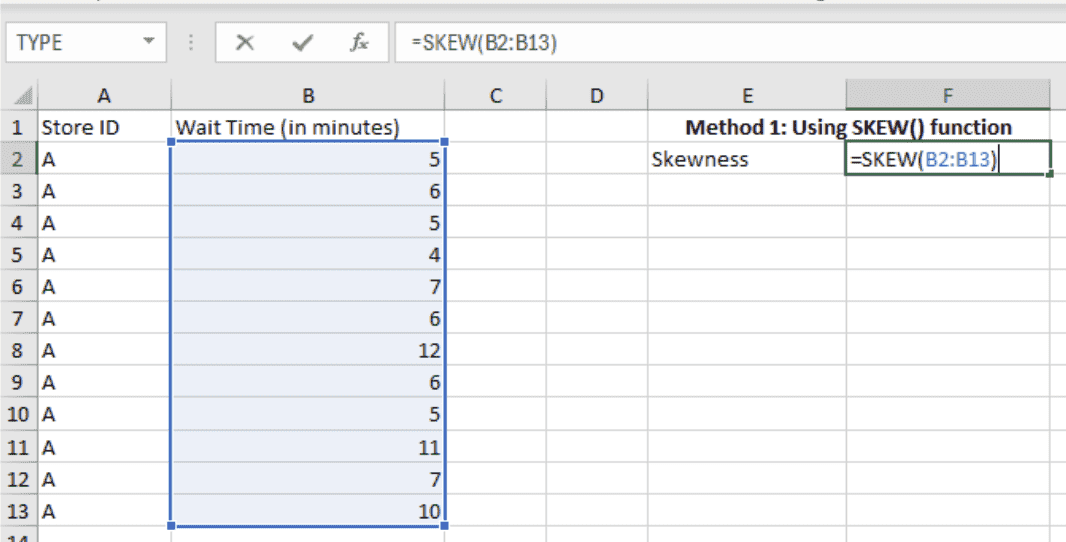
SKEW() फ़ंक्शन का उपयोग करके skewness की गणना। चित्र: लेखक
अगला, जैसे ही हम सेल पर Enter दबाते हैं, हम गणना किया गया skewness गुणांक देख सकते हैं:
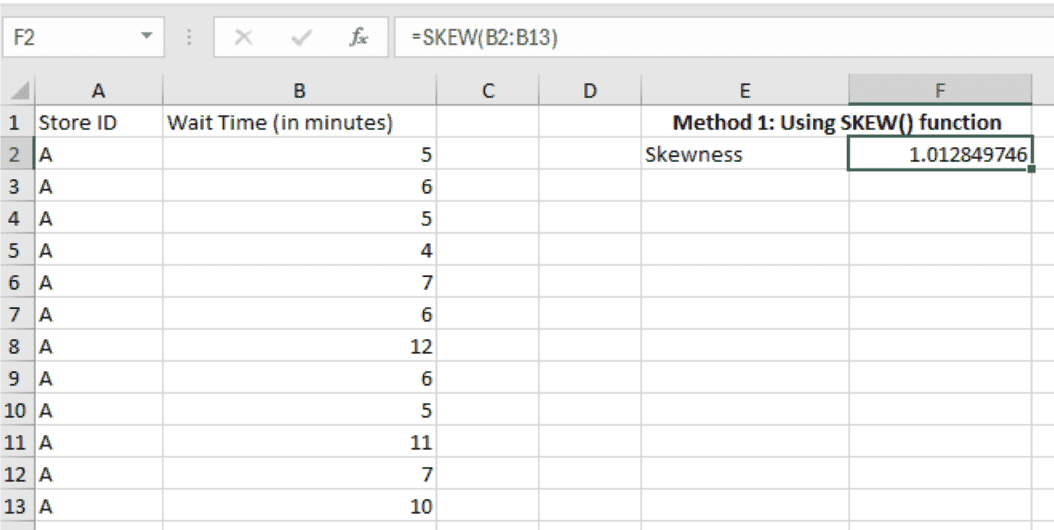 Skewness परिणाम। चित्र: लेखक
सकारात्मक आउटपुट दर्शाता है कि प्रतीक्षा समय दाएँ-तरफ झुका हुआ है। मान की व्याख्या करने से पहले, skewness मीट्रिक खोजने की एक और विधि देखें।
Data Analysis Toolpak Microsoft Excel के लिए एक अतिरिक्त ऐड-इन है जो डेटा एनालिटिक्स कार्यों में आम तौर पर उपयोग किए जाने वाले मीट्रिक की गणना करने में मदद करता है।
क्योंकि यह ऐड-इन डिफ़ॉल्ट रूप से सक्षम नहीं होता, आपको Excel वर्कबुक के ऊपर दाईं ओर Data टैब के अंतर्गत Data Analysis आइकन की जाँच करनी चाहिए, जैसा कि नीचे दिखाया गया है।
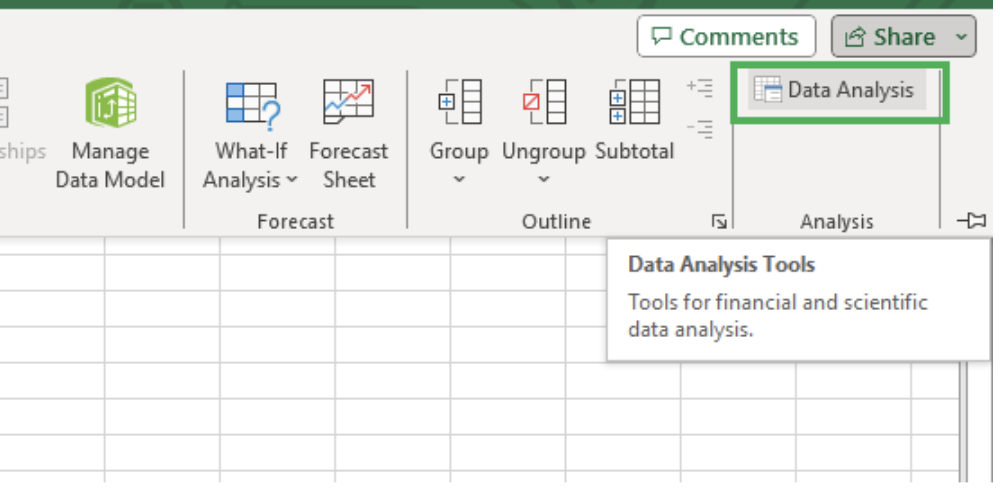
Excel में Data Analysis ToolPak। चित्र: लेखक
यदि आपको आइकन नहीं दिखता, तो यह सक्षम नहीं है। इसे सक्षम करने के लिए, मेनू से File पर क्लिक करें और Options चुनें।
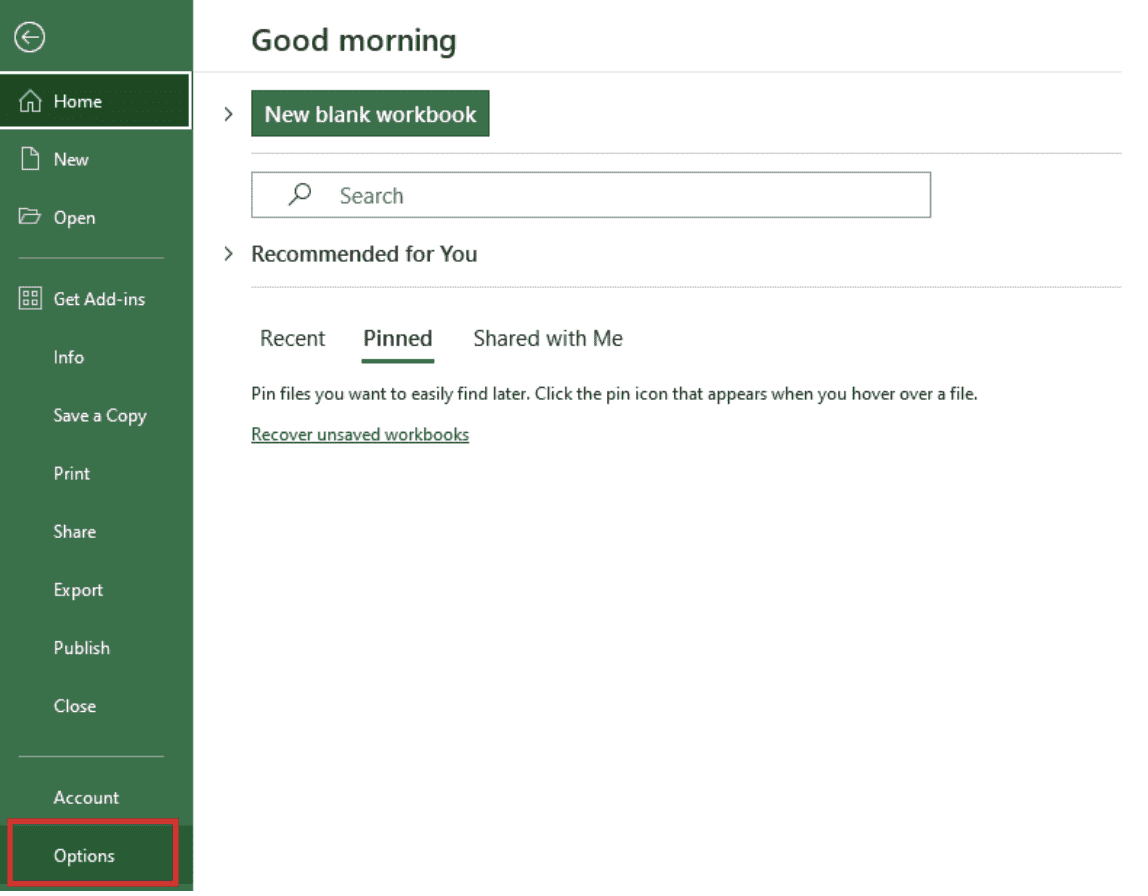
File टैब से Options चुनना। चित्र: लेखक
Excel Options डायलॉग बॉक्स खुलने पर Add-ins चुनें।
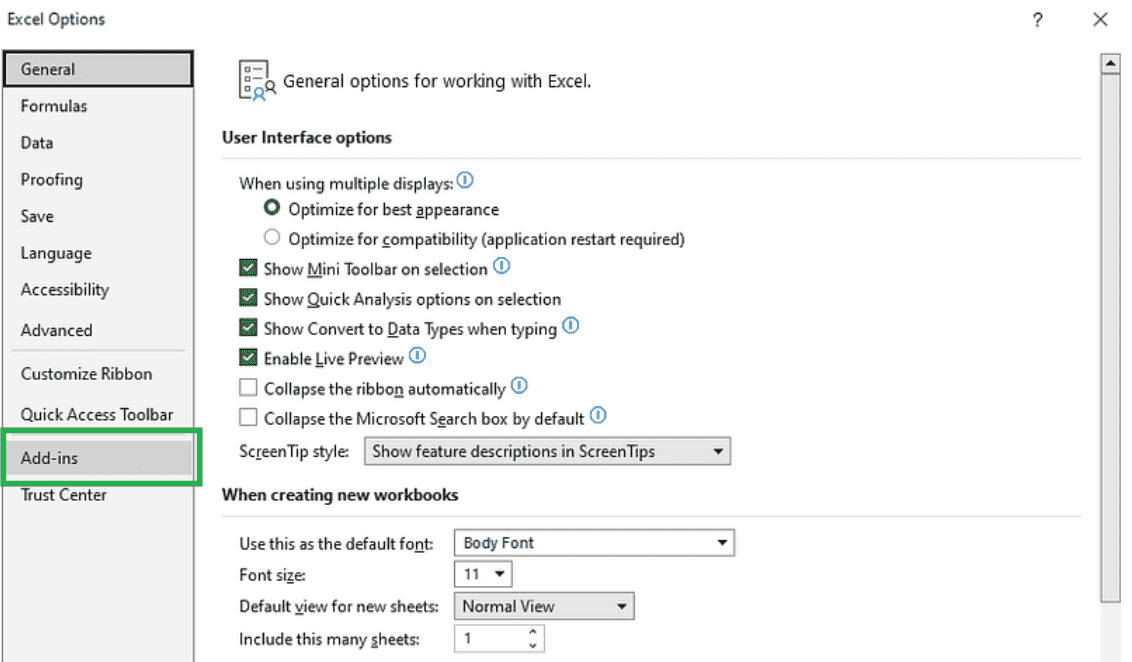
Excel Options डायलॉग बॉक्स से Add-ins चुनें। चित्र: लेखक
इसके बाद, नीचे Manage बॉक्स में Excel Add-ins चुनें, और Go पर क्लिक करें।
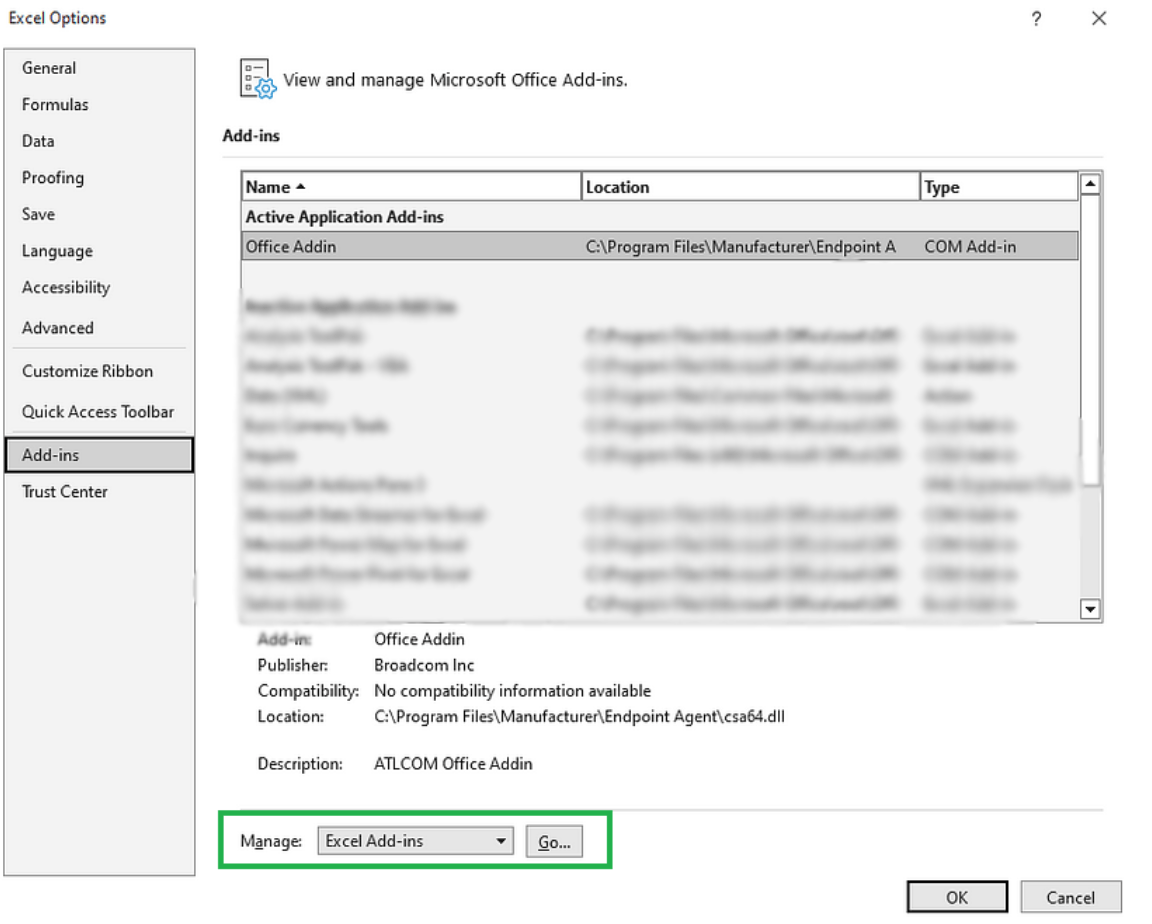 Excel add-ins प्रबंधित करना। चित्र: लेखक
Add-Ins डायलॉग बॉक्स खुलने पर Analysis ToolPak को चेक करें और OK पर क्लिक करें।
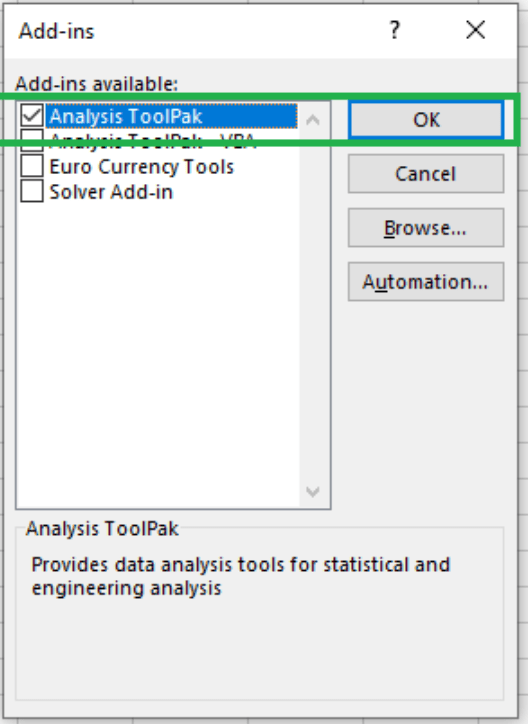
Data Analysis ToolPak सक्षम करना। चित्र: लेखक
अब Data टैब के अंतर्गत Data Analysis आइकन दिखाई देगा, और आपको यह प्रक्रिया दोहराने की आवश्यकता नहीं होगी, क्योंकि ऐड-इन को सक्षम करना एक बार का कार्य है।
सक्रिय किए गए ऐड-इन का उपयोग करके skewness की गणना की दिशा में पहला कदम के रूप में, कॉलम हेडर सहित डेटा बिंदुओं की रेंज का चयन करें, और नीचे दिखाए अनुसार Data Analysis आइकन पर क्लिक करें।
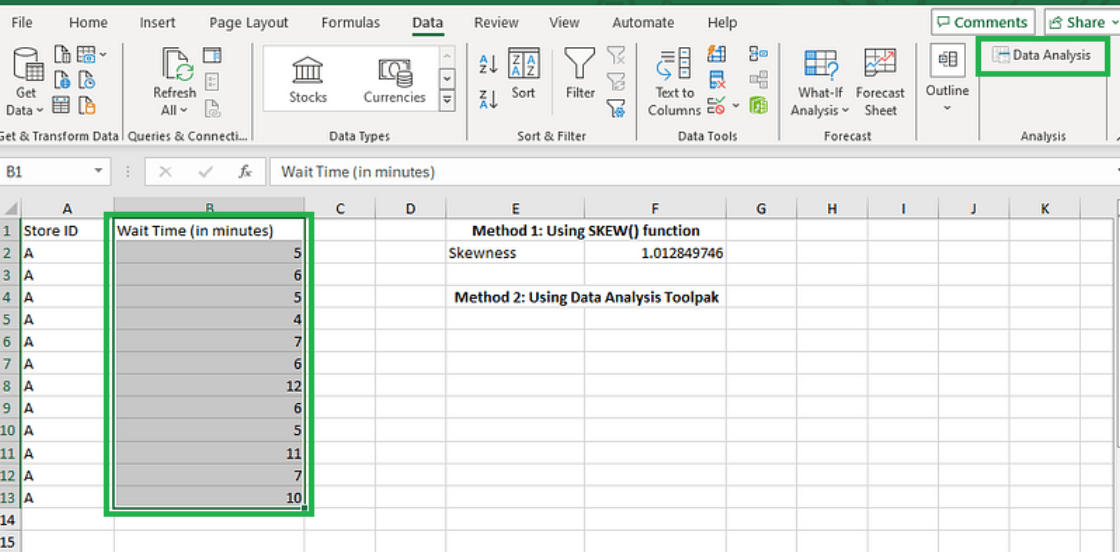
Data Analysis Toolpak ऐड-इन चालू करना। चित्र: लेखक
इसके बाद, डायलॉग बॉक्स से Descriptive Statistics चुनें और OK पर क्लिक करें।
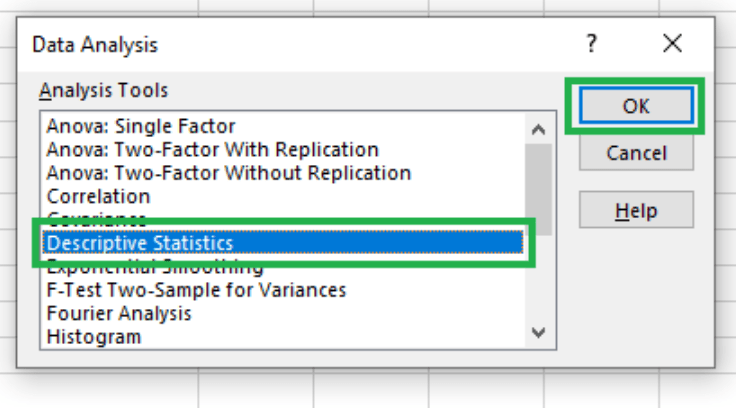
Descriptive statistics चुनना। चित्र: लेखक
आपके सामने नीचे दिखाया गया डायलॉग बॉक्स आएगा।
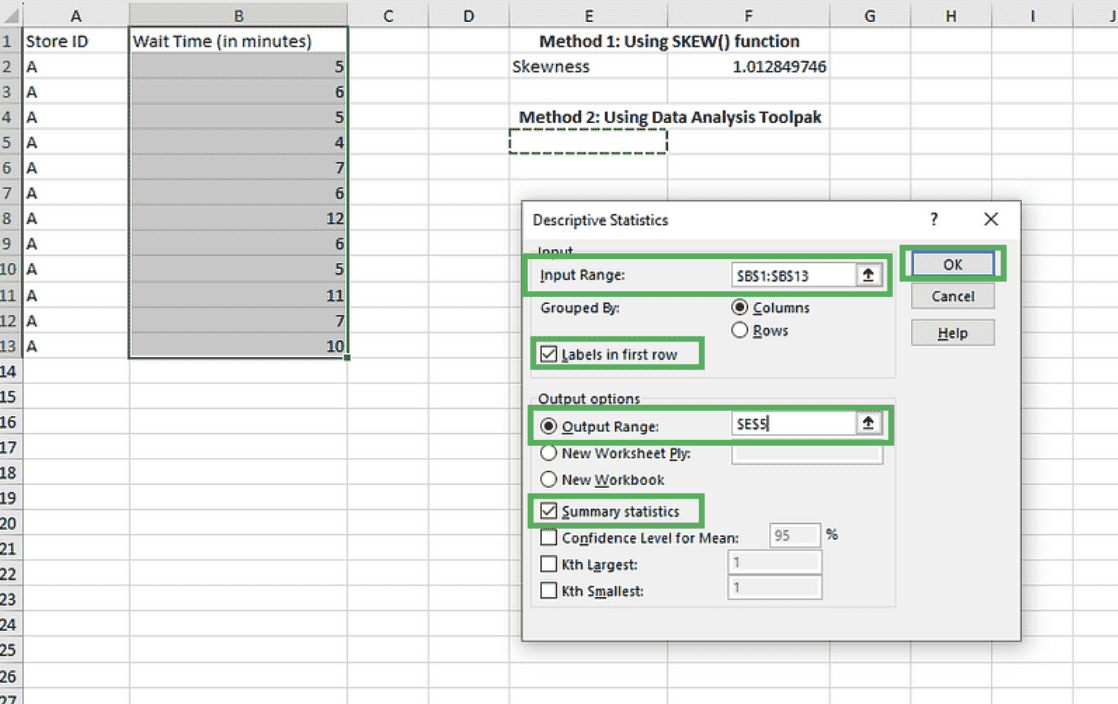 Descriptive statistics के लिए विवरण भरना। चित्र: लेखक
Input Range पहले से भरा हुआ होगा क्योंकि हमने ऐड-इन चालू करने से पहले इसे चुना था। Labels in the first row बॉक्स को चेक करें, और Output Range के लिए, हम इसी शीट में कोई सेल चुनेंगे, मान लीजिए $E$5। Summary statistics बॉक्स को चेक करें, जिसमें skewness मीट्रिक शामिल है।
OK पर क्लिक करें और इसी Excel शीट में गणना किए गए परिणाम देखें।
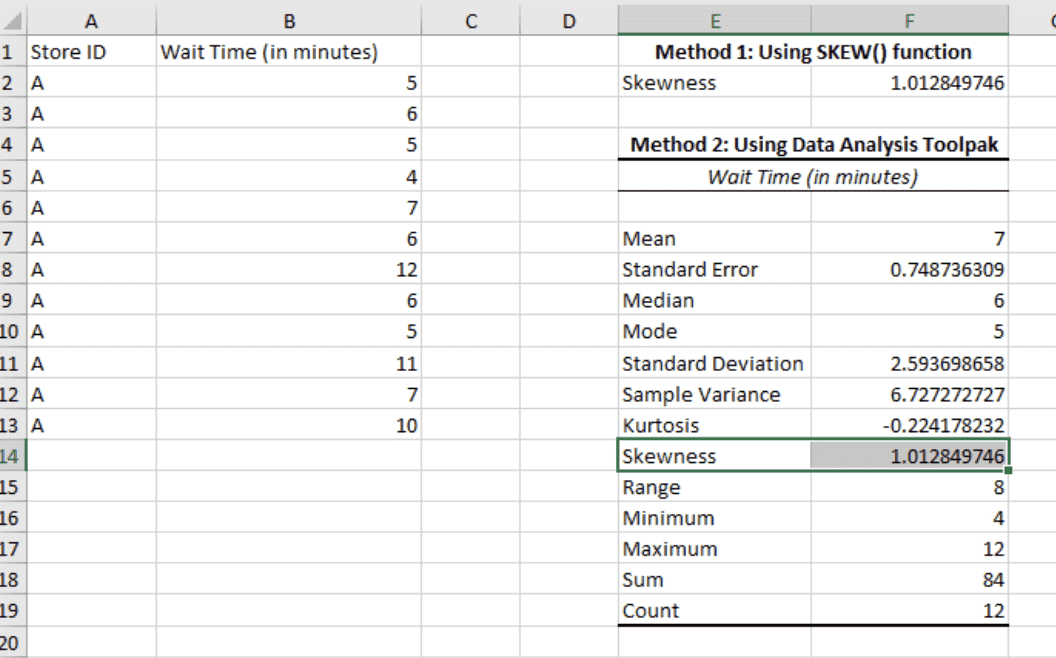 Descriptive statistics के परिणाम। चित्र: लेखक
बस इतना ही! आपने एक ही बार में skewness और अन्य उपयोगी descriptive statistics की गणना कर ली।
यदि आप Data Analysis Toolpak के बारे में और सीखने में रुचि रखते हैं, तो हमारे Comprehensive Guide to Using ANOVA in Excel ट्यूटोरियल को एक और उपयोगी उदाहरण के लिए देखें।
अब जब हमारे पास skewness और अन्य descriptive statistics हैं, तो हम डेटा के सैंपल के बारे में कुछ उपयोगी अंतर्दृष्टियों की व्याख्या और खोज कर सकते हैं।
मान लीजिए प्राप्त skewness गुणांक नकारात्मक है—तो आपकी व्याख्या कैसे बदलेगी? यहाँ बताया गया है कि ग्राहक प्रतीक्षा समय के लिए नकारात्मक skewness मानों की व्याख्या कैसे करें।
ध्यान रखें कि skewness मीट्रिक के पूरक अन्य descriptive statistics की गणना करना हमारे निष्कर्षों को सुदृढ़ करने में मदद करता है। यह डेटा एनालिटिक्स में एक आम प्रथा है।
अधिकांश व्यावहारिक अनुप्रयोगों में, विशेष रूप से सामान्य सांख्यिकीय विश्लेषण या Excel जैसे सॉफ्टवेयर टूल्स में, मोमेंटल skewness का उपयोग इसकी दृढ़ता और व्यापक प्रकृति के कारण आम है। आमतौर पर यह डिफ़ॉल्ट विकल्प होता है, जब तक कि डेटासेट की विशिष्ट विशेषताएँ या विश्लेषण के लक्ष्य अन्यथा संकेत न दें।
मोमेंटल skewness, जिसे तीसरा मानकीकृत मोमेंट भी कहते हैं, औसत के आसपास डेटा वितरण की असममिति को मात्राबद्ध करने के लिए प्रयुक्त एक सांख्यिकीय माप है।
सैद्धांतिक परिभाषा इसे वितरण के तीसरे केन्द्रीय मोमेंट, जो औसत से घनात्मक विचलन को पकड़ता है, को मानक विचलन के घन से भाग देकर गणना करती है। हालाँकि, जब किसी बड़ी जनसंख्या से लिए गए सैंपल का विश्लेषण किया जाता है, विशेष रूप से व्यावहारिक डेटा विश्लेषण परिदृश्यों में, सैंपल skewness के लिए व्युत्पन्न सूत्र यह है:
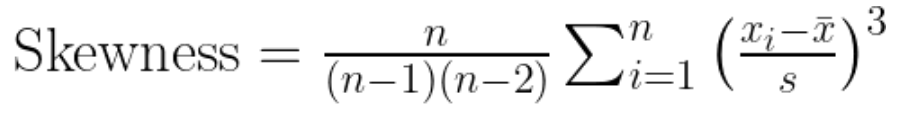
मोमेंटल skewness समीकरण। चित्र: लेखक
जहाँ:
Pearson के skewness माप में दो गुणांक शामिल हैं, जो मोड और माध्यिका का उपयोग करते हैं।
आइए Pearson के पहले skewness गुणांक (मोड skewness) पर नज़र डालते हैं। यह मोड की तुलना औसत से करता है और इस अंतर को मानक विचलन से सामान्यीकृत करता है। सूत्र इस प्रकार है:
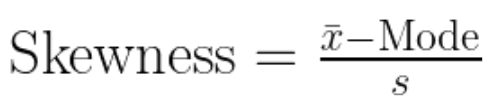 मोड skewness समीकरण। चित्र: लेखक
जहाँ:
कई डेटासेट में मोड को सटीक रूप से निर्धारित करने में कठिनाई के कारण skewness का यह संस्करण कम उपयोग होता है।
अब Pearson के दूसरे skewness गुणांक (माध्यिका skewness) पर नज़र डालें। यह वितरण की असममिति को उसकी माध्यिका की तुलना औसत से करके और परिणाम को मानक विचलन से स्केल करके मात्राबद्ध करता है। सूत्र इस प्रकार है:
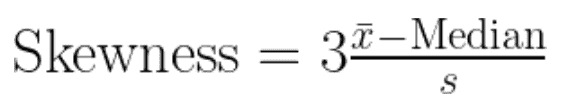 माध्यिका skewness समीकरण। चित्र: लेखक
जहाँ:
क्योंकि यह माप माध्यिका का उपयोग करता है, यह आउटलाईयर से कम प्रभावित होता है और अधिक दृढ़ skewness संकेतक प्रदान करता है।
Kelly का skewness माप डेटा के परसेंटाइल्स पर आधारित है। यह 10वें और 90वें परसेंटाइल के बीच माध्यिका की स्थिति के आधार पर वितरण की असममिति को मापता है।
Kelly के skewness का सूत्र इस प्रकार है:
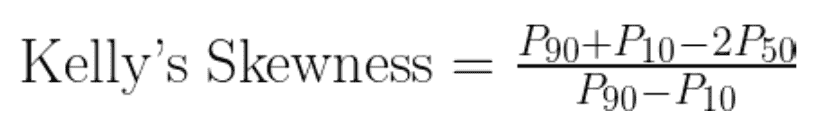 Kelly का skewness समीकरण। चित्र: लेखक
जहाँ:
Kelly का माप वितरण की टेल्स पर केंद्रित होता है और उन डेटासेट्स में skewness समझने में उपयोगी है जहाँ अत्यधिक मान विशेष रुचि के होते हैं।
Bowley का skewness, जिसे क्वार्टाइल skewness गुणांक भी कहते हैं, क्वार्टाइल्स के आधार पर वितरण की skewness मापने का एक तरीका है। Bowley के skewness का सूत्र इस प्रकार है:
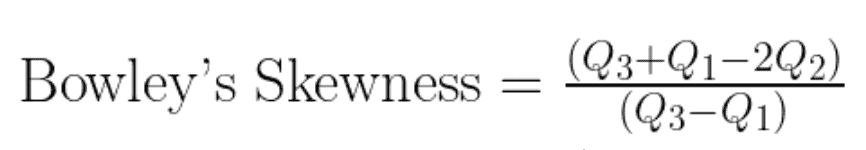
Bowley का skewness समीकरण। चित्र: लेखक
जहाँ:
यह माप अत्यधिक मानों के प्रति कम संवेदनशील है और इंटरक्वार्टाइल रेंज पर आधारित skewness का एक दृढ़ माप प्रदान करता है।
इस ट्यूटोरियल ने आपको डेटा वितरणों में skewness की अवधारणा और इसकी कई परिभाषाओं से परिचित कराया। एक सरल उदाहरण का उपयोग करते हुए, हमने Excel में skewness की गणना करने के कई तरीके सीखे और परिणामों की व्याख्या की।
आपकी सीख यहीं नहीं रुकनी चाहिए। शुरुआती-अनुकूल Introductions to Statistics पाठ्यक्रम डेटा एनालिटिक्स में आम तौर पर उपयोग की जाने वाली सांख्यिकीय तकनीकों और मीट्रिक्स को व्यापक रूप से कवर करता है। Excel Fundamentals ट्रैक Excel का उपयोग करके इसी तरह के विश्लेषणात्मक कार्यों के बारे में और सीखने के लिए उत्कृष्ट है, और Excel Formulas Cheat Sheet त्वरित संदर्भ के लिए भी सहायक है।
सीखते रहिए!
DataCamp के साथ Excel और सांख्यिकी सीखें
कोर्स
कोर्स
कोर्स