课程
使用 Python 中的 statsmodels 进行回归入门
4 小时
63K
想象一下,您正尝试根据某人学习的小时数来预测他的考试分数。那么,您的预测与实际分数有多吻合?这正是判定系数(也称为 R²,R-squared)要告诉我们的。
它告诉我们,一件事(如考试分数)的变化有多少可以用另一件事(如学习时长)的变化来解释。借此,您可以了解模型对数据的“拟合”程度。
在本文中,我们将帮助您理解 R² 的含义、重要性,以及即使您是统计学新手,也能如何计算和解读它。
判定系数,通常写作 R²(R-squared),是一个数字,用来说明回归模型对数据中“发生了什么”的解释程度。它展示了结果(因变量)的变化有多少可以由我们用来预测它的因素(自变量)来解释。
假设您想根据身高预测体重。如果 R² 接近 1,说明您的预测做得很好。体重差异大多可以归因于身高差异。如果 R² 接近 0,那么您的预测基本上是在猜测,因为在这种情况下,身高对体重变化的解释不大。
我们通常期望 R² 的取值在 0 到 1 之间:
0 表示模型无法解释数据中的任何变异性。
1 表示模型解释了所有变异性。
值越接近 1,拟合越好,说明模型捕捉到了更多数据中的模式。
当您只使用一个自变量时,该模型称为简单线性回归。在这种情况下,R² 与皮尔逊相关系数(r)有一个漂亮的关系:R² = r²
这意味着,如果预测变量与结果之间存在较强的正相关或负相关,R² 就会很高。
注意:在包含多个预测变量(称为多元回归)的模型中,R² 仍然表示解释的方差比例,但不再只是 r²,因为您现在综合了多个变量的作用。
R² 通常在 0 到 1 之间。但有时,您可能会看到负的 R²。出现这种情况可能是因为:
负的 R² 表示模型还不如猜平均值。换句话说,它对数据的拟合很差,甚至具有误导性。
计算 R² 有两种常见方法:
我们依次来看。
R² 最常见的公式是:
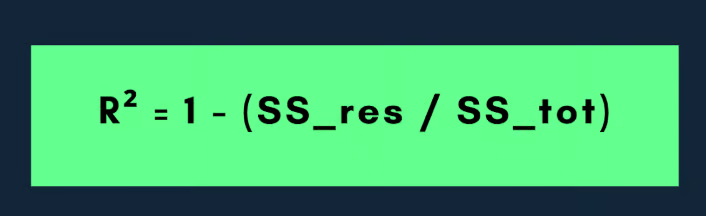
其中,残差平方和(未解释部分)衡量实际值与模型预测值之间的偏离程度。这就是模型产生的误差。
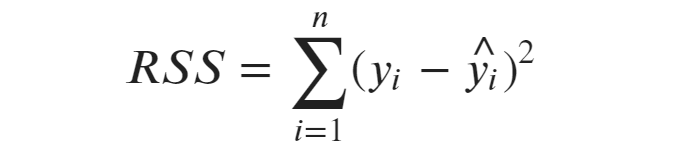
总平方和是观测数据的总体变差。它告诉我们实际值与因变量平均值(均值)的偏离程度。
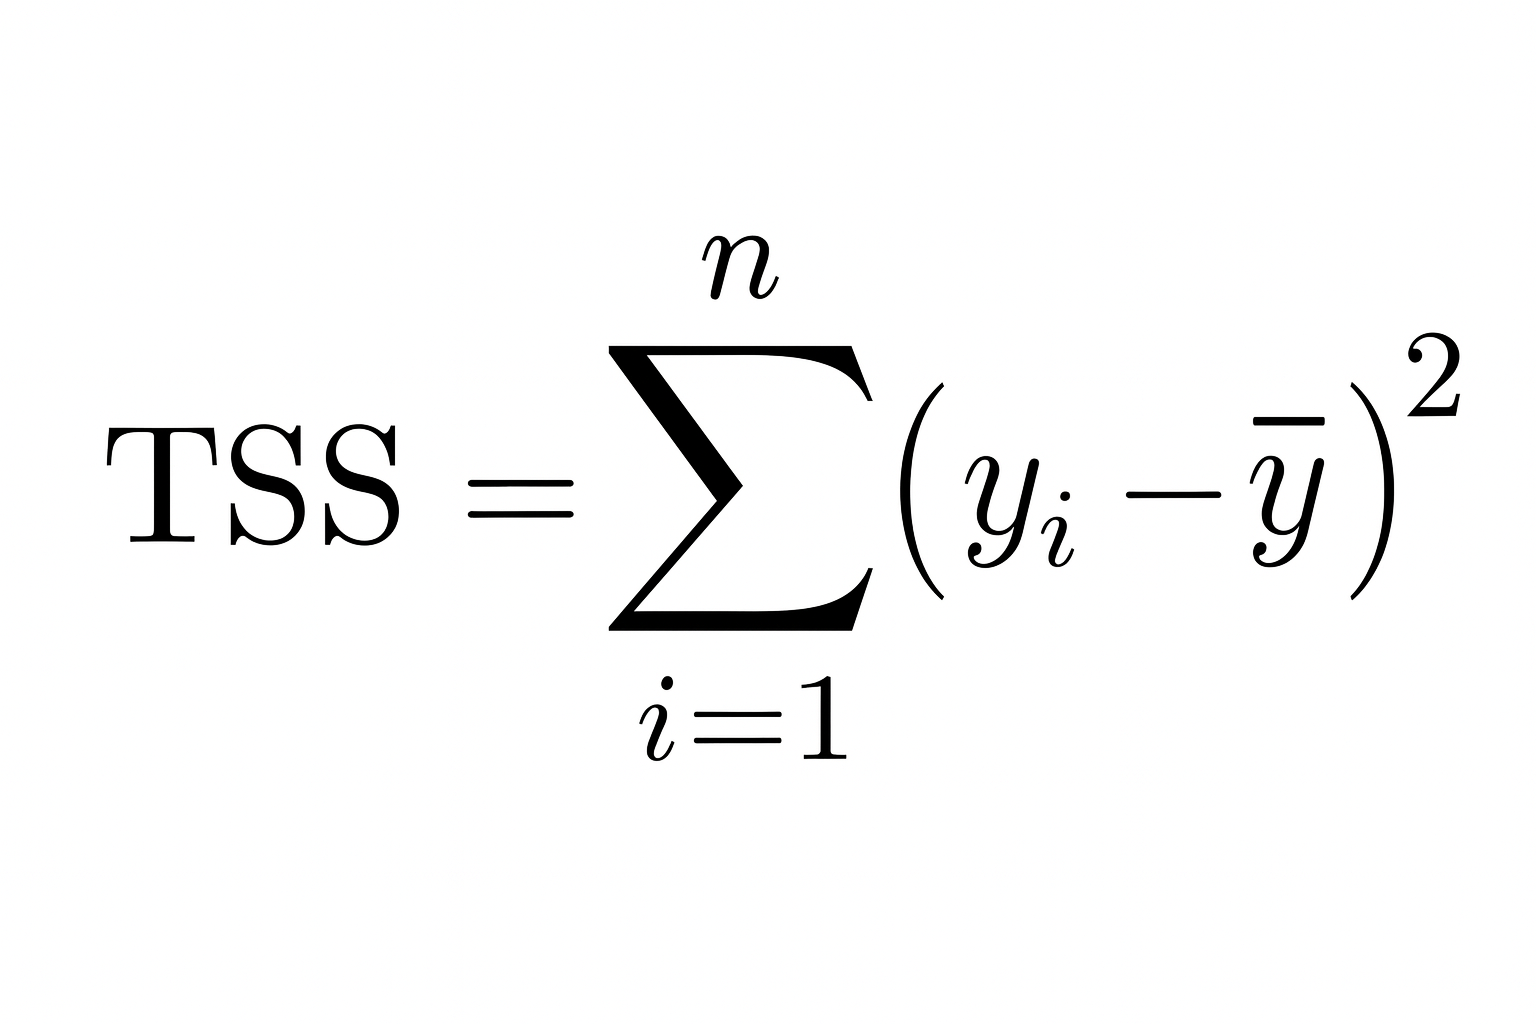
因此,残差平方和相对于总平方和越小,模型对数据的拟合就越好,R² 就越接近 1。
我们用一个示例来理解:
假设您有一个包含以下数值的小数据集:
|
观测 |
实际值 |
预测值 |
|
1 |
10 |
12 |
|
2 |
12 |
11 |
|
3 |
14 |
13 |
首先,计算实际值的均值:
然后计算总平方和(实际值与均值的偏离程度):
接着,计算残差平方和(实际值与预测值的偏离程度):
现在代入公式:
因此,R² = 0.25,这意味着模型解释了数据中 25% 的变异。
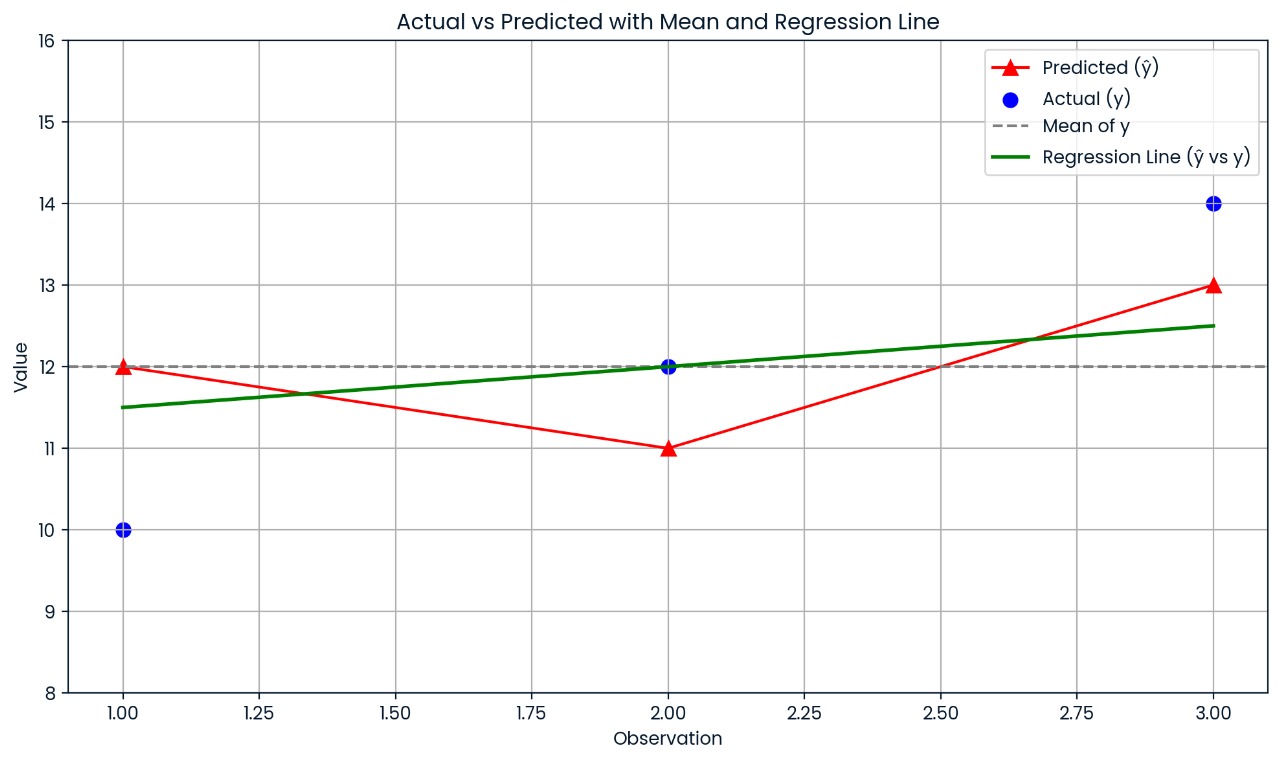
该图展示了每个实际值与其预测值的偏离程度。模型的预测误差不小,因此 R² 只有 0.25;仅有 25% 的变异被解释。
如果您使用的是简单线性回归(只有一个自变量),可用以下公式:
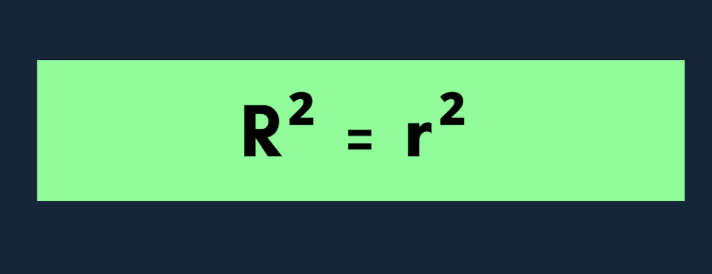
这里的 r 是实际值与预测值之间的皮尔逊相关系数。该捷径仅在只有一个预测变量时有效。
假设 X 与 Y 的相关系数为:r = −0.8
尽管相关为负(意味着变量朝相反方向变化),R² 仍为正:R² = (−0.8)² = 0.64
因此,即使关系为负,结果中的 64% 的变异仍可由预测变量解释。这就是为什么 R² 总是非负;它表示的是解释的变异量,而非方向。
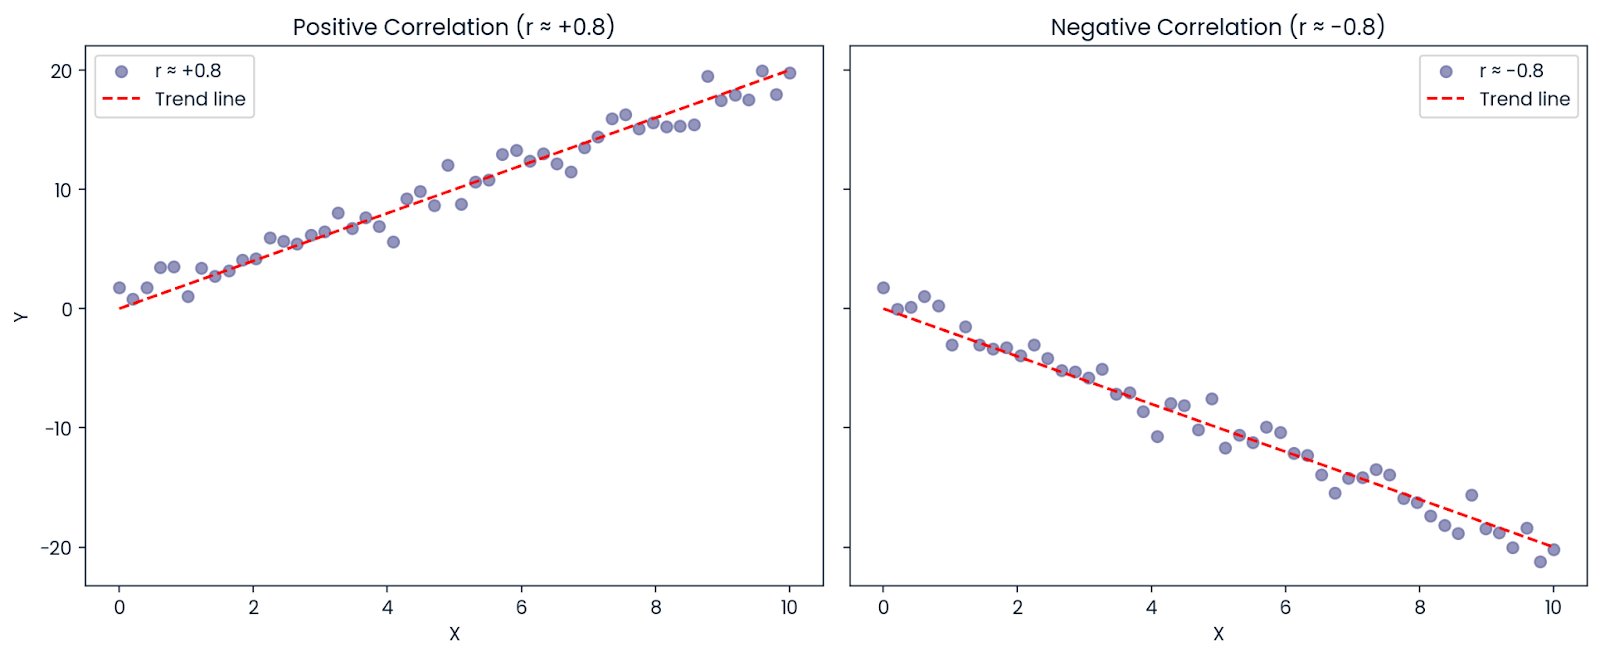
正相关与负相关。作者制图。
判定系数告诉我们,结果(因变量)的变异有多少由模型解释。简单说,就像在问:“我试图预测的变化,有多大一部分能用我所用数据来解释?”
比如,您在构建一个模型,用学习时长预测学生的考试分数。如果模型给出:R² = 0.90
这意味着,分数差异中有 90% 可以由学习时间的差异解释。其余 10% 则来自模型未纳入的因素,例如睡眠、天赋、既有知识或试题难度。
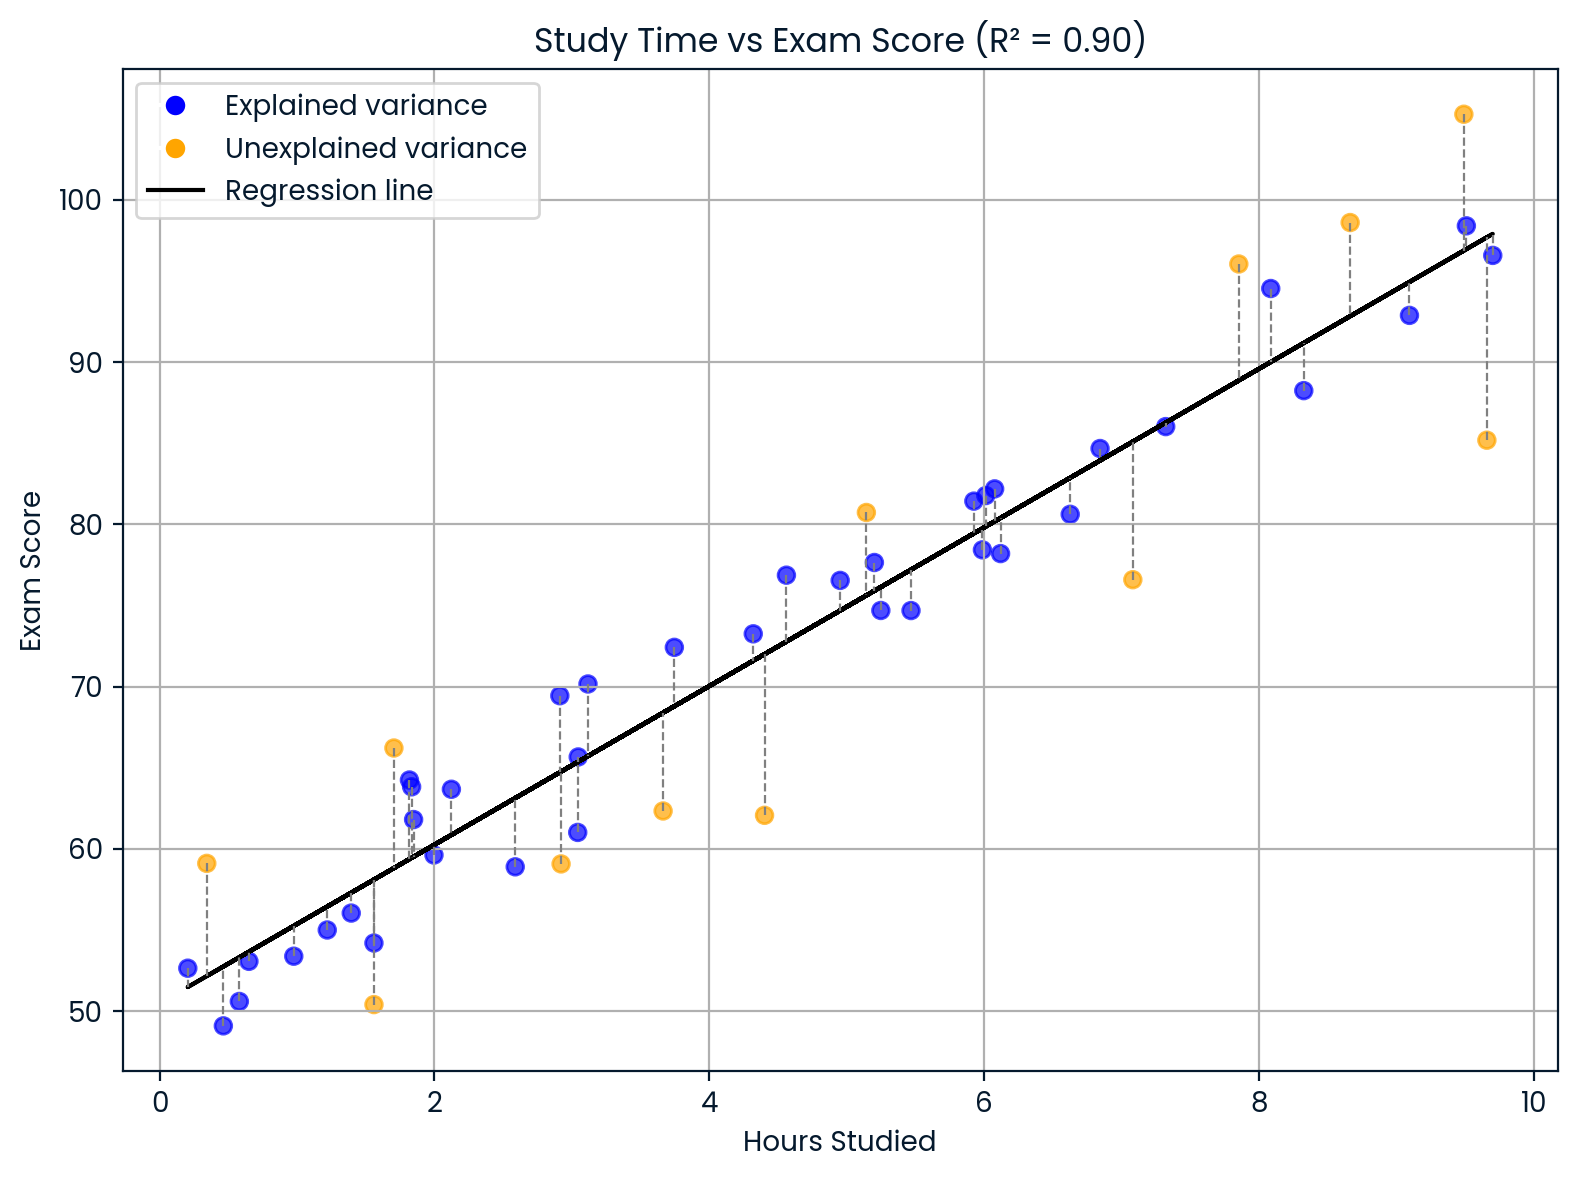
解读判定系数。作者制图。
该图展示了学习时间如何影响考试分数。
Jacob Cohen 提供了一套被广泛采用的指南,帮助我们理解在解读关系强度时,不同 R² 值可能意味着什么。
以下是 Cohen 对 R² 的大致基准:
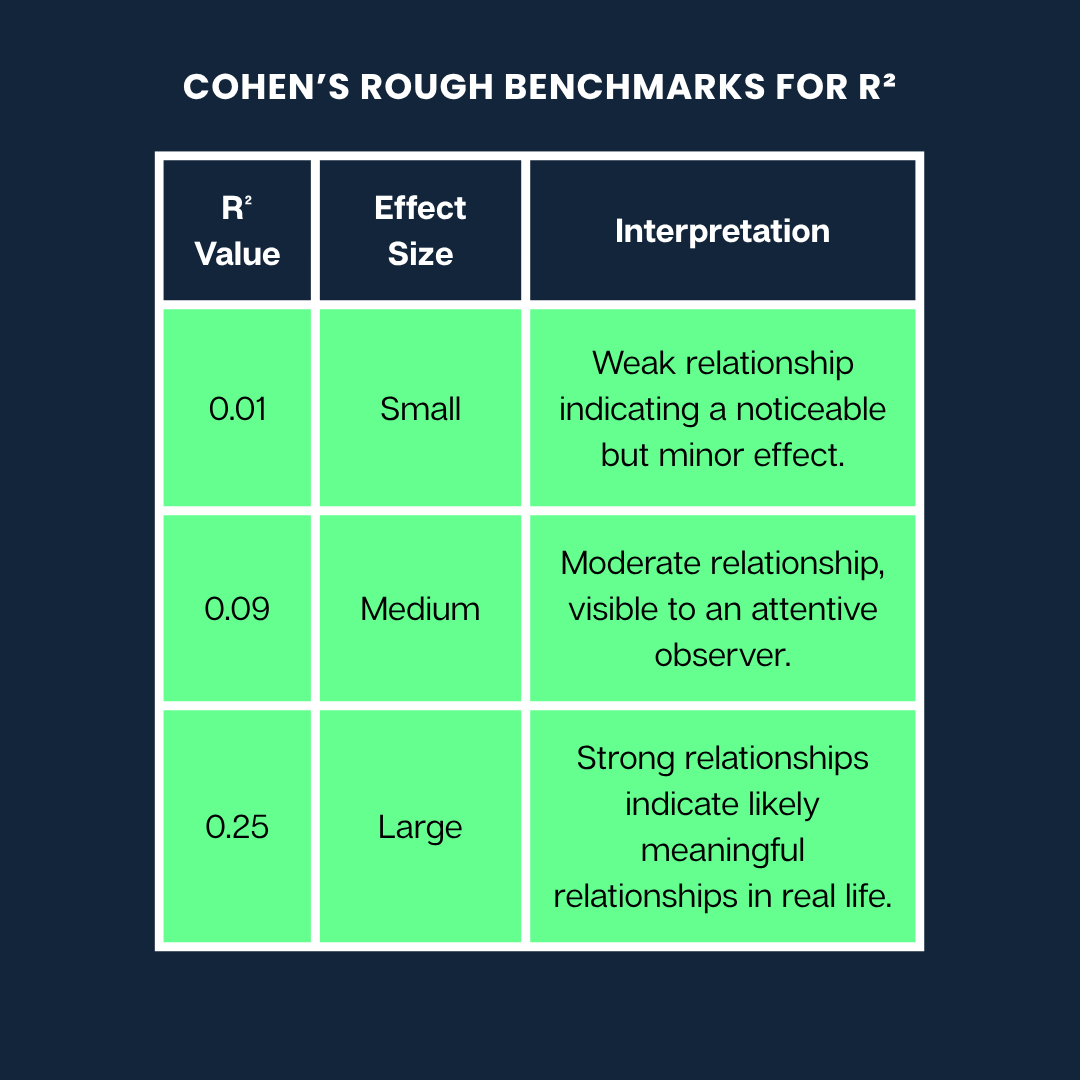
Cohen 的粗略基准。作者制图
注意:这些是一般性指南。何为“较大”或“较小”的效应,可能因研究领域(如心理学 vs. 工程)和研究情境而异。
尽管 R² 很有用,但您必须理解它能告诉您什么、不能告诉您什么。以下是一些需要注意的常见误解与局限:
看起来 R² 越高模型越好,但并非总是如此。即使新增的变量完全无关,向模型加入更多变量时,R² 也只会增加或保持不变。
为什么?
因为模型获得了更大的灵活性去拟合训练数据,即便只是拟合了随机噪声。这可能导致过拟合,即模型在训练数据上表现优异,但在新数据上表现不佳。
提示:请使用调整后的 R²来比较不同预测变量数量的模型。它会惩罚不必要的复杂度,并有助于发现过拟合。
R² 只度量模型对已有数据的描述程度。它并不能告诉您:
如果您使用了很多预测变量,高 R² 甚至可能是偶然的。因此务必关注其他模型评估指标(如用于预测质量的 RMSE 或 MAE),并请牢记:相关不等于因果。
有时,在复杂系统(如预测人类行为或金融市场)中,低 R² 是预料之中的。
例如,如果您建模的对象受众多不可预测或无法测量的因素影响,即便 R² 较低,模型仍可能有用。它也许能捕捉到有意义的趋势或提供洞见,即使它不能解释很大比例的方差。
在医学或心理学研究中,看到较低的 R² 值并不罕见,因为人类结局取决于许多相互作用的变量。
虽然 R² 有助于理解线性回归中的模型拟合,但还有其他变体与推广适用于不同的建模情境。
与常规 R² 一样,调整后的 R² 反映模型对因变量变异的解释比例。但它更进一步,会对不必要的复杂度进行惩罚。换句话说,它不鼓励您往模型里塞入无助益的额外预测变量。
其公式为:
Adjusted R² = 1 - [ (1 - R²) × (n - 1) / (n - p - 1) ]其中:
n 为观测数(数据点数量)
p 为预测变量数(自变量数量)
如果新变量没有改进模型,该公式会下调 R²。随着您添加更多预测变量,这种惩罚会更强。
例如,如果您新增的变量确实提升了模型精度,调整后的 R² 会升高。但如果该变量几乎没有改变,或仅是偶然有用,调整后的 R² 会下降,提醒您可能过拟合。
这使得调整后的 R² 有助于比较模型。
比如,您需要在一个包含三个预测变量的简单模型与一个包含六个预测变量的复杂模型之间做选择。即便复杂模型的 R² 略高,调整后的 R² 也可能更低,表明额外复杂度不值得。
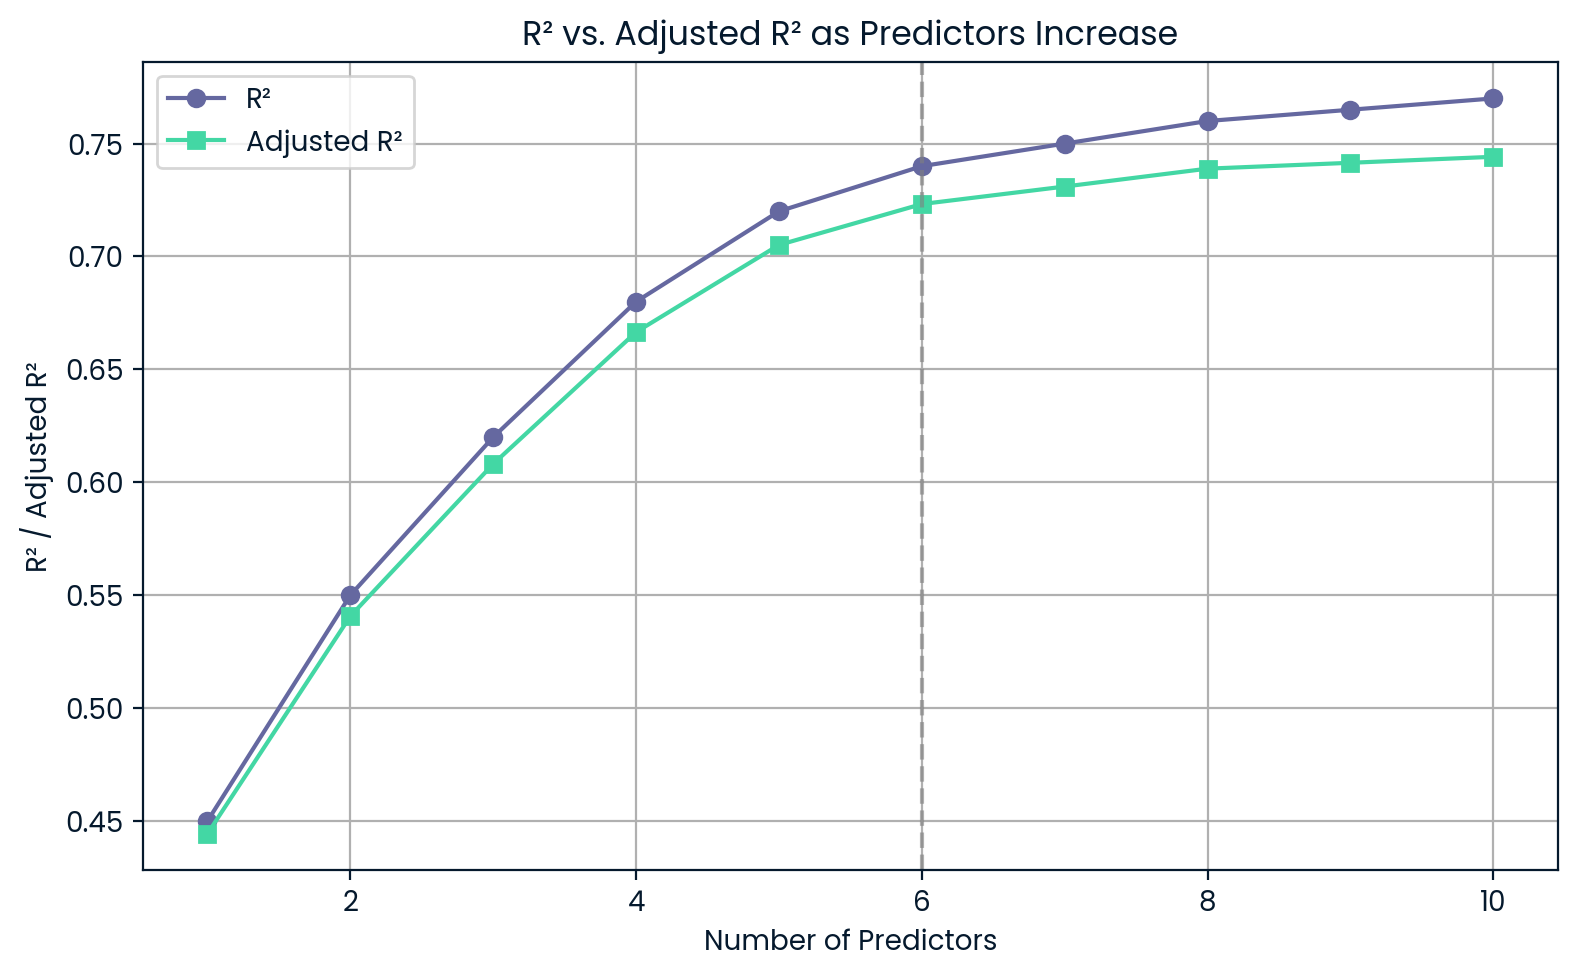
随预测变量增加,R² 与调整后 R² 的对比。作者制图。
该图显示,随着您加入更多预测变量,即使这些变量并不有用,R² 也会持续上升。相反,若添加过多,调整后的 R² 会下降,提醒您注意过拟合。
偏 R²(或偏判定系数)告诉我们,在已有其他变量的模型中,加入某个特定预测变量后,因变量的额外方差有多少被解释。
计算偏 R² 时,我们比较两个模型:
偏 R² 的公式基于加入新变量时误差平方和(SSE)的减少量。一种常见形式为:
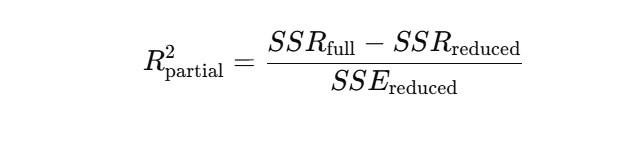
或用回归平方和来表示:
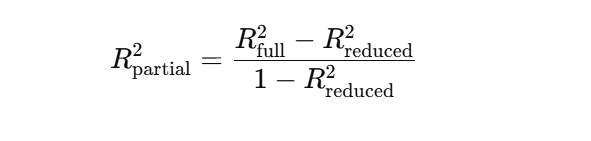
假设您正在构建一个预测产品销量的模型。
模型中已包含“产品价格”和“季节”。现在,您想看加入“营销支出”是否能改进预测。偏 R² 会告诉您,纳入“营销支出”后,销量的方差额外有多少被解释。
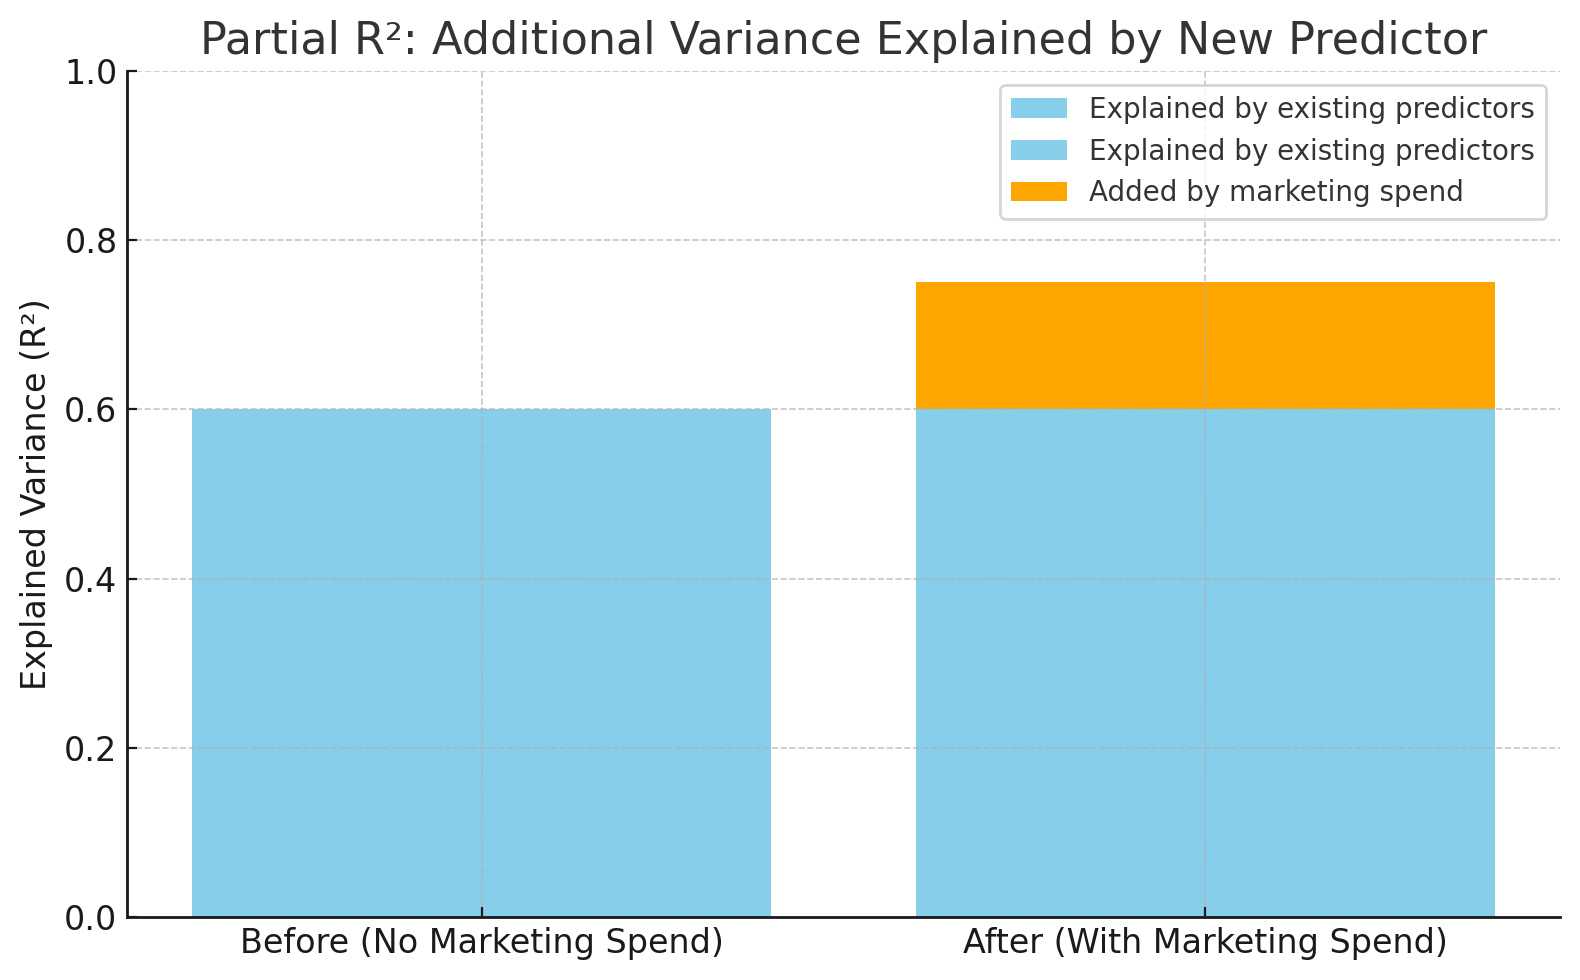
加入营销支出后,R² 从 0.60 提升至 0.75。作者制图。
该图展示了加入“营销支出”后模型变得更准确的程度。R² 从 0.60 上升到 0.75,意味着新变量又解释了销量变异的 15%——这就是偏 R²。
在逻辑回归中,结果变量是类别型(如是/否、及格/不及格),传统的 R² 不适用。取而代之,我们使用伪 R² 指标,其作用类似:估计模型对结果变异的解释程度。
两个常见的伪 R² 指标为:
假设您在建模客户是否会点击广告(是/否)。因为结果是二元的,不能用常规 R²。但像 Nagelkerke 这样的伪 R² 值,有助于比较逻辑回归模型并评估其预测能力,尽管它们并不等同于线性回归中的 R²。
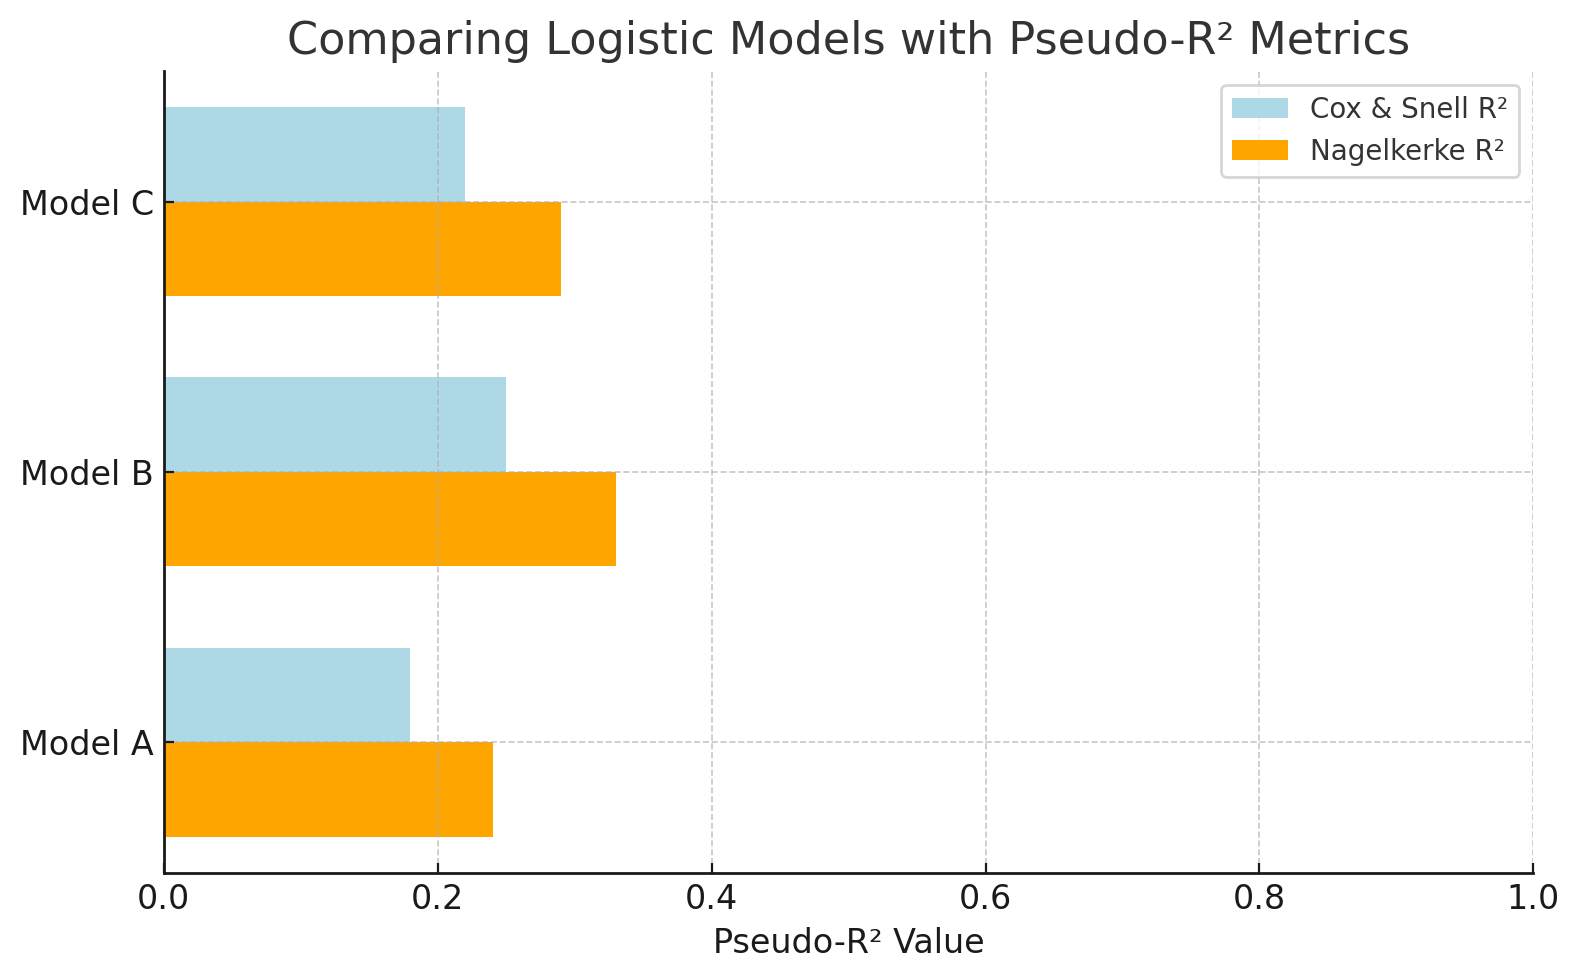
用伪 R² 指标比较逻辑回归模型。作者制图。
该图使用伪 R² 值比较逻辑回归模型。与 Cox & Snell 相比,Nagelkerke R² 提供了更易解读的刻度,从而更容易评估各模型对结果(如预测广告点击)的解释程度。
虽然 R² 有助于理解解释的变异量,但它并不衡量预测偏差的大小。RMSE、MAE、MAPE 等基于误差的指标正是为此而设。
简要比较如下:
|
指标 |
告知内容 |
最佳适用场景 |
注意事项 |
|
R² |
解释的方差百分比 |
比较线性模型、便于解读 |
若残差不服从正态或模型非线性,可能误导 |
|
RMSE |
更重罚大的误差 |
重视大误差影响时(如科学、机器学习) |
对离群值敏感 |
|
MAE |
平均绝对误差 |
稳健、简单的误差跟踪(如金融) |
对大误差不够敏感 |
|
MAPE |
相对实际值的百分比误差 |
预测、商业场景 |
当实际值接近零时失效 |
|
标准化残差 |
按方差调整的误差 |
加权回归、测量可信度不等时 |
需要已知误差方差 |
|
卡方 |
残差与已知方差的比较 |
科学研究、拟合优度检验 |
假设正态性与已知误差结构 |
现在,让我们看看判定系数在无数案例中的一部分应用。
在经济学中,R² 用于解释国内生产总值(GDP)等宏观指标的变化。例如,一个模型可能包含利率、消费者支出和贸易差额等变量来预测 GDP。
如果此类模型的 R² 为 0.83,则意味着 83% 的 GDP 变动可由这些经济因素解释。这帮助经济学家了解 GDP 的起伏有多少可归因于已知驱动因素。
一项研究使用美国 GDP 作为自变量来预测标普 500 指数,发现 R² 为 0.83。这显示出经济活动与股市趋势之间存在强关系。
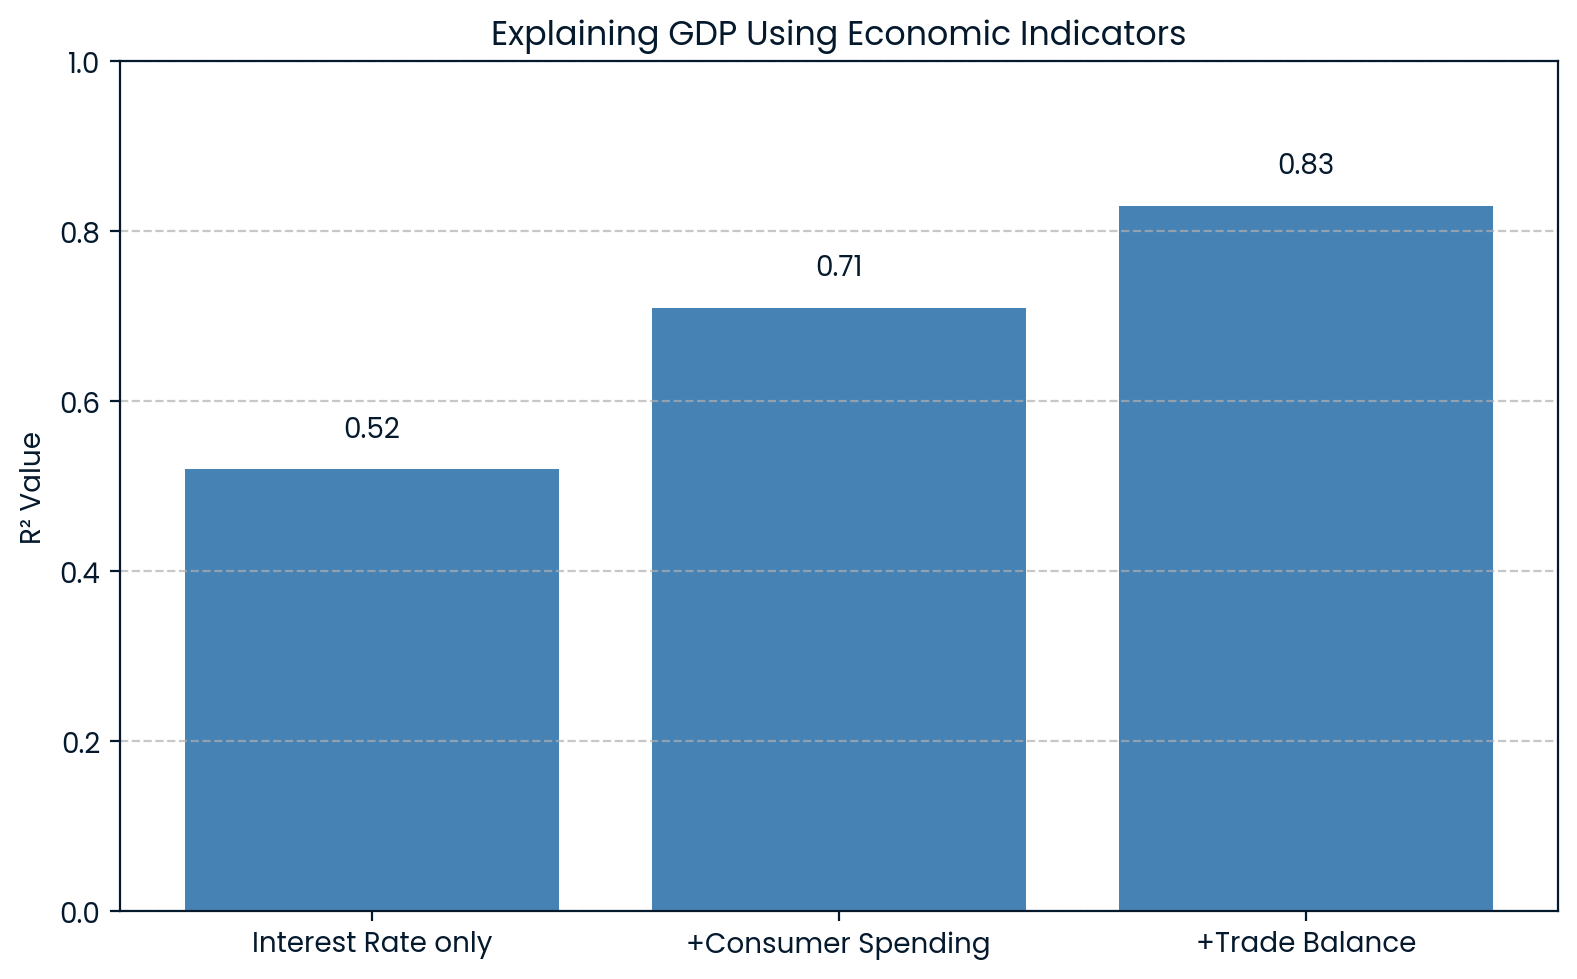
R² 解释 GDP 经济学。作者制图。
该图显示,随着将更多经济指标加入模型,R² 提高,从 0.52 增至使用三个变量时的 0.83。这清楚地表明,每增加一个因素,都能更好地解释 GDP 的波动。
在金融领域,R² 用来衡量一只股票的收益有多少可由整体市场波动解释。方法是将股票收益对标普 500 等市场指数进行回归。
例如,如果您将苹果(AAPL)的收益对标普 500 回归,得到 R² = 0.82,这意味着苹果收益波动的 85% 可由更广泛的市场解释。
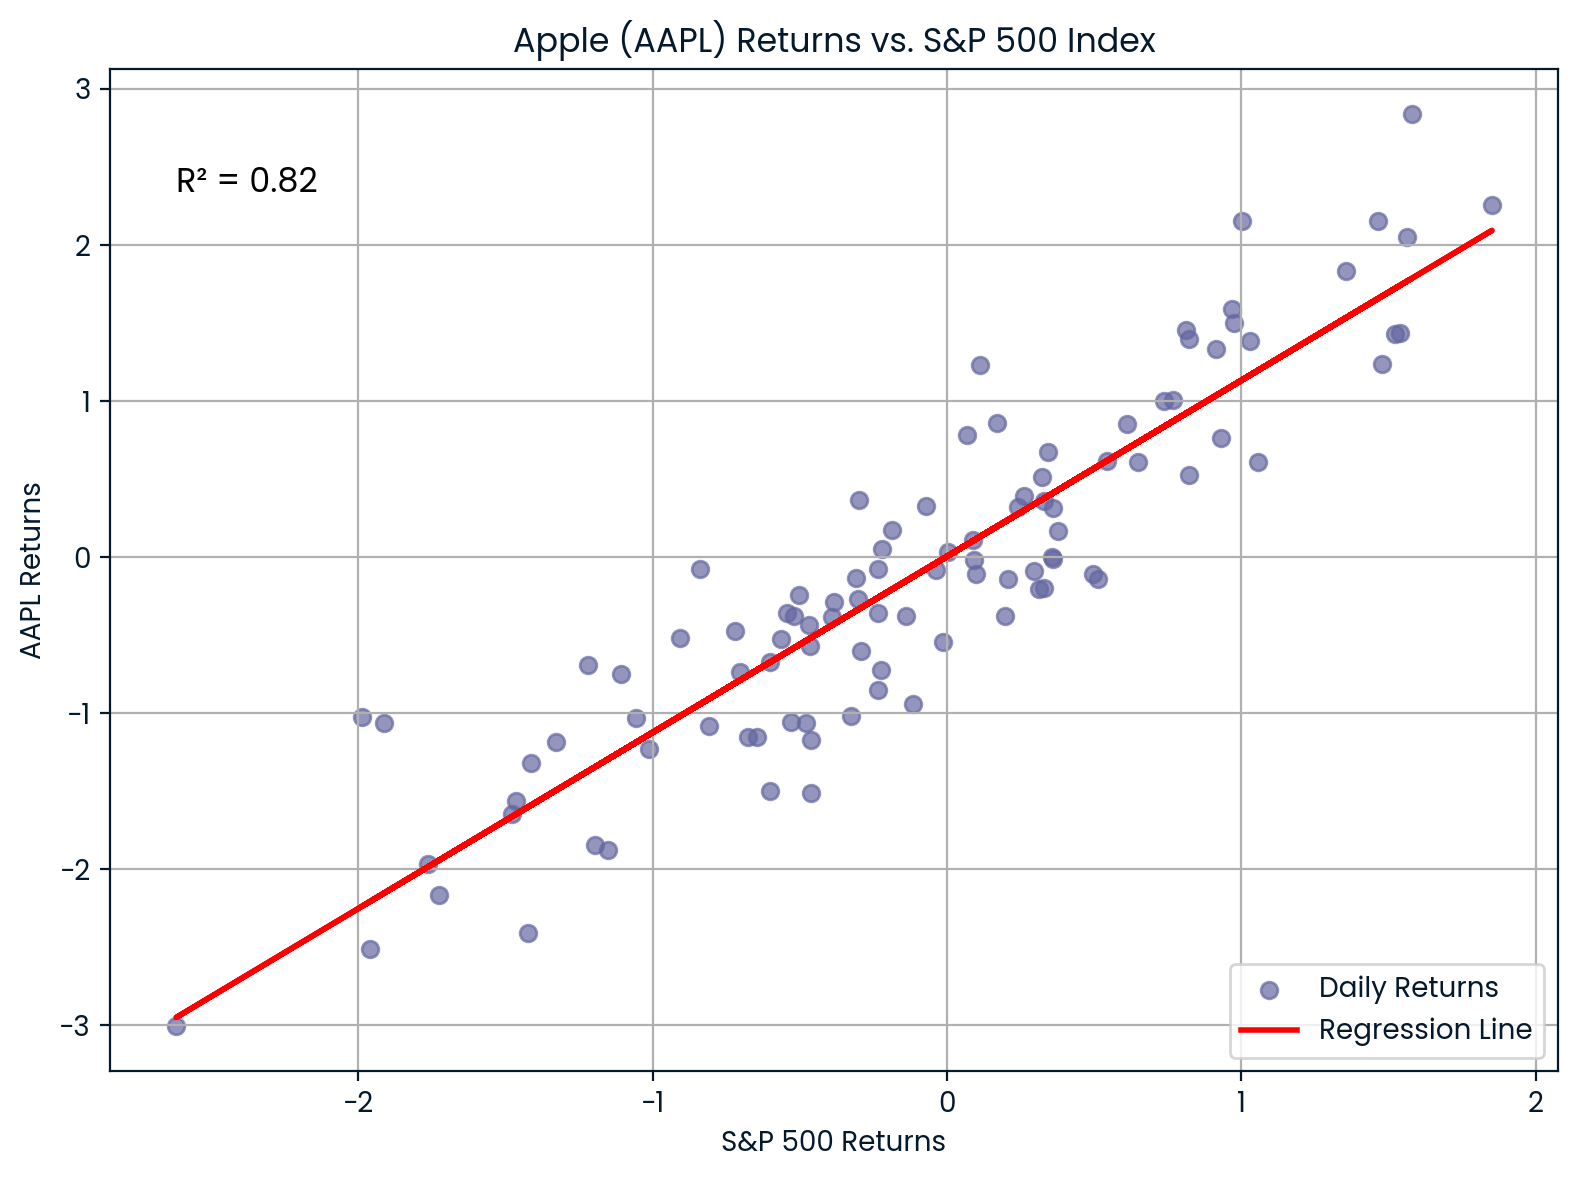
AAPL 与标普 500 的相关性。作者制图。
该图展示了苹果(AAPL)与标普 500 的强相关性。R² 为 0.82,表明苹果的大部分价格波动与市场趋势高度一致,显示出较高的市场敏感度。
在营销中,R² 展示了广告支出对客户转化率的解释程度。
假设您在一家电商公司工作,想知道增加每月广告支出是否能提升转化率。您进行线性回归,得到 R² = 0.98。这意味着转化率变异的 98% 由广告支出解释,表明关系非常强。
这些洞见能帮助营销人员:
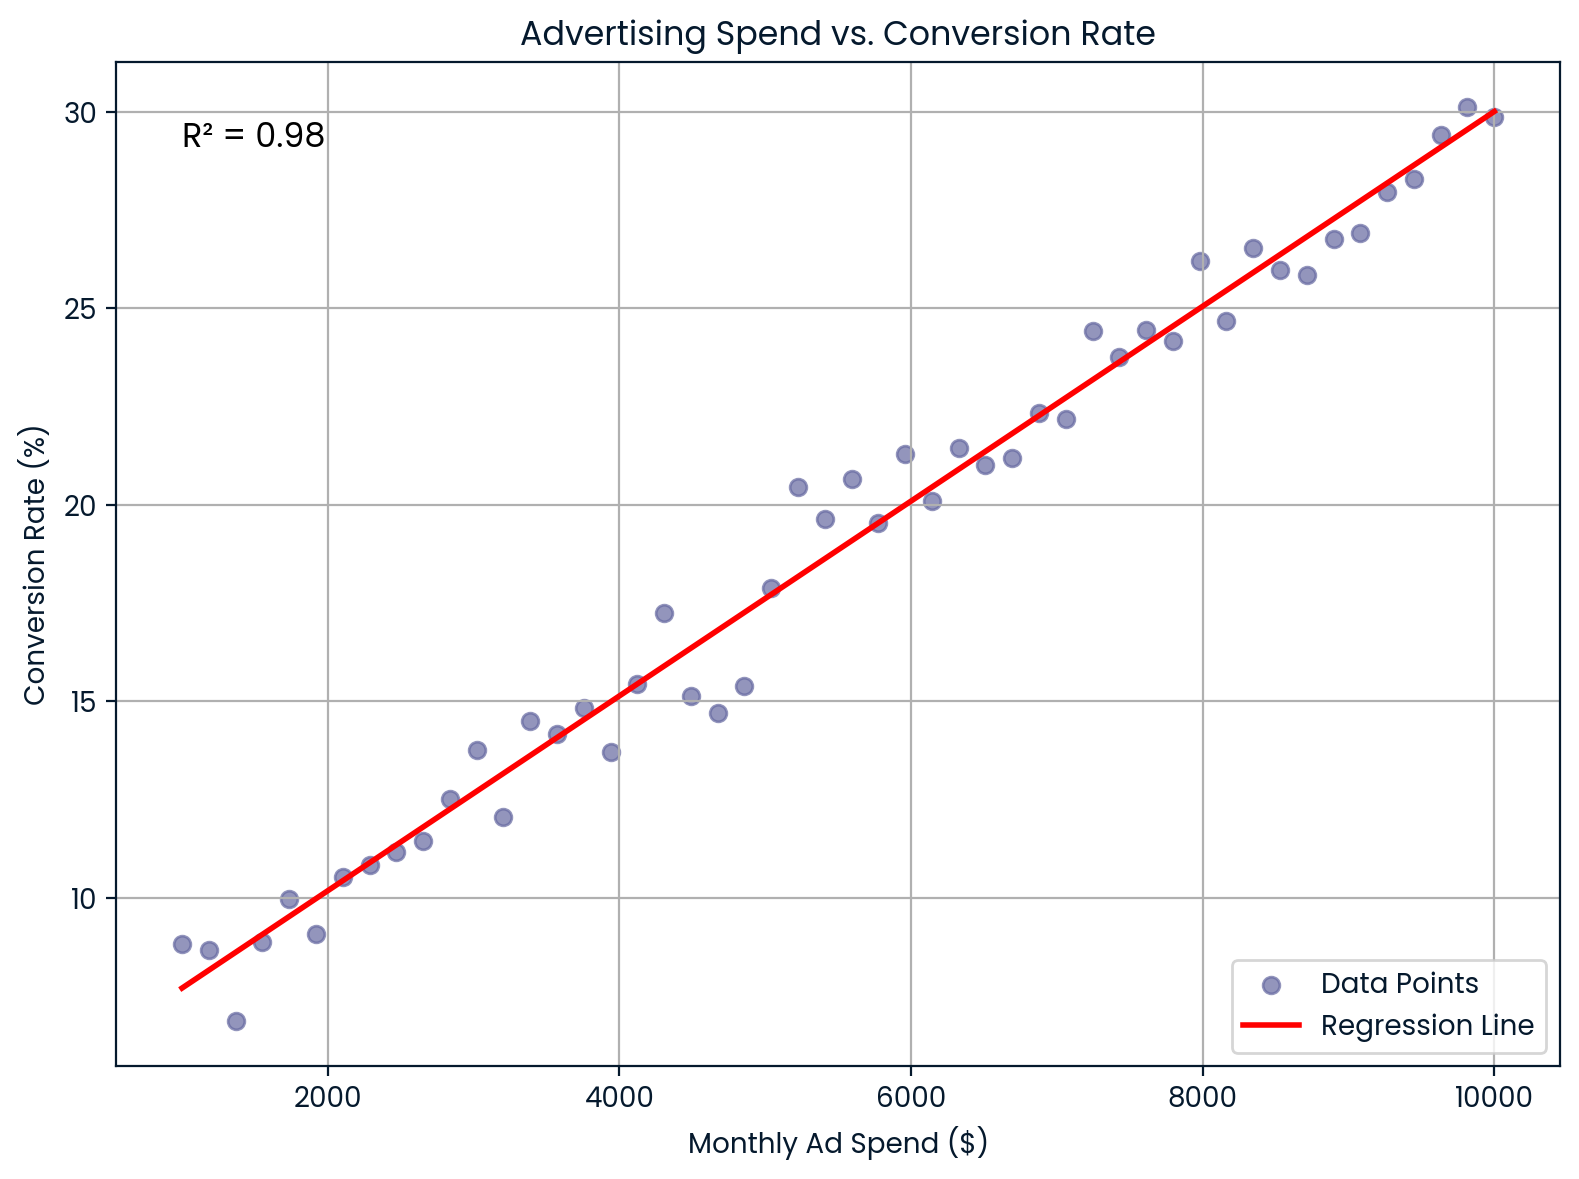
月度广告支出 vs 转化率。作者制图。
该图展示了月度广告支出与转化率近乎完美的线性关系。这为 ROI 与预算规划提供了强有力的预测价值。
在机器学习中,R² 常作为回归任务的性能指标。诸如 scikit-learn 等库提供了 r2_score() 函数来计算它。
它告诉您模型对数据变异的解释程度:
R² 接近 1 表示拟合良好、误差较小
R² 接近 0 表示拟合较差
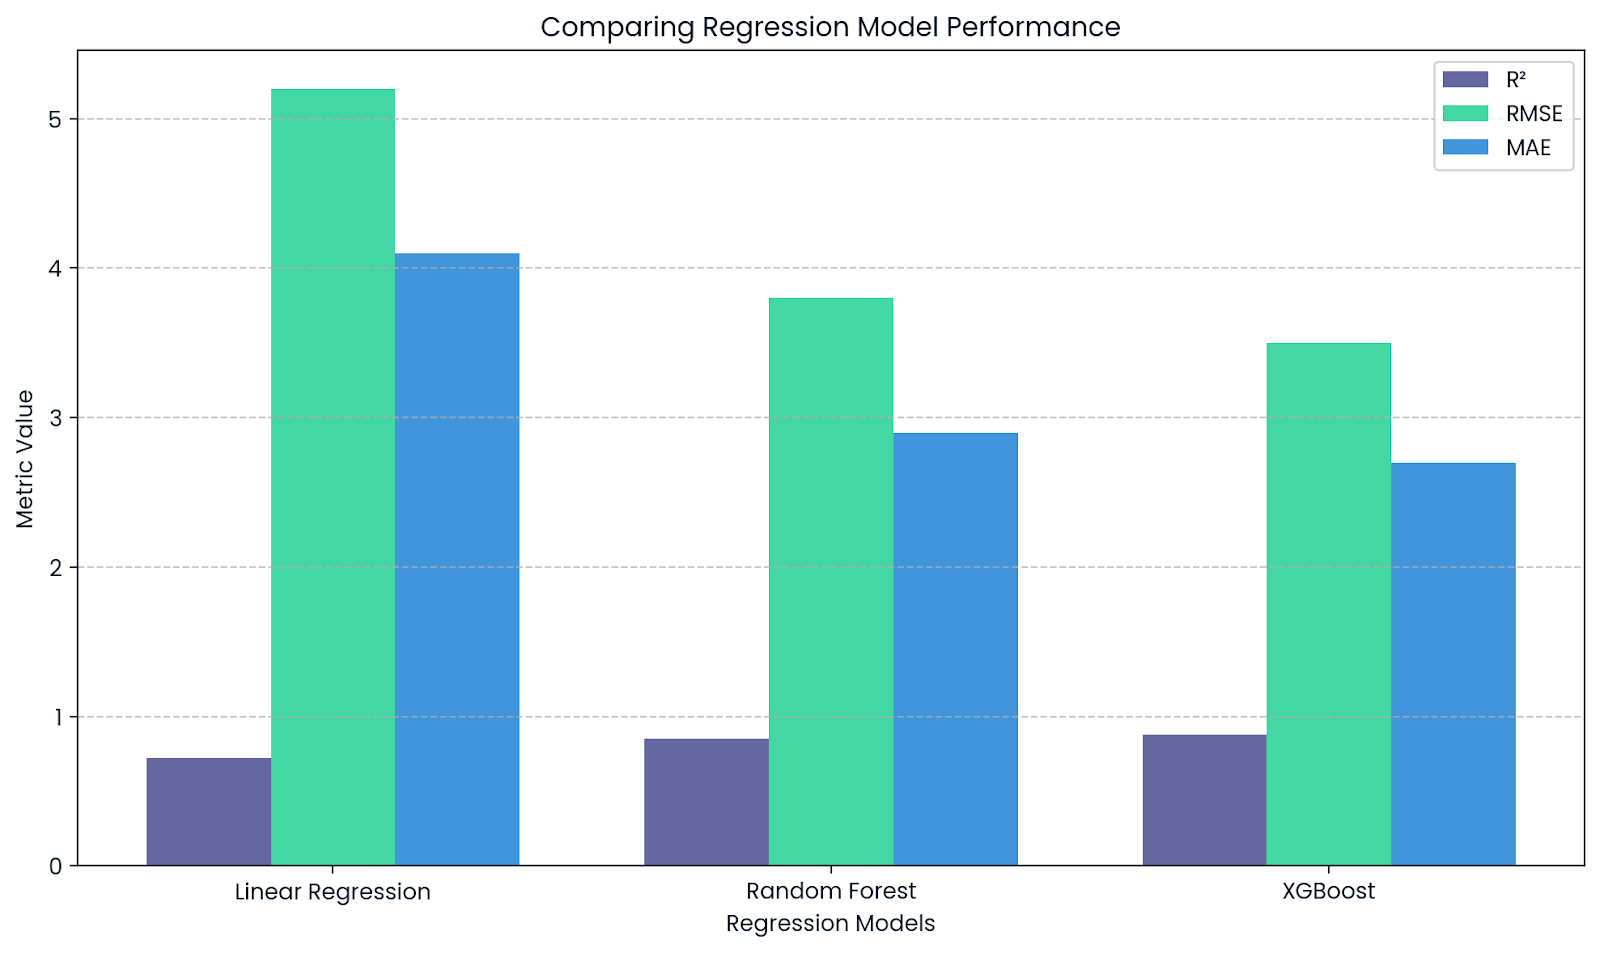
评估回归模型时,R² 与 RMSE、MAE 互为补充。作者制图。
该图强调了在评估回归模型时,R² 如何与 RMSE、MAE 等指标互补。R² 展示了解释力,而 RMSE 与 MAE 则提供了预测误差实际大小的洞见。
如果您要在研究论文或项目中包含 R²,有一些格式规则需要注意:
如果您在回归分析或方差分析(ANOVA)中使用 R² 并检验模型是否显著,请再包含以下内容:F 统计量、自由度和 p 值。这些信息可以告诉读者,您的模型在多大程度上解释了有意义的内容。
因此,在报告结果时,可以这样写:
“该模型解释了销量中显著比例的方差,R² = .73,F(2, 97) = 25.42,p < .001。”
然而,如果您不进行假设检验,例如在进行探索性分析或用交叉验证评估模型性能时,那么仅报告 R² 值也是完全可以的。
我们通过一个小型项目(基于学习时间预测学生分数),来看用三种方式(Python、R、Excel)计算 R²。
以下数据集将用于三个示例:
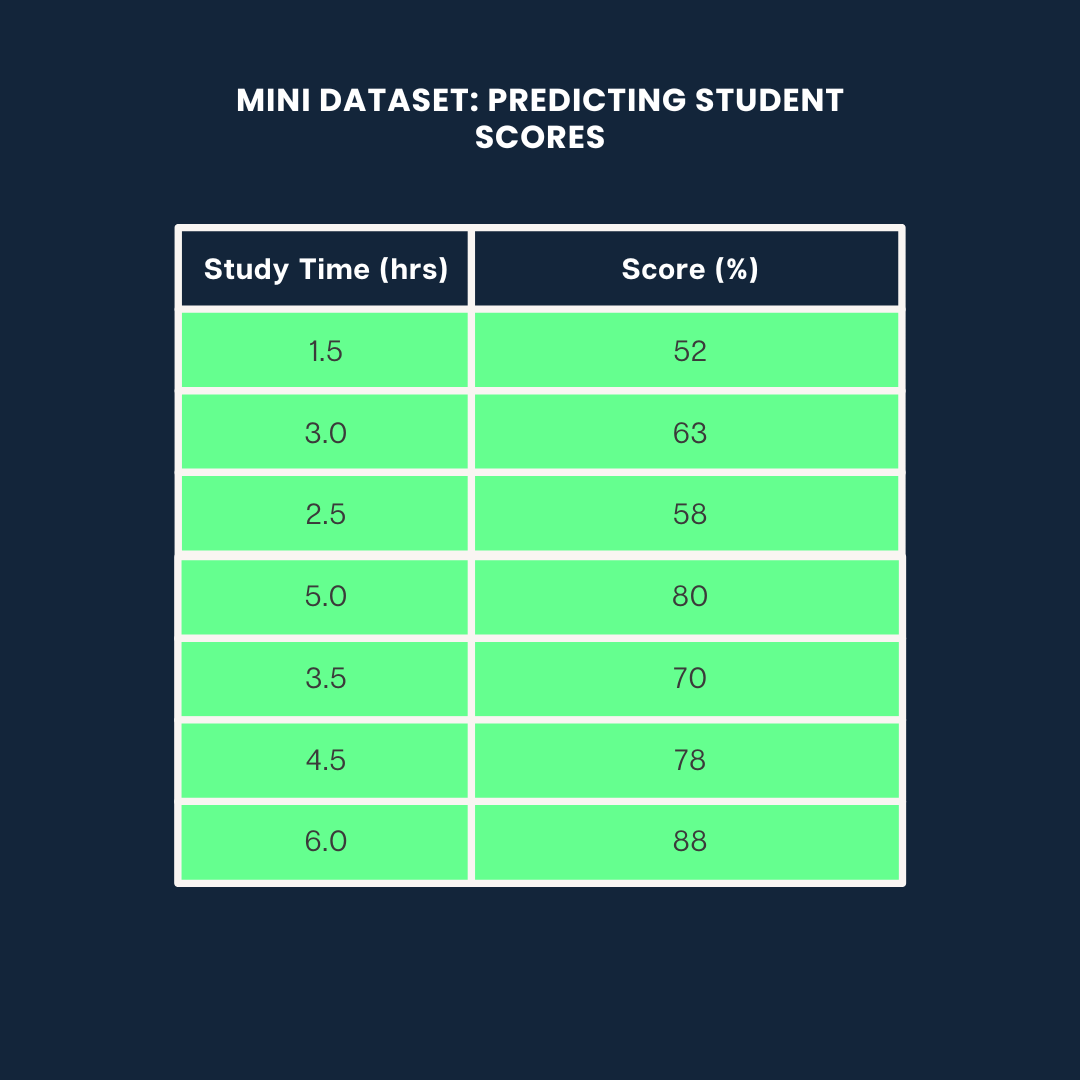
示例数据集。作者制图
以下展示如何使用 scikit-learn 在 Python 中计算 R²:
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import numpy as np

# Data
study_time = np.array([1.5, 3.0, 2.5, 5.0, 3.5, 4.5, 6.0]).reshape(-1, 1)
scores = np.array([52, 63, 58, 80, 70, 78, 88])

# Model
model = LinearRegression()
model.fit(study_time, scores)
predicted_scores = model.predict(study_time)

# R² score
r2 = r2_score(scores, predicted_scores)
print(f"R² = {r2:.2f}")0.99这表示分数变异的 99% 由学习时间解释。
如果您想进一步学习回归与统计模型,可参阅我们的指南:Introduction to Regression with statsmodels in Python。
在 R 中,您可以用几行代码,通过 lm() 函数计算 R²:
# Data
study_time <- c(1.5, 3.0, 2.5, 5.0, 3.5, 4.5, 6.0)
scores <- c(52, 63, 58, 80, 70, 78, 88)

# Linear model
model <- lm(scores ~ study_time)

# R-squared
summary(model)$r.squared0.9884718约 98% 的分数变异由学习时间解释。如果您想进一步学习 R 中的回归,请查看我们的课程:Introduction to Regression in R。
在 Excel 中,您可以使用内置的 RSQ() 函数计算 R²。假设:
学习时间在单元格 A2:A8 中
分数在单元格 B2:B8 中
其语法为:
RSQ(known_y's,known_x's)我使用了如下公式:
=RSQ(B2:B8,A2:A8)这告诉 Excel 计算因变量(分数)与自变量(学习时间)之间的 R² 值。
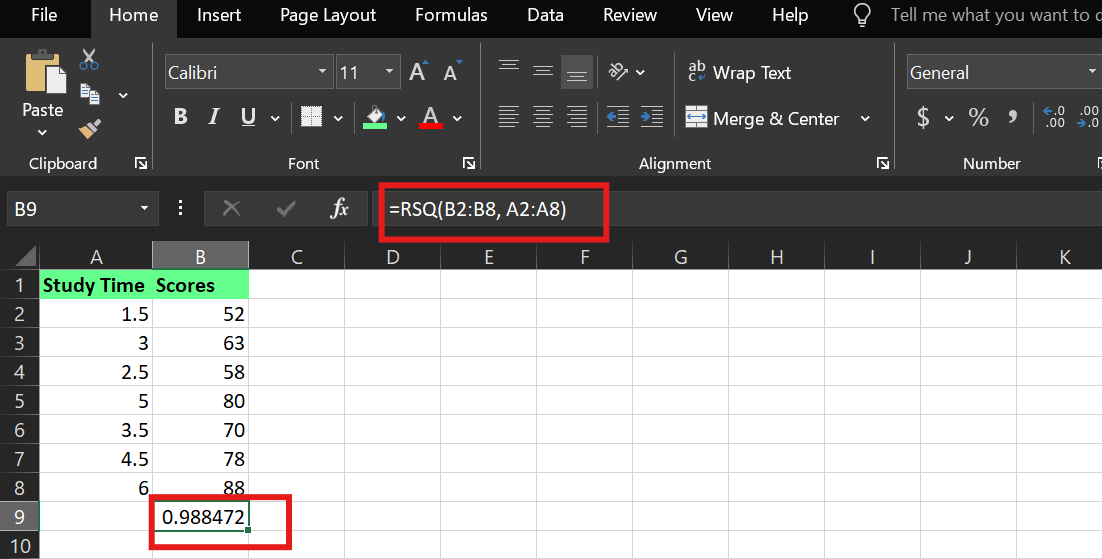
Excel 中的 R² 示例。作者制图。
无论您是在预测学生分数、股票收益还是客户行为,判定系数都能告诉您模型对结果的理解程度有多大。
较高的判定系数可能看起来很亮眼,但别因此误以为模型完美,或它证明了因果关系。而较低的判定系数也不总是意味着失败;这可能意味着系统很复杂,或变量尚不完整。
因此,在构建或分析模型时,请问问自己:
以此为出发点,您就能将判定系数作为更好决策的视角。
与 DataCamp 一起学习
课程
课程
课程