कोर्स
Python में statsmodels के साथ Regression परिचय
4 घंटा
63K
कल्पना कीजिए कि आप किसी के परीक्षा अंक का अनुमान पढ़ाई के घंटों के आधार पर लगाना चाहते हैं। अब, आपका अनुमान वास्तविक अंकों से कितना मेल खाता है? यही बात निर्धारण गुणांक, जिसे R² (R-स्क्वायर्ड) भी कहा जाता है, बताता है।
यह बताता है कि किसी एक चीज़ (जैसे परीक्षा अंक) में होने वाले बदलाव का कितना हिस्सा दूसरी चीज़ (जैसे पढ़ाई के घंटे) में बदलाव से समझाया जा सकता है। इस तरह आप समझ सकते हैं कि आपका मॉडल डेटा पर कितना "फिट" होता है।
इस लेख में, हम आपको समझाएँगे कि R² का मतलब क्या है, यह क्यों महत्वपूर्ण है, और आँकड़ों में नए होने पर भी इसे कैसे गणना करें और समझें।
निर्धारण गुणांक, जिसे आमतौर पर R² (R-स्क्वायर्ड) लिखा जाता है, एक संख्या है जो बताती है कि प्रतिगमन मॉडल डेटा में क्या हो रहा है, उसे कितनी अच्छी तरह समझाता है। यह दिखाता है कि परिणाम (आश्रित चर) में होने वाले बदलाव का कितना हिस्सा उन चीज़ों से समझाया जा सकता है जिनसे हम उसका पूर्वानुमान लगाते हैं (स्वतंत्र चर/चर)।
मान लीजिए आप किसी का वज़न उसकी लंबाई के आधार पर अनुमान लगाना चाहते हैं। यदि R² 1 के क़रीब है, तो आपका अनुमान बहुत अच्छा है। वज़न में अधिकांश अंतर लंबाई के अंतर से समझाए जा सकते हैं। यदि R² 0 के क़रीब है, तो आपका अनुमान लगभग अटकल जैसा है क्योंकि उस स्थिति में लंबाई वज़न में बदलाव को बहुत कम समझाती है।
हम R² के मान 0 और 1 के बीच अपेक्षित करते हैं:
0 का मतलब है कि मॉडल डेटा की किसी भी परिवर्तनशीलता को नहीं समझाता।
1 का मतलब है कि मॉडल पूरी परिवर्तनशीलता को समझाता है।
1 के नज़दीक मान बेहतर फिट दर्शाते हैं, यानी आपका मॉडल डेटा के पैटर्न का अधिक हिस्सा पकड़ रहा है।
जब आप केवल एक स्वतंत्र चर के साथ काम कर रहे होते हैं, तो मॉडल को साधारण रैखिक प्रतिगमन कहा जाता है। इस स्थिति में, R² का पीयरसन सहसंबंध गुणांक (r) से सीधा संबंध होता है: R² = r²
इसका मतलब है कि यदि आपके भविष्यवक्ता और परिणाम के बीच मज़बूत धनात्मक या ऋणात्मक सहसंबंध है, तो R² ऊँचा होगा।
नोट: जिन मॉडलों में एक से अधिक भविष्यवक्ता होते हैं (एकाधिक प्रतिगमन कहलाते हैं), R² अब भी बताता है कि कितना वैरिएंस समझाया गया है, लेकिन वह केवल r² नहीं रहता, क्योंकि अब आप कई चर के प्रभावों को जोड़ रहे होते हैं।
R² आमतौर पर 0 से 1 के बीच रहता है। लेकिन कभी-कभी आप नकारात्मक R² भी देख सकते हैं। ऐसा तब हो सकता है जब:
नकारात्मक R² का मतलब है कि आपका मॉडल औसत का अनुमान लगाने से भी बदतर कर रहा है। यानी, यह डेटा पर इतना खराब फिट है कि वह भ्रामक हो जाता है।
R² की गणना के दो सामान्य तरीके हैं:
आइए दोनों को समझते हैं।
R² के लिए सबसे आम सूत्र है:
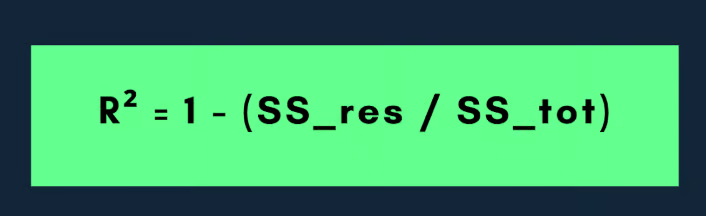
यहाँ, अवशिष्ट सम ऑफ स्क्वेयर (जो न समझाया गया भाग है)) मापता है कि वास्तविक मान आपके मॉडल द्वारा अनुमानित मानों से कितने दूर हैं। यही आपके मॉडल की त्रुटि है।
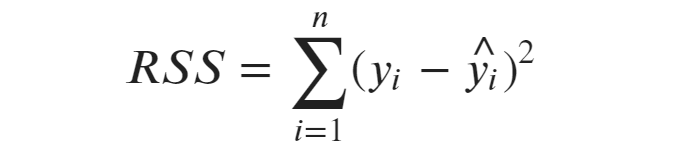
कुल सम ऑफ स्क्वेयर प्रेक्षित डेटा में कुल परिवर्तन है। यह बताता है कि वास्तविक मान आश्रित चर के औसत (मीन) से कितने दूर हैं।
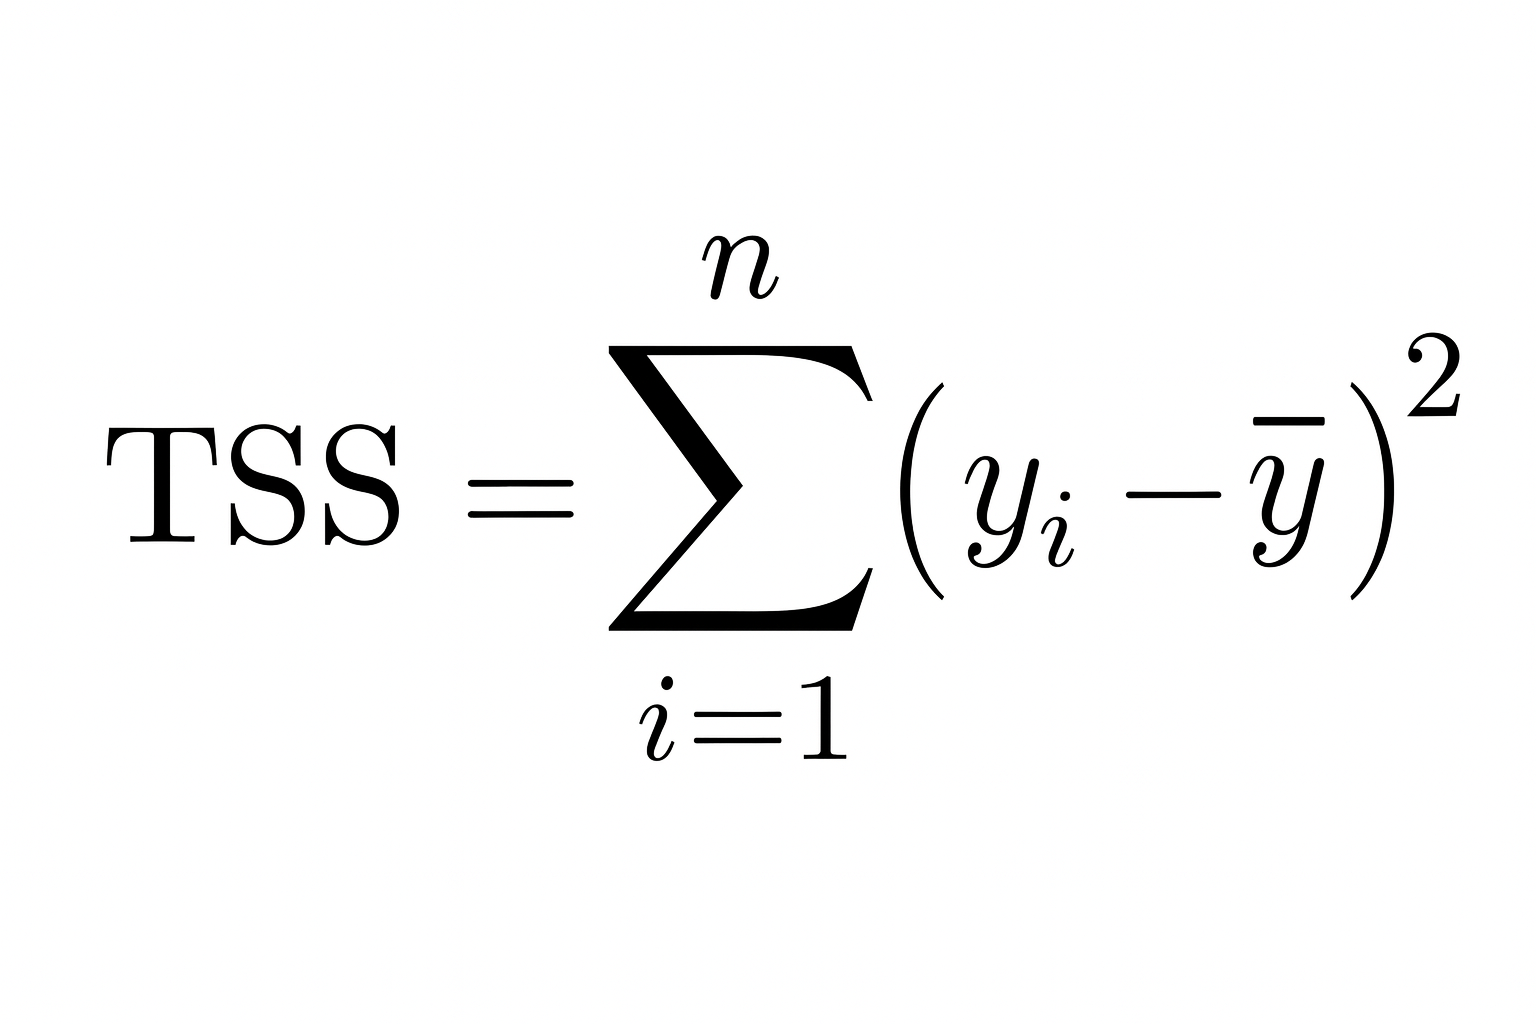
तो, जितना छोटा अवशिष्ट सम ऑफ स्क्वेयर कुल सम ऑफ स्क्वेयर की तुलना में होगा, आपका मॉडल उतना ही बेहतर फिट होगा, और R² 1 के उतना ही क़रीब होगा।
इसे एक उदाहरण से समझते हैं:
मान लीजिए आपके पास निम्न मानों वाला एक छोटा डेटासेट है:
|
प्रेक्षण |
वास्तविक |
अनुमानित |
|
1 |
10 |
12 |
|
2 |
12 |
11 |
|
3 |
14 |
13 |
पहले, वास्तविक मानों का औसत निकालें:
फिर कुल सम ऑफ स्क्वेयर निकालें (वास्तविक मान औसत से कितने दूर हैं):
अगला, अवशिष्ट सम ऑफ स्क्वेयर निकालें (वास्तविक मान अनुमानित मानों से कितने दूर हैं):
अब इसे सूत्र में डालें:
तो, R² = 0.25, यानी मॉडल डेटा में 25% परिवर्तन को समझाता है।
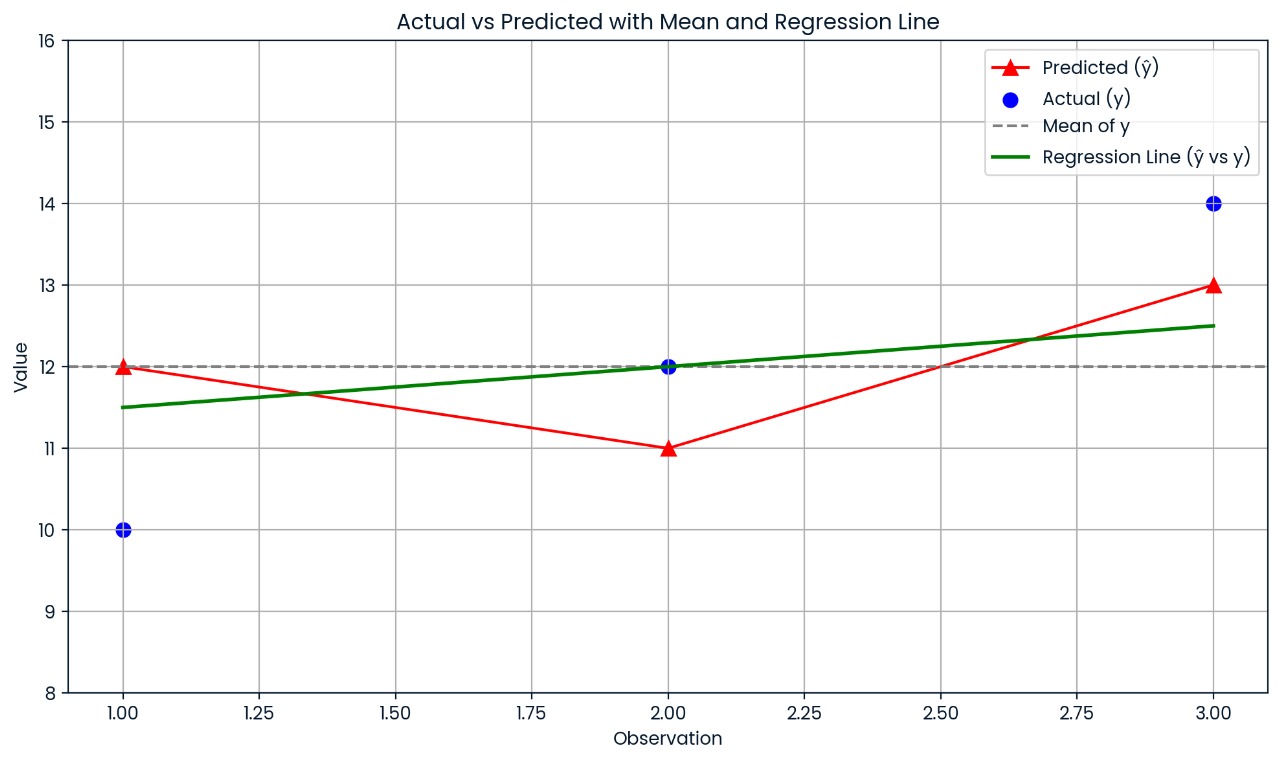
यह चार्ट दिखाता है कि प्रत्येक वास्तविक मान अपने अनुमानित मान से कितना दूर है। मॉडल के अनुमान काफ़ी हद तक चूक रहे हैं, इसलिए R² केवल 0.25 है; केवल 25% परिवर्तन समझाया गया है।
यदि आप साधारण रैखिक प्रतिगमन (केवल एक स्वतंत्र चर) का उपयोग कर रहे हैं, तो यह सूत्र अपनाएँ:
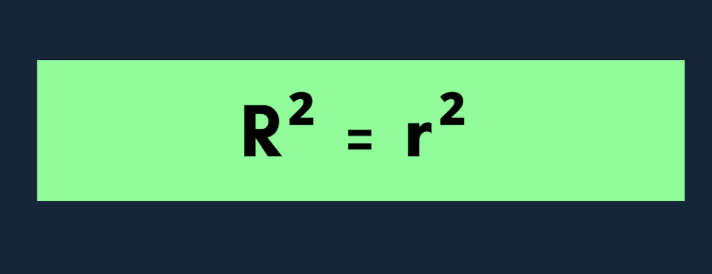
यहाँ r वास्तविक और अनुमानित मानों के बीच का पीयरसन सहसंबंध गुणांक है। यह शॉर्टकट तभी काम करता है जब केवल एक ही भविष्यवक्ता हो।
मान लीजिए X और Y के बीच सहसंबंध है: r = −0.8
भले ही सहसंबंध ऋणात्मक है (यानी चर विपरीत दिशा में चलते हैं), R² धनात्मक होता है: R² = (−0.8)² = 0.64
तो, परिणाम में 64% परिवर्तन अब भी भविष्यवक्ता द्वारा समझाया जा सकता है, भले ही संबंध ऋणात्मक हो। यही कारण है कि R² हमेशा शून्य या धनात्मक होता है; यह दिशा नहीं, बल्कि समझाए गए परिवर्तन की मात्रा दर्शाता है।
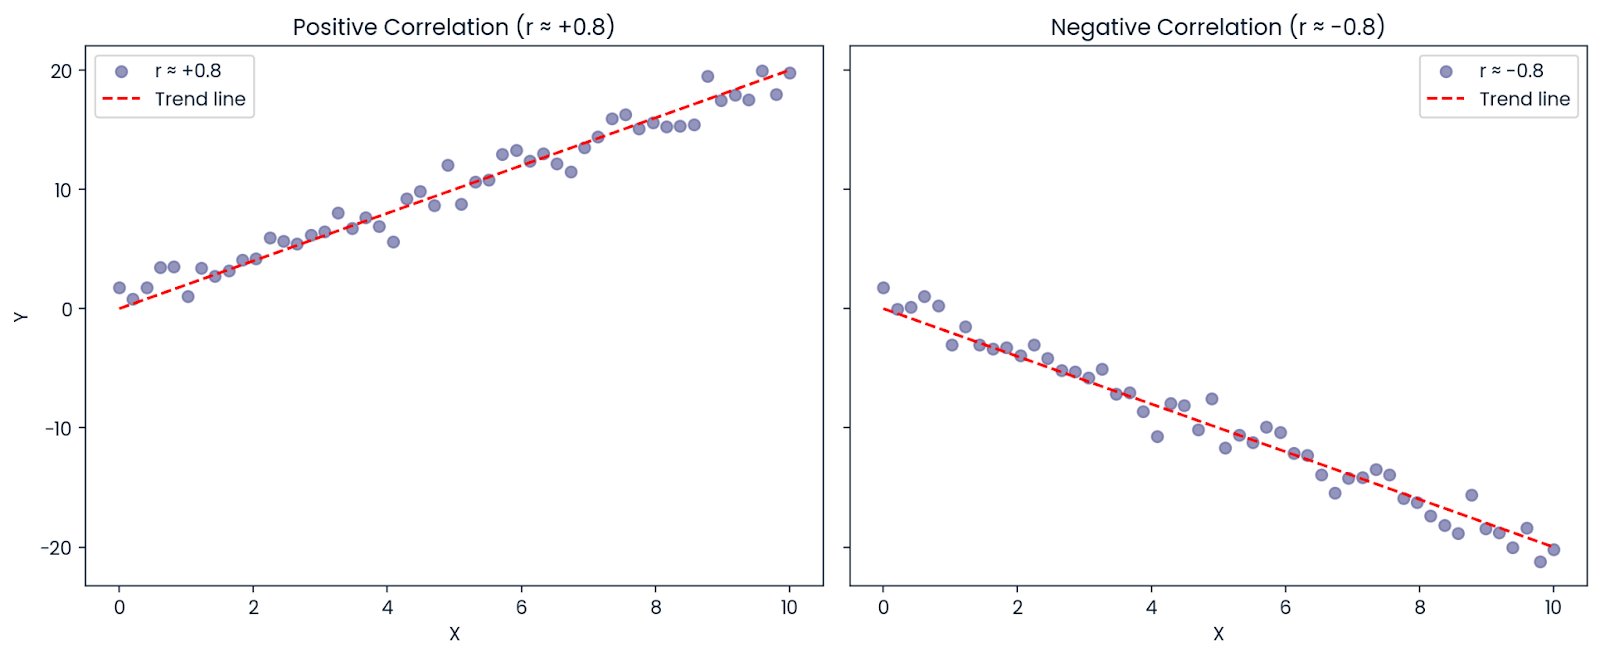
धनात्मक और ऋणात्मक सहसंबंध। छवि: लेखक
निर्धारण गुणांक हमें बताता है कि परिणाम (आश्रित चर) में होने वाले परिवर्तन का कितना हिस्सा हमारे मॉडल द्वारा समझाया जाता है। सरल शब्दों में, यह ऐसा है मानो पूछ रहे हों: "जिस चीज़ का मैं पूर्वानुमान लगाना चाहता हूँ, उसमें होने वाले बदलाव का कितना हिस्सा उस डेटा से समझाया जा सकता है जिसका मैं उपयोग कर रहा हूँ?"
मान लीजिए आप छात्रों के परीक्षा अंक पढ़ाई के घंटों के आधार पर अनुमानित करने का मॉडल बना रहे हैं। यदि आपके मॉडल से मिलता है: R² = 0.90
इसका मतलब है कि परीक्षा अंकों में 90% अंतर पढ़ाई के समय में अंतर से समझाया जा सकता है। बाकी 10% अन्य कारकों से आता है जिन्हें आपके मॉडल ने शामिल नहीं किया, जैसे नींद, स्वाभाविक योग्यता, पूर्व ज्ञान, या परीक्षा की कठिनाई।
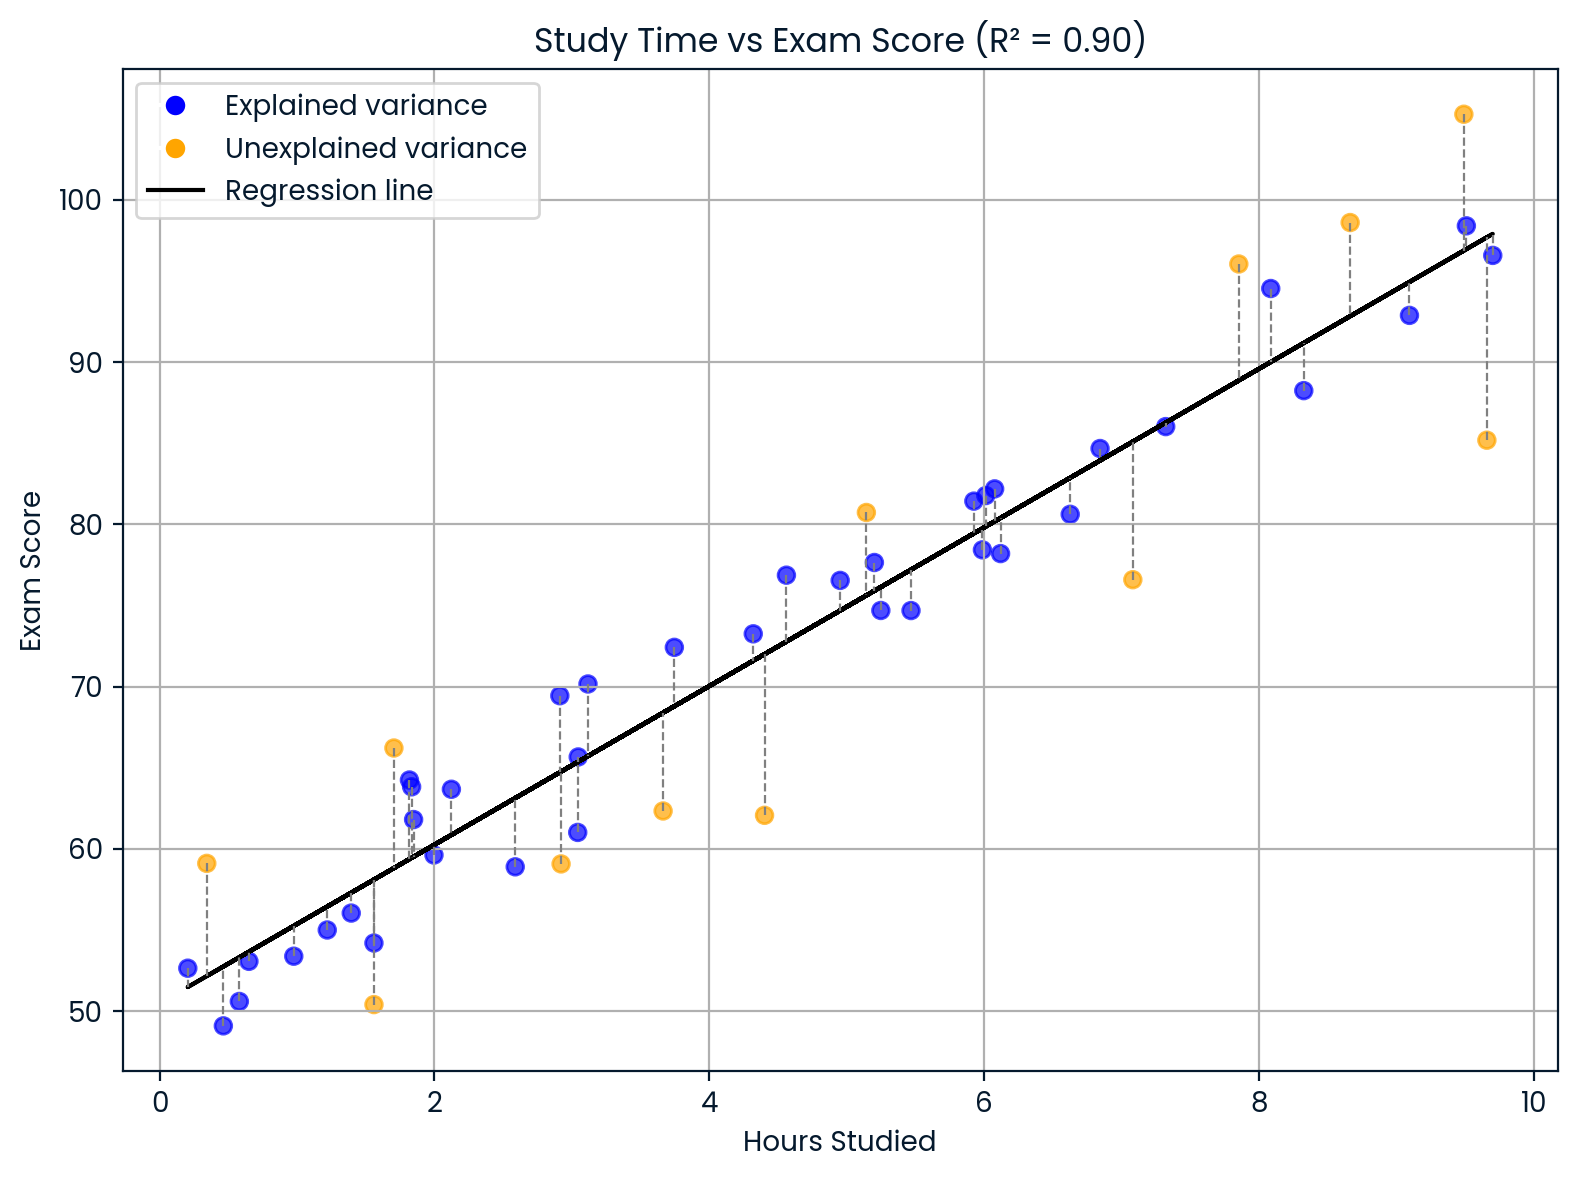
निर्धारण गुणांक की व्याख्या। छवि: लेखक
यह चार्ट दिखाता है कि पढ़ाई का समय परीक्षा अंकों को कैसे प्रभावित करता है।
जेकब कोहेन ने व्यापक रूप से उपयोग होने वाला मार्गदर्शक दिया, जो बताता है कि संबंध की मज़बूती की व्याख्या करते समय विभिन्न R² मानों का क्या अर्थ हो सकता है।
यह रहे कोहेन के R² के मोटे मानदंड:
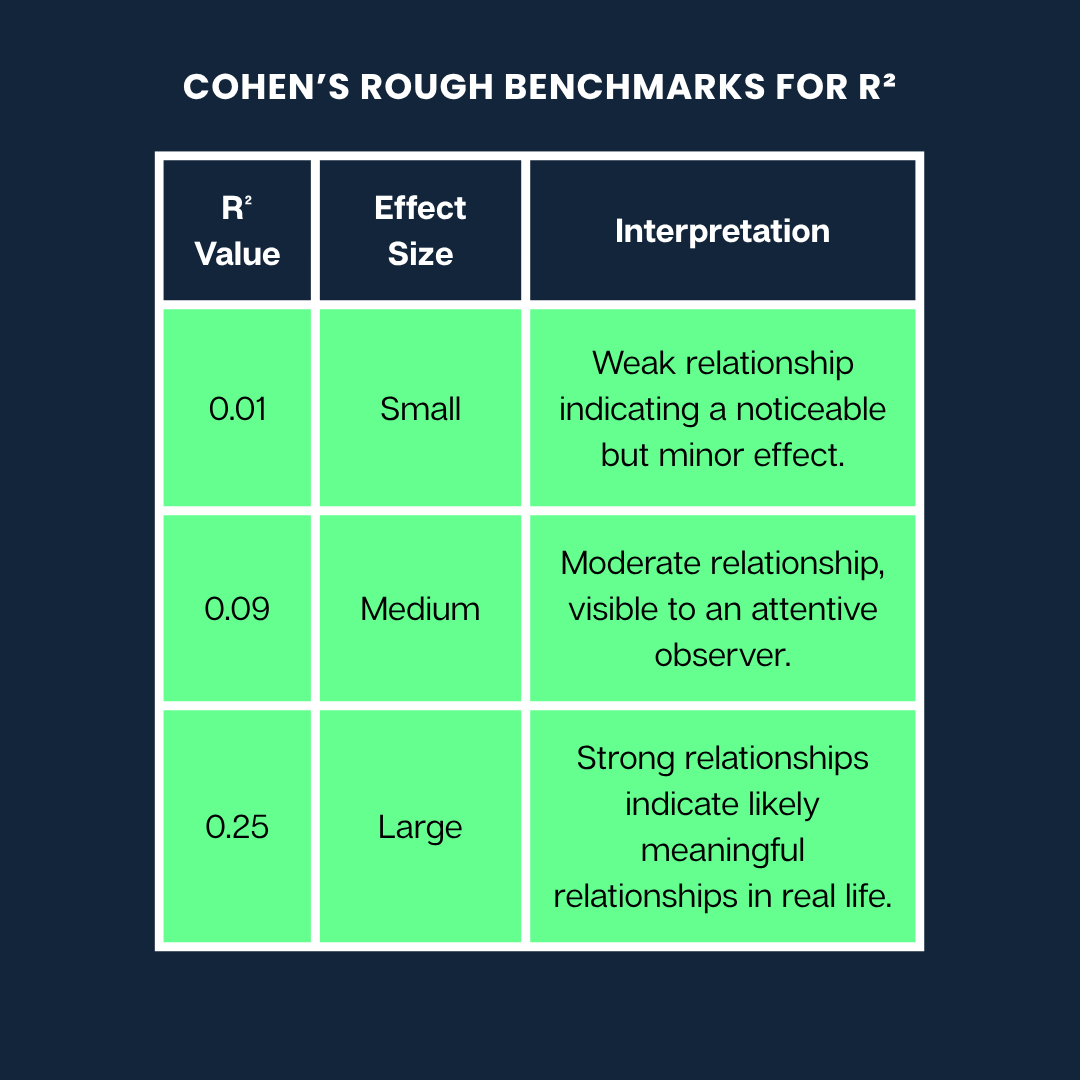
कोहेन के मोटे मानदंड। छवि: लेखक
नोट: ये सामान्य दिशानिर्देश हैं। आपके क्षेत्र (जैसे मनोविज्ञान बनाम अभियांत्रिकी) और शोध के संदर्भ के अनुसार “बड़ा” या “छोटा” प्रभाव काफी भिन्न हो सकता है।
हालाँकि R² सहायक है, आपको समझना चाहिए कि यह क्या बता सकता है और क्या नहीं। यहाँ कुछ आम गलतफहमियाँ और सीमाएँ हैं जिनसे बचना चाहिए:
ऐसा लग सकता है कि ऊँचा R² हमेशा बेहतर मॉडल का संकेत है, पर यह ज़रूरी नहीं। R² तब हमेशा बढ़ता है या समान रहता है जब आप मॉडल में और चर जोड़ते हैं, भले ही वे पूरी तरह अप्रासंगिक हों।
क्यों?
क्योंकि मॉडल के पास प्रशिक्षण डेटा पर फिट होने की अधिक स्वतंत्रता होती है, भले ही वह केवल यादृच्छिक शोर को ही फिट कर रहा हो। इससे ओवरफिटिंग हो सकती है, जहाँ आपका मॉडल जिस डेटा पर प्रशिक्षित हुआ है उस पर शानदार दिखता है, पर नए डेटा पर खराब प्रदर्शन करता है।
टिप: मॉडलों की तुलना करते समय जिनमें भविष्यवक्ताओं की संख्या अलग-अलग हो, समायोजित R² का उपयोग करें। यह अनावश्यक जटिलता पर दंड लगाता है और ओवरफिटिंग का पता लगाने में मदद कर सकता है।
R² केवल यह मापता है कि मॉडल आपके पास मौजूद डेटा का कितना अच्छा वर्णन करता है। यह यह नहीं बताता:
बहुत सारे भविष्यवक्ता इस्तेमाल करने पर ऊँचा R² संयोग से भी आ सकता है। इसलिए हमेशा अन्य मॉडल मूल्यांकन मीट्रिक (जैसे पूर्वानुमान गुणवत्ता के लिए RMSE या MAE) भी देखें और याद रखें: सहसंबंध, कारण-प्रभाव नहीं होता।
कभी-कभी जटिल प्रणालियों (जैसे मानवीय व्यवहार या वित्तीय बाज़ार का पूर्वानुमान) में कम R² अपेक्षित होता है।
उदाहरण के लिए, यदि आप किसी ऐसी चीज़ का मॉडल बना रहे हैं जो कई अप्रत्याशित या मापना कठिन कारकों से प्रभावित होती है, तो कम R² के बावजूद आपका मॉडल उपयोगी हो सकता है। यह कोई सार्थक प्रवृत्ति पकड़ सकता है या अंतर्दृष्टि दे सकता है, भले ही वह वैरिएंस का बड़ा हिस्सा न समझाए।
चिकित्सा या मनोवैज्ञानिक शोध में कम R² मान देखना आम है क्योंकि परिणाम अनेक अंतःक्रियात्मक चर पर निर्भर करते हैं।
जहाँ रैखिक प्रतिगमन में मॉडल फिट समझने में R² मदद करता है, वहीं अलग संदर्भों के लिए अन्य रूपांतर और सामान्यीकरण भी हैं।
साधारण R² की तरह, समायोजित R² भी बताता है कि आश्रित चर में परिवर्तन का कितना हिस्सा मॉडल से समझाया गया है। लेकिन यह एक कदम आगे जाकर अनावश्यक जटिलता पर दंड लगाता है। यानी, यह आपको ऐसे अतिरिक्त भविष्यवक्ताओं से मॉडल भरने से रोकता है जो मदद नहीं करते।
इसका सूत्र है:
Adjusted R² = 1 - [ (1 - R²) × (n - 1) / (n - p - 1) ]यहाँ:
n प्रेक्षणों (डेटा बिंदुओं) की संख्या है
p भविष्यवक्ताओं (स्वतंत्र चरों) की संख्या है
यदि कोई नया चर मॉडल में सुधार नहीं करता, तो यह सूत्र R² को नीचे समायोजित कर देता है। जैसे-जैसे आप अधिक भविष्यवक्ता जोड़ते हैं, यह दंड और मज़बूत होता जाता है।
उदाहरण के लिए, यदि आप कोई नया चर जोड़ते हैं जो आपके मॉडल की सटीकता बढ़ाता है, तो समायोजित R² बढ़ेगा। लेकिन यदि वह चर मुश्किल से कुछ बदलता है या संयोगवश ही मदद करता है, तो समायोजित R² घट जाएगा, जो संभावित ओवरफिटिंग की चेतावनी देता है।
यह समायोजित R² को मॉडलों की तुलना के लिए उपयोगी बनाता है।
मान लीजिए आपको तीन भविष्यवक्ताओं वाले सरल मॉडल और छह वाले अधिक जटिल मॉडल में से चुनना है। भले ही जटिल मॉडल का R² थोड़ा ऊँचा हो, समायोजित R² कम हो सकता है, यह संकेत देते हुए कि अतिरिक्त जटिलता सार्थक नहीं है।
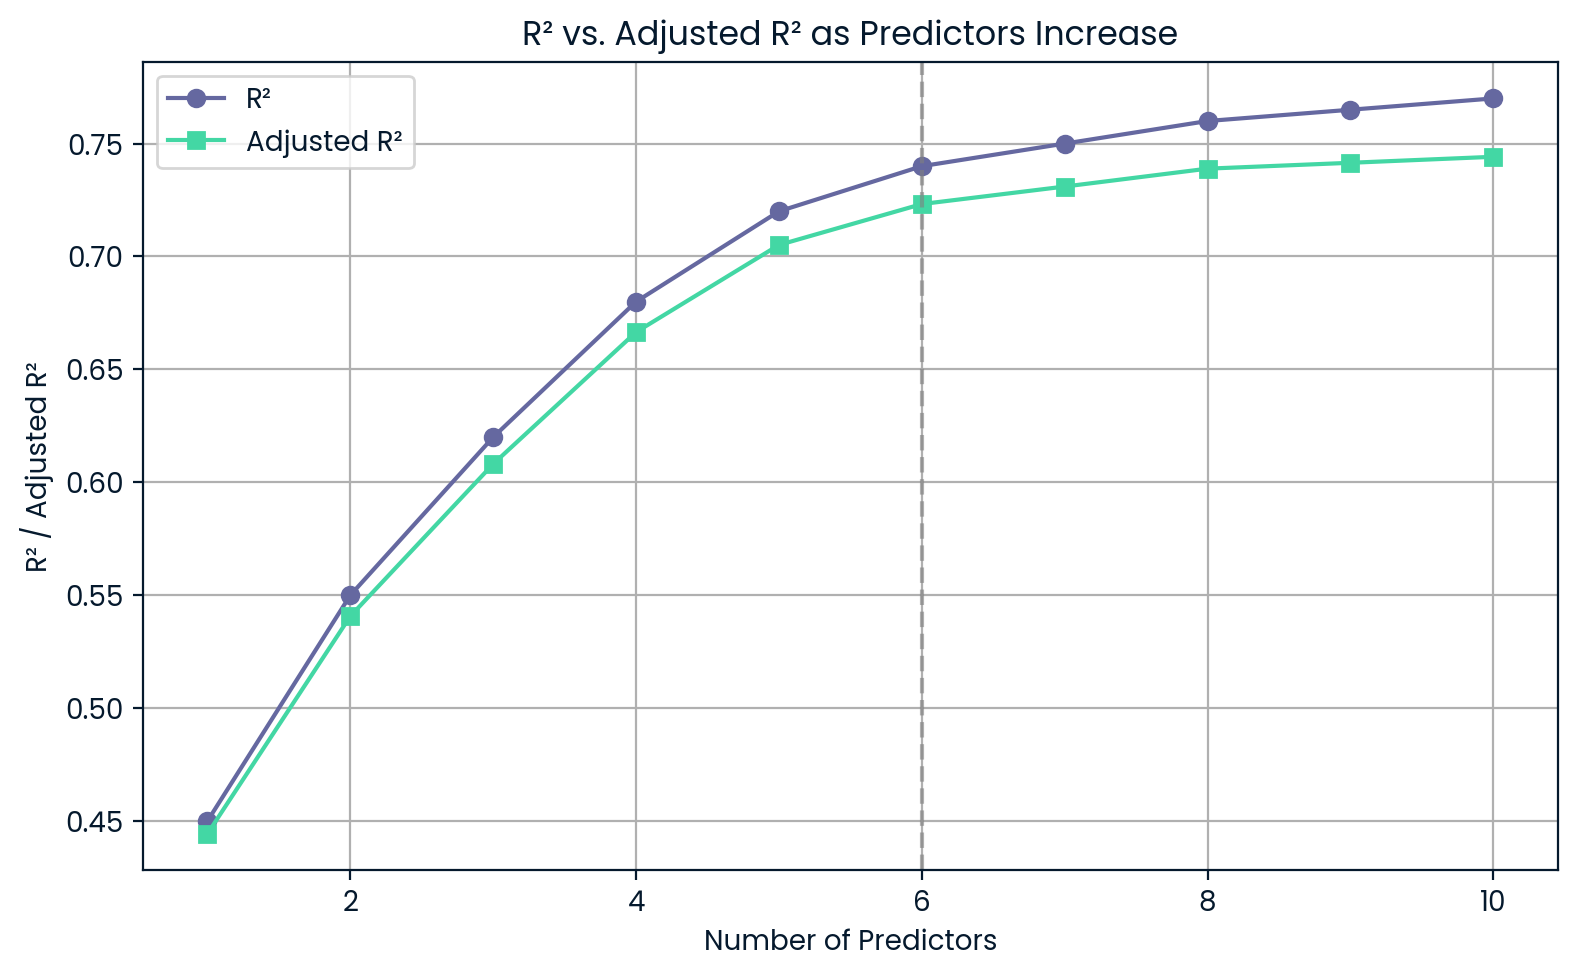
भविष्यवक्ताओं के बढ़ने पर R² बनाम समायोजित R²। छवि: लेखक
यह चार्ट दिखाता है कि जैसे-जैसे आप और भविष्यवक्ता जोड़ते हैं, R² बढ़ता रहता है भले ही वे बहुत उपयोगी न हों। दूसरी ओर, समायोजित R² अत्यधिक जोड़ने पर गिरता है और ओवरफिटिंग की चेतावनी देता है।
आंशिक R² (या आंशिक निर्धारण गुणांक) यह बताता है कि पहले से शामिल अन्य चरों वाले मॉडल में किसी एक विशेष भविष्यवक्ता को जोड़ने से आश्रित चर के वैरिएंस का कितना अतिरिक्त हिस्सा समझाया गया।
आंशिक R² निकालने के लिए, हम दो मॉडलों की तुलना करते हैं:
आंशिक R² का सूत्र उस कमी पर आधारित है जो नए चर को जोड़ने पर Sum of Squared Errors (SSE) में आती है। एक सामान्य रूप है:
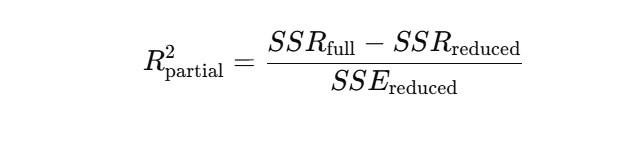
या प्रतिगमन सम ऑफ स्क्वेयर के संदर्भ में:
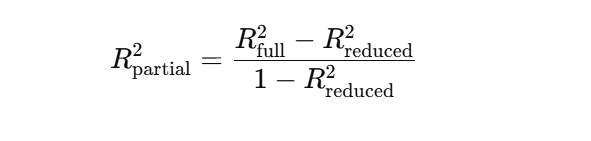
मान लीजिए आप उत्पाद बिक्री का पूर्वानुमान लगाने के लिए मॉडल बना रहे हैं।
आपके मॉडल में पहले से “उत्पाद मूल्य” और “सीज़न” शामिल हैं। अब, आप देखना चाहते हैं कि “मार्केटिंग खर्च” जोड़ने से पूर्वानुमान में सुधार होता है या नहीं। आंशिक R² आपको बताता है कि “मार्केटिंग खर्च” शामिल करने से बिक्री में वैरिएंस का कितना अधिक हिस्सा समझाया गया।
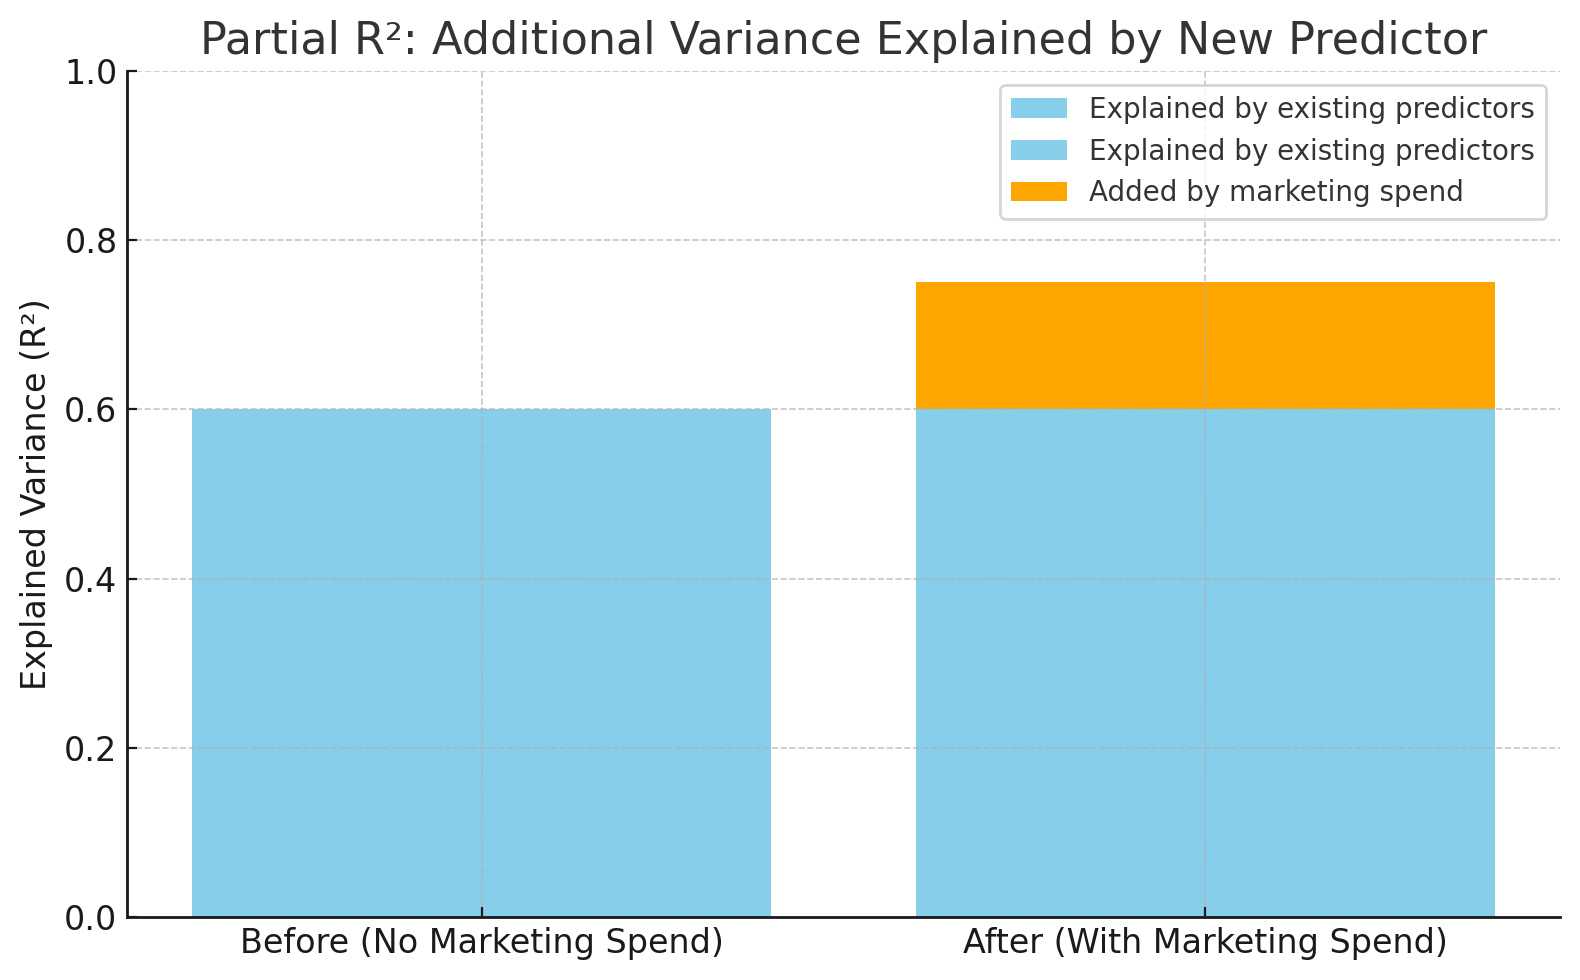
मार्केटिंग खर्च जोड़ने के बाद R² 0.60 से 0.75 तक बढ़ता है। छवि: लेखक
यह चार्ट दिखाता है कि “मार्केटिंग खर्च” जोड़ने पर मॉडल कितना अधिक सटीक हो जाता है। R² 0.60 से 0.75 हो जाता है, यानी नए चर ने बिक्री में 15% अतिरिक्त परिवर्तन समझाया—यही आंशिक R² है।
लॉजिस्टिक प्रतिगमन में परिणाम चर श्रेणीबद्ध होता है, जैसे हाँ/नहीं, पास/फेल, इसलिए पारंपरिक R² लागू नहीं होता। इसके बजाय, हम स्यूडो-R² मीट्रिक का उपयोग करते हैं, जिनका उद्देश्य समान होता है: यह अनुमान लगाना कि मॉडल परिणामों की विविधता को कितनी अच्छी तरह समझाता है।
दो सामान्य स्यूडो-R² मान हैं:
मान लीजिए आप यह मॉडल बना रहे हैं कि कोई ग्राहक विज्ञापन पर क्लिक करेगा या नहीं (हाँ/नहीं)। क्योंकि परिणाम द्विआधारी है, आप सामान्य R² का उपयोग नहीं कर सकते। लेकिन Nagelkerke जैसे स्यूडो-R² मान लॉजिस्टिक मॉडलों की तुलना और उनकी भविष्यवाणी क्षमता का आकलन करने में मदद करते हैं, भले ही वे रैखिक प्रतिगमन के R² के सीधे समकक्ष न हों।
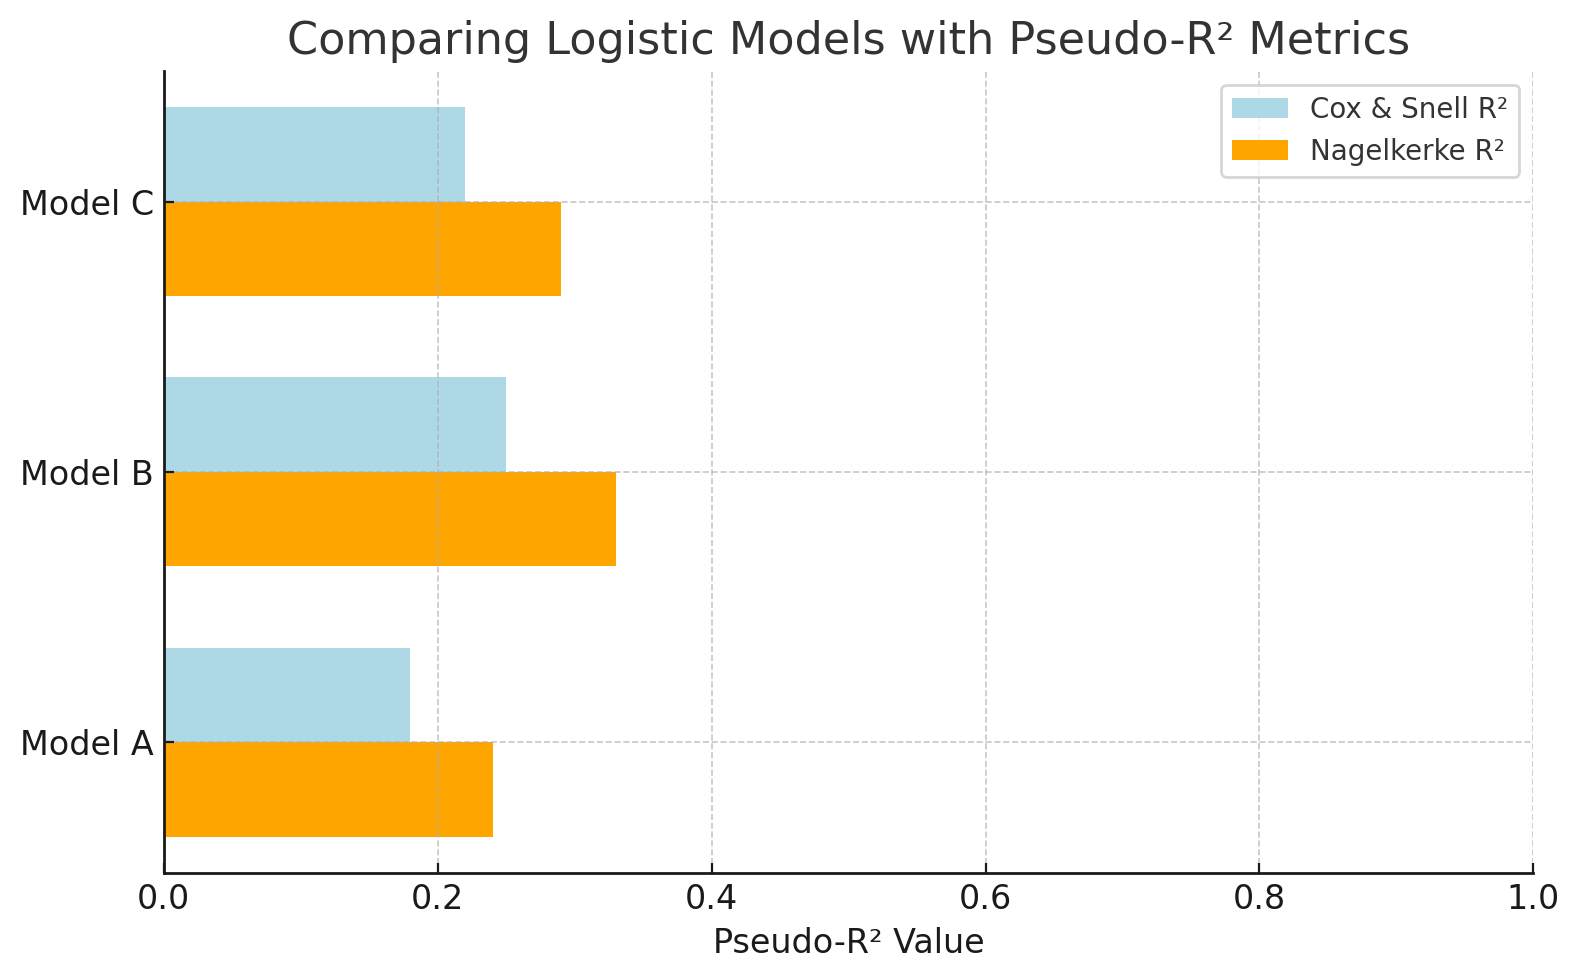
स्यूडो-R² मीट्रिक के साथ लॉजिस्टिक मॉडलों की तुलना करें। छवि: लेखक
यह चार्ट स्यूडो-R² मानों का उपयोग करके लॉजिस्टिक प्रतिगमन मॉडलों की तुलना करता है। Nagelkerke R² Cox & Snell की तुलना में अधिक व्याख्यायोग्य स्केल देता है। इससे यह आँकना आसान हो जाता है कि प्रत्येक मॉडल परिणाम (जैसे, विज्ञापन क्लिक की भविष्यवाणी) को कितना अच्छी तरह समझाता है।
जहाँ R² समझाई गई विविधता को समझने में सहायक है, यह नहीं बताता कि आपके पूर्वानुमान कितने दूर चूक रहे हैं। इसके लिए त्रुटि-आधारित मीट्रिक जैसे RMSE, MAE और MAPE काम आते हैं।
संक्षिप्त तुलना:
|
मीट्रिक |
यह क्या बताता है |
सबसे अच्छा उपयोग कब |
किससे सावधान रहें |
|
R² |
समझाया गया वैरिएंस % |
रैखिक मॉडलों की तुलना, व्याख्यात्मकता |
भ्रामक हो सकता है यदि अवशिष्ट सामान्य न हों या मॉडल गैर-रैखिक हो |
|
RMSE |
बड़ी त्रुटियों को अधिक दंड |
बड़ी त्रुटि-प्रभाव को प्राथमिकता देना (जैसे, विज्ञान, ML) |
आउटलायर के प्रति संवेदनशील |
|
MAE |
औसत त्रुटि (परम) |
मज़बूत, सरल त्रुटि ट्रैकिंग (जैसे, वित्त) |
बड़ी त्रुटियों के प्रति कम संवेदनशील |
|
MAPE |
वास्तविक के सापेक्ष % त्रुटि |
पूर्वानुमान, व्यावसायिक संदर्भ |
जब वास्तविक मान शून्य के पास हों तो गड़बड़ा जाता है |
|
सामान्यीकृत अवशिष्ट |
वैरिएंस के अनुसार समायोजित त्रुटि |
वेटेड प्रतिगमन, मापन विश्वसनीयता बदलती हो |
ज्ञात त्रुटि वैरिएंस की आवश्यकता |
|
काई-स्क्वायर |
अवशिष्ट बनाम ज्ञात वैरिएंस |
विज्ञान, गुडनेस-ऑफ-फिट परीक्षण |
सामान्यता और ज्ञात त्रुटि संरचना मानता है |
अब, आइए अनगिनत मामलों में से कुछ देखें जहाँ निर्धारण गुणांक का उपयोग किया गया है।
अर्थशास्त्र में, R² का उपयोग सकल घरेलू उत्पाद (GDP) जैसे व्यापक सूचकों में होने वाले बदलावों को समझाने के लिए किया जाता है। उदाहरण के लिए, किसी मॉडल में ब्याज दरें, उपभोक्ता व्यय, और व्यापार संतुलन जैसे चर शामिल हो सकते हैं ताकि GDP का पूर्वानुमान लगाया जा सके।
यदि ऐसा मॉडल 0.83 का R² देता है, तो इसका मतलब है कि GDP में 83% परिवर्तन इन आर्थिक कारकों से समझाया जा सकता है। यह अर्थशास्त्रियों को समझने में मदद करता है कि GDP के उतार-चढ़ाव का कितना हिस्सा ज्ञात कारकों से आता है।
एक शोध अध्ययन ने U.S. GDP को स्वतंत्र चर के रूप में लेकर S&P 500 इंडेक्स का पूर्वानुमान लगाया और R² 0.83 पाया। इसने आर्थिक गतिविधि और शेयर बाज़ार रुझानों के बीच मज़बूत संबंध दिखाया।
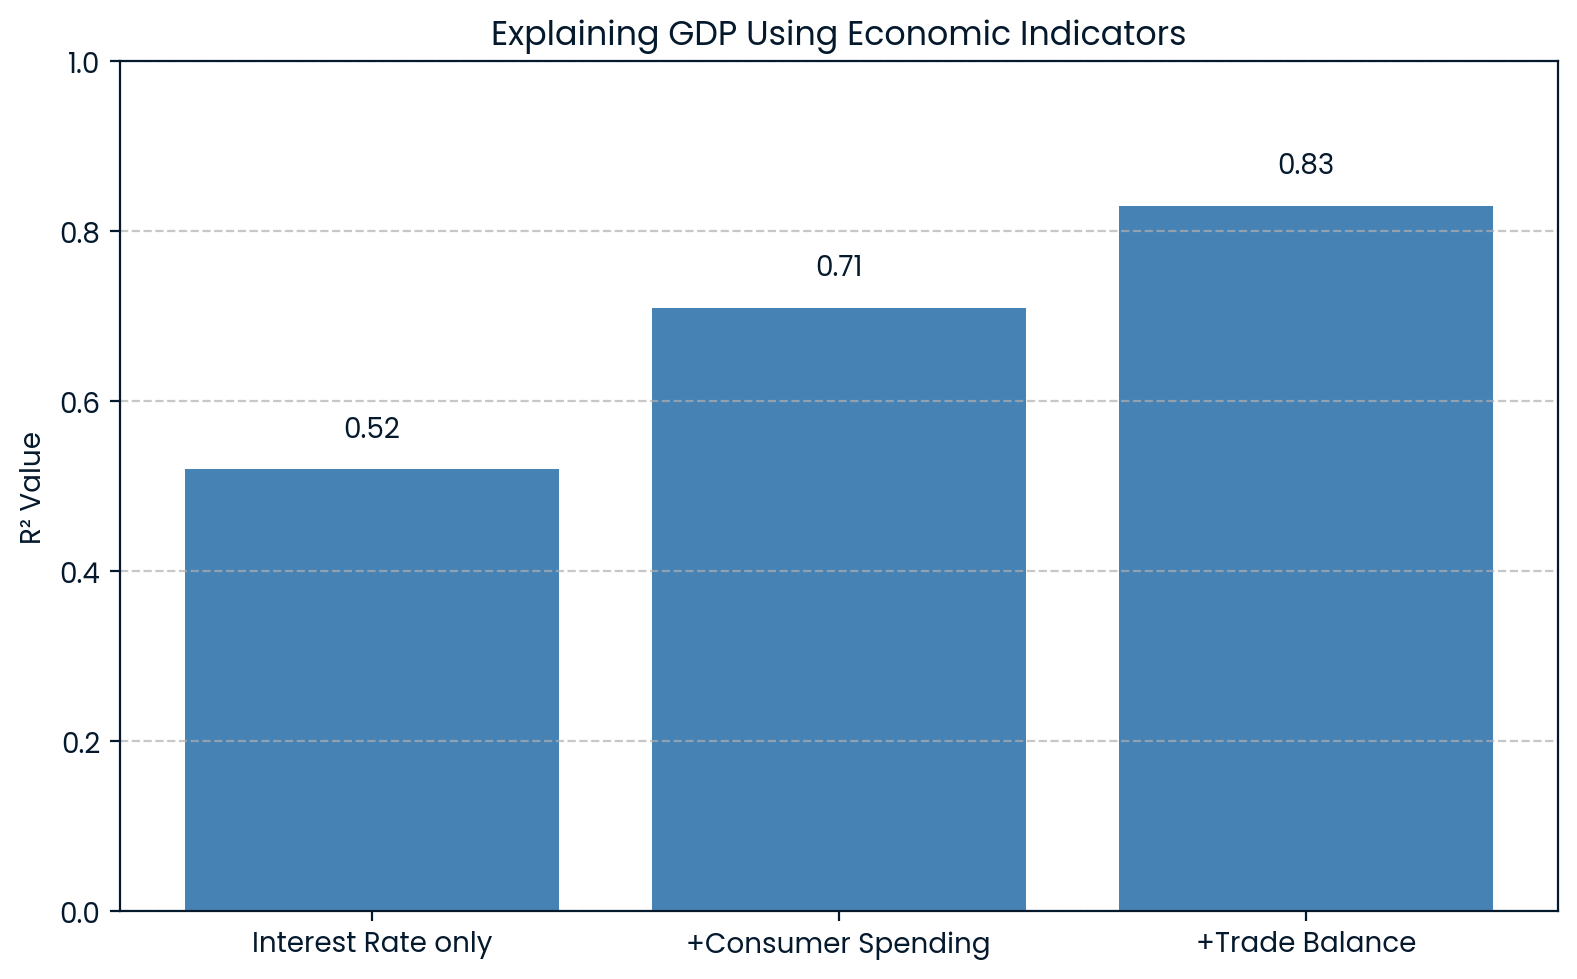
GDP अर्थशास्त्र को समझाते हुए R²। छवि: लेखक
चार्ट दिखाता है कि जैसे-जैसे और आर्थिक सूचक मॉडल में जोड़े जाते हैं, R² बढ़ता है, सभी तीन चरों के साथ 0.52 से 0.83 तक। इससे स्पष्ट होता है कि जोड़ा गया प्रत्येक कारक GDP में उतार-चढ़ाव को बेहतर ढंग से समझाता है।
वित्त में, R² मापता है कि किसी स्टॉक के रिटर्न का कितना हिस्सा समग्र बाज़ार की चालों से समझाया जा सकता है। यह किसी स्टॉक के रिटर्न को S&P 500 जैसे बाज़ार सूचकांक के विरुद्ध प्रतिगमन करके किया जाता है।
उदाहरण के लिए, यदि आप Apple (AAPL) के रिटर्न को S&P 500 के विरुद्ध रिग्रेस करते हैं और R² = 0.82 पाते हैं, तो इसका मतलब है कि Apple के रिटर्न मूवमेंट्स का 85% व्यापक बाज़ार से समझाया जाता है।
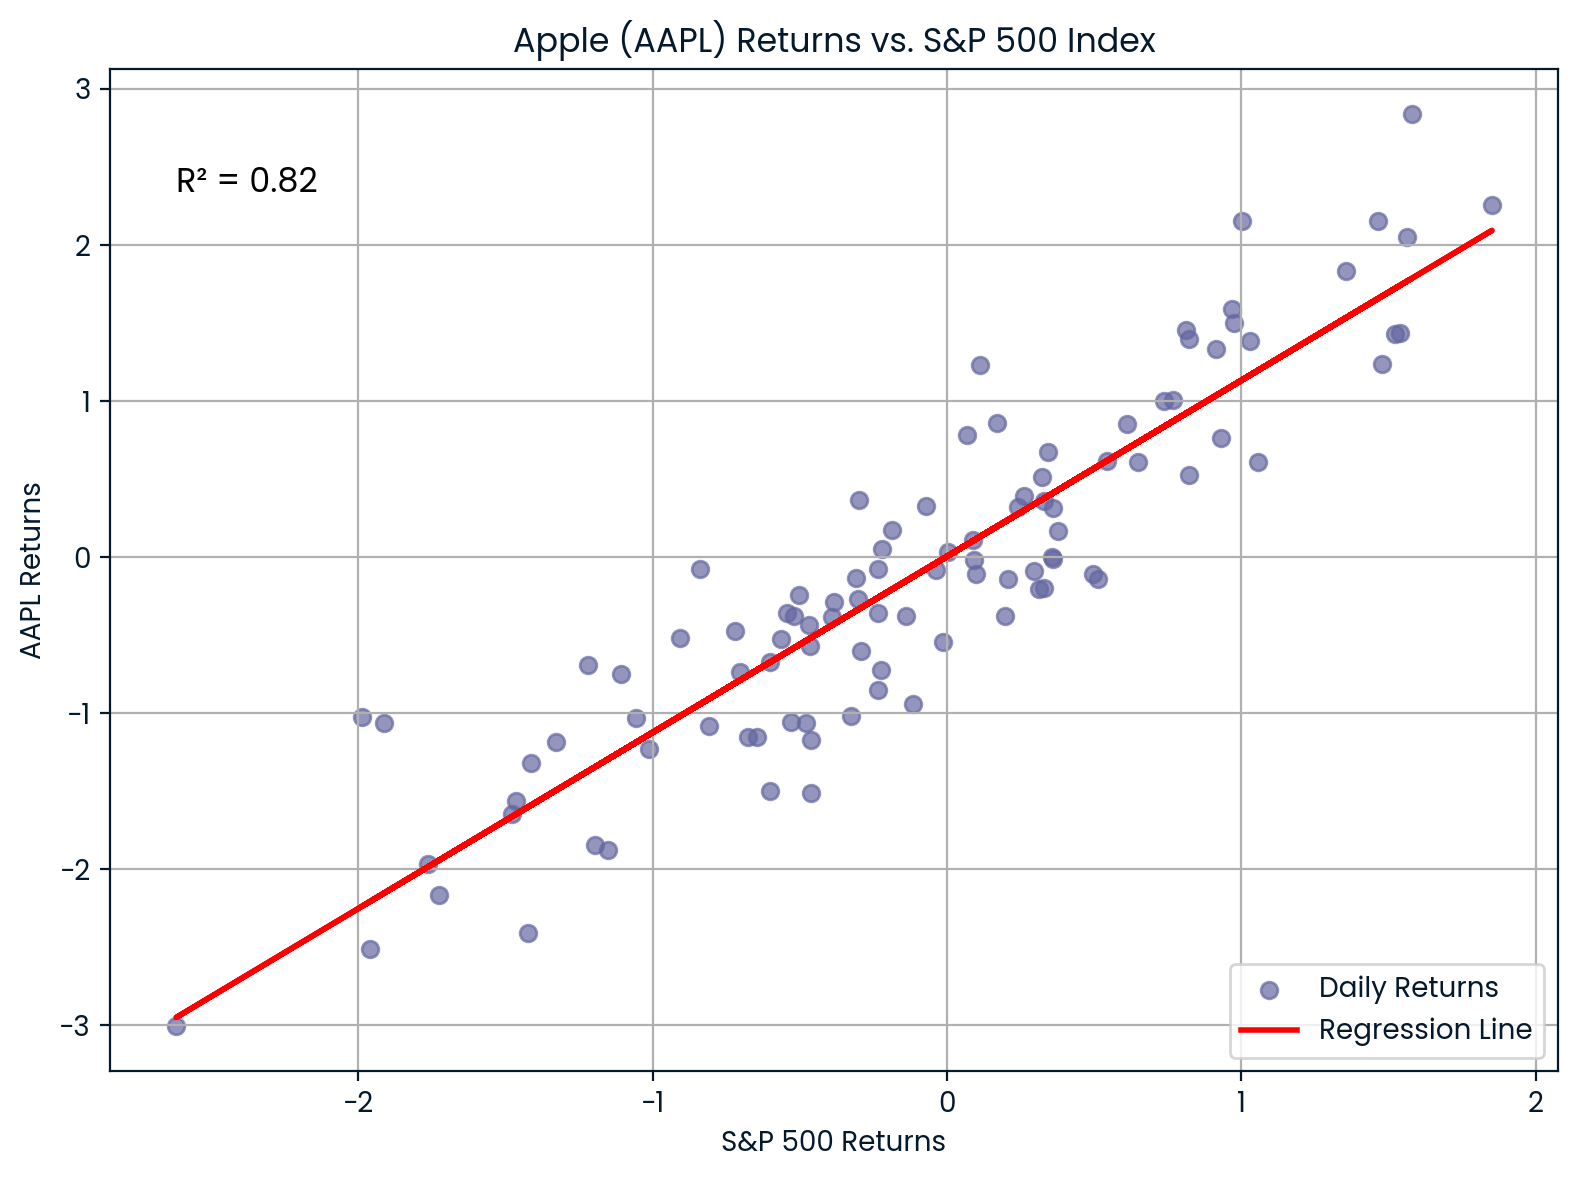
AAPL और S&P 500 के बीच सहसंबंध। छवि: लेखक
चार्ट Apple (AAPL) और S&P 500 के बीच मज़बूत सहसंबंध दिखाता है। 0.82 के R² के साथ, Apple की अधिकांश मूल्य चालें बाज़ार रुझानों के साथ क़रीबी मेल खाती हैं, जो उच्च बाज़ार संवेदनशीलता दर्शाती हैं।
मार्केटिंग में, R² दिखाता है कि विज्ञापन खर्च ग्राहक रूपांतरण दरों को कितनी अच्छी तरह समझाता है।
मान लीजिए आप एक ई-कॉमर्स कंपनी में काम करते हैं और जानना चाहते हैं कि मासिक विज्ञापन खर्च बढ़ाने से रूपांतरण दर में सुधार होता है या नहीं। आप रैखिक प्रतिगमन चलाते हैं और R² = 0.98 पाते हैं। इसका मतलब है कि रूपांतरण दर में 98% परिवर्तन आपके विज्ञापन खर्च से समझाया जाता है, जो बहुत मज़बूत संबंध का संकेत है।
ये अंतर्दृष्टि विपणक की मदद करती हैं:
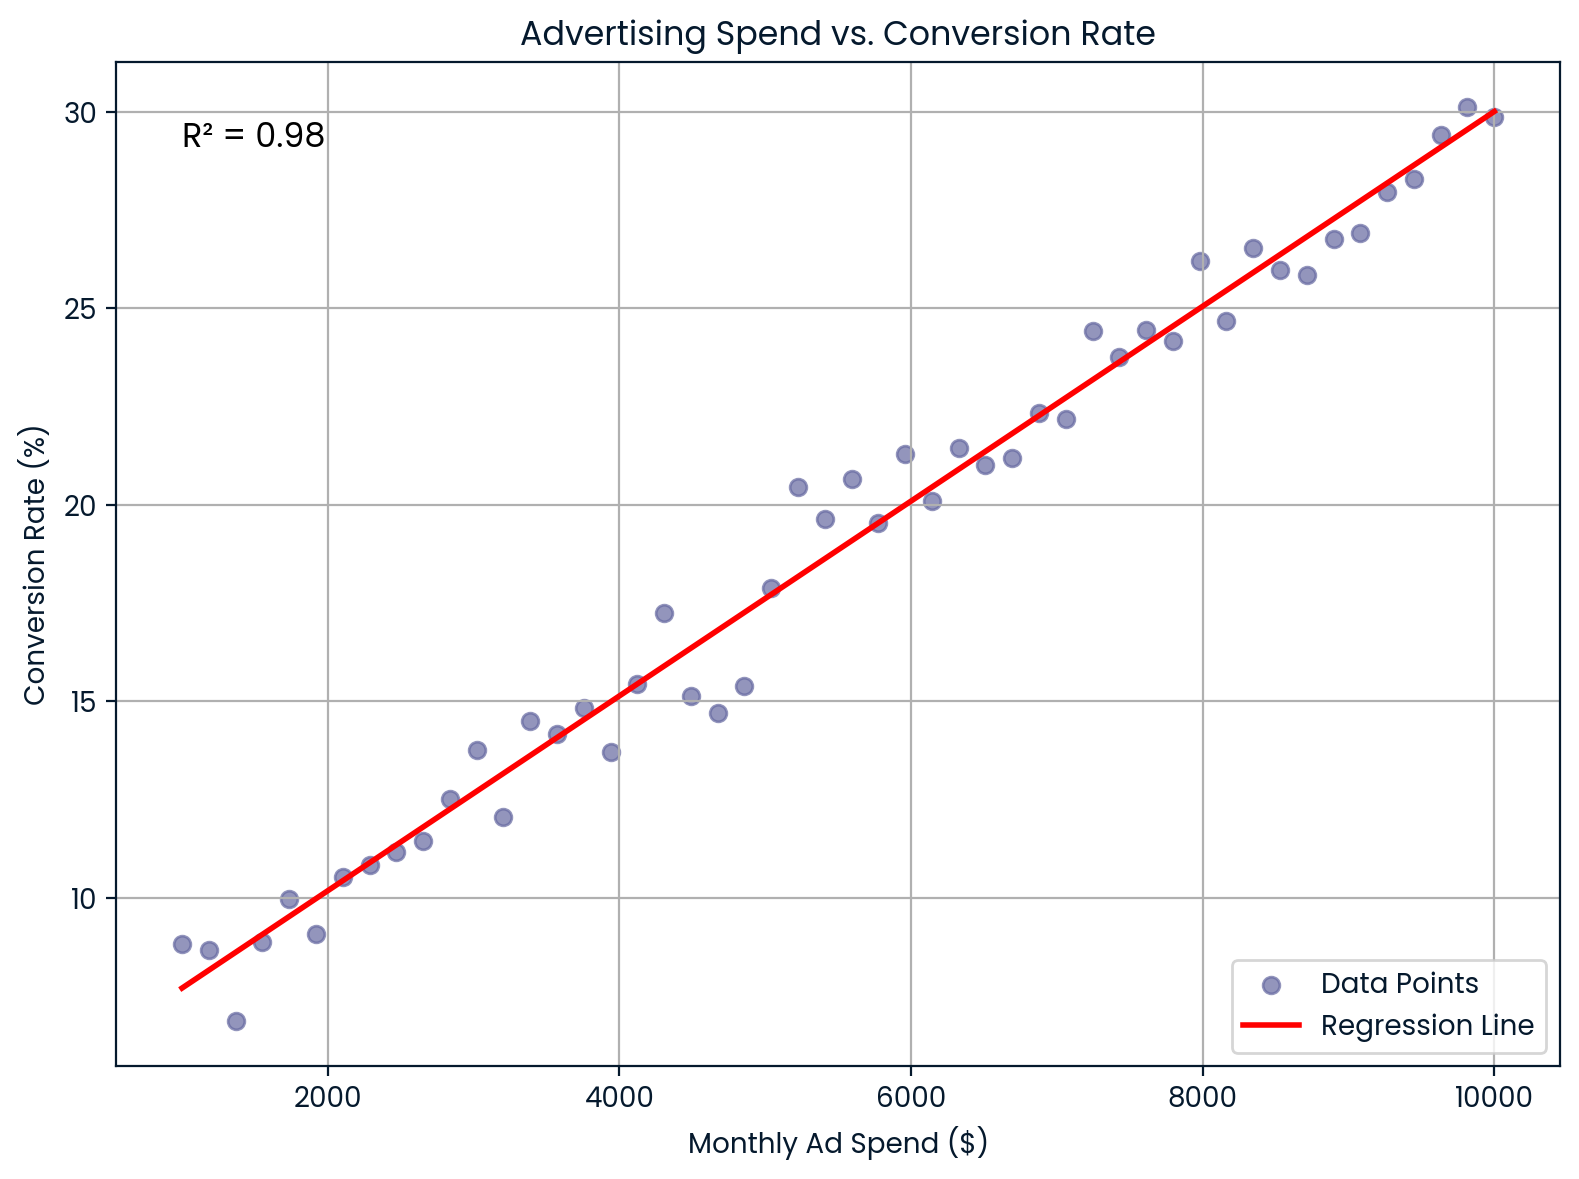
मासिक विज्ञापन खर्च बनाम रूपांतरण दर। छवि: लेखक
यह चार्ट मासिक विज्ञापन खर्च और रूपांतरण दर के बीच लगभग परिपूर्ण रैखिक संबंध दर्शाता है। यह ROI और बजट नियोजन के लिए मज़बूत पूर्वानुमान मूल्य का समर्थन करता है।
मशीन लर्निंग में, R² का उपयोग प्रतिगमन कार्यों के लिए प्रदर्शन मीट्रिक के रूप में किया जाता है। scikit-learn जैसी लाइब्रेरी r2_score() फ़ंक्शन उपलब्ध कराती हैं।
यह बताता है कि आपका मॉडल डेटा की परिवर्तनशीलता को कितनी अच्छी तरह समझाता है:
1 के क़रीब R² अच्छा फिट और कम त्रुटि दर्शाता है
0 के क़रीब R² खराब फिट दर्शाता है
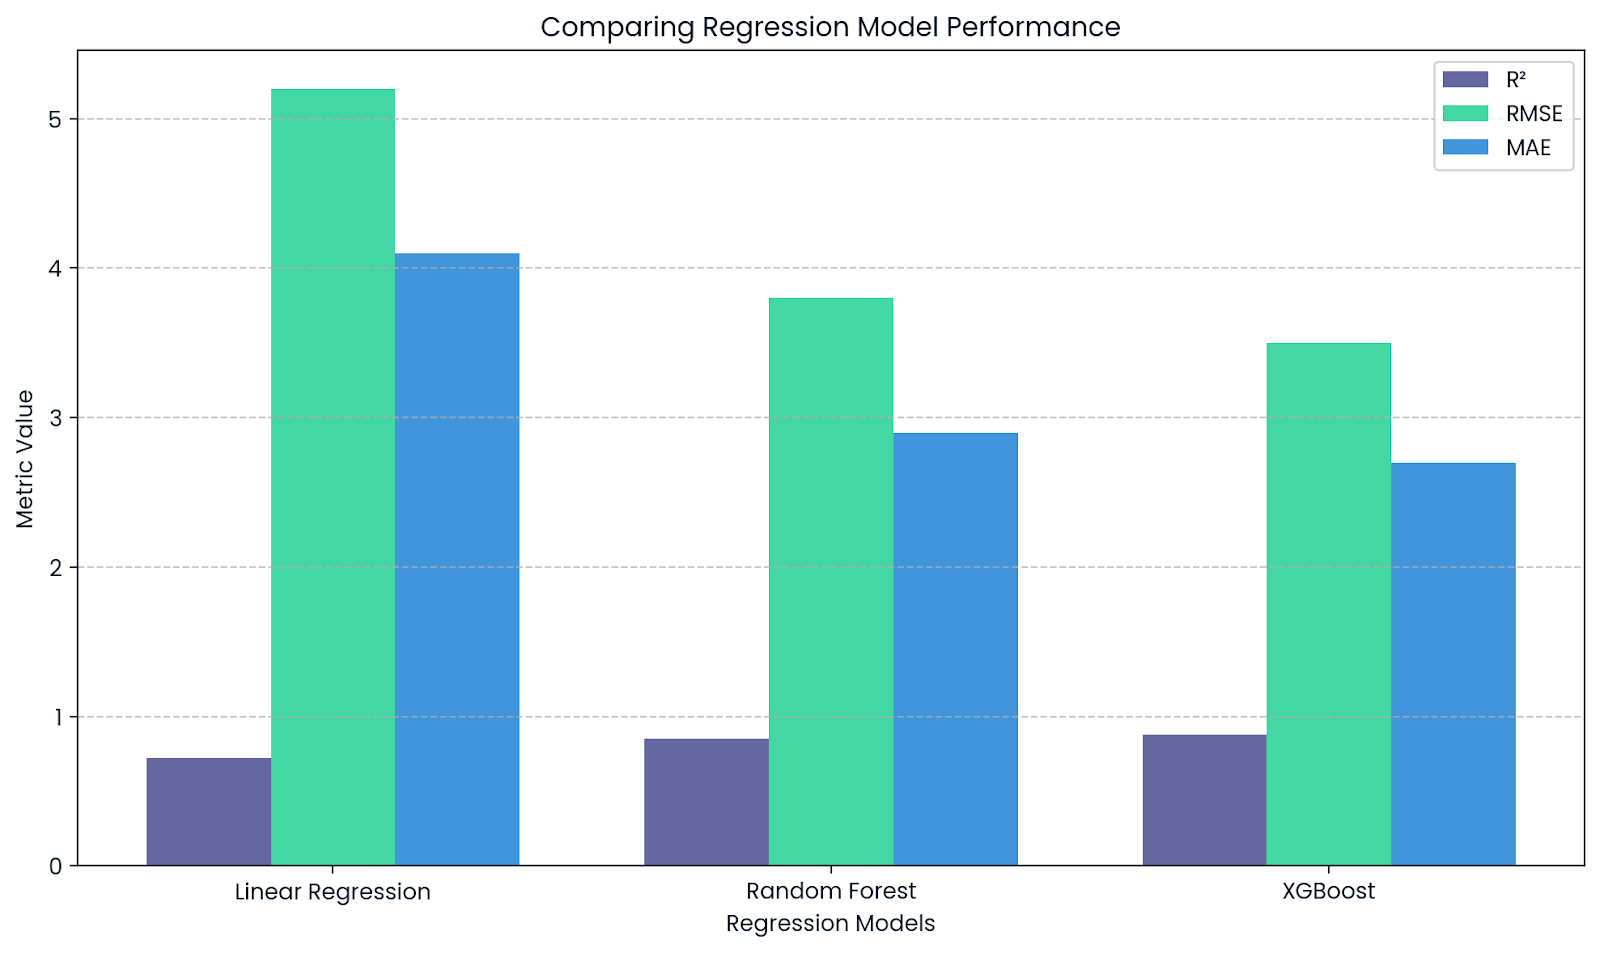
RMSE और MAE के साथ R² पूरक है। छवि: लेखक
यह चार्ट दिखाता है कि प्रतिगमन मॉडलों का मूल्यांकन करते समय R² अन्य मीट्रिक जैसे RMSE और MAE को कैसे पूरक करता है। जहाँ R² व्याख्यात्मक क्षमता दिखाता है, वहीं RMSE और MAE वास्तविक पूर्वानुमान त्रुटियों के आकार पर अंतर्दृष्टि देते हैं।
यदि आप शोध-पत्र या प्रोजेक्ट में R² शामिल कर रहे हैं, तो कुछ प्रारूप नियम ध्यान में रखें:
यदि आप R² का उपयोग प्रतिगमन विश्लेषण या ANOVA के हिस्से के रूप में कर रहे हैं, और यह जाँच रहे हैं कि आपका मॉडल सार्थक है या नहीं, तो कुछ और चीज़ें शामिल करें: F-सांख्यिकी, स्वतंत्रता की डिग्री, और p-मूल्य। ये पाठक को बताते हैं कि आपका मॉडल कुछ सार्थक समझाता है, इस पर हमें कितना भरोसा है।
तो परिणाम रिपोर्ट करते समय यह कुछ इस तरह दिख सकता है:
“मॉडल ने बिक्री में वैरिएंस के एक महत्वपूर्ण हिस्से को समझाया, R² = .73, F(2, 97) = 25.42, p < .001।”
हालाँकि, यदि आप परिकल्पना-परीक्षण नहीं कर रहे, मान लीजिए आप अन्वेषणात्मक विश्लेषण कर रहे हैं या क्रॉस-वैधता के साथ मॉडल के प्रदर्शन का आकलन कर रहे हैं, तो केवल R² मान रिपोर्ट करना बिल्कुल ठीक है।
आइए तीन अलग-अलग तरीकों—Python, R, और Excel—से R² कैसे निकालें, यह एक मिनी-प्रोजेक्ट के माध्यम से देखें, जहाँ हम पढ़ाई के समय के आधार पर छात्र अंकों का पूर्वानुमान लगाएँगे।
हम तीनों उदाहरणों में निम्न डेटासेट का उपयोग करेंगे:
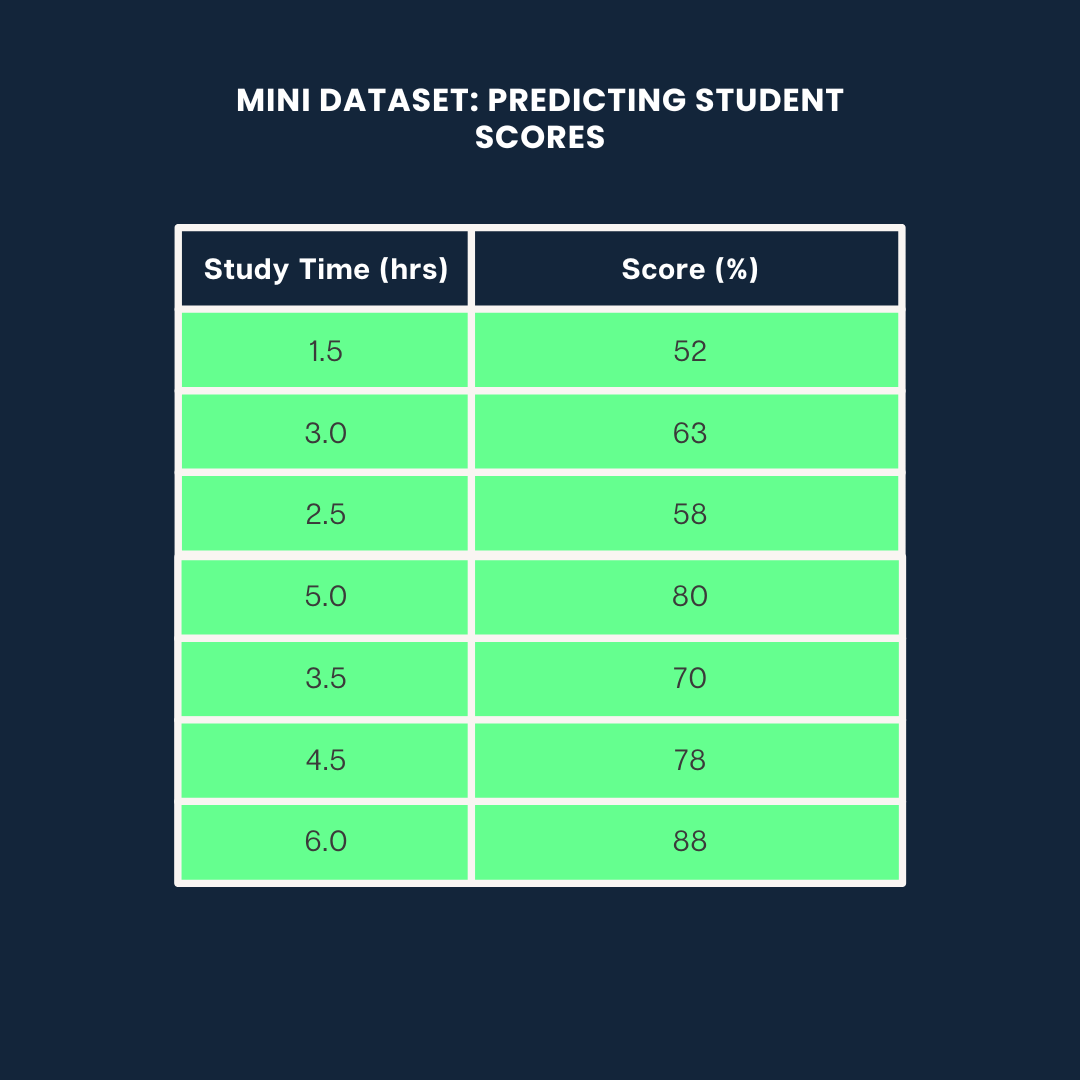
उदाहरण डेटासेट। छवि: लेखक
यहाँ scikit-learn का उपयोग करके Python में R² कैसे निकालें:
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import numpy as np

# Data
study_time = np.array([1.5, 3.0, 2.5, 5.0, 3.5, 4.5, 6.0]).reshape(-1, 1)
scores = np.array([52, 63, 58, 80, 70, 78, 88])

# Model
model = LinearRegression()
model.fit(study_time, scores)
predicted_scores = model.predict(study_time)

# R² score
r2 = r2_score(scores, predicted_scores)
print(f"R² = {r2:.2f}")0.99इसका मतलब है कि अंकों में 99% वैरिएंस पढ़ाई के समय से समझाया गया है।
यदि आप Regression और stats मॉडलों के बारे में और सीखना चाहते हैं, तो हमारा मार्गदर्शक देखें: Introduction to Regression with statsmodels in Python.
R में, आप lm() फ़ंक्शन का उपयोग करके कुछ ही पंक्तियों में R² निकाल सकते हैं:
# Data
study_time <- c(1.5, 3.0, 2.5, 5.0, 3.5, 4.5, 6.0)
scores <- c(52, 63, 58, 80, 70, 78, 88)

# Linear model
model <- lm(scores ~ study_time)

# R-squared
summary(model)$r.squared0.9884718लगभग 98% वैरिएंस पढ़ाई के समय से समझाया गया है। यदि आप R में Regression के बारे में और सीखना चाहते हैं, तो हमारा Introduction to Regression in R कोर्स देखें।
Excel में, आप अंतर्निहित RSQ() फ़ंक्शन से R² निकाल सकते हैं। मान लें:
Study Time सेल्स A2:A8 में है
Scores सेल्स B2:B8 में हैं
सिंटैक्स है:
RSQ(known_y's,known_x's)मैंने यह सूत्र इस्तेमाल किया:
=RSQ(B2:B8,A2:A8)यह Excel को आश्रित चर (scores) और स्वतंत्र चर (study time) के बीच R² मान निकालने को कहता है।
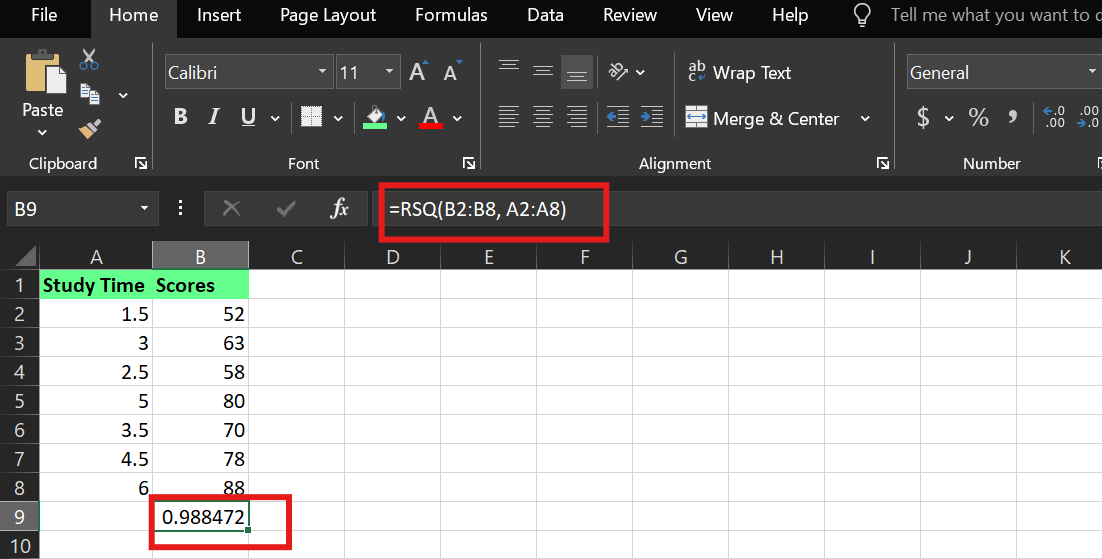
Excel में R² का उदाहरण। छवि: लेखक
चाहे आप छात्र अंकों, स्टॉक रिटर्न, या ग्राहक व्यवहार का पूर्वानुमान लगा रहे हों, निर्धारण गुणांक बताता है कि परिणाम का कितना हिस्सा आपका मॉडल वास्तव में समझता है।
ऊँचा निर्धारण गुणांक प्रभावशाली लग सकता है, पर इससे यह न मान लें कि मॉडल परिपूर्ण है या कारण-प्रभाव सिद्ध हो गया है। और कम निर्धारण गुणांक हमेशा असफलता नहीं होता; यह संकेत दे सकता है कि आपकी प्रणाली जटिल है या आपके चर अपूर्ण हैं।
इसलिए, यदि आप मॉडल बना रहे हैं या उनका विश्लेषण कर रहे हैं, तो अपने आप से पूछें:
इस सोच के साथ शुरुआत करें, और आप बेहतर निर्णय-निर्माण के लिए निर्धारण गुणांक का उपयोग एक दृष्टि-पट के रूप में करेंगे।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स