

DeepEval ile Başlarken
Bu eğitim için Kaggle’ı kodlama ortamımız olarak kullanacağız. Başlamak için yeni bir not defteri oluşturun.
OpenAI API’ını da kullanacağız. Devam etmek için bir API anahtarı oluşturun. Ardından, Kaggle’ın "Secrets" özelliğini kullanarak OpenAI API anahtarı için ortam değişkenini ayarlayın.
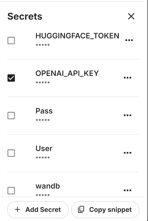
Bundan sonra, pip komutunu kullanarak DeepEval ve BitsandBytes Python kütüphanesini kurun:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytesOpenAI API anahtarını secrets’tan yükleyin:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")
os.environ['OPENAI_API_KEY'] = secret_value_0Jupyter Notebook büyü komutunu kullanarak aşağıdaki Python dosyasını yazın.
test_relevancy.py dosyası, GPT-4o modelini kullanarak bir LLM çıktısının alakalılığını değerlendiren bir test işlevi tanımlar. Bunu, modele verilen bir girdi karşısında yanıtını bir getirme bağlamıyla karşılaştırarak yapar ve çıktının sağlanan bilgilerle uyumlu olmasını sağlar.
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric
def test_relevancy():
relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
test_case_1 = LLMTestCase(
input="Can I return these shoes after 30 days?",
actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
retrieval_context=[
"All customers are eligible for a 30-day full refund at no extra cost.",
"Returns are only accepted within 30 days of purchase.",
],
)
assert_test(test_case_1, [relevancy_metric])Terminalde alakalılık testini çalıştırın:
!deepeval test run test_relevancy.pyAşağıdaki test sonucu, LLM test örneğinin testi başarıyla geçtiğini ve 1.0’lık kusursuz bir alakalılık puanı elde ettiğini gösterir; bu da modelin yanıtının tamamen ilgili olduğunu belirtir.
Değerlendirme 3,04 saniyede tamamlandı ve tahmini toplam token maliyeti 0,0027425 ABD dolarıydı:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03, 3.00s/
.Running teardown with pytest sessionfinish...
============================= slowest 10 durations =============================
3.03s call test_relevancy.py::test_relevancy
(2 durations < 0.005s hidden. Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃ ┃ ┃ ┃ ┃ Overall Success ┃
┃ Test case ┃ Metric ┃ Score ┃ Status ┃ Rate ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │ │ │ │ 100.0% │
│ │ Answer │ 1.0 │ PASSED │ │
│ │ Relevancy │ (threshold=0.... │ │ │
│ │ │ evaluation │ │ │
│ │ │ model=gpt-4o, │ │ │
│ │ │ reason=The │ │ │
│ │ │ score is 1.00 │ │ │
│ │ │ because the │ │ │
│ │ │ response was │ │ │
│ │ │ perfectly │ │ │
│ │ │ relevant and │ │ │
│ │ │ addressed the │ │ │
│ │ │ question │ │ │
│ │ │ directly │ │ │
│ │ │ without any │ │ │
│ │ │ irrelevant │ │ │
│ │ │ information. │ │ │
│ │ │ Great job!, │ │ │
│ │ │ error=None) │ │ │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️ Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.Ayrıca, HumanEval: LLM Kod Üretme Yeteneklerini Değerlendirmek İçin Bir Kıyaslama rehberini izleyerek Hugging Face ekosistemleriyle de LLM’leri değerlendirebilirsiniz.
G-Eval metriğiyle LLM test etme
G-Eval, zincirleme düşünme (CoT) akıl yürütmesini kullanarak LLM çıktıları özel ölçütlere göre değerlendiren bir LLM değerlendirme çerçevesidir. DeepEval’in en uyarlanabilir metriği olan G-Eval, neredeyse her kullanım senaryosunu insan benzeri doğrulukla ele alabilir ve LLM performansını değerlendirmek için vazgeçilmez bir araçtır.
Bu bölümde, LLM yanıtlarından oluşan veri kümesini G-Eval metriğiyle değerlendireceğiz.
1. G-Eval metriğini kurma
Modelin yanıtını olgusal çelişkiler açısından test etmek, eksik bilgileri hafifçe cezalandırmak ve muğlak dili veya farklı görüşleri tolere ederken ana fikre odaklanmak için özel yönergeler sağlayarak G-eval metriğini oluşturacağız:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
name="Correctness",
model="gpt-4o",
evaluation_params=[
LLMTestCaseParams.EXPECTED_OUTPUT,
LLMTestCaseParams.ACTUAL_OUTPUT],
evaluation_steps=[
"Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
"You should also lightly penalize omission of detail, and focus on the main idea",
"Vague language, or contradicting OPINIONS, are OK"
],
)2. Değerlendirme için test örnekleri oluşturma
Farklı konularda üç LLM test örneği oluşturun. Her test örneğinde bir girdi istemi, üretilen gerçek çıktı ve beklenen çıktı bulunur. GPT-4o modeli bunları karşılaştıracak ve sonunda ayrıntılı sonuçlar üretecektir:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset
first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")
second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")
third_test_case = LLMTestCase(input="List the primary colors.",
actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")3. Değerlendirme veri kümesini oluşturma
Üç test örneğini birleştirerek değerlendirme veri setini oluşturacağız:
test_cases = [first_test_case, second_test_case, third_test_case]
dataset = EvaluationDataset(test_cases=test_cases)4. G-Eval metriğini çalıştırma
G-Eval değerlendirme testini veri kümesi üzerinde çalıştırın:
evaluation_output = dataset.evaluate([correctness_metric])Çıktı:
Her test için sonuçlar; metrik özeti, test vakası ve genel metrik geçiş sonucuyla birlikte gelir.
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02, 1.08test case/s]
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)
For test case:
- input: What are the main causes of deforestation?
- actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)
For test case:
- input: Define the term 'artificial intelligence'.
- actual output: Artificial intelligence is the simulation of human intelligence by machines.
- expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)
For test case:
- input: List the primary colors.
- actual output: The primary colors are green, orange, and purple.
- expected output: The primary colors are red, blue, and yellow.
- context: None
- retrieval context: None
======================================================================
Overall Metric Pass Rates
Correctness (GEval): 66.67% pass rate
======================================================================Evaluating LLMs with MLflow eğitimini izleyerek favori aracınız MLflow ile LLM’leri nasıl değerlendireceğinizi öğrenin.
5. Test örneği sonuçlarını analiz etme
G-Eval metriğiyle üç test örneğinin değerlendirilmesi %66,67 geçiş oranına ulaştı: biri kusursuz eşleşme, biri eksik ayrıntılar nedeniyle kısmi eşleşme ve biri doğrudan çelişki nedeniyle başarısız oldu. Bu, modelin olgusal doğruluktaki güçlü yönlerini, ancak incelikli veya ayrıntılı çıktıları ele alma konusundaki sınırlılıklarını da ortaya koyar.
Qwen 2.5 için MMLU Karşılaştırması
MMLU (Massive Multitask Language Understanding), çoktan seçmeli sorularla büyük dil modellerini değerlendirmek için yaygın olarak kullanılan bir kıyaslamadır. Matematik, tarih, hukuk ve etik dahil 57 farklı konuyu kapsar ve bir LLM’in bilgi ve akıl yürütme yeteneklerinin kapsamlı bir testini sunar. Geniş konu kapsamı ve yüksek kaliteli soruları nedeniyle MMLU, LLM performansını değerlendirmede bir standart haline gelmiştir.
Bir adım daha ileri gidip özel LLM’imizi (Qwen 2.5 7B) MMLU veri kümesinde değerlendireceğiz. Veri kümesi, girdi istemleri ve sonuçları (A, B, C, D) içerir. Sonunda, doğru yanıtlanan soru sayısına göre bir doğruluk yüzdesi üretir.
1. Özel LLM model sınıfını oluşturma
DeepEvalBaseLLM’i genişleten ve dil modeli ile belirteçleyiciyi (tokenizer) kullanarak yanıtlar üreten QwenModel adlı özel bir sınıf tanımlayacağız.
Hedefimiz, verilen bir isteme dayalı olarak iki belirteçlik kısa çıktılar üretmek. Ayrıca aygıt tahsisini yönetecek ve girdi istemi ile çıktı metninin ön işlenmesini ele alacağız.
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
class QwenModel(DeepEvalBaseLLM):
def __init__(self, model, tokenizer):
self.model = model
self.tokenizer = tokenizer
self.device = "cuda"
def load_model(self):
return self.model
def generate(self, prompt: str) -> str:
prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
generated_ids = self.model.generate(
**model_inputs,
max_new_tokens=2,
do_sample=True,
pad_token_id=self.tokenizer.eos_token_id
)
prompt_length = len(model_inputs[0])
generated_tokens = generated_ids[0][prompt_length:]
clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
return clean_output.replace(".","")
async def a_generate(self, prompt: str) -> str:
return self.generate(prompt)
def get_model_name(self):
return "Qwen2.5 7B"2. Modeli ve belirteçleyiciyi yükleme
LLM modelini ve belirteçleyiciyi doğrudan yerelden yükleyen iki işlev oluşturacağız. Modeli 8 bit olarak yüklüyor ve aynı model için bir belirteçleyici başlatıyor, doldurma ve özel belirteç yapılandırmalarını ayarlıyoruz:
def load_model(model_name: str):
quant_config = BitsAndBytesConfig(
load_in_8bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=False
)
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=quant_config,
device_map="auto"
)
model.config.use_cache = False
model.config.pretraining_tp = 1
return model
def load_tokenizer(model_name):
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
return tokenizer3. Özel LLM’i oluşturma
“+ Add Input” düğmesini kullanarak Qwen 2.4 7B instruct modelini Kaggle not defterine ekleyin.
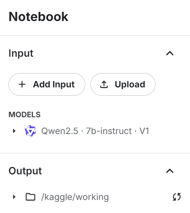
Modeli ve belirteçleyiciyi doğrudan yüklemek için modeli kullanın; ardından bir LLM yanıt üretici oluşturmak üzere özel LLM sınıfına aktarın:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)4. Özel LLM’i test etme
Karşılaştırma sonuçlarını üretmeden önce özel LLM’i test edin:
# Test model generation
prompt = """
The following are multiple choice questions (with answers) about abstract algebra.
Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))Veri setinden örnek bir istemi LLM’e sağladık ve tek bir harfle doğru şekilde yanıt verdi.
C5. MMLU kıyaslamasını çalıştırma
Şimdi MMLU kıyaslamasını yükleyip görevleri tanımlayacak ve ardından kıyaslamayı özel model üzerinde çalıştıracağız:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask
# Define benchmark with specific tasks and shots
benchmark = MMLU(
tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
n_shots=5
)
benchmark.evaluate(model=custom_model, batch_size=5)%83 doğrulukla mükemmel sonuçlar elde ettik!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00, 1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794Her bir görevin sonuçlarını gözden geçirelim:
benchmark.task_scores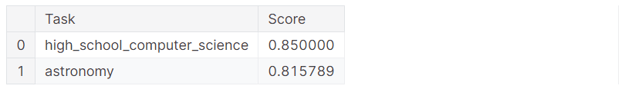
Ayrıca, hangi örneğin doğru sonuç aldığını hangisinin başarısız olduğunu gösteren tam sonuçları da inceleyebilirsiniz. Bu, modelin performansına ilişkin ayrıntılı bir analiz sunar.
benchmark.predictions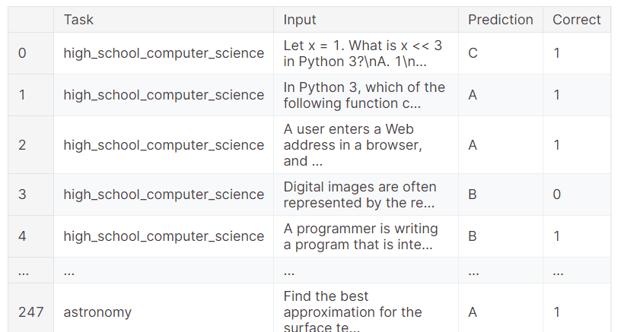
Yukarıdaki kodu çalıştırırken herhangi bir sorunla karşılaşırsanız lütfen Evaluating LLMs with DeepEval Kaggle not defterine başvurun. Kod kaynakları, veri kümeleri ve değerlendirme sonuçlarını içerir.
Sonuç
Dil modellerini değerlendirmek, özellikle üretim ortamında zorlu olabilir. Bazen basit değerlendirme metrikleri yeterli gelmez. LLM’inizin performansını çeşitli görevler ve işlevler genelinde değerlendirmek için bir dizi kıyaslama ve test çalıştırmak; kapsamlı bir anlayış kazanmak ve iyileştirme alanlarını belirlemek açısından elzemdir.
Bu eğitimde, Kaggle not defterinde DeepEval’ı kurduk ve Pytest’lere benzer LLM testleri gerçekleştirdik. Ardından, özel yönergelerle G-Eval’ı oluşturup değerlendirme veri seti üzerinde çalıştırdık. Son olarak, Qwen 2.5 7B modelini MMLU değerlendirme kıyaslamasına tabi tutarak lise düzeyi bilgisayar bilimi ve astronomi alanlarındaki performansını analiz ettik.
Öğrenme yolculuğunuzda bir sonraki adım, LLMOps araç ve metodolojilerini keşfetmek ve bir LLM’i üretime kolayca nasıl alacağınızı öğrenmektir. Daha fazla içgörü için LLMOps Concepts kursunu düşünebilirsiniz.

Sertifikalı bir veri bilimcisi olarak, yenilikçi makine öğrenimi uygulamaları oluşturmak için en son teknolojileri kullanmaya büyük ilgi duyuyorum. Konuşma tanıma, veri analizi ve raporlama, MLOps, konuşma yapay zekası ve NLP alanlarında güçlü bir geçmişe sahip olarak, gerçek bir etki yaratabilecek akıllı sistemler geliştirme becerilerimi geliştirdim. Teknik uzmanlığımın yanı sıra, karmaşık kavramları açık ve özlü bir dille ifade etme yeteneğine sahip, becerikli bir iletişimciyim. Sonuç olarak, veri bilimi konusunda aranan bir blog yazarı oldum ve giderek büyüyen veri profesyonelleri topluluğuyla görüşlerimi ve deneyimlerimi paylaşıyorum. Şu anda, içerik oluşturma ve düzenlemeye odaklanıyorum. Büyük dil modelleriyle çalışarak, hem işletmelerin hem de bireylerin verilerinden en iyi şekilde yararlanmalarına yardımcı olabilecek güçlü ve ilgi çekici içerikler geliştiriyorum.



Makine öğrenmesi ekosisteminde, büyük dil modellerini (LLM’ler) farklı özellikler üzerinde etkili biçimde test edebilen değerlendirme çerçeveleri çok azdır. LLM geliştirmelerindeki üstel artışla birlikte, performanslarını çeşitli görevlerde ölçmek ve güçlü, zayıf yönleri ile sınırlılıklarını değerlendirmek kritik hale gelmiştir.
DeepEval, bu ihtiyaca yanıt veren kapsamlı ve güvenilir bir çözüm olarak devreye girer; doğruluk, akıl yürütme, tutarlılık ve etik uyum gibi birden çok boyutta LLM’leri test etmek için sağlam bir çerçeve sunar.
Bu eğitimde, DeepEval’i nasıl kuracağınızı ve Pytest yaklaşımına benzer bir alakalılık testi oluşturmayı öğreneceksiniz. Ardından, LLM çıktıları G-eval metriğiyle test edecek ve Qwen 2.5 modelinde MMLU karşılaştırmasını çalıştıracaksınız. Bu, DeepEval ekosistemini daha iyi anlamak isteyen teknik geçmişe sahip herkes için başlangıç seviyesinde, basit bir eğitimdir.
LLM’lere yeniyseniz, temelleri öğrenmek için Master Large Language Models (LLMs) Concepts kursunu şiddetle öneririm.
DeepEval’ı Anlamak
DeepEval, özellikle büyük dil modelleri için tasarlanmış, geliştiricilerin LLM tabanlı uygulamaları verimli şekilde kurmasına, iyileştirmesine, test etmesine ve izlemesine olanak tanıyan açık kaynaklı bir değerlendirme çerçevesidir. Kullanıcıların modellerini tıpkı geleneksel yazılım testlerinde Pytest kullanır gibi “birim testleriyle” değerlendirmesine imkan tanıyarak LLM çıktılarının değerlendirilmesini basitleştirir.
DeepEval, 14 araştırma destekli LLM değerlendirme metriği, sentetik veri kümesi oluşturma, LLM kıyaslamaları, red team ve üretimde gerçek zamanlı değerlendirmeler dahil geniş bir özellik yelpazesi sunar. Bu özelliklerle DeepEval, testleri kolaylaştırmanın yanı sıra LLM destekli uygulamaların güvenliğini ve güvenilirliğini de sağlar.
Büyük dil modellerini temel metrikler, metodolojiler ve en iyi uygulamalarla nasıl değerlendireceğinizi öğrenmek için LLM Evaluation blogunu okuyun.