
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Trong hướng dẫn này, chúng ta sẽ dùng Kaggle làm môi trường lập trình. Để bắt đầu, hãy tạo một notebook mới.
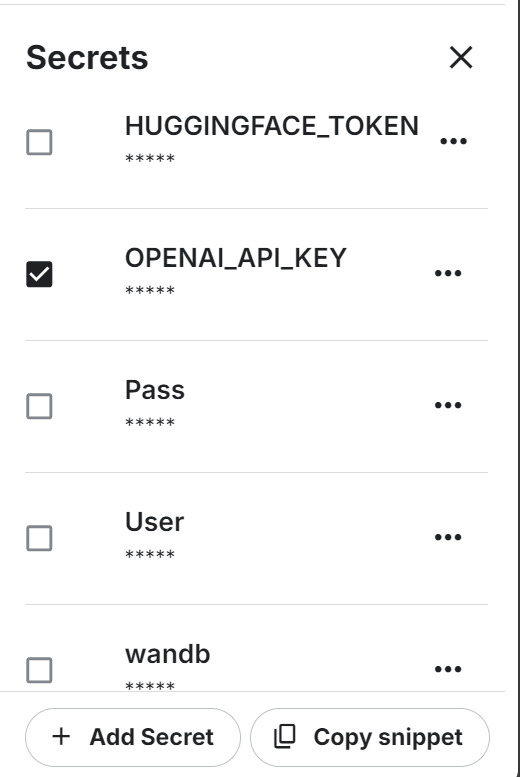
Chúng ta cũng sẽ dùng OpenAI API. Để tiếp tục, hãy tạo một khóa API. Sau đó, thiết lập biến môi trường cho khóa OpenAI API bằng tính năng "Secrets" của Kaggle.
Sau đó, cài đặt thư viện Python DeepEval và BitsandBytes bằng lệnh pip:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytes
Nạp khóa OpenAI API từ secrets:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")

os.environ['OPENAI_API_KEY'] = secret_value_0
Viết tệp Python sau bằng magic function của Jupyter Notebook.
Tệp test_relevancy.py định nghĩa một hàm kiểm thử đánh giá mức độ liên quan của đầu ra LLM bằng mô hình GPT-4o. Nó thực hiện bằng cách so sánh phản hồi của mô hình với ngữ cảnh truy xuất đã cho, đảm bảo đầu ra phù hợp với thông tin cung cấp.
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric


def test_relevancy():
    relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
    test_case_1 = LLMTestCase(
        input="Can I return these shoes after 30 days?",
        actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
        retrieval_context=[
            "All customers are eligible for a 30-day full refund at no extra cost.",
            "Returns are only accepted within 30 days of purchase.",
        ],
    )
    assert_test(test_case_1, [relevancy_metric])
Chạy bài kiểm thử mức độ liên quan trong terminal:
!deepeval test run test_relevancy.pyKết quả sau cho thấy ca kiểm thử LLM đã vượt qua và đạt điểm mức độ liên quan hoàn hảo 1.0, cho thấy phản hồi của mô hình hoàn toàn phù hợp.
Việc đánh giá hoàn tất trong 3,04 giây với tổng chi phí ước tính theo token là $0.0027425 USD:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03,  3.00s/
.Running teardown with pytest sessionfinish...

============================= slowest 10 durations =============================
3.03s call     test_relevancy.py::test_relevancy

(2 durations < 0.005s hidden.  Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
                                  Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃                ┃                 ┃                ┃        ┃ Overall Success ┃
┃ Test case     ┃ Metric         ┃ Score         ┃ Status ┃ Rate           ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │                 │                │        │ 100.0%          │
│                │ Answer          │ 1.0            │ PASSED │                 │
│                │ Relevancy       │ (threshold=0.... │        │                 │
│                │                 │ evaluation     │        │                 │
│                │                 │ model=gpt-4o,  │        │                 │
│                │                 │ reason=The     │        │                 │
│                │                 │ score is 1.00  │        │                 │
│                │                 │ because the    │        │                 │
│                │                 │ response was   │        │                 │
│                │                 │ perfectly      │        │                 │
│                │                 │ relevant and   │        │                 │
│                │                 │ addressed the  │        │                 │
│                │                 │ question       │        │                 │
│                │                 │ directly       │        │                 │
│                │                 │ without any    │        │                 │
│                │                 │ irrelevant     │        │                 │
│                │                 │ information.   │        │                 │
│                │                 │ Great job!,    │        │                 │
│                │                 │ error=None)    │        │                 │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️  Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.
Bạn cũng có thể đánh giá LLM bằng hệ sinh thái Hugging Face theo hướng dẫn HumanEval: A Benchmark for Evaluating LLM Code Generation Capabilities.
G-Eval là một khung đánh giá LLM sử dụng suy luận chuỗi tư duy (CoT) để đánh giá đầu ra LLM dựa trên tiêu chí tùy chỉnh. Là thước đo linh hoạt nhất của DeepEval, G-Eval có thể xử lý hầu như mọi tình huống với độ chính xác gần giống con người, khiến nó trở thành công cụ thiết yếu để đánh giá hiệu năng LLM.
Trong phần này, chúng ta sẽ đánh giá tập dữ liệu phản hồi của LLM bằng thước đo G-Eval.
Chúng ta sẽ tạo thước đo G-eval và cung cấp hướng dẫn tùy chỉnh để kiểm thử phản hồi của mô hình về mâu thuẫn thực tế, phạt việc bỏ sót chi tiết, và tập trung vào ý chính trong khi cho phép ngôn ngữ mơ hồ hoặc khác biệt về quan điểm:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
    name="Correctness",
    model="gpt-4o",
    evaluation_params=[
        LLMTestCaseParams.EXPECTED_OUTPUT,
        LLMTestCaseParams.ACTUAL_OUTPUT],
    evaluation_steps=[
        "Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
        "You should also lightly penalize omission of detail, and focus on the main idea",
        "Vague language, or contradicting OPINIONS, are OK"
    ],
)Tạo ba ca kiểm thử LLM về các chủ đề khác nhau. Mỗi ca kiểm thử có một lời nhắc đầu vào, một đầu ra thực tế được tạo và một đầu ra kỳ vọng. Mô hình GPT-4o sẽ so sánh chúng và tạo báo cáo chi tiết ở cuối:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset


first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
                              actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
                              expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")


second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
                               actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
                               expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")


third_test_case = LLMTestCase(input="List the primary colors.",
                              actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")Chúng ta sẽ tạo tập dữ liệu đánh giá bằng cách kết hợp cả ba ca kiểm thử:
test_cases = [first_test_case, second_test_case, third_test_case]

dataset = EvaluationDataset(test_cases=test_cases)Chạy bài đánh giá G-Eval trên tập dữ liệu:
evaluation_output = dataset.evaluate([correctness_metric])Kết quả:
Kết quả cho mỗi bài kiểm thử bao gồm tóm tắt thước đo, ca kiểm thử và kết quả vượt/không vượt tổng thể của thước đo.
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02,  1.08test case/s]
======================================================================

Metrics Summary

  - ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)

For test case:

  - input: What are the main causes of deforestation?
  - actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
  - expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
  - context: None
  - retrieval context: None

======================================================================

Metrics Summary

  - ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)

For test case:

  - input: Define the term 'artificial intelligence'.
  - actual output: Artificial intelligence is the simulation of human intelligence by machines.
  - expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
  - context: None
  - retrieval context: None

======================================================================

Metrics Summary

  - ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)

For test case:

  - input: List the primary colors.
  - actual output: The primary colors are green, orange, and purple.
  - expected output: The primary colors are red, blue, and yellow.
  - context: None
  - retrieval context: None

======================================================================

Overall Metric Pass Rates

Correctness (GEval): 66.67% pass rate

======================================================================
Tìm hiểu cách đánh giá LLM bằng công cụ ưa thích MLflow qua hướng dẫn Evaluating LLMs with MLflow.
Đánh giá ba ca kiểm thử bằng thước đo G-Eval đạt tỷ lệ vượt 66,67%, với một trường hợp khớp hoàn hảo, một trường hợp khớp một phần do thiếu chi tiết và một trường hợp thất bại do mâu thuẫn trực tiếp. Điều này cho thấy điểm mạnh của mô hình ở độ chính xác thực tế nhưng cũng nêu bật hạn chế khi xử lý các đầu ra tinh tế hoặc giàu chi tiết.
MMLU (Massive Multitask Language Understanding) là bộ benchmark được dùng rộng rãi để đánh giá các mô hình ngôn ngữ lớn qua câu hỏi trắc nghiệm. Nó bao phủ 57 chủ đề đa dạng, gồm toán, lịch sử, luật và đạo đức, tạo thành bài kiểm tra toàn diện về kiến thức và khả năng suy luận của LLM. Nhờ phạm vi chủ đề rộng và câu hỏi chất lượng cao, MMLU đã trở thành tiêu chuẩn để đánh giá hiệu năng LLM.
Chúng ta sẽ tiến thêm một bước và đánh giá LLM tùy chỉnh (Qwen 2.5 7B) trên bộ dữ liệu MMLU. Bộ dữ liệu chứa lời nhắc đầu vào và đáp án (A, B, C, D). Cuối cùng, nó dùng số câu trả lời đúng để tính phần trăm độ chính xác.
Chúng ta sẽ định nghĩa một lớp tùy chỉnh tên QwenModel mở rộng DeepEvalBaseLLM để tạo phản hồi bằng cách sử dụng mô hình ngôn ngữ và tokenizer.
Mục tiêu là tạo đầu ra ngắn gồm hai token dựa trên lời nhắc cho trước. Bên cạnh đó, chúng ta sẽ quản lý phân bổ thiết bị và xử lý tiền xử lý lời nhắc đầu vào và văn bản đầu ra.
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

class QwenModel(DeepEvalBaseLLM):
    def __init__(self, model, tokenizer):
        self.model = model
        self.tokenizer = tokenizer
        self.device = "cuda"

    def load_model(self):
        return self.model

    def generate(self, prompt: str) -> str:
        prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
        model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
        generated_ids = self.model.generate(
            **model_inputs,
            max_new_tokens=2,
            do_sample=True,
            pad_token_id=self.tokenizer.eos_token_id
        )
        prompt_length = len(model_inputs[0])
        generated_tokens = generated_ids[0][prompt_length:]
        clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
        return clean_output.replace(".","")

    async def a_generate(self, prompt: str) -> str:
        return self.generate(prompt)

    def get_model_name(self):
return "Qwen2.5 7B"Chúng ta sẽ tạo hai hàm để nạp mô hình LLM và tokenizer trực tiếp từ local. Ta nạp mô hình ở 8-bit và khởi tạo tokenizer cho cùng mô hình, thiết lập cấu hình padding và token đặc biệt:
def load_model(model_name: str):
    quant_config = BitsAndBytesConfig(
        load_in_8bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.float16,
        bnb_4bit_use_double_quant=False
    )
    model = AutoModelForCausalLM.from_pretrained(
        model_name,
        quantization_config=quant_config,
        device_map="auto"
    )
    model.config.use_cache = False
    model.config.pretraining_tp = 1
    return model

def load_tokenizer(model_name):
    tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
    tokenizer.pad_token = tokenizer.eos_token
    tokenizer.padding_side = "right"
return tokenizerThêm mô hình Qwen 2.4 7b instruct vào Kaggle notebook bằng nút “+ Add Input”.
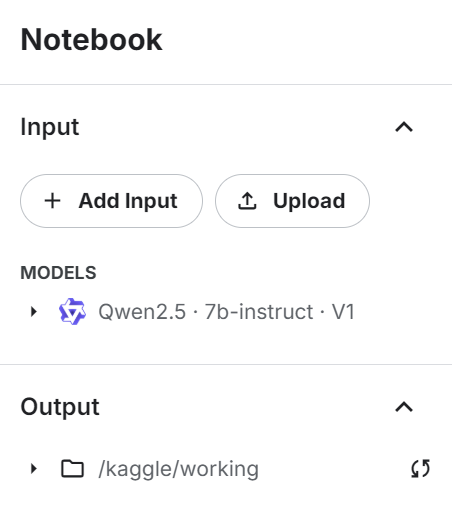
Sử dụng trực tiếp mô hình để nạp mô hình và tokenizer, sau đó cung cấp cho lớp LLM tùy chỉnh để tạo bộ sinh phản hồi LLM:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)Kiểm thử LLM tùy chỉnh trước khi tạo kết quả benchmark:
# Test model generation

prompt = """
The following are multiple choice questions (with answers) about abstract algebra.

Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))
Chúng ta cung cấp cho LLM một lời nhắc mẫu từ bộ dữ liệu và mô hình phản hồi chính xác bằng một chữ cái.
CBây giờ, chúng ta sẽ nạp benchmark MMLU, định nghĩa tác vụ, rồi chạy benchmark trên mô hình tùy chỉnh:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask

# Define benchmark with specific tasks and shots
benchmark = MMLU(
    tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
    n_shots=5
)

benchmark.evaluate(model=custom_model, batch_size=5)
Chúng ta thu được kết quả xuất sắc với độ chính xác 83%!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00,  1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794
Hãy xem lại kết quả của từng tác vụ riêng lẻ:
benchmark.task_scores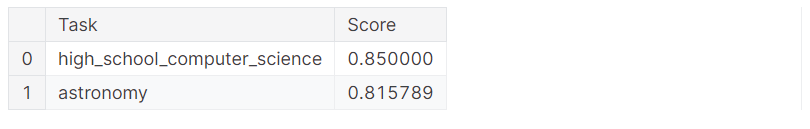
Bạn cũng có thể xem toàn bộ kết quả, cho biết mẫu nào trả lời đúng và mẫu nào sai. Điều này cung cấp phân tích chi tiết về hiệu năng của mô hình.
benchmark.predictions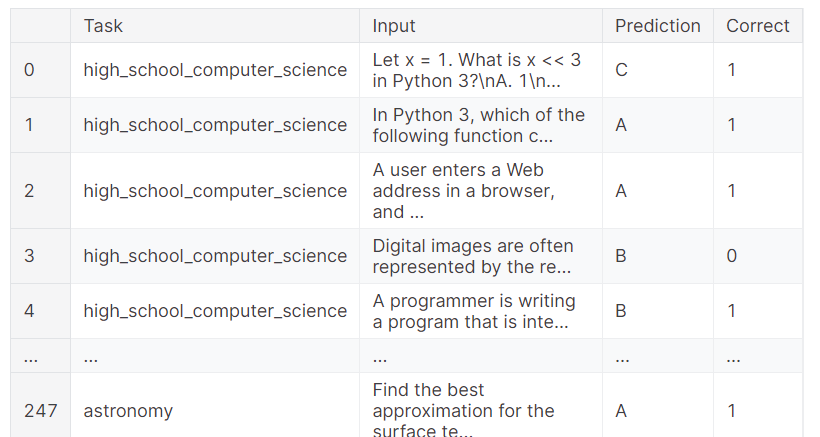
Nếu bạn gặp bất kỳ vấn đề nào khi chạy mã ở trên, vui lòng tham khảo Evaluating LLMs with DeepEval trên Kaggle. Notebook này chứa mã nguồn, bộ dữ liệu và kết quả đánh giá.
Đánh giá mô hình ngôn ngữ có thể rất thách thức, đặc biệt trong môi trường sản xuất. Đôi khi, các thước đo đánh giá đơn giản là chưa đủ. Cần chạy một bộ benchmark và kiểm thử để đánh giá hiệu năng LLM của bạn trên nhiều tác vụ và chức năng, từ đó có cái nhìn toàn diện và xác định các điểm cần cải thiện.
Trong hướng dẫn này, chúng ta đã thiết lập DeepEval trong Kaggle notebook và thực hiện các kiểm thử LLM tương tự Pytest. Sau đó, chúng ta xây dựng G-Eval bằng hướng dẫn tùy chỉnh và chạy trên tập dữ liệu đánh giá. Cuối cùng, chúng ta kiểm thử mô hình Qwen 2.5 7B với benchmark MMLU để phân tích hiệu năng của nó trong các chủ đề khoa học máy tính bậc phổ thông và thiên văn học.
Bước tiếp theo trong hành trình học tập của bạn là khám phá công cụ và phương pháp LLMOps, cũng như học cách triển khai LLM vào sản xuất một cách dễ dàng. Để hiểu sâu hơn, hãy cân nhắc học khóa LLMOps Concepts.
Tìm hiểu thêm về LLM với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
