
Cursus
Concepten van Large Language Models (LLMs)
2 uur
113.3K
Voor deze tutorial gebruiken we Kaggle als onze code-omgeving. Maak om te beginnen een nieuw notebook aan.
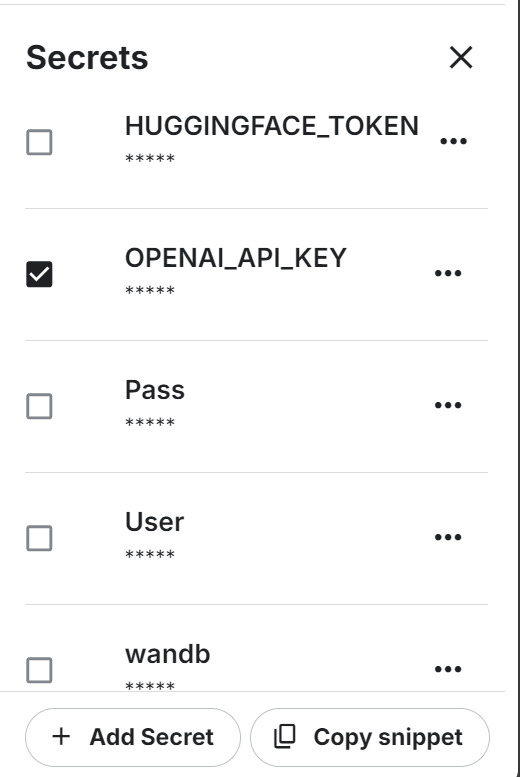
We gebruiken ook de OpenAI API. Maak hiervoor een API-sleutel aan. Stel vervolgens de omgevingsvariabele voor de OpenAI API-sleutel in via de "Secrets"-functie van Kaggle.
Installeer daarna de Python-bibliotheken DeepEval en BitsandBytes met het commando pip:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytes
Laad de OpenAI API-sleutel uit secrets:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")

os.environ['OPENAI_API_KEY'] = secret_value_0
Schrijf het volgende Python-bestand met de Jupyter Notebook-magicfunctie.
Het bestand test_relevancy.py definieert een testfunctie die de relevantie van de uitvoer van een LLM beoordeelt met het GPT-4o-model. Dit gebeurt door de respons van het model op een gegeven invoer te vergelijken met een retrievalcontext, zodat de uitvoer aansluit bij de verstrekte informatie.
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric


def test_relevancy():
    relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
    test_case_1 = LLMTestCase(
        input="Can I return these shoes after 30 days?",
        actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
        retrieval_context=[
            "All customers are eligible for a 30-day full refund at no extra cost.",
            "Returns are only accepted within 30 days of purchase.",
        ],
    )
    assert_test(test_case_1, [relevancy_metric])
Voer de relevantietest uit in de terminal:
!deepeval test run test_relevancy.pyUit de onderstaande testresultaten blijkt dat de LLM-testcase de test succesvol heeft doorstaan en een perfecte relevantiescore van 1,0 heeft behaald. Dit geeft aan dat de respons van het model volledig relevant was.
De evaluatie was voltooid in 3,04 seconden met een geschatte totale tokencost van $0,0027425 USD:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03,  3.00s/
.Running teardown with pytest sessionfinish...

============================= slowest 10 durations =============================
3.03s call     test_relevancy.py::test_relevancy

(2 durations < 0.005s hidden.  Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
                                  Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃                ┃                 ┃                ┃        ┃ Overall Success ┃
┃ Test case     ┃ Metric         ┃ Score         ┃ Status ┃ Rate           ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │                 │                │        │ 100.0%          │
│                │ Answer          │ 1.0            │ PASSED │                 │
│                │ Relevancy       │ (threshold=0.... │        │                 │
│                │                 │ evaluation     │        │                 │
│                │                 │ model=gpt-4o,  │        │                 │
│                │                 │ reason=The     │        │                 │
│                │                 │ score is 1.00  │        │                 │
│                │                 │ because the    │        │                 │
│                │                 │ response was   │        │                 │
│                │                 │ perfectly      │        │                 │
│                │                 │ relevant and   │        │                 │
│                │                 │ addressed the  │        │                 │
│                │                 │ question       │        │                 │
│                │                 │ directly       │        │                 │
│                │                 │ without any    │        │                 │
│                │                 │ irrelevant     │        │                 │
│                │                 │ information.   │        │                 │
│                │                 │ Great job!,    │        │                 │
│                │                 │ error=None)    │        │                 │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️  Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.
Je kunt LLM’s ook evalueren via het Hugging Face-ecosysteem met de gids HumanEval: A Benchmark for Evaluating LLM Code Generation Capabilities.
G-Eval is een LLM-evaluatiekader dat chain-of-thought (CoT)-redenering gebruikt om LLM-uitvoer te beoordelen op basis van aangepaste criteria. Als DeepEvals meest aanpasbare metriek kan G-Eval bijna elke usecase aan met mensachtige nauwkeurigheid, waardoor het een essentieel hulpmiddel is om LLM-prestaties te evalueren.
In deze sectie evalueren we de dataset met LLM-responsen met behulp van de G-Eval-metriek.
We maken de G-eval-metriek en geven aangepaste instructies om de respons van het model te testen op feitelijke tegenstrijdigheden, omissies licht te bestraffen en te focussen op de hoofdgedachte, terwijl vage taal of afwijkende meningen worden toegestaan:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
    name="Correctness",
    model="gpt-4o",
    evaluation_params=[
        LLMTestCaseParams.EXPECTED_OUTPUT,
        LLMTestCaseParams.ACTUAL_OUTPUT],
    evaluation_steps=[
        "Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
        "You should also lightly penalize omission of detail, and focus on the main idea",
        "Vague language, or contradicting OPINIONS, are OK"
    ],
)Maak drie LLM-testcases over verschillende onderwerpen. Elke testcase heeft een invoerprompt, een daadwerkelijk gegenereerde uitvoer en een verwachte uitvoer. Het GPT-4o-model vergelijkt deze en genereert aan het eind gedetailleerde resultaten:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset


first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
                              actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
                              expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")


second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
                               actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
                               expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")


third_test_case = LLMTestCase(input="List the primary colors.",
                              actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")We maken de evaluatieset door alle drie de testcases te combineren:
test_cases = [first_test_case, second_test_case, third_test_case]

dataset = EvaluationDataset(test_cases=test_cases)Voer de G-Eval-evaluatietest uit op de dataset:
evaluation_output = dataset.evaluate([correctness_metric])Uitvoer:
De testresultaten per test bevatten een metriekoverzicht, testcase en het totale resultaat (geslaagd/niet geslaagd) op de metriek.
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02,  1.08test case/s]
======================================================================

Metrics Summary

  - ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)

For test case:

  - input: What are the main causes of deforestation?
  - actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
  - expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
  - context: None
  - retrieval context: None

======================================================================

Metrics Summary

  - ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)

For test case:

  - input: Define the term 'artificial intelligence'.
  - actual output: Artificial intelligence is the simulation of human intelligence by machines.
  - expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
  - context: None
  - retrieval context: None

======================================================================

Metrics Summary

  - ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)

For test case:

  - input: List the primary colors.
  - actual output: The primary colors are green, orange, and purple.
  - expected output: The primary colors are red, blue, and yellow.
  - context: None
  - retrieval context: None

======================================================================

Overall Metric Pass Rates

Correctness (GEval): 66.67% pass rate

======================================================================
Leer LLM’s evalueren met een favoriete tool, MLflow, via de tutorial Evaluating LLMs with MLflow.
De evaluatie van drie testcases met de G-Eval-metriek behaalde een slagingspercentage van 66,67%, met één perfecte match, één gedeeltelijke match door ontbrekende details en één misser door een directe tegenspraak. Dit benadrukt de sterke punten van het model in feitelijke nauwkeurigheid, maar ook de beperkingen bij genuanceerde of gedetailleerde uitvoer.
MMLU (Massive Multitask Language Understanding) is een veelgebruikte benchmark om grote taalmodellen te evalueren met multiplechoicevragen. De benchmark beslaat 57 uiteenlopende vakken, waaronder wiskunde, geschiedenis, recht en ethiek, en vormt zo een uitgebreide test van de kennis en redeneervaardigheden van een LLM. Door de brede dekking en de kwalitatieve vragen is MMLU uitgegroeid tot een standaard voor het beoordelen van LLM-prestaties.
We gaan een stap verder en evalueren ons eigen LLM (Qwen 2.5 7B) op de MMLU-dataset. De dataset bevat invoerprompts en resultaten (A, B, C, D). Uiteindelijk wordt de nauwkeurigheid als percentage berekend op basis van het aantal correct beantwoorde vragen.
We definiëren een aangepaste klasse QwenModel die DeepEvalBaseLLM uitbreidt om responsen te genereren met behulp van het taalmodel en de tokenizer.
Ons doel is om korte uitvoer van twee tokens te produceren op basis van een gegeven prompt. Daarnaast beheren we de device-toewijzing en verwerken we de invoerprompt en uitvoertekst voor.
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig

class QwenModel(DeepEvalBaseLLM):
    def __init__(self, model, tokenizer):
        self.model = model
        self.tokenizer = tokenizer
        self.device = "cuda"

    def load_model(self):
        return self.model

    def generate(self, prompt: str) -> str:
        prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
        model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
        generated_ids = self.model.generate(
            **model_inputs,
            max_new_tokens=2,
            do_sample=True,
            pad_token_id=self.tokenizer.eos_token_id
        )
        prompt_length = len(model_inputs[0])
        generated_tokens = generated_ids[0][prompt_length:]
        clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
        return clean_output.replace(".","")

    async def a_generate(self, prompt: str) -> str:
        return self.generate(prompt)

    def get_model_name(self):
return "Qwen2.5 7B"We maken twee functies die het LLM-model en de tokenizer lokaal laden. We laden het model in 8 bits en initialiseren een tokenizer voor hetzelfde model, met instellingen voor padding en speciale tokens:
def load_model(model_name: str):
    quant_config = BitsAndBytesConfig(
        load_in_8bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.float16,
        bnb_4bit_use_double_quant=False
    )
    model = AutoModelForCausalLM.from_pretrained(
        model_name,
        quantization_config=quant_config,
        device_map="auto"
    )
    model.config.use_cache = False
    model.config.pretraining_tp = 1
    return model

def load_tokenizer(model_name):
    tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
    tokenizer.pad_token = tokenizer.eos_token
    tokenizer.padding_side = "right"
return tokenizerVoeg het Qwen 2.4 7B instruct-model toe aan het Kaggle-notebook met de knop “+ Add Input”.
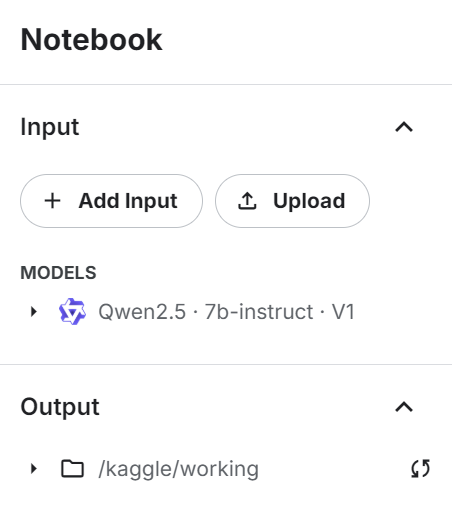
Gebruik het modelpad direct om het model en de tokenizer te laden en geef deze vervolgens door aan de aangepaste LLM-klasse om een LLM-responsgenerator te maken:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)Test de aangepaste LLM voordat je de benchmarkresultaten genereert:
# Test model generation

prompt = """
The following are multiple choice questions (with answers) about abstract algebra.

Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))
We gaven de LLM een voorbeelprompt uit de dataset en het model antwoordde correct met één letter.
CWe laden nu de MMLU-benchmark, definiëren de taken en voeren vervolgens de benchmark uit op het aangepaste model:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask

# Define benchmark with specific tasks and shots
benchmark = MMLU(
    tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
    n_shots=5
)

benchmark.evaluate(model=custom_model, batch_size=5)
We behaalden uitstekende resultaten met 83% nauwkeurigheid!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00,  1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794
Laten we de resultaten per individuele taak bekijken:
benchmark.task_scores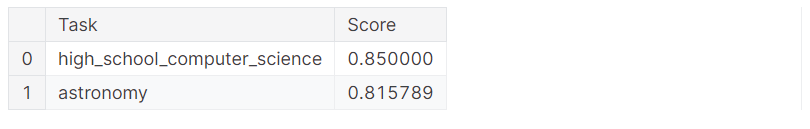
Je kunt ook de volledige resultaten bekijken, waarin staat welke voorbeelden correct waren en welke niet. Dit biedt een gedetailleerde analyse van de modelprestaties.
benchmark.predictions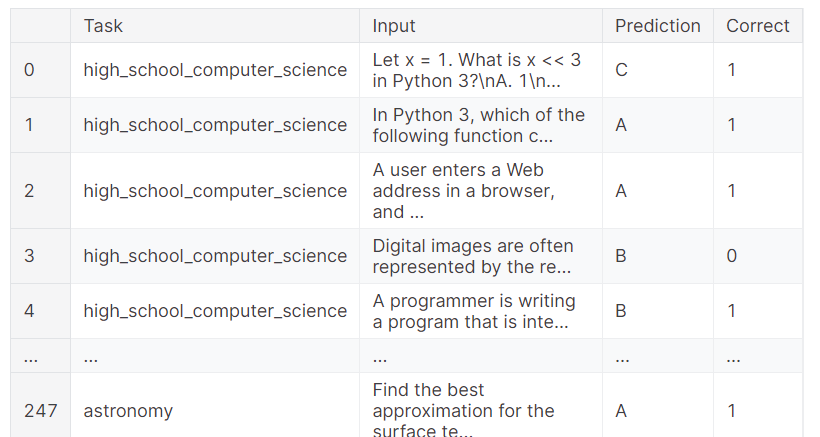
Als je problemen ondervindt bij het uitvoeren van de bovenstaande code, raadpleeg dan de Evaluating LLMs with DeepEval Kaggle-notebook. Deze bevat codebronnen, datasets en evaluatieresultaten.
Het evalueren van taalmodellen kan uitdagend zijn, zeker in een productieomgeving. Soms zijn eenvoudige evaluatiemetrieken niet voldoende. Het is essentieel om een reeks benchmarks en tests uit te voeren om de prestaties van je LLM over verschillende taken en functies te beoordelen, zodat je een compleet beeld krijgt en verbetermogelijkheden identificeert.
In deze tutorial hebben we DeepEval opgezet in een Kaggle-notebook en LLM-tests uitgevoerd vergelijkbaar met Pytests. Daarna hebben we G-Eval gebouwd met aangepaste instructies en dit gedraaid op de evaluatiedataset. Tot slot hebben we het Qwen 2.5 7B-model getest tegen de MMLU-benchmark om de prestaties op het gebied van middelbare school-informatica en astronomie te analyseren.
De volgende stap in je leertraject is het verkennen van LLMOps-tools en -methodologieën en leren hoe je een LLM eenvoudig in productie brengt. Voor meer inzichten kun je de cursus LLMOps Concepts volgen.
Leer meer over LLM’s met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

