

DeepEval के साथ शुरुआत
इस ट्यूटोरियल के लिए, हम Kaggle को अपने कोडिंग वातावरण के रूप में उपयोग करेंगे। शुरू करने के लिए, एक नया नोटबुक बनाएँ।
हम OpenAI API का भी उपयोग करेंगे। आगे बढ़ने के लिए, एक API कुंजी बनाएँ। फिर, Kaggle की "Secrets" सुविधा का उपयोग करके OpenAI API कुंजी के लिए पर्यावरण चर सेट करें।
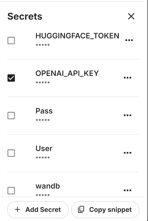
उसके बाद, pip कमांड का उपयोग करके DeepEval और BitsandBytes Python लाइब्रेरी इंस्टॉल करें:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytesसीक्रेट्स से OpenAI API कुंजी लोड करें:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")
os.environ['OPENAI_API_KEY'] = secret_value_0Jupyter Notebook मैजिक फ़ंक्शन का उपयोग करके निम्न Python फ़ाइल लिखें।
test_relevancy.py फ़ाइल एक टेस्ट फ़ंक्शन परिभाषित करती है जो GPT-4o मॉडल का उपयोग करके LLM के आउटपुट की प्रासंगिकता का मूल्यांकन करती है। यह दिए गए इनपुट पर मॉडल की प्रतिक्रिया को रिट्रीवल कॉन्टेक्स्ट के साथ तुलना करके सुनिश्चित करती है कि आउटपुट प्रदत्त जानकारी के अनुरूप है।
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric
def test_relevancy():
relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
test_case_1 = LLMTestCase(
input="Can I return these shoes after 30 days?",
actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
retrieval_context=[
"All customers are eligible for a 30-day full refund at no extra cost.",
"Returns are only accepted within 30 days of purchase.",
],
)
assert_test(test_case_1, [relevancy_metric])टर्मिनल में प्रासंगिकता परीक्षण चलाएँ:
!deepeval test run test_relevancy.pyनिम्नलिखित परीक्षण परिणाम दर्शाता है कि LLM टेस्ट केस सफलता पूर्वक पास हो गया और 1.0 का परफेक्ट प्रासंगिकता स्कोर हासिल किया, जो इंगित करता है कि मॉडल की प्रतिक्रिया पूरी तरह प्रासंगिक थी।
मूल्यांकन 3.04 सेकंड में पूरा हुआ, और कुल अनुमानित टोकन लागत $0.0027425 USD रही:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03, 3.00s/
.Running teardown with pytest sessionfinish...
============================= slowest 10 durations =============================
3.03s call test_relevancy.py::test_relevancy
(2 durations < 0.005s hidden. Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃ ┃ ┃ ┃ ┃ Overall Success ┃
┃ Test case ┃ Metric ┃ Score ┃ Status ┃ Rate ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │ │ │ │ 100.0% │
│ │ Answer │ 1.0 │ PASSED │ │
│ │ Relevancy │ (threshold=0.... │ │ │
│ │ │ evaluation │ │ │
│ │ │ model=gpt-4o, │ │ │
│ │ │ reason=The │ │ │
│ │ │ score is 1.00 │ │ │
│ │ │ because the │ │ │
│ │ │ response was │ │ │
│ │ │ perfectly │ │ │
│ │ │ relevant and │ │ │
│ │ │ addressed the │ │ │
│ │ │ question │ │ │
│ │ │ directly │ │ │
│ │ │ without any │ │ │
│ │ │ irrelevant │ │ │
│ │ │ information. │ │ │
│ │ │ Great job!, │ │ │
│ │ │ error=None) │ │ │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️ Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.आप Hugging Face इकोसिस्टम का उपयोग करके भी LLMs का मूल्यांकन कर सकते हैं। इसके लिए HumanEval: A Benchmark for Evaluating LLM Code Generation Capabilities गाइड का अनुसरण करें।
G-Eval मेट्रिक पर LLM का परीक्षण
G-Eval एक LLM मूल्यांकन फ्रेमवर्क है जो चेन-ऑफ-थॉट (CoT) रीजनिंग का उपयोग करके कस्टम मानदंडों के आधार पर LLM आउटपुट का मूल्यांकन करता है। DeepEval का सबसे अनुकूलनीय मेट्रिक होने के नाते, G-Eval लगभग किसी भी उपयोग-केस को मानव-समान सटीकता के साथ संभाल सकता है, जिससे यह LLM प्रदर्शन के आकलन के लिए एक आवश्यक उपकरण बन जाता है।
इस खंड में, हम G-Eval मेट्रिक का उपयोग करके LLM प्रतिक्रियाओं के डेटासेट का मूल्यांकन करेंगे।
1. G-Eval मेट्रिक सेटअप करना
हम G-eval मेट्रिक बनाएँगे और कस्टम निर्देश देंगे ताकि मॉडल की प्रतिक्रिया को तथ्यात्मक विरोधाभासों पर परखा जा सके, चूकों पर हल्का दंड दिया जाए, और मुख्य विचार पर ध्यान केंद्रित किया जाए, जबकि अस्पष्ट भाषा या भिन्न मत स्वीकार्य हों:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
name="Correctness",
model="gpt-4o",
evaluation_params=[
LLMTestCaseParams.EXPECTED_OUTPUT,
LLMTestCaseParams.ACTUAL_OUTPUT],
evaluation_steps=[
"Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
"You should also lightly penalize omission of detail, and focus on the main idea",
"Vague language, or contradicting OPINIONS, are OK"
],
)2. मूल्यांकन के लिए टेस्ट केस बनाना
विभिन्न विषयों पर तीन LLM टेस्ट केस बनाएँ। प्रत्येक टेस्ट केस में एक इनपुट प्रॉम्प्ट, एक वास्तविक जनरेटेड आउटपुट, और एक अपेक्षित आउटपुट होता है। GPT-4o मॉडल इनकी तुलना करेगा और अंत में विस्तृत परिणाम उत्पन्न करेगा:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset
first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")
second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")
third_test_case = LLMTestCase(input="List the primary colors.",
actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")3. मूल्यांकन डेटासेट तैयार करना
हम तीनों टेस्ट केस को मिलाकर मूल्यांकन डेटा सेट बनाएँगे:
test_cases = [first_test_case, second_test_case, third_test_case]
dataset = EvaluationDataset(test_cases=test_cases)4. G-Eval मेट्रिक चलाना
डेटासेट पर G-Eval मूल्यांकन परीक्षण चलाएँ:
evaluation_output = dataset.evaluate([correctness_metric])आउटपुट:
प्रत्येक परीक्षण के परिणाम मेट्रिक सारांश, टेस्ट केस, और समग्र मेट्रिक्स पास परिणाम के साथ आते हैं।
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02, 1.08test case/s]
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)
For test case:
- input: What are the main causes of deforestation?
- actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)
For test case:
- input: Define the term 'artificial intelligence'.
- actual output: Artificial intelligence is the simulation of human intelligence by machines.
- expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)
For test case:
- input: List the primary colors.
- actual output: The primary colors are green, orange, and purple.
- expected output: The primary colors are red, blue, and yellow.
- context: None
- retrieval context: None
======================================================================
Overall Metric Pass Rates
Correctness (GEval): 66.67% pass rate
======================================================================Evaluating LLMs with MLflow ट्यूटोरियल का अनुसरण करके अपने पसंदीदा टूल MLflow के साथ LLMs का मूल्यांकन करना सीखें।
5. टेस्ट केस परिणामों का विश्लेषण
G-Eval मेट्रिक का उपयोग करके तीन टेस्ट केस का मूल्यांकन 66.67% पास दर पर पहुँचा—एक परफेक्ट मैच, एक विवरणों की कमी के कारण आंशिक मैच, और एक प्रत्यक्ष विरोधाभास के कारण असफल। यह मॉडल की तथ्यात्मक सटीकता में ताकत को रेखांकित करता है, साथ ही सूक्ष्म या विस्तृत आउटपुट को संभालने में इसकी सीमाओं को भी उजागर करता है।
Qwen 2.5 का MMLU बेंचमार्किंग
MMLU (Massive Multitask Language Understanding) बहुविकल्पीय प्रश्नों के माध्यम से बड़े भाषा मॉडलों का मूल्यांकन करने के लिए व्यापक रूप से उपयोग किया जाने वाला बेंचमार्क है। यह 57 विविध विषयों को कवर करता है, जिनमें गणित, इतिहास, कानून, और नैतिकता शामिल हैं, जो किसी LLM के ज्ञान और तर्क क्षमताओं की एक व्यापक परीक्षा बनाता है। व्यापक विषय कवरेज और उच्च-गुणवत्ता वाले प्रश्नों के कारण, MMLU LLM प्रदर्शन के आकलन के लिए एक मानक बन चुका है।
हम एक कदम आगे बढ़ेंगे और अपने कस्टम LLM (Qwen 2.5 7B) का MMLU डेटासेट पर मूल्यांकन करेंगे। डेटासेट में इनपुट प्रॉम्प्ट्स और परिणाम (A, B, C, D) होते हैं। अंत में, यह सही उत्तरों के स्कोर का उपयोग करके सटीकता का प्रतिशत उत्पन्न करता है।
1. कस्टम LLM मॉडल क्लास बनाना
हम QwenModel नामक एक कस्टम क्लास परिभाषित करेंगे, जो DeepEvalBaseLLM का विस्तार करता है ताकि भाषा मॉडल और टोकनाइज़र का उपयोग करके प्रतिक्रियाएँ उत्पन्न की जा सकें।
हमारा उद्देश्य दिए गए प्रॉम्प्ट के आधार पर दो टोकन के छोटे आउटपुट उत्पन्न करना है। अतिरिक्त रूप से, हम डिवाइस आवंटन प्रबंधित करेंगे और इनपुट प्रॉम्प्ट तथा आउटपुट टेक्स्ट का प्री-प्रोसेसिंग संभालेंगे।
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
class QwenModel(DeepEvalBaseLLM):
def __init__(self, model, tokenizer):
self.model = model
self.tokenizer = tokenizer
self.device = "cuda"
def load_model(self):
return self.model
def generate(self, prompt: str) -> str:
prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
generated_ids = self.model.generate(
**model_inputs,
max_new_tokens=2,
do_sample=True,
pad_token_id=self.tokenizer.eos_token_id
)
prompt_length = len(model_inputs[0])
generated_tokens = generated_ids[0][prompt_length:]
clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
return clean_output.replace(".","")
async def a_generate(self, prompt: str) -> str:
return self.generate(prompt)
def get_model_name(self):
return "Qwen2.5 7B"2. मॉडल और टोकनाइज़र लोड करना
हम दो फ़ंक्शन बनाएँगे जो LLM मॉडल और टोकनाइज़र को सीधे लोकल से लोड करेंगे। हम मॉडल को 8 बिट में लोड करेंगे और उसी मॉडल के लिए एक टोकनाइज़र इनिशियलाइज़ करेंगे, जिसमें पैडिंग और विशेष टोकन कॉन्फ़िगरेशन सेट होंगे:
def load_model(model_name: str):
quant_config = BitsAndBytesConfig(
load_in_8bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=False
)
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=quant_config,
device_map="auto"
)
model.config.use_cache = False
model.config.pretraining_tp = 1
return model
def load_tokenizer(model_name):
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
return tokenizer3. कस्टम LLM बनाना
Kaggle नोटबुक में “+ Add Input” बटन का उपयोग करके Qwen 2.4 7b instruct मॉडल जोड़ें।
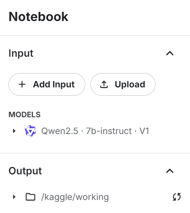
मॉडल और टोकन को लोड करने के लिए मॉडल का सीधे उपयोग करें, फिर इसे कस्टम LLM क्लास को दें ताकि एक LLM प्रतिक्रिया जनरेटर बनाया जा सके:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)4. कस्टम LLM का परीक्षण
बेंचमार्किंग परिणाम उत्पन्न करने से पहले कस्टम LLM का परीक्षण करें:
# Test model generation
prompt = """
The following are multiple choice questions (with answers) about abstract algebra.
Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))हमने डेटासेट से एक नमूना प्रॉम्प्ट LLM को दिया, और इसने एक अक्षर के साथ सटीक उत्तर दिया।
C5. MMLU बेंचमार्क चलाना
अब, हम MMLU बेंचमार्क लोड करेंगे, टास्क परिभाषित करेंगे, और फिर कस्टम मॉडल पर बेंचमार्क चलाएँगे:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask
# Define benchmark with specific tasks and shots
benchmark = MMLU(
tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
n_shots=5
)
benchmark.evaluate(model=custom_model, batch_size=5)हमें 83% सटीकता के साथ उत्कृष्ट परिणाम मिले!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00, 1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794आइए प्रत्येक व्यक्तिगत टास्क के परिणामों की समीक्षा करें:
benchmark.task_scores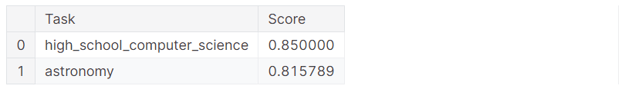
आप पूर्ण परिणाम भी देख सकते हैं, जो दिखाते हैं कि किस नमूने ने सही परिणाम प्राप्त किया और कौन-सा असफल रहा। यह मॉडल के प्रदर्शन का सूक्ष्म विश्लेषण प्रदान करता है।
benchmark.predictions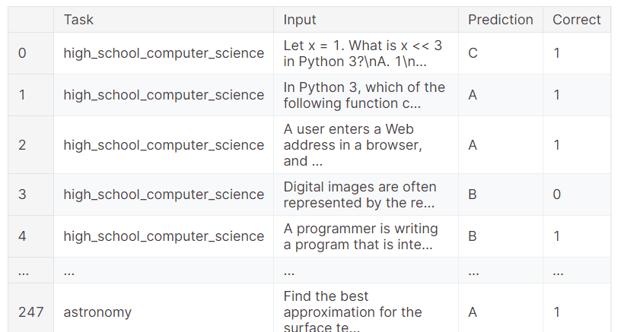
यदि आपको ऊपर दिया गया कोड चलाने में कोई समस्या आती है, तो कृपया Evaluating LLMs with DeepEval Kaggle नोटबुक देखें। इसमें कोड स्रोत, डेटासेट्स, और मूल्यांकन परिणाम शामिल हैं।
निष्कर्ष
भाषा मॉडलों का मूल्यांकन चुनौतीपूर्ण हो सकता है, खासकर प्रोडक्शन वातावरण में। कभी-कभी, सरल मूल्यांकन मेट्रिक्स पर्याप्त नहीं होते। यह आवश्यक है कि आप अपने LLM के प्रदर्शन का विभिन्न कार्यों और फंक्शंस में आकलन करने के लिए बेंचमार्क्स और परीक्षणों का एक सूट चलाएँ, ताकि व्यापक समझ मिल सके और सुधार के क्षेत्रों की पहचान हो सके।
इस ट्यूटोरियल में, हमने Kaggle नोटबुक में DeepEval सेटअप किया और Pytests जैसे LLM परीक्षण संचालित किए। फिर, हमने कस्टम निर्देशों के साथ G-Eval बनाया और उसे मूल्यांकन डेटासेट पर चलाया। अंत में, हमने Qwen 2.5 7B मॉडल को MMLU मूल्यांकन बेंचमार्क के विरुद्ध परखा ताकि हाई स्कूल कंप्यूटर साइंस और खगोल विज्ञान में उसके प्रदर्शन का विश्लेषण किया जा सके।
आपकी सीखने की यात्रा का अगला कदम LLMOps टूल्स और कार्यप्रणालियों का अन्वेषण करना और यह सीखना है कि किसी LLM को आसानी से प्रोडक्शन में कैसे डिप्लॉय किया जाए। अधिक जानकारी के लिए, LLMOps Concepts कोर्स करने पर विचार करें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
मशीन लर्निंग इकोसिस्टम में ऐसे बहुत कम मूल्यांकन फ्रेमवर्क मौजूद हैं जो बड़े भाषा मॉडल्स (LLMs) को विभिन्न गुणों पर प्रभावी ढंग से परख सकें। LLMs के विकास में तीव्र वृद्धि के साथ, विभिन्न कार्यों में उनके प्रदर्शन का आकलन करना और उनकी ताकत, कमजोरियों, और सीमाओं का मूल्यांकन करना अत्यंत महत्वपूर्ण हो गया है।
DeepEval इस आवश्यकता को पूरा करने के लिए एक व्यापक और विश्वसनीय समाधान के रूप में सामने आता है, जो सटीकता, तर्क, सुसंगतता, और नैतिक संरेखण जैसे कई आयामों पर LLMs की जाँच के लिए एक मज़बूत फ्रेमवर्क प्रदान करता है।
इस ट्यूटोरियल में, आप जानेंगे कि DeepEval कैसे सेटअप करें और Pytest दृष्टिकोण जैसा एक प्रासंगिकता परीक्षण कैसे बनाएँ। इसके बाद, आप G-eval मेट्रिक का उपयोग करके LLM आउटपुट का परीक्षण करेंगे और Qwen 2.5 मॉडल पर MMLU बेंचमार्किंग चलाएँगे। यह एक शुरुआती-हितैषी और सरल ट्यूटोरियल है, जो किसी भी तकनीकी पृष्ठभूमि वाले व्यक्ति के लिए DeepEval इकोसिस्टम को बेहतर समझने हेतु बनाया गया है।
यदि आप LLMs में नए हैं, तो मैं Master Large Language Models (LLMs) Concepts कोर्स करने की सिफारिश करता/करती हूँ ताकि आप बुनियादी बातों को सीख सकें।
DeepEval को समझना
DeepEval एक ओपन-सोर्स मूल्यांकन फ्रेमवर्क है, जो विशेष रूप से बड़े भाषा मॉडल्स के लिए डिज़ाइन किया गया है, और डेवलपर्स को LLM-आधारित अनुप्रयोगों को कुशलतापूर्वक बनाना, सुधारना, परखना, और मॉनिटर करना सक्षम करता है। यह उपयोगकर्ताओं को अपने मॉडलों का "यूनिट टेस्ट" करने की सुविधा देकर LLM आउटपुट के मूल्यांकन की प्रक्रिया को सरल बनाता है, ठीक वैसे ही जैसे पारंपरिक सॉफ्टवेयर परीक्षण के लिए Pytest का उपयोग किया जाता है।
DeepEval व्यापक मूल्यांकन सुनिश्चित करने के लिए कई विशेषताएँ प्रदान करता है, जिनमें 14 शोध-समर्थित LLM मूल्यांकन मेट्रिक्स, सिंथेटिक डेटासेट जनरेशन, LLMs बेंचमार्क, रेड टीम, और प्रोडक्शन में रियल-टाइम मूल्यांकन शामिल हैं। इन सुविधाओं के साथ, DeepEval न केवल परीक्षण को सुव्यवस्थित करता है, बल्कि LLM-समर्थित अनुप्रयोगों की सुरक्षा और विश्वसनीयता भी सुनिश्चित करता है।
बड़े भाषा मॉडलों का प्रमुख मेट्रिक्स, कार्यप्रणालियाँ, और सर्वोत्तम प्रथाओं के माध्यम से मूल्यांकन कैसे करें, यह जानने के लिए LLM Evaluation ब्लॉग पढ़ें।