

Memulai dengan DeepEval
Untuk tutorial ini, kita akan menggunakan Kaggle sebagai lingkungan pemrograman. Untuk mulai, buat notebook baru.
Kita juga akan menggunakan OpenAI API. Untuk melanjutkan, buat kunci API. Lalu, atur variabel lingkungan untuk kunci OpenAI API menggunakan fitur "Secrets" milik Kaggle.
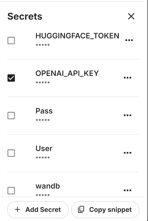
Setelah itu, instal pustaka Python DeepEval dan BitsandBytes menggunakan perintah pip:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytesMuat kunci OpenAI API dari secrets:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")
os.environ['OPENAI_API_KEY'] = secret_value_0Tulis berkas Python berikut menggunakan magic function Jupyter Notebook.
Berkas test_relevancy.py mendefinisikan fungsi uji yang mengevaluasi relevansi output LLM menggunakan model GPT-4o. Ini dilakukan dengan membandingkan respons model terhadap masukan tertentu dengan retrieval context, memastikan output selaras dengan informasi yang disediakan.
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric
def test_relevancy():
relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
test_case_1 = LLMTestCase(
input="Can I return these shoes after 30 days?",
actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
retrieval_context=[
"All customers are eligible for a 30-day full refund at no extra cost.",
"Returns are only accepted within 30 days of purchase.",
],
)
assert_test(test_case_1, [relevancy_metric])Jalankan uji relevansi di terminal:
!deepeval test run test_relevancy.pyHasil uji berikut menunjukkan bahwa kasus uji LLM berhasil lolos dan meraih skor relevansi sempurna 1,0, menandakan respons model sepenuhnya relevan.
Evaluasi selesai dalam 3,04 detik dengan total estimasi biaya token sebesar $0,0027425 USD:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03, 3.00s/
.Running teardown with pytest sessionfinish...
============================= slowest 10 durations =============================
3.03s call test_relevancy.py::test_relevancy
(2 durations < 0.005s hidden. Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃ ┃ ┃ ┃ ┃ Overall Success ┃
┃ Test case ┃ Metric ┃ Score ┃ Status ┃ Rate ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │ │ │ │ 100.0% │
│ │ Answer │ 1.0 │ PASSED │ │
│ │ Relevancy │ (threshold=0.... │ │ │
│ │ │ evaluation │ │ │
│ │ │ model=gpt-4o, │ │ │
│ │ │ reason=The │ │ │
│ │ │ score is 1.00 │ │ │
│ │ │ because the │ │ │
│ │ │ response was │ │ │
│ │ │ perfectly │ │ │
│ │ │ relevant and │ │ │
│ │ │ addressed the │ │ │
│ │ │ question │ │ │
│ │ │ directly │ │ │
│ │ │ without any │ │ │
│ │ │ irrelevant │ │ │
│ │ │ information. │ │ │
│ │ │ Great job!, │ │ │
│ │ │ error=None) │ │ │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️ Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.Anda juga dapat mengevaluasi LLM menggunakan ekosistem Hugging Face dengan mengikuti panduan HumanEval: A Benchmark for Evaluating LLM Code Generation Capabilities.
Menguji LLM dengan metrik G-Eval
G-Eval adalah kerangka evaluasi LLM yang menggunakan penalaran chain-of-thought (CoT) untuk menilai output LLM berdasarkan kriteria kustom. Sebagai metrik DeepEval yang paling adaptif, G-Eval dapat menangani hampir semua use case dengan akurasi mendekati manusia, menjadikannya alat penting untuk mengevaluasi kinerja LLM.
Pada bagian ini, kita akan mengevaluasi dataset respons LLM menggunakan metrik G-Eval.
1. Menyiapkan metrik G-Eval
Kita akan membuat metrik G-eval dan memberikan instruksi kustom untuk menguji respons model terkait kontradiksi faktual, memberikan penalti pada kelalaian detail, serta berfokus pada gagasan utama sambil mentoleransi bahasa samar atau perbedaan pendapat:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
name="Correctness",
model="gpt-4o",
evaluation_params=[
LLMTestCaseParams.EXPECTED_OUTPUT,
LLMTestCaseParams.ACTUAL_OUTPUT],
evaluation_steps=[
"Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
"You should also lightly penalize omission of detail, and focus on the main idea",
"Vague language, or contradicting OPINIONS, are OK"
],
)2. Membuat kasus uji untuk evaluasi
Buat tiga kasus uji LLM pada topik berbeda. Setiap kasus uji memiliki prompt masukan, output aktual yang dihasilkan, dan output yang diharapkan. Model GPT-4o akan membandingkannya dan menghasilkan hasil terperinci di akhir:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset
first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")
second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")
third_test_case = LLMTestCase(input="List the primary colors.",
actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")3. Membangun dataset evaluasi
Kita akan membuat dataset evaluasi dengan menggabungkan ketiga kasus uji tersebut:
test_cases = [first_test_case, second_test_case, third_test_case]
dataset = EvaluationDataset(test_cases=test_cases)4. Menjalankan metrik G-Eval
Jalankan uji evaluasi G-Eval pada dataset:
evaluation_output = dataset.evaluate([correctness_metric])Output:
Hasil uji untuk setiap tes dilengkapi ringkasan metrik, kasus uji, dan hasil kelulusan metrik secara keseluruhan.
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02, 1.08test case/s]
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)
For test case:
- input: What are the main causes of deforestation?
- actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)
For test case:
- input: Define the term 'artificial intelligence'.
- actual output: Artificial intelligence is the simulation of human intelligence by machines.
- expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)
For test case:
- input: List the primary colors.
- actual output: The primary colors are green, orange, and purple.
- expected output: The primary colors are red, blue, and yellow.
- context: None
- retrieval context: None
======================================================================
Overall Metric Pass Rates
Correctness (GEval): 66.67% pass rate
======================================================================Pelajari cara mengevaluasi LLM dengan alat favorit Anda, MLflow, dengan mengikuti tutorial Evaluating LLMs with MLflow.
5. Menganalisis hasil kasus uji
Evaluasi tiga kasus uji menggunakan metrik G-Eval mencapai tingkat kelulusan 66,67%, dengan satu kecocokan sempurna, satu kecocokan parsial karena detail yang hilang, dan satu kegagalan akibat kontradiksi langsung. Hal ini menyoroti kekuatan model dalam akurasi faktual sekaligus keterbatasannya dalam menangani output yang bernuansa atau detail.
Benchmarking MMLU pada Qwen 2.5
MMLU (Massive Multitask Language Understanding) adalah tolok ukur yang banyak digunakan untuk mengevaluasi large language model melalui pertanyaan pilihan ganda. Benchmark ini mencakup 57 subjek beragam, termasuk matematika, sejarah, hukum, dan etika, menjadikannya pengujian komprehensif atas pengetahuan dan kemampuan penalaran LLM. Karena cakupan subjek yang luas dan kualitas pertanyaan yang tinggi, MMLU menjadi standar dalam menilai kinerja LLM.
Kita akan melangkah lebih jauh dan mengevaluasi LLM kustom kita (Qwen 2.5 7B) pada dataset MMLU. Dataset ini berisi prompt masukan dan hasil (A, B, C, D). Pada akhirnya, skor jawaban benar digunakan untuk menghasilkan persentase akurasi.
1. Membuat kelas model LLM kustom
Kita akan mendefinisikan kelas kustom bernama QwenModel yang memperluas DeepEvalBaseLLM untuk menghasilkan respons menggunakan language model dan tokenizer.
Tujuan kita adalah menghasilkan output pendek dua token berdasarkan prompt yang diberikan. Selain itu, kita akan mengelola alokasi perangkat serta menangani prapemrosesan prompt masukan dan teks keluaran.
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
class QwenModel(DeepEvalBaseLLM):
def __init__(self, model, tokenizer):
self.model = model
self.tokenizer = tokenizer
self.device = "cuda"
def load_model(self):
return self.model
def generate(self, prompt: str) -> str:
prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
generated_ids = self.model.generate(
**model_inputs,
max_new_tokens=2,
do_sample=True,
pad_token_id=self.tokenizer.eos_token_id
)
prompt_length = len(model_inputs[0])
generated_tokens = generated_ids[0][prompt_length:]
clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
return clean_output.replace(".","")
async def a_generate(self, prompt: str) -> str:
return self.generate(prompt)
def get_model_name(self):
return "Qwen2.5 7B"2. Memuat model dan tokenizer
Kita akan membuat dua fungsi yang memuat model LLM dan tokenizer langsung dari lokal. Kita memuat model dalam 8 bit dan menginisialisasi tokenizer untuk model yang sama, dengan pengaturan padding dan token khusus:
def load_model(model_name: str):
quant_config = BitsAndBytesConfig(
load_in_8bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=False
)
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=quant_config,
device_map="auto"
)
model.config.use_cache = False
model.config.pretraining_tp = 1
return model
def load_tokenizer(model_name):
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
return tokenizer3. Membangun LLM kustom
Tambahkan model instruct Qwen 2.4 7B ke notebook Kaggle menggunakan tombol “+ Add Input”.
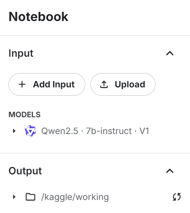
Gunakan model tersebut secara langsung untuk memuat model dan token, lalu berikan ke kelas LLM kustom untuk membuat generator respons LLM:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)4. Menguji LLM kustom
Uji LLM kustom sebelum menghasilkan hasil benchmarking:
# Test model generation
prompt = """
The following are multiple choice questions (with answers) about abstract algebra.
Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))Kita memberikan LLM sebuah contoh prompt dari dataset, dan model merespons dengan tepat menggunakan satu huruf.
C5. Menjalankan benchmark MMLU
Sekarang, kita akan memuat benchmark MMLU, mendefinisikan tugas, lalu menjalankan benchmark pada model kustom:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask
# Define benchmark with specific tasks and shots
benchmark = MMLU(
tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
n_shots=5
)
benchmark.evaluate(model=custom_model, batch_size=5)Kita mendapatkan hasil yang sangat baik dengan akurasi 83%!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00, 1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794Mari tinjau hasil tiap tugas secara individual:
benchmark.task_scores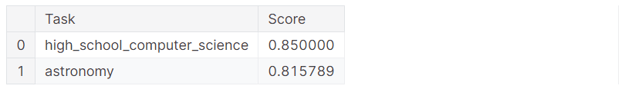
Anda juga dapat memeriksa hasil lengkap yang menunjukkan sampel mana yang benar dan mana yang gagal. Ini memberikan analisis kinerja model secara mendetail.
benchmark.predictions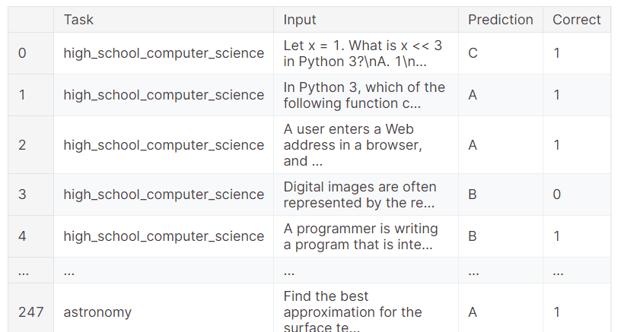
Jika Anda mengalami masalah saat menjalankan kode di atas, silakan rujuk ke Evaluating LLMs with DeepEval notebook Kaggle. Di dalamnya terdapat sumber kode, dataset, dan hasil evaluasi.
Kesimpulan
Mengevaluasi language model bisa menantang, terutama di lingkungan produksi. Terkadang, metrik evaluasi sederhana tidaklah cukup. Penting untuk menjalankan rangkaian tolok ukur dan pengujian guna menilai kinerja LLM Anda di berbagai tugas dan fungsi untuk mendapatkan pemahaman menyeluruh serta mengidentifikasi area yang perlu ditingkatkan.
Dalam tutorial ini, kita menyiapkan DeepEval di notebook Kaggle dan melakukan pengujian LLM yang mirip Pytest. Kita kemudian membangun G-Eval menggunakan instruksi kustom dan menjalankannya pada dataset evaluasi. Terakhir, kita menguji model Qwen 2.5 7B terhadap tolok ukur evaluasi MMLU untuk menganalisis kinerjanya dalam ilmu komputer tingkat sekolah menengah dan astronomi.
Langkah berikutnya dalam perjalanan belajar Anda adalah mengeksplorasi alat dan metodologi LLMOps serta mempelajari cara menerapkan LLM ke produksi dengan mudah. Untuk wawasan lebih lanjut, pertimbangkan untuk mengikuti kursus LLMOps Concepts.

Sebagai data scientist tersertifikasi, saya bersemangat memanfaatkan teknologi mutakhir untuk menciptakan aplikasi machine learning yang inovatif. Dengan latar belakang kuat di pengenalan ucapan, analisis dan pelaporan data, MLOps, conversational AI, dan NLP, saya mengasah keterampilan dalam mengembangkan sistem cerdas yang berdampak nyata. Selain keahlian teknis, saya juga komunikator andal yang mampu menyederhanakan konsep kompleks menjadi bahasa yang jelas dan ringkas. Karena itu, saya menjadi blogger yang dicari di bidang data science, membagikan wawasan dan pengalaman kepada komunitas profesional data yang terus berkembang. Saat ini, saya berfokus pada pembuatan dan penyuntingan konten, bekerja dengan large language model untuk mengembangkan konten yang kuat dan menarik agar membantu bisnis dan individu memaksimalkan data mereka.




Hanya sedikit kerangka evaluasi dalam ekosistem machine learning yang dapat menguji large language model (LLM) secara efektif pada berbagai aspek. Dengan pertumbuhan eksponensial dalam pengembangan LLM, menjadi krusial untuk menilai kinerjanya di berbagai tugas serta mengevaluasi kekuatan, kelemahan, dan keterbatasannya.
DeepEval hadir sebagai solusi komprehensif dan andal untuk kebutuhan ini, menawarkan kerangka yang kuat untuk menguji LLM pada berbagai dimensi, seperti akurasi, penalaran, koherensi, dan keselarasan etis.
Dalam tutorial ini, Anda akan mempelajari cara menyiapkan DeepEval dan membuat uji relevansi yang mirip pendekatan Pytest. Lalu, Anda akan menguji output LLM menggunakan metrik G-eval dan menjalankan benchmarking MMLU pada model Qwen 2.5. Ini adalah tutorial sederhana dan ramah pemula yang ditujukan bagi siapa pun dengan latar belakang teknis yang ingin memahami ekosistem DeepEval dengan lebih baik.
Jika Anda baru mengenal LLM, saya sangat merekomendasikan mengikuti kursus Master Large Language Models (LLMs) Concepts untuk mempelajari dasar-dasarnya.
Memahami DeepEval
DeepEval adalah kerangka evaluasi open-source yang dirancang khusus untuk large language model, memungkinkan pengembang membangun, meningkatkan, menguji, dan memantau aplikasi berbasis LLM secara efisien. Kerangka ini menyederhanakan proses evaluasi output LLM dengan memungkinkan pengguna melakukan "unit test" pada modelnya, mirip penggunaan Pytest untuk pengujian perangkat lunak tradisional.
DeepEval menawarkan beragam fitur untuk memastikan evaluasi yang komprehensif, termasuk 14 metrik evaluasi LLM berbasis riset, pembuatan dataset sintetis, tolok ukur LLM, red team, dan evaluasi real-time di produksi. Dengan fitur-fitur ini, DeepEval tidak hanya merampingkan pengujian, tetapi juga memastikan keamanan dan keandalan aplikasi bertenaga LLM.
Baca blog LLM Evaluation untuk mempelajari cara mengevaluasi large language model menggunakan metrik kunci, metodologi, dan praktik terbaik.