
Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.4K
Mô hình ngôn ngữ lớn (LLM) đã trở nên rất quan trọng trong quá trình phát triển mô hình máy học, đặc biệt là khi nâng cao năng lực của các thuật toán xử lý ngôn ngữ tự nhiên. Từ chatbot đến trình tạo nội dung, các mô hình này đang thay đổi cách chúng ta tương tác với công nghệ.
Tuy nhiên, khi LLM ngày càng nhiều và phức tạp hơn, việc đánh giá hiệu năng của chúng cũng trở nên quan trọng hơn. Nếu không có đánh giá phù hợp và chính xác, việc biết một mô hình có hoạt động như mong đợi hay cần điều chỉnh sẽ rất khó khăn.
Đây là lúc MLflow phát huy tác dụng. MLflow là một công cụ mã nguồn mở được thiết kế để hỗ trợ quản lý các thí nghiệm máy học. Nó giúp chúng ta theo dõi kết quả của các thí nghiệm khác nhau, quản lý mô hình và giữ mọi thứ ngăn nắp!
Trong hướng dẫn này, chúng ta sẽ khám phá vai trò của MLflow trong việc nâng cao quy trình làm việc với LLM. Tôi sẽ hướng dẫn bạn cách thiết lập và cách ghi log chỉ số, theo dõi tham số trong các thí nghiệm LLM. Cuối cùng, chúng ta sẽ xem MLflow hỗ trợ quản lý và triển khai mô hình hiệu quả như thế nào.
MLflow là nền tảng mã nguồn mở được thiết kế để quản lý toàn bộ vòng đời máy học. Nó cung cấp các công cụ để đơn giản hóa quá trình phát triển, theo dõi và triển khai các mô hình máy học.
Dù chúng ta đang làm việc với một dự án nhỏ hay quản lý các thí nghiệm phức tạp với mô hình lớn, MLflow đều có thể giúp chúng ta làm việc có tổ chức và hiệu quả.
Một số ưu điểm của việc sử dụng MLflow trong vòng đời máy học gồm:
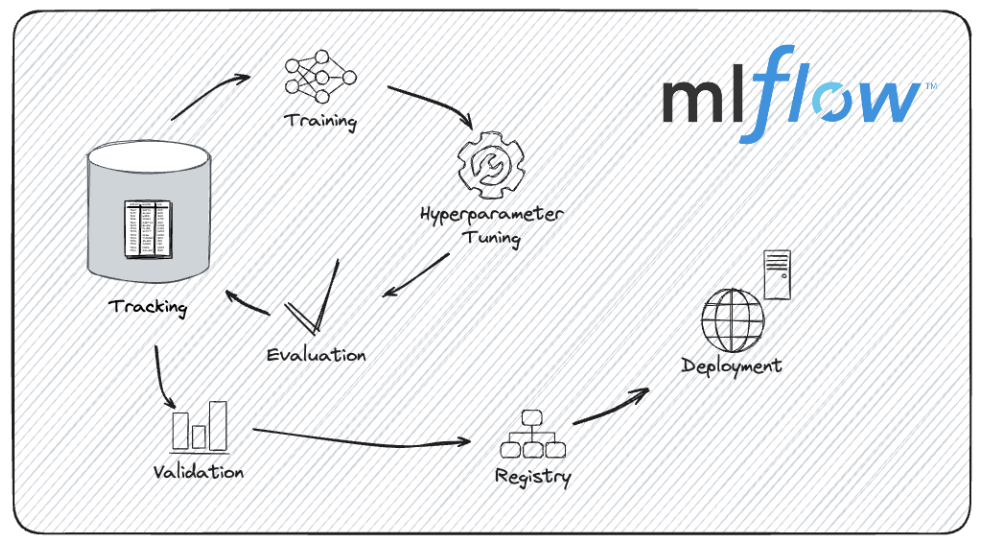
Vòng đời phát triển mô hình với MLflow. Nguồn ảnh: Tài liệu MLflow.
MLflow được thiết kế để giúp quản lý dự án máy học trơn tru và minh bạch hơn. Điều này đặc biệt hữu ích khi làm việc với các mô hình phức tạp như LLM, như chúng ta sẽ thấy ngay sau đây.
Sử dụng MLflow để đánh giá LLM mang lại nhiều lợi ích như theo dõi phiên bản mô hình, ghi log chỉ số đánh giá và so sánh hiệu năng trên nhiều khía cạnh.
Hãy xem chi tiết các lợi ích này.
Quy trình phát triển LLM bao gồm các vòng lặp và cải tiến liên tục. Mỗi phiên bản mới mang đến những nâng cấp nhỏ hoặc thay đổi hành vi. MLflow quản lý có hệ thống các vòng lặp này bằng cách theo dõi phiên bản mô hình. Khả năng này cho phép chúng ta tái tạo kết quả, so sánh hiệu quả các phiên bản và duy trì lịch sử tiến hóa của mô hình.
Giả sử chúng ta đang thử nghiệm các kỹ thuật fine-tuning khác nhau; MLflow có thể giúp quản lý và xem lại kết quả của từng phiên bản, từ đó dễ dàng xác định vòng lặp nào cho hiệu năng tốt nhất.
Vì MLflow đảm bảo mọi thí nghiệm và kết quả liên quan đều được ghi log đầy đủ, chúng ta có thể tự tin chia sẻ phát hiện, biết rằng người khác có thể tái tạo kết quả chính xác.
Nếu dự án của bạn liên quan đến việc thử nghiệm các kiến trúc LLM hoặc phương pháp huấn luyện khác nhau, khả năng theo dõi của MLflow sẽ giúp việc ghi chép và chia sẻ công việc trở nên dễ dàng hơn.
Đánh giá LLM liên quan đến việc theo dõi nhiều chỉ số như độ chính xác (accuracy), perplexity và F1, cùng các chỉ số khác.
Tính năng ghi log của MLflow cho phép chúng ta ghi lại các chỉ số này một cách hiệu quả và có tổ chức. Phân tích các chỉ số này cho chúng ta bức tranh rõ ràng về hiệu năng mô hình.
Ví dụ, chúng ta có thể muốn so sánh tác động của các siêu tham số hoặc tập dữ liệu huấn luyện khác nhau đến chỉ số hiệu năng. Với MLflow, chúng ta có thể ghi log và trực quan hóa các chỉ số này để rút ra các insight có thể hành động.
Khi mô hình được triển khai và sử dụng trong ứng dụng thực tế, chúng có thể gặp drift mô hình, khi hiệu năng suy giảm do thay đổi dữ liệu hoặc môi trường. Chúng ta có thể tận dụng MLflow để theo dõi và quản lý drift bằng cách theo dõi hiệu năng theo thời gian.
Chúng ta có thể thiết lập đánh giá định kỳ và dùng MLflow để ghi log, phân tích cách các chỉ số thay đổi, từ đó ra quyết định kịp thời.
Một lợi thế quan trọng của MLflow là khả năng đơn giản hóa việc so sánh mô hình toàn diện. Bằng cách lưu hồ sơ chi tiết về các thí nghiệm khác nhau, MLflow cho phép chúng ta so sánh hiệu năng của nhiều LLM và cấu hình siêu tham số song song.
Tìm siêu tham số phù hợp có thể quyết định thành công của mô hình khi phát triển LLM.
Hãy hình dung chúng ta đang fine-tune một LLM và muốn đánh giá tác động của các thiết lập siêu tham số khác nhau. Với MLflow, chúng ta có thể ghi log và so sánh kết quả từ các learning rate, batch size hay dropout khác nhau để xác định cấu hình cho hiệu năng tốt nhất, tối ưu hóa quy trình phát triển mô hình.
Kho đăng ký mô hình và các chức năng theo dõi của MLflow phát huy tác dụng khi đánh giá nhiều LLM cho triển khai.
Giả sử chúng ta có vài phiên bản mô hình ngôn ngữ đang cân nhắc cho môi trường sản xuất. MLflow có thể giúp ghi log chỉ số hiệu năng của từng mô hình, so sánh và đưa ra quyết định dựa trên bằng chứng thực nghiệm thay vì chỉ dựa vào trực giác.
Giờ khi đã có cái nhìn rõ hơn về MLflow và lợi ích của nó, hãy bắt tay vào thực hành!
Trước khi đánh giá LLM với MLflow, chúng ta cần thiết lập nền tảng đúng cách. Điều này bao gồm cài đặt MLflow, tùy chọn cấu hình máy chủ theo dõi để ghi log từ xa và đảm bảo môi trường sẵn sàng để quản lý thí nghiệm và theo dõi kết quả.
Hãy xem cách thực hiện.
1. Đảm bảo đã cài Python:
Trước tiên, cần chắc chắn rằng máy bạn đã cài Python. MLflow tương thích với Python 3.6 trở lên (Lưu ý Python 3.8 đã ngừng hỗ trợ, nên dùng Python >= 3.9). Bạn có thể kiểm tra phiên bản Python bằng:
python --version2. Tạo môi trường ảo (không bắt buộc nhưng nên làm):
Nên dùng môi trường ảo khi theo dõi thí nghiệm với MLflow, đặc biệt nếu bạn làm việc trên Mac OS X. Có thể tạo bằng venv hoặc virtualenv.
python -m venv mlflow-envKích hoạt môi trường ảo:
Trên Windows:
mlflow-env\Scripts\activateTrên Mac/Linux:
source mlflow-env/bin/activate3. Cài MLflow bằng pip:
Khi môi trường ảo đã được kích hoạt (nếu dùng), cài MLflow qua pip:
pip install mlflow4. Cài thêm phụ thuộc:
MLflow có một vài phụ thuộc tùy chọn để tăng cường chức năng. Nếu cần dùng các tính năng cụ thể như khả năng phục vụ mô hình của MLflow, bạn cần cài gunicorn.
pip install gunicornNếu bạn dùng các thư viện như TensorFlow hoặc PyTorch, có thể cần cài tích hợp tương ứng của MLflow:
pip install mlflow[extras]4. Xác minh cài đặt:
Sau đó, hãy đảm bảo MLflow đã được cài đúng bằng cách kiểm tra phiên bản:
mlflow --versionNếu chúng ta làm việc trong môi trường cộng tác hoặc cần ghi log từ xa, chúng ta nên thiết lập máy chủ theo dõi MLflow. Tính năng này cho phép tập trung hóa việc theo dõi và quản lý thí nghiệm.
1. Chạy máy chủ theo dõi:
Chúng ta có thể khởi động máy chủ MLflow bằng cách chỉ định kho lưu trữ backend và vị trí artifact.
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri chỉ định nơi lưu trữ dữ liệu thí nghiệm. Có thể dùng bất kỳ hệ quản trị cơ sở dữ liệu nào (PostgreSQL, MySQL, v.v.).--default-artifact-root chỉ định thư mục lưu artifact, ví dụ file mô hình.2. Cấu hình máy chủ theo dõi:
Cần đảm bảo các client MLflow được cấu hình để ghi log vào máy chủ theo dõi. Có thể đặt biến môi trường MLFLOW_TRACKING_URI trỏ đến máy chủ của bạn.
export MLFLOW_TRACKING_URI=http://localhost:50003. Truy cập giao diện theo dõi:
Giờ chúng ta có thể mở trình duyệt và đi đến http://localhost:5000 để truy cập giao diện MLflow. Giao diện này cho phép xem thí nghiệm, so sánh kết quả và quản lý các dự án MLflow, như chúng ta sẽ thấy sau.
Khi MLflow đã được thiết lập và sẵn sàng, đã đến lúc đi vào các tác vụ cốt lõi là tải và đánh giá LLM. Hãy xem cách chọn một LLM tiền huấn luyện, tải bằng các thư viện khác nhau và chuẩn bị tập dữ liệu đánh giá để đo lường hiệu năng mô hình.
Khi chọn LLM tiền huấn luyện, các thư viện như Hugging Face Transformers cung cấp rất nhiều lựa chọn. Ví dụ, chúng ta có thể tải một mô hình tiền huấn luyện như GPT (cho sinh văn bản) hoặc BERT (cho phân loại văn bản và các tác vụ khác).
1. Cài Hugging Face Transformers
Trước hết, hãy đảm bảo đã cài thư viện Hugging Face Transformers. Có thể thực hiện bằng pip.
pip install transformers2. Tải mô hình và tokenizer tiền huấn luyện
Giờ chúng ta tải mô hình BERT bằng thư viện transformers, gồm cả mô hình và tokenizer, vốn cần thiết để xử lý văn bản và tạo dự đoán.
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
Mô hình bert-base-uncased phù hợp khi dữ liệu văn bản chủ yếu có chữ thường và chữ hoa, nhưng chúng ta không cần mô hình phân biệt chữ hoa và chữ thường.
Để đánh giá LLM, chúng ta cần một tập dữ liệu phù hợp với tác vụ đang đánh giá. Hãy xem cách chuẩn bị tập dữ liệu văn bản cho phân tích cảm xúc:
1. Tải hoặc tạo và tiền xử lý tập dữ liệu
Dữ liệu của chúng ta có thể được lưu ở nhiều nơi: trên ổ đĩa máy cục bộ, trong kho Github hoặc trên Hugging Face Hub, nơi tập hợp các tập dữ liệu do cộng đồng tuyển chọn và nghiên cứu phổ biến.
Trong hướng dẫn này, chúng ta sẽ dùng một tập dữ liệu đánh giá phim lớn cho phân tích cảm xúc có tên IMDB. Chúng ta sẽ dùng thư viện datasets để tải tập dữ liệu dựng sẵn:
Cài đặt thư viện datasets:
pip install datasetsTải một tập dữ liệu:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. Tiền xử lý cho phân tích cảm xúc
Chúng ta sẽ dùng tokenizer BERT đã tải ở trên để tiền xử lý tập dữ liệu cho phân tích cảm xúc.
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)Khi LLM đã được tải và tập dữ liệu đánh giá đã sẵn sàng, đã đến lúc chạy đánh giá và ghi log các chỉ số.
1. Import MLflow và bắt đầu thí nghiệm mới
Để theo dõi thí nghiệm với MLflow, trước tiên chúng ta cần bắt đầu một thí nghiệm mới và ghi log các siêu dữ liệu liên quan như tên mô hình, phiên bản và tham số đánh giá.
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. Ghi log tham số đánh giá
Giờ chúng ta có thể ghi log các tham số liên quan đến quá trình đánh giá, như kích thước tập dữ liệu đánh giá hoặc cấu hình cụ thể được dùng trong đánh giá.
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))Khi đã huấn luyện và tạo dự đoán tương ứng bằng mô hình, chúng ta có thể đánh giá LLM và ghi log các chỉ số phản ánh hiệu năng của nó.
Phân tích cảm xúc là một bài toán phân loại, vì vậy có thể đánh giá mô hình bằng các chỉ số như accuracy và F1. Với tác vụ sinh văn bản, các chỉ số như BLEU hoặc perplexity thường được sử dụng.
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)Khi đã theo dõi nhiều lần đánh giá bằng MLflow, việc so sánh hiệu năng là cần thiết để xác định mô hình và cấu hình hoạt động tốt nhất.
Hãy hiểu cách theo dõi nhiều lần chạy và dùng giao diện MLflow để trực quan hóa, so sánh kết quả hiệu quả.
Trước hết, chúng ta cần theo dõi nhiều lần chạy trong cùng một thí nghiệm hoặc giữa các thí nghiệm khác nhau để so sánh hiệu năng của các phiên bản LLM.
1. Ghi log nhiều lần chạy
Chúng ta có thể ghi log nhiều lần chạy dưới một thí nghiệm bằng cách bắt đầu lần chạy mới cho mỗi mô hình hoặc cấu hình muốn đánh giá.
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. Theo dõi thí nghiệm với các mô hình khác nhau
Hãy tưởng tượng chúng ta muốn đánh giá các loại mô hình khác nhau. Để làm vậy, chúng ta có thể dùng MLflow để tạo một thí nghiệm và ghi log các mô hình cùng nhau.
Ghi log mô hình trong MLflow tương tự như kiểm soát phiên bản cho mô hình máy học. Ghi lại chi tiết mô hình và môi trường đảm bảo khả năng tái lập.
Đầu tiên, chúng ta sẽ thiết lập một thí nghiệm. Sau đó, ghi log mỗi mô hình trong một lần chạy MLflow riêng, bao gồm ID lần chạy và đường dẫn artifact.
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
Giờ chúng ta có thể đánh giá các mô hình và ghi log kết quả. MLflow cung cấp API mlflow.evaluate() để hỗ trợ đánh giá LLM.
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)Sau khi đã ghi log các chỉ số và mô hình khác nhau trong MLflow, chúng ta có thể tiến hành so sánh. Có thể dùng giao diện thân thiện của MLflow để trực quan hóa và so sánh chỉ số đánh giá từ các lần chạy khác nhau. Để làm điều đó, cần khởi động máy chủ MLflow nếu chưa chạy
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsSau đó mở trình duyệt và đi đến http://localhost:5000 để truy cập giao diện MLflow. Trong giao diện MLflow, vào trang "Experiments" để xem tất cả thí nghiệm. Nhấp vào tên thí nghiệm để xem danh sách các lần chạy liên quan.
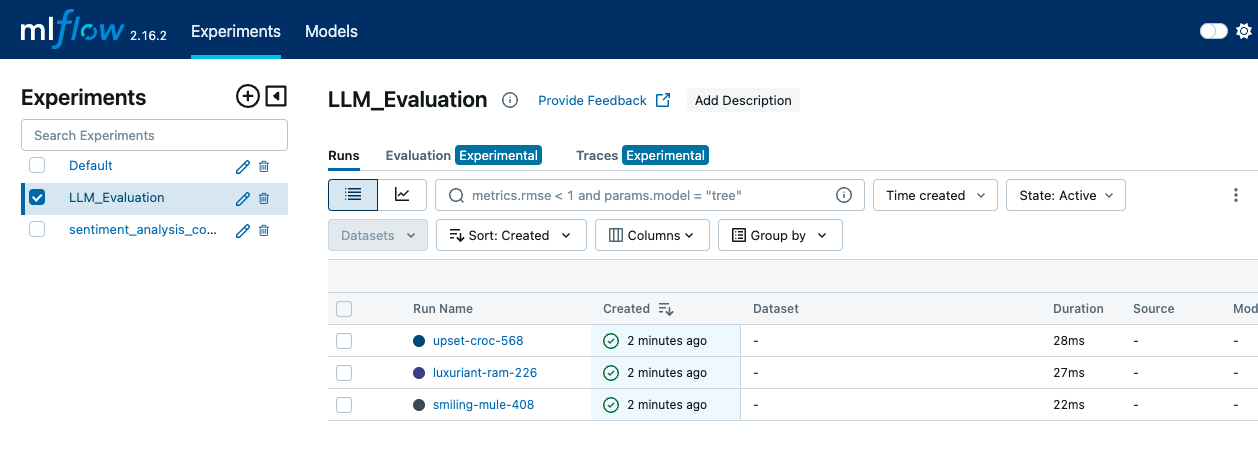
Giao diện MLflow hiển thị thẻ Experiments, nơi có thể xem các lần chạy và sự kiện log—ảnh: Tác giả.
Trong một thí nghiệm, chúng ta có thể so sánh các lần chạy khác nhau bằng cách chọn nhiều lần chạy và xem chỉ số cạnh nhau.
Giao diện cho phép xem biểu diễn trực quan các chỉ số như accuracy, F1 và các chỉ số đánh giá khác. Chúng ta cũng có thể dùng trực quan hóa tích hợp của MLflow để tạo biểu đồ, đồ thị nhằm so sánh chi tiết hơn.
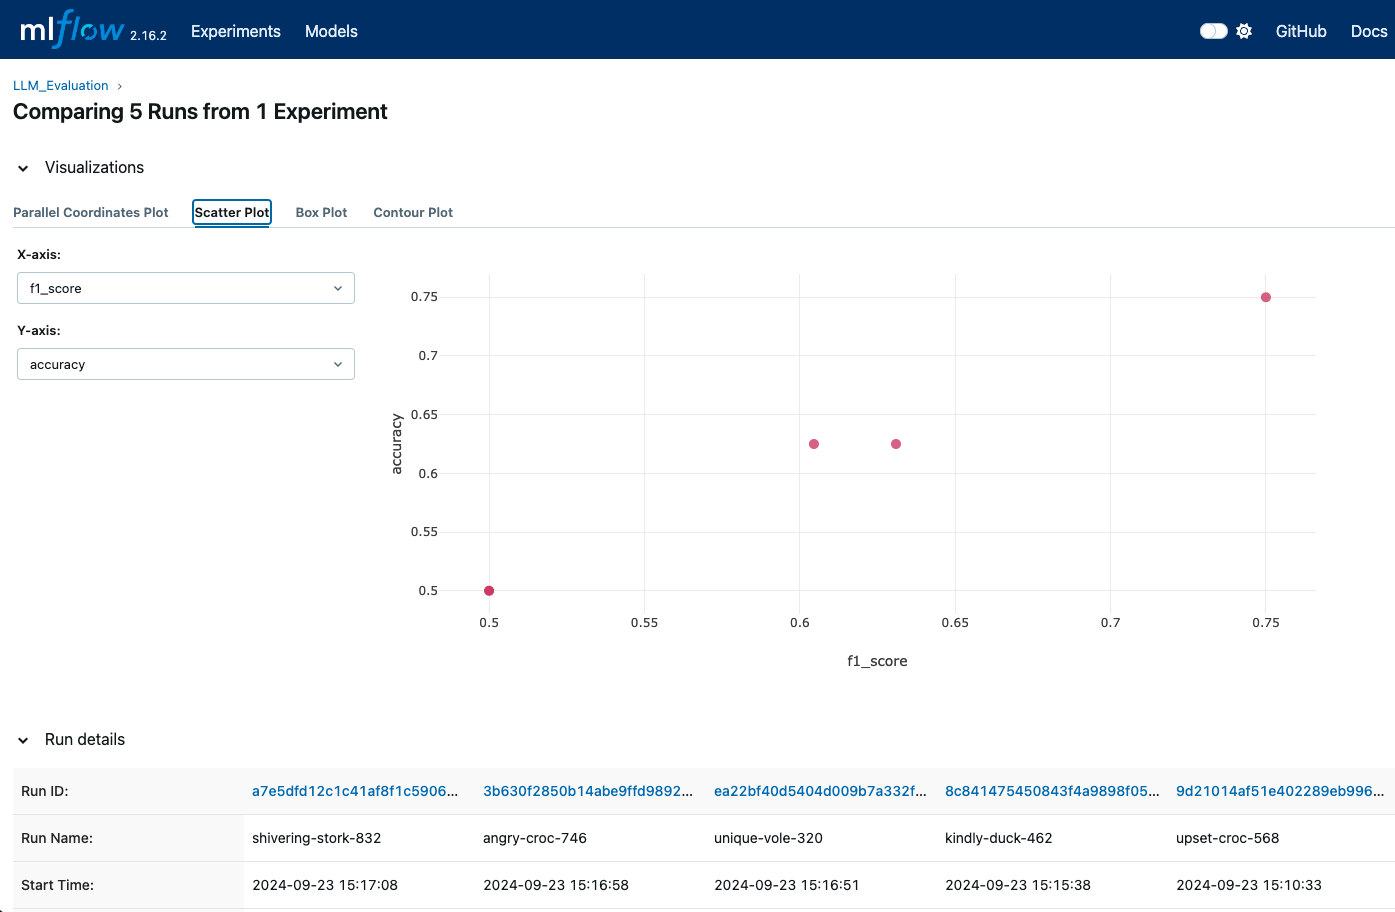
Các trực quan hóa của MLflow có thể cho thấy thời điểm các lần chạy được ghi log để so sánh các chỉ số—ảnh: Tác giả.
Giao diện MLflow cung cấp biểu đồ và log chi tiết cho từng lần chạy. Chúng ta có thể truy cập các log và trực quan hóa này để hiểu mô hình hoặc cấu hình nào hoạt động tốt nhất dựa trên các chỉ số đã ghi log.
Để có đánh giá LLM sâu và toàn diện hơn, MLflow cung cấp các kỹ thuật nâng cao giúp tăng cường theo dõi và phân tích. Chúng ta sẽ xem cách ghi log artifact mô hình để theo dõi kỹ lưỡng và tận dụng MLflow cho tối ưu siêu tham số nhằm tối ưu hiệu năng LLM.
Ghi log artifact mô hình rất quan trọng để lưu giữ và phân tích chi tiết thí nghiệm. Artifact có thể cung cấp bức tranh hoàn chỉnh về hiệu năng mô hình và hỗ trợ tái tạo kết quả.
Trong số các artifact có thể ghi log, gồm có:
joblib cho scikit-learn hoặc định dạng SavedModel của TensorFlow).Ví dụ như sau:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
       mlflow.log_artifact("generated_outputs.txt")
Tối ưu siêu tham số là phần quan trọng để tối ưu hiệu năng LLM. Trong thí nghiệm, chúng ta có thể dùng MLflow để ghi log các cấu hình siêu tham số khác nhau. Điều này cho phép so sánh tác động của các thiết lập và tìm cấu hình tối ưu.
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
Một lợi thế khác của MLflow là có thể dùng cùng với các thư viện tối ưu siêu tham số như Optuna hoặc Ray Tune để tự động hóa quá trình tinh chỉnh.
Đánh giá LLM chính xác không chỉ là chạy kiểm thử và ghi log chỉ số. Cần một cách tiếp cận có chiến lược để đảm bảo tính nhất quán, chính xác và hiệu quả. Áp dụng các thực tiễn tốt nhất có thể nâng cao độ tin cậy và hiệu quả của quá trình đánh giá.
Sử dụng các tập dữ liệu ổn định và đại diện là một trong những yếu tố đầu tiên góp phần cho đánh giá hiệu quả. Bằng cách đảm bảo tập dữ liệu đánh giá ổn định và đại diện cho tác vụ mà LLM được thiết kế để thực hiện, chúng ta sẽ có so sánh ý nghĩa theo thời gian và giữa các mô hình hay phiên bản khác nhau. Nếu tập dữ liệu thay đổi, sẽ khó quy kết thay đổi hiệu năng là do mô hình thay vì do chính tập dữ liệu.
Không chỉ tập dữ liệu mà cả cách chúng ta tiền xử lý cũng quan trọng. Chúng ta cần áp dụng cùng một bước tiền xử lý cho tất cả tập dữ liệu đánh giá để đảm bảo kết quả có thể so sánh. Điều này bao gồm tokenization, chuẩn hóa và xử lý trường hợp đặc biệt. Tiền xử lý nhất quán đảm bảo sự khác biệt hiệu năng không đến từ cách xử lý dữ liệu.
Như đã thấy ở trên, sử dụng kho đăng ký mô hình của MLflow để cho phép kiểm soát phiên bản giúp theo dõi các phiên bản LLM khác nhau. Điều này hỗ trợ so sánh hiệu năng mô hình và quay lại phiên bản trước khi cần. Nên ghi log tất cả chi tiết và theo dõi các thay đổi của mô hình, bao gồm chỉnh sửa kiến trúc, siêu tham số hoặc dữ liệu huấn luyện.
Cuối cùng, tự động hóa quá trình đánh giá bằng cách tích hợp vào pipeline tích hợp liên tục/triển khai liên tục (CI/CD) có thể giúp đảm bảo mô hình được đánh giá nhất quán và kịp thời khi có cập nhật. Nên thiết lập đánh giá theo lịch để định kỳ kiểm tra hiệu năng. Điều này giúp theo dõi drift mô hình và đảm bảo mô hình đáp ứng tiêu chuẩn hiệu năng theo thời gian.
Đánh giá LLM hiệu quả đòi hỏi một cách tiếp cận có cấu trúc và có hệ thống, và MLflow cung cấp một khung hỗ trợ quy trình này.
Trong hướng dẫn này, chúng ta đã cài đặt MLflow và thiết lập máy chủ theo dõi. Sau đó, đánh giá LLM bằng cách ghi log các chỉ số quan trọng, theo dõi nhiều lần chạy để so sánh và dùng giao diện MLflow để trực quan hóa, phân tích so sánh một cách hiệu quả.
Nếu bạn muốn nâng cao kiến thức MLflow, hãy xem khóa học Introduction to MLflow của chúng tôi!
Tìm hiểu thêm về LLM qua các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
