
कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
112K
लार्ज लैंग्वेज मॉडल्स (LLMs) मशीन लर्निंग मॉडल विकसित करते समय, खासकर प्राकृतिक भाषा संसाधन एल्गोरिद्म की क्षमताएँ बढ़ाने में, अत्यंत महत्वपूर्ण हो गए हैं। चैटबॉट्स से लेकर कंटेंट जनरेटर तक, ये मॉडल इस बात को बदल रहे हैं कि हम तकनीक के साथ कैसे इंटरैक्ट करते हैं।
हालाँकि, जैसे-जैसे LLM की उपस्थिति संख्या और जटिलता में बढ़ती है, उनके प्रदर्शन का मूल्यांकन और भी महत्वपूर्ण हो जाता है। उपयुक्त और सटीक मूल्यांकन के बिना, यह जानना कठिन है कि कोई मॉडल अपेक्षित रूप से काम कर रहा है या समायोजन की आवश्यकता है।
यहीं पर MLflow काम आता है। MLflow एक ओपन-सोर्स टूल है जिसे मशीन लर्निंग प्रयोगों के प्रबंधन को सरल बनाने के लिए डिज़ाइन किया गया है। यह हमें विभिन्न प्रयोगों के परिणामों को ट्रैक करने, मॉडलों को मैनेज करने और सब कुछ व्यवस्थित रखने में मदद करता है!
इस ट्यूटोरियल में, हम LLM वर्कफ़्लो को बेहतर बनाने में MLflow की भूमिका का पता लगाएंगे। मैं आपको इसकी सेटअप प्रक्रिया से लेकर LLM प्रयोगों में मेट्रिक्स लॉग करने और पैरामीटर ट्रैक करने तक समझाऊँगा। अंत में, हम देखेंगे कि MLflow प्रभावी मॉडल प्रबंधन और परिनियोजन में कैसे सहायता करता है।
MLflow एक ओपन-सोर्स प्लेटफ़ॉर्म है जो एंड-टू-एंड मशीन लर्निंग लाइफ़साइकल को मैनेज करने के लिए बनाया गया है। यह मशीन लर्निंग मॉडलों के विकास, ट्रैकिंग और परिनियोजन की प्रक्रिया को सुव्यवस्थित करने के लिए टूल प्रदान करता है।
चाहे हम किसी छोटे प्रोजेक्ट पर काम कर रहे हों या बड़े मॉडलों के साथ जटिल प्रयोगों का प्रबंधन कर रहे हों, MLflow हमें संगठित और कुशल बने रहने में मदद कर सकता है।
मशीन लर्निंग लाइफ़साइकल में MLflow उपयोग करने के कुछ फायदे निम्न हैं:
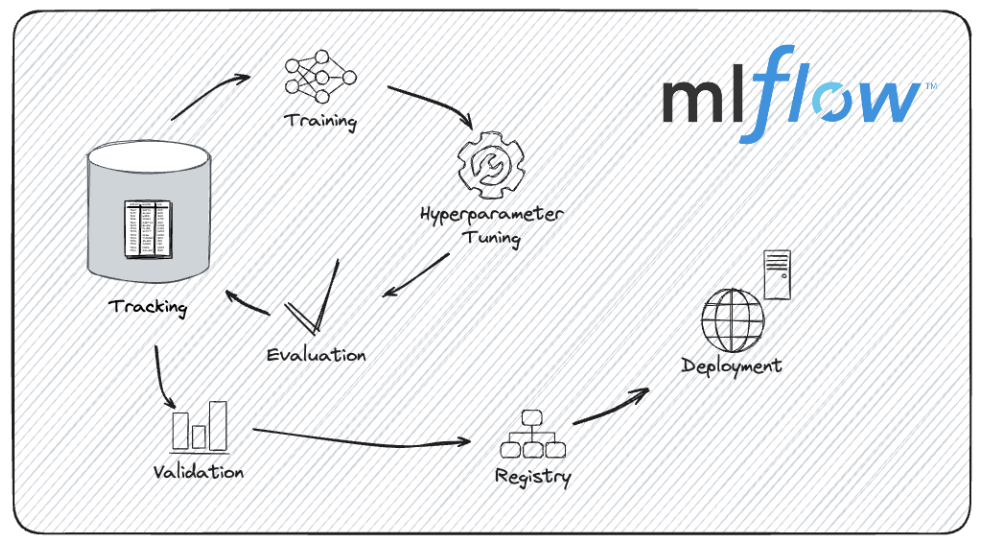
MLflow के साथ मॉडल विकास का लाइफ़साइकल। इमेज सोर्स: MLflow प्रलेखन।
MLflow को मशीन लर्निंग प्रोजेक्ट्स के प्रबंधन को अधिक सुगम और पारदर्शी बनाने के लिए डिज़ाइन किया गया है। यह विशेष रूप से LLM जैसे जटिल मॉडलों पर काम करते समय उपयोगी है, जैसा कि हम अब देखेंगे।
LLM मूल्यांकन के लिए MLflow का उपयोग करने के कई लाभ हैं, जैसे मॉडल संस्करणों को ट्रैक करना, मूल्यांकन मेट्रिक्स लॉग करना, और विभिन्न क्षेत्रों में प्रदर्शन की तुलना करना।
आइए इन लाभों को विस्तार से देखते हैं।
LLMs का विकास लगातार दोहराव और सुधारों में शामिल होता है। हर नया संस्करण छोटे-छोटे संवर्धन या व्यवहारिक बदलाव लाता है। MLflow मॉडल संस्करणों को व्यवस्थित ढंग से ट्रैक करके इन विभिन्न दोहरावों का प्रबंधन करता है। यह क्षमता हमें परिणामों को पुन: उत्पन्न करने, अलग-अलग संस्करणों की प्रभावी तुलना करने, और मॉडल इवोल्यूशन का स्पष्ट इतिहास बनाए रखने में सक्षम बनाती है।
मान लें कि हम अलग-अलग फाइन-ट्यूनिंग तकनीकों के साथ प्रयोग कर रहे हैं; MLflow हमें प्रत्येक संस्करण के परिणामों को मैनेज और रिव्यू करने में मदद कर सकता है, जिससे यह पहचानना आसान हो जाता है कि किस इटरेशन से सर्वश्रेष्ठ प्रदर्शन मिलता है।
क्योंकि MLflow यह सुनिश्चित करता है कि हर प्रयोग और उससे जुड़े परिणाम पूरी तरह लॉग किए गए हों, हम अपने निष्कर्षों को आत्मविश्वास से साझा कर सकते हैं, यह जानते हुए कि अन्य लोग हमारे परिणामों को ठीक-ठीक पुन: उत्पन्न कर सकते हैं।
यदि हमारा प्रोजेक्ट विभिन्न LLM आर्किटेक्चर या प्रशिक्षण पद्धतियों के साथ प्रयोग करने में शामिल है, तो MLflow की ट्रैकिंग क्षमताएँ हमारे काम का दस्तावेजीकरण और साझा करना आसान बना देंगी।
LLMs का मूल्यांकन कई मेट्रिक्स की निगरानी शामिल करता है, जैसे एक्यूरेसी, परप्लेक्सिटी और F1 स्कोर, आदि।
MLflow की लॉगिंग सुविधा हमें इन मेट्रिक्स को कुशलतापूर्वक और व्यवस्थित तरीके से रिकॉर्ड करने देती है। इन मेट्रिक्स का विश्लेषण करने से हमें हमारे मॉडल के प्रदर्शन की स्पष्ट तस्वीर मिलती है।
उदाहरण के लिए, हम तुलना करना चाह सकते हैं कि अलग-अलग हाइपरपैरामीटर्स या प्रशिक्षण डेटासेट मॉडल के प्रदर्शन मेट्रिक्स को कैसे प्रभावित करते हैं। MLflow के साथ, हम इन मेट्रिक्स को लॉग और विज़ुअलाइज़ कर सकते हैं ताकि कार्रवाई योग्य अंतर्दृष्टि निकाल सकें।
जैसे-जैसे मॉडल्स को परिनियोजित किया जाता है और वास्तविक दुनिया के अनुप्रयोगों में उपयोग किया जाता है, वे मॉडल ड्रिफ्ट का अनुभव कर सकते हैं, जहाँ डेटा या परिवेश में बदलाव के कारण उनका प्रदर्शन घटता है। हम समय के साथ मॉडल प्रदर्शन को ट्रैक करके MLflow का उपयोग मॉडल ड्रिफ्ट की निगरानी और प्रबंधन के लिए कर सकते हैं।
हम नियमित मूल्यांकन सेट कर सकते हैं और MLflow का उपयोग करके यह लॉग और विश्लेषण कर सकते हैं कि प्रदर्शन मेट्रिक्स कैसे बदलते हैं, ताकि वास्तविक समय में कार्रवाई योग्य निर्णय लिए जा सकें।
MLflow के सबसे महत्वपूर्ण फायदों में से एक इसकी व्यापक मॉडल तुलना को सरल बनाने की क्षमता है। अलग-अलग प्रयोगों के विस्तृत रिकॉर्ड स्टोर करके, MLflow हमें विभिन्न LLMs और हाइपरपैरामीटर कॉन्फ़िगरेशन के प्रदर्शन की साइड-बाय-साइड तुलना करने में सक्षम बनाता है।
सही हाइपरपैरामीटर्स खोजना LLMs विकसित करते समय मॉडल की सफलता निर्धारित कर सकता है।
कल्पना करें कि हम किसी LLM को फाइन-ट्यून कर रहे हैं और अलग-अलग हाइपरपैरामीटर सेटिंग्स के प्रभाव का मूल्यांकन करना चाहते हैं। MLflow का उपयोग करके, हम विभिन्न लर्निंग रेट्स, बैच साइज़ या ड्रॉपआउट रेट्स के परिणामों को लॉग और तुलना कर सकते हैं ताकि यह तय कर सकें कि कौन-सा कॉन्फ़िगरेशन सर्वश्रेष्ठ प्रदर्शन देता है, और इस तरह हमारे मॉडल विकास प्रक्रिया को अनुकूलित कर सकें।
MLflow की मॉडल रजिस्ट्री और ट्रैकिंग सुविधाएँ परिनियोजन के लिए कई LLMs का मूल्यांकन करते समय काम आती हैं।
मान लें कि हमारे पास भाषा मॉडल के कई संस्करण हैं जिन्हें हम प्रोडक्शन वातावरण के लिए विचार कर रहे हैं। MLflow हमें प्रत्येक मॉडल के प्रदर्शन मेट्रिक्स को लॉग करने, उनकी तुलना करने, और केवल अंतर्ज्ञान पर नहीं बल्कि अनुभवजन्य साक्ष्य के आधार पर सूचित निर्णय लेने में मदद कर सकता है।
अब जब हमें MLflow और उसके फायदों की स्पष्ट तस्वीर मिल गई है, तो चलिए व्यावहारिक बनते हैं!
MLflow के साथ LLMs का मूल्यांकन करने से पहले, हमें प्लेटफ़ॉर्म को ठीक से सेट करना होगा। इसमें MLflow इंस्टॉल करना, वैकल्पिक रूप से रिमोट लॉगिंग के लिए ट्रैकिंग सर्वर कॉन्फ़िगर करना, और यह सुनिश्चित करना शामिल है कि हमारा वातावरण प्रयोगों को मैनेज करने और परिणामों को ट्रैक करने के लिए तैयार हो।
आइए देखें कि यह कैसे करें।
1. सुनिश्चित करें कि Python इंस्टॉल है:
सबसे पहले, हमें यह सुनिश्चित करना होगा कि हमारे मशीन पर Python इंस्टॉल है। MLflow Python 3.6 और उससे ऊपर के संस्करणों के साथ संगत है (ध्यान दें कि Python 3.8 अब डिप्रिकेटेड है, इसलिए Python >= 3.9 का उपयोग करने की अनुशंसा की जाती है)। हम अपना Python संस्करण इस कमांड से जाँच सकते हैं:
python --version2. एक वर्चुअल वातावरण बनाएँ (वैकल्पिक लेकिन अनुशंसित):
MLflow के साथ प्रयोगों को ट्रैक करते समय वर्चुअल वातावरण का उपयोग करना अच्छा अभ्यास है, खासकर यदि हम Mac OS X पर काम कर रहे हैं। हम venv या virtualenv का उपयोग करके एक बना सकते हैं।
python -m venv mlflow-envहम वर्चुअल वातावरण को सक्रिय करते हैं:
Windows पर:
mlflow-env\Scripts\activateMac/Linux पर:
source mlflow-env/bin/activate3. pip के माध्यम से MLflow इंस्टॉल करें:
यदि वर्चुअल वातावरण सक्रिय है (यदि उपयोग किया गया है), तो हम pip के जरिए MLflow इंस्टॉल कर सकते हैं:
pip install mlflow4. अतिरिक्त निर्भरताएँ इंस्टॉल करें:
उन्नत कार्यक्षमता के लिए MLflow की कुछ वैकल्पिक निर्भरताएँ हैं। यदि हमें MLflow की सर्विंग क्षमताओं जैसी विशिष्ट सुविधाएँ चाहिए, तो हमें gunicorn इंस्टॉल करना होगा।
pip install gunicornयदि हम TensorFlow या PyTorch जैसी लाइब्रेरीज़ का उपयोग कर रहे हैं, तो हमें उनके संबंधित MLflow इंटीग्रेशंस इंस्टॉल करने की आवश्यकता हो सकती है:
pip install mlflow[extras]4. इंस्टॉलेशन सत्यापित करें:
इसके बाद हमें यह सुनिश्चित करना होगा कि MLflow सही ढंग से इंस्टॉल हो गया है, इसके संस्करण की जाँच करके:
mlflow --versionयदि हम सहयोगी वातावरण में काम कर रहे हैं या हमें रिमोट लॉगिंग करनी आवश्यक है, तो हमें एक MLflow ट्रैकिंग सर्वर सेट करना चाहिए। यह सुविधा हमारे प्रयोगों की ट्रैकिंग और प्रबंधन को केंद्रीकृत करने देती है।
1. ट्रैकिंग सर्वर चलाएँ:
हम बैकएंड स्टोर और आर्टिफैक्ट लोकेशन निर्दिष्ट करके MLflow सर्वर शुरू कर सकते हैं।
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri बताता है कि प्रयोग डेटा कहाँ संग्रहीत होगा। हम किसी भी डेटाबेस सिस्टम (PostgreSQL, MySQL, आदि) का उपयोग कर सकते हैं।--default-artifact-root उस डायरेक्टरी को निर्दिष्ट करता है जहाँ आर्टिफैक्ट्स, जैसे मॉडल फाइलें, संग्रहीत होते हैं।2. ट्रैकिंग सर्वर कॉन्फ़िगर करें:
हमें यह सुनिश्चित करना होगा कि हमारे MLflow क्लाइंट्स ट्रैकिंग सर्वर में लॉग करने के लिए कॉन्फ़िगर हों। हम MLFLOW_TRACKING_URI परिवेश वेरिएबल को अपने सर्वर की ओर इंगित कर सकते हैं।
export MLFLOW_TRACKING_URI=http://localhost:50003. ट्रैकिंग UI तक पहुँचें:
अब हम ब्राउज़र खोलकर http://localhost:5000 पर जा सकते हैं और MLflow UI तक पहुँच सकते हैं। यह इंटरफ़ेस हमें प्रयोगों को देखने, परिणामों की तुलना करने और बाद में देखेंगे कि कैसे अपने MLflow प्रोजेक्ट्स को मैनेज करने देता है।
MLflow सेट और तैयार होने के साथ, अब समय है LLMs को लोड और मूल्यांकन करने जैसे मुख्य कार्यों में उतरने का। आइए देखें कि हम किसी प्री-ट्रेन्ड LLM का चयन कैसे कर सकते हैं, अलग-अलग लाइब्रेरीज़ का उपयोग करके उसे कैसे लोड करें, और मॉडल के प्रदर्शन को मापने के लिए एक मूल्यांकन डेटासेट कैसे तैयार करें।
किसी प्री-ट्रेन्ड LLM का चयन करते समय, Hugging Face Transformers जैसी लाइब्रेरीज़ कई विकल्प प्रदान करती हैं। उदाहरण के लिए, हम GPT (टेक्स्ट जनरेशन के लिए) या BERT (टेक्स्ट वर्गीकरण और अन्य कार्यों के लिए) जैसे प्री-ट्रेन्ड मॉडल लोड कर सकते हैं।
1. Hugging Face Transformers इंस्टॉल करें
सबसे पहले, हम सुनिश्चित करेंगे कि Hugging Face Transformers लाइब्रेरी इंस्टॉल है। हम यह pip का उपयोग करके कर सकते हैं।
pip install transformers2. प्री-ट्रेन्ड मॉडल और टोकनाइज़र लोड करें
अब हम transformers लाइब्रेरी का उपयोग करके BERT मॉडल लोड करेंगे, जिसमें मॉडल और टोकनाइज़र दोनों शामिल होंगे, जो टेक्स्ट को प्रोसेस करने और प्रेडिक्शन जनरेट करने के लिए आवश्यक हैं।
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
मॉडल bert-base-uncased तब उपयोग किया जाता है जब वह टेक्स्ट डेटा जिससे हम काम कर रहे हैं, ज़्यादातर छोटे-बड़े अक्षरों में होता है, लेकिन हमें मॉडल से बड़े और छोटे अक्षरों के बीच भेद करने की आवश्यकता नहीं होती।
किसी LLM का मूल्यांकन करने के लिए, हमें ऐसा उपयुक्त डेटासेट चाहिए जो उस कार्य से मेल खाता हो जिसका हम आकलन कर रहे हैं। आइए सेंटिमेंट एनालिसिस के लिए एक टेक्स्ट-आधारित मूल्यांकन डेटासेट तैयार करने का तरीका देखें:
1. डेटासेट लोड/बनाएँ और प्रीप्रोसेस करें
हमारा डेटा कई जगह संग्रहीत हो सकता है: हमारी लोकल मशीन के डिस्क पर, किसी Github रिपॉजिटरी में, या Hugging Face Hub पर—जो कि समुदाय-संक्रमित और लोकप्रिय शोध डेटासेट्स का बड़ा संग्रह है।
इस ट्यूटोरियल के लिए, हम सेंटिमेंट विश्लेषण के लिए एक बड़ा मूवी रिव्यू डेटासेट उपयोग करेंगे, जिसे IMDB कहा जाता है। हम प्री-बिल्ट डेटासेट लोड करने के लिए datasets लाइब्रेरी का उपयोग करेंगे:
डेटासेट लाइब्रेरी इंस्टॉल करना:
pip install datasetsडेटासेट लोड करना:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. सेंटिमेंट विश्लेषण के लिए प्रीप्रोसेसिंग
हम सेंटिमेंट विश्लेषण के लिए डेटासेट को प्रीप्रोसेस करने हेतु पहले से लोड किए गए BERT टोकनाइज़र का उपयोग करेंगे।
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)अब जबकि हमारे LLMs लोड हो चुके हैं और हमारा मूल्यांकन डेटासेट तैयार है, अब समय है मूल्यांकन चलाने और मेट्रिक्स लॉग करने का।
1. MLflow इम्पोर्ट करें और नया प्रयोग शुरू करें
MLflow के साथ प्रयोगों को ट्रैक करने के लिए, पहले हमें एक नया प्रयोग शुरू करना होगा और संबंधित मेटाडेटा जैसे मॉडल नाम, संस्करण और मूल्यांकन पैरामीटर लॉग करने होंगे।
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. मूल्यांकन पैरामीटर लॉग करें
अब हम मूल्यांकन प्रक्रिया से संबंधित कोई भी पैरामीटर लॉग कर सकते हैं, जैसे मूल्यांकन डेटासेट का आकार या मूल्यांकन के दौरान उपयोग की गई विशिष्ट कॉन्फ़िगरेशन।
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))एक बार जब हमने अपने मॉडल का प्रशिक्षण कर लिया और संबंधित प्रेडिक्शंस बना लिए, तो हम LLM का मूल्यांकन कर सकते हैं और विभिन्न मेट्रिक्स लॉग कर सकते हैं जो उसके प्रदर्शन को दर्शाते हैं।
सेंटिमेंट विश्लेषण एक वर्गीकरण समस्या है, इसलिए हम अपने मॉडल का मूल्यांकन एक्यूरेसी और F1 स्कोर जैसे मेट्रिक्स से कर सकते हैं। टेक्स्ट जनरेशन कार्यों के लिए, BLEU स्कोर या परप्लेक्सिटी जैसे मेट्रिक्स आमतौर पर उपयोग किए जाते हैं।
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)एक बार जब कई मूल्यांकन रन MLflow के साथ ट्रैक हो जाते हैं, तो सर्वश्रेष्ठ प्रदर्शन करने वाले मॉडलों और कॉन्फ़िगरेशन का निर्धारण करने के लिए उनकी तुलना करना आवश्यक हो जाता है।
आइए समझें कि कई रन कैसे ट्रैक करें और परिणामों को प्रभावी ढंग से विज़ुअलाइज़ और तुलना करने के लिए MLflow के UI का उपयोग कैसे करें।
सबसे पहले, हमें समान प्रयोग के भीतर या अलग-अलग प्रयोगों में कई रन ट्रैक करने होंगे ताकि अलग-अलग LLM संस्करणों के प्रदर्शन की तुलना की जा सके।
1. कई रन लॉग करें
हम जिस भी मॉडल या कॉन्फ़िगरेशन का मूल्यांकन करना चाहते हैं, उसके लिए नए रन शुरू करके एक ही प्रयोग के अंतर्गत कई रन लॉग कर सकते हैं।
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. अलग-अलग मॉडलों के साथ प्रयोग ट्रैक करें
मान लें कि हम विभिन्न प्रकार के मॉडलों का मूल्यांकन करना चाहते हैं। इस उद्देश्य के लिए, हम MLflow का उपयोग करके एक प्रयोग बना सकते हैं और मॉडलों को साथ में लॉग कर सकते हैं।
MLflow में मॉडल लॉगिंग करना मशीन लर्निंग मॉडलों के लिए वर्ज़न कंट्रोल करने जैसा है। मॉडल और वातावरण के विवरण रिकॉर्ड करना पुनरुत्पादकता की गारंटी देता है।
पहले, हम एक प्रयोग सेट करेंगे। फिर, हम प्रत्येक मॉडल को एक अलग MLflow रन में लॉग करेंगे, जिसमें रन IDs और आर्टिफैक्ट पाथ शामिल होंगे।
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
अब हम मॉडलों का मूल्यांकन कर सकते हैं और परिणाम लॉग कर सकते हैं। MLflow एक API mlflow.evaluate() प्रदान करता है, जो हमारे LLMs का मूल्यांकन करने में मदद करता है।
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)अलग-अलग मेट्रिक्स और मॉडलों को MLflow में लॉग करने के बाद, हम तुलना कर सकते हैं। हम MLflow के उपयोगकर्ता-अनुकूल इंटरफ़ेस का उपयोग करके अलग-अलग रन के मूल्यांकन मेट्रिक्स को विज़ुअलाइज़ और तुलना कर सकते हैं। ऐसा करने के लिए, यदि MLflow सर्वर पहले से नहीं चल रहा है, तो हमें उसे शुरू करना होगा
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsइसके बाद हम ब्राउज़र खोलकर http://localhost:5000 पर जाते हैं और MLflow UI तक पहुँचते हैं। MLflow UI में, हम "Experiments" पेज पर जाकर अपने सभी प्रयोग देखते हैं। संबंधित रन की सूची देखने के लिए हम प्रयोग के नाम पर क्लिक करते हैं।
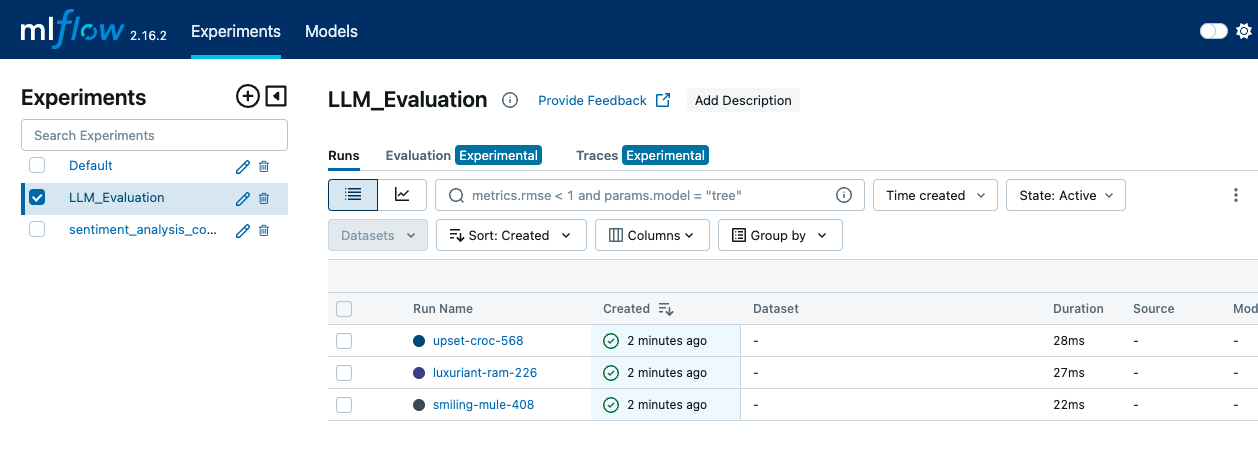
MLflow इंटरफ़ेस में Experiments टैब दिखता है, जहाँ अलग-अलग रन और लॉग ईवेंट देखे जा सकते हैं—चित्र लेखक द्वारा।
किसी प्रयोग के भीतर, हम कई रन का चयन करके और उनके मेट्रिक्स को साथ-साथ देखकर उनकी तुलना कर सकते हैं।
UI हमें एक्यूरेसी, F1 स्कोर और अन्य मूल्यांकन मेट्रिक्स का विज़ुअल प्रतिनिधित्व दिखाता है। हम MLflow की बिल्ट-इन विज़ुअलाइज़ेशंस का उपयोग अधिक विस्तृत तुलना के लिए प्लॉट्स और ग्राफ़ बनाने में भी कर सकते हैं।
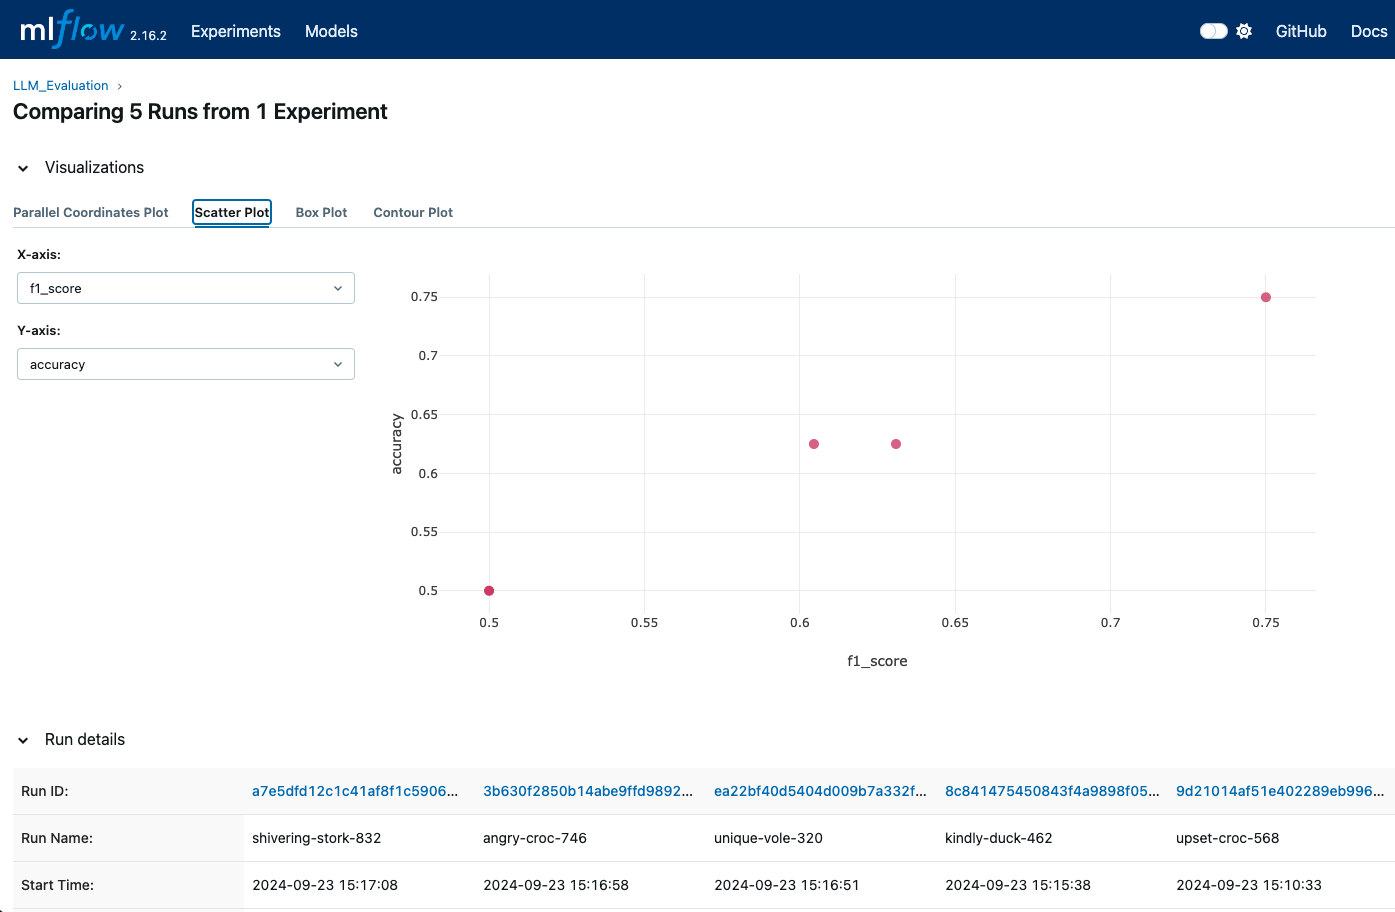
MLflow विज़ुअलाइज़ेशन हमें दिखा सकते हैं कि अलग-अलग रन कब लॉग हुए ताकि हम विभिन्न मेट्रिक्स की तुलना कर सकें—चित्र लेखक द्वारा।
MLflow UI प्रत्येक रन के लिए विस्तृत चार्ट और लॉग प्रदान करता है। हम इन लॉग्स और विज़ुअलाइज़ेशंस तक पहुँचकर यह समझ सकते हैं कि लॉग किए गए मेट्रिक्स के आधार पर कौन-सा मॉडल या कॉन्फ़िगरेशन बेहतर प्रदर्शन करता है।
LLMs के गहन और व्यापक मूल्यांकन के लिए, MLflow उन्नत तकनीकें प्रदान करता है जो ट्रैकिंग और विश्लेषण को बेहतर बनाती हैं। हम यह समीक्षा करेंगे कि समग्र ट्रैकिंग के लिए मॉडल आर्टिफैक्ट्स को कैसे लॉग करें और हाइपरपैरामीटर ट्यूनिंग के लिए MLflow का उपयोग कर LLM प्रदर्शन को कैसे अनुकूलित करें।
हमारे प्रयोगों के विवरणों को संरक्षित और विश्लेषित करने के लिए मॉडल आर्टिफैक्ट्स लॉग करना बहुत महत्वपूर्ण है। आर्टिफैक्ट्स हमारे मॉडल के प्रदर्शन की पूरी तस्वीर प्रदान कर सकते हैं और परिणामों को पुन: उत्पन्न करने में मदद करते हैं।
जिन आर्टिफैक्ट्स को हम लॉग कर सकते हैं, उनमें शामिल हैं:
joblib या TensorFlow के SavedModel फ़ॉर्मेट) का उपयोग करके मॉडल वेट्स को सेव और लॉग कर सकते हैं।यहाँ एक उदाहरण है:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
mlflow.log_artifact("generated_outputs.txt")हाइपरपैरामीटर ट्यूनिंग LLM के प्रदर्शन को अनुकूलित करने का एक प्रमुख हिस्सा है। अपने प्रयोगों में, हम MLflow का उपयोग विभिन्न हाइपरपैरामीटर कॉन्फ़िगरेशन लॉग करने के लिए कर सकते हैं। इससे हमें अलग-अलग सेटिंग्स के प्रभावों की तुलना करने और सर्वोत्तम कॉन्फ़िगरेशन खोजने में मदद मिलती है।
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
MLflow का एक और लाभ यह है कि इसे Optuna या Ray Tune जैसी हाइपरपैरामीटर ऑप्टिमाइज़ेशन लाइब्रेरीज़ के साथ उपयोग किया जा सकता है, जिससे ट्यूनिंग प्रक्रिया स्वचालित हो जाती है।
LLMs का सटीक मूल्यांकन केवल परीक्षण चलाने और मेट्रिक्स लॉग करने से अधिक होता है। इसके लिए एक रणनीतिक दृष्टिकोण चाहिए ताकि स्थिरता, सटीकता और दक्षता सुनिश्चित हो सके। सर्वोत्तम प्रथाएँ अपनाने से मूल्यांकन प्रक्रिया की विश्वसनीयता और प्रभावशीलता बढ़ती है।
स्थिर और प्रतिनिधि डेटासेट का उपयोग करना प्रभावी मूल्यांकन में योगदान देने वाली पहली चीज़ों में से एक है। यह सुनिश्चित करके कि हमारे मूल्यांकन डेटासेट स्थिर हैं और उन कार्यों का प्रतिनिधित्व करते हैं जिनके लिए हमारा LLM डिज़ाइन किया गया है, हमें समय के साथ और अलग-अलग मॉडलों या संस्करणों में सार्थक तुलना मिलती है। यदि डेटासेट बदलता है, तो प्रदर्शन में बदलाव को मॉडल की बजाय स्वयं डेटासेट को सौंपना कठिन हो सकता है।
केवल डेटासेट ही नहीं, बल्कि हम उसे कैसे प्रीप्रोसेस करते हैं यह भी महत्वपूर्ण है। हमें सभी मूल्यांकन डेटासेट्स पर समान प्रीप्रोसेसिंग स्टेप्स लागू करने चाहिए ताकि परिणाम तुलनीय हों। इसमें टोकनाइज़ेशन, नॉर्मलाइज़ेशन और विशेष मामलों का हैंडलिंग शामिल है। सुसंगत प्रीप्रोसेसिंग यह सुनिश्चित करती है कि मॉडल प्रदर्शन में भिन्नताएँ डेटा हैंडलिंग के अंतर के कारण न हों।
जैसा कि ऊपर देखा गया, MLflow की मॉडल रजिस्ट्री का उपयोग करके वर्ज़न कंट्रोल करने से हमें अपने LLMs के विभिन्न संस्करणों को ट्रैक करने में मदद मिलती है। यह मॉडल प्रदर्शन की तुलना को सुगम बनाता है और आवश्यकता पड़ने पर पिछले संस्करणों पर वापस लौटना आसान करता है। हमें सभी विवरण लॉग करने चाहिए और मॉडलों में किए गए बदलावों का ट्रैक रखना चाहिए, जिनमें आर्किटेक्चर, हाइपरपैरामीटर्स या प्रशिक्षण डेटा में संशोधन शामिल हैं।
अंत में, मूल्यांकन प्रक्रिया को सतत इंटीग्रेशन/सतत परिनियोजन (CI/CD) पाइपलाइंस में एकीकृत करके स्वचालित करना हमें यह सुनिश्चित करने में मदद करता है कि जब भी अपडेट किए जाएँ, मॉडलों का सुसंगत और समय पर मूल्यांकन हो। हमें अनुसूचित मूल्यांकन सेट करने चाहिए ताकि समय-समय पर मॉडल प्रदर्शन का आकलन किया जा सके। यह मॉडल ड्रिफ्ट की निगरानी में मदद करता है और सुनिश्चित करता है कि मॉडल समय के साथ प्रदर्शन मानकों को पूरा करते रहें।
LLMs का प्रभावी मूल्यांकन एक संरचित और व्यवस्थित दृष्टिकोण की आवश्यकता रखता है, और MLflow इस प्रक्रिया का समर्थन करने के लिए एक ढाँचा प्रदान करता है।
इस ट्यूटोरियल में, हमने MLflow इंस्टॉल किया और एक ट्रैकिंग सर्वर सेट किया। फिर, हमने अपने LLM का मूल्यांकन महत्वपूर्ण मेट्रिक्स लॉग करके किया, कई रन ट्रैक किए ताकि उनकी तुलना की जा सके, और इन तुलनाओं को प्रभावी ढंग से विज़ुअलाइज़ और विश्लेषित करने के लिए MLflow के UI का उपयोग किया।
यदि आप अपनी MLflow जानकारी को अगले स्तर पर ले जाना चाहते हैं, तो हमारा Introduction to MLflow कोर्स देखें!
इन कोर्सेस के साथ LLMs के बारे में और जानें!
कोर्स
कोर्स
कोर्स