
Cursus
Concepten van Large Language Models (LLMs)
2 uur
112K
Large Language Models (LLM’s) zijn heel belangrijk geworden bij het ontwikkelen van machinelearningmodellen en versterken vooral de mogelijkheden van natural language processing-algoritmen. Van chatbots tot contentgeneratie: deze modellen veranderen hoe we met technologie omgaan.
Maar naarmate het aantal en de complexiteit van LLM’s toenemen, wordt het steeds belangrijker om hun prestaties te evalueren. Zonder een geschikte en nauwkeurige evaluatie is het lastig om te weten of een model werkt zoals verwacht of dat er aanpassingen nodig zijn.
Daar komt MLflow om de hoek kijken. MLflow is een open-sourcetool die is ontworpen om het beheer van machinelearningexperimenten te faciliteren. Het helpt ons de resultaten van verschillende experimenten bij te houden, modellen te beheren en alles georganiseerd te houden!
In deze tutorial verkennen we de rol van MLflow bij het verbeteren van LLM-workflows. Ik laat je zien hoe je het instelt en hoe je metrics logt en parameters volgt in LLM-experimenten. Tot slot bekijken we hoe MLflow effectief modelbeheer en -deployments ondersteunt.
MLflow is een open-sourceplatform dat is ontworpen om de end-to-end-levenscyclus van machine learning te beheren. Het biedt tools om het ontwikkelen, volgen en deployen van machinelearningmodellen te stroomlijnen.
Of we nu aan een klein project werken of complexe experimenten met grote modellen beheren, MLflow kan ons helpen georganiseerd en efficiënt te blijven.
Enkele voordelen van MLflow in de machinelearning-levenscyclus zijn:
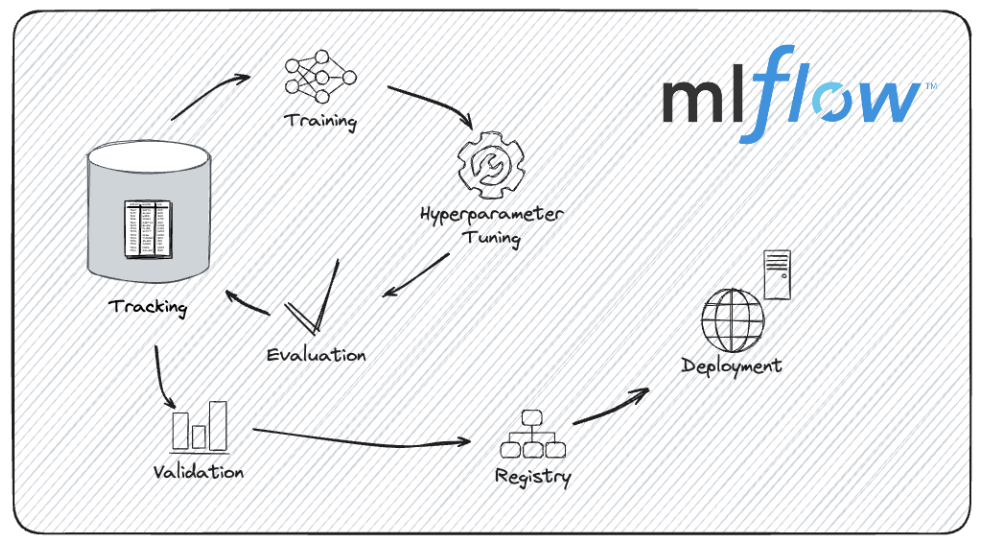
De levenscyclus van modelontwikkeling met MLflow. Beeldbron: MLflow-documentatie.
MLflow is ontworpen om het beheer van machinelearningprojecten soepeler en transparanter te maken. Dat is vooral handig bij complexe modellen zoals LLM’s, zoals we nu zullen zien.
MLflow gebruiken voor LLM-evaluatie heeft verschillende voordelen, zoals het bijhouden van modelversies, het loggen van evaluatiemetrics en het vergelijken van prestaties over velden heen.
Laten we deze voordelen in meer detail bekijken.
De ontwikkeling van LLM’s omvat frequente iteraties en verbeteringen. Elke nieuwe versie brengt kleine verbeteringen of gedragsveranderingen met zich mee. MLflow beheert deze iteraties door modelversies systematisch bij te houden. Zo kunnen we resultaten reproduceren, versies effectief vergelijken en een duidelijk geschiedenisoverzicht van de modelontwikkeling behouden.
Stel dat we experimenteren met verschillende fine-tuningtechnieken; MLflow helpt ons de uitkomsten van elke versie te beheren en te bekijken, zodat we makkelijker zien welke iteratie het beste presteert.
Omdat MLflow garandeert dat elk experiment en de bijbehorende resultaten volledig worden gelogd, kunnen we onze bevindingen met vertrouwen delen, wetende dat anderen onze resultaten exact kunnen reproduceren.
Als ons project experimenten met verschillende LLM-architecturen of trainingsmethodes omvat, maken de trackingmogelijkheden van MLflow het documenteren en delen van ons werk eenvoudiger.
Het evalueren van LLM’s omvat meerdere metrics, zoals nauwkeurigheid (accuracy), perplexity en F1-score, en meer.
Met de logfunctionaliteit van MLflow kunnen we deze metrics efficiënt en geordend vastleggen. Door deze metrics te analyseren, krijgen we een goed beeld van de modelprestaties.
We willen bijvoorbeeld vergelijken hoe verschillende hyperparameters of trainingsdatasets de prestatiemetrics van het model beïnvloeden. Met MLflow kunnen we deze metrics loggen en visualiseren om tot bruikbare inzichten te komen.
Wanneer modellen worden gedeployed en in echte toepassingen gebruikt, kunnen ze te maken krijgen met modeldrift, waarbij prestaties achteruitgaan door veranderingen in data of omgeving. We kunnen MLflow inzetten om modeldrift te monitoren en te beheren door prestaties in de tijd bij te houden.
We kunnen regelmatige evaluaties inrichten en MLflow gebruiken om te loggen en te analyseren hoe metrics veranderen, zodat we realtime, onderbouwde beslissingen kunnen nemen.
Een van de belangrijkste voordelen van MLflow is dat het uitgebreide modelvergelijkingen eenvoudig maakt. Door gedetailleerde gegevens van verschillende experimenten op te slaan, kunnen we de prestaties van diverse LLM’s en hyperparameterconfiguraties naast elkaar vergelijken.
De juiste hyperparameters vinden kan het succes van een model bepalen bij het ontwikkelen van LLM’s.
Stel dat we een LLM fine-tunen en de impact van verschillende hyperparameters willen evalueren. Met MLflow kunnen we resultaten loggen en vergelijken voor verschillende learning rates, batchgroottes of dropoutpercentages om te bepalen welke configuratie het beste presteert en zo ons ontwikkelproces optimaliseren.
De model registry en trackingfunctionaliteit van MLflow komen van pas als we meerdere LLM’s voor productie willen evalueren.
Stel dat we meerdere versies van een taalmodel hebben die we overwegen voor productie. MLflow helpt ons de metrics van elk model te loggen, ze te vergelijken en een weloverwogen beslissing te nemen op basis van empirisch bewijs in plaats van enkel intuïtie.
Nu we een beter beeld hebben van MLflow en de voordelen, gaan we aan de slag!
Voordat we LLM’s met MLflow evalueren, moeten we het platform goed instellen. Dit houdt onder meer in: MLflow installeren, optioneel een trackingserver configureren voor remote logging, en zorgen dat onze omgeving klaar is voor het beheren van experimenten en het volgen van resultaten.
Laten we zien hoe je dat doet.
1. Zorg dat Python is geïnstalleerd:
We moeten eerst controleren of Python op onze machine staat. MLflow is compatibel met Python 3.6 en hoger (let op: Python 3.8 is nu verouderd, dus Python >= 3.9 wordt aanbevolen). We kunnen onze Python-versie checken met:
python --version2. Maak een virtuele omgeving (optioneel maar aanbevolen):
Het is een goede gewoonte om een virtuele omgeving te gebruiken bij het tracken van experimenten met MLflow, zeker op macOS. We kunnen er een maken met venv of virtualenv.
python -m venv mlflow-envWe activeren de virtuele omgeving:
Op Windows:
mlflow-env\Scripts\activateOp Mac/Linux:
source mlflow-env/bin/activate3. Installeer MLflow met pip:
Met de virtuele omgeving geactiveerd (indien gebruikt) kunnen we MLflow installeren via pip:
pip install mlflow4. Installeer aanvullende dependencies:
MLflow heeft enkele optionele dependencies voor extra functionaliteit. Als we specifieke features nodig hebben, zoals de serveermogelijkheden van MLflow-modellen, moeten we gunicorn installeren.
pip install gunicornAls we bibliotheken zoals TensorFlow of PyTorch gebruiken, moeten we mogelijk hun respectieve MLflow-integraties installeren:
pip install mlflow[extras]4. Verifieer de installatie:
Controleer vervolgens of MLflow correct is geïnstalleerd door de versie op te vragen:
mlflow --versionAls we in een samenwerking werken of remote logging nodig hebben, moeten we een MLflow-trackingserver opzetten. Deze feature stelt ons in staat om het tracken en beheren van experimenten te centraliseren.
1. Start de trackingserver:
We kunnen de MLflow-server starten door de backend store en de artifactlocatie te specificeren.
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri specificeert waar de experimentdata wordt opgeslagen. We kunnen elk databasesysteem gebruiken (PostgreSQL, MySQL, enz.).--default-artifact-root geeft de map aan waar artifacts, bijv. modelfiles, worden opgeslagen.2. Configureer de trackingserver:
We moeten zorgen dat onze MLflow-clients zijn geconfigureerd om naar de trackingserver te loggen. We kunnen de omgevingsvariabele MLFLOW_TRACKING_URI instellen om naar onze server te verwijzen.
export MLFLOW_TRACKING_URI=http://localhost:50003. Open de tracking-UI:
Nu kunnen we een webbrowser openen en navigeren naar http://localhost:5000 om de MLflow-UI te bereiken. In deze interface kunnen we experimenten bekijken, resultaten vergelijken en je MLflow-projecten beheren, zoals we later zullen zien.
Met MLflow ingesteld is het tijd voor de kerntaken: LLM’s laden en evalueren. Laten we bekijken hoe we een vooraf getrainde LLM kiezen, laden met verschillende bibliotheken en een evaluatiedataset voorbereiden om de prestaties van het model te meten.
Bij het selecteren van een vooraf getrainde LLM bieden bibliotheken zoals Hugging Face Transformers veel opties. Zo kunnen we een vooraf getraind model laden, zoals GPT (voor tekstgeneratie) of BERT (voor tekstclassificatie en andere taken).
1. Hugging Face Transformers installeren
We zorgen eerst dat de Hugging Face Transformers-bibliotheek is geïnstalleerd. Dat doen we met pip.
pip install transformers2. Een vooraf getraind model en tokenizer laden
Nu laden we het BERT-model met de transformers-bibliotheek, inclusief zowel het model als de tokenizer, die nodig zijn om tekst te verwerken en voorspellingen te genereren.
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
Het model bert-base-uncased gebruik je wanneer de tekstdata hoofdzakelijk uit kleine en hoofdletters bestaat, maar je niet wilt dat het model onderscheid maakt tussen hoofd- en kleine letters.
Om een LLM te evalueren, hebben we een geschikte dataset nodig die past bij de taak die we beoordelen. Laten we zien hoe we een tekstreeks evaluatiedataset voor sentimentanalyse voorbereiden:
1. De dataset laden of maken en preprocessen
Onze data kan op meerdere plekken staan: op de lokale schijf, in een GitHub-repository of op de Hugging Face Hub, een uitgebreide verzameling community-gecurateerde en populaire onderzoeksdatasets.
Voor deze tutorial gebruiken we een grote dataset met filmrecensies voor sentimentanalyse: IMDB. We gebruiken de datasets-bibliotheek om de kant-en-klare dataset te laden:
De datasetsbibliotheek installeren:
pip install datasetsEen dataset laden:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. Preprocessing voor sentimentanalyse
We gebruiken de eerder geladen BERT-tokenizer om de dataset voor sentimentanalyse te preprocessen.
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)Nu onze LLM’s zijn geladen en de evaluatiedataset is voorbereid, is het tijd om evaluaties uit te voeren en metrics te loggen.
1. MLflow importeren en een nieuw experiment starten
Om experimenten met MLflow te tracken, moeten we eerst een nieuw experiment starten en relevante metadata loggen, zoals modelnaam, versie en evaluatieparameters.
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. Evaluatieparameters loggen
We kunnen nu parameters loggen die betrekking hebben op het evaluatieproces, zoals de grootte van de evaluatiedataset of specifieke configuraties die tijdens de evaluatie zijn gebruikt.
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))Zodra we het model hebben getraind en de bijbehorende voorspellingen hebben gemaakt, kunnen we de LLM evalueren en diverse metrics loggen die de prestaties weerspiegelen.
Sentimentanalyse is een classificatieprobleem, dus we kunnen ons model evalueren met metrics zoals accuracy en F1-score. Voor tekstgeneratie worden vaak metrics zoals BLEU-score of perplexity gebruikt.
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)Als meerdere evaluatieruns met MLflow zijn getrackt, is het vergelijken van hun prestaties essentieel om de best presterende modellen en configuraties te bepalen.
Laten we bekijken hoe we meerdere runs tracken en de MLflow-UI gebruiken om resultaten effectief te visualiseren en te vergelijken.
We moeten eerst meerdere runs binnen hetzelfde experiment of over verschillende experimenten tracken om de prestaties van verschillende LLM-versies te vergelijken.
1. Meerdere runs loggen
We kunnen meerdere runs onder één experiment loggen door voor elk model of elke configuratie die we willen evalueren een nieuwe run te starten.
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. Experimenten met verschillende modellen tracken
Stel dat we verschillende typen modellen willen evalueren. Dan kunnen we MLflow gebruiken om een experiment te maken en de modellen samen te loggen.
Modellogging in MLflow uitvoeren is vergelijkbaar met versiebeheer voor machinelearningmodellen. Het vastleggen van model- en omgevingsdetails garandeert reproduceerbaarheid.
Eerst zetten we een experiment op. Vervolgens loggen we elk model in een aparte MLflow-run, inclusief de run-ID’s en artifactpaden.
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
Nu kunnen we de modellen evalueren en de resultaten loggen. MLflow biedt een API, mlflow.evaluate(), om onze LLM’s te helpen evalueren.
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)Nadat we de verschillende metrics en modellen in MLflow hebben gelogd, kunnen we een vergelijking maken. We kunnen de gebruiksvriendelijke interface van MLflow gebruiken om evaluatiemetrics van verschillende runs te visualiseren en te vergelijken. Om dat te doen, moeten we de MLflow-server starten als die nog niet draait
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsWe openen vervolgens een webbrowser en navigeren naar http://localhost:5000 om de MLflow-UI te bereiken. In de MLflow-UI gaan we naar de pagina "Experiments" om al onze experimenten te bekijken. Klik op de naam van het experiment om de lijst met bijbehorende runs te zien.
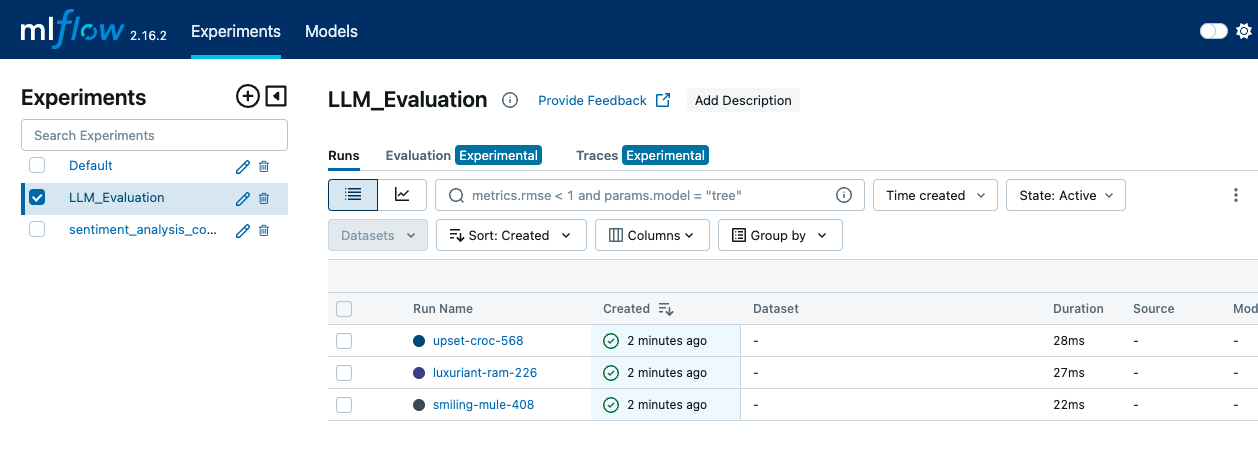
De MLflow-interface toont het tabblad Experiments, waar de verschillende runs en logevents te zien zijn—afbeelding door de auteur.
Binnen een experiment kunnen we verschillende runs vergelijken door meerdere runs te selecteren en hun metrics naast elkaar te bekijken.
De UI biedt een visuele weergave van metrics zoals accuracy, F1-score en andere evaluatiemetrics. We kunnen ook de ingebouwde visualisaties van MLflow gebruiken om grafieken te genereren voor meer gedetailleerde vergelijkingen.
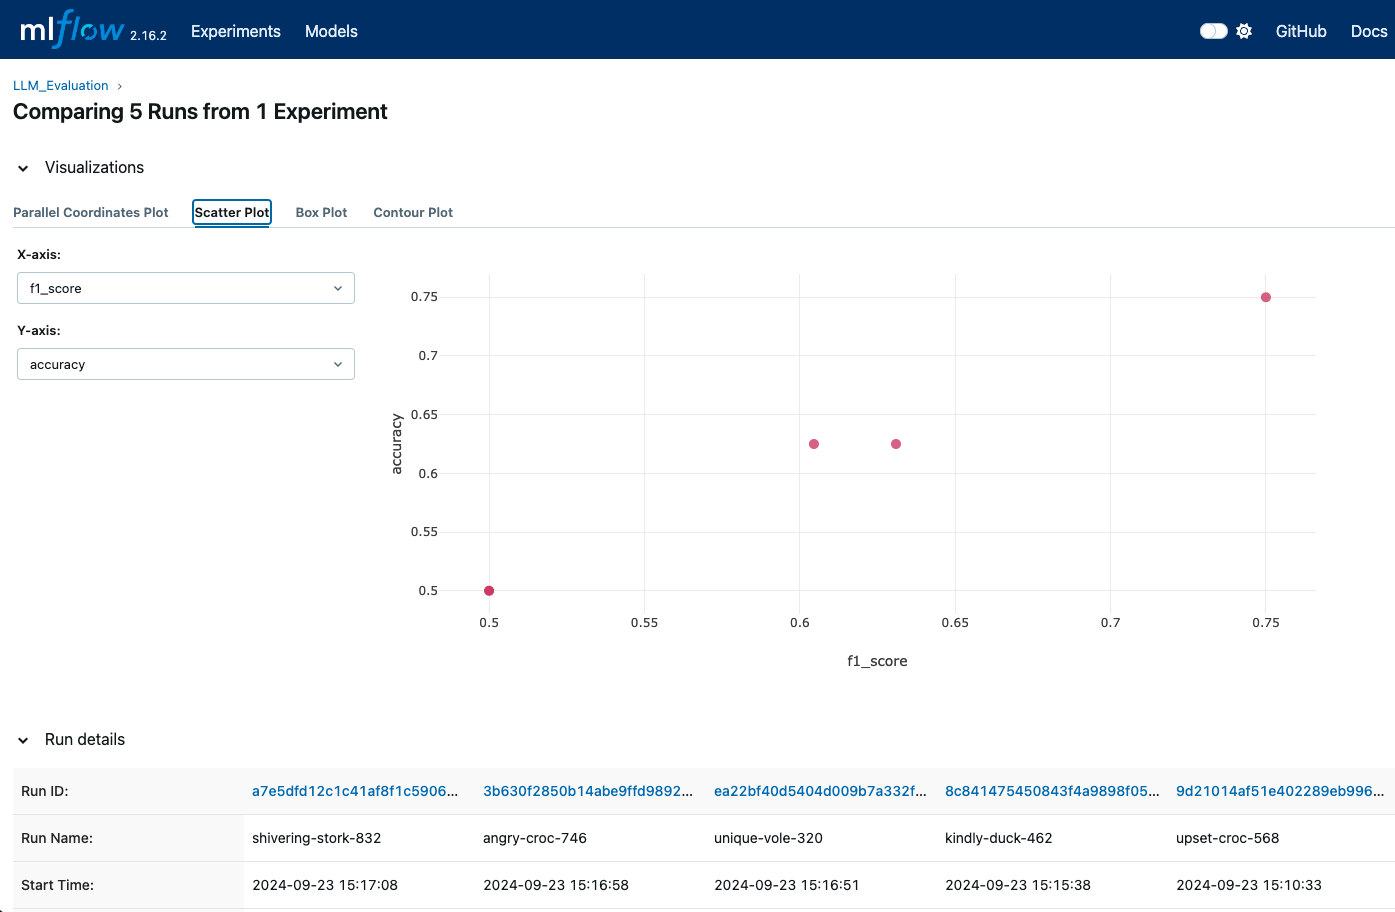
MLflow-visualisaties kunnen laten zien wanneer verschillende runs zijn gelogd, zodat we metrics kunnen vergelijken—afbeelding door de auteur.
De MLflow-UI biedt gedetailleerde grafieken en logs voor elke run. We kunnen deze logs en visualisaties raadplegen om te begrijpen welk model of welke configuratie het beste presteert op basis van de gelogde metrics.
Voor een diepere en meer uitgebreide evaluatie van LLM’s biedt MLflow geavanceerde technieken die tracking en analyse verbeteren. We bekijken hoe je modelartefacten logt voor grondige tracking en MLflow inzet voor hyperparameter-tuning om de LLM-prestaties te optimaliseren.
Modelartefacten loggen is erg belangrijk om de details van onze experimenten te bewaren en te analyseren. Artefacten geven een compleet beeld van de modelprestaties en helpen resultaten te reproduceren.
Onder de artefacten die we kunnen loggen, vallen onder meer:
joblib voor scikit-learn of TensorFlow’s SavedModel-formaat).Hier is een voorbeeld:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
       mlflow.log_artifact("generated_outputs.txt")
Hyperparameter-tuning is cruciaal om LLM-prestaties te optimaliseren. In onze experimenten kunnen we met MLflow verschillende hyperparameterconfiguraties loggen. Zo kunnen we de effecten van diverse instellingen vergelijken en de optimale configuratie vinden.
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
Een ander voordeel van MLflow is dat het kan worden gebruikt met hyperparameter-optimalisatiebibliotheken zoals Optuna of Ray Tune om het tuningproces te automatiseren.
Een nauwkeurige evaluatie van LLM’s is meer dan tests draaien en metrics loggen. Het vereist een strategische aanpak om consistentie, nauwkeurigheid en efficiëntie te waarborgen. Door best practices te hanteren, verhoog je de betrouwbaarheid en effectiviteit van het evaluatieproces.
Stabiele en representatieve datasets gebruiken is een van de eerste dingen die bijdragen aan een effectieve evaluatie. Door te zorgen dat onze evaluatiedatasets stabiel en representatief zijn voor de taken waarvoor onze LLM is ontworpen, krijgen we betekenisvolle vergelijkingen in de tijd en tussen verschillende modellen of versies. Als de dataset verandert, is het lastig om prestatieveranderingen toe te schrijven aan het model in plaats van aan de dataset zelf.
Niet alleen de dataset, maar ook hoe we preprocessen is belangrijk. We moeten dezelfde preprocessingstappen op alle evaluatiedatasets toepassen om vergelijkbare resultaten te garanderen. Dit omvat tokenization, normalization en het afhandelen van speciale gevallen. Consistente preprocessing zorgt ervoor dat variaties in prestaties niet voortkomen uit verschillen in gegevensverwerking.
Zoals hierboven gezien helpt het gebruik van de model registry van MLflow voor versiebeheer ons om verschillende versies van onze LLM’s te tracken. Dit maakt het eenvoudiger om prestaties te vergelijken en zo nodig terug te schakelen naar eerdere versies. We moeten alle details loggen en veranderingen aan de modellen bijhouden, inclusief aanpassingen aan architectuur, hyperparameters of trainingsdata.
Tot slot helpt het om de evaluatie te automatiseren door deze te integreren in CI/CD-pipelines (continuous integration/continuous deployment), zodat modellen consistent en tijdig worden geëvalueerd wanneer er updates zijn. Stel geplande evaluaties in om periodiek de prestaties te beoordelen. Zo monitoren we modeldrift en zorgen we dat modellen aan de prestatienormen blijven voldoen.
LLM’s effectief evalueren vereist een gestructureerde en systematische aanpak, en MLflow biedt een framework om dit proces te ondersteunen.
In deze tutorial hebben we MLflow geïnstalleerd en een trackingserver ingesteld. Vervolgens hebben we onze LLM geëvalueerd door belangrijke metrics te loggen, meerdere runs getrackt om ze te vergelijken en de UI van MLflow gebruikt om deze vergelijkingen effectief te visualiseren en analyseren.
Wil je je MLflow-kennis naar een hoger niveau tillen? Bekijk dan onze cursus Introduction to MLflow!
Leer meer over LLM’s met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

