
Last chance! 50% off DataCamp Premium
Sale ends in
I Large Language Models (LLM) sono diventati fondamentali nello sviluppo di modelli di machine learning, potenziando in particolare le capacità degli algoritmi di elaborazione del linguaggio naturale. Dai chatbot ai generatori di contenuti, questi modelli stanno trasformando il modo in cui interagiamo con la tecnologia.
Tuttavia, man mano che gli LLM crescono per numero e complessità, valutarne le prestazioni diventa sempre più importante. Senza una valutazione adeguata e accurata, è difficile capire se un modello sta funzionando come previsto o necessita di aggiustamenti.
È qui che entra in gioco MLflow. MLflow è uno strumento open source progettato per facilitare la gestione degli esperimenti di machine learning. Ci aiuta a tracciare i risultati dei vari esperimenti, gestire i modelli e mantenere tutto organizzato!
In questo tutorial esploreremo il ruolo di MLflow nel migliorare i flussi di lavoro dei LLM. Ti guiderò nella configurazione e ti mostrerò come registrare metriche e tracciare parametri negli esperimenti con LLM. Infine, vedremo come MLflow supporta una gestione e una distribuzione efficaci dei modelli.
MLflow è una piattaforma open source pensata per gestire l'intero ciclo di vita del machine learning. Fornisce strumenti per semplificare lo sviluppo, il tracciamento e la distribuzione dei modelli di machine learning.
Che si tratti di un piccolo progetto o di esperimenti complessi con modelli di grandi dimensioni, MLflow può aiutarci a rimanere organizzati ed efficienti.
Alcuni vantaggi dell'uso di MLflow nel ciclo di vita del machine learning includono:
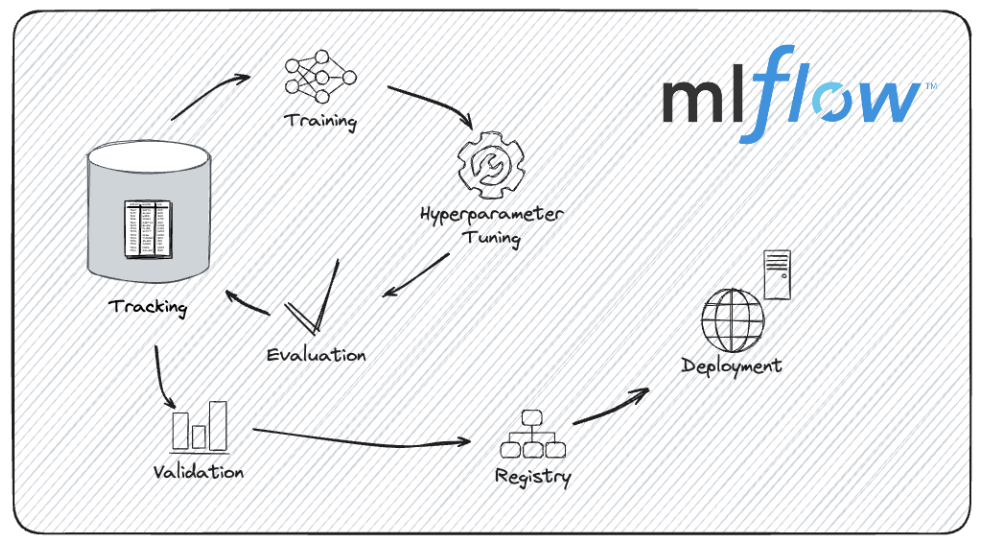
Il ciclo di vita dello sviluppo dei modelli con MLflow. Fonte immagine: documentazione MLflow.
MLflow è progettato per rendere la gestione dei progetti di machine learning più fluida e trasparente. Questo è particolarmente utile quando si lavora con modelli complessi come i LLM, come vedremo ora.
Usare MLflow per la valutazione dei LLM offre diversi vantaggi, come il tracciamento delle versioni del modello, la registrazione delle metriche di valutazione e il confronto delle prestazioni su vari ambiti.
Vediamo questi benefici più nel dettaglio.
Lo sviluppo dei LLM comporta iterazioni e miglioramenti frequenti. Ogni nuova versione porta piccoli affinamenti o cambiamenti di comportamento. MLflow gestisce queste diverse iterazioni tracciando sistematicamente le versioni del modello. Questa capacità ci permette di riprodurre i risultati, confrontare efficacemente le versioni e mantenere una chiara cronologia dell'evoluzione del modello.
Poniamo di sperimentare diverse tecniche di fine-tuning; MLflow può aiutarci a gestire e rivedere gli esiti di ciascuna versione, facilitando l'identificazione dell'iterazione con le migliori prestazioni.
Poiché MLflow garantisce che ogni esperimento e i relativi risultati siano registrati in modo esaustivo, possiamo condividere i nostri risultati con sicurezza, sapendo che altri potranno riprodurli esattamente.
Se il nostro progetto prevede esperimenti con diverse architetture di LLM o metodologie di training, le capacità di tracciamento di MLflow renderanno più semplice documentare e condividere il nostro lavoro.
Valutare i LLM comporta il monitoraggio di diverse metriche, come accuracy, perplexity e F1 score, tra le altre.
La funzionalità di logging di MLflow ci permette di registrare queste metriche in modo efficiente e organizzato. Analizzarle ci dà un quadro chiaro delle prestazioni del nostro modello.
Per esempio, potremmo voler confrontare come diversi iperparametri o dataset di training influenzino le metriche di prestazione del modello. Con MLflow possiamo registrare e visualizzare queste metriche per trarne insight utilizzabili.
Quando i modelli vengono distribuiti e usati in applicazioni reali, possono andare incontro a model drift, ovvero un degrado delle prestazioni dovuto a cambiamenti nei dati o nell'ambiente. Possiamo sfruttare MLflow per monitorare e gestire il model drift tracciando le prestazioni nel tempo.
Possiamo impostare valutazioni periodiche e usare MLflow per registrare e analizzare come cambiano le metriche, prendendo decisioni operative in tempo reale.
Uno dei vantaggi più importanti di MLflow è la capacità di semplificare confronti completi tra modelli. Archiviando registrazioni dettagliate dei vari esperimenti, MLflow ci permette di confrontare affiancati le prestazioni di diversi LLM e configurazioni di iperparametri.
Trovare gli iperparametri corretti può determinare il successo di un modello nello sviluppo di LLM.
Immagina di eseguire il fine-tuning di un LLM e voler valutare l'impatto di diverse impostazioni di iperparametri. Con MLflow possiamo registrare e confrontare i risultati di vari learning rate, dimensioni di batch o tassi di dropout per individuare la configurazione con le migliori prestazioni, ottimizzando così lo sviluppo del modello.
Il model registry di MLflow e le funzionalità di tracciamento entrano in gioco quando valutiamo più LLM per il deployment.
Supponiamo di avere diverse versioni di un modello linguistico da considerare per la produzione. MLflow può aiutarci a registrare le metriche di ciascun modello, confrontarle e prendere una decisione informata basata su evidenze empiriche e non solo sull'intuizione.
Ora che abbiamo un quadro più chiaro di MLflow e dei suoi vantaggi, passiamo alla pratica!
Prima di valutare i LLM con MLflow, dobbiamo configurare correttamente la piattaforma. Questo comporta l'installazione di MLflow, la configurazione facoltativa di un tracking server per il logging remoto e la verifica che l'ambiente sia pronto a gestire esperimenti e tracciare i risultati.
Vediamo come fare.
1. Verifica che Python sia installato:
Per prima cosa dobbiamo assicurarci di avere Python installato sulla macchina. MLflow è compatibile con Python 3.6 e successivi (attenzione: Python 3.8 è ora deprecato, quindi è consigliato usare Python >= 3.9). Possiamo controllare la versione di Python con:
python --version2. Crea un ambiente virtuale (opzionale ma consigliato):
È buona pratica usare un ambiente virtuale quando si tracciano esperimenti con MLflow, soprattutto se si lavora su Mac OS X. Possiamo crearne uno usando venv o virtualenv.
python -m venv mlflow-envAttiviamo l'ambiente virtuale:
Su Windows:
mlflow-env\Scripts\activateSu Mac/Linux:
source mlflow-env/bin/activate3. Installa MLflow con pip:
Con l'ambiente virtuale attivo (se usato), possiamo installare MLflow via pip:
pip install mlflow4. Installa dipendenze aggiuntive:
MLflow ha alcune dipendenze opzionali per funzionalità avanzate. Se ci servono funzionalità specifiche, come le capacità di serving del modello di MLflow, dobbiamo installare gunicorn.
pip install gunicornSe usiamo librerie come TensorFlow o PyTorch, potremmo dover installare le relative integrazioni MLflow:
pip install mlflow[extras]4. Verifica dell'installazione:
Poi dobbiamo assicurarci che MLflow sia installato correttamente controllandone la versione:
mlflow --versionSe lavoriamo in un ambiente collaborativo o se dobbiamo effettuare logging remoto, dovremmo configurare un tracking server MLflow. Questa funzione ci consente di centralizzare il tracciamento e la gestione degli esperimenti.
1. Avvia il tracking server:
Possiamo avviare il server MLflow specificando il backend store e la posizione degli artifact.
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri specifica dove vengono archiviati i dati degli esperimenti. Possiamo usare qualsiasi sistema di database (PostgreSQL, MySQL, ecc.).--default-artifact-root specifica la directory in cui vengono salvati gli artifact, ad esempio i file dei modelli.2. Configura il tracking server:
Dobbiamo assicurarci che i client MLflow siano configurati per registrare sul tracking server. Possiamo impostare la variabile d'ambiente MLFLOW_TRACKING_URI per puntare al nostro server.
export MLFLOW_TRACKING_URI=http://localhost:50003. Accedi all'interfaccia di tracciamento:
Ora possiamo aprire un browser e andare su http://localhost:5000 per accedere all'UI di MLflow. Questa interfaccia ci permette di visualizzare esperimenti, confrontare risultati e gestire i progetti MLflow, come vedremo più avanti.
Con MLflow configurato e pronto, è il momento di affrontare i compiti principali: caricare e valutare i LLM. Vediamo come selezionare un LLM preaddestrato, caricarlo usando diverse librerie e preparare un dataset di valutazione per misurare le prestazioni del modello.
Quando si seleziona un LLM preaddestrato, librerie come Hugging Face Transformers offrono molte opzioni. Per esempio, possiamo caricare un modello preaddestrato come GPT (per la generazione di testo) o BERT (per la classificazione del testo e altri compiti).
1. Installa Hugging Face Transformers
Per prima cosa, assicuriamoci di avere installata la libreria Hugging Face Transformers. Possiamo farlo usando pip.
pip install transformers2. Carica un modello e un tokenizer preaddestrati
Ora carichiamo il modello BERT usando la libreria transformers, includendo sia il modello sia il tokenizer, necessari per elaborare il testo e generare previsioni.
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
Il modello bert-base-uncased si usa quando i dati testuali con cui lavoriamo contengono soprattutto minuscole e maiuscole, ma non abbiamo bisogno che il modello distingua tra parole scritte in maiuscolo e minuscolo.
Per valutare un LLM, ci serve un dataset adatto al compito che stiamo analizzando. Vediamo come preparare un dataset testuale di valutazione per l'analisi del sentiment:
1. Carica o crea e preprocessa il dataset
I nostri dati possono essere archiviati in vari luoghi: sul disco locale della macchina, in un repository GitHub o su Hugging Face Hub, un'ampia raccolta di dataset curati dalla community e della ricerca.
Per questo tutorial, useremo un ampio dataset di recensioni cinematografiche per l'analisi del sentiment chiamato IMDB. Useremo la libreria datasets per caricare il dataset predefinito:
Installare la libreria datasets:
pip install datasetsCaricare un dataset:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. Preprocessing per l'analisi del sentiment
Useremo il tokenizer BERT caricato in precedenza per preprocessare il dataset per l'analisi del sentiment.
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)Ora che i nostri LLM sono caricati e il dataset di valutazione è pronto, è il momento di eseguire le valutazioni e registrare le metriche.
1. Importa MLflow e avvia un nuovo esperimento
Per tracciare gli esperimenti con MLflow, dobbiamo prima avviare un nuovo esperimento e registrare i metadati rilevanti, come nome del modello, versione e parametri di valutazione.
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. Registra i parametri di valutazione
Ora possiamo registrare tutti i parametri legati al processo di valutazione, come la dimensione del dataset di valutazione o configurazioni specifiche usate durante la valutazione.
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))Una volta addestrato il modello e ottenute le relative previsioni, possiamo valutare il LLM e registrare varie metriche che riflettono le sue prestazioni.
L'analisi del sentiment è un problema di classificazione, quindi possiamo valutare il modello usando metriche come accuracy e F1 score. Per i compiti di generazione del testo, sono comuni metriche come BLEU score o perplexity.
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)Una volta tracciate più esecuzioni con MLflow, confrontarne le prestazioni è essenziale per individuare i modelli e le configurazioni migliori.
Vediamo come tracciare più esecuzioni e usare l'UI di MLflow per visualizzare e confrontare i risultati in modo efficace.
Per prima cosa, dobbiamo tracciare più esecuzioni all'interno dello stesso esperimento o tra esperimenti diversi per confrontare le prestazioni di differenti versioni di LLM.
1. Registra più esecuzioni
Possiamo registrare più esecuzioni sotto un unico esperimento avviando nuove run per ciascun modello o configurazione che vogliamo valutare.
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. Tracciare esperimenti con modelli diversi
Immaginiamo di voler valutare diversi tipi di modelli. A tal fine, possiamo usare MLflow per creare un esperimento e registrare i modelli insieme.
Registrare i modelli in MLflow è come fare il controllo di versione per i modelli di machine learning. Annotare dettagli su modello e ambiente garantisce la riproducibilità.
Per prima cosa imposteremo un esperimento. Poi registreremo ciascun modello in una run separata di MLflow, includendo gli ID delle run e i percorsi degli artifact.
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
Ora possiamo valutare i modelli e registrare i risultati. MLflow fornisce un'API, mlflow.evaluate(), per aiutare a valutare i nostri LLM.
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)Dopo aver registrato le varie metriche e i modelli in MLflow, possiamo effettuare un confronto. Possiamo usare l'interfaccia utente di MLflow, semplice e intuitiva, per visualizzare e confrontare le metriche di valutazione delle diverse esecuzioni. Per farlo, dobbiamo avviare il server MLflow se non è già in esecuzione
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsQuindi apriamo un browser e andiamo su http://localhost:5000 per accedere all'UI di MLflow. Nell'UI di MLflow, andiamo alla pagina "Experiments" per visualizzare tutti i nostri esperimenti. Facciamo clic sul nome dell'esperimento per vedere l'elenco delle run associate.
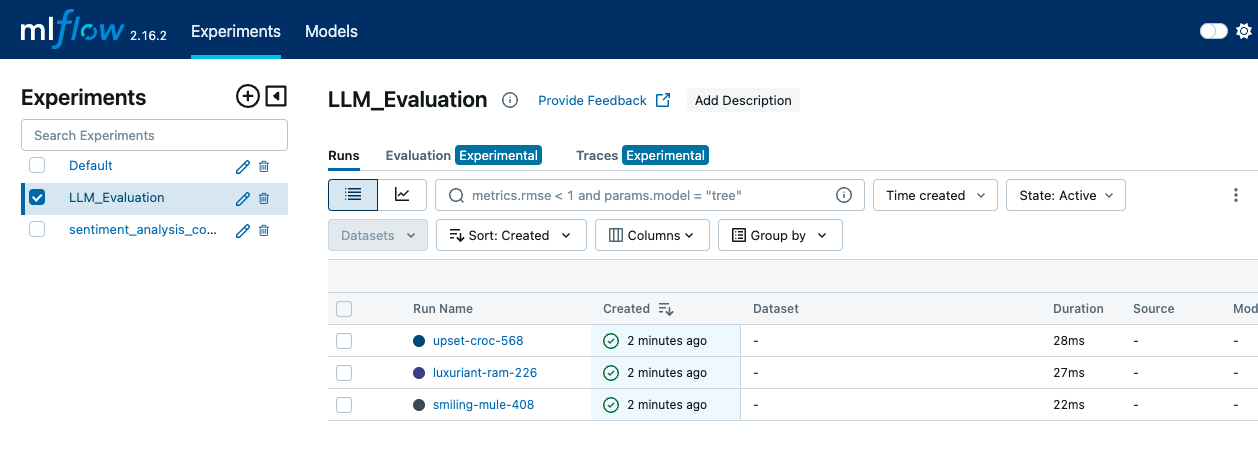
L'interfaccia MLFLow mostra la scheda Experiments, dove sono visibili le diverse esecuzioni e gli eventi di log — immagine dell'autore.
All'interno di un esperimento, possiamo confrontare diverse run selezionandone più di una e visualizzandone le metriche affiancate.
L'UI ci permette di vedere una rappresentazione visiva di metriche come accuracy, F1 score e altre metriche di valutazione. Possiamo anche usare le visualizzazioni integrate di MLflow per generare grafici e plot per confronti più dettagliati.
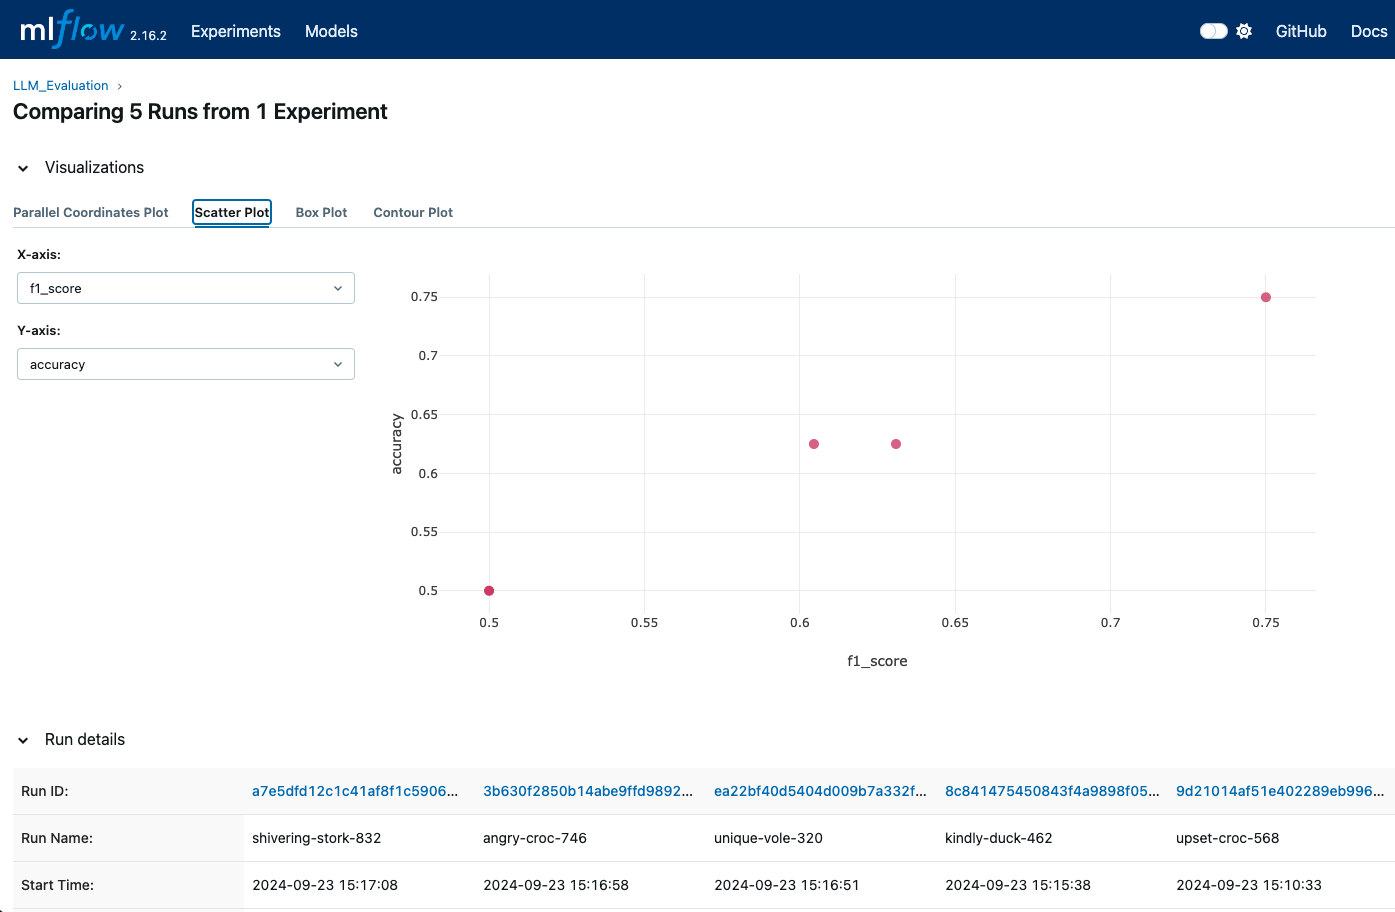
Le visualizzazioni di MLflow possono mostrarci quando vengono registrate le diverse esecuzioni, così da confrontare varie metriche — immagine dell'autore.
L'UI di MLflow fornisce grafici e log dettagliati per ogni esecuzione. Possiamo accedere a questi log e visualizzazioni per capire quale modello o configurazione performa meglio in base alle metriche registrate.
Per una valutazione più profonda e completa dei LLM, MLflow offre tecniche avanzate che migliorano tracciamento e analisi. Esamineremo come registrare gli artifact del modello per un tracciamento accurato e come usare MLflow per la tuning degli iperparametri per ottimizzare le prestazioni dei LLM.
Registrare gli artifact del modello è molto importante per preservare e analizzare i dettagli dei nostri esperimenti. Gli artifact possono fornire un quadro completo delle prestazioni del modello e aiutare a riprodurre i risultati.
Tra gli artifact che possiamo registrare troviamo:
joblib per scikit-learn o formato SavedModel per TensorFlow).Ecco un esempio:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
mlflow.log_artifact("generated_outputs.txt")Il tuning degli iperparametri è una parte chiave dell'ottimizzazione delle prestazioni dei LLM. Nei nostri esperimenti possiamo usare MLflow per registrare diverse configurazioni di iperparametri. Questo ci permette di confrontare gli effetti delle varie impostazioni e trovare la configurazione ottimale.
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
Un altro vantaggio di MLflow è la possibilità di integrarsi con librerie di ottimizzazione degli iperparametri come Optuna o Ray Tune per automatizzare il processo di tuning.
Una valutazione accurata dei LLM richiede più che eseguire test e registrare metriche. Serve un approccio strategico per garantire coerenza, accuratezza ed efficienza. Adottare best practice può migliorare l'affidabilità e l'efficacia del processo di valutazione.
Usare dataset stabili e rappresentativi è uno dei primi elementi che contribuiscono a una valutazione efficace. Assicurandoci che i dataset di valutazione siano stabili e rappresentativi dei compiti per cui il nostro LLM è progettato, otterremo confronti significativi nel tempo e tra modelli o versioni diverse. Se il dataset cambia, può essere difficile attribuire i cambiamenti di performance al modello invece che al dataset stesso.
Non solo il dataset, ma anche come lo preprocessiamo è importante. Dobbiamo applicare gli stessi passaggi di preprocessing a tutti i dataset di valutazione per garantire risultati confrontabili. Questo include tokenizzazione, normalizzazione e gestione dei casi speciali. Un preprocessing coerente assicura che le variazioni di performance del modello non siano dovute a differenze nel trattamento dei dati.
Come visto sopra, usare il model registry di MLflow per abilitare il controllo di versione ci aiuta a tracciare le diverse versioni dei nostri LLM. Questo facilita il confronto delle prestazioni e l'eventuale rollback a versioni precedenti. Dovremmo registrare tutti i dettagli e tenere traccia delle modifiche apportate ai modelli, incluse modifiche all'architettura, agli iperparametri o ai dati di training.
Infine, automatizzare il processo di valutazione integrandolo in pipeline di continuous integration/continuous deployment (CI/CD) può aiutarci a garantire che i modelli vengano valutati in modo coerente e tempestivo a ogni aggiornamento. Dovremmo impostare valutazioni pianificate per verificare periodicamente le prestazioni del modello. Questo ci aiuta a monitorare il model drift e ad assicurarci che i modelli soddisfino gli standard di performance nel tempo.
Valutare efficacemente i LLM richiede un approccio strutturato e sistematico, e MLflow fornisce un framework a supporto di questo processo.
In questo tutorial abbiamo installato MLflow e configurato un tracking server. Poi abbiamo valutato il nostro LLM registrando le metriche importanti, tracciato più esecuzioni per confrontarle e usato l'UI di MLflow per visualizzare e analizzare efficacemente questi confronti.
Se vuoi portare la tua conoscenza di MLflow al livello successivo, dai un'occhiata al nostro corso Introduction to MLflow!
Scopri di più sui LLM con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min




