{count, plural, one {Khóa học} other {Khóa học}}
Nhập môn Python cho Tài chính
{hours} giờ
107.9K
Hầu hết so sánh Stock API bắt đầu sai chỗ.
Họ so giá, đếm số endpoint, trang tài liệu, và giới hạn gói miễn phí. Những chi tiết đó quan trọng, nhưng không cho bạn biết API có hỗ trợ được hệ thống bạn đang xây hay không.
Một backtest không thất bại vì nhà cung cấp có ít endpoint hơn đối thủ. Nó thất bại vì giá lịch sử không được điều chỉnh đúng, lịch sử dữ liệu quá ngắn, hoặc xử lý hành động doanh nghiệp kém.
Một bảng điều khiển có mô thức hỏng khác. Nó “vỡ” khi phản hồi báo giá chậm, trường thay đổi bất ngờ, hoặc giới hạn tốc độ trở thành vấn đề khi người dùng bắt đầu làm mới trang.
Đó là lý do tôi coi các danh sách “best stock API” chung chung là điểm khởi đầu, không phải câu trả lời. Câu hỏi thực sự là: "API này có còn hoạt động khi dự án của tôi không còn là bản mẫu không?"
Khi một API vận hành một quy trình thực, nó trở thành hạ tầng dữ liệu:
Chuyển đổi sau này rất đau vì bạn không chỉ đổi URL yêu cầu. Bạn có thể cần viết lại pipeline, job làm mới, cập nhật logic lưu trữ, điều chỉnh đầu vào mô hình, và sửa một phần giao diện người dùng.
Việc IEX Cloud ngừng hoạt động năm 2024 là một lời nhắc hữu ích. Nhiều nhà phát triển và công ty đã xây bảng điều khiển, ứng dụng, và công cụ nội bộ dựa trên API của họ. Khi dịch vụ dừng, việc di trú đồng nghĩa với phải nghĩ lại endpoint, trường dữ liệu, giá, cấp phép, và các giả định về dữ liệu.
Trước khi so sánh nhà cung cấp, hãy xác định quy trình mà API sẽ hỗ trợ. Một bộ backtest và một bảng điều khiển có thể cùng dùng giá cổ phiếu, nhưng không phụ thuộc vào cùng yêu cầu dữ liệu.
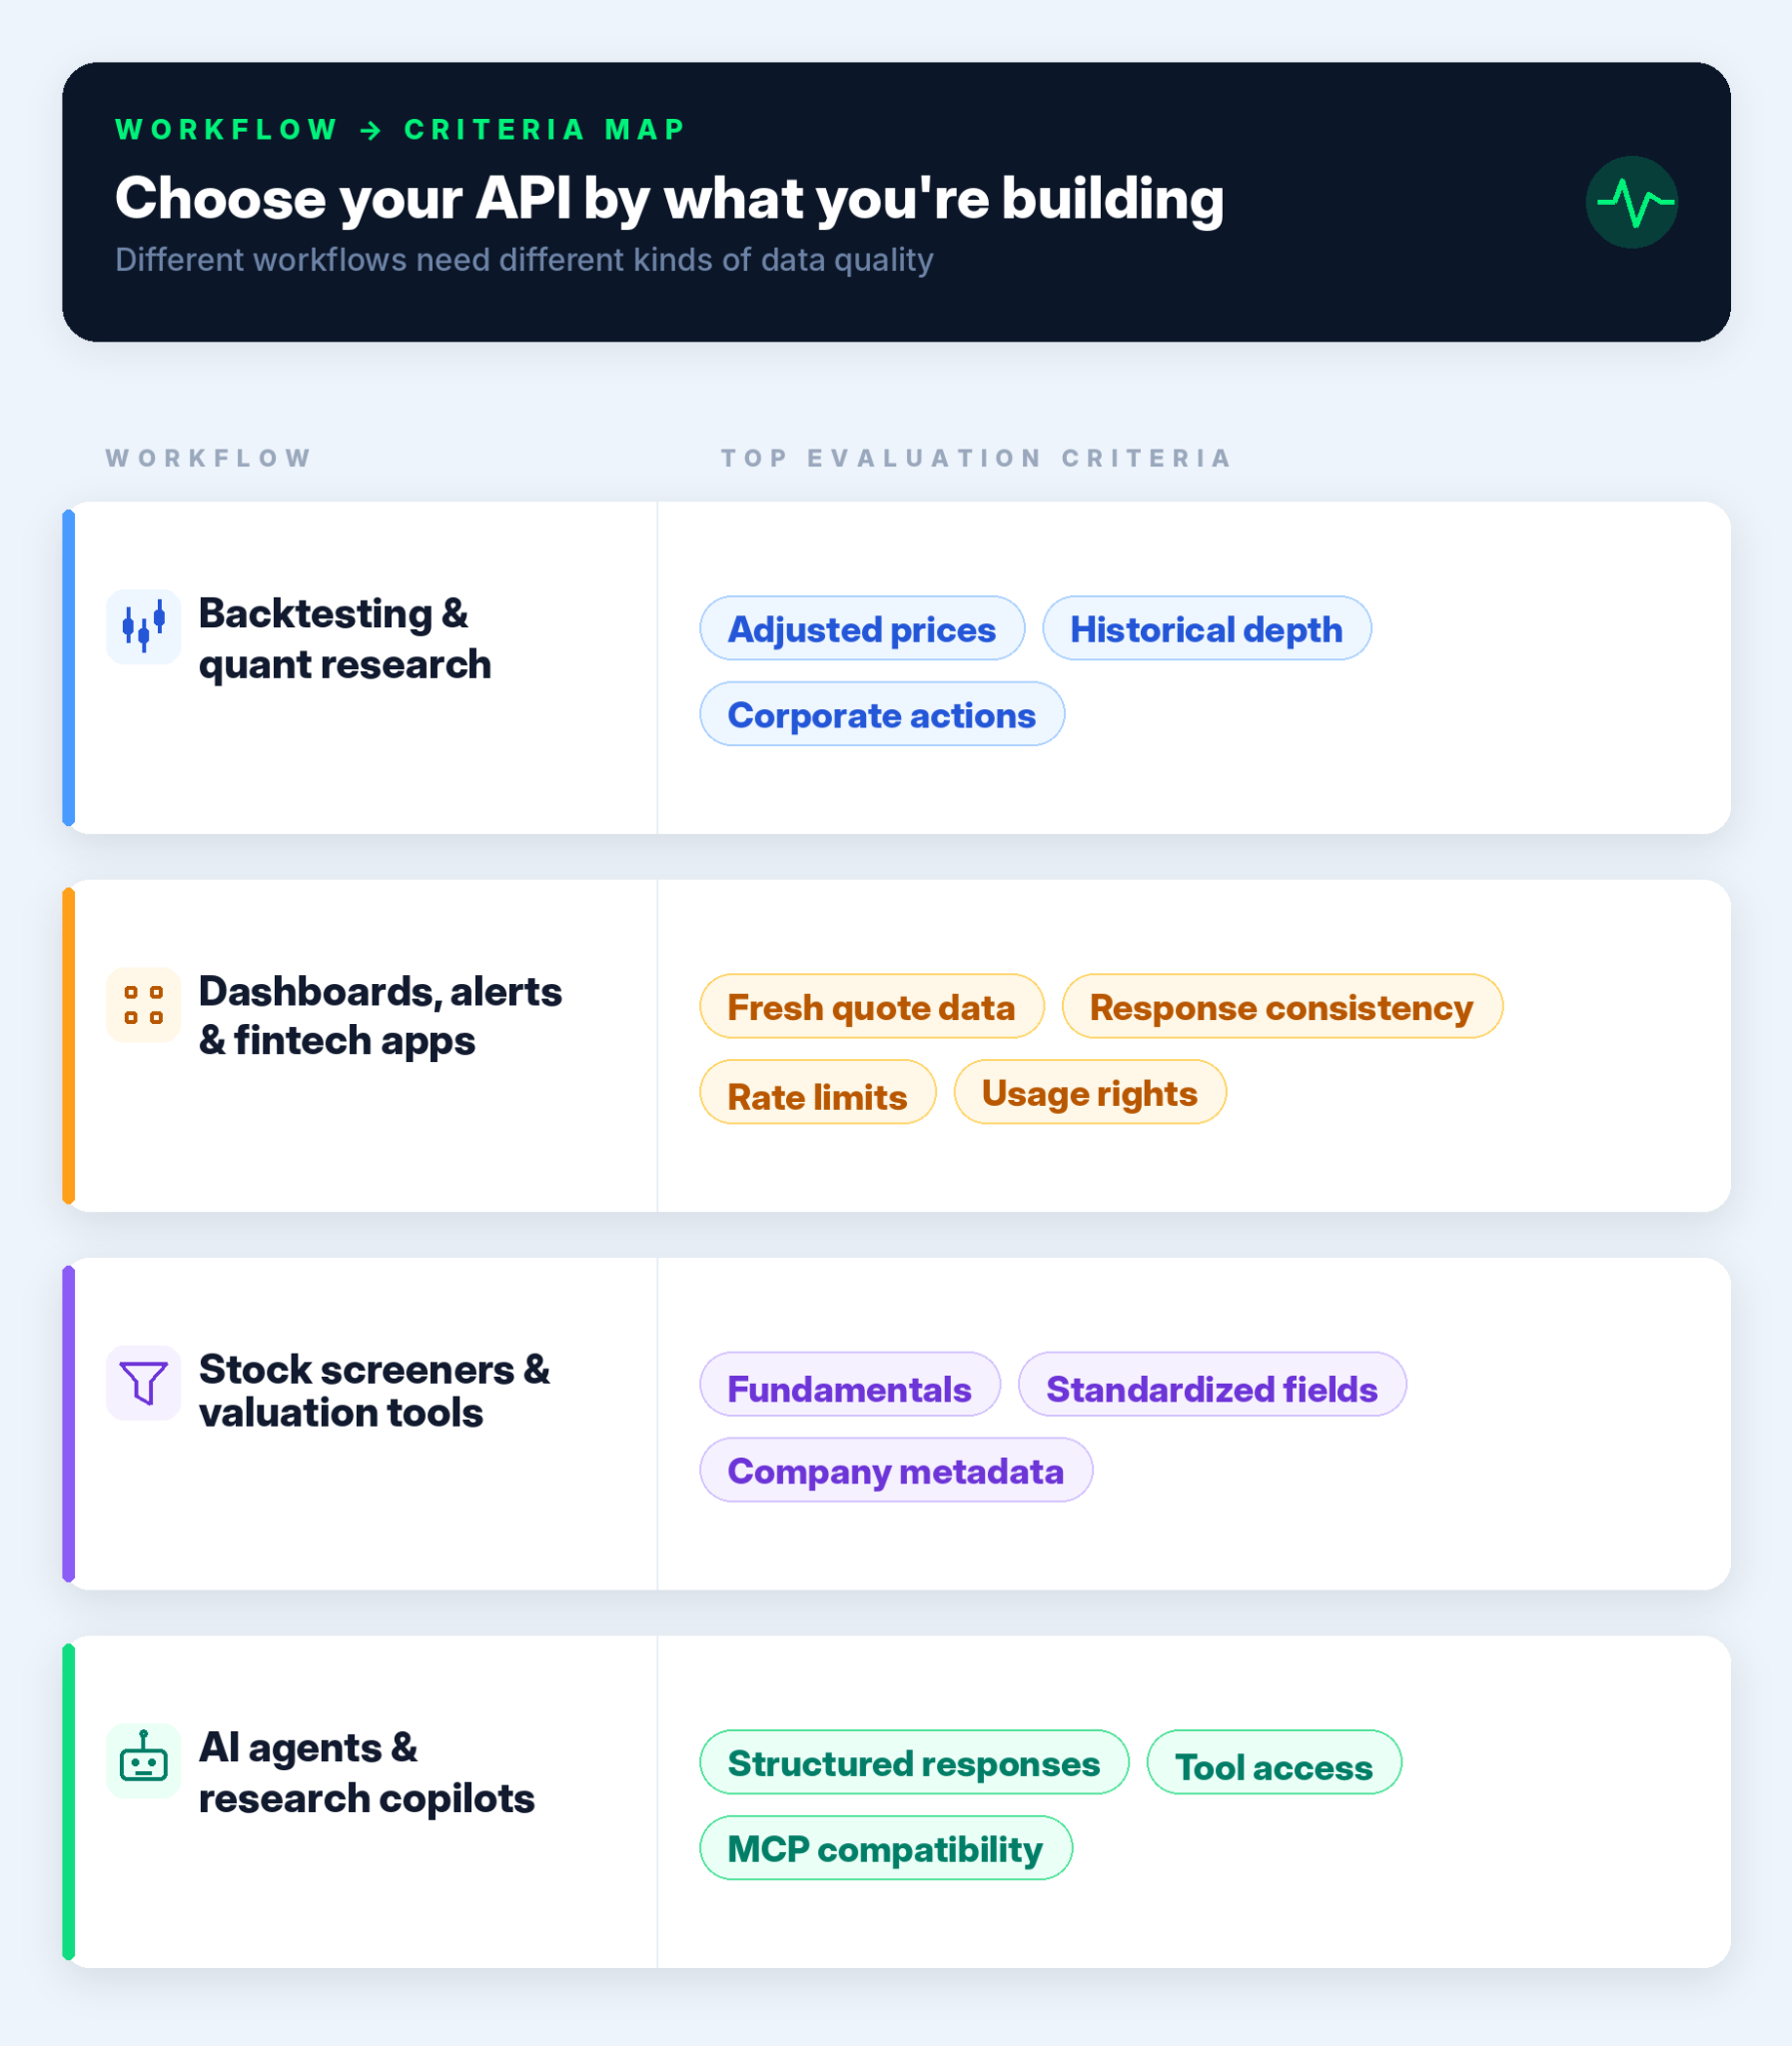
Với backtesting, dữ liệu lịch sử sạch thường quan trọng hơn dữ liệu thời gian thực.
Tiêu chí chính cần kiểm tra:
Để đào sâu cách triển khai và kiểm thử chiến lược giao dịch trong Python, hướng dẫn Algorithmic Trading in Python của chúng tôi trình bày chi tiết hơn về khái niệm backtesting và các bẫy thường gặp.
Bảng điều khiển và hệ thống cảnh báo ưu tiên tính mới, độ tin cậy và nhất quán. Một notebook cá nhân có thể chấp nhận yêu cầu thất bại hoặc tên trường lộn xộn. Sản phẩm cho người dùng thì không.
Tiêu chí chính cần kiểm tra:
Bộ lọc và công cụ định giá cần dữ liệu doanh nghiệp, không chỉ dữ liệu giá. Thách thức chính là so sánh vì bạn thường lọc hoặc xếp hạng nhiều công ty cùng lúc.
Tiêu chí chính cần kiểm tra:
Quy trình AI cần API trả về dữ liệu có cấu trúc, có thể dự đoán. Một LLM có thể tóm tắt văn bản, nhưng không nên đoán dữ liệu tài chính.
Tiêu chí chính cần kiểm tra:
Để đi từ dữ liệu API đến một agent hoạt động, hướng dẫn Model Context Protocol (MCP) trình bày cách MCP kết nối mô hình AI với công cụ bên ngoài, trong khi các hướng dẫn Building LangChain Agents và OpenAI Agents SDK cho thấy cách thực hành điều đó bằng Python.
Khi bạn đã biết quy trình, việc so sánh API trở nên dễ hơn. Bạn không còn hỏi, “Nhà cung cấp nào có nhiều tính năng nhất?” mà là, “Nhà cung cấp nào có thể hỗ trợ lớp dữ liệu mà dự án này cần?”
|
Tiêu chí |
Cần kiểm tra gì |
Vì sao quan trọng |
|
Phạm vi dữ liệu |
Loại tài sản, thị trường, mã và khu vực địa lý |
API nên bao phủ vũ trụ mà dự án của bạn thực sự cần |
|
Độ sâu lịch sử |
Độ dài lịch sử, quyền truy cập full-history, dữ liệu đã và chưa điều chỉnh |
Backtest và công cụ nghiên cứu cần nhiều hơn dữ liệu gần đây |
|
Chất lượng dữ liệu và hành động doanh nghiệp |
Chia tách, cổ tức, đổi mã, thiếu hàng và mã lỗi thời |
Điều chỉnh sai có thể bóp méo biểu đồ, lợi nhuận và đầu ra mô hình |
|
Hỗ trợ số liệu cơ bản |
Báo cáo, lợi nhuận, tỷ số, hồ sơ công ty và metadata |
Bộ lọc và công cụ định giá cần bối cảnh doanh nghiệp, không chỉ giá |
|
Cấp phép và phân phối lại |
Quyền hiển thị, quyền lưu trữ, sử dụng thương mại và quy định sàn |
Use case notebook khác với sản phẩm công khai hoặc trả phí |
|
Trải nghiệm nhà phát triển |
Tài liệu, định dạng phản hồi, lỗi, giới hạn tốc độ và khả năng dùng với Python |
API sạch tiết kiệm thời gian sau lần yêu cầu đầu tiên |
|
Sẵn sàng cho AI và agent |
Phản hồi có cấu trúc, truy cập công cụ, hỗ trợ MCP và schema có thể dự đoán |
Trợ lý AI cần dữ liệu có thể truy xuất, phân tích và suy luận |
Phạm vi nên khớp với dự án, không phải trang marketing.
Kiểm tra:
Sai lầm là chọn nhà cung cấp có tuyên bố phạm vi lớn nhất thay vì nhà cung cấp bao phủ đúng vũ trụ truy vấn thực tế của bạn.
Độ sâu lịch sử quan trọng khi dự án cần thử ý tưởng qua các điều kiện thị trường khác nhau.
Kiểm tra:
Có khác biệt giữa “chúng tôi cung cấp giá lịch sử” và “tập dữ liệu này đủ sâu cho kiểm thử nghiêm túc”.
Đây là nơi dữ liệu cổ phiếu trở nên phiền phức.
Kiểm tra:
Để xử lý phần “lộn xộn” của dữ liệu tài chính (hãy nghĩ tới giá trị thiếu, trường không nhất quán, và lỗi định dạng), lộ trình Importing & Cleaning Data in Python bao quát kỹ thuật cốt lõi bạn sẽ cần sau khi gọi API đã ổn.
Số liệu cơ bản quan trọng khi dự án cần bối cảnh doanh nghiệp, không chỉ biến động giá.
Kiểm tra:
Từ khóa là tính nhất quán. Nếu bạn so sánh công ty, các trường nên hoạt động nhất quán trên toàn vũ trụ mà không cần logic tùy biến cho từng mã.
Cấp phép nhàm chán cho đến khi nó chặn sản phẩm.
Kiểm tra:
Tôi muốn biết các giới hạn này trước khi viết pipeline hơn là sau khi đã xây xong frontend.
Một API sạch tiết kiệm thời gian sau lần yêu cầu đầu tiên.
Kiểm tra:
Cuộc gọi thành công đầu tiên không phải là bài test thực. Bài test thực là API có còn thấy sạch khi bạn thêm job làm mới, xử lý lỗi, và join với tập dữ liệu khác hay không.
Quy trình AI cần khả năng truy cập dữ liệu có thể dự đoán.
Kiểm tra:
API không cần phải “AI-native” cho mọi use case. Nhưng nếu bạn xây trợ lý nghiên cứu tài chính, lớp dữ liệu nên dễ dùng cho cả mã Python và công cụ AI.
Hướng dẫn Codex CLI MCP của chúng tôi minh họa cụ thể điều này trong bối cảnh tài chính, xây dựng agent bảng điều khiển danh mục sống dùng dữ liệu Alpha Vantage qua quy trình MCP.
Các tiêu chí trên hữu ích, nhưng tôi sẽ không chọn nhà cung cấp chỉ từ checklist. Tôi sẽ kiểm thử API với những mô thức hỏng quan trọng cho dự án.
Trong các ví dụ dưới đây, tôi sẽ dùng Alpha Vantage vì nó cung cấp cho chúng ta giá lịch sử, báo giá trực tiếp, số liệu cơ bản, chỉ báo kỹ thuật và tùy chọn quy trình AI ở một nơi. Mục tiêu là kiểm tra liệu API có đáp ứng yêu cầu dự án thực mà không tạo quá nhiều việc dọn dẹp hay không.
Với backtester, đây là một trong những kiểm tra đầu tiên tôi sẽ chạy. Nếu chuỗi giá không xử lý chia tách gọn gàng, mọi phép tính lợi nhuận xây trên đó đều đáng ngờ.
Đoạn mã dưới kéo giá điều chỉnh theo ngày của Tesla quanh đợt chia tách cổ phiếu năm 2022 và so sánh lợi nhuận thô với lợi nhuận đã điều chỉnh.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Đây là đầu ra:
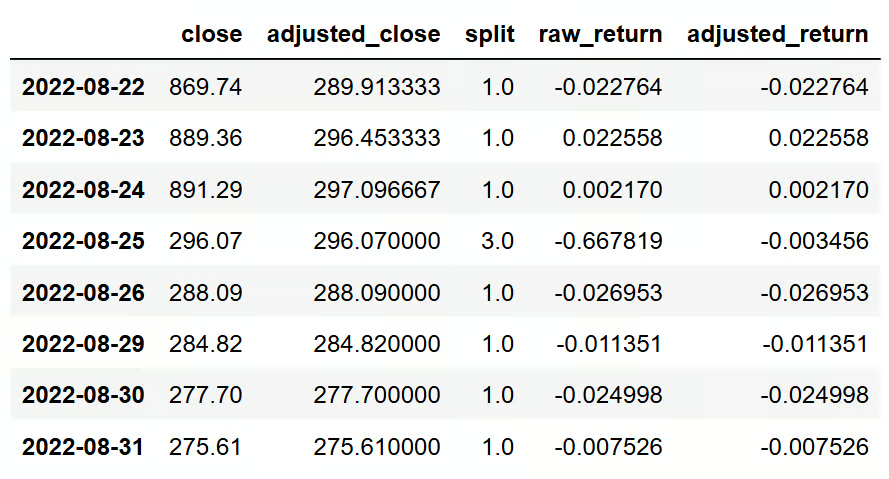
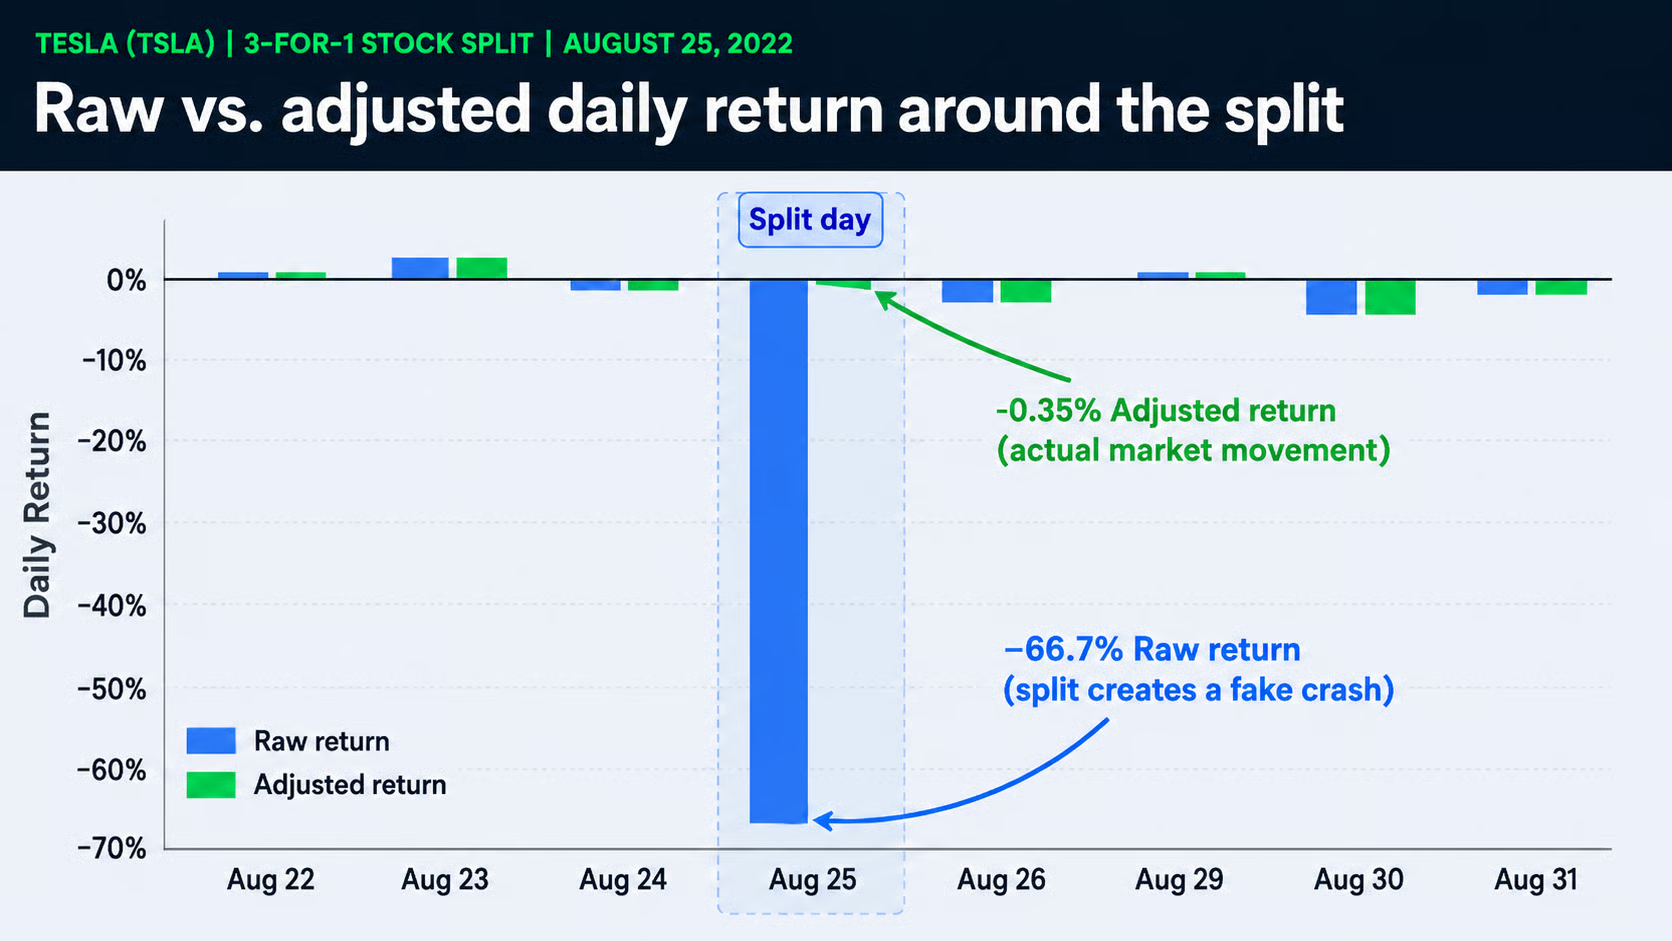
Đây chính là lý do dữ liệu đã điều chỉnh quan trọng.
Giá đóng cửa thô gợi ý mức giảm 66,7% vào ngày 25/08/2022. Đó không phải cú sập thật. Đó là chia tách cổ phiếu 3-đổi-1 của Tesla xuất hiện trong chuỗi giá thô.
Lợi nhuận đã điều chỉnh cùng ngày chỉ khoảng -0,35%, sát hơn nhiều với biến động thực tế của thị trường sau khi tính đến chia tách.
Kiểm tra nhỏ này cho bạn biết API có cung cấp các trường cần để bắt lỗi backtesting phổ biến hay không. Một danh sách tính năng dài không thể nói cho bạn điều đó.
Một bảng điều khiển hoặc hệ thống cảnh báo không chỉ cần dữ liệu. Nó cần các yêu cầu thất bại một cách rõ ràng.
Trình trợ giúp này thêm mẫu retry đơn giản và kiểm tra các vấn đề phản hồi API thường gặp. Đây không phải hạ tầng sản xuất, nhưng đủ để thử xem API có hành xử có thể dự đoán khi có sự cố hay không.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Đây là kiểu kiểm tra tôi sẽ thêm trước khi tin API trong bảng điều khiển hoặc job theo lịch.
Điểm quan trọng không phải số lần retry. Mà là liệu mã của bạn có thể tách bạch mã xấu, phản hồi rỗng, thông điệp giới hạn tốc độ, và lỗi yêu cầu tạm thời hay không. Nếu mọi lỗi trông như nhau, việc gỡ lỗi sẽ rất đau khi dự án có người dùng.
Với bộ lọc, công cụ định giá và trợ lý AI, tôi sẽ thử xem API có thể tạo một đối tượng nghiên cứu sạch từ nhiều endpoint hay không.
Ví dụ dưới đây kéo báo giá và tổng quan công ty của Apple, rồi biến kết quả thành một dictionary gọn. Đây gần hơn với thứ mà thẻ bảng điều khiển, một hàng bộ lọc, hoặc phản hồi công cụ AI sẽ cần.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
Đầu ra trông như thế này:
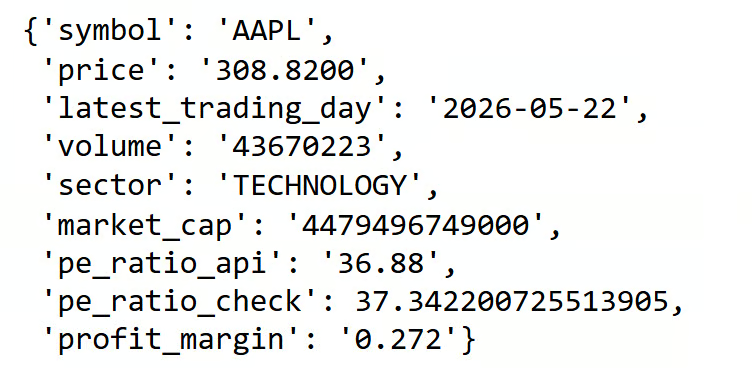
Tỷ số P/E do API báo và phép tính đơn giản giá/ EPS của chúng ta không giống hệt, điều này bình thường vì nhà cung cấp có thể dùng quy ước thời gian hoặc đầu vào điều chỉnh khác nhau. Nhưng so sánh vẫn hữu ích vì nó cho biết các trường có dùng được theo hướng “đúng chiều” hay không.
Bài test này không chỉ hữu ích cho backtesting:
Điểm cuối cùng này quan trọng. MCP hay tool calling không thể “phù phép” dữ liệu lộn xộn. API vẫn cần trả về trường có thể biến thành đối tượng có thể dự đoán. Nếu mỗi endpoint đều cần dọn dẹp tùy biến, quy trình agent sẽ nhanh chóng mong manh.
Bài test thực tế rất đơn giản: bạn có thể kéo dữ liệu, xác thực, tính một chỉ số cơ bản, và trả về một thứ phần khác của hệ thống có thể dùng không? Nếu có, API đã tiến gần hơn nhiều đến việc hữu dụng vượt quá notebook đầu tiên.
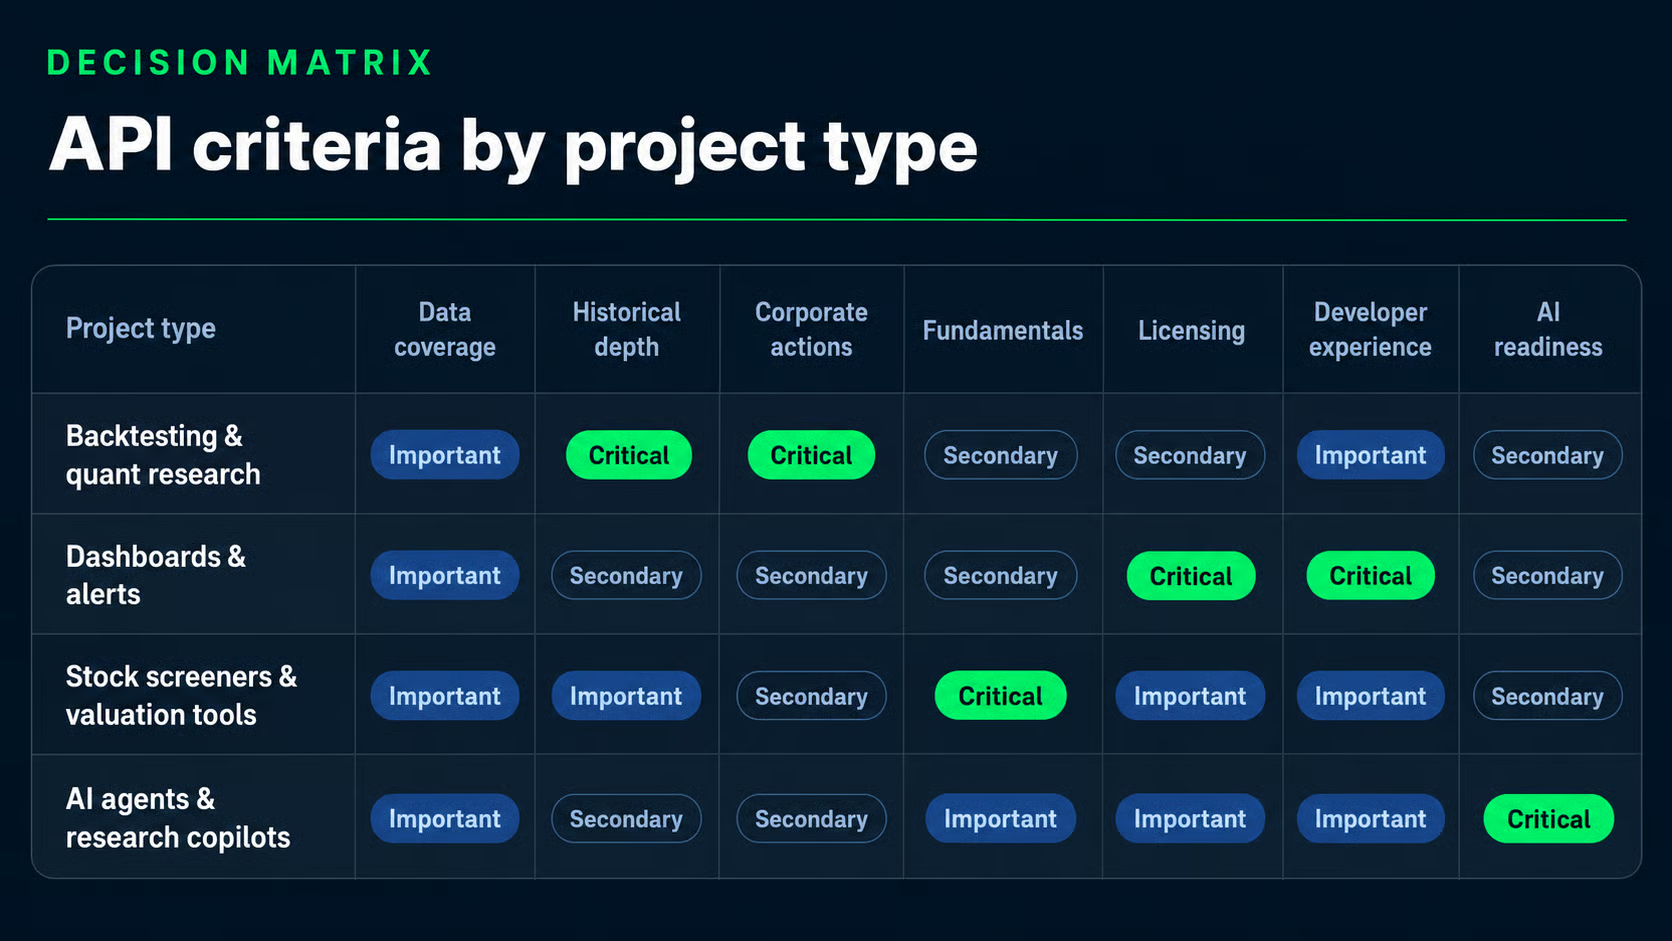
Giờ chúng ta có thể ghép quy trình và tiêu chí đánh giá lại với nhau.
Mục đích của ma trận này không phải xếp hạng nhà cung cấp. Mà là giúp bạn quyết định tiêu chí nào xứng đáng được chú ý nhiều nhất cho dự án bạn đang xây.
|
Loại dự án |
Tiêu chí quan trọng nhất |
Tiêu chí thứ cấp |
Nhà cung cấp nên cân nhắc |
|
Backtesting và nghiên cứu định lượng |
Độ sâu lịch sử, giá đã điều chỉnh và hành động doanh nghiệp |
Sẵn sàng cho AI, cấp phép |
Alpha Vantage cho quy trình lịch sử rộng và chỉ báo; EODHD cho nghiên cứu EOD toàn cầu |
|
Bảng điều khiển và cảnh báo |
Cấp phép, trải nghiệm phản hồi cho dev, giới hạn tốc độ |
Độ sâu lịch sử, số liệu cơ bản |
QuoteMedia cho bảng điều khiển thân thiện nhà phát triển; Xignite cho ứng dụng tài chính doanh nghiệp |
|
Bộ lọc cổ phiếu và công cụ định giá |
Số liệu cơ bản, metadata công ty, tỷ số và báo cáo tài chính |
Độ sâu lịch sử, phạm vi mã |
Alpha Vantage cho quy trình rộng về số liệu cơ bản và giá; Intrinio cho công cụ nặng về số liệu cơ bản tại Mỹ |
|
Tác nhân AI và trợ lý nghiên cứu |
Phản hồi có cấu trúc, truy cập công cụ và sẵn sàng MCP |
Số liệu cơ bản, chỉ báo, cấp phép |
Alpha Vantage cho MCP và độ bao phủ API rộng |
Bảng này cố ý không hoàn hảo. Dự án thực hiếm khi khớp một hàng, và đa số sản phẩm nghiêm túc kết hợp hơn một quy trình.
Với backtester, tôi sẽ bắt đầu từ độ sâu lịch sử và hành động doanh nghiệp trước khi lo báo giá thời gian thực.
Câu hỏi chính không phải, “Tôi có thể lấy lịch sử giá không?” mà là, “Tôi có thể tin lịch sử giá này qua chia tách, cổ tức, thiếu ngày và các chế độ thị trường dài hay không?”
Với quy trình này, kiểm tra:
Dữ liệu thời gian thực có thể quan trọng sau này nếu bạn tiến tới giám sát hoặc thực thi trực tiếp. Với nghiên cứu lịch sử, nó không nên là ưu tiên đầu tiên.
Với trợ lý AI, API phải dễ cho cả mã và mô hình làm việc cùng.
Nhà phát triển có thể xem phản hồi JSON lộn xộn và sửa logic phân tích. Quy trình agent thì khó tính hơn. Nếu schema không thể dự đoán, mô hình có thể gọi đúng công cụ nhưng vẫn khó dùng kết quả.
Với quy trình này, kiểm tra:
Điểm rộng hơn rất đơn giản: chọn API dựa trên mô thức hỏng mà bạn không thể chấp nhận nhất. Backtester hỏng khi lịch sử sai. Bảng điều khiển hỏng khi người dùng không có phản hồi mới. Trợ lý AI hỏng khi lớp truy cập dữ liệu quá lộn xộn để dùng.
Không có stock API nào “tốt nhất” cho mọi dự án. Lựa chọn đúng phụ thuộc vào việc hệ thống của bạn cần làm gì: độ sâu lịch sử cho backtesting, tính mới cho bảng điều khiển, số liệu cơ bản cho bộ lọc, và phản hồi có cấu trúc cho quy trình AI.
Đó cũng là lý do Alpha Vantage là API linh hoạt để dùng xuyên suốt các ví dụ trong bài. Nó bao phủ vài lớp chúng ta đã bàn, gồm dữ liệu thị trường, số liệu cơ bản, chỉ báo kỹ thuật và quy trình AI dựa trên MCP, nên cho phép chúng ta kiểm thử nhiều yếu tố quyết định mà không phải đổi nhà cung cấp.
Tôi sẽ coi stock API là một phần của hạ tầng dữ liệu dự án, không chỉ là tập hợp endpoint. Nó ảnh hưởng đến mã, cơ sở dữ liệu, job làm mới, đầu vào mô hình, trải nghiệm người dùng, và thậm chí cả những gì bạn có thể hiển thị trong sản phẩm cuối.
Nếu bạn muốn xây quy trình tài chính mạnh hơn với Python, tôi khuyên bắt đầu với khóa học Python for Finance của chúng tôi.
Học Phân tích Tài chính bằng Python với DataCamp!
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}