{count, plural, one {Curso} other {Cursos}}
Introdução ao Python para finanças
{hours} h
107.9K
A maioria das comparações de APIs de ações começa do jeito errado.
Elas comparam planos de preço, número de endpoints, páginas de documentação e limites do plano gratuito. Esses detalhes importam, mas não dizem se a API sustenta o sistema que você está construindo.
Um backtest não falha porque o provedor tem menos endpoints do que o concorrente. Ele falha porque os preços históricos não estão ajustados corretamente, o histórico é curto demais ou os eventos corporativos são tratados de forma fraca.
Um dashboard tem outro tipo de falha. Ele quebra quando as cotações demoram a chegar, os campos mudam de forma inesperada ou os limites de taxa viram problema quando os usuários começam a atualizar a página.
Por isso eu trato listas genéricas de “melhor API de ações” como ponto de partida, não como resposta. A pergunta real é: "Essa API ainda vai funcionar quando meu projeto deixar de ser um protótipo?"
Quando uma API sustenta um workflow real, ela vira infraestrutura de dados:
Trocar depois é doloroso porque não é só mudar uma URL de requisição. Você pode ter que reescrever pipelines, jobs de atualização, lógica de armazenamento, ajustar entradas de modelos e revisar partes da interface.
O encerramento do IEX Cloud em 2024 é um lembrete útil. Muitos desenvolvedores e empresas construíram dashboards, apps e ferramentas internas em cima da API. Quando o serviço foi descontinuado, migrar significou repensar endpoints, campos, preços, licenças e premissas de dados.
Antes de comparar provedores, identifique o workflow que a API vai atender. Um backtester e um dashboard podem usar preços de ações, mas não dependem dos mesmos requisitos de dados.
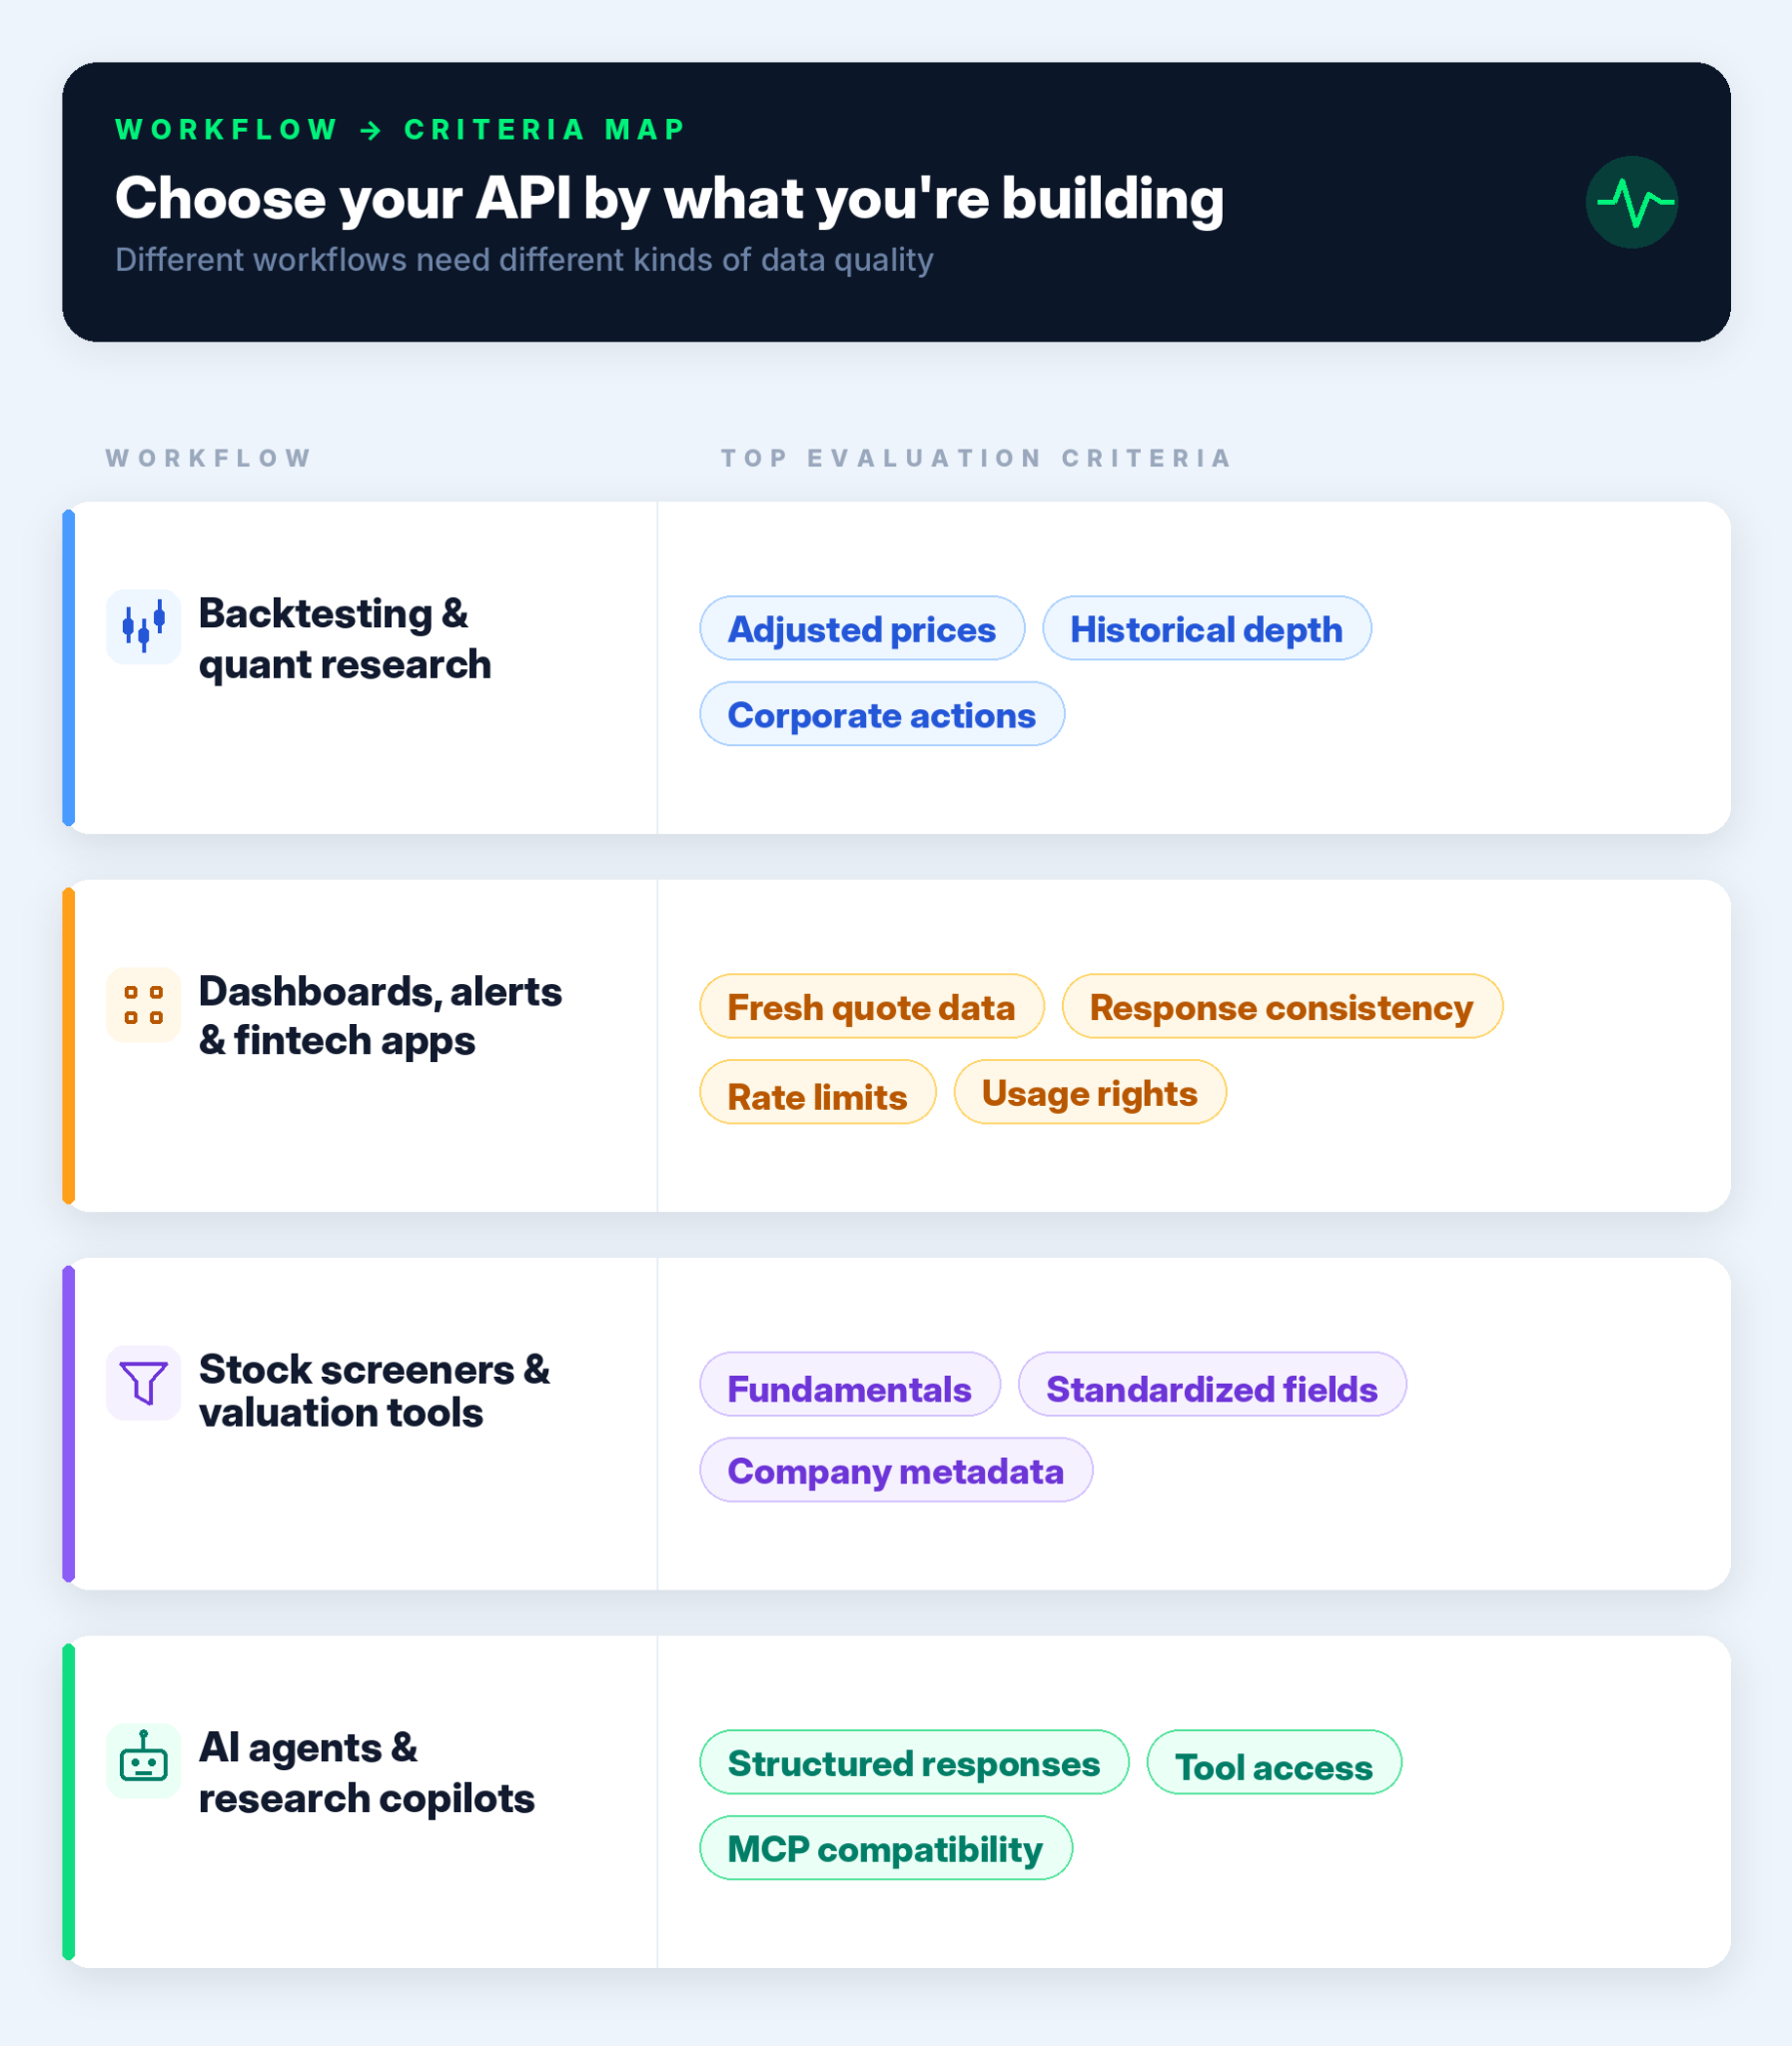
Para backtesting, dados históricos limpos normalmente importam mais do que dados em tempo real.
Critérios principais para checar:
Para se aprofundar na implementação e no teste de estratégias de trading em Python, nosso tutorial Algorithmic Trading in Python detalha conceitos e armadilhas de backtesting.
Dashboards e sistemas de alerta priorizam atualidade, confiabilidade e consistência. Um notebook privado tolera uma requisição com falha ou um nome de campo estranho. Um produto para o usuário final não.
Critérios principais para checar:
Screeners e ferramentas de valuation precisam de dados de negócio, não só de preço. O principal desafio é a comparação, porque geralmente você filtra ou ranqueia muitas empresas ao mesmo tempo.
Critérios principais para checar:
Workflows de IA precisam de APIs que retornem dados estruturados e previsíveis. Um LLM pode resumir texto, mas não deveria “chutar” dados financeiros.
Critérios principais para checar:
Para ir dos dados da API a um agente funcionando, o guia de Model Context Protocol (MCP) mostra como o MCP conecta modelos de IA a ferramentas externas, enquanto os tutoriais Building LangChain Agents e OpenAI Agents SDK mostram isso na prática com Python.
Depois que você entende o workflow, comparar APIs fica mais fácil. Você não pergunta mais “Qual provedor tem mais recursos?”, e sim “Qual provedor aguenta a camada de dados que este projeto precisa?”
|
Critério |
O que checar |
Por que importa |
|
Cobertura de dados |
Classes de ativos, mercados, símbolos e geografia |
A API deve cobrir o universo que seu projeto realmente precisa |
|
Profundidade histórica |
Tamanho do histórico, acesso a histórico completo, dados ajustados e não ajustados |
Backtests e ferramentas de pesquisa precisam de mais do que dados recentes |
|
Qualidade dos dados e eventos corporativos |
Splits, dividendos, mudanças de ticker, linhas ausentes e símbolos obsoletos |
Ajustes ruins distorcem gráficos, retornos e saídas de modelos |
|
Suporte a fundamentos |
Demonstrações, resultados, múltiplos, perfis e metadados |
Screeners e valuation precisam de contexto de negócio, não só preços |
|
Licença e redistribuição |
Direitos de exibição, armazenamento, uso comercial e regras das bolsas |
Usar em notebook é diferente de um produto público ou pago |
|
Experiência do desenvolvedor |
Documentação, formato da resposta, erros, limites de taxa e usabilidade em Python |
APIs limpas economizam tempo depois da primeira requisição |
|
Prontidão para IA e agentes |
Respostas estruturadas, acesso a ferramentas, suporte a MCP e esquemas previsíveis |
Assistentes de IA precisam de dados que consigam recuperar, parsear e raciocinar |
A cobertura deve bater com o projeto, não com a página de marketing.
Cheque:
O erro é escolher o provedor com a maior promessa de cobertura em vez daquele que cobre seu universo real de consultas.
Profundidade histórica importa quando o projeto precisa testar ideias em diferentes condições de mercado.
Cheque:
Há diferença entre “fornecemos preços históricos” e “este dataset é profundo o bastante para testes sérios”.
Aqui é onde dados de ações ficam chatos.
Cheque:
Para lidar com o lado mais bagunçado dos dados financeiros (valores ausentes, campos inconsistentes e formatos), a trilha Importing & Cleaning Data in Python cobre as técnicas essenciais assim que as chamadas à API estiverem funcionando.
Fundamentos importam quando o projeto precisa de contexto de negócio, não só de movimento de preço.
Cheque:
A palavra-chave é consistência. Se você está comparando empresas, os campos precisam funcionar no universo inteiro sem lógica customizada para cada ticker.
Licença é entediante até bloquear o produto.
Cheque:
Prefiro descobrir esses limites antes de escrever o pipeline do que depois de montar o frontend.
Uma API limpa economiza tempo depois da primeira requisição.
Cheque:
A primeira chamada bem-sucedida não é o teste real. O teste real é se a API continua parecendo limpa depois que você adiciona jobs de refresh, tratamento de erros e joins com outros datasets.
Workflows de IA precisam de acesso a dados previsível.
Cheque:
A API não precisa ser “nativa de IA” para todo uso. Mas se você está construindo um assistente de pesquisa financeira, a camada de dados deve ser fácil para o código em Python e para as ferramentas de IA.
Nosso tutorial Codex CLI MCP traz um exemplo concreto em finanças, criando um agente de dashboard de portfólio ao vivo usando dados da Alpha Vantage via um workflow MCP.
Os critérios acima são úteis, mas eu não escolheria um provedor só por checklist. Eu testaria a API contra os modos de falha que importam para o projeto.
Nos exemplo
s abaixo, vou usar a Alpha Vantage porqu
e ela oferece preços históricos, cotações ao vivo, fundamentos, indicadores técnicos e opções para workflows de IA em um só lugar. A ideia é verificar se a API atende a requisitos reais sem gerar trabalho excessivo de limpeza.
Para um backtester, este é um dos primeiros checks que eu faria. Se uma série de preços não trata splits de forma limpa, todo cálculo de retorno construído em cima dela fica questionável.
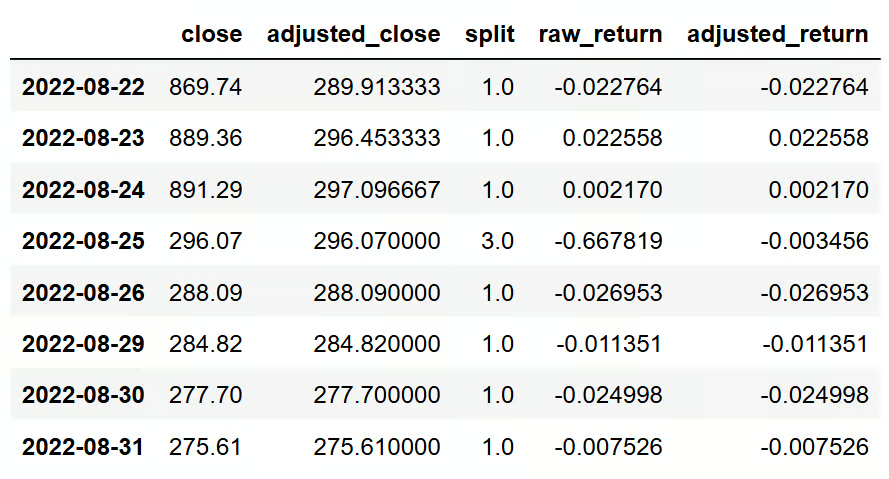
O código abaixo puxa os preços diários ajustados da Tesla ao redor do split de 2022 e compara retornos brutos com retornos ajustados.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Aqui está a saída:
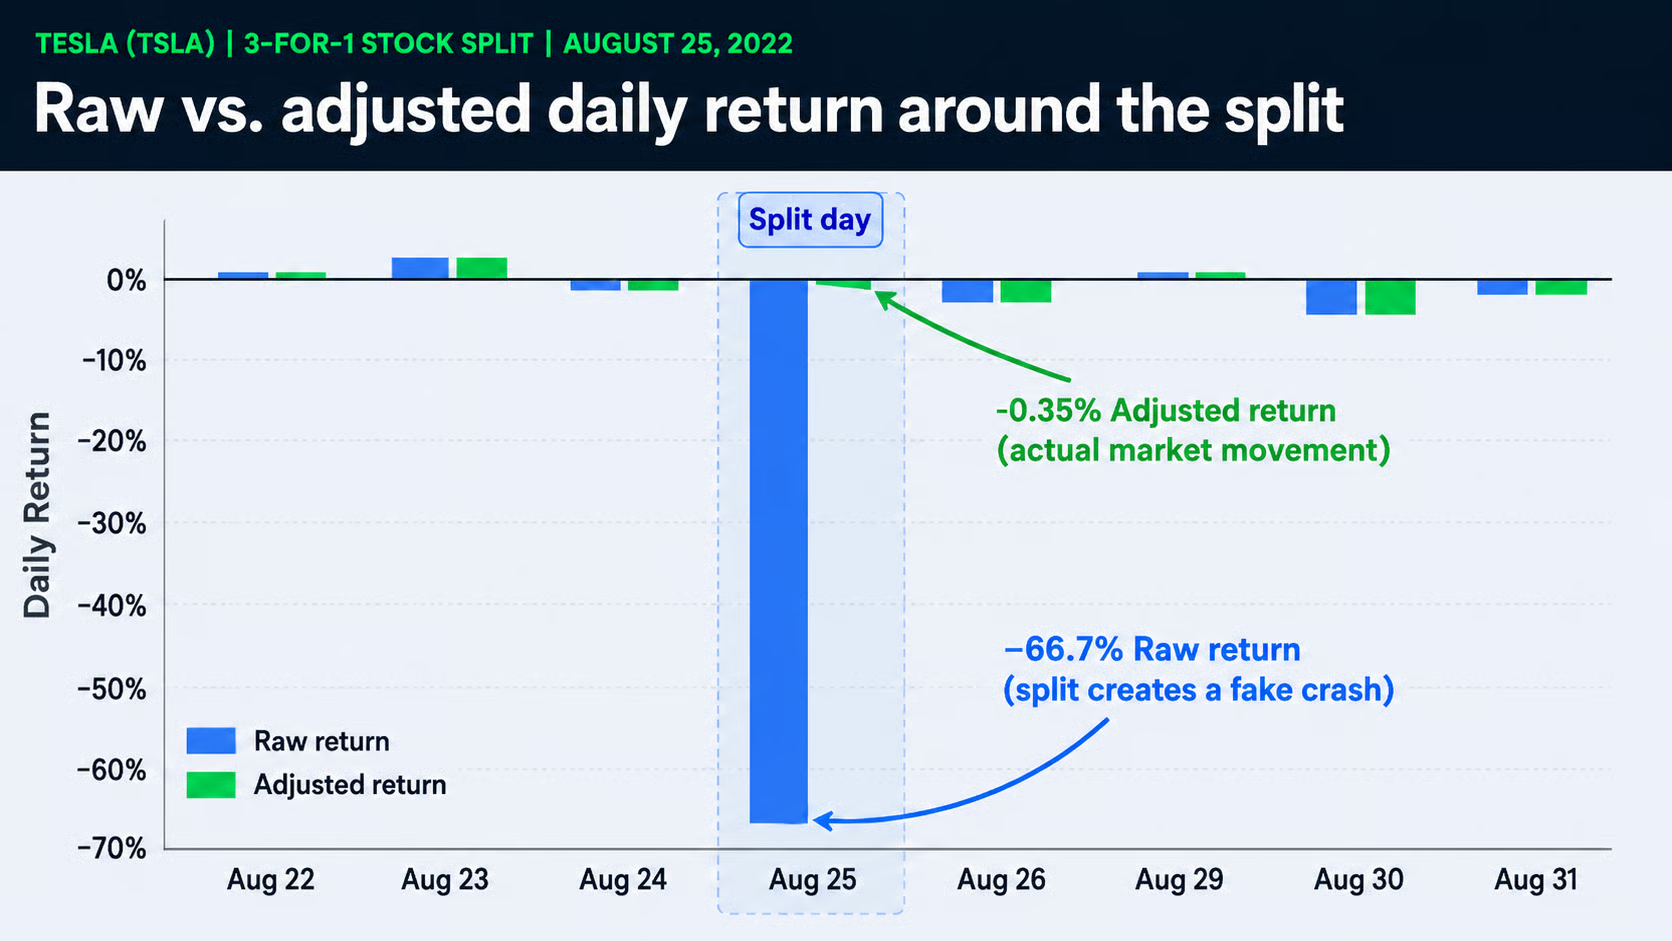
É exatamente por isso que dados ajustados importam.
O fechamento bruto sugere uma queda de 66,7% em 25 de agosto de 2022. Não foi um crash real. Foi o split 3-por-1 da Tesla aparecendo na série de preços brutos.
O retorno ajustado no mesmo dia fica em torno de -0,35%, bem mais próximo do movimento real de mercado após considerar o split.
Esse check simples mostra se a API oferece os campos necessários para capturar um problema comum de backtesting. Uma lista longa de recursos não mostra isso.
Um dashboard ou sistema de alertas não precisa só de dados. Precisa de requisições que falhem de forma clara.
Este helper adiciona um padrão simples de retry e checa problemas comuns de resposta da API. Não é infraestrutura de produção, mas basta para testar se a API se comporta de forma previsível quando algo dá errado.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
Este é o tipo de check que eu adicionaria antes de confiar em uma API dentro de um dashboard ou job agendado.
O importante não é o número de tentativas. É seu código conseguir diferenciar símbolo inválido, resposta vazia, mensagem de rate limit e falha temporária. Se toda falha parece igual, depurar vira sofrimento quando o projeto tem usuários.
Para screeners, valuation e assistentes de IA, eu testaria se a API consegue produzir um objeto de pesquisa limpo a partir de múltiplos endpoints.
O exemplo abaixo puxa a cotação e o overview da Apple e transforma o resultado em um dicionário compacto. Isso se aproxima do que um card de dashboard, uma linha de screener ou a resposta de uma ferramenta de IA precisariam.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
A saída fica assim:
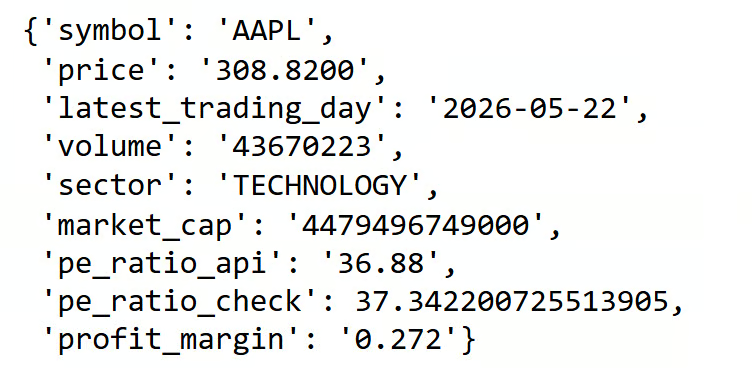
O P/L reportado pela API e nosso cálculo simples de preço/EPS não são idênticos, o que é normal porque provedores podem usar convenções de tempo ou insumos ajustados diferentes. Mas a comparação ainda é útil, pois mostra se os campos são utilizáveis de forma direcional.
Esse teste não é útil só para backtesting:
Esse último ponto importa. MCP ou tool calling não consertam dados bagunçados por mágica. A API ainda precisa retornar campos que virem um objeto previsível. Se cada endpoint exige limpeza customizada, o workflow do agente fica frágil rapidinho.
O teste prático é simples: você consegue puxar os dados, validá-los, calcular uma métrica básica e retornar algo que outra parte do sistema consiga usar? Se sim, a API está bem mais perto de ser útil além do primeiro notebook.
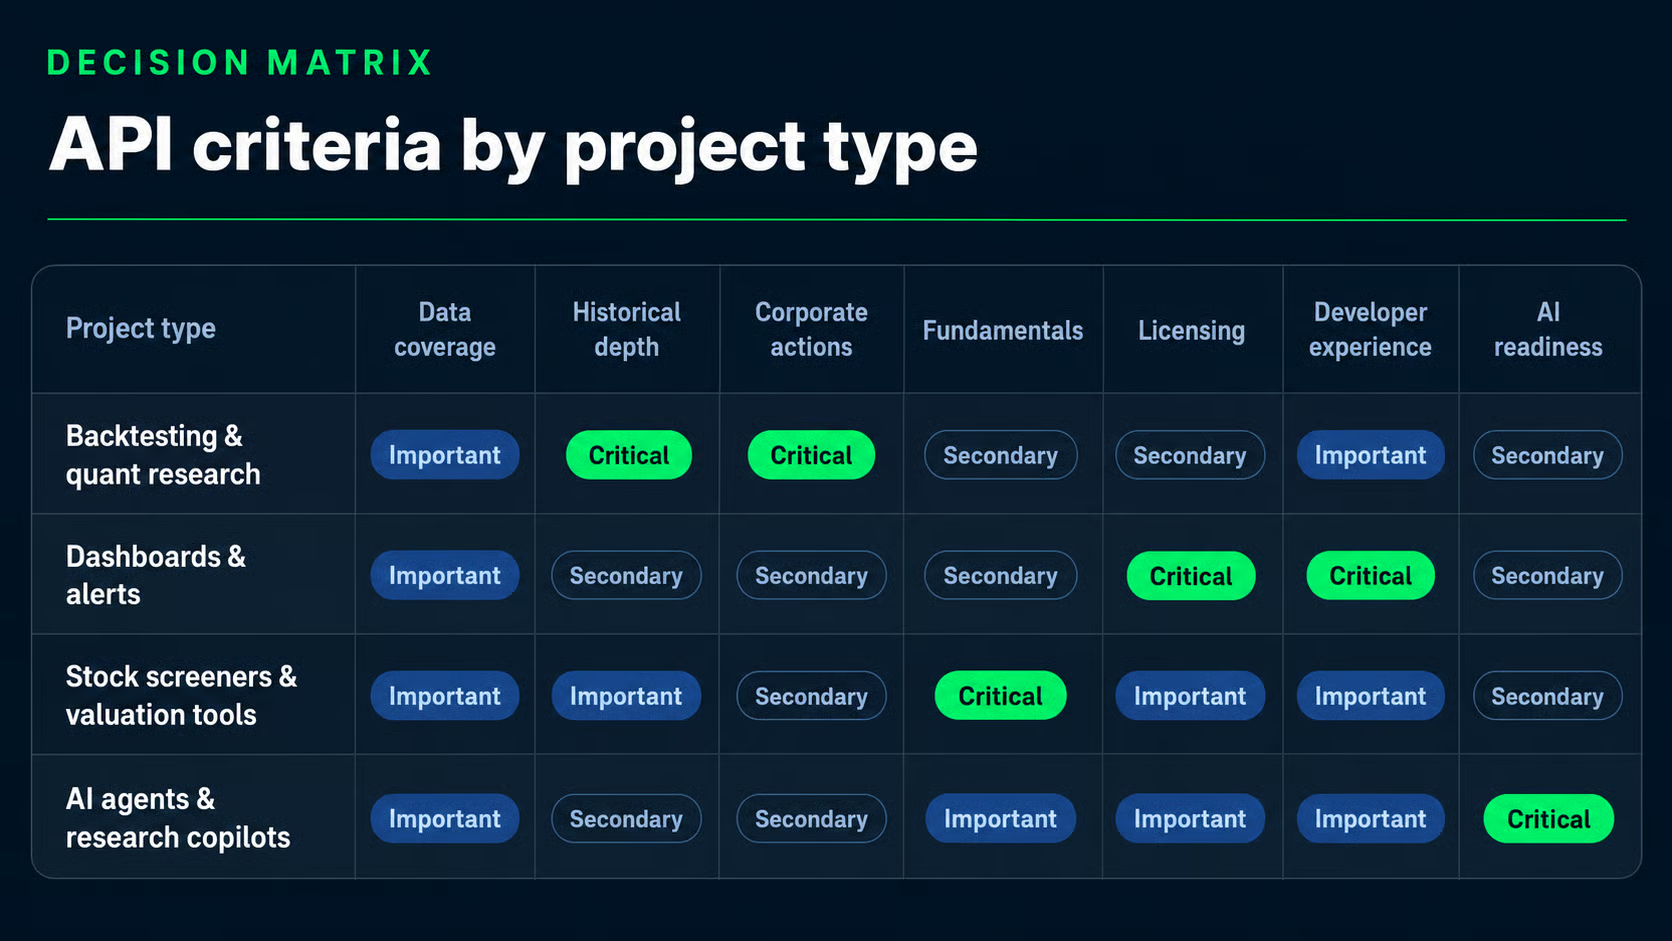
Agora dá para juntar o workflow com os critérios de avaliação.
O objetivo desta matriz não é ranquear provedores. É ajudar você a decidir quais critérios merecem mais atenção no projeto que está construindo.
|
Tipo de projeto |
Critérios mais importantes |
Critérios secundários |
Provedores a considerar |
|
Backtesting e pesquisa quant |
Profundidade histórica, preços ajustados e eventos corporativos |
Prontidão para IA, licenciamento |
Alpha Vantage para workflows amplos de histórico e indicadores; EODHD para pesquisa EOD global |
|
Dashboards e alertas |
Licenciamento, experiência do desenvolvedor na resposta, limites de taxa |
Profundidade histórica, fundamentos |
QuoteMedia para dashboards developer-friendly; Xignite para apps financeiros enterprise |
|
Screeners e ferramentas de valuation |
Fundamentos, metadados da empresa, múltiplos e demonstrações financeiras |
Profundidade histórica, cobertura de símbolos |
Alpha Vantage para workflows amplos de fundamentos e preços; Intrinio para ferramentas com foco em fundamentos nos EUA |
|
Agentes de IA e copilotos de pesquisa |
Respostas estruturadas, acesso a ferramentas e prontidão para MCP |
Fundamentos, indicadores, licenciamento |
Alpha Vantage para MCP e ampla cobertura de API |
Esta t
abela é propositalmente imperfeita. Projetos reais raramente cabem em uma linha só, e produtos sérios combinam mais de um workflow.
Para um backtester, eu começaria por profundidade histórica e eventos corporativos antes de me preocupar com cotações ao vivo.
A pergunta-chave não é “Consigo buscar histórico de preços?”, e sim “Posso confiar nesse histórico diante de splits, dividendos, datas ausentes e regimes longos de mercado?”
Para este workflow, cheque:
Dados em tempo real podem importar depois, se você avançar para monitoramento ou execução. Para pesquisa histórica, não deveria ser prioridade.
Para um assistente de IA, a API precisa ser fácil tanto para o código quanto para o modelo.
Um desenvolvedor humano inspeciona um JSON bagunçado e arruma o parsing. Um agente é menos tolerante. Se o schema é imprevisível, o modelo pode chamar a ferramenta certa e ainda assim sofrer para usar o resultado.
Para este workflow, cheque:
O ponto mais amplo é simples: escolha a API com base no modo de falha que você menos pode tolerar. Um backtester falha quando o histórico está errado. Um dashboard falha quando o usuário não recebe respostas atualizadas. Um assistente de IA falha quando a camada de acesso a dados é bagunçada demais para usar.
Não existe uma única melhor API de ações para todo projeto. A escolha certa depende do que seu sistema precisa fazer: profundidade histórica para backtesting, atualidade para dashboards, fundamentos para screeners e respostas estruturadas para workflows de IA.
É também por isso que a Alpha Vantage foi uma API versátil nos exemplos deste artigo. Ela cobre várias camadas que discutimos, incluindo dados de mercado, fundamentos, indicadores técnicos e workflows de IA baseados em MCP, permitindo testar mais de um fator de decisão sem trocar de provedor.
Eu trataria uma API de ações como parte da infraestrutura de dados do projeto, não só um conjunto de endpoints. Ela afeta seu código, banco, jobs de atualização, entradas de modelos, experiência do usuário e até o que você pode exibir no produto final.
Se você quer fortalecer seus workflows de finanças em Python, recomendo começar pelo nosso curso Python for Finance.
Aprenda análise financeira em Python com a DataCamp!
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Armstrong Asenavi
15 min
{count, plural, one {blog} other {blogs}}
{count, plural, one {Tutorial} other {Tutoriais}}
Thushan Ganegedara
15 min
{count, plural, one {Tutorial} other {Tutoriais}}
Joleen Bothma
9 min
{count, plural, one {Tutorial} other {Tutoriais}}
Adel Nehme
9 min
{count, plural, one {Tutorial} other {Tutoriais}}
Abid Ali Awan
6 min



