{count, plural, one {Cours} other {Cours}}
Introduction à Python pour la finance
{hours} h
107.9K
La plupart des comparatifs commencent par le mauvais bout.
Ils comparent les grilles tarifaires, le nombre d'endpoints, les pages de documentation et les limites des plans gratuits. Ces détails comptent, mais ils ne disent pas si l'API peut soutenir le système que vous construisez.
Un backtest n'échoue pas parce que le fournisseur a moins d'endpoints qu'un concurrent. Il échoue parce que les prix historiques ne sont pas correctement ajustés, l'historique est trop court, ou les opérations sur titres sont mal gérées.
Un tableau de bord a un autre mode de panne. Il casse quand les réponses de cotations sont lentes, que les champs changent de manière inattendue, ou que les limites de débit posent problème dès que les utilisateurs rafraîchissent la page.
C'est pourquoi je considère les listes génériques des « meilleures APIs boursières » comme des points de départ, pas des réponses. La vraie question est : « Cette API tiendra-t-elle la route quand mon projet ne sera plus un prototype ? »
Dès qu'une API alimente un vrai workflow, elle devient de l'infrastructure data :
Changer plus tard est douloureux car vous ne modifiez pas seulement une URL de requête. Vous devrez peut-être réécrire des pipelines, des jobs de rafraîchissement, mettre à jour la logique de stockage, ajuster les entrées des modèles et revoir des pans de l'interface.
La fermeture d'IEX Cloud en 2024 en est un bon rappel. De nombreux développeurs et entreprises avaient bâti des dashboards, apps et outils internes autour de son API. Une fois le service arrêté, la migration a impliqué de repenser endpoints, champs, prix, licences et hypothèses de données.
Avant de comparer les fournisseurs, identifiez le workflow que l'API devra soutenir. Un backtester et un tableau de bord utilisent tous deux des cours, mais n'ont pas les mêmes exigences de données.
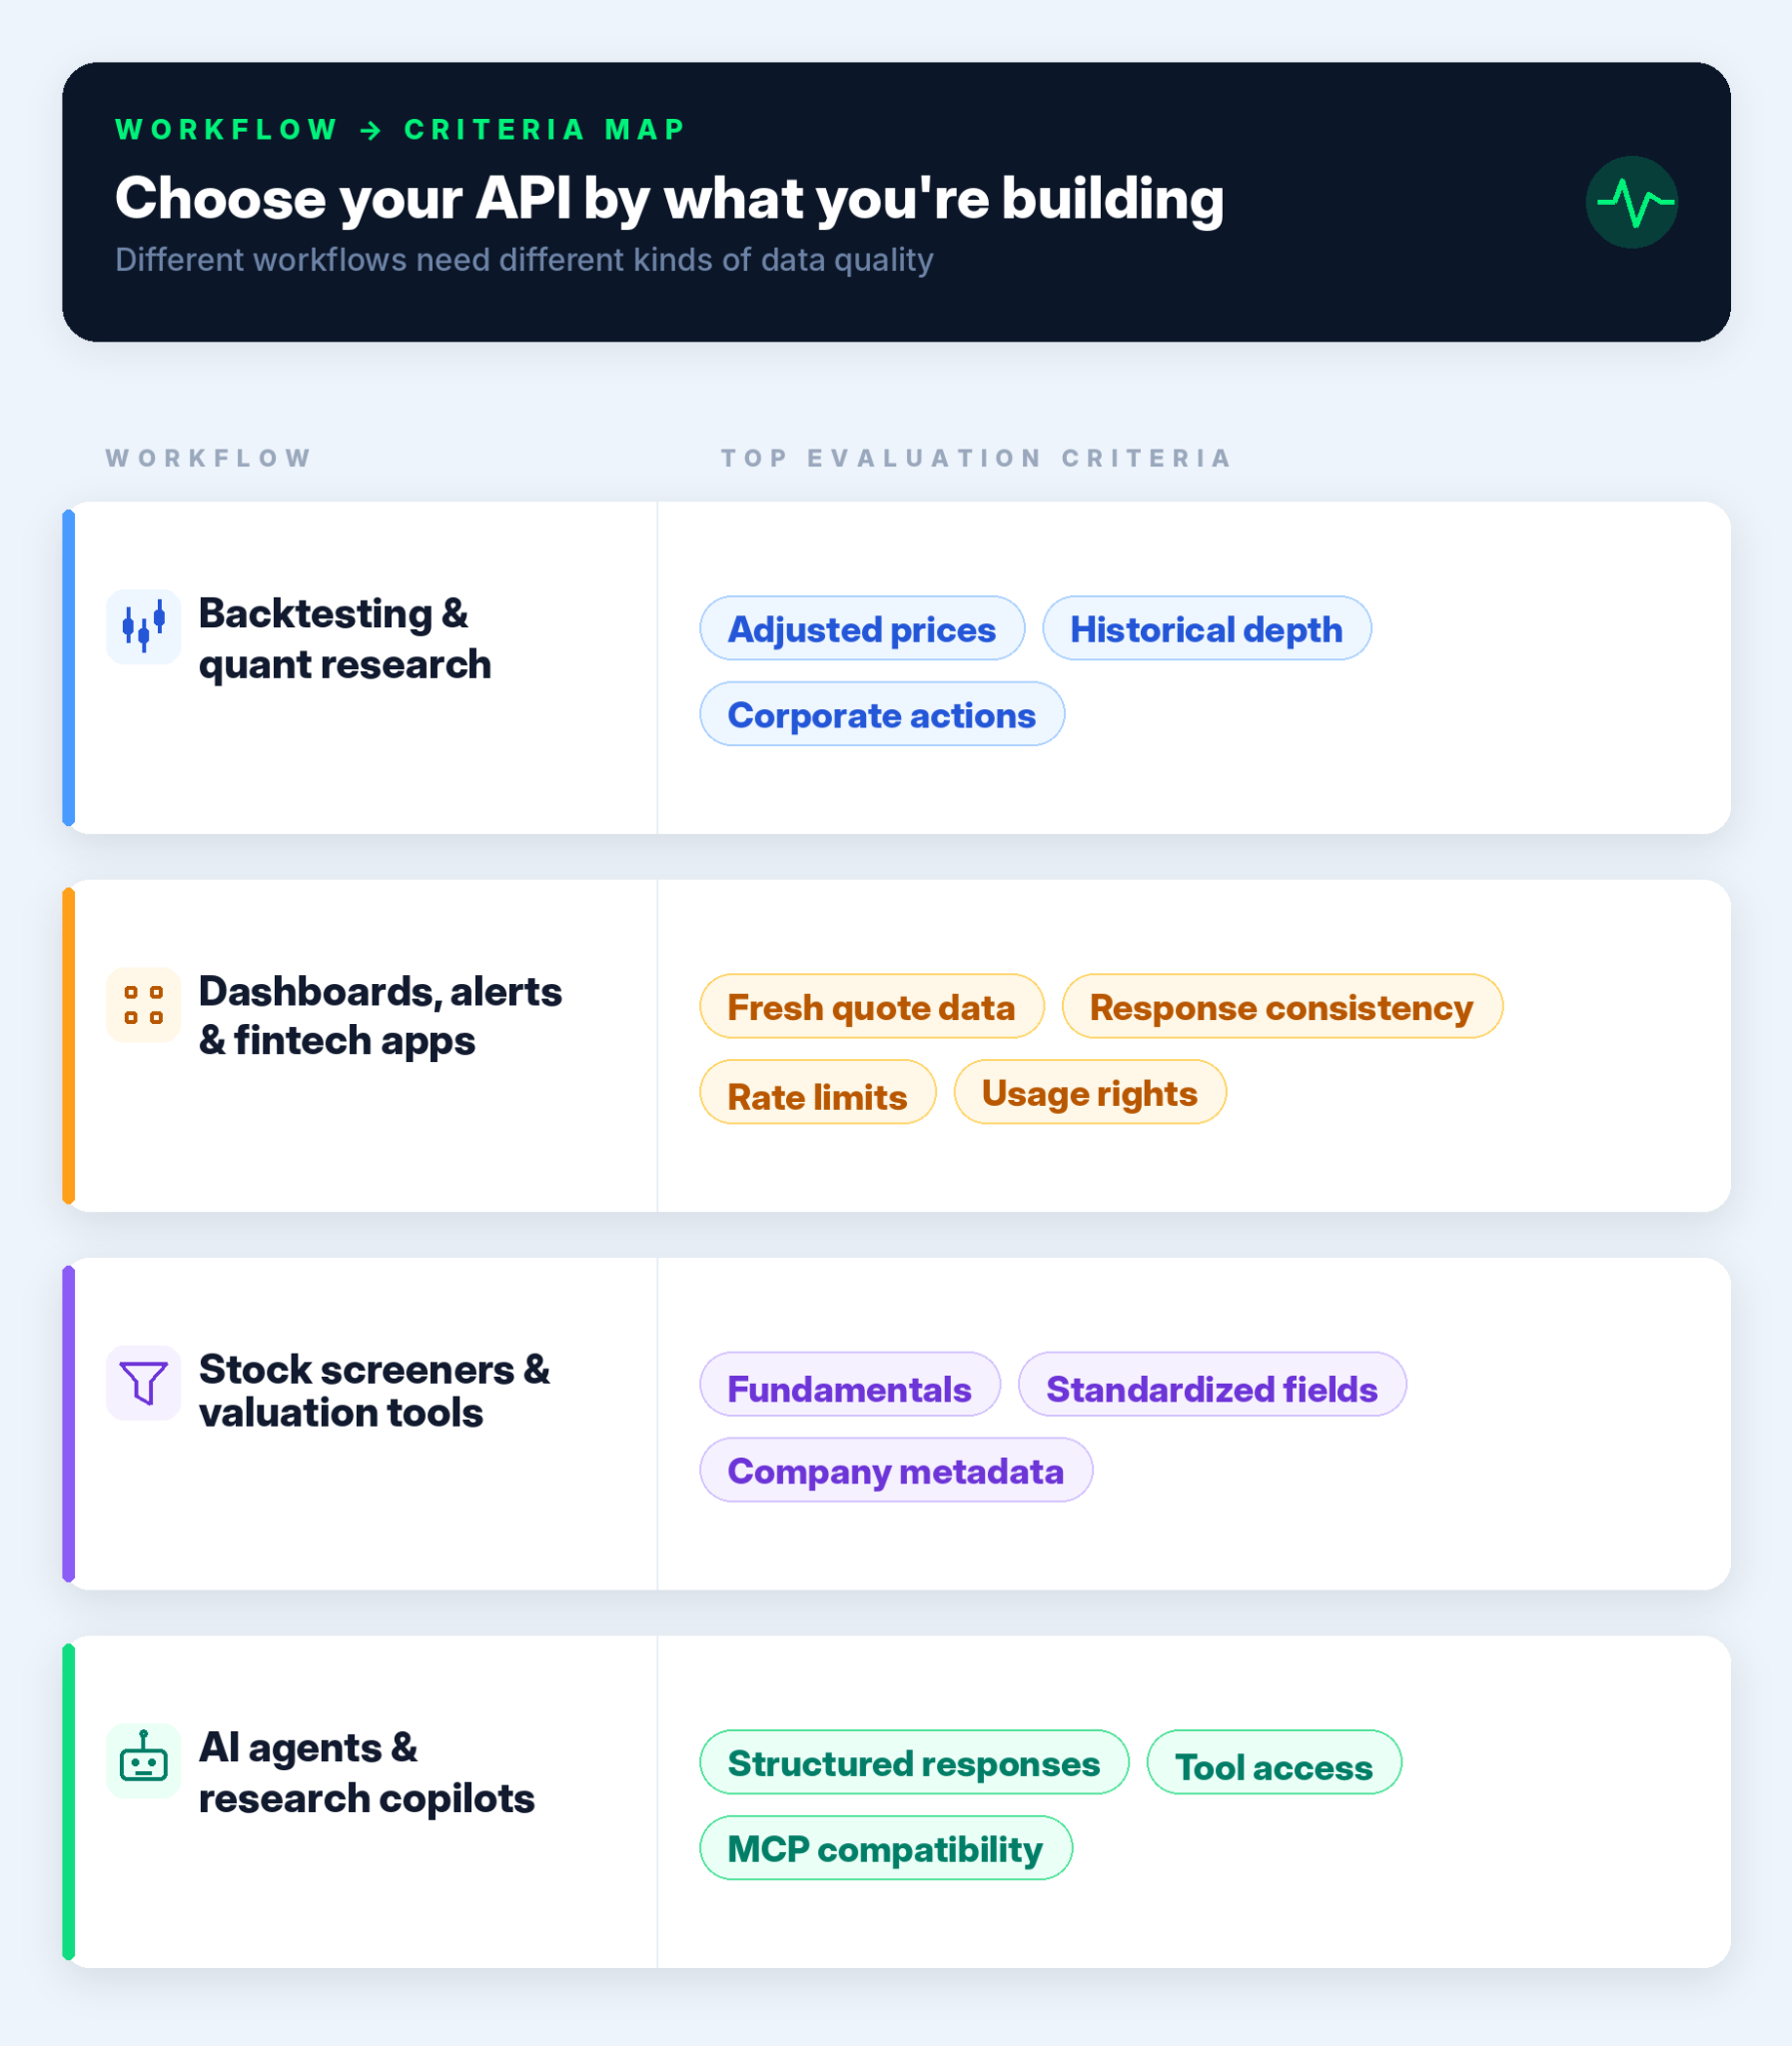
Pour le backtesting, des historiques propres comptent souvent plus que des données live.
Critères clés à vérifier :
Pour aller plus loin dans l'implémentation et le test de stratégies de trading en Python, notre tutoriel Algorithmic Trading in Python détaille les concepts de backtesting et les écueils à éviter.
Les tableaux de bord et systèmes d'alerte privilégient fraîcheur, fiabilité et constance. Un notebook privé tolère une requête échouée ou un champ mal nommé. Un produit face à l'utilisateur, non.
Critères clés à vérifier :
Les screeners et outils de valorisation nécessitent des données business, pas seulement des prix. Le principal défi est la comparaison, car vous filtrez ou classez souvent de nombreuses sociétés à la fois.
Critères clés à vérifier :
Les workflows IA exigent des APIs qui renvoient des données structurées et prévisibles. Un LLM peut résumer du texte, mais ne doit pas deviner des données financières.
Critères clés à vérifier :
Pour passer des données d'API à un agent opérationnel, le guide sur le Model Context Protocol (MCP) explique comment MCP relie les modèles d'IA aux outils externes, tandis que les tutoriels Building LangChain Agents et OpenAI Agents SDK montrent la mise en pratique en Python.
Une fois le workflow identifié, comparer les APIs devient plus simple. Vous ne demandez plus « Quel fournisseur a le plus de fonctions ? », mais « Quel fournisseur peut soutenir la couche données dont ce projet a besoin ? »
|
Critère |
À vérifier |
Pourquoi c'est important |
|
Couverture des données |
Classes d'actifs, marchés, symboles et zones géographiques |
L'API doit couvrir l'univers dont votre projet a réellement besoin |
|
Profondeur historique |
Longueur d'historique, accès full-history, données ajustées et non ajustées |
Les backtests et outils de recherche ont besoin de plus que des données récentes |
|
Qualité des données et opérations sur titres |
Splits, dividendes, changements de ticker, lignes manquantes et symboles obsolètes |
De mauvais ajustements faussent graphiques, rendements et sorties de modèles |
|
Support des fondamentaux |
États financiers, bénéfices, ratios, profils et métadonnées d'entreprise |
Screeners et outils de valorisation ont besoin de contexte business, pas seulement des prix |
|
Licences et redistribution |
Droits d'affichage, de stockage, usage commercial et règles des places |
Un usage en notebook diffère d'un produit public ou payant |
|
Expérience développeur |
Documentation, format de réponse, erreurs, limites de débit et utilisabilité Python |
Des APIs propres font gagner du temps au-delà de la première requête |
|
Préparation IA et agents |
Réponses structurées, accès aux outils, support MCP et schémas prévisibles |
Les assistants IA ont besoin de données récupérables, parseables et exploitables |
La couverture doit correspondre au projet, pas à la page marketing.
À vérifier :
L'erreur, c'est de choisir le fournisseur avec la revendication de couverture la plus large plutôt que celui qui couvre votre univers de requêtes réel.
La profondeur historique est essentielle si le projet doit tester des idées sur différentes conditions de marché.
À vérifier :
Il y a une différence entre « nous fournissons des prix historiques » et « ce jeu de données est suffisamment profond pour des tests sérieux ».
C'est là que les données boursières deviennent pénibles.
À vérifier :
Pour gérer le côté plus « sale » des données financières (valeurs manquantes, champs incohérents, problèmes de format), le parcours Importing & Cleaning Data in Python couvre les techniques clés dès que les appels API fonctionnent.
Les fondamentaux comptent lorsque le projet a besoin de contexte business, pas seulement de mouvements de prix.
À vérifier :
Le maître-mot est la cohérence. Si vous comparez des sociétés, les champs doivent fonctionner sur tout l'univers sans logique sur mesure pour chaque ticker.
Les licences sont ennuyeuses… jusqu'à bloquer le produit.
À vérifier :
Mieux vaut découvrir ces limites avant d'écrire le pipeline que après avoir construit le frontend.
Une API propre fait gagner du temps après la première requête.
À vérifier :
La première requête réussie n'est pas le vrai test. Le vrai test, c'est si l'API reste « propre » après ajout de jobs de rafraîchissement, gestion des erreurs et jointures avec d'autres jeux de données.
Les workflows IA exigent un accès aux données prévisible.
À vérifier :
L'API n'a pas besoin d'être « AI-native » pour tous les cas. Mais si vous construisez un assistant de recherche financière, la couche data doit être facile à manipuler autant pour du code Python que pour des outils IA.
Notre tutoriel Codex CLI MCP illustre cela concrètement dans un contexte finance, en construisant un agent de tableau de bord de portefeuille live utilisant les données Alpha Vantage via un workflow MCP.
Ces critères sont utiles, mais je ne choisirais pas un fournisseur sur la seule base d'une checklist. Je testerais l'API face aux modes d'échec critiques pour le projet.
Dans les exemples ci-dessous, j'utilise Alpha Vantage car il propose en un seul endroit prix historiques, cotations live, fondamentaux, indicateurs techniques et options pour workflows IA. L'objectif est de vérifier que l'API répond aux exigences réelles sans exiger trop de nettoyage.
Pour un backtester, c'est l'un des premiers contrôles. Si une série de prix gère mal les splits, tout calcul de rendement construit dessus devient discutable.
Le code ci-dessous récupère les cours quotidiens ajustés de Tesla autour de son split de 2022 et compare les rendements bruts aux rendements ajustés.
import requests
import pandas as pd
import time
api_key = 'YOUR ALPHA VANTAGE API KEY'
url = f'https://www.alphavantage.co/query?function=TIME_SERIES_DAILY_ADJUSTED&symbol=TSLA&outputsize=full&apikey={api_key}'
response = requests.get(url)
data = response.json()
tsla = pd.DataFrame(data['Time Series (Daily)']).T
tsla.index = pd.to_datetime(tsla.index)
tsla = tsla.sort_index()
tsla = tsla.rename(columns={
    '4. close': 'close',
    '5. adjusted close': 'adjusted_close',
    '7. dividend amount': 'dividend',
    '8. split coefficient': 'split'
})
cols = ['close', 'adjusted_close', 'dividend', 'split']
tsla[cols] = tsla[cols].astype(float)
tsla['raw_return'] = tsla['close'].pct_change()
tsla['adjusted_return'] = tsla['adjusted_close'].pct_change()
tsla.loc['2022-08-22':'2022-08-31', ['close', 'adjusted_close', 'split', 'raw_return', 'adjusted_return']]
Voici la sortie :
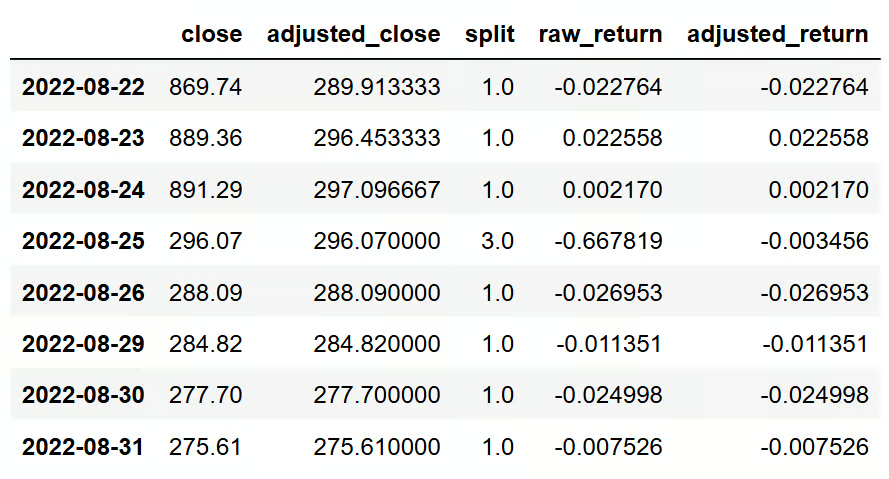
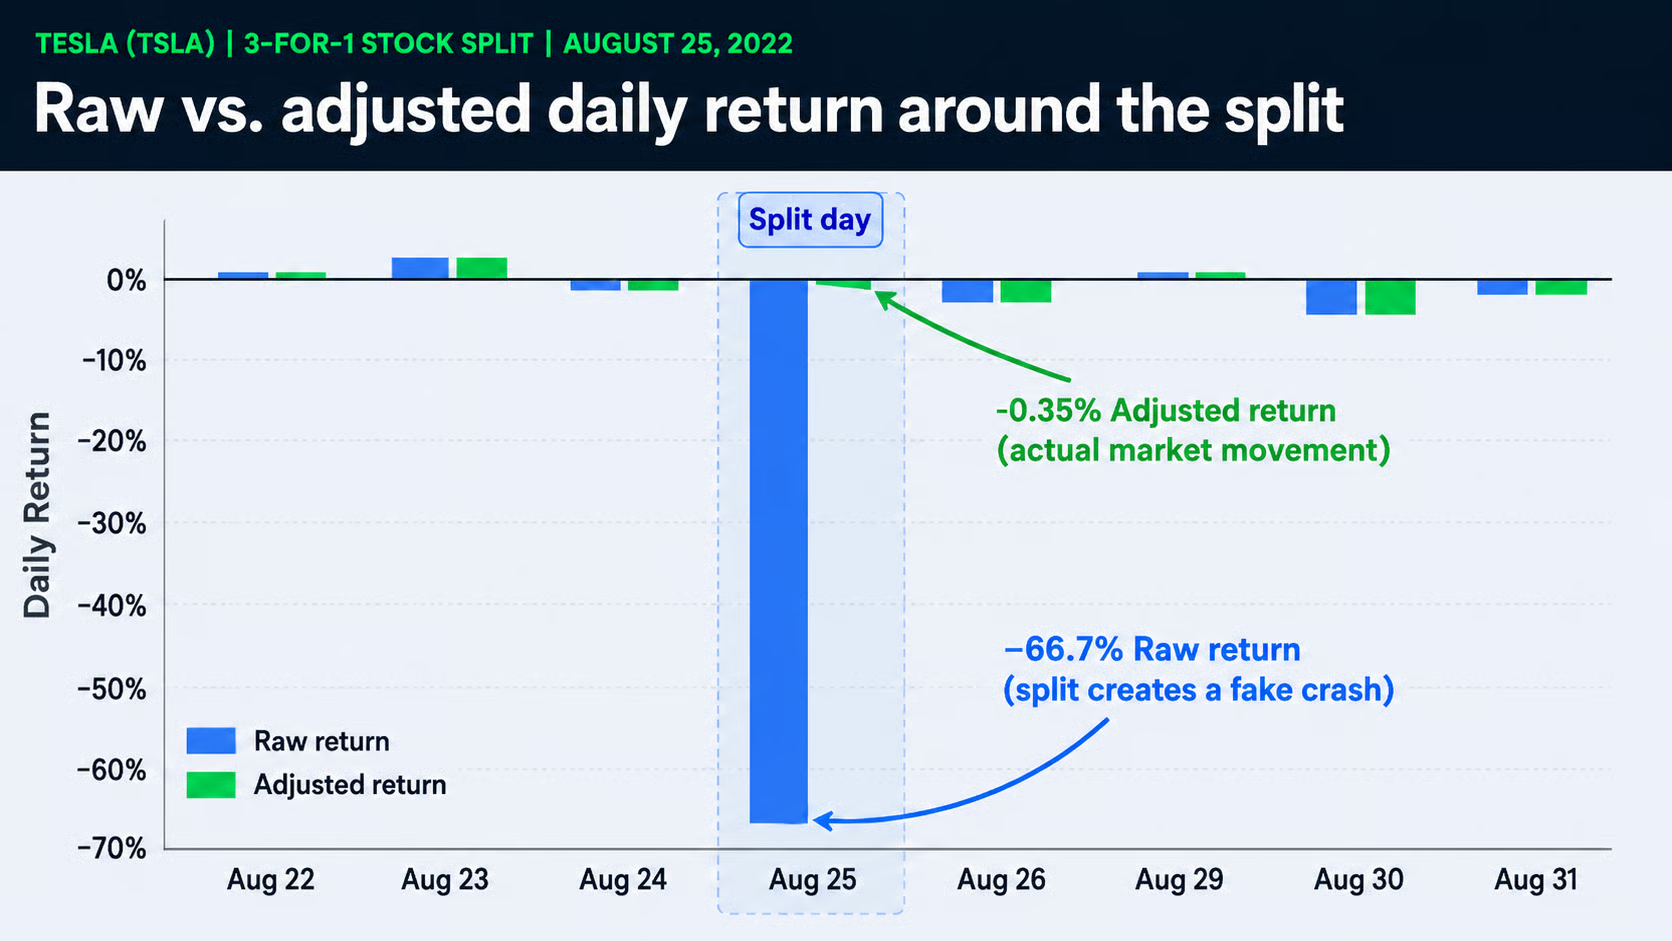
C'est exactement pourquoi les données ajustées comptent.
Le cours brut suggère une baisse de 66,7 % le 25 août 2022. Ce n'était pas un vrai krach : c'est le split 3‑pour‑1 de Tesla qui apparaît dans la série brute.
Le rendement ajusté du même jour est d'environ ‑0,35 %, bien plus proche du mouvement réel une fois le split pris en compte.
Ce petit test montre si l'API fournit les champs nécessaires pour détecter un problème classique de backtesting. Une longue liste de fonctionnalités ne vous dira pas cela.
Un dashboard ou un système d'alerte a besoin de plus que de données : il a besoin de requêtes qui échouent clairement.
Ce helper ajoute un schéma simple de retry et vérifie des problèmes de réponse courants. Ce n'est pas une infra de production, mais suffisant pour tester si une API se comporte de manière prévisible quand quelque chose se passe mal.
def get_json(url, retries=3, wait=10):
    for i in range(retries):
        try:
            response = requests.get(url, timeout=20)
            data = response.json()
            if 'Error Message' in data:
                raise ValueError(data['Error Message'])
            if 'Note' in data:
                print('API note:', data['Note'])
                time.sleep(wait)
                continue
            if not data:
                raise ValueError('Empty response')
            return data
        except Exception as e:
            print(f'Attempt {i + 1} failed:', e)
            time.sleep(wait)
    return None
C'est le genre de contrôle que j'ajouterais avant de faire confiance à une API dans un dashboard ou un job planifié.
L'important n'est pas le nombre de tentatives. C'est la capacité de votre code à distinguer un mauvais symbole, une réponse vide, un message de rate limit et une défaillance temporaire. Si tous les échecs se ressemblent, le débogage devient pénible dès que le projet a des utilisateurs.
Pour les screeners, outils de valorisation et assistants IA, je testerais la capacité de l'API à produire un objet de recherche propre à partir de plusieurs endpoints.
L'exemple ci-dessous récupère une cotation et un aperçu société pour Apple, puis transforme le résultat en dictionnaire compact. C'est proche de ce qu'exigerait une carte de dashboard, une ligne de screener ou la réponse d'un outil IA.
def get_research_snapshot(symbol):
    quote_url = f'https://www.alphavantage.co/query?function=GLOBAL_QUOTE&symbol={symbol}&apikey={api_key}'
    overview_url = f'https://www.alphavantage.co/query?function=OVERVIEW&symbol={symbol}&apikey={api_key}'
    quote_data = get_json(quote_url)
    overview = get_json(overview_url)
    quote = quote_data.get('Global Quote', {}) if quote_data else {}
    price = quote.get('05. price')
    eps = overview.get('EPS') if overview else None
    pe_check = None
    if price and eps:
        pe_check = float(price) / float(eps)
    return {
        'symbol': symbol,
        'price': price,
        'latest_trading_day': quote.get('07. latest trading day'),
        'volume': quote.get('06. volume'),
        'sector': overview.get('Sector') if overview else None,
        'market_cap': overview.get('MarketCapitalization') if overview else None,
        'pe_ratio_api': overview.get('PERatio') if overview else None,
        'pe_ratio_check': pe_check,
        'profit_margin': overview.get('ProfitMargin') if overview else None
    }
snapshot = get_research_snapshot('AAPL')
snapshot
La sortie ressemble à ceci :
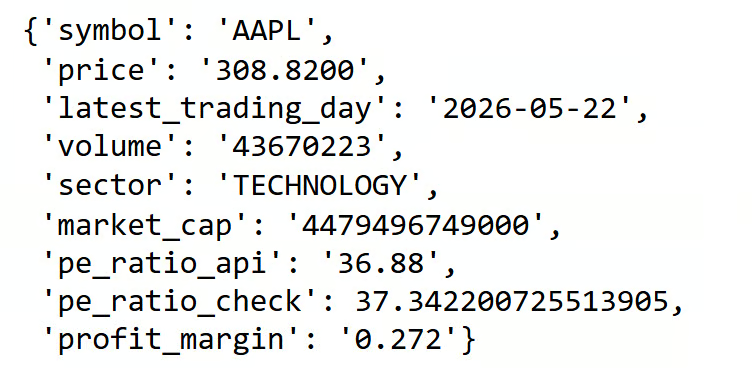
Le PER rapporté par l'API et notre calcul simple prix/EPS ne sont pas identiques, ce qui est normal car les fournisseurs peuvent utiliser des conventions temporelles ou des ajustements différents. Mais la comparaison reste utile : elle indique si les champs sont exploitables dans le bon ordre de grandeur.
Ce test n'est pas utile que pour le backtesting :
Ce dernier point est crucial. MCP ou le tool calling ne « réparent » pas des données désordonnées. L'API doit renvoyer des champs transformables en objet prévisible. Si chaque endpoint exige un nettoyage spécifique, le workflow d'agent deviendra vite fragile.
Le test pratique est simple : pouvez-vous extraire la donnée, la valider, calculer une métrique de base et retourner quelque chose qu'un autre module peut utiliser ? Si oui, l'API est bien plus proche d'être utile au-delà du premier notebook.
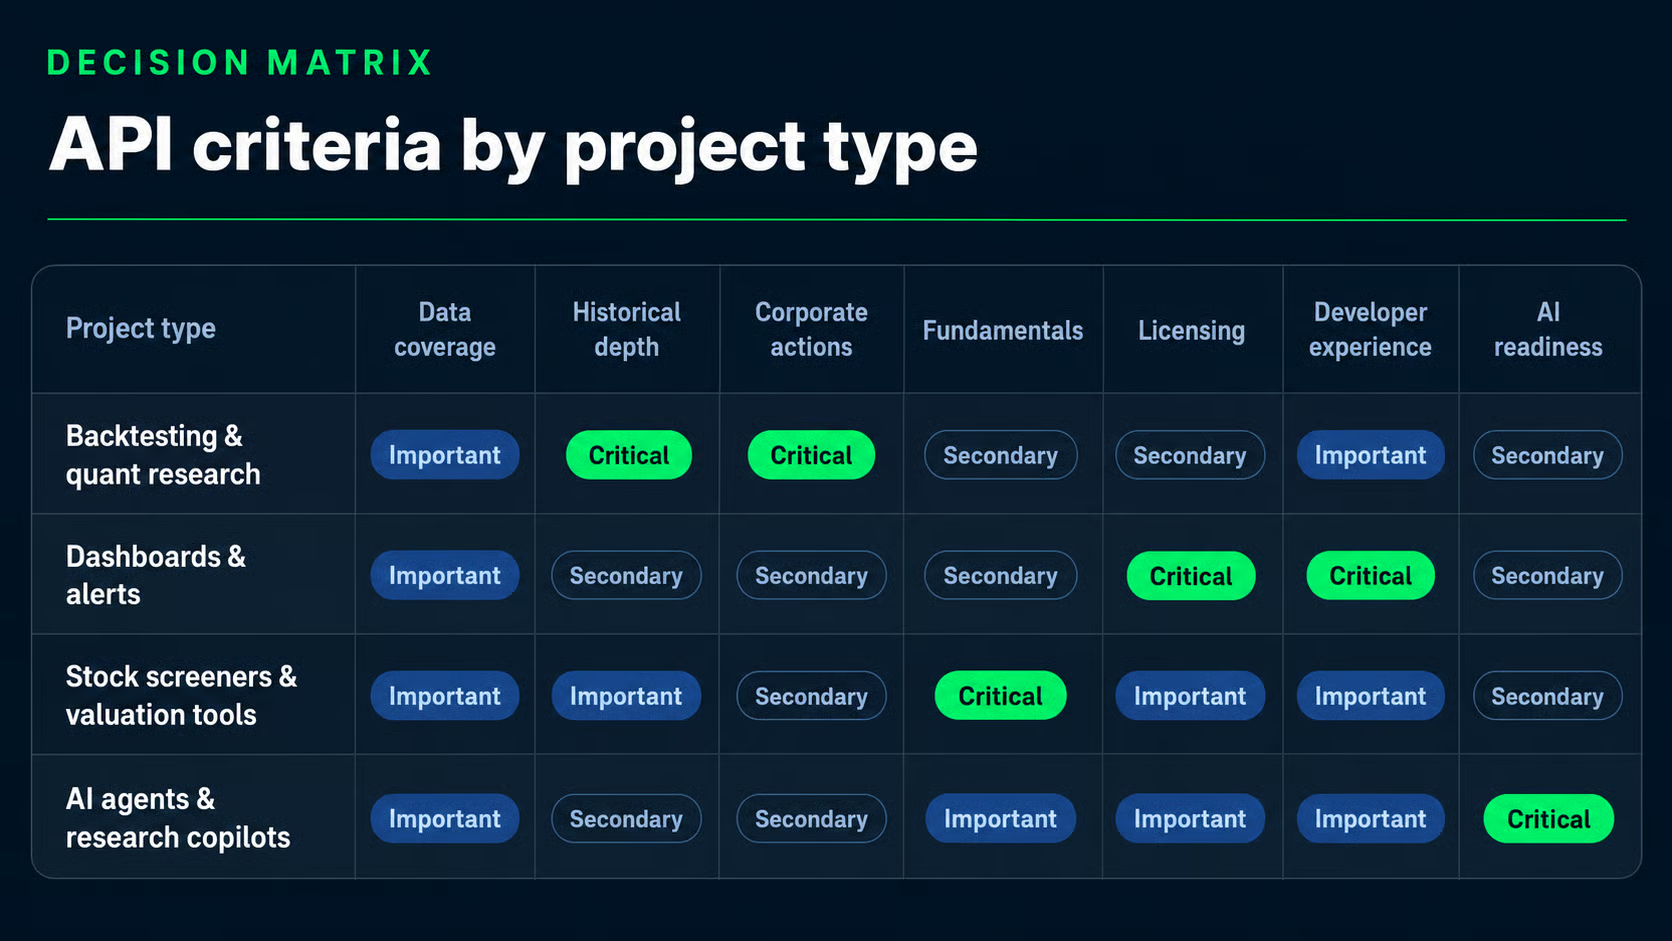
Nous pouvons maintenant relier workflow et critères d'évaluation.
Le but de cette matrice n'est pas de classer les fournisseurs, mais d'aider à décider quels critères méritent le plus d'attention pour le projet que vous construisez.
|
Type de projet |
Critères principaux |
Critères secondaires |
Fournisseurs à considérer |
|
Backtesting et recherche quant |
Profondeur historique, prix ajustés et opérations sur titres |
Préparation IA, licences |
Alpha Vantage pour les workflows historiques et indicateurs étendus ; EODHD pour la recherche EOD globale |
|
Tableaux de bord et alertes |
Licences, DX des réponses, limites de débit |
Profondeur historique, fondamentaux |
QuoteMedia pour des dashboards orientés développeurs ; Xignite pour des apps financières enterprise |
|
Screeners et outils de valorisation |
Fondamentaux, métadonnées d'entreprise, ratios et états financiers |
Profondeur historique, couverture des symboles |
Alpha Vantage pour des workflows larges fondamentaux+prix ; Intrinio pour des outils US riches en fondamentaux |
|
Agents IA et copilotes de recherche |
|||
|
Réponses structurées, accès outils et préparation MCP |
Fondamentaux, indicateurs, licences |
Alpha Vantage pour MCP et une large couverture API |
Ce tableau est volontairement imparfait. Les projets réels dépassent rarement une seule ligne, et la plupart des produits sérieux combinent plusieurs workflows.
Pour un backtester, je commencerais par la profondeur historique et les opérations sur titres avant de me soucier des cotations live.
La vraie question n'est pas « Puis-je récupérer l'historique des prix ? », mais « Puis-je faire confiance à cet historique à travers splits, dividendes, dates manquantes et longs régimes de marché ? »
Pour ce workflow, vérifiez :
Les données temps réel peuvent compter plus tard si vous allez vers du monitoring live ou de l'exécution. Pour la recherche historique, ce n'est pas la première priorité.
Pour un assistant IA, l'API doit être simple à utiliser autant pour le code que pour le modèle.
Un développeur humain peut inspecter un JSON désordonné et corriger le parsing. Un workflow d'agent est moins tolérant. Si le schéma est imprévisible, le modèle peut appeler le bon outil tout en peinant à exploiter le résultat.
Pour ce workflow, vérifiez :
Le point plus large est simple : choisissez l'API selon le mode d'échec que vous ne pouvez pas vous permettre. Un backtester échoue quand l'historique est faux. Un dashboard échoue quand les utilisateurs n'obtiennent pas de réponses fraîches. Un assistant IA échoue quand la couche d'accès aux données est trop désordonnée.
Il n'existe pas d'API boursière unique valable pour tous les projets. Le bon choix dépend de ce que votre système doit faire : profondeur historique pour le backtesting, fraîcheur pour les dashboards, fondamentaux pour les screeners et réponses structurées pour les workflows IA.
C'est aussi pourquoi Alpha Vantage s'est avérée polyvalente dans ces exemples. Elle couvre plusieurs couches : données de marché, fondamentaux, indicateurs techniques et workflows IA basés sur MCP, ce qui permet de tester plusieurs facteurs de décision sans changer de fournisseur.
Je traiterais une API boursière comme une brique de l'infrastructure data du projet, pas comme une simple collection d'endpoints. Elle impacte votre code, base de données, jobs de rafraîchissement, entrées de modèles, expérience utilisateur, et même ce que vous pouvez afficher dans le produit final.
Si vous souhaitez renforcer vos workflows finance en Python, commencez par notre cours Python for Finance.
Apprenez l'analyse financière en Python avec DataCamp !
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {Cours} other {Cours}}
{count, plural, one {blog} other {blogs}}
Kurtis Pykes
15 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Moez Ali
6 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Kurtis Pykes
15 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Allan Ouko
11 min
{count, plural, one {Tutoriel} other {Tutoriels}}
Sejal Jaiswal
24 min
{count, plural, one {Tutoriel} other {Tutoriels}}
DataCamp Team
3 min